Boilerplate code: qué es el código repetitivo y cómo se reduce

En programación se llama boilerplate code, o simplemente boilerplate, al código que hay que escribir una y otra vez, casi sin cambios, para que un programa funcione: no aporta nada propio del problema que se resuelve, pero sin él el programa no compila o no arranca. En español se suele decir código repetitivo o código de plantilla.

Placa metálica de 1913 de la Reid Newfoundland Company, constructora de calderas
Una placa de fabricante de calderas de 1913. El nombre del boilerplate viene de este tipo de piezas de metal.

El nombre viene de la imprenta. A finales del siglo XIX, en Estados Unidos, las agencias enviaban a los periódicos pequeños textos ya compuestos en planchas de metal, listos para imprimir sin cambiar una coma: anuncios, columnas fijas, avisos legales. Aquellas planchas recordaban a las de acero con que se fabricaban las calderas, las boiler plates, y el nombre se quedó para cualquier texto que se reutiliza tal cual. Hoy se usa también en derecho, para las cláusulas que se copian de un contrato a otro, y en programación.

Ejemplos de boilerplate

Todos los lenguajes tienen su ración. Algunos de los ejemplos más conocidos:

  • El esqueleto de una página HTML: <!doctype html>, <html>, <head>, el charset y el viewport se repiten en cada página antes de escribir una sola línea de contenido.
  • El if __name__ == "__main__": de Python, que separa lo que se ejecuta al lanzar un archivo de lo que se ejecuta al importarlo.
  • El if err != nil { return err } de Go, que aparece después de casi cada llamada que puede fallar.
  • Las clases de datos en Java: constructor, métodos para leer cada campo, equals, hashCode y toString. Es el ejemplo clásico, y lo vemos ahora.

Esta clase solo guarda un nombre y una edad, y ocupa 29 líneas. Casi todas son boilerplate: si se añade un campo, hay que acordarse de tocar el constructor, el método de lectura, equals, hashCode y toString. Si se olvida uno, el error no salta al compilar.

import java.util.Objects;

public final class PersonaClasica {
    private final String nombre;
    private final int edad;

    public PersonaClasica(String nombre, int edad) {
        this.nombre = nombre;
        this.edad = edad;
    }

    public String getNombre() { return nombre; }
    public int getEdad() { return edad; }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (!(o instanceof PersonaClasica p)) return false;
        return edad == p.edad && Objects.equals(nombre, p.nombre);
    }

    @Override
    public int hashCode() { return Objects.hash(nombre, edad); }

    @Override
    public String toString() {
        return "PersonaClasica[nombre=" + nombre + ", edad=" + edad + "]";
    }
}

Desde Java 16, un record hace lo mismo en una línea. El compilador genera el constructor, los métodos para leer los campos, equals, hashCode y toString:

public record Persona(String nombre, int edad) { }
public class Prueba {
    public static void main(String[] args) {
        var a = new PersonaClasica("Ana", 30);
        var b = new PersonaClasica("Ana", 30);
        System.out.println(a + " | iguales: " + a.equals(b));

        var c = new Persona("Ana", 30);
        var d = new Persona("Ana", 30);
        System.out.println(c + " | iguales: " + c.equals(d) + " | nombre: " + c.nombre());
    }
}
java PruebaPersonaClasica[nombre=Ana, edad=30] | iguales: true
Persona[nombre=Ana, edad=30] | iguales: true | nombre: Ana

Las dos versiones se comportan igual: las dos personas con el mismo nombre y edad son iguales, y se imprimen con todos sus campos. La diferencia es que en la segunda no hay nada que mantener a mano.

Cómo se reduce el boilerplate

  • El propio lenguaje. Es la mejor solución, porque no añade dependencias: los record de Java, las data class de Kotlin, las dataclass de Python o los #[derive(Debug, Clone, PartialEq)] de Rust generan el código repetitivo por ti.
  • Bibliotecas que generan código. En Java, Lombok añade getters, setters y constructores con anotaciones como @Data. Funciona, pero es una dependencia más, que además se mete en el proceso de compilación.
  • Frameworks. Spring Boot, Django o Ruby on Rails existen en buena parte para ahorrar boilerplate: configuran solos lo habitual y solo hay que escribir lo que se sale de lo normal.
  • Generadores y plantillas de proyecto. Herramientas como npm create, cargo new o Spring Initializr crean la estructura inicial completa con una orden.
  • El editor y la IA. Los IDE generan constructores y métodos con un atajo, y los asistentes de IA escriben el boilerplate en segundos. Es justo el tipo de código que mejor generan, porque lo han visto millones de veces.
Que lo escriba la IA no lo hace gratis. El boilerplate generado hay que leerlo, revisarlo y mantenerlo igual que el escrito a mano. Si un campo nuevo no se añade a equals, el error es el mismo lo haya escrito quien lo haya escrito. Por eso, cuando el lenguaje ofrece una forma de no tener que escribirlo, como un record, sigue siendo mejor opción que generarlo. Lo explicamos en qué lenguaje elegir cuando la IA escribe el código.

¿Es siempre malo?

No. Parte del boilerplate existe por buenas razones: el if err != nil de Go obliga a decidir qué hacer con cada error, en lugar de dejar que una excepción suba sin control, y declarar los tipos de forma explícita hace que el código se lea mejor meses después. El problema aparece cuando la repetición no aporta información y solo multiplica los sitios donde equivocarse. La regla práctica: si al leer un bloque no aprendes nada sobre lo que hace el programa, es boilerplate y conviene que lo genere el lenguaje, un framework o una herramienta.

Los ejemplos de Java se compilaron y ejecutaron con Java 25 (Eclipse Temurin 25.0.4). Más información: Boilerplate code en Wikipedia y JEP 395: Records.

El ciclo for en Java, Go y Python

Los tres lenguajes tienen for, pero cada uno lo entiende a su manera. Java tiene dos formas, Go usa una sola palabra para todos los bucles, y en Python el for siempre recorre algo. Los comparamos con ejemplos ejecutados en los tres.

Java: el for clásico y el de recorrido

public class CicloFor {
    public static void main(String[] args) {
        for (int i = 0; i < 3; i++) {
            System.out.println("valor de i: " + i);
        }

        String[] lenguajes = {"Java", "Go", "Python"};
        for (String l : lenguajes) {
            System.out.println(l);
        }

        for (int i = 0, j = 10; i < j; i += 3, j -= 3) {
            System.out.println(i + " " + j);
        }
    }
}
java CicloFor.javavalor de i: 0
valor de i: 1
valor de i: 2
Java
Go
Python
0 10
3 7

El primero es el for heredado de C: una inicialización, una condición que se comprueba antes de cada vuelta y un incremento que se ejecuta al final de cada una. El segundo, el «for mejorado», recorre un arreglo o cualquier colección sin índice. El tercero recuerda que cada una de las tres partes puede tener varias expresiones separadas por comas.

Go: una sola palabra para todos los bucles

package main

import "fmt"

func main() {
	for i := 0; i < 3; i++ {
		fmt.Println("valor de i: ", i)
	}

	for i := range 3 {
		fmt.Println("range:", i)
	}

	lenguajes := []string{"Java", "Go", "Python"}
	for i, l := range lenguajes {
		fmt.Println(i, l)
	}

	n := 1
	for n < 100 {
		n *= 3
	}
	fmt.Println("primera potencia de 3 mayor que 100:", n)

	for {
		fmt.Println("una vez y fuera")
		break
	}
}
go run .valor de i:  0
valor de i:  1
valor de i:  2
range: 0
range: 1
range: 2
0 Java
1 Go
2 Python
primera potencia de 3 mayor que 100: 243
una vez y fuera

Go no tiene while ni do: todo se escribe con for. Con tres partes es el clásico, sin paréntesis. Con solo la condición, hace de while. Sin nada es un bucle infinito, del que se sale con break. Y con range recorre colecciones devolviendo el índice y el valor. Desde Go 1.22, range también acepta un número: for i := range 3 da 0, 1 y 2.

Fíjate en los dos espacios de valor de i: 0. fmt.Println pone un espacio entre cada argumento, y el texto ya terminaba en espacio. En Go se escribe fmt.Println("valor de i:", i), sin el espacio final.

Python: siempre recorre algo

for i in range(3):
    print("valor de i: ", i)

for i in range(3):
    print("valor de i:", i)

lenguajes = ["Java", "Go", "Python"]
for i, l in enumerate(lenguajes):
    print(i, l)

for i in range(10, 0, -3):
    print(i, end=" ")
print()

for l in lenguajes:
    if l == "Rust":
        break
else:
    print("no había Rust")
python ciclo.pyvalor de i:  0
valor de i:  1
valor de i:  2
valor de i: 0
valor de i: 1
valor de i: 2
0 Java
1 Go
2 Python
10 7 4 1
no había Rust

En Python no hay for con contador: se recorre una secuencia, y range genera los números. range(10, 0, -3) cuenta hacia atrás de tres en tres, y enumerate da el índice junto a cada elemento. El primer print tiene el mismo doble espacio que Go, por el mismo motivo: print separa sus argumentos con un espacio.

Lo exclusivo de Python es el else del for: se ejecuta solo si el bucle terminó sin break. Sirve para búsquedas como esta, donde llegar al final significa que no se encontró nada.

Lado a lado

JavaGoPython
Contar de 0 a 9for (int i = 0; i < 10; i++)for i := 0; i < 10; i++ o for i := range 10for i in range(10):
Recorrer una colecciónfor (String l : lista)for _, l := range listafor l in lista:
Con índiceel for clásicofor i, l := range listafor i, l in enumerate(lista):
Mientras se cumpla algowhile (cond)for condwhile cond:
Infinitowhile (true)forwhile True:
Bloquellavesllaves, obligatoriassangría

Lo que cambia por debajo

La versión anterior de esta entrada decía que Java es un lenguaje interpretado, como Python. No es exacto, y la diferencia explica buena parte de la diferencia de velocidad. Java se compila a bytecode, y la máquina virtual compila a código máquina, mientras el programa se ejecuta, las partes que más se usan. Go se compila directamente a un ejecutable nativo. Python, en su implementación habitual, también compila a bytecode, pero lo interpreta instrucción a instrucción, y por eso un bucle con mucho cálculo suele ir bastante más despacio. Para medirlo bien, mira medir el rendimiento en Java.

Entrada publicada en 2020 y revisada en octubre de 2026. Cada ejemplo se ejecutó en un contenedor limpio con Java 25 LTS, Go 1.25 y Python 3.14; las salidas están copiadas de esa ejecución.

Primera Imagen de un Agujero Negro, por Katherine Louise Bouman


Katherine Louise Bouman es una científica y profesora asistente de ciencias de la computación en el Instituto de Tecnología de California.  Hace tres años, Bouman lideró la creación de un algoritmo que eventualmente ayudó a formar esta imagen única en su clase: un agujero negro supermasivo y su sombra en el centro de una galaxia conocida como M87. Ella era entonces una estudiante graduada en ciencias de la computación e inteligencia artificial en el Instituto de Tecnología de Massachusetts.

Puedes ver una interesante charla de Bouman y su propuesta para la detección de agujeros negros en TED de hace tres años.

Años más tarde puedes ver que su investigación es un total éxito.

Ella y su equipo tomaron los «datos escasos y ruidosos» que generaron diversos radiotelescopios alrededor del mundo e intentaron crear una imagen. Durante los últimos años, Bouman dirigió la verificación de imágenes y la selección de parámetros para crearla. Mas de 5 petabytes fueron necesarios para recabar la información de todos los centros de investigación que participaron.


La imagen obtenida, revela la cara sombría de un agujero negro supermasivo de 6.500 millones de masas solares en el centro de Messier 87 (M87), una gran galaxia a unos 55 millones de años luz de la Tierra en el cúmulo de galaxias de Virgo. Tales objetos son la comprobación (una vez más) de la teoría de la relatividad general de Einstein que predice la deformación del espacio-tiempo por objetos súper massivos.

Las librerías de Python más usadas, con ejemplos que funcionan

Portada: las librerías de Python más usadas, con el logotipo de Python y los nombres de diez librerías: requests, tqdm, Pillow, NumPy, pandas, Matplotlib, Beautiful Soup, SQLAlchemy, FastAPI y pytest

Python trae mucho de serie, pero buena parte de lo que se hace con él a diario se apoya en librerías externas. Estas son las que más se usan, agrupadas por tarea y cada una con un ejemplo corto que puedes copiar y ejecutar.

Cómo instalarlas

Lo recomendable es instalar cada proyecto en su propio entorno virtual, para que las versiones de un proyecto no choquen con las de otro:

python -m venv venv
source venv/bin/activate        # en Windows: venv\Scripts\activate
pip install requests tqdm pillow numpy pandas matplotlib beautifulsoup4 sqlalchemy fastapi httpx2 pytest

Ten en cuenta que el nombre del paquete no siempre coincide con el del import: se instala pillow y se importa PIL, se instala beautifulsoup4 y se importa bs4.

Para…LibreríaVersión probada
Peticiones HTTPrequests2.34.2
Barras de progresotqdm4.70.1
ImágenesPillow12.3.0
Cálculo numéricoNumPy2.5.3
Tablas de datospandas3.0.6
GráficasMatplotlib3.11.2
Extraer datos de HTMLBeautiful Soup4.15.0
Bases de datosSQLAlchemy2.1.4
APIs webFastAPI0.143.0
Pruebaspytest9.1.1

requests: peticiones HTTP

import requests

r = requests.get("https://httpbin.org/get", params={"lenguaje": "python"}, timeout=10)
print(r.status_code, r.headers["Content-Type"])
print(r.json()["args"])

r = requests.post("https://httpbin.org/post", json={"sitio": "decodigo.com"}, timeout=10)
print(r.json()["json"])
salida200 application/json
{'lenguaje': 'python'}
{'sitio': 'decodigo.com'}

Con params se arma la cadena de consulta, con json= se envía un cuerpo JSON con su cabecera, y r.json() decodifica la respuesta. Pon siempre un timeout: sin él, una petición a un servidor que no responde puede quedarse esperando indefinidamente. Si solo necesitas algo puntual y no quieres dependencias, la biblioteca estándar también lo hace; lo vemos en peticiones HTTP sin dependencias.

tqdm: barras de progreso

from time import sleep
from tqdm import tqdm

total = 0
for n in tqdm(range(50), desc="Procesando", ncols=70):
    total += n
    sleep(0.02)
print("suma:", total)
salida, última línea de la barraProcesando: 100%|█████████████████████| 50/50 [00:01<00:00, 49.11it/s]
suma: 1225

Basta con envolver el iterable en tqdm(). La barra se va redibujando en la misma línea y muestra el avance, la velocidad y el tiempo que falta. Es muy útil en procesos largos, porque deja ver enseguida si el trabajo avanza o se ha atascado.

Pillow: imágenes

from PIL import Image, ImageDraw

img = Image.new("RGB", (800, 400), "#1e64af")
ImageDraw.Draw(img).rectangle([40, 40, 760, 360], outline="white", width=8)
img.save("original.png")

copia = Image.open("original.png")
copia.thumbnail((200, 200))
copia.save("miniatura.png")
print(Image.open("original.png").size, "->", Image.open("miniatura.png").size)
salida(800, 400) -> (200, 100)

thumbnail reduce la imagen para que quepa en la caja que le das (200×200), pero conserva la proporción: por eso queda en 200×100 y no se deforma. Pillow abre y guarda los formatos habituales (PNG, JPEG, WebP, GIF…) y sirve para recortar, rotar, dibujar o cambiar el formato por lotes.

NumPy y pandas: datos

import numpy as np
import pandas as pd

temps = np.array([18.5, 21.0, 24.3, 19.8, 22.1])
print("media:", temps.mean().round(2), "máxima:", temps.max())
print(temps * 9 / 5 + 32)

ventas = pd.DataFrame({
    "lenguaje": ["Python", "Java", "Python", "Go", "Java", "Python"],
    "visitas": [120, 80, 150, 40, 95, 130],
})
print(ventas.groupby("lenguaje")["visitas"].agg(["count", "sum", "mean"]).sort_values("sum", ascending=False))
salidamedia: 21.14 máxima: 24.3
[65.3  69.8  75.74 67.64 71.78]
          count  sum        mean
lenguaje
Python        3  400  133.333333
Java          2  175   87.500000
Go            1   40   40.000000

NumPy opera sobre arreglos completos de una vez: temps * 9 / 5 + 32 convierte las cinco temperaturas sin escribir ningún bucle, y además mucho más rápido que un bucle en Python. pandas se apoya en NumPy para trabajar con tablas: aquí agrupa por lenguaje y calcula el número de filas, la suma y la media de cada grupo en una sola línea. Si trabajas con archivos muy grandes, merece la pena mirar también Polars, una alternativa más reciente y muy rápida.

Matplotlib: gráficas

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

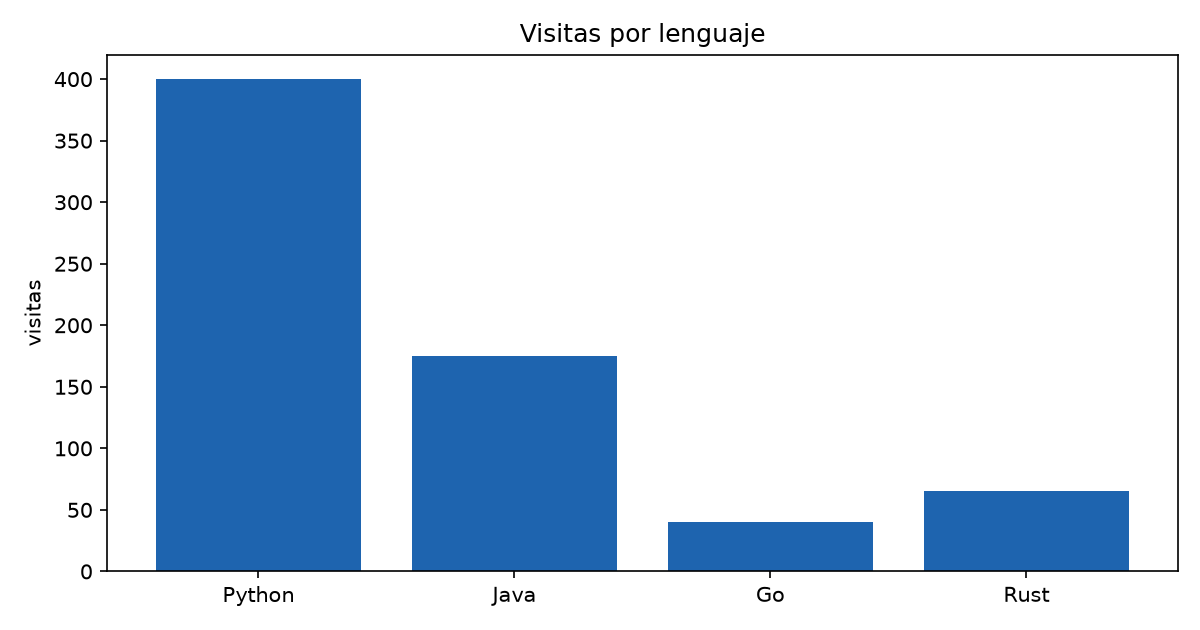
lenguajes = ["Python", "Java", "Go", "Rust"]
visitas = [400, 175, 40, 65]

fig, ax = plt.subplots(figsize=(8, 4.2))
ax.bar(lenguajes, visitas, color="#1e64af")
ax.set_title("Visitas por lenguaje")
ax.set_ylabel("visitas")
fig.tight_layout()
fig.savefig("grafica.png", dpi=150)
print("guardada grafica.png")
Gráfica de barras generada con matplotlib: visitas por lenguaje, con Python a la cabeza, seguido de Java, Rust y Go (datos de ejemplo)
La gráfica que genera el ejemplo, tal cual. Los datos son inventados.

matplotlib.use("Agg") hace que dibuje directamente a un archivo, sin abrir ninguna ventana; así funciona también en un servidor o en un contenedor. En tu ordenador puedes quitarlo y llamar a plt.show() para ver la gráfica en pantalla.

Beautiful Soup: extraer datos de HTML

from bs4 import BeautifulSoup

html = """
<ul id="lenguajes">
  <li class="activo"><a href="/python">Python</a></li>
  <li><a href="/java">Java</a></li>
  <li class="activo"><a href="/rust">Rust</a></li>
</ul>
"""
soup = BeautifulSoup(html, "html.parser")
for a in soup.select("#lenguajes li.activo a"):
    print(a.text, "->", a["href"])
salidaPython -> /python
Rust -> /rust

select acepta selectores CSS, los mismos que se usan en las hojas de estilo, así que #lenguajes li.activo a se lee igual que en CSS. Para descargar la página se combina con requests. Si lo que necesitas es recorrer un sitio entero siguiendo enlaces, la herramienta adecuada es Scrapy. Y antes de extraer datos de un sitio, revisa sus condiciones de uso y su robots.txt.

SQLAlchemy: bases de datos

from sqlalchemy import create_engine, select, String
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, Session

class Base(DeclarativeBase):
    pass

class Articulo(Base):
    __tablename__ = "articulos"
    id: Mapped[int] = mapped_column(primary_key=True)
    titulo: Mapped[str] = mapped_column(String(100))
    visitas: Mapped[int]

engine = create_engine("sqlite:///:memory:")
Base.metadata.create_all(engine)

with Session(engine) as s:
    s.add_all([Articulo(titulo="Hola mundo", visitas=10),
               Articulo(titulo="Leer CSV", visitas=42),
               Articulo(titulo="Peticiones HTTP", visitas=27)])
    s.commit()
    consulta = select(Articulo).where(Articulo.visitas > 20).order_by(Articulo.visitas.desc())
    for a in s.scalars(consulta):
        print(a.titulo, a.visitas)
salidaLeer CSV 42
Peticiones HTTP 27

Cada tabla se define como una clase, y las consultas se escriben en Python en lugar de en SQL. Es el estilo de SQLAlchemy 2, con anotaciones de tipo (Mapped[int]). El mismo código funciona con SQLite, PostgreSQL o MySQL cambiando solo la cadena de conexión. Para SQLite sin ninguna librería externa, mira SQLite con Python.

FastAPI: APIs web

from fastapi import FastAPI
from fastapi.testclient import TestClient
from pydantic import BaseModel

app = FastAPI()

class Articulo(BaseModel):
    titulo: str
    visitas: int = 0

@app.get("/saludo/{nombre}")
def saludo(nombre: str):
    return {"mensaje": f"Hola, {nombre}"}

@app.post("/articulos")
def crear(articulo: Articulo):
    return {"creado": articulo.titulo, "visitas": articulo.visitas}

cliente = TestClient(app)
print(cliente.get("/saludo/Ana").json())
print(cliente.post("/articulos", json={"titulo": "FastAPI"}).json())
r = cliente.post("/articulos", json={"visitas": "muchas"})
print(r.status_code, [e["loc"][-1] + ": " + e["type"] for e in r.json()["detail"]])
salida{'mensaje': 'Hola, Ana'}
{'creado': 'FastAPI', 'visitas': 0}
422 ['titulo: missing', 'visitas: int_parsing']

FastAPI usa las anotaciones de tipo para validar lo que llega: en la última petición falta el título y visitas no es un número, así que responde con un error 422 que explica cada fallo, sin que hayas escrito ninguna validación. Aquí se prueba con TestClient, que llama a la API sin levantar un servidor; en producción se ejecuta con uvicorn.

Con las versiones actuales, TestClient avisa de que usar httpx está obsoleto y pide instalar httpx2. Por eso aparece en el pip install de arriba; con él, el aviso desaparece y el ejemplo funciona igual.

Si buscas un framework completo, con panel de administración, usuarios y plantillas incluidos, la referencia es Django. Para algo pequeño y sin estructura impuesta, Flask.

pytest: pruebas

import pytest

def precio_con_iva(precio, iva=0.16):
    if precio < 0:
        raise ValueError("el precio no puede ser negativo")
    return round(precio * (1 + iva), 2)

def test_iva_por_defecto():
    assert precio_con_iva(100) == 116.0

@pytest.mark.parametrize("precio, iva, esperado", [(50, 0.16, 58.0), (200, 0.08, 216.0), (0, 0.16, 0.0)])
def test_varios(precio, iva, esperado):
    assert precio_con_iva(precio, iva) == esperado

def test_negativo():
    with pytest.raises(ValueError):
        precio_con_iva(-1)
python -m pytest -v test_precios.py
salida (recortada)test_precios.py::test_iva_por_defecto PASSED                             [ 20%]
test_precios.py::test_varios[50-0.16-58.0] PASSED                        [ 40%]
test_precios.py::test_varios[200-0.08-216.0] PASSED                      [ 60%]
test_precios.py::test_varios[0-0.16-0.0] PASSED                          [ 80%]
test_precios.py::test_negativo PASSED                                    [100%]

============================== 5 passed in 0.04s ===============================

Las pruebas son funciones que empiezan por test_ y usan un assert normal. parametrize ejecuta la misma prueba con varios casos, y cada uno aparece por separado en el informe; pytest.raises comprueba que se lanza la excepción esperada.

Otras que conviene conocer

LibreríaPara qué
scikit-learnAprendizaje automático clásico: clasificación, regresión, agrupamiento
PyTorchRedes neuronales y aprendizaje profundo
KerasAPI de alto nivel para redes neuronales; desde Keras 3 funciona sobre JAX, TensorFlow o PyTorch
NLTK y spaCyProcesamiento de lenguaje natural
ScapyCrear, enviar y analizar paquetes de red; muy usada en seguridad
KivyInterfaces gráficas multiplataforma, también para móviles
La versión de 2019 de esta entrada incluía Twisted, un framework de red basado en eventos. Sigue existiendo, pero hoy, para la mayoría de los programas concurrentes, se usa asyncio, que viene con Python, o librerías construidas sobre él.

Entrada publicada en 2019 y revisada en octubre de 2026. Todo el código se ejecutó con Python 3.14.8 en un contenedor limpio, con las versiones de la tabla; las salidas están copiadas de esa ejecución.

Curiosidades del punto flotante: por qué 9999999999999999.0 − 9999999999999998.0 da 2

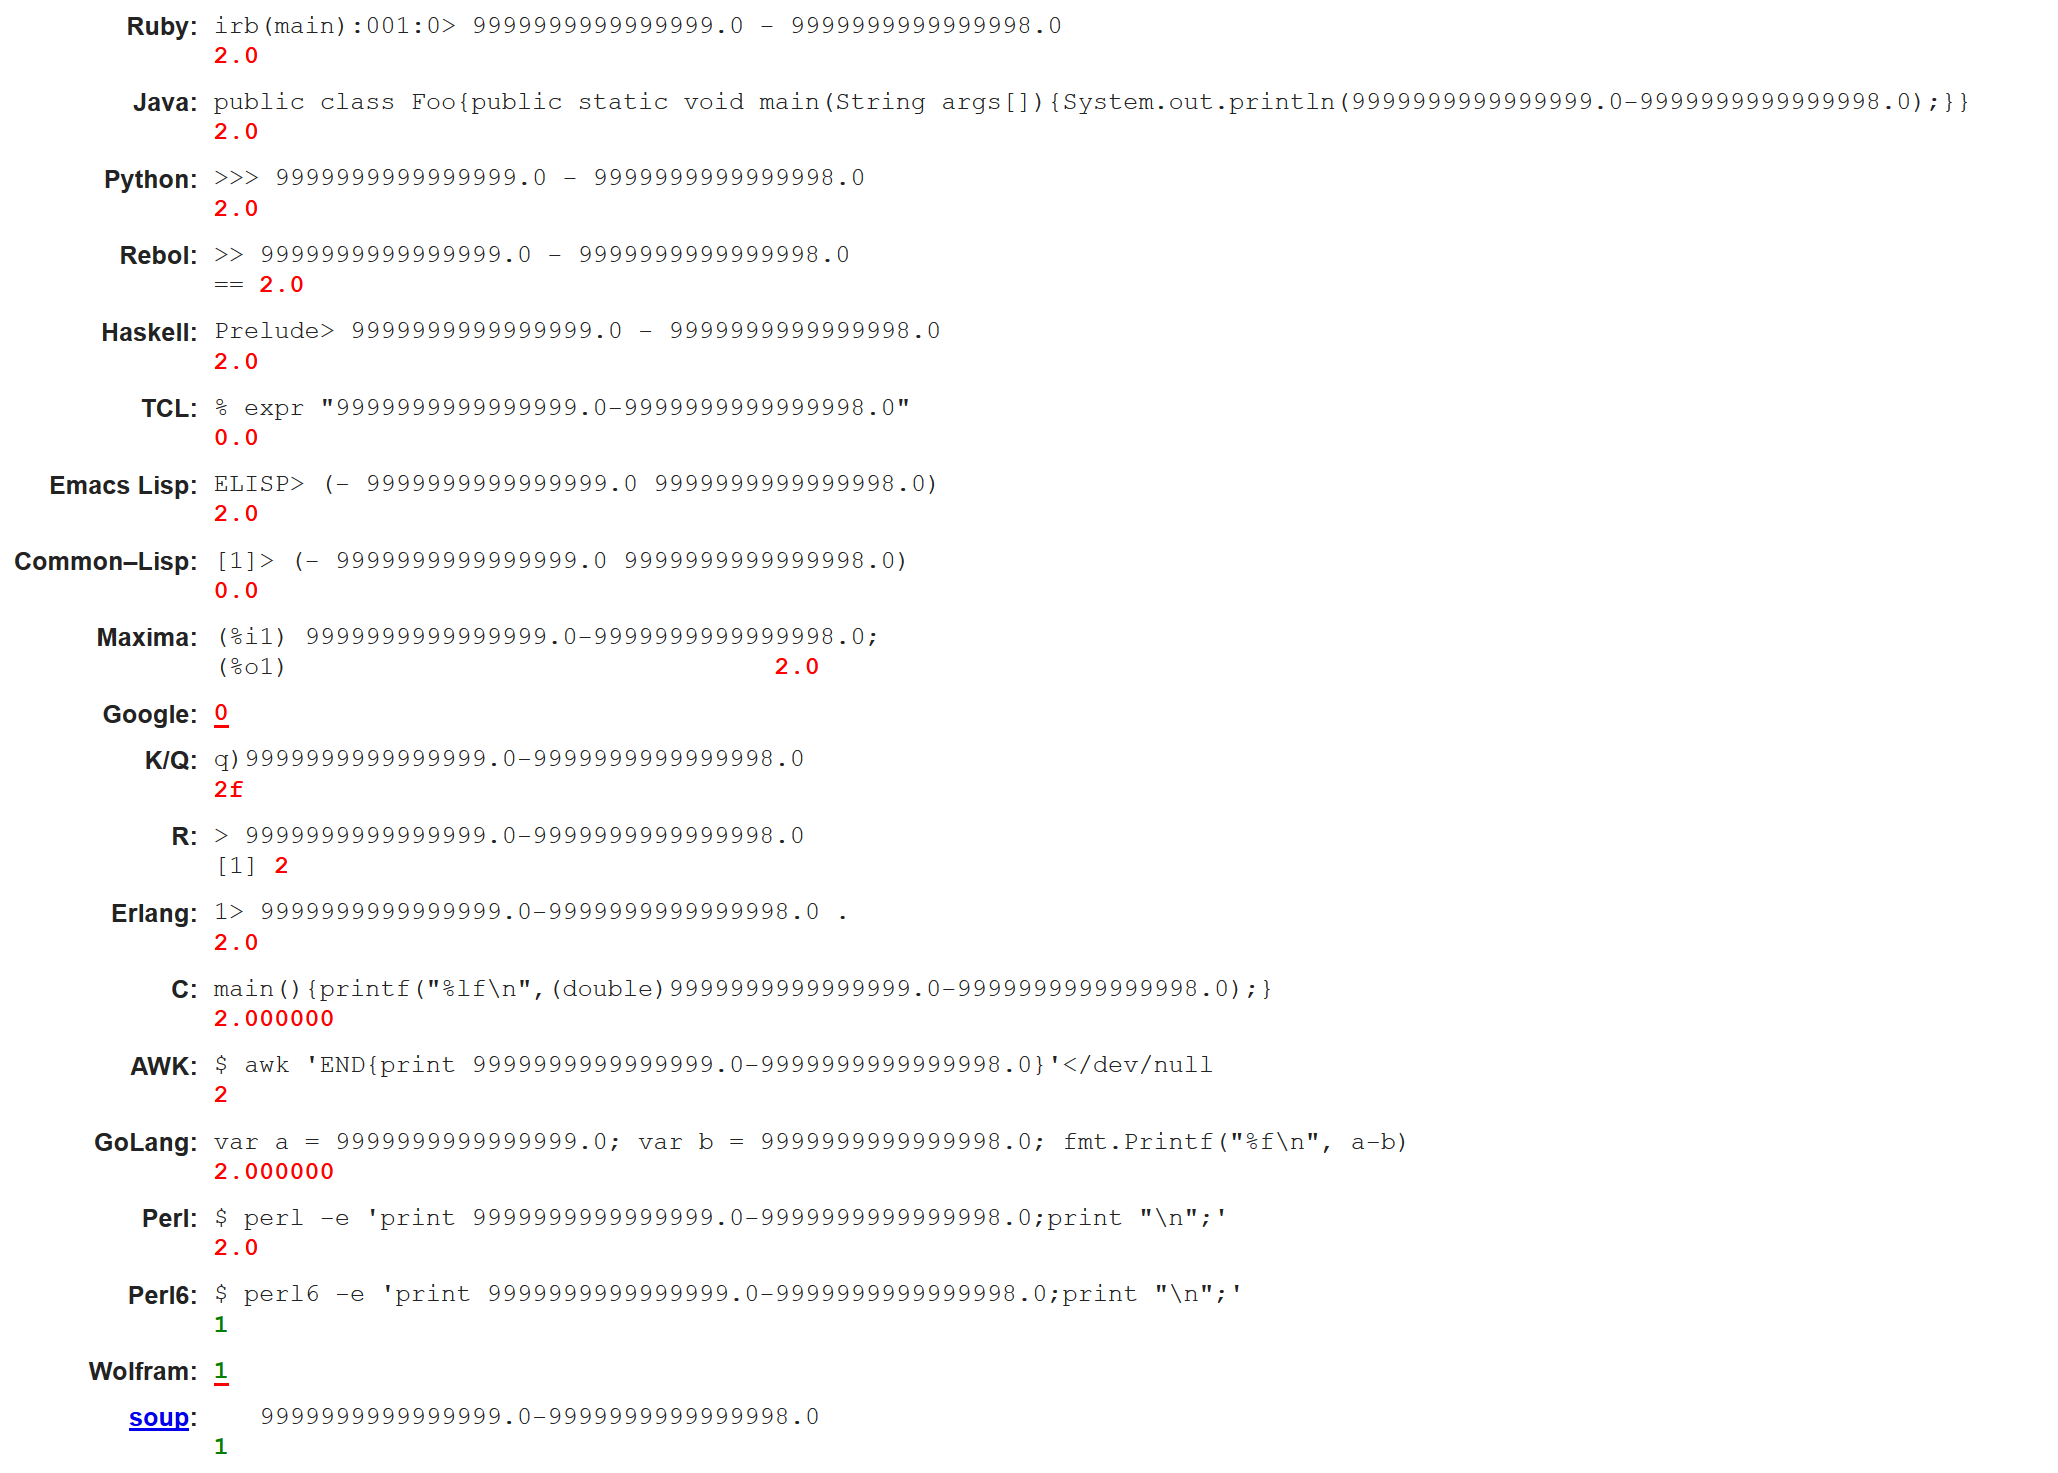
¿Cuánto es 9999999999999999.0 - 9999999999999998.0? Debería ser 1, pero en la mayoría de los lenguajes el resultado es 2. Geo Carncross hizo la prueba en una veintena de ellos, y la tabla de arriba resume lo que obtuvo. Aquí lo comprobamos en Java y vemos por qué pasa.

En Java

double a = 9999999999999999.0;
double b = 9999999999999998.0;
IO.println("a: " + a);
IO.println("b: " + b);
IO.println("a - b: " + (a - b));
IO.println("a exacto: " + new BigDecimal(a));
IO.println("b exacto: " + new BigDecimal(b));
IO.println("separación entre doubles cerca de a: " + Math.ulp(a));
IO.println("2^53 = " + (long) Math.pow(2, 53));
salidaa: 1.0E16
b: 9.999999999999998E15
a - b: 2.0
a exacto: 10000000000000000
b exacto: 9999999999999998
separación entre doubles cerca de a: 2.0
2^53 = 9007199254740992

La segunda línea de la salida ya da la pista: a se imprime como 1.0E16, es decir, 10000000000000000. El número que escribimos no es el que se guardó. new BigDecimal(a) muestra el valor exacto que hay en memoria, y la resta, con esos valores, sí está bien hecha: 10000000000000000 − 9999999999999998 = 2.

Por qué no cabe

Un double ocupa 64 bits: 1 para el signo, 11 para el exponente y 52 para la mantisa, que con un bit implícito dan 53 bits de precisión. Con 53 bits se pueden representar exactamente todos los enteros hasta 253 = 9,007,199,254,740,992. Nuestros números son mayores.

Por encima de ese límite, los double ya no están en todos los enteros: entre 253 y 254 van de dos en dos, que es lo que dice Math.ulp(a). 9999999999999998 es par y cae justo en uno. 9999999999999999 es impar, queda exactamente a medio camino entre 9999999999999998 y 10000000000000000, y la regla de redondeo de IEEE 754 (al vecino «par») lo lleva a 10000000000000000.

No es un fallo de Java: es el formato que usan casi todos los lenguajes y los procesadores. Por eso la mayoría de la tabla dice 2.

El caso de todos los días: 0.1 + 0.2

No hace falta irse a números tan grandes. Con decimales pequeños pasa algo parecido, porque la mayoría no tienen representación exacta en binario, igual que 1/3 no la tiene en decimal:

IO.println("0.1 + 0.2 = " + (0.1 + 0.2));
IO.println("0.1 + 0.2 == 0.3 -> " + (0.1 + 0.2 == 0.3));
IO.println("0.1 exacto: " + new BigDecimal(0.1));
IO.println("Math.abs((0.1 + 0.2) - 0.3) < 1e-9 -> " + (Math.abs((0.1 + 0.2) - 0.3) < 1e-9));
salida0.1 + 0.2 = 0.30000000000000004
0.1 + 0.2 == 0.3 -> false
0.1 exacto: 0.1000000000000000055511151231257827021181583404541015625
Math.abs((0.1 + 0.2) - 0.3) < 1e-9 -> true

El 0.1 que se guarda es un poquito mayor que 0.1, y al sumar se acumulan esos errores. De ahí la regla: nunca compares double con ==. Compara la diferencia con un margen de tolerancia adecuado a tu problema.

Cuando hace falta exactitud

IO.println("new BigDecimal(\"0.1\").add(new BigDecimal(\"0.2\")) = " + new BigDecimal("0.1").add(new BigDecimal("0.2")));
IO.println("new BigDecimal(0.1).add(new BigDecimal(0.2)) = " + new BigDecimal(0.1).add(new BigDecimal(0.2)));
IO.println("9999999999999999L - 9999999999999998L = " + (9999999999999999L - 9999999999999998L));
double suma = 0;
for (int i = 0; i < 10; i++) suma += 0.1;
IO.println("0.1 sumado diez veces = " + suma);
salidanew BigDecimal("0.1").add(new BigDecimal("0.2")) = 0.3
new BigDecimal(0.1).add(new BigDecimal(0.2)) = 0.3000000000000000166533453693773481063544750213623046875
9999999999999999L - 9999999999999998L = 1
0.1 sumado diez veces = 0.9999999999999999

Dos detalles importantes. BigDecimal se crea a partir de una cadena: new BigDecimal(0.1) recibe el double ya redondeado y conserva el error con todos sus decimales. Y la resta original, hecha con long, da 1, porque un long guarda enteros exactos hasta unos 9.2 trillones.

Para…UsaPor qué
Medidas, física, gráficos, estadísticadoubleRápido, y un error en el decimal 16 no importa
DineroBigDecimal creado desde texto, o long en céntimosLos céntimos tienen que cuadrar siempre
Contadores e identificadores grandeslongExacto hasta 9,223,372,036,854,775,807
Comparar dos doubleMath.abs(x - y) < tolerancia== falla con resultados de operaciones

La tabla de la imagen está tomada del experimento de Geo Carncross, que sigue en línea con algunos lenguajes más.

Entrada publicada en 2019 y revisada en octubre de 2026. Todo el código se compiló y se ejecutó con Java 25 LTS en un contenedor limpio; las salidas están copiadas de esa ejecución.

Tips para programadores

Aprende un nuevo lenguaje

Es sabido que no debes enfocarte en una sola tecnología o lenguaje de programación.   Pero el sentido de este consejo no es sólo que escojas una tecnología que te permita ganar más dinero (que también es una buena idea), sino que además de eso te permita experimentar y hacer cosas diferentes. Por ejemplo, si siempre has estado enfocado a aplicaciones WEB, puedes comenzar a experimentar con el control de motores eléctricos o para obtener datos desde sensores o hardware que no hayas usado anteriormente, o probar también con aplicaciones para móviles, tendrás una perspectiva más amplia de lo que es el desarrollo de software.

Ten un  «Pet Project»

Todos tenemos ideas para una aplicación o desarrollo que nos gustaría programar.  Sin embargo pocas veces las materializamos.  Esto no sólo es malo porque pierdes la oportunidad de llevar a cabo una buena idea, sino que también es posible que nunca sepas si esa idea es mala o que en realidad no sea tan útil, o peor aún, que ya exista algo parecido porque no habías investigado demasiado y te enfoques mejor en otra cosa.  Adquiere el hábito de tener al menos un proyecto y ve agregando características poco a poco pero de forma constante.

Relaciónate con personas que hagan cosas diferentes

No sólo se trata de encontrar gente que use otras tecnologías, sino otras formas de hacer negocios y de ganar dinero.  Es posible que encuentres oportunidades donde otros no las han visto, tan sólo porque no ha llegado nadie para propornerlas.  No te enfoques sólo a entender los problemas de los clientes de la empresa donde trabajes.

Haz que tu trabajo se vea elegante

Son muchos los desarrolladores que descuidan el aspecto visual de su trabajo y sólo se preocupan porque funcione correctamente.  Sin embargo una apariencia visual o usabilidad deficientes, pueden hacer que el usuario tenga una impresión equivocada sobre como funcionan tus desarrollos y llegue a pensar que tiene errores aún cuando esto no sea verdad, recuerda que haces desarrollo para facilitarle la vida a personas que no siempre tienen un conocimiento técnico silimar al tuyo.

No inventes cosas que ya están bien hechas

Lenguajes como Java o C# no son los más ampliamente usados por su sintaxis o su facilidad de uso, sino por la inmensa variedad de librerías o herramientas que existen y que puedes usar libremente, con la seguridad de que van a funcionar correctamente. No gastes tu tiempo tratndo de hacer algo que ya existe si no lo vas a superar.

Comparte y acepta críticas a tu código

Es universal. Ocurre en todas las profesiones. A nadie le gusta que le digan como hacer cosas que uno supone hace bien.  Pero compartir ideas y tomar en cuenta las recomendaciones de otros es casi tan útil como Google para aprender cosas nuevas.  Además mejoras tu ambiente laboral.

Crea librerías de ejemplos o soluciones

No es que tengas que desarrollar librerías nuevas, se trata más bien de esos ejemplos, como conectarte a bases de datos, nombres de drivers, herramientas, comandos, funciones o técnicas de desarrollo que quizá aplicarás en tus proyectos más de una vez. En cualquier momento puedes usar el buscador y encontrar prácticamente todo lo que necesites, pero tener cosas ya probadas previamente por tí, es muy útil.

Descansa lejos de la computadora

Esto debes hacerlo por puro amor propio y no sólo es descansar, ejercítate.  Algunos problemas de espalda y ojos derivados de pasar horas sentados frente a la computadora pueden agravarse y son difíciles de tratar.  Cuida tu cuerpo.


Linus Torvalds, la mente detrás de Linux: lo que contó en su charla TED

Linus Torvalds ha cambiado la informática dos veces: primero con el núcleo Linux, que hoy funciona en la mayoría de los servidores de Internet, en todos los móviles Android y en todos los superordenadores de la lista TOP500, y después con Git, el sistema de control de versiones que usa casi cualquier programador del mundo. En 2016 dio una de sus pocas entrevistas en público, en el escenario de TED, con Chris Anderson.

La charla está en inglés. Se pueden activar los subtítulos en español desde el menú del vídeo.

Dos proyectos que empezaron como un apaño

El 25 de agosto de 1991, Torvalds, entonces estudiante de 21 años en la Universidad de Helsinki, publicó un mensaje en el grupo de noticias de Minix en el que anunciaba que estaba escribiendo un sistema operativo gratuito: «solo un hobby, no será grande y profesional como GNU». Lo hacía para su propio PC, porque quería un Unix en casa y no podía pagarlo. Publicó el código, otros empezaron a mandarle mejoras y, en pocos años, aquel hobby se convirtió en el núcleo de sistemas operativos de todo el mundo. Hoy reciben contribuciones miles de desarrolladores de cientos de empresas, y Torvalds sigue siendo quien decide qué entra en cada versión.

Git nació igual, por necesidad. Hasta 2005, el desarrollo de Linux usaba BitKeeper, una herramienta comercial que su empresa dejaba usar gratis al proyecto. Cuando esa licencia se retiró, Torvalds no encontró ninguna alternativa que le sirviera y escribió la suya en unas pocas semanas. A los pocos meses le pasó el mantenimiento a Junio Hamano, que sigue dirigiéndolo. Si quieres aprender a usarlo, tenemos una guía de Git.

«No soy un visionario, soy un ingeniero»

Es la frase central de la charla. Torvalds explica que no trabaja pensando en grandes planes de futuro: le parece bien que haya gente que mira las estrellas y dice «quiero ir allí», pero él prefiere mirar al suelo, porque, en sus palabras, quiere «arreglar el bache que tengo justo delante antes de caerme en él». Linux no salió de una visión de cambiar el mundo, sino de resolver un problema concreto detrás de otro durante décadas.

También reconoce que no es una persona sociable. Dice, medio en broma, que no le gusta especialmente la gente, pero sí la que se implica en su proyecto, y que el código abierto permite justamente eso: que personas muy distintas trabajen juntas sin necesidad de llevarse bien. Admite, además, que a veces no tiene en cuenta cómo se sienten los demás. Su estilo directo, y a veces muy duro, en la lista de correo del núcleo fue polémico durante años, y en 2018 él mismo se tomó un descanso para cambiar su forma de tratar a los demás desarrolladores.

El «buen gusto» en el código

La parte más comentada de la charla, sobre todo entre programadores, es un ejemplo de código en C. Torvalds enseña dos formas de quitar un elemento de una lista enlazada y dice que la segunda tiene buen gusto. La primera es la que aparece en muchos libros: recorre la lista recordando el nodo anterior y, al final, necesita un if porque quitar el primer elemento es un caso especial. La segunda no recuerda el nodo anterior, sino la dirección del enlace que hay que cambiar, sea el puntero al inicio de la lista o el campo sig de otro nodo. Así, el primer elemento deja de ser especial y el if desaparece.

#include <stdio.h>

struct nodo {
    int valor;
    struct nodo *sig;
};

/* Versión habitual: el primer nodo es un caso especial. */
void quitar_v1(struct nodo **cabeza, struct nodo *objetivo) {
    struct nodo *prev = NULL, *act = *cabeza;
    while (act != objetivo) {
        prev = act;
        act = act->sig;
    }
    if (prev == NULL)
        *cabeza = act->sig;      /* era el primero */
    else
        prev->sig = act->sig;    /* estaba en medio o al final */
}

/* Versión «con buen gusto»: un puntero al enlace que hay que cambiar. */
void quitar_v2(struct nodo **cabeza, struct nodo *objetivo) {
    struct nodo **enlace = cabeza;
    while (*enlace != objetivo)
        enlace = &(*enlace)->sig;
    *enlace = objetivo->sig;     /* sin casos especiales */
}

static void imprimir(const char *t, struct nodo *n) {
    printf("%-24s", t);
    for (; n; n = n->sig) printf(" %d", n->valor);
    printf("\n");
}

int main(void) {
    for (int v = 1; v <= 2; v++) {
        struct nodo c = {3, NULL}, b = {2, &c}, a = {1, &b};
        struct nodo *lista = &a;
        void (*quitar)(struct nodo **, struct nodo *) = v == 1 ? quitar_v1 : quitar_v2;
        printf("-- versión %d\n", v);
        imprimir("lista:", lista);
        quitar(&lista, &a); imprimir("quitar el 1 (primero):", lista);
        quitar(&lista, &c); imprimir("quitar el 3 (final):", lista);
    }
    return 0;
}
gcc -std=c11 -Wall -Wextra -o lista lista.c && ./lista-- versión 1
lista:                   1 2 3
quitar el 1 (primero):   2 3
quitar el 3 (final):     2
-- versión 2
lista:                   1 2 3
quitar el 1 (primero):   2 3
quitar el 3 (final):     2

Las dos versiones dan el mismo resultado, pero la segunda tiene la mitad de líneas y ningún caso especial que probar por separado. Para Torvalds, el buen gusto consiste en «ver los patrones grandes» y saber casi por instinto cuál es la forma correcta de hacer las cosas: mirar el problema desde otro ángulo hasta que el caso especial deja de existir, en lugar de añadir más condiciones para cubrirlo. No es una cuestión de estética, sino de errores: cada if que desaparece es un camino menos donde puede haber un fallo.

El ejemplo, adaptado. En la charla Torvalds solo muestra las dos funciones en una diapositiva. Aquí están en un programa completo que se puede compilar, con nombres en español, y lo probamos con gcc 14.

Por qué sigue siendo relevante

Más de treinta años después de aquel mensaje, Linux sigue saliendo cada nueve o diez semanas con una versión nueva, y Torvalds sigue revisando lo que entra. Entretanto, el núcleo ha empezado a admitir código en Rust junto al C de siempre, y Git se ha convertido en la base de plataformas como GitHub o GitLab. Pocas personas han tenido tanta influencia en cómo se escribe y se comparte el software, y su receta, según él mismo, es poco espectacular: resolver bien el problema que tienes delante.

Fuente: «The mind behind Linux», Linus Torvalds en conversación con Chris Anderson, TED2016, y crónica de la charla en Linux.com. El ejemplo de la lista enlazada se compiló y ejecutó con gcc 14.2.

Pregunta Java: campos transient al serializar

Piensa la respuesta antes de abrirla. Todas las opciones parecen razonables, y casi siempre hay un detalle que lo cambia todo.

Pregunta Java · Serialización

¿Cuál es el resultado de compilar y ejecutar la clase Persona?

import java.io.*;
public class Persona implements Serializable {
    transient String nombre;
    transient int edad;
    String ocupacion;

    public Persona(String nombre, int edad, String ocupacion) {
        this.edad = edad;
        this.nombre = nombre;
        this.ocupacion = ocupacion;
    }
    public String toString() {
        return "Soy " + nombre + ", tengo " + edad + " años y soy " + ocupacion;
    }
    public static void main(String[] args) throws Exception {
        Persona antes = new Persona("Yo", 30, "programador");
        ObjectOutputStream out = new ObjectOutputStream(new FileOutputStream("/dir/ejemplo.txt"));
        out.writeObject(antes);

        ObjectInputStream input = new ObjectInputStream(new FileInputStream("/dir/ejemplo.txt"));
        Persona despues = (Persona) input.readObject();
        System.out.println(despues);
    }
}
  1. Soy Yo, tengo 30 años y soy programador
  2. Soy Yo, tengo 30 años y soy null
  3. Soy null, tengo 0 años y soy programador
  4. Error de ejecución
Ver la respuesta

Respuesta: c.

java PersonaSoy null, tengo 0 años y soy programador

transient marca un campo para que no se guarde al serializar. Al leer el objeto, esos campos reciben su valor por omisión: null para nombre y 0 para edad. Solo ocupacion viaja en el archivo. Tampoco se ejecuta el constructor de Persona, que podría haberles dado otro valor.

Se usa para lo que no tiene sentido o no debe guardarse: contraseñas, cachés, conexiones abiertas. El enunciado original pedía «la clase Test», pero el código solo tiene la clase Persona. Para ejecutarlo creamos antes la carpeta /dir.

Pregunta publicada en 2014 y revisada en octubre de 2026. La respuesta se comprobó compilando y ejecutando el código con Java 25 LTS en un contenedor limpio; las salidas están copiadas de esa ejecución.

No importa

Texto sobre fondo claro: «¡No me importa si funciona en tu máquina! ¡No vamos a enviar tu máquina!», cita atribuida a Vidiu Platon.
¡No importa si funciona en tu máquina! ¡No vamos a enviar tu máquina!

«En mi máquina funciona» es una de las excusas más famosas de la programación. Contenedores como Docker nacieron, en buena parte, para que el entorno del desarrollador y el del servidor sean el mismo y esta frase deje de tener sentido.