Python trae mucho de serie, pero buena parte de lo que se hace con él a diario se apoya en librerías externas. Estas son las que más se usan, agrupadas por tarea y cada una con un ejemplo corto que puedes copiar y ejecutar.
También te puede interesar
Cómo instalarlas
Lo recomendable es instalar cada proyecto en su propio entorno virtual, para que las versiones de un proyecto no choquen con las de otro:
python -m venv venv
source venv/bin/activate        # en Windows: venv\Scripts\activate
pip install requests tqdm pillow numpy pandas matplotlib beautifulsoup4 sqlalchemy fastapi httpx2 pytest
Ten en cuenta que el nombre del paquete no siempre coincide con el del import: se instala pillow y se importa PIL, se instala beautifulsoup4 y se importa bs4.
| Para… | Librería | Versión probada |
|---|---|---|
| Peticiones HTTP | requests | 2.34.2 |
| Barras de progreso | tqdm | 4.70.1 |
| Imágenes | Pillow | 12.3.0 |
| Cálculo numérico | NumPy | 2.5.3 |
| Tablas de datos | pandas | 3.0.6 |
| Gráficas | Matplotlib | 3.11.2 |
| Extraer datos de HTML | Beautiful Soup | 4.15.0 |
| Bases de datos | SQLAlchemy | 2.1.4 |
| APIs web | FastAPI | 0.143.0 |
| Pruebas | pytest | 9.1.1 |
requests: peticiones HTTP
import requests

r = requests.get("https://httpbin.org/get", params={"lenguaje": "python"}, timeout=10)
print(r.status_code, r.headers["Content-Type"])
print(r.json()["args"])

r = requests.post("https://httpbin.org/post", json={"sitio": "decodigo.com"}, timeout=10)
print(r.json()["json"])salida200 application/json
{'lenguaje': 'python'}
{'sitio': 'decodigo.com'}Con params se arma la cadena de consulta, con json= se envía un cuerpo JSON con su cabecera, y r.json() decodifica la respuesta. Pon siempre un timeout: sin él, una petición a un servidor que no responde puede quedarse esperando indefinidamente. Si solo necesitas algo puntual y no quieres dependencias, la biblioteca estándar también lo hace; lo vemos en peticiones HTTP sin dependencias.
tqdm: barras de progreso
from time import sleep
from tqdm import tqdm

total = 0
for n in tqdm(range(50), desc="Procesando", ncols=70):
    total += n
    sleep(0.02)
print("suma:", total)
salida, última línea de la barraProcesando: 100%|█████████████████████| 50/50 [00:01<00:00, 49.11it/s] suma: 1225
Basta con envolver el iterable en tqdm(). La barra se va redibujando en la misma línea y muestra el avance, la velocidad y el tiempo que falta. Es muy útil en procesos largos, porque deja ver enseguida si el trabajo avanza o se ha atascado.
Pillow: imágenes
from PIL import Image, ImageDraw

img = Image.new("RGB", (800, 400), "#1e64af")
ImageDraw.Draw(img).rectangle([40, 40, 760, 360], outline="white", width=8)
img.save("original.png")

copia = Image.open("original.png")
copia.thumbnail((200, 200))
copia.save("miniatura.png")
print(Image.open("original.png").size, "->", Image.open("miniatura.png").size)salida(800, 400) -> (200, 100)
thumbnail reduce la imagen para que quepa en la caja que le das (200×200), pero conserva la proporción: por eso queda en 200×100 y no se deforma. Pillow abre y guarda los formatos habituales (PNG, JPEG, WebP, GIF…) y sirve para recortar, rotar, dibujar o cambiar el formato por lotes.
NumPy y pandas: datos
import numpy as np
import pandas as pd

temps = np.array([18.5, 21.0, 24.3, 19.8, 22.1])
print("media:", temps.mean().round(2), "máxima:", temps.max())
print(temps * 9 / 5 + 32)

ventas = pd.DataFrame({
    "lenguaje": ["Python", "Java", "Python", "Go", "Java", "Python"],
    "visitas": [120, 80, 150, 40, 95, 130],
})
print(ventas.groupby("lenguaje")["visitas"].agg(["count", "sum", "mean"]).sort_values("sum", ascending=False))salidamedia: 21.14 máxima: 24.3
[65.3 69.8 75.74 67.64 71.78]
count sum mean
lenguaje
Python 3 400 133.333333
Java 2 175 87.500000
Go 1 40 40.000000NumPy opera sobre arreglos completos de una vez: temps * 9 / 5 + 32 convierte las cinco temperaturas sin escribir ningún bucle, y además mucho más rápido que un bucle en Python. pandas se apoya en NumPy para trabajar con tablas: aquí agrupa por lenguaje y calcula el número de filas, la suma y la media de cada grupo en una sola línea. Si trabajas con archivos muy grandes, merece la pena mirar también Polars, una alternativa más reciente y muy rápida.
Matplotlib: gráficas
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

lenguajes = ["Python", "Java", "Go", "Rust"]
visitas = [400, 175, 40, 65]

fig, ax = plt.subplots(figsize=(8, 4.2))
ax.bar(lenguajes, visitas, color="#1e64af")
ax.set_title("Visitas por lenguaje")
ax.set_ylabel("visitas")
fig.tight_layout()
fig.savefig("grafica.png", dpi=150)
print("guardada grafica.png")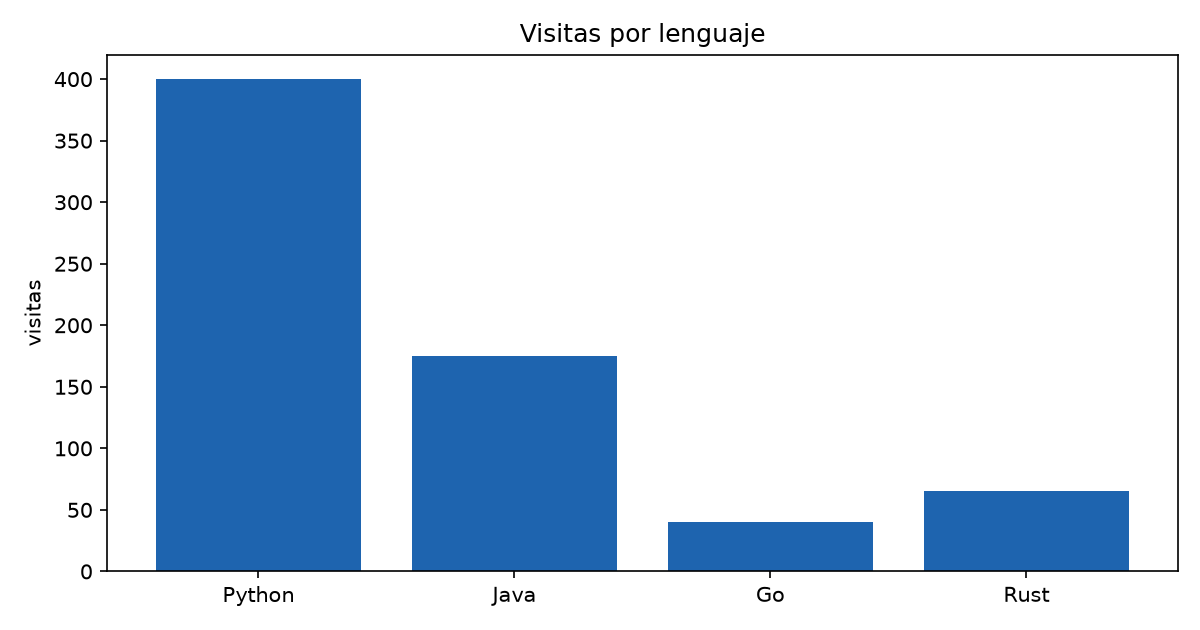
matplotlib.use("Agg") hace que dibuje directamente a un archivo, sin abrir ninguna ventana; así funciona también en un servidor o en un contenedor. En tu ordenador puedes quitarlo y llamar a plt.show() para ver la gráfica en pantalla.
Beautiful Soup: extraer datos de HTML
from bs4 import BeautifulSoup

html = """
<ul id="lenguajes">
  <li class="activo"><a href="/python">Python</a></li>
  <li><a href="/java">Java</a></li>
  <li class="activo"><a href="/rust">Rust</a></li>
</ul>
"""
soup = BeautifulSoup(html, "html.parser")
for a in soup.select("#lenguajes li.activo a"):
print(a.text, "->", a["href"])salidaPython -> /python Rust -> /rust
select acepta selectores CSS, los mismos que se usan en las hojas de estilo, así que #lenguajes li.activo a se lee igual que en CSS. Para descargar la página se combina con requests. Si lo que necesitas es recorrer un sitio entero siguiendo enlaces, la herramienta adecuada es Scrapy. Y antes de extraer datos de un sitio, revisa sus condiciones de uso y su robots.txt.
SQLAlchemy: bases de datos
from sqlalchemy import create_engine, select, String
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, Session

class Base(DeclarativeBase):
    pass

class Articulo(Base):
    __tablename__ = "articulos"
    id: Mapped[int] = mapped_column(primary_key=True)
    titulo: Mapped[str] = mapped_column(String(100))
    visitas: Mapped[int]

engine = create_engine("sqlite:///:memory:")
Base.metadata.create_all(engine)

with Session(engine) as s:
    s.add_all([Articulo(titulo="Hola mundo", visitas=10),
               Articulo(titulo="Leer CSV", visitas=42),
               Articulo(titulo="Peticiones HTTP", visitas=27)])
    s.commit()
    consulta = select(Articulo).where(Articulo.visitas > 20).order_by(Articulo.visitas.desc())
    for a in s.scalars(consulta):
print(a.titulo, a.visitas)salidaLeer CSV 42 Peticiones HTTP 27
Cada tabla se define como una clase, y las consultas se escriben en Python en lugar de en SQL. Es el estilo de SQLAlchemy 2, con anotaciones de tipo (Mapped[int]). El mismo código funciona con SQLite, PostgreSQL o MySQL cambiando solo la cadena de conexión. Para SQLite sin ninguna librería externa, mira SQLite con Python.
FastAPI: APIs web
from fastapi import FastAPI
from fastapi.testclient import TestClient
from pydantic import BaseModel

app = FastAPI()

class Articulo(BaseModel):
    titulo: str
    visitas: int = 0

@app.get("/saludo/{nombre}")
def saludo(nombre: str):
    return {"mensaje": f"Hola, {nombre}"}

@app.post("/articulos")
def crear(articulo: Articulo):
    return {"creado": articulo.titulo, "visitas": articulo.visitas}

cliente = TestClient(app)
print(cliente.get("/saludo/Ana").json())
print(cliente.post("/articulos", json={"titulo": "FastAPI"}).json())
r = cliente.post("/articulos", json={"visitas": "muchas"})
print(r.status_code, [e["loc"][-1] + ": " + e["type"] for e in r.json()["detail"]])salida{'mensaje': 'Hola, Ana'}
{'creado': 'FastAPI', 'visitas': 0}
422 ['titulo: missing', 'visitas: int_parsing']FastAPI usa las anotaciones de tipo para validar lo que llega: en la última petición falta el título y visitas no es un número, así que responde con un error 422 que explica cada fallo, sin que hayas escrito ninguna validación. Aquí se prueba con TestClient, que llama a la API sin levantar un servidor; en producción se ejecuta con uvicorn.
TestClient avisa de que usar httpx está obsoleto y pide instalar httpx2. Por eso aparece en el pip install de arriba; con él, el aviso desaparece y el ejemplo funciona igual.Si buscas un framework completo, con panel de administración, usuarios y plantillas incluidos, la referencia es Django. Para algo pequeño y sin estructura impuesta, Flask.
pytest: pruebas
import pytest

def precio_con_iva(precio, iva=0.16):
    if precio < 0:
        raise ValueError("el precio no puede ser negativo")
    return round(precio * (1 + iva), 2)

def test_iva_por_defecto():
    assert precio_con_iva(100) == 116.0

@pytest.mark.parametrize("precio, iva, esperado", [(50, 0.16, 58.0), (200, 0.08, 216.0), (0, 0.16, 0.0)])
def test_varios(precio, iva, esperado):
    assert precio_con_iva(precio, iva) == esperado

def test_negativo():
    with pytest.raises(ValueError):
        precio_con_iva(-1)
python -m pytest -v test_precios.py
salida (recortada)test_precios.py::test_iva_por_defecto PASSED                             [ 20%]
test_precios.py::test_varios[50-0.16-58.0] PASSED                        [ 40%]
test_precios.py::test_varios[200-0.08-216.0] PASSED                      [ 60%]
test_precios.py::test_varios[0-0.16-0.0] PASSED                          [ 80%]
test_precios.py::test_negativo PASSED                                    [100%]

============================== 5 passed in 0.04s ===============================
Las pruebas son funciones que empiezan por test_ y usan un assert normal. parametrize ejecuta la misma prueba con varios casos, y cada uno aparece por separado en el informe; pytest.raises comprueba que se lanza la excepción esperada.
Otras que conviene conocer
| Librería | Para qué |
|---|---|
| scikit-learn | Aprendizaje automático clásico: clasificación, regresión, agrupamiento |
| PyTorch | Redes neuronales y aprendizaje profundo |
| Keras | API de alto nivel para redes neuronales; desde Keras 3 funciona sobre JAX, TensorFlow o PyTorch |
| NLTK y spaCy | Procesamiento de lenguaje natural |
| Scapy | Crear, enviar y analizar paquetes de red; muy usada en seguridad |
| Kivy | Interfaces gráficas multiplataforma, también para móviles |
asyncio, que viene con Python, o librerías construidas sobre él.Entrada publicada en 2019 y revisada en octubre de 2026. Todo el código se ejecutó con Python 3.14.8 en un contenedor limpio, con las versiones de la tabla; las salidas están copiadas de esa ejecución.


