Lente gravitacional: cómo la gravedad dobla la luz y forma anillos de Einstein, con simulador

Anillo de Einstein azul alrededor de una galaxia anaranjada, calculado con la ecuación de la lente gravitacional

La gravedad no solo atrae planetas y manzanas: también dobla la luz. Cuando una galaxia enorme queda justo entre nosotros y otra mucho más lejana, hace de lupa: la de fondo se ve deformada, repetida o convertida en un anillo de luz, el anillo de Einstein. Es una lente gravitacional, y hoy es una de las herramientas favoritas de los astrónomos para pesar galaxias y cartografiar la materia oscura. Aquí te contamos cómo funciona y puedes formar tus propios anillos arrastrando una galaxia por detrás de otra.

De un eclipse a un espejismo cósmico

La idea de que la gravedad pueda desviar la luz es antigua: en 1801, el astrónomo alemán Johann Georg von Soldner calculó con la física de Newton cuánto se desviaría la luz de una estrella al pasar rozando el Sol. En 1915, la relatividad general de Albert Einstein dio una respuesta distinta: la masa curva el espacio y el tiempo, y la luz sigue esa curvatura, así que el desvío debía ser el doble, unos 1.75 segundos de arco.

Para comprobarlo hacía falta ver estrellas junto al Sol, y eso solo es posible durante un eclipse total. El 29 de mayo de 1919, dos expediciones británicas organizadas por el astrónomo real Frank Dyson lo fotografiaron desde la isla de Príncipe, frente a África, con Arthur Eddington, y desde Sobral, en Brasil. Los resultados, presentados el 6 de noviembre de 1919, le dieron la razón a Einstein y lo convirtieron en una celebridad mundial.

Que una estrella pudiera hacer de lente para otra lo describió Orest Chwolson en 1924, y Einstein lo calculó en 1936 en un artículo breve de la revista Science, animado por un ingeniero aficionado, Rudi Mandl, que fue a visitarlo para convencerlo. Einstein concluyó que no había esperanza de observarlo directamente con estrellas. Un año después, Fritz Zwicky propuso que las galaxias, mucho más masivas, sí serían lentes visibles. Tenía razón: en 1979, Dennis Walsh, Robert Carswell y Ray Weymann encontraron el cuásar doble Q0957+561, dos imágenes idénticas separadas por 6 segundos de arco que en realidad eran el mismo cuásar, desdoblado por una galaxia que tiene delante. En 1988 llegó el primer anillo, MG1131+0456, observado con radiotelescopios, y en 1998 el Hubble fotografió el primero completo.
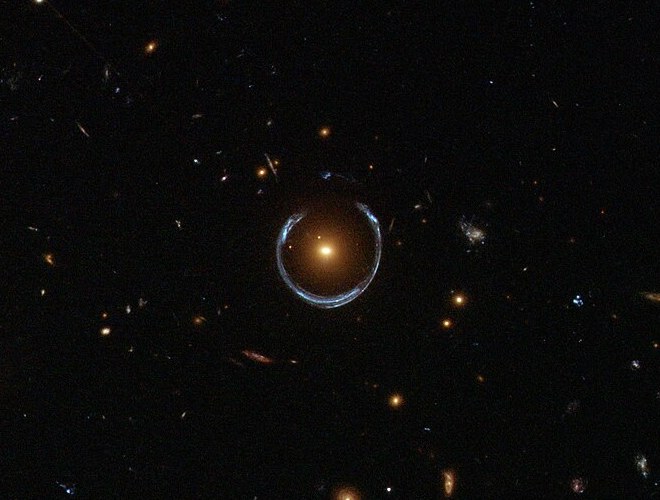
Galaxia roja con un anillo azul casi completo a su alrededor: la Herradura Cósmica fotografiada por el Hubble
La Herradura Cósmica: una galaxia roja muy masiva deforma la luz de una galaxia azul que está mucho más lejos, justo detrás, hasta convertirla en un anillo casi completo. Foto: ESA/Hubble y NASA, dominio público, recortada.

La ecuación de la lente

Todo se resume en una ecuación sorprendentemente corta. Llamemos θ (theta) a la dirección en la que vemos un punto de luz en el cielo y β (beta) a la dirección en la que está de verdad la galaxia de fondo. La lente desvía la luz un ángulo α (alfa), que depende de por dónde pase el rayo:

β = θ – α(θ)

Dicho con palabras: lo que vemos en la dirección θ viene en realidad de la dirección β. Si para una misma β hay varias θ que cumplen la ecuación, vemos la galaxia de fondo varias veces. Cuanto más cerca del centro de la lente pasa la luz, más se desvía, y por eso los rayos que pasan por encima y por debajo de la lente pueden acabar llegando al mismo sitio: a nosotros.

Dos caminos para la misma luzTierraGalaxia lenteGalaxiade fondoimagen aparenteimagen aparente
Vista de lado, muy exagerada. Cada rayo llega a la Tierra desde una dirección distinta, y en cada una vemos una copia de la galaxia de fondo. Esquema: decodigo.com.

Cada lente tiene un tamaño característico, el radio de Einstein: el radio del anillo que se forma cuando la fuente queda exactamente detrás. Crece con la masa de la lente y depende de las distancias entre nosotros, la lente y la fuente. En el simulador usamos tres modelos sencillos:

  • Estrella (masa puntual): toda la masa en un punto, como una estrella o un agujero negro. El desvío disminuye con la distancia al centro: α = θE² / θ.
  • Galaxia (esfera isoterma): la masa repartida como en una galaxia real, en la que las estrellas se mueven a la misma velocidad a cualquier distancia del centro. Aquí el desvío es el mismo en todas partes, α = θE, y solo cambia su dirección.
  • Galaxia achatada: la anterior más una pequeña deformación (en inglés, shear), que imita una galaxia ovalada o el tirón de otras galaxias cercanas. Es la que produce las cruces de cuatro imágenes.

Pruébalo

Arrastra con el ratón o con el dedo sobre el lienzo para mover la galaxia azul de fondo (la cruz blanca marca dónde está de verdad). Pulsa «Alinear» para ponerla justo detrás y ver el anillo, o «Pasar por detrás» para que cruce sola. Cambia la masa con el control del radio de Einstein, y activa «Curva crítica y cáustica» para ver las líneas que explican cuántas imágenes aparecen. En el modo «Débil», lo que arrastras es la masa.

Lente:
Masa:
  • curva crítica
  • cáustica (en el plano de la fuente)
  • + dónde está de verdad la fuente

Prueba esto: con la «Estrella», aparta la fuente un poco del centro y verás dos imágenes, una por fuera del anillo y otra más débil pegada a la lente. Con la «Galaxia achatada», activa la cáustica: es un pequeño rombo con puntas. Si llevas la cruz blanca dentro del rombo aparecen cuatro imágenes alrededor de la lente, como en la famosa cruz de Einstein, el cuásar Q2237+0305, descubierto en 1985 por John Huchra y su equipo; si la sacas, quedan dos. Y fíjate en el brillo total: con la fuente alineada, la lente la hace unas 24 veces más brillante. No crea luz: estira la imagen y la hace más grande, y por eso llega más luz en total.
Justo detrás: un anilloLa fuente, detrás de la lente, se ve como un anillolínea de puntos: radio de Einstein; círculo azul: dónde está de verdadUn poco al lado: dos imágenesUn arco por fuera y una imagen débil por dentrolínea de puntos: radio de Einstein; círculo azul: dónde está de verdad
Lo que ves en el simulador, de forma simplificada. Con una galaxia como lente, si la fuente se aparta del centro, el anillo se rompe en un arco grande por fuera y una imagen pequeña por dentro, al otro lado. Esquemas: decodigo.com.
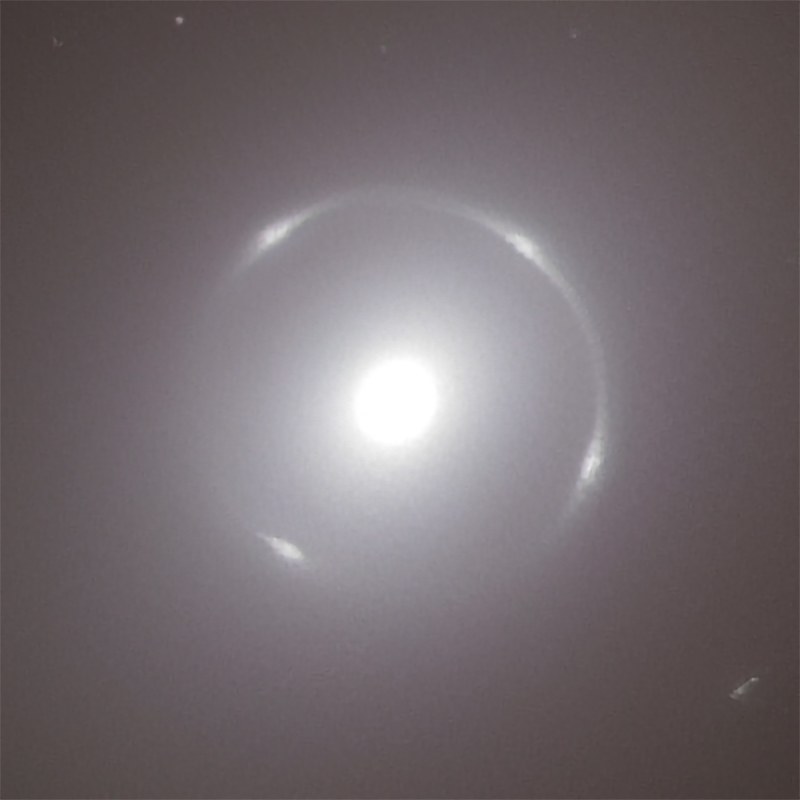
Galaxia brillante en el centro rodeada por un anillo de luz casi perfecto, fotografiada por el telescopio Euclid
Un anillo de Einstein casi perfecto alrededor de la galaxia NGC 6505, fotografiado por el telescopio espacial Euclid y presentado por la ESA en febrero de 2025. Foto: ESA/Euclid/Euclid Consortium/NASA, procesado de J.-C. Cuillandre, G. Anselmi y T. Li, CC BY-SA 3.0 IGO.

Cómo está hecho el simulador

La animación usa una técnica que se llama trazado de rayos hacia atrás (backward ray tracing). En vez de seguir la luz desde la galaxia de fondo, que se dispersa en todas direcciones, recorre los píxeles del lienzo: para cada píxel θ calcula con la ecuación de la lente de qué punto β viene su luz, y lo pinta con el brillo que tiene la galaxia de fondo en ese punto. Así salen solos los arcos, los anillos y las imágenes repetidas, sin programarlos uno por uno. Mientras arrastras, el cálculo se hace a la mitad de resolución para que vaya fluido, y al soltar se repinta completo.

La galaxia de fondo es un disco ovalado cuyo brillo cae de forma exponencial desde el centro, con dos nudos más brillantes, como las zonas donde nacen estrellas. Las líneas naranja y celeste se calculan aparte: la curva crítica son los puntos del cielo donde la lente amplificaría sin límite una fuente diminuta, y la cáustica es esa misma curva llevada al plano de la galaxia de fondo. Cada vez que la fuente cruza una cáustica, aparecen o desaparecen dos imágenes.

Para saber de qué tamaño son estos efectos en el cielo real, este programa en Python calcula el desvío de la luz al rozar el Sol, el anillo de una estrella que pasa por delante de otra en nuestra galaxia y el de una galaxia completa:

# Cuánto se desvía la luz y qué tamaño tiene el anillo de Einstein en tres casos reales.
import math

G = 6.674e-11          # constante de gravitación (m³ kg⁻¹ s⁻²)
c = 2.998e8            # velocidad de la luz (m/s)
M_SOL = 1.989e30       # masa del Sol (kg)
R_SOL = 6.957e8        # radio del Sol (m)
KPC = 3.086e19         # un kiloparsec (m), unos 3,260 años luz
ARCSEG = math.degrees(1) * 3600   # segundos de arco por radián

# 1. La luz de una estrella que roza el borde del Sol: α = 4GM / (c² b)
alfa = 4 * G * M_SOL / (c**2 * R_SOL)
print(f"Desvío al rozar el Sol: {alfa * ARCSEG:.2f} segundos de arco (Newton daba la mitad: {alfa * ARCSEG / 2:.2f})")

# 2. Una estrella de media masa solar a 4 kpc pasa por delante de otra a 8 kpc, en el centro de la Vía Láctea
#    (microlente, uno de los estudios del telescopio Roman): θE = √(4GM/c² · Dls / (Dl · Ds))
M, Dl, Ds = 0.5 * M_SOL, 4 * KPC, 8 * KPC
tE = math.sqrt(4 * G * M / c**2 * (Ds - Dl) / (Dl * Ds))
print(f"Anillo de una estrella (microlente): {tE * ARCSEG * 1000:.2f} milésimas de segundo de arco")

# 3. Una galaxia elíptica cuyas estrellas se mueven a 250 km/s, a mitad de camino de la fuente
#    (esfera isoterma): θE = 4π (σ/c)² · Dls/Ds
sigma, cociente = 250e3, 0.5
tE = 4 * math.pi * (sigma / c)**2 * cociente
print(f"Anillo de una galaxia: {tE * ARCSEG:.2f} segundos de arco de radio")
print(f"La Luna llena mide unos 1,800 segundos de arco: {1800 / (2 * tE * ARCSEG):,.0f} veces el diámetro del anillo")
salidaDesvío al rozar el Sol: 1.75 segundos de arco (Newton daba la mitad: 0.88)
Anillo de una estrella (microlente): 0.71 milésimas de segundo de arco
Anillo de una galaxia: 0.90 segundos de arco de radio
La Luna llena mide unos 1,800 segundos de arco: 999 veces el diámetro del anillo

Los anillos de galaxias miden alrededor de un segundo de arco, unas mil veces menos que la Luna llena: hace falta un telescopio espacial o una óptica muy buena para verlos. Los de estrellas son mil veces más pequeños todavía y no se ven como anillos, pero sí se nota que la estrella de fondo se vuelve más brillante durante unos días o semanas, mientras la otra pasa por delante. Eso es una microlente, y si la estrella que hace de lente tiene un planeta, el planeta deja su propia marca en la curva de brillo.

Hemos comprobado que el simulador hace bien las cuentas. Su núcleo, escrito en JavaScript, da exactamente las mismas imágenes, píxel a píxel, que una versión independiente en Python con NumPy en 60 escenas al azar con los tres modelos y los dos modos. Y con una fuente muy pequeña, la magnificación que mide coincide al 0.1 % con las fórmulas exactas de la masa puntual y de la esfera isoterma.

La lente débil y el telescopio Roman

Los anillos y los arcos son la lente fuerte, y son raros: hace falta una alineación casi perfecta. Mucho más común es la lente débil: toda la materia que hay entre nosotros y las galaxias lejanas, incluida la materia oscura que no emite luz, deforma un poquito su forma. Es una deformación del orden del 0.1 al 1 %, imposible de ver en una galaxia sola, porque cada una tiene su propia forma ovalada. Pero si se miden millones, las deformaciones se suman: las galaxias tienden a alinearse alrededor de las zonas con más masa, y de ahí se reconstruye un mapa de la materia oscura. Este efecto en todo el cielo, la cizalla cósmica (cosmic shear), lo detectaron por primera vez cuatro equipos independientes en el año 2000.

Lente débil (exagerada)Las galaxias de fondo se alinean alrededor de la masa
En la realidad, lejos de la masa la deformación es de un uno por ciento o menos; aquí está exagerada para que se vea. Esquema: decodigo.com.

Es justo lo que hará el telescopio espacial Nancy Grace Roman, que la NASA acaba de enfocar: su gran estudio del cielo medirá la posición, la forma y el tamaño de cientos de millones de galaxias débiles para ver cómo las deforma la masa que tienen delante, y con ello medir cómo ha crecido la estructura del universo y estudiar la energía oscura. Por eso importa tanto que su óptica salga más nítida de lo previsto: la señal está en deformaciones de un uno por ciento. Roman también buscará planetas con microlentes, vigilando millones de estrellas hacia el centro de nuestra galaxia.
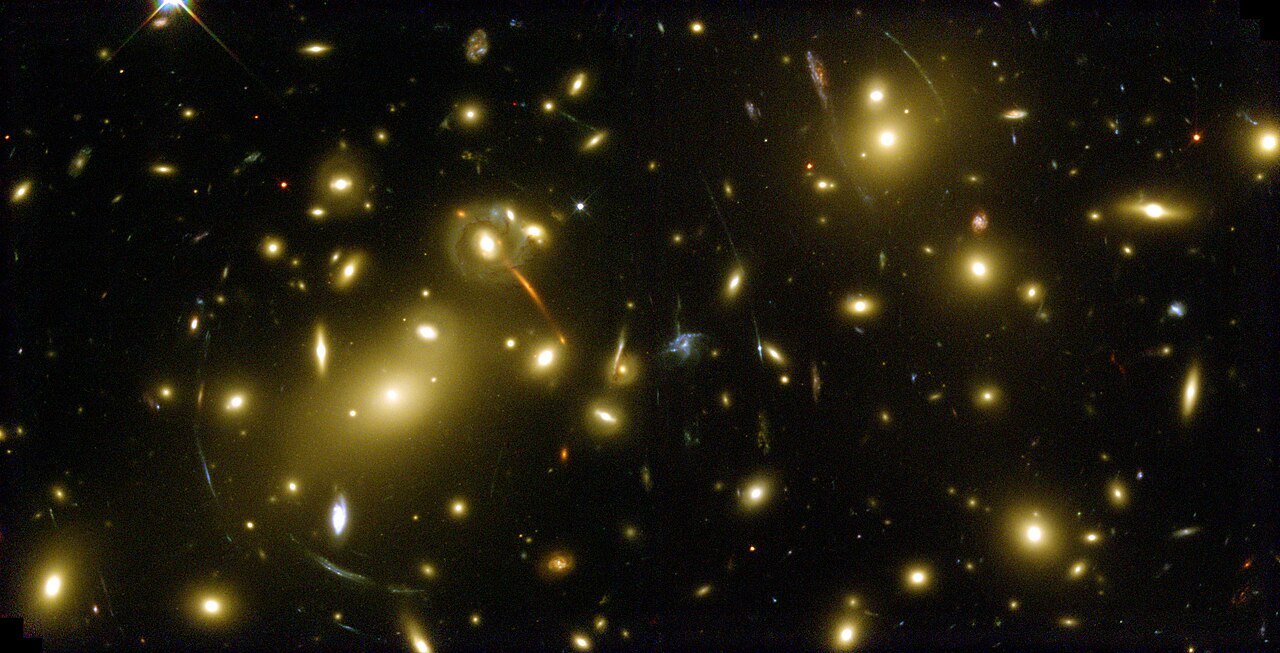
Cúmulo de galaxias amarillas con finos arcos de luz curvados a su alrededor, fotografiado por el Hubble
El cúmulo de galaxias Abell 2218 visto por el Hubble. Las galaxias amarillas pertenecen al cúmulo; los arcos finos que las rodean son galaxias mucho más lejanas, estiradas por su masa. Foto: NASA, ESA, A. Fruchter y el equipo ERO (STScI, ST-ECF), dominio público.

En el modo «Débil» del simulador puedes verlo: con poca masa, activa y desactiva «Ver sin la lente» y fíjate en las galaxias lejos del centro, que apenas cambian; súbela y, cerca del cúmulo, aparecen arcos como los de Abell 2218.

Si te gustan los fenómenos que se entienden mejor viéndolos, tenemos más simuladores: el motor de curvatura, que juega con el mismo espacio curvo de la relatividad, los epiciclos de Fourier, los boids y el algoritmo A*.

Fuentes: A. Einstein, «Lens-Like Action of a Star by the Deviation of Light in the Gravitational Field», Science 84, 506–507 (1936); F. Zwicky, «Nebulae as Gravitational Lenses», Physical Review 51, 290 (1937); D. Walsh, R. F. Carswell y R. J. Weymann, «0957 + 561 A, B: twin quasistellar objects or gravitational lens?», Nature 279, 381–384 (1979); Wikipedia en inglés: experimento de Eddington, anillo de Einstein y lente débil; NASA, el estudio de alta latitud de Roman; ESA, el anillo de NGC 6505. El programa se ejecutó con Python 3.13 y la comparación, con Node.js 22 y NumPy. El simulador, los esquemas y la portada: decodigo.com.
Microsoft y Linux: de llamarlo «cáncer» a construir su propia distribución, la historia de una reconciliación

Tux, el pingüino mascota de Linux

En 2001, el director general de Microsoft, Steve Ballmer, dijo que Linux era «un cáncer». Veinticinco años después, más de dos tercios de los procesadores que alquilan los clientes de Azure, la nube de Microsoft, ejecutan Linux. Windows trae un kernel Linux de verdad dentro, Microsoft es dueña de GitHub y mantiene su propia distribución, basada en Fedora. Pocas empresas han cambiado tanto de opinión sobre una tecnología. Esta es la historia de cómo pasó, y de los roces que todavía quedan.

De rivales a socios1998Documentos de HalloweenMicrosoft estudia cómo frenar el software libre2001«Linux es un cáncer»Steve Ballmer, en el Chicago Sun-Times2007Las «235 patentes»Microsoft dice que Linux las infringe2009Controladores de Hyper-Vunas 20,000 líneas para el kernel, en GPLv22014«Microsoft loves Linux»Nadella; .NET pasa a ser de código abierto2016WSL y la Linux FoundationBash en Windows; miembro Platinum2018GitHub y 60,000 patenteslas patentes, a la Open Invention Network2019WSL 2un kernel Linux de verdad dentro de Windows2025WSL, de código abiertoanunciado en Build el 19 de mayo2026Azure Linux 4.0y más de dos tercios de Azure con Linux
Los hitos de la relación entre Microsoft y Linux. En rojo, la etapa de enfrentamiento.

La guerra: 1998-2007

A finales de los noventa, Windows dominaba los PC y Windows NT intentaba quedarse con los servidores. Linux, un sistema gratuito y de código abierto, empezaba a colarse justo ahí. En agosto de 1998, el ingeniero de Microsoft Vinod Valloppillil escribió un memorándum interno que analizaba el software libre como amenaza y cómo frenarlo. Alguien se lo filtró a Eric S. Raymond, uno de los nombres del movimiento del código abierto, el 31 de octubre, y Raymond lo publicó como los documentos de Halloween. Microsoft confirmó que eran auténticos.

El tono público fue a peor. En febrero de 2001, el vicepresidente Jim Allchin llamó al código abierto «un destructor de la propiedad intelectual». En junio de ese año, Ballmer fue más lejos en una entrevista con el Chicago Sun-Times: «Linux es un cáncer que se adhiere, en el sentido de la propiedad intelectual, a todo lo que toca». Se refería a la licencia GPL, que obliga a publicar el código de los programas que se derivan de otro con esa licencia.

Después llegaron las patentes. En 2003, Microsoft compró una licencia de Unix a SCO, la empresa que en ese momento demandaba a IBM por, supuestamente, copiar código de Unix en Linux; la demanda acabó desestimada. En 2004 lanzó «Get the Facts», una campaña de anuncios que comparaba Windows con Linux. En noviembre de 2006 firmó un acuerdo con Novell que incluía la promesa de no demandar por patentes a los clientes de su distribución, SUSE. Y en mayo de 2007 dijo a la revista Fortune que el software libre infringía 235 de sus patentes, 42 de ellas en el kernel de Linux. Nunca dijo cuáles.

El deshielo: Hyper-V entra en el kernel

El primer cambio llegó por interés comercial. Microsoft quería que Linux funcionara bien dentro de Hyper-V, su sistema de máquinas virtuales, y para eso hacían falta controladores dentro del kernel. El 20 de julio de 2009, Greg Kroah-Hartman, uno de los responsables del kernel, anunció que Microsoft publicaba sus controladores de Hyper-V para Linux con licencia GPLv2: unas 20,000 líneas de código. Poco antes, un ingeniero de la empresa Vyatta había denunciado que uno de esos controladores mezclaba código GPL dentro de un programa cerrado. Microsoft negó que esa fuera la razón.

El comienzo no fue fácil. Kroah-Hartman llegó a amenazar con sacar el código por abandono, y Microsoft tuvo que ponerse a mantenerlo en serio. En julio de 2011, en Linux 3.0, Microsoft fue la empresa que más cambios aportó al kernel, casi todos de limpieza de esos controladores. Al año siguiente se resolvió otro problema: con el arranque seguro de UEFI que exigía Windows 8, las distribuciones no podían arrancar sin una firma reconocida, y Microsoft aceptó firmar el pequeño cargador, llamado shim, que usan hasta hoy para arrancar con Secure Boot.

El giro de Nadella: 2014-2018

Satya Nadella llegó a la dirección de Microsoft en febrero de 2014 con la nube como prioridad, y en la nube los clientes querían Linux. El 20 de octubre de ese año presentó las novedades de Azure delante de una diapositiva que decía «Microsoft ♥ Linux». Entonces, cerca del 20 % de las máquinas virtuales de Azure ya eran Linux. Lo que siguió fue una cadena de decisiones que la Microsoft de 2001 no habría tomado:

  • .NET, abierto y multiplataforma (noviembre de 2014): la base de C# pasó a tener licencia MIT y a funcionar en Linux y macOS.
  • SQL Server en Linux (anunciado en marzo de 2016, disponible en octubre de 2017), su base de datos estrella.
  • PowerShell, abierto y en Linux (agosto de 2016).
  • Miembro Platinum de la Linux Foundation (noviembre de 2016), el nivel más alto de la organización que paga a Linus Torvalds. Ese mismo año, Ballmer, ya retirado, dijo que la amenaza de Linux había quedado «en el retrovisor».
  • Un kernel Linux propio (abril de 2018) para Azure Sphere, su plataforma para dispositivos conectados.
  • La compra de GitHub (anunciada en junio de 2018, por $7,500 millones de USD), donde vive buena parte del código abierto del mundo.
  • Más de 60,000 patentes aportadas a la Open Invention Network (octubre de 2018), un fondo de patentes que se compromete a no usar contra Linux. Era lo opuesto a las 235 patentes de 2007.

En 2020, el presidente de Microsoft, Brad Smith, lo resumió así: «Microsoft estuvo en el lado equivocado de la historia cuando el código abierto explotó a principios de siglo, y lo puedo decir de mí mismo».

Linux dentro de Windows

El cambio más visible para los programadores fue WSL, el subsistema de Windows para Linux. En Build 2016, Microsoft enseñó Bash, la consola de órdenes de Linux, ejecutándose con Ubuntu dentro de Windows 10. «Esto no es una máquina virtual», insistió Kevin Gallo en el escenario. La primera versión traducía las llamadas de Linux al sistema de Windows, y ahí estaba su límite: algunos programas no funcionaban.

En 2019, WSL 2 cambió el enfoque: un kernel Linux de verdad, compilado por Microsoft, dentro de una máquina virtual ligera que arranca en segundos. Desde entonces Windows trae un kernel Linux. En 2021 llegó WSLg, que deja abrir aplicaciones gráficas de Linux en el escritorio de Windows. El 19 de mayo de 2025, Microsoft liberó el código de WSL, salvo unas pocas piezas del sistema. Y el 29 de septiembre de 2026 hizo estables los contenedores de WSL, que ejecutan contenedores de Linux sin instalar un motor aparte.

Para entonces, la nube ya había decidido la cuestión. En 2019, el ingeniero de Microsoft Sasha Levin escribió que el uso de Linux en Azure había superado al de Windows. En mayo de 2026, Brendan Burns, vicepresidente de Azure, dio la cifra actual: más de dos tercios de los procesadores de los clientes de Azure ejecutan Linux. Microsoft tiene además su propia distribución, Azure Linux, que nació como herramienta interna con el nombre de CBL-Mariner. Su versión 4.0, anunciada en mayo, se basa en Fedora.

Los roces que quedan

  • El arranque dual roto de 2024. Una actualización de seguridad de Windows de agosto de 2024 bloqueó cargadores de Linux vulnerables y dejó sin arrancar Ubuntu, Linux Mint y otras en equipos con los dos sistemas, con el mensaje «SBAT self-check failed». Microsoft dijo que no se aplicaría si detectaba Linux; la detección falló, y la corrección completa tardó hasta mayo de 2025.
  • Las llaves de Secure Boot. Linux sigue dependiendo de la firma de Microsoft para arrancar con Secure Boot. Los certificados de 2011 que firman el shim caducaron en junio de 2026. Los equipos siguen arrancando, porque el firmware no comprueba esa fecha, pero las distribuciones han tenido que pasarse a las llaves de 2023.
  • DirectX en WSL. Microsoft propuso en 2020 un controlador para usar la tarjeta gráfica desde WSL, pero los responsables de gráficos del kernel lo rechazaron porque solo sirve para conectar con bibliotecas cerradas. Sigue fuera del kernel oficial.
  • Lo que no se porta. Teams tuvo un cliente para Linux entre 2019 y 2022, y se retiró a favor de la versión web. Office sigue sin versión para Linux.

Microsoft no se ha convertido en una empresa de software libre. Windows y Office siguen cerrados, y su aportación al kernel, importante en Hyper-V, la deja hoy en torno al puesto 20 entre las empresas que más contribuyen, según el recuento de LWN. Lo que cambió fue el negocio: cuando el dinero pasó de vender licencias de Windows a alquilar servidores en la nube, Linux dejó de ser el rival y se convirtió en lo que la mayoría de los clientes de Microsoft quiere ejecutar. Para quien programa, el resultado es práctico: hoy se puede trabajar con herramientas de Linux en Windows, con C# en Linux y con el código en GitHub sin elegir bando. Si estás empezando, nuestra guía de SSH y sus comandos y la de redes básicas te sirven en los dos sistemas.

Más fuentes: The Register, Ballmer y el «cáncer» (2001); Microsoft, acuerdo con Novell (2006); The Register, «Microsoft ♥ Linux» (2014); Linux Foundation, Microsoft miembro Platinum (2016); Microsoft, la compra de GitHub (2018); The Register, Brad Smith (2020); BleepingComputer, el fallo de SBAT; Microsoft, caducidad de los certificados de Secure Boot; versiones de WSL en GitHub. Tux: Larry Ewing y The GIMP.

De la neurona al perceptrón: cómo nació la idea de copiar el cerebro para crear redes neuronales, con animación

Red neuronal sobre fondo oscuro con neuronas iluminadas en azul y rojo según su activación, junto al título De la neurona al perceptrón

ChatGPT, Claude o el reconocimiento de caras del móvil funcionan con redes neuronales artificiales: millones de piezas diminutas que copian, de forma muy simplificada, lo que hace una neurona del cerebro. La idea tiene más de ochenta años, y nació de una pregunta muy concreta: si una neurona solo se enciende o se apaga, ¿puede una red de neuronas razonar como una calculadora? Te contamos cómo surgió, cómo funciona una neurona artificial y, con dos animaciones, cómo una red aprende sola.

Primero hubo que ver la neurona

A finales del siglo XIX no estaba claro que el cerebro estuviera hecho de células separadas. Muchos científicos, entre ellos el italiano Camillo Golgi, creían que era una red continua, como una malla de tuberías. Fue el español Santiago Ramón y Cajal quien, a partir de 1888, tiñó y dibujó miles de neuronas y demostró que cada una es una célula independiente, con una dirección clara: las señales entran por las dendritas, se reúnen en el cuerpo celular y salen por el axón hacia otras neuronas, a las que se conecta en las sinapsis. Golgi y Cajal compartieron el Nobel de Medicina de 1906, todavía sin ponerse de acuerdo.

Durante las décadas siguientes se vio además que una neurona funciona casi como un interruptor: va acumulando las señales que le llegan y, si pasan de cierto umbral, dispara un impulso eléctrico. Si no, se queda en silencio. No hay término medio: es todo o nada.

1943: una neurona hecha de lógica

Ese «todo o nada» llamó la atención de dos personajes muy distintos. Warren McCulloch era un neurofisiólogo de Chicago que llevaba años pensando cómo podía el cerebro producir pensamiento. Walter Pitts era un joven autodidacta, sin título universitario, que de adolescente había leído los Principia Mathematica de Bertrand Russell y le había escrito para señalarle errores; vivía prácticamente sin casa cerca de la Universidad de Chicago cuando McCulloch lo acogió.

En 1943 publicaron juntos «A Logical Calculus of the Ideas Immanent in Nervous Activity». Su modelo de neurona era mínimo: unas entradas que valen 0 o 1, una suma y un umbral. Si la suma lo alcanza, la salida es 1; si no, 0. Con eso demostraron algo sorprendente: combinando neuronas así se puede construir cualquier operación lógica, como Y, O o NO, y, por tanto, en principio, cualquier cálculo. El cerebro podía verse como una máquina de calcular. John von Neumann citó el artículo poco después al describir la arquitectura de los primeros ordenadores.

Faltaba algo esencial: en la neurona de McCulloch y Pitts, los pesos y el umbral los ponía una persona a mano. La neurona no aprendía. En 1949, el psicólogo canadiense Donald Hebb propuso cómo podría hacerlo el cerebro: cuando una neurona ayuda repetidamente a que otra se dispare, la conexión entre las dos se refuerza. Es la idea que hoy se resume en «las neuronas que se disparan juntas se conectan», y la base de todo lo que vino después: aprender es ajustar la fuerza de las conexiones.

La neurona y su copiaNeurona biológicadendritas: reciben señalescuerpo celular: las sumaaxón: lleva el impulsosinapsisNeurona artificialx1w1x2w2x3w3Σyentradas × pesossumaumbralsalidaSi la suma pasa del umbral, la neurona «dispara» un 1.
Cada pieza de la neurona artificial copia una de la biológica: las dendritas son las entradas, la fuerza de cada sinapsis es un peso, el cuerpo celular es la suma y el disparo del axón es la salida. Esquema: decodigo.com.

Pruébalo: una neurona que aprende

Esta es una neurona artificial con dos entradas. Haz clic en las entradas para encenderlas y apagarlas, y mueve los pesos (w₁ y w₂) y el umbral (b): la neurona suma cada entrada multiplicada por su peso, más el umbral, y dispara si el resultado es mayor que cero. Los pulsos azules son señales que empujan a disparar; los rojos, señales que frenan. A la derecha verás lo que «ve» la neurona: los cuatro casos posibles como puntos en un plano y la recta que separa los que dan 1 de los que dan 0.

Objetivo:

    Objetivo: Y (AND). Mueve los pesos y el umbral hasta que los cuatro casos salgan bien, o pulsa «Aprender los pesos».

    Con «Aprender los pesos», la neurona empieza con todo a cero y aplica la regla del perceptrón: prueba cada caso y, si se queda corta, sube los pesos de las entradas que estaban encendidas; si se pasa, los baja. Con la Y y la O encuentra la solución en unas pocas vueltas. Con el XOR, que da 1 solo cuando las dos entradas son distintas, no lo consigue nunca, y la explicación está en el plano: no hay ninguna recta que deje los dos puntos azules a un lado y los dos rojos al otro.

    1958: el perceptrón, la máquina que «iba a pensar»

    Esa regla la inventó Frank Rosenblatt, un psicólogo del Laboratorio Aeronáutico de Cornell, que en 1958 juntó las dos ideas: la neurona de McCulloch y Pitts y el aprendizaje de Hebb. Lo llamó perceptrón, y no se quedó en el papel. Con dinero de la Oficina de Investigación Naval de Estados Unidos construyó el Mark I Perceptron, una máquina con una «retina» de 400 fotocélulas en una cuadrícula de 20 por 20, cuyos pesos eran potenciómetros que unos motores eléctricos giraban para ajustarlos. Le enseñaban tarjetas con formas y, tras unos cuantos intentos, aprendía a distinguirlas.

    La presentación, en julio de 1958, desató la primera fiebre de la IA. Según la crónica del New York Times, la Marina esperaba que fuera el embrión de un ordenador capaz de andar, hablar, ver, escribir, reproducirse y ser consciente de su propia existencia. Nada de eso estaba cerca.

    El invierno y el deshielo

    En 1969, Marvin Minsky y Seymour Papert, del MIT, publicaron el libro Perceptrons, donde demostraban matemáticamente lo que acabas de ver en la animación: un perceptrón de una sola capa no puede aprender cosas tan simples como el XOR. Sabían que una red con más capas sí podría, pero nadie sabía cómo entrenarla. El libro, junto con las promesas incumplidas, contribuyó a que la financiación de las redes neuronales se secara durante más de una década. Es el primer «invierno de la IA».

    La salida llegó con la retropropagación (backpropagation). La idea es repartir la culpa del error hacia atrás: se mira cuánto se equivocó la salida y se calcula cuánto contribuyó cada peso de cada capa, para corregirlos todos un poco. Paul Werbos la había descrito en su tesis de 1974, pero fue el artículo de David Rumelhart, Geoffrey Hinton y Ronald Williams en Nature, en 1986, el que la popularizó. Con ella, las redes podían tener capas ocultas entre la entrada y la salida, y esas capas aprenden por su cuenta a detectar rasgos intermedios. El XOR dejó de ser un problema.

    Pruébalo: una red que aprende a separar

    Aquí tienes una red pequeña, de las que se entrenan con retropropagación. Recibe dos números, la posición de un punto en el mapa de la izquierda, y tiene que decir si es azul o rojo. Pulsa «Entrenar» y mira cómo el fondo del mapa, que muestra lo que la red responde en cada zona, se va ajustando a los puntos. A la derecha, la red por dentro: cada neurona se ilumina según su activación para el punto marcado con el círculo, y los pulsos de luz recorren las conexiones con la fuerza de cada señal, en azul si suman y en rojo si restan. Pasa el ratón o el dedo por el mapa para ver qué neuronas se encienden en cada zona.

    Datos:
    Capas ocultas:

    Prueba a quitar las capas ocultas: con «Ninguna», la red es un perceptrón y solo sabe dibujar una recta, así que no pasa de acertar poco más de la mitad de los puntos en ninguno de los tres conjuntos. Con una capa oculta resuelve el XOR y el círculo en un par de segundos, pero la espiral se le resiste. Con dos capas, también la espiral. Cada capa combina lo que encontró la anterior, y eso le permite trazar fronteras cada vez más retorcidas: es la idea del aprendizaje profundo.

    Este programa en Python hace lo mismo que las dos animaciones en pequeño, sin ninguna biblioteca: primero la neurona sola con la regla del perceptrón, que aprende la Y y la O pero no el XOR, y después una red con una capa oculta de solo dos neuronas, entrenada con retropropagación, que sí lo resuelve:

    # Una neurona artificial que aprende con la regla del perceptrón (Rosenblatt, 1958),
    # y una red con una capa oculta que resuelve el XOR con retropropagación (1986).
    import math
    import random
    
    TABLAS = {
        "Y":   [((0, 0), 0), ((0, 1), 0), ((1, 0), 0), ((1, 1), 1)],
        "O":   [((0, 0), 0), ((0, 1), 1), ((1, 0), 1), ((1, 1), 1)],
        "XOR": [((0, 0), 0), ((0, 1), 1), ((1, 0), 1), ((1, 1), 0)],
    }
    
    
    def neurona(x, w, b):
        """Dispara (1) si la suma ponderada supera el umbral, como la de McCulloch y Pitts."""
        return 1 if w[0] * x[0] + w[1] * x[1] + b > 0 else 0
    
    
    def perceptron(tabla, max_epocas):
        w, b = [0, 0], 0
        for epoca in range(1, max_epocas + 1):
            errores = 0
            for x, objetivo in tabla:
                error = objetivo - neurona(x, w, b)
                if error:
                    errores += 1
                    w = [w[0] + error * x[0], w[1] + error * x[1]]
                    b += error
            if errores == 0:
                return w, b, epoca, True
        return w, b, max_epocas, False
    
    
    for nombre, tabla in TABLAS.items():
        w, b, epocas, converge = perceptron(tabla, 6 if nombre == "XOR" else 20)
        salidas = [neurona(x, w, b) for x, _ in tabla]
        estado = f"aprendido en {epocas} épocas" if converge else f"sin solución tras {epocas} épocas"
        print(f"{nombre:3}  w = {w}, b = {b:2}  salidas {salidas}  ({estado})")
    
    
    # Red 2-2-1 con sigmoides: la capa oculta resuelve lo que una neurona sola no puede.
    def sig(z):
        return 1 / (1 + math.exp(-z))
    
    
    random.seed(1)   # con la semilla 3 se queda atascada en un mínimo local
    W1 = [[random.uniform(-1, 1) for _ in range(2)] for _ in range(2)]
    b1 = [0.0, 0.0]
    W2 = [random.uniform(-1, 1) for _ in range(2)]
    b2 = 0.0
    tasa = 0.5
    for epoca in range(20000):
        for x, t in TABLAS["XOR"]:
            h = [sig(W1[j][0] * x[0] + W1[j][1] * x[1] + b1[j]) for j in range(2)]
            y = sig(W2[0] * h[0] + W2[1] * h[1] + b2)
            dy = (y - t) * y * (1 - y)                      # error de la salida
            dh = [dy * W2[j] * h[j] * (1 - h[j]) for j in range(2)]   # repartido hacia atrás
            for j in range(2):
                W2[j] -= tasa * dy * h[j]
                W1[j][0] -= tasa * dh[j] * x[0]
                W1[j][1] -= tasa * dh[j] * x[1]
                b1[j] -= tasa * dh[j]
            b2 -= tasa * dy
    
    print("\nRed con una capa oculta de 2 neuronas, tras 20,000 épocas:")
    for x, t in TABLAS["XOR"]:
        h = [sig(W1[j][0] * x[0] + W1[j][1] * x[1] + b1[j]) for j in range(2)]
        y = sig(W2[0] * h[0] + W2[1] * h[1] + b2)
        print(f"XOR{x} = {y:.3f}  (debe dar {t})")
    salidaY    w = [2, 1], b = -2  salidas [0, 0, 0, 1]  (aprendido en 6 épocas)
    O    w = [1, 1], b =  0  salidas [0, 1, 1, 1]  (aprendido en 4 épocas)
    XOR  w = [-1, 0], b =  1  salidas [1, 1, 0, 0]  (sin solución tras 6 épocas)
    
    Red con una capa oculta de 2 neuronas, tras 20,000 épocas:
    XOR(0, 0) = 0.013  (debe dar 0)
    XOR(0, 1) = 0.989  (debe dar 1)
    XOR(1, 0) = 0.989  (debe dar 1)
    XOR(1, 1) = 0.011  (debe dar 0)

    La neurona sola da exactamente los mismos pesos que la animación de arriba; lo comprobamos ejecutando las dos. Y un detalle honesto: con otros pesos iniciales al azar (por ejemplo, la semilla 3), esa red tan pequeña se queda atascada y no resuelve el XOR. Es uno de los problemas reales del entrenamiento, y una de las razones por las que las redes actuales tienen muchas más neuronas de las que en teoría necesitarían.

    De 400 fotocélulas a cientos de miles de millones de pesos

    Durante los noventa y los dos mil, las redes neuronales siguieron siendo una opción más entre muchas. Yann LeCun las usó para leer códigos postales escritos a mano, pero eran lentas de entrenar y necesitaban muchos datos. Las dos cosas cambiaron a la vez: internet trajo los datos y las tarjetas gráficas, las GPU, diseñadas para videojuegos, resultaron perfectas para hacer millones de multiplicaciones en paralelo. En 2012, AlexNet, una red profunda de Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton entrenada con dos GPU, arrasó en el concurso de reconocimiento de imágenes ImageNet. Desde entonces, casi toda la IA es aprendizaje profundo, y en 2024 John Hopfield y Geoffrey Hinton recibieron el Nobel de Física por sus trabajos fundacionales sobre redes neuronales.

    De la neurona a la IA actual1888Ramón y Cajallas neuronas son células separadas1943McCulloch y Pittsla primera neurona matemática1949Donald Hebbaprender es reforzar conexiones1958Rosenblattel perceptrón aprende solo1969Minsky y Papertlímites del perceptrón: llega el invierno1986Rumelhart, Hinton y Williamsretropropagación: redes con capas2012AlexNetredes profundas con GPU ganan ImageNet2024Hopfield y HintonNobel de Física por las redes neuronales
    Las fechas clave, de la neurona de Cajal a la IA actual. El hito en gris marca el comienzo del primer invierno de la IA. Esquema: decodigo.com.

    Los grandes modelos de lenguaje de hoy siguen hechos de la misma pieza: entradas multiplicadas por pesos, una suma y una función de activación, aunque ya no es el escalón de todo o nada sino curvas suaves, que permiten calcular hacia dónde ajustar cada peso. La diferencia es la escala: en lugar de dos pesos, cientos de miles de millones, organizados en capas y en arquitecturas como los transformers, entrenados con buena parte del texto de internet.

    Una copia muy tosca del original

    Conviene no tomarse el nombre demasiado al pie de la letra. El cerebro humano tiene unos 86,000 millones de neuronas, y cada una es mucho más compleja que una suma y un umbral: sus dendritas hacen cálculos propios, las señales llevan información en su ritmo y no solo en su intensidad, y las conexiones cambian con la química del cerebro. En 2021, un equipo de la Universidad Hebrea de Jerusalén intentó imitar con una red artificial lo que hace una sola neurona de la corteza cerebral, y necesitó una red profunda de entre cinco y ocho capas.

    Además, el cerebro no aprende con retropropagación, o al menos nadie ha encontrado cómo podría hacerlo, y consume unos 20 vatios, menos que una bombilla, mientras que entrenar un modelo grande requiere centros de datos enteros. La neurona artificial fue una inspiración, no una copia: tomó del cerebro una sola idea, que muchas piezas simples, conectadas con fuerzas ajustables, pueden aprender casi cualquier cosa. Ochenta años después, esa idea sigue dando de sí.

    Si te gustan los algoritmos que se entienden mejor viéndolos, tenemos más con animación: el código Huffman, los boids, el juego del caos y los epiciclos de Fourier. Y si te interesa hacia dónde va la IA, lee qué es la inteligencia artificial general y la carrera por los chips que la mueven.

    Fuentes: W. S. McCulloch y W. Pitts, «A Logical Calculus of the Ideas Immanent in Nervous Activity», Bulletin of Mathematical Biophysics 5, 115–133 (1943); F. Rosenblatt, «The perceptron: A probabilistic model for information storage and organization in the brain», Psychological Review 65(6), 386–408 (1958); el Mark I Perceptron y la crónica del New York Times, en Wikipedia; la vida de Walter Pitts, en Wikipedia; D. E. Rumelhart, G. E. Hinton y R. J. Williams, «Learning representations by back-propagating errors», Nature 323, 533–536 (1986); D. Beniaguev, I. Segev y M. London, «Single cortical neurons as deep artificial neural networks», Neuron 109(17), 2727–2739 (2021); Nobel de Medicina de 1906 y Nobel de Física de 2024. El programa se ejecutó con Python 3.13 y la comparación, con Node.js 24. Las animaciones, los esquemas y la portada: decodigo.com.
    Java 8 frente a Java 21: las diferencias que importan, con código

    Logotipo de Java junto al texto Java 8 hacia 21, sobre fondo azul

    Java 8 salió en marzo de 2014 y Java 21 en septiembre de 2023. Entre una y otra hay nueve años y trece versiones, y en ese tiempo Java cambió más que en toda la década anterior: llegaron var, los records, los bloques de texto, el switch con patrones y los hilos virtuales, y se fueron partes enteras de la plataforma. Muchas empresas siguen en Java 8, así que la pregunta es práctica: qué ganas al pasar a 21 y qué se rompe por el camino. Cada ejemplo de este artículo se compiló y se ejecutó en los dos JDK.

    Las dos son versiones LTS (de soporte largo). Desde 2017, Java publica una versión cada seis meses y, desde la 17, marca como LTS una de cada cuatro, es decir, una cada dos años. Por eso la mayoría de proyectos saltan de una LTS a otra: de 8 a 11, a 17, a 21 y, hoy, a 25, la LTS más reciente, de septiembre de 2025. Todo lo que cuenta este artículo sigue valiendo en Java 25.

    Línea de tiempo vertical de Java 8, de 2014, a Java 21, de 2023, con una tarjeta por versión. Java 8 (LTS): lambdas, streams, java.time. Java 9: módulos, List.of, JShell. Java 10: var. Java 11 (LTS): HttpClient, java Hola.java, sin Java EE. Java 14: switch con ->, NPE detallada. Java 15: bloques de texto """, sin Nashorn. Java 16: record, instanceof con patrón, toList(). Java 17 (LTS): sealed, encapsulación fuerte. Java 18: UTF-8 por omisión. Java 21 (LTS): hilos virtuales, patrones en switch, getFirst().De Java 8 a Java 21, versión a versiónlenguajebibliotecasplataformase eliminó8Java 8marzo de 2014LTSlambdasstreamsjava.time9Java 9septiembre de 2017módulosList.ofJShell10Java 10marzo de 2018var11Java 11septiembre de 2018LTSHttpClientjava Hola.javasin Java EE14Java 14marzo de 2020switch con ->NPE detallada15Java 15septiembre de 2020bloques de texto """sin Nashorn16Java 16marzo de 2021recordinstanceof con patróntoList()17Java 17septiembre de 2021LTSsealedencapsulación fuerte18Java 18marzo de 2022UTF-8 por omisión21Java 21septiembre de 2023LTShilos virtualespatrones en switchgetFirst()
    Las novedades de este artículo, en la versión en que llegaron como definitivas. Esquema: decodigo.com.

    Menos código para lo mismo

    Colecciones: var, List.of, toList y las secuenciadas

    En Java 8, crear una lista que no se pueda modificar y quedarse con su primer y último elemento cuesta bastante ceremonia:

    import java.util.*;
    import java.util.stream.*;
    
    public class Main {
        public static void main(String[] args) {
            List<String> lenguajes = Collections.unmodifiableList(
                Arrays.asList("Java", "Kotlin", "Scala", "Groovy"));
            Map<String, Integer> anios = new HashMap<>();
            anios.put("Java", 1995);
            anios.put("Kotlin", 2011);
    
            List<String> cortos = lenguajes.stream()
                .filter(l -> l.length() <= 5)
                .collect(Collectors.toList());
    
            System.out.println(cortos);
            System.out.println(lenguajes.get(0) + " ... " + lenguajes.get(lenguajes.size() - 1));
            System.out.println(anios.get("Kotlin"));
        }
    }
    java 8[Java, Scala]
    Java ... Groovy
    2011

    En Java 21, lo mismo:

    import java.util.*;
    
    public class Main {
        public static void main(String[] args) {
            var lenguajes = List.of("Java", "Kotlin", "Scala", "Groovy");
            var anios = Map.of("Java", 1995, "Kotlin", 2011);
    
            var cortos = lenguajes.stream()
                .filter(l -> l.length() <= 5)
                .toList();
    
            System.out.println(cortos);
            System.out.println(lenguajes.getFirst() + " ... " + lenguajes.getLast());
            System.out.println(lenguajes.reversed());
            System.out.println(anios.get("Kotlin"));
        }
    }
    java 21[Java, Scala]
    Java ... Groovy
    [Groovy, Scala, Kotlin, Java]
    2011
    • var (Java 10) deja que el compilador deduzca el tipo de una variable local. Sigue siendo un tipo fijo: no es el var de JavaScript.
    • List.of, Set.of y Map.of (Java 9) crean colecciones inmutables en una línea. No admiten null, y Map.of llega hasta diez pares; para más, Map.ofEntries.
    • .toList() (Java 16) sustituye a .collect(Collectors.toList()) y devuelve una lista que no se puede modificar.
    • getFirst(), getLast() y reversed() (Java 21) llegan con las colecciones secuenciadas, una interfaz común para todo lo que tiene orden: listas, LinkedHashSet, LinkedHashMap, Deque…

    Texto: bloques de texto y los métodos que faltaban

    public class Main {
        public static void main(String[] args) {
            String json = "{\n" +
                          "  \"nombre\": \"Ana\",\n" +
                          "  \"lenguaje\": \"Java\"\n" +
                          "}";
            String entrada = "   \t  ";
            System.out.println(json);
            System.out.println(entrada.trim().isEmpty());
            StringBuilder linea = new StringBuilder();
            for (int i = 0; i < 20; i++) linea.append('-');
            System.out.println(linea);
            System.out.println(String.format("%s tiene %d años", "Java", 2023 - 1995));
        }
    }
    java 8{
      "nombre": "Ana",
      "lenguaje": "Java"
    }
    true
    --------------------
    Java tiene 28 años
    public class Main {
        public static void main(String[] args) {
            String json = """
                {
                  "nombre": "Ana",
                  "lenguaje": "Java"
                }""";
            String entrada = "   \t  ";
            System.out.println(json);
            System.out.println(entrada.isBlank());
            System.out.println("-".repeat(20));
            System.out.println("%s tiene %d años".formatted("Java", 2023 - 1995));
            "uno\ndos\ntres".lines().map(String::strip).forEach(System.out::println);
        }
    }
    java 21{
      "nombre": "Ana",
      "lenguaje": "Java"
    }
    true
    --------------------
    Java tiene 28 años
    uno
    dos
    tres

    Los bloques de texto (Java 15), entre triples comillas, permiten escribir JSON, SQL o HTML tal cual, sin escapar comillas ni concatenar líneas; la sangría común se quita sola. Java 11 añadió a String isBlank(), strip() (que, a diferencia de trim(), entiende los espacios de Unicode), lines() y repeat(), y Java 15, formatted().

    Records: clases de datos en una línea

    Una clase que solo guarda datos, en Java 8, necesita constructor, getters, equals, hashCode y toString, unas cuarenta líneas que casi siempre se generaban con el IDE o con Lombok:

    import java.util.Objects;
    
    public class Main {
        static final class Punto {
            private final int x;
            private final int y;
    
            Punto(int x, int y) {
                this.x = x;
                this.y = y;
            }
    
            int getX() { return x; }
            int getY() { return y; }
    
            @Override
            public boolean equals(Object o) {
                if (this == o) return true;
                if (!(o instanceof Punto)) return false;
                Punto p = (Punto) o;
                return x == p.x && y == p.y;
            }
    
            @Override
            public int hashCode() { return Objects.hash(x, y); }
    
            @Override
            public String toString() { return "Punto[x=" + x + ", y=" + y + "]"; }
        }
    
        public static void main(String[] args) {
            Punto a = new Punto(1, 2);
            System.out.println(a + " " + a.equals(new Punto(1, 2)) + " " + a.getX());
        }
    }
    java 8Punto[x=1, y=2] true 1
    public class Main {
        record Punto(int x, int y) {
            Punto {
                if (x < 0 || y < 0) throw new IllegalArgumentException("Coordenadas negativas");
            }
        }
    
        public static void main(String[] args) {
            var a = new Punto(1, 2);
            System.out.println(a + " " + a.equals(new Punto(1, 2)) + " " + a.x());
            new Punto(-1, 0);
        }
    }
    java 21Punto[x=1, y=2] true 1
    Exception in thread "main" java.lang.IllegalArgumentException: Coordenadas negativas
    	at Main$Punto.<init>(Main.java:4)
    	at Main.main(Main.java:11)
    código de salida: 1

    Un record (Java 16) declara los campos una vez y el compilador escribe el constructor, los métodos de acceso (x(), no getX()), equals, hashCode y toString. Es inmutable, y el constructor compacto permite validar los datos, como aquí, donde la segunda línea lanza la excepción. Es el sustituto natural de buena parte de los usos de Lombok.

    Decidir según el tipo: patrones y clases selladas

    Este es el cambio más profundo del lenguaje. En Java 8, actuar según el tipo de un objeto es una cadena de instanceof con conversiones:

    public class Main {
        interface Forma {}
        static final class Circulo implements Forma { final double r; Circulo(double r) { this.r = r; } }
        static final class Rectangulo implements Forma { final double an, al; Rectangulo(double an, double al) { this.an = an; this.al = al; } }
    
        static double area(Forma f) {
            if (f instanceof Circulo) {
                Circulo c = (Circulo) f;
                return Math.PI * c.r * c.r;
            } else if (f instanceof Rectangulo) {
                Rectangulo r = (Rectangulo) f;
                return r.an * r.al;
            }
            throw new IllegalArgumentException("Forma desconocida");
        }
    
        public static void main(String[] args) {
            System.out.printf("%.2f %.2f%n", area(new Circulo(1)), area(new Rectangulo(2, 3)));
        }
    }
    java 83.14 6.00
    public class Main {
        sealed interface Forma permits Circulo, Rectangulo, Triangulo {}
        record Circulo(double r) implements Forma {}
        record Rectangulo(double an, double al) implements Forma {}
        record Triangulo(double base, double alto) implements Forma {}
    
        static double area(Forma f) {
            return switch (f) {
                case Circulo(double r) -> Math.PI * r * r;
                case Rectangulo(double an, double al) when an == al -> an * an;
                case Rectangulo(double an, double al) -> an * al;
                case Triangulo(double b, double h) -> b * h / 2;
            };
        }
    
        public static void main(String[] args) {
            System.out.printf("%.2f %.2f %.2f%n", area(new Circulo(1)), area(new Rectangulo(2, 3)), area(new Triangulo(4, 5)));
            Object o = "Java 21";
            if (o instanceof String s && s.length() > 4) {
                System.out.println(s.toUpperCase());
            }
        }
    }
    java 213.14 6.00 10.00
    JAVA 21

    Cuatro novedades trabajan juntas:

    • switch como expresión (Java 14): devuelve un valor, usa flechas y no se cae al caso siguiente, así que se acabaron los break olvidados.
    • Patrones en el switch y patrones de records (Java 21): case Circulo(double r) comprueba el tipo y saca sus componentes a la vez, y when añade una condición.
    • Clases selladas (Java 17): sealed ... permits fija la lista cerrada de implementaciones. Gracias a eso el compilador sabe que el switch cubre todos los casos y no hace falta un default.
    • instanceof con patrón (Java 16): o instanceof String s comprueba y declara la variable de una vez.

    El efecto más útil es el que no se ve: si mañana alguien añade una forma nueva a la interfaz sellada, el switch de area deja de compilar hasta que se trate. Lo comprobamos quitando la línea del triángulo:

    public class Main {
        sealed interface Forma permits Circulo, Rectangulo, Triangulo {}
        record Circulo(double r) implements Forma {}
        record Rectangulo(double an, double al) implements Forma {}
        record Triangulo(double base, double alto) implements Forma {}
    
        static double area(Forma f) {
            return switch (f) {
                case Circulo(double r) -> Math.PI * r * r;
                case Rectangulo(double an, double al) -> an * al;
            };
        }
    
        public static void main(String[] args) {
            System.out.println(area(new Circulo(1)));
        }
    }
    javac 21Main.java:8: error: the switch expression does not cover all possible input values
            return switch (f) {
                   ^
    1 error
    código de salida: 1

    Errores que se entienden

    El mismo programa, con un null escondido, ejecutado en los dos JDK:

    public class Main {
        static class Direccion { String ciudad; }
        static class Cliente { Direccion direccion; }
    
        public static void main(String[] args) {
            Cliente c = new Cliente();
            c.direccion = new Direccion();
            c.direccion.ciudad = "Lima";
            Cliente[] clientes = { c, new Cliente() };
            for (Cliente cl : clientes) {
                System.out.println(cl.direccion.ciudad.length());
            }
        }
    }
    java 84
    Exception in thread "main" java.lang.NullPointerException
    	at Main.main(Main.java:11)
    código de salida: 1
    java 214
    Exception in thread "main" java.lang.NullPointerException: Cannot read field "ciudad" because "<local6>.direccion" is null
    	at Main.main(Main.java:11)
    código de salida: 1

    El primer cliente funciona; el segundo no tiene dirección. En Java 8, el error dice la línea, pero no qué era null: ¿cl, direccion o ciudad? Desde Java 14, las NullPointerException detalladas lo dicen. El <local6> es la variable cl: su nombre solo aparece si se compila con javac -g, que es lo que hacen Maven y Gradle por omisión. Pequeño cambio, horas de depuración ahorradas.

    Hilos virtuales: miles de tareas sin miles de hilos

    La novedad más importante de Java 21 para los servidores. Un hilo normal de Java es un hilo del sistema operativo, caro de crear y limitado a unos pocos miles. Por eso, en Java 8, las tareas que pasan casi todo el tiempo esperando (a una base de datos, a una API) se reparten en un grupo fijo de hilos, y las que no caben esperan su turno:

    import java.util.concurrent.*;
    
    public class Main {
        public static void main(String[] args) throws Exception {
            long inicio = System.nanoTime();
            ExecutorService ejecutor = Executors.newFixedThreadPool(100);
            for (int i = 0; i < 2_000; i++) {
                ejecutor.submit(() -> { Thread.sleep(100); return null; });
            }
            ejecutor.shutdown();
            ejecutor.awaitTermination(1, TimeUnit.MINUTES);
            long ms = (System.nanoTime() - inicio) / 1_000_000;
            System.out.println("2000 esperas de 100 ms con 100 hilos: unos " + Math.round(ms / 100.0) / 10.0 + " s");
        }
    }
    java 82000 esperas de 100 ms con 100 hilos: unos 2.0 s
    import java.util.concurrent.*;
    
    public class Main {
        public static void main(String[] args) throws Exception {
            long inicio = System.nanoTime();
            try (var ejecutor = Executors.newVirtualThreadPerTaskExecutor()) {
                for (int i = 0; i < 2_000; i++) {
                    ejecutor.submit(() -> { Thread.sleep(100); return null; });
                }
            }
            long ms = (System.nanoTime() - inicio) / 1_000_000;
            System.out.println("2000 esperas de 100 ms con hilos virtuales: unos " + Math.round(ms / 100.0) / 10.0 + " s");
        }
    }
    java 212000 esperas de 100 ms con hilos virtuales: unos 0.1 s

    Con 100 hilos, 2,000 esperas de 100 ms tardan unos dos segundos: van de cien en cien. Con hilos virtuales (Java 21), cada tarea tiene su propio hilo, que la JVM gestiona y aparca mientras espera, sin ocupar un hilo del sistema: las 2,000 esperan a la vez. El código apenas cambia, y sigue siendo el estilo sencillo de «una petición, un hilo», sin programación reactiva. Hay más en el ejemplo de tareas en paralelo con hilos virtuales. Los tiempos exactos varían en cada ejecución; la diferencia de orden de magnitud, no.

    Lo que cambia sin tocar el código

    UTF-8 por omisión

    import java.nio.charset.Charset;
    
    public class Main {
        public static void main(String[] args) {
            System.out.println(Charset.defaultCharset());
        }
    }
    LANG=C java Main   (Java 8)US-ASCII
    LANG=C java Main   (Java 21)UTF-8

    En Java 8, el juego de caracteres por omisión depende del sistema: en un Linux sin idioma configurado (LANG=C) es ASCII (US-ASCII), y en un Windows en español suele ser windows-1252. Desde Java 18 es UTF-8 en todas partes. Un programa que leía archivos sin indicar la codificación puede empezar a mostrar las tildes de otra manera al migrar; lo correcto, en las dos versiones, es indicarla siempre (Files.readString(ruta, StandardCharsets.UTF_8)).

    El recolector de basura

    java -XX:+PrintCommandLineFlags -version   (Java 8)-XX:InitialHeapSize=373306944 -XX:MaxHeapSize=5972911104 -XX:+PrintCommandLineFlags -XX:+UseCompressedClassPointers -XX:+UseCompressedOops -XX:+UseParallelGC 
    java -XX:+PrintCommandLineFlags -version   (Java 21)-XX:ConcGCThreads=3 -XX:G1ConcRefinementThreads=13 -XX:GCDrainStackTargetSize=64 -XX:InitialHeapSize=373306944 -XX:MarkStackSize=4194304 -XX:MaxHeapSize=5972911104 -XX:MinHeapSize=6815736 -XX:+PrintCommandLineFlags -XX:ReservedCodeCacheSize=251658240 -XX:+SegmentedCodeCache -XX:-THPStackMitigation -XX:+UseCompressedOops -XX:+UseG1GC 

    Java 8 usa por omisión el recolector Parallel, pensado para el rendimiento total con pausas largas; desde Java 9 es G1, que reparte el trabajo para que las pausas sean cortas. Java 21 añade además ZGC generacional para pausas de menos de un milisegundo con montones enormes. Si tu aplicación fija el recolector o sus opciones con parámetros de la JVM heredados de Java 8, revísalos: algunos ya no existen y la JVM se niega a arrancar.

    Ejecutar un archivo suelto

    java Hola.java   (Java 8)Error: Could not find or load main class Hola.java
    código de salida: 1
    java Hola.java   (Java 21)Hola desde un solo archivo
    código de salida: 0

    Desde Java 11, java Hola.java compila y ejecuta un archivo sin pasar por javac, útil para guiones y para aprender. Y desde Java 9 existe JShell, una consola para probar código línea a línea.

    Lo que se rompe al migrar

    Lo anterior son ventajas. Esto es lo que suele dar trabajo al pasar un proyecto de Java 8 a 21.

    Java EE ya no viene con el JDK

    import javax.xml.bind.DatatypeConverter;
    
    public class Main {
        public static void main(String[] args) {
            System.out.println(DatatypeConverter.printBase64Binary("Hola".getBytes()));
        }
    }
    java 8SG9sYQ==
    javac 21Main.java:1: error: package javax.xml.bind does not exist
    import javax.xml.bind.DatatypeConverter;
                         ^
    Main.java:5: error: cannot find symbol
            System.out.println(DatatypeConverter.printBase64Binary("Hola".getBytes()));
                               ^
      symbol:   variable DatatypeConverter
      location: class Main
    2 errors
    código de salida: 1

    Java 11 retiró del JDK los módulos de Java EE y CORBA: JAXB (javax.xml.bind), JAX-WS, javax.activation y otros. El código que los usa deja de compilar. La solución es añadirlos como dependencias de Maven o Gradle (hoy, en su versión de Jakarta, con el paquete jakarta.xml.bind) o usar la alternativa estándar, como aquí java.util.Base64.

    Las tripas del JDK están cerradas

    import java.lang.reflect.Field;
    import java.util.ArrayList;
    
    public class Main {
        public static void main(String[] args) throws Exception {
            ArrayList<String> lista = new ArrayList<>();
            lista.add("a");
            Field interno = ArrayList.class.getDeclaredField("elementData");
            interno.setAccessible(true);
            System.out.println("Capacidad interna: " + ((Object[]) interno.get(lista)).length);
        }
    }
    java 8Capacidad interna: 10
    java 21Exception in thread "main" java.lang.reflect.InaccessibleObjectException: Unable to make field transient java.lang.Object[] java.util.ArrayList.elementData accessible: module java.base does not "opens java.util" to unnamed module @2a139a55
    	at java.base/java.lang.reflect.AccessibleObject.throwInaccessibleObjectException(AccessibleObject.java:391)
    	at java.base/java.lang.reflect.AccessibleObject.checkCanSetAccessible(AccessibleObject.java:367)
    	at java.base/java.lang.reflect.AccessibleObject.checkCanSetAccessible(AccessibleObject.java:315)
    	at java.base/java.lang.reflect.Field.checkCanSetAccessible(Field.java:183)
    	at java.base/java.lang.reflect.Field.setAccessible(Field.java:177)
    	at Main.main(Main.java:9)
    código de salida: 1

    Con los módulos de Java 9, las clases internas del JDK pasaron a estar encapsuladas, y desde Java 17 ya no hay forma de abrirlas de manera global (la opción --illegal-access desapareció). Las bibliotecas antiguas que hurgaban con reflexión en clases del JDK fallan así; casi siempre basta con actualizarlas a una versión moderna. Como último recurso, --add-opens abre un paquete concreto.

    Nashorn, sun.misc y compañía

    import javax.script.*;
    
    public class Main {
        public static void main(String[] args) throws Exception {
            ScriptEngine motor = new ScriptEngineManager().getEngineByName("nashorn");
            System.out.println(motor == null ? "No hay motor de JavaScript" : "1 + 2 = " + motor.eval("1 + 2"));
        }
    }
    java 81 + 2 = 3
    java 21No hay motor de JavaScript

    El motor de JavaScript Nashorn se retiró en Java 15 (existe como biblioteca aparte), y con él otras piezas: los applets, javafx (que se distribuye por separado desde Java 11), el SecurityManager (obsoleto desde Java 17) y APIs internas como sun.misc.BASE64Encoder. Para encontrarlas en un proyecto existe jdeps, que viene con el JDK:

    jdeps --jdk-internals Viejo.class   (con el JDK 21, sobre una clase compilada con Java 8)Viejo.class -> JDK removed internal API
       Viejo                                              -> sun.misc.BASE64Encoder                             JDK removed internal API
    
    Warning: JDK internal APIs are unsupported and private to JDK implementation that are
    subject to be removed or changed incompatibly and could break your application.
    Please modify your code to eliminate dependence on any JDK internal APIs.
    For the most recent update on JDK internal API replacements, please check:
    https://wiki.openjdk.org/display/JDK8/Java+Dependency+Analysis+Tool
    
    JDK Internal API                         Suggested Replacement
    ----------------                         ---------------------
    sun.misc.BASE64Encoder                   Use java.util.Base64 @since 1.8

    jdeps lista cada uso de una API interna y propone su sustituta. Su compañero jdeprscan busca lo que está marcado como obsoleto.

    Cómo migrar de Java 8 a 21

    1. Actualiza primero las herramientas: Maven, Gradle y sus plugins, y las bibliotecas (Spring, Hibernate, Lombok, Mockito…), a versiones que admitan Java 21. Es la parte que más problemas resuelve sola.
    2. Pasa jdeps --jdk-internals y jdeprscan sobre tus JAR y los de tus dependencias.
    3. Añade las dependencias de Java EE que antes venían con el JDK, si las usas.
    4. Compila y prueba con Java 21, pero manteniendo de momento el nivel de lenguaje antiguo si quieres ir por partes: --release 8. Después sube a --release 21 y empieza a usar lo nuevo.
    5. Revisa la configuración de la JVM: opciones de recolector, de memoria y de registro que ya no existen hacen que la JVM no arranque.
    6. Prueba en un entorno igual al de producción, con atención a la codificación de archivos, las fechas y la memoria.
    ¿Por qué no ir directamente a Java 25? Es la LTS más reciente y la migración desde 8 es prácticamente la misma. Si tus dependencias ya la admiten, es la mejor opción; Java 21 es el salto seguro si alguna todavía no. En el curso de Java usamos Java 25.

    ¿Y si me quedo en Java 8?

    Java 8 sigue recibiendo parches de seguridad en las distribuciones gratuitas de OpenJDK, como Eclipse Temurin, que promete mantenerla al menos hasta diciembre de 2030, más que a Java 11 y 17. Pero recibir parches no es lo mismo que estar al día: las bibliotecas nuevas ya no la admiten (Spring Boot 3, por ejemplo, exige Java 17), los desarrolladores la conocen cada vez menos y se pierde todo lo anterior. Y ojo con la licencia: las actualizaciones del Oracle JDK 8 para uso comercial son de pago desde 2019; con una distribución de OpenJDK como Temurin o Amazon Corretto no hay ese problema.

    Java 8Java 21
    Saliómarzo de 2014septiembre de 2023
    Soporte en Temurinal menos hasta dic. de 2030al menos hasta dic. de 2029
    Lenguajelambdas y streams+ var, records, bloques de texto, switch con patrones, clases selladas
    Concurrenciahilos del sistema+ hilos virtuales
    Recolector por omisiónParallelG1
    Codificación por omisiónla del sistemaUTF-8
    Incluye Java EE y Nashornsíno
    Bibliotecas modernascada vez menossí (Spring Boot 3 exige 17)

    La conclusión es clara: Java 21 se escribe con menos código, avisa antes de los errores y aguanta mucha más carga con los hilos virtuales. La migración tiene un coste, sobre todo en dependencias antiguas, pero cada año que pasa en Java 8 ese coste crece. Si empiezas un proyecto hoy, la pregunta no es entre 8 y 21, sino entre 21 y 25.

    Todo el código se compiló y ejecutó con Eclipse Temurin 1.8.0_504 y 21.0.12.1, en contenedores sin acceso a la red y sin idioma configurado; las salidas están copiadas de esa ejecución (los tiempos de los hilos varían ligeramente en cada una). Fechas de soporte: Eclipse Adoptium. Versión de cada novedad: sus propuestas de mejora (JEP) en openjdk.org.

    Las personas que crearon el software: de Grace Hopper y Linus Torvalds a la era de la IA

    Collage de retratos de Grace Hopper, Margaret Hamilton, Dennis Ritchie, Richard Stallman, Bjarne Stroustrup, Linus Torvalds, Guido van Rossum y James Gosling

    Detrás de cada programa que usas hay ideas que alguien tuvo primero: que una máquina pudiera traducir palabras a instrucciones, que un sistema operativo se pudiera copiar y mejorar libremente, que el mismo código funcionara en cualquier ordenador. Este es un recorrido por las personas más influyentes del software, desde las pioneras de los años cincuenta hasta quienes hoy definen cómo se programa con inteligencia artificial.

    No es una lista cerrada ni un ranking: el software es obra de millones de personas y casi todo lo importante se hizo en equipo. Pero algunos nombres aparecen una y otra vez en la historia, y conocerlos ayuda a entender por qué las herramientas que usamos son como son.

    Siete décadas de software1952Grace Hopper: el compilador A-01969Apolo 11 y el primer Unix1972Dennis Ritchie crea C1983Stallman anuncia GNU1985Primera versión de C++1989Propuesta de la World Wide Web1991Nacen Python y Linux1995Java y JavaScript2000C# y el inicio de LLVM2005Torvalds escribe Git2006Graydon Hoare empieza Rust2009Go, de Pike, Thompson y Griesemer2012TypeScript2014Swift y Vue2025Karpathy bautiza el vibe coding
    Algunos hitos de las personas de este artículo. Las fechas son las de la primera versión o el primer anuncio público.

    Las pioneras y los primeros maestros

    Grace Hopper: que las máquinas entiendan palabras

    En los años cuarenta, programar era escribir números y conectar cables. Grace Hopper (1906-1992), matemática y oficial de la Marina de Estados Unidos, pensaba que los ordenadores debían entender algo más parecido al inglés. En 1952 creó el A-0, uno de los primeros compiladores, y después FLOW-MATIC, un lenguaje con palabras en lugar de símbolos que fue la base de COBOL en 1959. También hizo famosa la palabra bug: en 1947 su equipo encontró una polilla atrapada en un relé del ordenador Mark II y la pegó en el cuaderno de registro como «el primer caso real de un bicho encontrado». Se retiró en 1986 como contraalmirante.

    Retrato oficial de Grace Hopper con uniforme de comodoro de la Marina de Estados Unidos, junto a la bandera
    Grace Hopper en su retrato oficial de 1984. Foto: James S. Davis, dominio público, Wikimedia Commons.

    Margaret Hamilton: el software que llevó al ser humano a la Luna

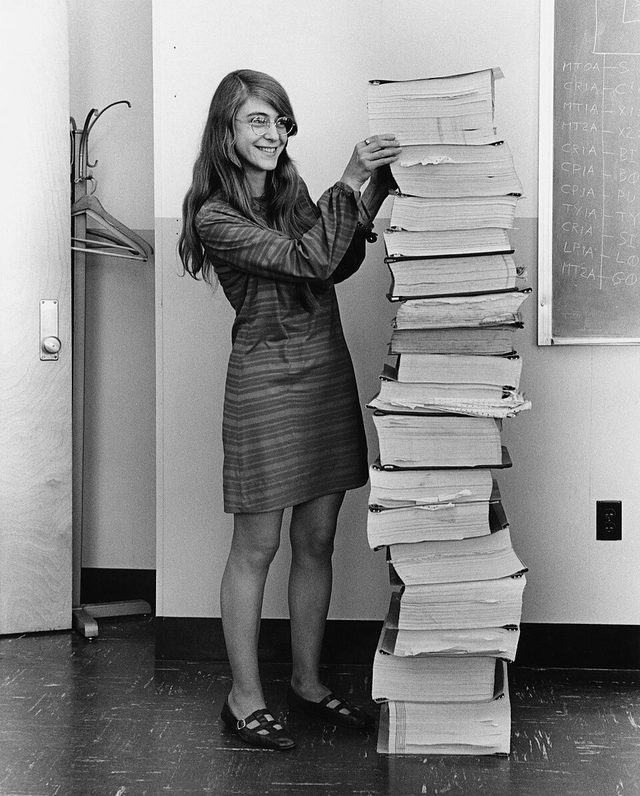
    Margaret Hamilton (1936) dirigió en el MIT el equipo que escribió el software de vuelo del programa Apolo. Durante el alunizaje del Apolo 11, en 1969, el ordenador de la nave se saturó y lanzó las alarmas 1201 y 1202; como su software sabía dar prioridad a las tareas críticas y descartar las demás, el aterrizaje siguió adelante. Hamilton popularizó la expresión software engineering para que el desarrollo de programas se tomara tan en serio como cualquier otra ingeniería. Recibió la Medalla Presidencial de la Libertad en 2016.

    Margaret Hamilton en 1969, de pie junto a una pila de listados impresos del software de navegación del Apolo tan alta como ella
    Margaret Hamilton en 1969, junto a los listados del software de navegación del Apolo. Foto: Draper Laboratory, restaurada por Adam Cuerden, dominio público, Wikimedia Commons.

    Knuth, Dijkstra y Liskov: la ciencia detrás del código

    • Donald Knuth (1938) empezó en 1968 The Art of Computer Programming, la obra de referencia sobre algoritmos, que todavía sigue escribiendo. Creó además TeX, el sistema con el que se componen casi todos los artículos científicos con fórmulas. Premio Turing en 1974.
    • Edsger Dijkstra (1930-2002) inventó en 1956 el algoritmo del camino más corto que lleva su nombre (la base del algoritmo A*) y en 1968 escribió «Go To Statement Considered Harmful», el texto que impulsó la programación estructurada. Premio Turing en 1972.
    • Barbara Liskov (1939) creó CLU, uno de los primeros lenguajes con tipos abstractos de datos, y en 1987 formuló el principio de sustitución de Liskov, la «L» de los principios SOLID que se enseñan en cualquier curso de diseño. Premio Turing en 2008.

    Unix y C: la base de casi todo

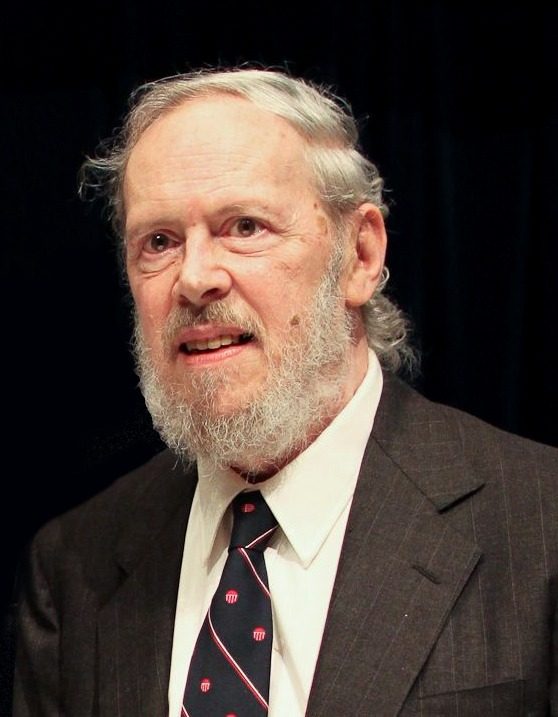
    En 1969, en los Bell Labs, Ken Thompson (1943) escribió la primera versión de Unix en un ordenador PDP-7 que nadie usaba. Su compañero Dennis Ritchie (1941-2011) creó en 1972 el lenguaje C, y en 1973 reescribieron Unix en C: por primera vez un sistema operativo se podía llevar a otra máquina sin reescribirlo entero. De esas dos ideas descienden Linux, macOS, Android, iOS y la mayoría de los servidores de internet, y la sintaxis de C sigue viva en C++, Java, C#, JavaScript y Go. Ambos recibieron el Premio Turing en 1983.

    Ritchie murió en octubre de 2011, una semana después que Steve Jobs, con mucho menos ruido mediático pese a que su trabajo está dentro de cada iPhone. Thompson siguió inventando: en 1992 diseñó con Rob Pike la codificación UTF-8, la que permite escribir acentos y emojis en la web, y en 2009 presentó en Google el lenguaje Go junto con Pike y Robert Griesemer.

    Dennis Ritchie, con barba y traje, en 2011
    Dennis Ritchie, creador de C y coautor de Unix, en 2011. Foto: Denise Panyik-Dale, CC BY 2.0, Wikimedia Commons.

    El software libre

    Richard Stallman: la libertad de copiar y modificar

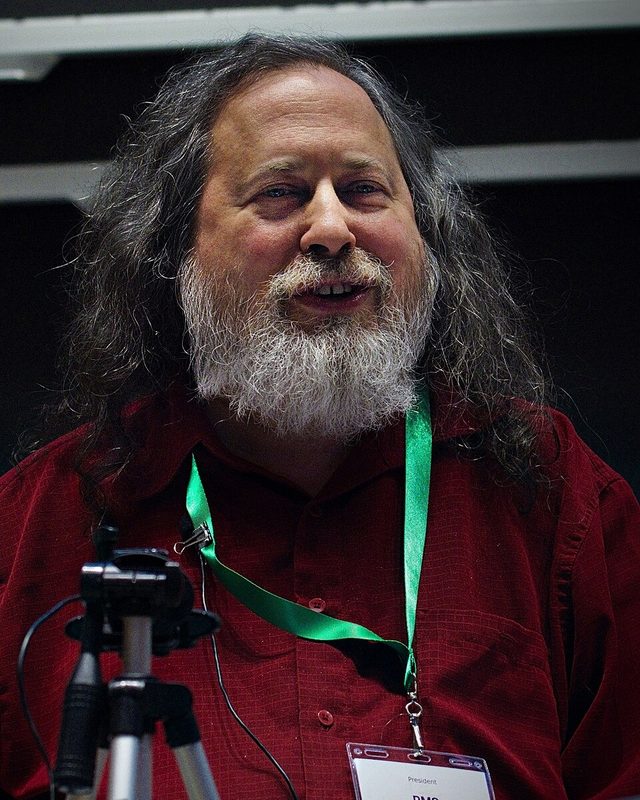
    En septiembre de 1983, Richard Stallman (1953) anunció el proyecto GNU: un sistema operativo completo, compatible con Unix, que cualquiera pudiera usar, estudiar, modificar y compartir. Fundó la Free Software Foundation en 1985 y escribió la licencia GPL en 1989, la que obliga a que las versiones modificadas sigan siendo libres. De GNU salieron el compilador GCC y el editor Emacs. Es una figura polémica: dejó la presidencia de la FSF en 2019 tras unas declaraciones muy criticadas y volvió a su consejo en 2021. Pero sin su idea de software libre la historia del código abierto sería otra.

    Richard Stallman hablando en el congreso LibrePlanet de 2019
    Richard Stallman en LibrePlanet, en 2019. Foto: Ruben Rodriguez, CC BY 4.0, Wikimedia Commons.

    Linus Torvalds: Linux y Git

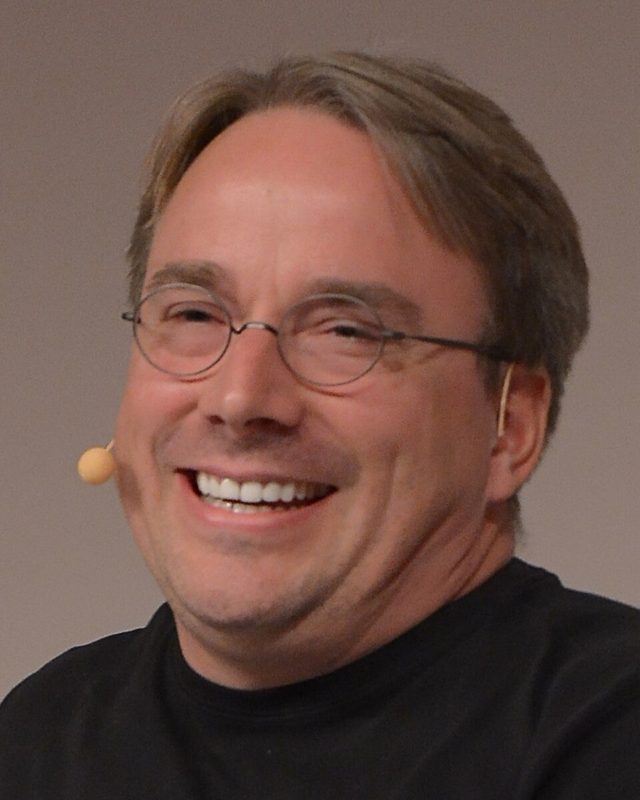
    Al proyecto GNU le faltaba una pieza, el kernel. El 25 de agosto de 1991, un estudiante finlandés de 21 años, Linus Torvalds (1969), escribió en un foro que estaba haciendo «un sistema operativo libre, solo un hobby, nada grande ni profesional como GNU». Ese hobby es Linux, que hoy funciona en casi todos los servidores de internet, en los 500 superordenadores más potentes del mundo y, a través de Android, en miles de millones de teléfonos. En 2005, cuando el kernel se quedó sin su herramienta de control de versiones, Torvalds escribió Git en unas semanas; hoy es el estándar de todo el sector (y su algoritmo de diferencias merece su propio artículo).

    Torvalds sigue dirigiendo el desarrollo del kernel, con su estilo directo de siempre, y este año ha fijado cómo se debe declarar el código escrito con ayuda de IA. Contamos su historia con más detalle en este artículo de 2018.

    Linus Torvalds sonriendo con un micrófono de diadema en la LinuxCon Europe de 2014
    Linus Torvalds en la LinuxCon Europe de 2014. Foto: Krd, CC BY-SA 4.0, Wikimedia Commons.

    Los creadores de lenguajes

    Bjarne Stroustrup: C++

    El danés Bjarne Stroustrup (1950) quería la velocidad de C con la organización de los lenguajes orientados a objetos. Empezó «C con clases» en 1979 en los Bell Labs y en 1985 publicó la primera versión de C++. Cuatro décadas después sigue siendo el lenguaje de los motores de videojuegos, los navegadores, las bases de datos y el software financiero. Stroustrup es profesor en la Universidad de Columbia y sigue participando en el comité que define el lenguaje. Puedes empezar con nuestros ejemplos de C++.

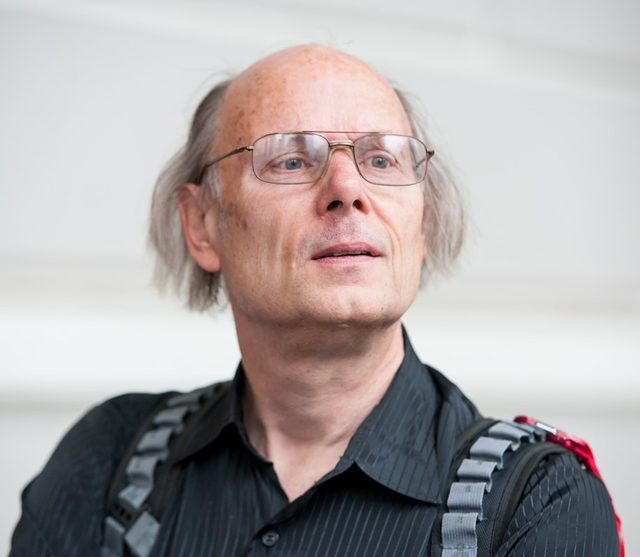
    Bjarne Stroustrup con gafas en 2013
    Bjarne Stroustrup en 2013. Foto: ICPCNews, CC BY 2.0, Wikimedia Commons.

    Guido van Rossum: Python

    En la Navidad de 1989, el holandés Guido van Rossum (1956) empezó un lenguaje para pasar el rato en el instituto CWI de Ámsterdam. Lo llamó Python por los Monty Python, publicó la primera versión en febrero de 1991 y durante casi treinta años fue su «dictador benevolente vitalicio», hasta que dejó ese papel en 2018. Hoy Python es uno de los lenguajes más usados del mundo y el idioma de la inteligencia artificial. Trabajó en Google, Dropbox y Microsoft, de donde se retiró en mayo de 2026. Si quieres aprenderlo, tienes nuestro curso de Python.

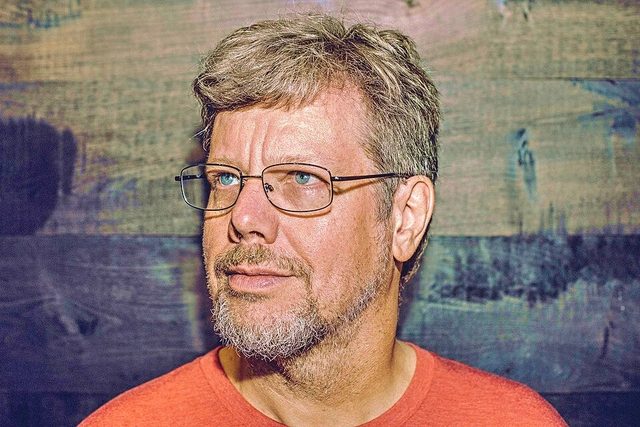
    Retrato de Guido van Rossum con gafas y camiseta naranja
    Guido van Rossum en 2014. Foto: Daniel Stroud, CC BY-SA 4.0, Wikimedia Commons.

    James Gosling: Java

    El canadiense James Gosling (1955) dirigió en Sun Microsystems el equipo que en 1991 empezó un lenguaje para electrodomésticos llamado Oak. En 1995 salió con otro nombre, Java, y una promesa: write once, run anywhere, escribirlo una vez y ejecutarlo en cualquier sistema gracias a una máquina virtual. Java conquistó los servidores de empresas y bancos, y fue la base de las aplicaciones de Android. Gosling dejó Oracle en 2010, cuando compró Sun, pasó por Google y Amazon Web Services y se retiró en 2024. Su lenguaje sigue entre los más usados, y lo explicamos en nuestro curso de Java.

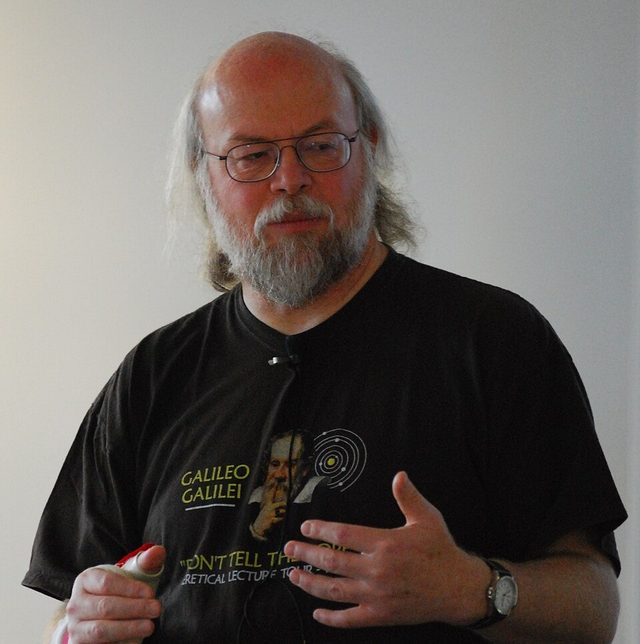
    James Gosling con camiseta negra durante una charla
    James Gosling en 2010. Foto: Peter Campbell, CC BY-SA 4.0, Wikimedia Commons.

    Brendan Eich: JavaScript en diez días

    En mayo de 1995, Netscape necesitaba un lenguaje para dar vida a las páginas web, y Brendan Eich (1961) escribió el primer prototipo en unos diez días. Se llamó Mocha, luego LiveScript y, por marketing, JavaScript. Las prisas dejaron rarezas que todavía se comentan, pero hoy es el único lenguaje que funciona en todos los navegadores. Eich cofundó Mozilla, la organización detrás de Firefox, y hoy dirige Brave, el navegador centrado en la privacidad. Aquí tienes nuestra sección de JavaScript.

    Anders Hejlsberg: de Turbo Pascal a TypeScript

    Pocas personas han diseñado tantos lenguajes de éxito como el danés Anders Hejlsberg (1960). Escribió Turbo Pascal en 1983 y dirigió Delphi en Borland. En Microsoft creó C#, presentado en 2000, y TypeScript, en 2012, que añadió tipos a JavaScript y se ha convertido en el estándar de los proyectos web grandes. En 2025 anunció que el compilador de TypeScript se reescribía en Go para ser unas diez veces más rápido; esa versión, TypeScript 7, llegó en junio de 2026 como versión candidata. Tenemos secciones de C# y de TypeScript.

    Más lenguajes, más nombres

    • Yukihiro «Matz» Matsumoto publicó Ruby en 1995 con una meta poco común: que programar fuera agradable.
    • Rasmus Lerdorf creó PHP en 1994 para su página personal; hoy mueve buena parte de la web, incluido WordPress.
    • Graydon Hoare empezó Rust en 2006 tras quedarse sin ascensor por un fallo de software, y hoy su lenguaje está dentro del kernel de Linux.
    • Rob Pike, compañero de Thompson en Bell Labs y en Google, es la otra mitad de UTF-8 y de Go.

    La web, los videojuegos y el software en español

    • Tim Berners-Lee (1955) propuso en el CERN, en marzo de 1989, un sistema de documentos enlazados, y en 1990 programó el primer servidor y el primer navegador: la World Wide Web. No la patentó, y por eso cualquiera pudo construir sobre ella. Premio Turing en 2016.
    • Bill Gates y Paul Allen escribieron en 1975 un intérprete de BASIC para el ordenador Altair y con él fundaron Microsoft, que llevó MS-DOS y Windows a cientos de millones de casas.
    • John Carmack (1970) programó los motores de Wolfenstein 3D, Doom (1993) y Quake (1996), que definieron los juegos en 3D, y publicó su código fuente para que otros aprendieran de él. Después fue director técnico de Oculus y hoy investiga inteligencia artificial en su empresa, Keen Technologies.
    • Miguel de Icaza (1972), mexicano, cofundó en 1997 el escritorio GNOME y en 2001 creó Mono, la versión libre de .NET, que dio lugar a Xamarin y permitió programar apps móviles en C#. Microsoft compró Xamarin en 2016.
    • Guillermo Rauch, argentino, creó la biblioteca Socket.IO y el framework Next.js (2016), y dirige Vercel, una de las plataformas más usadas para publicar aplicaciones web.

    La generación actual

    • David Heinemeier Hansson (DHH) publicó Ruby on Rails en 2004, el framework que popularizó la idea de «convención sobre configuración» e inspiró a casi todos los que vinieron después. Sigue al frente de 37signals y de Rails, y es una de las voces más críticas con la nube y la complejidad innecesaria.
    • Evan You creó Vue en 2014 como proyecto personal y en 2020 Vite, la herramienta con la que hoy arrancan la mayoría de los proyectos web. En 2024 fundó VoidZero para unificar las herramientas de JavaScript.
    • Mitchell Hashimoto cofundó HashiCorp, creadora de Vagrant y Terraform, que IBM compró en 2025. Después lanzó Ghostty, un terminal que donó a una organización sin ánimo de lucro, y este año fundó una nueva empresa, Superlogical.
    • Chris Lattner (1978) empezó LLVM en 2000 como estudiante; hoy es la base de los compiladores de Swift, Rust y Clang. En Apple creó Swift (2014) y en 2022 fundó Modular, donde diseñó Mojo, un lenguaje con sintaxis de Python pensado para la IA. Qualcomm compró Modular este verano y Mojo 1.0 publicó su compilador como código abierto en agosto.
    • Andrej Karpathy, cofundador de OpenAI y exdirector de IA de Tesla, explicó en 2017 la idea de «Software 2.0», programas que se entrenan en vez de escribirse, y en febrero de 2025 bautizó el vibe coding: programar describiendo lo que quieres y dejando que la IA escriba el código. Sus vídeos son de los más usados para aprender cómo funcionan los modelos de lenguaje. En mayo de 2026 se unió a Anthropic, la empresa de Claude que acaba de pedir su salida a bolsa.

    Lo que tienen en común

    Casi ninguna de estas personas se propuso cambiar el mundo. Hopper quería ahorrar trabajo a los programadores, Thompson quería un sistema cómodo para sus experimentos, Torvalds y Van Rossum empezaron por diversión y Eich tenía diez días de plazo. Lo que convirtió sus proyectos en historia fue que resolvían un problema real, que otros podían usarlos y mejorarlos, y que alrededor creció una comunidad. Unix se repartió con su código fuente, la web no se patentó, Linux y Python fueron libres desde el principio.

    La generación actual afronta otro cambio de la misma escala: si en los cincuenta el salto fue pasar de números a palabras, ahora es pasar de escribir código a describirlo. Las ideas de estos pioneros, abstraer, compartir y dejar que otros construyan encima, siguen siendo las mismas. Y es muy probable que alguno de los nombres que marcarán la próxima década esté ahora mismo escribiendo, como Torvalds en 1991, un proyecto «solo por hobby».

    Fechas y datos biográficos contrastados con las páginas de cada persona en Wikipedia y con las fuentes primarias enlazadas en el texto (anuncio de GNU, mensaje de Torvalds en comp.os.minix, CERN, blog de TypeScript, blog de Mitchell Hashimoto). Datos de 2026: Wikipedia (retiro de Guido van Rossum), TechRepublic (Karpathy en Anthropic) y Phoronix (Mojo). Fotos de Wikimedia Commons con sus licencias en cada pie.

    Rust: cómo nació, qué lo hizo distinto y por qué crece en Linux y en la programación con IA

    Ferris, la mascota de Rust, hinchable con tubos de luz, junto al logotipo oficial de Rust

    En 2006, un programador de 29 años volvió a su casa en Vancouver y se encontró, otra vez, el ascensor estropeado. Vivía en el piso 21, y pensó que era ridículo que los informáticos no supieran hacer ni un ascensor que funcionara sin colgarse. Poco después empezó a diseñar un lenguaje de programación. Se llamaba Graydon Hoare, y el lenguaje, Rust. Veinte años después está dentro del kernel de Linux, de Android, de Windows y de las herramientas con las que la IA escribe código. Te contamos cómo nació, qué ideas lo hicieron distinto y hacia dónde va.

    Un ascensor roto y un hongo muy resistente

    Hoare trabajaba entonces para Mozilla, la fundación que hace Firefox. Sabía que muchos de esos cuelgues vienen de errores en el manejo de la memoria, típicos de los programas escritos en C y C++, los lenguajes con los que se hace casi todo el software que tiene que ser rápido: sistemas operativos, navegadores, el firmware de un ascensor. Su idea era un lenguaje tan rápido como C y C++, pero en el que esos errores no se pudieran cometer, y sin la solución de Java o Python, un recolector de basura (garbage collector) que se encarga de la memoria a cambio de gastar recursos y de hacer pausas.

    Le puso el nombre de un grupo de hongos, las royas, que según él están «sobrediseñados para sobrevivir»: tienen ciclos de vida de hasta cinco fases y varias formas de esporas, y atacan a plantas de todo el mundo.

    Hoja de ortiga deformada por la roya Puccinia urticata, cubierta de pequeños cráteres de color naranja
    La roya de la ortiga (Puccinia urticata), uno de los hongos que dieron nombre al lenguaje. Foto: Rambatino, CC BY-SA 2.5, Wikimedia Commons.

    Durante tres años fue un proyecto personal. En 2009, Mozilla decidió patrocinarlo, y durante una década llegó a tener a más de una docena de ingenieros dedicados a él, según los cálculos de Hoare. En 2013 Hoare dejó el proyecto en manos de otros, y ese mismo año Rust se quedó definitivamente sin recolector de basura. La primera versión estable, Rust 1.0, salió el 15 de mayo de 2015.

    El primer gran examen llegó en 2017: Firefox empezó a usar un motor de CSS escrito en Rust, sacado de Servo, el navegador experimental de Mozilla. Lo llamaron Quantum CSS (antes, Stylo), y su gracia era repartir el trabajo entre todos los núcleos del procesador, algo que en C++ habría sido muy arriesgado. Cuando Mozilla recortó su plantilla en 2020, el lenguaje ya no dependía de ella: el 8 de febrero de 2021 nació la Rust Foundation, con AWS, Huawei, Google, Microsoft y Mozilla como miembros fundadores.

    De proyecto personal a pieza de Linux2006Graydon Hoare empieza Rustcomo proyecto personal2009Mozilla lo patrocinay le pone ingenieros a tiempo completo2013Hoare deja el proyectoy Rust se queda sin recolector de basura2015Rust 1.0la primera versión estable, el 15 de mayo2017Firefox estrena código en Rustsu motor de CSS, que viene de Servo2021Nace la Rust Foundationcon AWS, Huawei, Google, Microsoft y Mozilla2022Linux 6.1 admite Rustel 11 de diciembre, como experimento2025Fin del experimentoRust deja de ser experimental en el kernel2026Ubuntu 26.10con las órdenes básicas reescritas en Rust
    Los momentos clave de Rust, de 2006 a 2026. Fuentes: MIT Technology Review, Mozilla, la Rust Foundation, kernelnewbies, LWN y Canonical. Esquema: decodigo.com.

    Las ideas que lo hicieron distinto

    Rust no inventó casi ninguna de sus piezas: muchas venían de lenguajes académicos. Lo nuevo fue juntarlas en un lenguaje práctico, tan rápido como C, y hacer que el compilador las vigile todas. Estos son los conceptos clave, con programas que hemos compilado de verdad.

    Cada dato tiene un solo dueño (ownership)

    En Rust, cada valor pertenece a una variable, su dueña. Cuando la dueña desaparece, la memoria se libera sola, sin recolector de basura. Y si el valor pasa a otra variable, la anterior deja de poder usarlo. Así es imposible liberar la misma memoria dos veces o usarla después de liberarla, dos de los fallos de seguridad más comunes en C y C++:

    fn main() {
        let saludo = String::from("hola");
        let otro = saludo; // la cadena pasa a tener un nuevo dueño: `otro`
        println!("{otro}");
        println!("{saludo}"); // error: `saludo` ya no es dueño de nada
    }
    rustcerror[E0382]: borrow of moved value: `saludo`
     --> propiedad.rs:5:16
      |
    2 |     let saludo = String::from("hola");
      |         ------ move occurs because `saludo` has type `String`, which does not implement the `Copy` trait
    3 |     let otro = saludo; // la cadena pasa a tener un nuevo dueño: `otro`
      |                ------ value moved here
    4 |     println!("{otro}");
    5 |     println!("{saludo}"); // error: `saludo` ya no es dueño de nada

    El compilador no solo se niega: explica dónde se movió el valor y propone una solución (clonarlo, si de verdad hacen falta dos copias).

    Prestar sin perder el control (borrowing)

    Para usar un dato sin quedárselo, se presta con una referencia (&). La regla es sencilla: puede haber muchas referencias de solo lectura a la vez, o una sola que puede modificar el dato, pero nunca las dos cosas al mismo tiempo. La parte del compilador que lo comprueba se llama borrow checker, y es la fama, buena y mala, de Rust.

    Las reglas del préstamoMuchos lectoreslista&lista&lista&listaleen a la vezO un solo escritorlista&mut listapuede cambiarlaNunca las dos cosas a la vez: así no hayquien lea algo mientras otro lo cambia.
    Las dos formas de prestar un dato en Rust. Esquema: decodigo.com.
    fn main() {
        let mut lista = vec![1, 2, 3];
        let primero = &lista[0]; // préstamo de solo lectura
        lista.push(4); // error: no se puede modificar mientras alguien la está leyendo
        println!("{primero}");
    }
    rustcerror[E0502]: cannot borrow `lista` as mutable because it is also borrowed as immutable
     --> prestamo.rs:4:5
      |
    3 |     let primero = &lista[0]; // préstamo de solo lectura
      |                    ----- immutable borrow occurs here
    4 |     lista.push(4); // error: no se puede modificar mientras alguien la está leyendo
      |     ^^^^^^^^^^^^^ mutable borrow occurs here
    5 |     println!("{primero}");
      |                ------- immutable borrow later used here

    Este error parece exagerado, pero no lo es: al añadir un elemento, el vector puede necesitar más espacio y mudarse a otro sitio de la memoria, y primero apuntaría a donde ya no hay nada. En C++, ese mismo programa compila y falla, o no, según el día. Rust lo detecta antes de ejecutarlo. Las lifetimes (tiempos de vida) son la otra mitad de este sistema: el compilador comprueba que ninguna referencia dure más que el dato al que apunta.

    Sin null y con los errores a la vista

    Tony Hoare (que no es pariente de Graydon) llamó al valor nulo su «error de los mil millones de dólares». Rust no lo tiene: un valor que puede faltar es un Option, que vale Some(valor) o None, y el compilador obliga a tratar los dos casos. Con los errores pasa igual: en vez de excepciones, una operación que puede fallar devuelve un Result, que es Ok o Err:

    fn dividir(a: i32, b: i32) -> Option<i32> {
        if b == 0 { None } else { Some(a / b) }
    }
    
    fn main() {
        for b in [2, 0] {
            match dividir(10, b) {
                Some(r) => println!("10 / {b} = {r}"),
                None => println!("10 / {b}: no se puede dividir entre cero"),
            }
        }
        let bien: Result<i32, _> = "42".parse();
        let mal: Result<i32, _> = "cuarenta y dos".parse();
        println!("{bien:?}");
        println!("{mal:?}");
    }
    salida10 / 2 = 5
    10 / 0: no se puede dividir entre cero
    Ok(42)
    Err(ParseIntError { kind: InvalidDigit })

    El match obliga a cubrir todas las posibilidades: si falta el caso None, el programa no compila.

    Concurrencia sin miedo

    Los fallos más difíciles de encontrar son los que aparecen cuando varios hilos tocan los mismos datos a la vez: dependen del orden en que se ejecutan y a veces tardan meses en dar la cara. Rust marca cada tipo según si es seguro enviarlo a otro hilo (Send) o compartirlo entre hilos (Sync), y el compilador lo comprueba. Este programa intenta pasar a otro hilo un Rc, un contador de referencias que no está preparado para eso:

    use std::rc::Rc;
    use std::thread;
    
    fn main() {
        let datos = Rc::new(vec![1, 2, 3]); // Rc: contador de referencias sin protección entre hilos
        let copia = Rc::clone(&datos);
        let hilo = thread::spawn(move || println!("{copia:?}"));
        hilo.join().unwrap();
    }
    rustcerror[E0277]: `Rc<Vec<i32>>` cannot be sent between threads safely
       --> hilos.rs:7:30
        |
      7 |     let hilo = thread::spawn(move || println!("{copia:?}"));
        |                ------------- -------^^^^^^^^^^^^^^^^^^^^^^
        |                |             |
        |                |             `Rc<Vec<i32>>` cannot be sent between threads safely
        |                |             within this `{closure@hilos.rs:7:30: 7:37}`
        |                required by a bound introduced by this call

    Basta con cambiar Rc por Arc, su versión con contador atómico, para que compile y funcione. La comunidad lo llama «concurrencia sin miedo» (fearless concurrency): no porque sea fácil, sino porque los errores salen al compilar y no en producción.

    Y además

    • Abstracciones de coste cero (zero-cost abstractions): los iteradores, los genéricos y los traits (las interfaces de Rust) se compilan a un código tan rápido como si se hubiera escrito a mano.
    • unsafe como excepción visible: cuando hace falta saltarse las reglas, por ejemplo para hablar con el hardware, se marca el bloque con unsafe. El riesgo no desaparece, pero queda acotado a unas pocas líneas fáciles de revisar.
    • Cargo: el gestor de paquetes y de compilación viene incluido, con un repositorio común, crates.io. En C y C++ no hay nada equivalente que use todo el mundo.
    • Mensajes de error que enseñan: como se ve arriba, el compilador explica el problema y casi siempre propone cómo arreglarlo.

    El precio es una curva de aprendizaje empinada: al principio, el borrow checker rechaza programas que en otros lenguajes funcionarían, y hay que aprender a pensar como él. Y el compilador tampoco es infalible: hace poco se descubrió que tenía un agujero de casi 11 años que dejaba compilar código que leía memoria ya liberada.

    Por qué tanta gente lo quiere

    En la encuesta de Stack Overflow a desarrolladores, Rust ha sido el lenguaje más admirado (antes, «el más querido») año tras año desde 2016. En la de 2025, el 72 % de quienes lo usan quería seguir haciéndolo, por delante de Gleam (70 %), Elixir (66 %) y Zig (64 %).

    Y los datos de seguridad le dan la razón. Microsoft calcula que el 70 % de las vulnerabilidades de su código vienen de errores de memoria. Google, que lleva años escribiendo en Rust las partes nuevas de Android, publicó en noviembre de 2025 que los fallos de memoria habían bajado por primera vez del 20 % de todas las vulnerabilidades de Android, cuando hace pocos años pasaban del 70 %. Según Google, el código en Rust tiene unas 1,000 veces menos vulnerabilidades de memoria por línea que el de C y C++. Además, sus cambios se revierten unas 4 veces menos y pasan un 25 % menos de tiempo en revisión.

    Rust en Linux: de experimento a pieza fija

    Linus Torvalds aceptó Rust en el kernel con Linux 6.1, publicado el 11 de diciembre de 2022, como un experimento: solo la infraestructura básica, para ver si funcionaba. No fue un camino tranquilo: hubo discusiones duras entre quienes mantienen el código en C y quienes empujaban Rust, y algún abandono sonado.

    Tres años después, el experimento se dio por terminado. En la cumbre de mantenedores del kernel de diciembre de 2025, en Tokio, se acordó quitarle la etiqueta de experimental, y Miguel Ojeda, que dirige el proyecto Rust for Linux, lo dejó por escrito en el parche que cerraba la etapa: «Rust is here to stay» (Rust ha venido para quedarse). Según LWN, los móviles con Android 16 y el kernel 6.12 ya usan un módulo del kernel escrito en Rust (ashmem). Además, Linux 6.18 incorporó Binder, el sistema con el que se comunican las aplicaciones de Android, reescrito en Rust, y hay drivers gráficos en camino: Nova, para las tarjetas de NVIDIA, y Tyr, para las GPU Mali de Arm.

    Fuera del kernel, el cambio es aún más visible. Ubuntu 26.10 usa ya por completo uutils, una reimplementación en Rust de las órdenes básicas como cp, mv o rm, que estaban escritas en C desde hace décadas. Y herramientas clásicas se reescriben en Rust por velocidad, como el enlazador mold 3.0.

    La perspectiva es de crecimiento, pero lento y por capas. Rust sigue siendo una parte pequeña del kernel, y nadie plantea reescribir los más de 30 años de código en C que ya funcionan. Lo que sí está cambiando es dónde se escribe el código nuevo: drivers nuevos, sobre todo en gráficos, y piezas expuestas a datos de fuera, donde un fallo de memoria es más peligroso. El propio parche de Ojeda lo resume: hay Rust en producción, pero «queda muchísimo trabajo por hacer en todas las áreas».

    Rust y la programación con IA

    La llegada de los asistentes de IA ha dado a Rust un argumento inesperado. Un modelo de lenguaje escribe código que parece correcto y a veces no lo es, y en C o C++ un error de memoria puede pasar todas las pruebas y explotar meses después. En Rust, buena parte de esos errores se detecta al compilar, y el compilador explica qué falla. Para un agente de IA, que puede compilar, leer el error y corregir en bucle, eso es una ventaja enorme: el compilador hace de revisor estricto y gratuito. Hay investigación reciente que va más allá, como la «compilación generativa» de ETH Zúrich y Berkeley, que consulta al compilador mientras el modelo todavía está escribiendo, en vez de al final, y consigue que salgan menos programas que no compilan.

    La IA también puede acelerar la migración desde C. La agencia de investigación militar de Estados Unidos, DARPA, tiene un programa llamado TRACTOR (Translating All C to Rust) para traducir C a Rust de forma automática, apoyado en modelos de lenguaje. En diciembre de 2025, un ingeniero distinguido de Microsoft, Galen Hunt, causó revuelo al publicar como objetivo de su equipo «un ingeniero, un mes, un millón de líneas de código» traducidas con IA. Después aclaró que es un proyecto de investigación y que Windows no se está reescribiendo en Rust.

    Y el propio mundo de la IA ya se apoya en Rust. OpenAI reescribió en Rust su herramienta de programación en terminal, Codex CLI, en 2025, entre otras cosas para que se instale sin depender de Node.js. En decodigo hemos visto los dos lados: ArtCraft rehízo en Rust, con ayuda de Claude, trece aplicaciones de escritorio en dos semanas, y en nuestra comparación de Go y Rust en la época de la IA medimos lo que cuesta cada uno al compilar, al ejecutar y al mantener.

    No es magia: un programa que compila en Rust puede seguir haciendo algo distinto de lo que se quería, y el código generado con IA abusa a veces de unsafe o de copias innecesarias. Pero cuando la IA escribe más código del que nadie puede revisar línea a línea, un lenguaje que descarta por sí solo una familia entera de fallos tiene mucho a su favor.

    Ferris, el cangrejo mascota de Rust, en versión hinchable transparente con tubos de luz morados y rosas, colgado sobre las mesas de la zona de Rust del congreso 38C3
    Ferris, el cangrejo que hace de mascota no oficial de Rust (por eso sus usuarios se llaman rustaceans), en la zona de Rust del congreso 38C3 del Chaos Computer Club, en Hamburgo, en diciembre de 2024. Foto: Igloo22225, CC BY 4.0, Wikimedia Commons.

    Veinte años después de aquel ascensor, Rust ha pasado de proyecto personal a lenguaje de los sistemas que no se pueden permitir fallar. No va a sustituir a C de la noche a la mañana, y su dificultad sigue espantando a mucha gente. Pero cada vez más código nuevo de Linux, de Android y de las propias herramientas de IA se escribe en él. Si quieres probarlo, tenemos un curso de Rust desde cero con ejemplos probados y un test de 24 preguntas para ver cuánto sabes.

    Fuentes: Clive Thompson, «How Rust went from a side project to the world’s most-loved programming language», MIT Technology Review (14 de febrero de 2023): el ascensor, el nombre, el patrocinio de Mozilla y las cifras de Microsoft; Mozilla, Quantum CSS (Stylo); Rust Foundation; Linux 6.1 en kernelnewbies; LWN, «The state of the kernel Rust experiment» y la crónica de la cumbre de mantenedores; Google, «Rust in Android: move fast and fix things» (13 de noviembre de 2025); encuesta de Stack Overflow 2025; «Generative Compilation» (Mündler-Sasahara, Venev, Song, Vechev y He, 2026); DARPA TRACTOR; InfoWorld sobre Microsoft y Rust; InfoQ sobre Codex CLI. Los programas se compilaron con rustc 1.96.1 (edición 2024) y los errores y salidas son los reales. Esquemas: decodigo.com.

    El algoritmo A*: cómo encontrar el camino más corto sin explorar todo el mapa, con animación

    Portada: el mapa de ejemplo resuelto por A*, con las casillas exploradas en gris y el camino más corto en azul de la salida verde a la meta roja

    Un personaje de videojuego que rodea una pared para llegar hasta ti, un robot que cruza un almacén esquivando estanterías, un programa que resuelve un laberinto: detrás de muchos de ellos está el mismo algoritmo, A* (se lee «A estrella»). Su truco es sencillo: en vez de explorar a ciegas en todas direcciones, en cada paso mira cuánto ha recorrido y cuánto le falta, y avanza por donde promete. Aquí lo verás buscar en un mapa que tú mismo puedes dibujar, y compararlo con otros dos métodos.

    Un robot que necesitaba moverse

    A finales de los años sesenta, en el Stanford Research Institute (hoy SRI International), un equipo construía Shakey, el primer robot móvil capaz de razonar sobre lo que hacía. Para moverse por sus salas necesitaba planificar rutas, y de ahí salió A*. Nils Nilsson propuso primero usar un método ya existente, Graph Traverser; Bertram Raphael sugirió puntuar cada posición sumando lo ya recorrido y una estimación de lo que faltaba, y Peter Hart puso la base matemática: demostró en qué condiciones el método encuentra siempre el camino más corto. Los tres lo publicaron en 1968 con el título «A Formal Basis for the Heuristic Determination of Minimum Cost Paths».

    Partían de un algoritmo anterior, el de Edsger Dijkstra. Dijkstra lo ideó en 1956, según contó, sentado en la terraza de un café de Ámsterdam mientras iba de compras con su novia: «un invento de veinte minutos», hecho sin papel ni lápiz. Lo usó para calcular rutas en un mapa simplificado de 64 ciudades de los Países Bajos en el ordenador ARMAC, y lo publicó en 1959. Encuentra siempre el camino más corto, pero sin ninguna pista de hacia dónde está la meta.

    La idea: lo recorrido más lo que falta

    Los tres métodos de este artículo funcionan igual por fuera. Tienen una cola de casillas pendientes, empezando por la salida. En cada paso sacan de la cola la casilla más prometedora, la exploran y meten en la cola sus vecinas libres. Lo único que cambia es qué entienden por «más prometedora»:

    • Dijkstra elige la casilla más cercana a la salida. Avanza como una mancha de aceite, igual hacia todos lados, y por eso explora muchísimo.
    • La búsqueda voraz elige la que parece más cercana a la meta. Va derecha hacia ella, pero no tiene en cuenta lo que lleva recorrido, y se puede meter en un callejón y acabar con un camino más largo.
    • A* suma las dos cosas: f = g + h, donde g son los pasos recorridos desde la salida y h una estimación de los que faltan hasta la meta.

    En una cuadrícula en la que solo se puede ir arriba, abajo, a la izquierda y a la derecha, la estimación más habitual es la distancia Manhattan: las columnas más las filas que separan una casilla de la meta, como si no hubiera muros. Se llama así por las calles en cuadrícula de Nueva York, donde no se puede cortar en diagonal.

    f = g + hg = 4pasos ya recorridos desde la salidah = 3lo que falta, sin contar los murosf = 7lo mínimo que cuesta pasar por aquí
    Para la casilla en ámbar, g cuenta los pasos que ya se han dado (en verde) y h los que faltan en línea recta, como si el muro no estuviera (en rojo). Por eso f = 7 es lo mínimo que puede costar un camino que pase por ahí. Esquema: decodigo.com.

    Pruébalo

    Elige un algoritmo y un mapa, y pulsa «Paso» para ver cada casilla explorada o «Reproducir» para verlas seguidas. Con el ratón puedes dibujar muros directamente sobre la cuadrícula; en el móvil, elige antes una herramienta (pulsa otra vez para soltarla y que la página vuelva a desplazarse). «Salida» y «Meta» las mueven a la casilla que toques. Debajo de la cuadrícula verás cómo les va a los tres algoritmos en el mapa que tengas en ese momento.

    Algoritmo:
    Mapa:
    Editar:
    • salida
    • meta
    • en la cola
    • explorada
    • explorando
    • muro

      Prueba el mapa «Vacío» con los tres: Dijkstra explora un rombo cada vez más grande hasta tocar la meta; A* y la voraz van casi en línea recta. Después, cierra con muros el lado derecho de la bolsa y verás que la voraz se mete dentro antes de darse cuenta. En el «Laberinto», en cambio, las tres exploran casi lo mismo: cuando solo hay un camino posible, ninguna pista ayuda mucho.

      Tres formas de buscar, el mismo mapa

      Este es el mapa con el que empieza la animación, en su versión pequeña: una bolsa abierta hacia la salida, justo entre ella y la meta. Los números salen del programa de Python que hay más abajo.

      Dijkstra17 pasos · 125 exploradasLo más corto, pero explora casi todoA*17 pasos · 28 exploradasLo más corto, explorando pocoVoraz21 pasos · 27 exploradasExplora poco, pero el camino es más largo
      En gris, las casillas que explora cada algoritmo antes de llegar a la meta; en azul, el camino que devuelve. Dijkstra y A* encuentran un camino de 17 pasos, pero A* explora 28 casillas y Dijkstra 125. La voraz explora 27, pero se mete en la bolsa y su camino tiene 21 pasos. Esquemas: decodigo.com.

      Por qué A* no se equivoca

      La garantía de A* depende de una condición: que la estimación h no exagere nunca, es decir, que nunca diga que faltan más pasos de los que de verdad faltan. A esa estimación se le llama admisible. La distancia Manhattan lo es en esta cuadrícula, porque un muro solo puede alargar el camino, nunca acortarlo. Con una h admisible, A* nunca da por bueno un camino más largo que el óptimo: mientras quede en la cola una casilla que podría llevar a algo mejor, su f será menor y la explorará antes.

      Si además la estimación es consistente (al dar un paso, h no baja más de lo que cuesta ese paso, algo que la distancia Manhattan también cumple), A* no necesita explorar ninguna casilla dos veces. Y en 1985, Rina Dechter y Judea Pearl demostraron que, con una h consistente y salvo casos rebuscados, ningún método de su misma familia que garantice el camino óptimo puede explorar menos casillas.

      Los dos extremos también encajan en la fórmula: Dijkstra es A* con h = 0, una estimación que no ayuda pero que tampoco exagera, así que sigue siendo exacto. La voraz es lo contrario: solo mira h, y pierde la garantía. Si la cuadrícula permitiera moverse en diagonal, la distancia Manhattan dejaría de valer, porque exageraría, y habría que usar otra estimación, como la distancia en línea recta.

      Este programa en Python hace las tres búsquedas con la biblioteca estándar, usando heapq como cola de prioridad. Cada entrada de la cola lleva la prioridad, un desempate (a igual f, A* prefiere la casilla más cercana a la meta) y un contador para que, en caso de empate total, salga primero la que entró antes:

      """A*, Dijkstra y búsqueda voraz en una cuadrícula, solo con la biblioteca estándar."""
      import heapq
      
      MAPA = """
      ..................
      ..........#.......
      .S........#.......
      ..........#.......
      .....######.......
      ..................
      ..................
      .............G....
      ..................
      """
      
      
      def leer(texto):
          filas = texto.strip().splitlines()
          celdas = {(x, y): c for y, fila in enumerate(filas) for x, c in enumerate(fila)}
          muros = {p for p, c in celdas.items() if c == "#"}
          inicio = next(p for p, c in celdas.items() if c == "S")
          meta = next(p for p, c in celdas.items() if c == "G")
          return len(filas[0]), len(filas), muros, inicio, meta
      
      
      def buscar(ancho, alto, muros, inicio, meta, modo="astar"):
          def h(p):  # distancia Manhattan: sin diagonales, nunca sobrestima lo que falta
              return abs(p[0] - meta[0]) + abs(p[1] - meta[1])
      
          def prioridad(g, p):
              if modo == "dijkstra":
                  return (g, 0)            # solo lo recorrido
              if modo == "voraz":
                  return (h(p), h(p))      # solo lo que falta
              return (g + h(p), h(p))      # A*: f = g + h; con empate, la más cercana a la meta
      
          g, padre, vistas, orden = {inicio: 0}, {}, set(), []
          cola, turno = [(*prioridad(0, inicio), 0, inicio)], 1
          while cola:
              actual = heapq.heappop(cola)[-1]
              if actual in vistas:
                  continue                 # entrada vieja: ya se expandió con un coste menor
              vistas.add(actual)
              orden.append(actual)
              if actual == meta:
                  break
              x, y = actual
              for v in ((x, y - 1), (x + 1, y), (x, y + 1), (x - 1, y)):
                  if not (0 <= v[0] < ancho and 0 <= v[1] < alto) or v in muros or v in vistas:
                      continue
                  if g[actual] + 1 < g.get(v, float("inf")):
                      g[v], padre[v] = g[actual] + 1, actual
                      heapq.heappush(cola, (*prioridad(g[v], v), turno, v))
                      turno += 1
          if meta not in vistas:
              return None, orden
          camino = [meta]
          while camino[-1] != inicio:
              camino.append(padre[camino[-1]])
          return camino[::-1], orden
      
      
      def dibujar(ancho, alto, muros, inicio, meta, camino, orden):
          filas = []
          for y in range(alto):
              fila = ""
              for x in range(ancho):
                  p = (x, y)
                  fila += ("S" if p == inicio else "G" if p == meta else "#" if p in muros
                           else "*" if p in camino else "·" if p in orden else ".")
              filas.append(fila)
          return "\n".join(filas)
      
      
      if __name__ == "__main__":
          ancho, alto, muros, inicio, meta = leer(MAPA)
          print(f"Mapa de {ancho}×{alto}, de {inicio} a {meta}\n")
          for modo, nombre in (("dijkstra", "Dijkstra"), ("astar", "A*"), ("voraz", "Voraz")):
              camino, orden = buscar(ancho, alto, muros, inicio, meta, modo)
              print(f"{nombre:9} camino de {len(camino) - 1} pasos, {len(orden)} casillas exploradas")
          for modo, nombre in (("astar", "A*"), ("voraz", "Voraz")):
              camino, orden = buscar(ancho, alto, muros, inicio, meta, modo)
              print(f"\n{nombre} (* camino, · explorada):")
              print(dibujar(ancho, alto, muros, inicio, meta, camino, orden))
      salidaMapa de 18×9, de (1, 2) a (13, 7)
      
      Dijkstra  camino de 17 pasos, 125 casillas exploradas
      A*        camino de 17 pasos, 28 casillas exploradas
      Voraz     camino de 21 pasos, 27 casillas exploradas
      
      A* (* camino, · explorada):
      ..................
      ..........#.......
      .S***·····#.......
      ....*·····#.......
      ....*######.......
      ....**********....
      .............*....
      .............G....
      ..................
      
      Voraz (* camino, · explorada):
      .........*****....
      ........·*#..*....
      .S********#..*....
      ......····#..*....
      .....######..*....
      .............*....
      .............*....
      .............G....
      ..................

      Hemos comprobado que la animación de arriba hace exactamente las mismas cuentas: en 601 mapas, el de este ejemplo y 600 al azar de distintos tamaños y con distinta cantidad de muros, explora las mismas casillas, en el mismo orden, y devuelve el mismo camino que el programa de Python con los tres algoritmos. Además, A* y Dijkstra dieron siempre el camino más corto, y la voraz dio uno más largo en 59 de esos mapas.

      Dónde se usa

      A* es el método clásico para que los personajes de los videojuegos encuentren su camino, normalmente sobre una cuadrícula o una red de puntos por los que se puede pasar. También se usa en robótica, donde nació, para planificar trayectorias. En los navegadores de carretera, con mapas de millones de cruces, los sistemas actuales suelen preferir métodos que preparan el mapa de antemano y luego responden mucho más rápido, aunque muchos siguen siendo parientes de A* y de Dijkstra.

      Su punto débil es la memoria: guarda todas las casillas que ha visto, y en problemas enormes eso no cabe. De ahí salieron variantes que gastan menos memoria a cambio de repetir trabajo, como IDA*.

      Si te gustan los algoritmos que se entienden mejor viéndolos, tenemos más con animación: el código Huffman, que comprime un texto dando menos bits a las letras más usadas, el algoritmo de Myers, con el que Git encuentra las diferencias entre dos archivos, los epiciclos de Fourier y los boids.

      Fuentes: P. E. Hart, N. J. Nilsson y B. Raphael, «A Formal Basis for the Heuristic Determination of Minimum Cost Paths», IEEE Transactions on Systems Science and Cybernetics 4(2), 100–107 (1968); E. W. Dijkstra, «A note on two problems in connexion with graphs», Numerische Mathematik 1, 269–271 (1959); la historia de los dos algoritmos y la entrevista de Dijkstra de 2001, en Wikipedia (A* y Dijkstra); R. Dechter y J. Pearl, «Generalized best-first search strategies and the optimality of A*» (1985). El programa se ejecutó con Python 3.13 y la comparación, con Node.js 22. La animación, los esquemas y la portada: decodigo.com.
      Código Huffman: cómo se comprime un texto dando menos bits a las letras más usadas, con animación

      Código Huffman: el árbol de abracadabra, con la a en el código 0 y las demás letras con códigos de tres bits

      Cada letra de este texto ocupa en tu ordenador el mismo espacio, normalmente 8 bits. Pero no todas aparecen igual: la «e» y la «a» salen sin parar y la «k» casi nunca. ¿Y si las letras frecuentes usaran menos bits y las raras, más? Esa es la idea del código Huffman, un algoritmo de 1952 que sigue dentro de los ZIP, las imágenes PNG y JPEG y la compresión de las páginas web. Aquí lo verás construirse paso a paso con el texto que tú escribas.

      Un trabajo de clase que superó a su profesor

      En 1951, el profesor Robert Fano dio a sus alumnos de teoría de la información del MIT a elegir: hacer el examen final o un trabajo sobre un problema abierto, encontrar el código binario más eficiente posible. Fano y Claude Shannon, el padre de la teoría de la información, ya tenían un método, el código de Shannon-Fano, pero no siempre daba el mejor resultado. David Huffman, uno de los alumnos, estuvo a punto de rendirse y ponerse a estudiar para el examen cuando dio con la clave: construir el árbol al revés, de abajo arriba, empezando por los símbolos menos frecuentes. Y demostró que así el resultado es siempre el óptimo.

      Lo publicó en septiembre de 1952 con el título «A Method for the Construction of Minimum-Redundancy Codes». Más de setenta años después, sigue siendo una pieza básica de la compresión de datos.

      La idea: códigos cortos para lo frecuente

      El código Morse ya hacía algo parecido: la «E» es un solo punto y la «Q», raya-raya-punto-raya. Pero en Morse hay pausas entre letras para saber dónde acaba cada una. Con bits no hay pausas: llega una tira de ceros y unos y hay que saber cortarla. Huffman lo resuelve con un código prefijo, en el que ningún código es el principio de otro. Si la «a» es 0, ninguna otra letra puede empezar por 0, y en cuanto se lee un 0 se sabe que es una «a».

      Esos códigos salen de un árbol binario, y el algoritmo para construirlo cabe en cuatro pasos:

      1. Se cuenta cuántas veces aparece cada símbolo. Cada uno es una hoja con ese número como peso.
      2. Se meten todas las hojas en una cola ordenada de menor a mayor peso.
      3. Se sacan las dos más ligeras y se juntan bajo un nodo nuevo, cuyo peso es la suma de las dos. El nodo vuelve a la cola. Se repite hasta que solo queda uno: la raíz.
      4. Se lee el código de cada hoja recorriendo el camino desde la raíz: un 0 por cada rama a la izquierda y un 1 por cada rama a la derecha.

      Como los símbolos raros se juntan primero, acaban en lo más hondo del árbol, con códigos largos, y los frecuentes se quedan cerca de la raíz, con códigos cortos.

      El árbol de «abracadabra»0101010124611a×50c×1100d×1101b×2110r×2111La «a», que aparece 5 veces, se queda con un solo bit.
      El árbol de «abracadabra»: la «a» aparece 5 veces de 11 y se queda con el código 0; las otras cuatro letras necesitan tres bits. Calculado con el programa de Python de abajo. Esquema: decodigo.com.

      Pruébalo

      Elige un ejemplo o escribe tu propio texto, y pulsa «Paso» para ver cada unión o «Reproducir» para verlas seguidas. Arriba aparece la cola, con el peso de cada nodo; en rojo, los dos que se juntan en cada paso. Al terminar, verás el código de cada símbolo, el texto convertido en bits y cuánto ocupa comparado con los 8 bits por carácter de siempre.

      Ejemplo:

        Prueba a escribir «aaaaaaab» y luego «murciélago». En el primero, cada carácter queda en un solo bit, el mínimo posible con bits enteros, aunque el límite teórico sea de 0.544. En el segundo no se repite ninguna letra: Huffman les da códigos de 3 y 4 bits, lo mismo que necesitaría cualquier código para distinguir diez letras distintas, y el ahorro frente a los 8 bits viene solo de que el texto usa pocas letras. Huffman aprovecha que unos símbolos sean más frecuentes que otros; si todos aparecen lo mismo, no puede hacer milagros.

        Cuánto se ahorra

        Con «abracadabra», los 88 bits de siempre se quedan en 23. La clave es que, al leer, no hace falta ninguna marca entre letras:

        «abracadabra» en bitsCon 8 bits por letra88 bitsCon Huffman23 bits (26 %)Para leerlo, se avanza bit a bithasta completar un código:0a110b111r0a100c0a101d0a110b111r0aNingún código es el principio de otro,así que no hace falta separarlos.
        Arriba, lo que ocupa «abracadabra» con 8 bits por letra y con los códigos de Huffman, a la misma escala; abajo, cómo se cortan los 23 bits al leerlos. Esquema: decodigo.com.

        Este programa en Python hace todo el proceso con la biblioteca estándar: cuenta los símbolos, construye el árbol con una cola de prioridad (heapq), saca los códigos, codifica el texto, lo decodifica para comprobar que sale igual y lo compara con el límite teórico:

        from collections import Counter
        import heapq
        import math
        
        
        def huffman(texto):
            """Devuelve las frecuencias de cada símbolo y su código de Huffman."""
            frec = Counter(texto)
            # Cada nodo de la cola es (peso, orden, contenido). El orden deshace los
            # empates: primero las hojas, de menos a más frecuentes, y después los
            # nodos nuevos en el orden en que se crean.
            hojas = sorted(frec.items(), key=lambda x: (x[1], x[0]))
            cola = [(f, i, s) for i, (s, f) in enumerate(hojas)]
            heapq.heapify(cola)
            orden = len(cola)
            while len(cola) > 1:
                a = heapq.heappop(cola)          # los dos nodos más ligeros
                b = heapq.heappop(cola)
                heapq.heappush(cola, (a[0] + b[0], orden, (a, b)))
                orden += 1
        
            codigos = {}
        
            def recorre(nodo, prefijo):
                contenido = nodo[2]
                if isinstance(contenido, tuple):   # nodo interno: 0 a la izquierda, 1 a la derecha
                    recorre(contenido[0], prefijo + "0")
                    recorre(contenido[1], prefijo + "1")
                else:
                    codigos[contenido] = prefijo or "0"
        
            recorre(cola[0], "")
            return frec, codigos
        
        
        def decodifica(bits, codigos):
            inverso = {c: s for s, c in codigos.items()}
            texto, actual = [], ""
            for b in bits:
                actual += b
                if actual in inverso:              # ningún código es el principio de otro
                    texto.append(inverso[actual])
                    actual = ""
            return "".join(texto)
        
        
        def informe(texto):
            frec, codigos = huffman(texto)
            n = len(texto)
            bits = "".join(codigos[s] for s in texto)
            entropia = -sum(f / n * math.log2(f / n) for f in frec.values())
            print(f"Texto: {texto!r} ({n} caracteres, {len(frec)} distintos)")
            print("símbolo  veces  código")
            for s, f in sorted(frec.items(), key=lambda x: (-x[1], x[0])):
                print(f"  {s!r:5}  {f:5}   {codigos[s]}")
            print(f"Con 8 bits por carácter: {8 * n} bits")
            print(f"Con Huffman: {len(bits)} bits ({len(bits) / n:.3f} por carácter, "
                  f"{100 * len(bits) / (8 * n):.1f} % del original)")
            print(f"Límite de Shannon (entropía): {entropia:.3f} bits por carácter")
            print(f"Se decodifica bien: {decodifica(bits, codigos) == texto}")
            print()
            return bits
        
        
        bits = informe("abracadabra")
        print("abracadabra codificado:", bits)
        print()
        informe("en un lugar de la mancha de cuyo nombre no quiero acordarme")
        salidaTexto: 'abracadabra' (11 caracteres, 5 distintos)
        símbolo  veces  código
          'a'        5   0
          'b'        2   110
          'r'        2   111
          'c'        1   100
          'd'        1   101
        Con 8 bits por carácter: 88 bits
        Con Huffman: 23 bits (2.091 por carácter, 26.1 % del original)
        Límite de Shannon (entropía): 2.040 bits por carácter
        Se decodifica bien: True
        
        abracadabra codificado: 01101110100010101101110
        
        Texto: 'en un lugar de la mancha de cuyo nombre no quiero acordarme' (59 caracteres, 17 distintos)
        símbolo  veces  código
          ' '       11   111
          'a'        6   001
          'e'        6   010
          'n'        5   1100
          'o'        5   1101
          'r'        5   000
          'u'        4   1001
          'c'        3   0110
          'd'        3   0111
          'm'        3   1000
          'l'        2   10100
          'b'        1   101010
          'g'        1   101011
          'h'        1   101100
          'i'        1   101101
          'q'        1   101110
          'y'        1   101111
        Con 8 bits por carácter: 472 bits
        Con Huffman: 222 bits (3.763 por carácter, 47.0 % del original)
        Límite de Shannon (entropía): 3.710 bits por carácter
        Se decodifica bien: True

        La última línea de cada bloque es la más interesante. En 1948, Shannon demostró que hay un límite para lo que se puede comprimir un mensaje sin perder información: la entropía, que depende solo de las frecuencias de los símbolos. Para «abracadabra» es de 2.040 bits por carácter, y Huffman consigue 2.091; para la frase del Quijote, 3.710 frente a 3.763. Huffman es el mejor código posible que asigna a cada símbolo un número entero de bits, y por eso se queda siempre a menos de un bit por símbolo del límite.

        Hemos comprobado que la animación de arriba hace exactamente las mismas cuentas: en 300 textos, los tres de ejemplo y casi trescientos al azar con muchos empates, da los mismos códigos que el programa de Python, y todos se decodifican sin error.

        Dónde está Huffman hoy

        Casi nunca va solo. El formato DEFLATE, el de los archivos ZIP, gzip y las imágenes PNG, combina dos ideas: primero, el algoritmo LZ77 sustituye los trozos repetidos por referencias a donde ya aparecieron («copia los 12 caracteres de hace 300 posiciones»), y después Huffman comprime el resultado. Brotli, el formato de Google con el que viajan comprimidas muchas páginas web, usa la misma combinación de LZ77 y Huffman, más un modelo que tiene en cuenta el contexto de cada símbolo. Y el JPEG clásico usa códigos de Huffman en su último paso, después de quedarse con lo que el ojo nota de cada bloque de la imagen.

        Precisamente, en el descompresor de Brotli acaba de aparecer un fallo crítico, Node2Shell, en la parte que lee esas estructuras: un recordatorio de que, por elegante que sea un algoritmo, el código que lo implementa también tiene que comprobar que los datos que recibe tienen sentido.

        Si te gustan los algoritmos que se entienden mejor viéndolos, tenemos más con animación: los epiciclos de Fourier, que dibujan cualquier figura con círculos que giran, el algoritmo de Myers con el que Git encuentra las diferencias entre dos archivos, el juego del caos y los boids.

        Fuentes: D. A. Huffman, «A Method for the Construction of Minimum-Redundancy Codes», Proceedings of the IRE 40(9), 1098–1101 (1952); la historia del trabajo de clase, en Wikipedia; C. E. Shannon, «A Mathematical Theory of Communication» (1948); DEFLATE, RFC 1951; Brotli, RFC 7932; JPEG, ITU-T T.81. El programa se ejecutó con Python 3.13 y la comparación, con Node.js 24. La animación, los esquemas y la portada: decodigo.com.
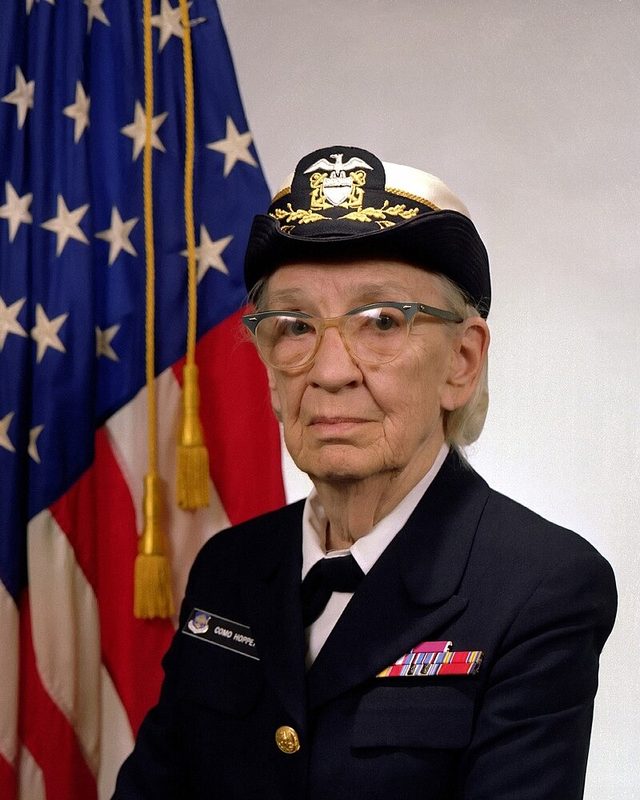
        Epiciclos de Fourier: cómo dibujar cualquier figura con círculos que giran, con animación

        Una cadena de círculos que giran dibuja un corazón, con el título: Dibujar cualquier figura con círculos que giran

        Coge una cadena de círculos, haz que cada uno gire sobre la punta del anterior a su propia velocidad y fíjate en la punta del último: puede dibujar un corazón, una estrella o tu firma. No es un truco de ilustrador, sino una de las ideas más útiles de las matemáticas: la transformada de Fourier, la que dice que cualquier forma (o cualquier sonido) se puede descomponer en movimientos circulares sencillos. Aquí la verás funcionar con tus propios dibujos.

        De los planetas a la fórmula de Fourier

        La idea de explicar un movimiento complicado con círculos que giran sobre otros círculos tiene más de dos mil años. Los astrónomos griegos, de Apolonio de Perga a Hiparco y, sobre todo, Claudio Ptolomeo, la usaron para explicar por qué los planetas a veces parecen ir hacia atrás en el cielo: cada planeta giraba en un círculo pequeño, el epiciclo, cuyo centro giraba a su vez en uno grande alrededor de la Tierra. El modelo estaba equivocado sobre lo que pasa en el cielo, pero acertaba en algo: con suficientes círculos se puede imitar casi cualquier recorrido.

        La explicación de por qué llegó en 1822, cuando Joseph Fourier publicó Théorie analytique de la chaleur. Estudiando cómo se reparte el calor en un objeto, Fourier sostuvo que cualquier función que se repite se puede escribir como una suma de ondas simples, senos y cosenos, de frecuencias cada vez más altas. Un círculo que gira es justo eso, una onda seno en horizontal y otra en vertical a la vez, así que los epiciclos de Ptolomeo eran, sin saberlo, una serie de Fourier.

        Un círculo que gira son tres números

        Para describir un círculo que gira basta con tres datos: su radio; el ángulo en el que empieza, que se llama fase, y cuántas vueltas da mientras se dibuja la figura una vez, la frecuencia k. Con k = 1 da una vuelta; con k = 2, dos; con k = −1, una vuelta en sentido contrario.

        Los matemáticos lo escriben con un solo número complejo, c, cuyo tamaño es el radio y cuyo ángulo es la fase. La posición de la punta en cada instante t, de 0 a 1, es c · e2πikt: la fórmula de Euler convierte esa exponencial en un punto que da k vueltas al círculo. No hace falta dominar los números complejos para seguir el artículo: basta con pensar en cada círculo como una flecha que gira.

        Un círculo que girafasek vueltas por vueltaradioTres números lo describen todo: el radio, elángulo en el que empieza (la fase) y cuántasvueltas da: k. Si k es negativo, gira al revés.Círculos sobre círculos1.º: k = 12.º: k = -23.º: k = 4La punta roja va dibujando la curva azul clara.
        A la izquierda, un solo círculo con su radio, su fase y su frecuencia. A la derecha, tres encadenados: cada flecha sale de la punta de la anterior, y la punta de la última dibuja la curva. Esquemas: decodigo.com.

        De la figura a los círculos

        ¿Cómo se saben los círculos que dibujan una figura concreta? Ese es el trabajo de la transformada discreta de Fourier. Los pasos son cuatro:

        1. Se recorre la figura y se toman 256 puntos a la misma distancia unos de otros. Cada punto se trata como un número complejo: la x es la parte real y la y, la imaginaria.
        2. Para cada frecuencia k, de −128 a 127, se calcula ck = (1/256) · Σ zj · e−2πikj/256. Es como hacer girar la figura en sentido contrario k veces y ver qué queda de media: si la figura tiene algo que gira a esa velocidad, sobrevive; si no, se cancela.
        3. Cada ck es un círculo: su radio es el tamaño de ck, su fase es su ángulo y da k vueltas. El de k = 0 no gira: es el centro de la figura, de donde sale la cadena.
        4. Se ordenan de mayor a menor y se encadenan. Con los 255 círculos, la punta pasa exactamente por los 256 puntos; con menos, se queda con lo esencial de la forma.

        Lo bonito es que funciona igual para cualquier figura cerrada: no hay que diseñar nada a mano.

        Pruébalo

        Elige una figura o pulsa «Dibuja la tuya» y traza algo en el recuadro, con el dedo o el ratón, sin levantarlo. Luego mueve el control de «Círculos»: con 1 solo sale un círculo, con 5 aparece la forma general y con 50 el dibujo es casi perfecto. La figura original se ve en gris claro, debajo; la línea azul es lo que llevan dibujado los círculos, y el punto rojo, la punta de la cadena. El error medio que aparece debajo mide cuánto se aleja el dibujo de la figura.

        Figura:

        Fíjate en la estrella: necesita bastantes más círculos que el corazón para que sus puntas salgan afiladas. Las esquinas son cambios bruscos de dirección, y para hacer un cambio brusco hacen falta círculos que giren muy deprisa. Con un garabato propio pasa lo mismo, y además verás que el punto rojo cruza en línea recta desde el final de tu trazo hasta el principio: la serie de Fourier siempre dibuja una figura cerrada.

        Lo que enseña un cuadrado

        El cuadrado es el mejor ejemplo para ver qué hace cada círculo. Con uno solo sale el círculo que mejor se le ajusta; con dos ya se adivinan las cuatro esquinas, y con ocho la diferencia apenas se ve:

        1 círculoerror medio: 4,7 % de la diagonal2 círculoserror medio: 1,8 % de la diagonal4 círculoserror medio: 0,6 % de la diagonal8 círculoserror medio: 0,2 % de la diagonal
        El cuadrado (gris) y lo que dibujan los círculos más grandes (azul). Calculado con el programa de Python de abajo. Esquemas: decodigo.com.

        Este programa hace el cálculo completo en Python, sin bibliotecas: reparte 256 puntos por el borde del cuadrado, calcula sus 256 coeficientes y mide el error al redibujarlo con cada vez más círculos.

        """Epiciclos de Fourier: dibujar un cuadrado con círculos que giran.
        
        Se toman 256 puntos repartidos por el borde del cuadrado, se calcula su transformada
        discreta de Fourier y cada coeficiente se convierte en un círculo: su radio es el
        módulo del coeficiente, su velocidad, la frecuencia k, y su ángulo inicial, la fase.
        """
        import cmath
        import math
        
        N = 256
        
        
        def cuadrado(n):
            """n puntos a la misma distancia unos de otros por el borde de un cuadrado de lado 2."""
            esquinas = [complex(1, 1), complex(-1, 1), complex(-1, -1), complex(1, -1)]
            puntos = []
            for i in range(n):
                s = 4 * i / n                      # recorrido: 0 a 4, un lado por unidad
                lado, f = int(s), s - int(s)
                a, b = esquinas[lado], esquinas[(lado + 1) % 4]
                puntos.append(a + (b - a) * f)
            return puntos
        
        
        def dft(z):
            """Coeficientes c_k de la serie, con k de -n/2 a n/2 - 1."""
            n = len(z)
            return {k: sum(z[j] * cmath.exp(-2j * math.pi * k * j / n) for j in range(n)) / n
                    for k in range(-n // 2, n // 2)}
        
        
        def epiciclos(c, cuantos, t):
            """Punto que dibujan el centro (k = 0) y los `cuantos` círculos más grandes en el instante t (0 a 1)."""
            orden = sorted((k for k in c if k != 0), key=lambda k: -abs(c[k]))[:cuantos]
            return c[0] + sum(c[k] * cmath.exp(2j * math.pi * k * t) for k in orden)
        
        
        z = cuadrado(N)
        c = dft(z)
        
        print("Los 8 círculos más grandes:")
        print("    k   radio    fase   radio × k²")
        for k in sorted((k for k in c if k != 0), key=lambda k: -abs(c[k]))[:8]:
            print(f"{k:5d}  {abs(c[k]):.4f}  {math.degrees(cmath.phase(c[k])):5.1f}°   {abs(c[k]) * k * k:.4f}")
        
        print()
        print("Error medio al redibujar el cuadrado (lado 2):")
        for cuantos in (1, 2, 4, 8, 16, 32, 64, 255):
            error = sum(abs(epiciclos(c, cuantos, j / N) - z[j]) for j in range(N)) / N
            print(f"{cuantos:4d} círculo{'s' if cuantos > 1 else ''}: {error:.4f}")
        
        # ¿Cuántos círculos tienen un radio que no sea prácticamente cero?
        print()
        print("Círculos que cuentan:", sum(1 for k in c if k != 0 and abs(c[k]) > 1e-9), "de", N - 1)
        salidaLos 8 círculos más grandes:
            k   radio    fase   radio × k²
            1  1.1464   45.0°   1.1464
           -3  0.1274   45.0°   1.1468
            5  0.0459   45.0°   1.1478
           -7  0.0235   45.0°   1.1491
            9  0.0142   45.0°   1.1510
          -11  0.0095   45.0°   1.1533
           13  0.0068   45.0°   1.1561
          -15  0.0052   45.0°   1.1594
        
        Error medio al redibujar el cuadrado (lado 2):
           1 círculo: 0.1317
           2 círculos: 0.0500
           4 círculos: 0.0170
           8 círculos: 0.0055
          16 círculos: 0.0017
          32 círculos: 0.0006
          64 círculos: 0.0000
         255 círculos: 0.0000
        
        Círculos que cuentan: 64 de 255

        La salida esconde dos sorpresas. La primera: de los 255 círculos posibles, solo 64 tienen un radio que no es cero, los de k = 1, −3, 5, −7, 9…, y por eso con 64 círculos el error ya es nulo. Es consecuencia de la simetría: si giras el cuadrado un cuarto de vuelta, queda igual, y eso anula todas las demás frecuencias. La segunda: el radio de cada círculo es el del primero dividido entre k², como muestra la última columna. En un cuadrado perfecto, el radio vale exactamente 8√2 / (π² · k²), es decir, 1.1463 / k²; con 256 puntos los valores se separan un poco en los círculos más pequeños.

        Los círculos del cuadrado-150,005-110,010-70,023-30,12711,14650,04690,014130,007170,004Solo hay círculos con k = 1, -3, 5, -7, 9…, y su radiocae como 1/k²: el de k = 3 mide la novena parteque el de k = 1, y el de k = 5, la vigesimoquinta.
        El radio de cada círculo del cuadrado según su frecuencia k. A esta gráfica se la llama el espectro de la figura. Esquema: decodigo.com.

        Hemos comprobado que la animación de arriba hace exactamente estas cuentas: en el cuadrado, sus coeficientes coinciden con los del programa en las 16 primeras cifras decimales, y en otras 53 figuras, las de ejemplo y 50 garabatos al azar, coinciden con los de NumPy con una diferencia máxima de menos de una billonésima.

        Por qué todo el mundo usa la transformada de Fourier

        Dibujar con círculos es la versión visual, pero la misma operación está en todas partes. Un sonido es una onda que se repite, y su transformada de Fourier dice qué frecuencias, qué notas, lo componen: es lo que muestran los ecualizadores y los afinadores. En las imágenes, el formato JPEG usa una prima cercana, la transformada discreta del coseno, para separar en cada bloque de 8 × 8 píxeles los cambios suaves de los detalles finos, y guardar con menos precisión los detalles que el ojo apenas nota.

        Todo eso sería lentísimo con el método de este artículo, que hace 256 × 256 = 65,536 multiplicaciones para 256 puntos. En 1965, James Cooley y John Tukey publicaron la transformada rápida de Fourier (FFT), que obtiene el mismo resultado con del orden de N · log₂N operaciones: unas 2,048 para 256 puntos, y para un millón de puntos, unos 20 millones en lugar de un billón. Es la versión que usa NumPy, y una de las razones por las que el audio, las imágenes y las comunicaciones digitales funcionan en tiempo real.

        Si te gustan los algoritmos que se entienden mejor viéndolos, tenemos más con animación: el algoritmo de Myers con el que Git encuentra las diferencias entre dos archivos, el juego del caos, que dibuja fractales con puntos al azar, y los boids, que imitan una bandada de pájaros con tres reglas.

        Fuentes: J. Fourier, Théorie analytique de la chaleur (París, Didot, 1822); J. W. Cooley y J. W. Tukey, «An algorithm for the machine calculation of complex Fourier series», Mathematics of Computation 19, 297–301 (1965); la norma de JPEG, ITU-T T.81; la historia de los epiciclos, en Wikipedia. La animación de los círculos que dibujan figuras la popularizó 3Blue1Brown en su vídeo «But what is a Fourier series?» (2019). El programa se ejecutó con Python 3.13 y la comparación, con NumPy 2.3.4 y Node.js 24. La animación y las imágenes, incluida la portada, las generan los propios círculos: decodigo.com.

        Go vs Rust en la época de la IA: lo medimos al compilar, al ejecutar y al mantener

        Logotipos de Go y Rust sobre fondo blanco con líneas cian y óxido detrás, y el título Go vs Rust

        Cuando un asistente de IA escribe buena parte del código, la pregunta ya no es en qué lenguaje se teclea más rápido. Importa cuánto tarda el compilador en revisar cada cambio, porque el agente repite ese ciclo decenas de veces; cuánto cuesta ejecutar lo que sale; y cuánto trabajo da mantenerlo dentro de cinco años. Para este Go vs Rust lo hemos medido con Go 1.27.3 y Rust 1.99.1, las versiones estables de hoy, escribiendo los mismos programas en los dos lenguajes y ejecutándolos en las mismas condiciones.

        Go y Rust suelen aparecer juntos en la misma conversación, aunque nacieron para cosas distintas. Go lo presentó Google en 2009 para escribir servidores y herramientas de forma sencilla, con un recolector de basura y una compilación muy rápida. Rust, impulsado por Mozilla y con su versión 1.0 en 2015, busca la velocidad de C y C++ sin sus errores de memoria, a cambio de un compilador mucho más exigente. Ya contamos en qué lenguaje elegir cuando la IA escribe el código por qué la IA favorece a los lenguajes con tipos estrictos. Aquí bajamos al detalle con números propios.

        El banco de pruebas es pequeño pero realista: una API REST de tareas en memoria, con validación, errores 400 y 404 y cuatro pruebas, escrita tres veces (Go solo con su biblioteca estándar, Go con Gin y Rust con axum). Además, tres programas clásicos de rendimiento con el mismo algoritmo en los dos lenguajes. Todo corre en contenedores con 4 núcleos de un AMD Ryzen 7 PRO 6850H, se repite varias veces y cada pareja de programas da exactamente la misma salida.

        Claves de Go vs Rust en 2026

        • En el bucle del agente, empate técnico: tras cambiar una línea, revisar los tipos tarda unos 100 ms en los dos. Compilar, 337 ms en Go y 405 ms en Rust. En un proyecto pequeño, ninguno frena a la IA.
        • Desde cero, Go vuela si no hay dependencias: la API con la biblioteca estándar compila en 0.34 s. Con Gin sube a 10.75 s, más que Rust con axum (8.48 s en debug y 10.40 s en release): lo que pesa son las dependencias.
        • Al ejecutar, Rust es más rápido y gasta menos: 1.5 veces en cálculo numérico, el doble en JSON y un 58 % más de peticiones por segundo en la API, con la tercera parte de latencia en el peor 1 % y menos de la mitad de memoria.
        • Go gasta más CPU de la que parece: en la prueba que crea millones de objetos empatan en tiempo, pero Go usa el doble de CPU porque su recolector trabaja en paralelo en otros núcleos.
        • Los frameworks de Go son más estables; los de Rust, más jóvenes: Go sirve una API con su biblioteca estándar, y Gin va por la versión 1.12. En Rust, axum (0.8), tonic (0.14) y sqlx (0.9) siguen por debajo de la 1.0.
        • Mantenimiento: Go promete que el código de Go 1 sigue compilando y mantiene cada versión un año. Rust publica una versión cada seis semanas y agrupa los cambios incompatibles en «ediciones» que conviven entre sí.

        Compilar: lo que nota un agente de IA

        Un agente de programación trabaja en bucle: escribe un cambio, compila o revisa los tipos, lee los errores, corrige y pasa las pruebas. Cada vuelta suma el tiempo del compilador. Por eso medimos dos cosas: la compilación desde cero, que es lo que pagas al clonar un proyecto o en cada ejecución de integración continua sin caché, y lo que tarda cada paso después de cambiar una sola línea.

        Compilar la API desde ceroSegundos; dependencias ya descargadas y la biblioteca estándar de Go ya compilada, como tras el primer usoGo, solo biblioteca estándarGo con GinRust con axumGo, estándar0.34 sGo con Gin10.75 sRust axum (debug)8.48 sRust axum (release)10.40 sMedia de 5 ejecuciones con hyperfine, contenedor de 4 CPU. Go 1.27.3, Rust 1.99.1, Gin 1.12.0, axum 0.8.9.
        Compilación desde cero de la misma API, con las dependencias ya descargadas. Go no trae precompilada su biblioteca estándar: la primera vez suma entre 3 y 8 s más, según los paquetes que use, y luego quedan en caché. Esquema: decodigo.com.

        La versión de Go sin dependencias compila en un tercio de segundo, y por eso Go tiene fama de compilar «al instante». Pero Gin cambia la foto: arrastra 55 módulos y su compilación limpia pasa a 10.75 s, algo más que la de Rust en release. Varios de esos módulos llegan al binario aunque la API no los use, entre ellos clientes de QUIC, protobuf y el codificador BSON de MongoDB. En Rust, axum trae 48 crates y la compilación limpia ronda los 8.5 s en debug. Esa diferencia se paga una sola vez: después, ambos guardan lo compilado en caché.

        Tras cambiar una línea: el bucle que repite un agenteMilisegundos de cada paso después de editar un manejador de la APIGo, solo biblioteca estándarGo con GinRust con axumComprobar tipos101 ms (go vet)133 ms96 ms (cargo check)Compilar337 ms723 ms405 msPasar las pruebas313 ms597 ms338 msBucle completo751 ms1.45 s926 msBucle completo: Go, go build + go vet + go test; Rust, cargo clippy + cargo build + cargo test (mediana de 10).
        Cada paso tras cambiar el texto de un error en un manejador, con un texto distinto en cada ejecución para que ninguna caché lo evite. Esquema: decodigo.com.

        En el bucle que de verdad repite un agente, la diferencia casi desaparece. cargo check, que revisa tipos y préstamos sin generar código, tarda 96 ms; go vet, 101 ms. Compilar cuesta 337 ms en Go y 405 ms en Rust, y la vuelta completa (linter, compilación y pruebas) se queda por debajo de un segundo en los dos, salvo con Gin. La sorpresa es que, en un proyecto pequeño, Rust ya no es el lenguaje lento de compilar. Ha ayudado que desde Rust 1.90 enlace por omisión con LLD, un enlazador mucho más rápido que el clásico de Linux.

        Pero hay que leerlo con cuidado: es un proyecto de unas cien líneas. En proyectos grandes, Rust escala peor. En la encuesta sobre el rendimiento del compilador que hizo el propio proyecto Rust, con más de 3,700 respuestas, la queja más repetida fue justo esta recompilación tras un cambio pequeño, y el 55 % dijo esperar más de diez segundos por ella. Go se diseñó precisamente para compilar deprisa bases de código enormes, y en Rust lo normal es partir el proyecto en varias crates para que cada cambio recompile poco. Si el agente compila en release para medir rendimiento, también se nota: 1.36 s en Rust por cada cambio, sin compilación incremental.

        Por qué la IA se lleva bien con el compilador de Rust: sus mensajes señalan la línea, explican la causa y a menudo proponen el arreglo, así que un agente corrige solo la mayoría de los errores. Go es menos exigente: deja pasar más fallos a las pruebas, pero produce un código tan uniforme que es fácil de revisar. En la encuesta de Go de 2025, el 53 % de los desarrolladores dijo que el principal problema de las herramientas de IA es que generan código que no funciona.

        Ejecutar: Rust gana, aunque no siempre por lo que parece

        Para la velocidad usamos tres programas clásicos, escritos de forma idiomática y sin trucos de bajo nivel en ninguno de los dos lenguajes: n-body, que simula cinco planetas con cálculo en coma flotante; binary-trees, que crea y libera millones de pequeños objetos, y un tercero que convierte un millón de objetos a JSON (99 MB) y los vuelve a leer.

        Ejecutar: los mismos programas, el mismo algoritmoSegundos (menos es mejor); entre paréntesis, la memoria máximaGo 1.27.3Rust 1.99.1n-body, 50 M pasos3.06 s1.99 sbinary-trees 21, tiempo real10.28 s (249 MB)10.34 s (258 MB)binary-trees 21, CPU gastada21.0 s (el recolector usa otros núcleos)10.2 sJSON, 1 M de objetos1.50 s (736 MB)0.76 s (588 MB)Media de 5 ejecuciones tras 1 de calentamiento, contenedor de 4 CPU. Salidas idénticas en los dos lenguajes (md5).
        Programas compilados con las opciones normales de cada lenguaje: go build y cargo build –release. Rust usa el asignador de memoria del sistema, sin arenas ni asignadores especiales. Esquema: decodigo.com.
        • Cálculo puro: Rust termina n-body en 1.99 s y Go en 3.06 s. El compilador de Rust, basado en LLVM, optimiza más a fondo este tipo de bucles numéricos.
        • Muchos objetos pequeños: empatan en tiempo (unos 10.3 s), pero Go lo consigue porque su recolector de basura trabaja en paralelo en los otros núcleos: gasta 21 s de CPU frente a 10.2 s. Con un único núcleo, Go tarda 18.5 s. En un servidor compartido, esa CPU extra la pagas igual.
        • JSON: serde_json hace el viaje completo en 0.76 s; Go, en 1.50 s con encoding/json y 1.42 s con el nuevo encoding/json/v2, que Go 1.27 ya incluye y que, según sus notas, lee JSON bastante más rápido. Rust también usa menos memoria: 588 MB frente a 736 MB.
        Servir la API: peticiones por segundoGET /tasks/1 con wrk, 64 conexiones durante 30 s; el servidor, limitado a 2 núcleosGo, solo biblioteca estándarGo con GinRust con axumGo, estándar64,739 /s · p99 2.72 ms · 14 MBGo con Gin63,188 /s · p99 3.26 ms · 20 MBRust axum101,979 /s · p99 0.94 ms · 5.8 MBMediana de 3 tandas de 30 s. Memoria del servidor durante la carga. Sin base de datos: mide solo el servidor HTTP y el JSON.
        La API de tareas respondiendo GET /tasks/1. El generador de carga, wrk, corre en otro contenedor y en otros núcleos; con el doble de núcleos para él, las cifras no cambian, así que el límite era el servidor. Esquema: decodigo.com.

        Sirviendo la API, axum atiende unas 102,000 peticiones por segundo con dos núcleos, frente a unas 65,000 de Go. La mayor diferencia está en la cola: el 1 % de respuestas más lentas tarda menos de 1 ms en Rust y casi 3 ms en Go, porque no hay recolector que interrumpa. Y el proceso de Rust ocupa 5.8 MB en plena carga, frente a 14 MB de Go y 20 MB con Gin. Gin, por cierto, no aporta velocidad: rinde igual que la biblioteca estándar. Conviene no exagerar estas cifras: la prueba no toca ninguna base de datos, que en una aplicación real suele ser lo que más tarda.

        Frameworks maduros: la ventaja de la biblioteca estándar

        • Servidor HTTP y API. Go: net/http de la biblioteca estándar, con rutas por método y parámetro desde Go 1.22; y si se quiere framework, Gin 1.12, Echo 5.4, Chi 5.5 o Fiber 3.6. Rust: axum 0.8, del equipo de Tokio, y Actix Web 4.17; Rocket sigue en la 0.5.1, de mayo de 2024.
        • Ejecución asíncrona. Go: incluida en el lenguaje, con gorutinas y canales. Rust: Tokio 1.54, con versiones de soporte largo (la 1.51 hasta marzo de 2027 y la 1.53 hasta septiembre de 2027).
        • JSON. Go: encoding/json, v1 y v2, en la biblioteca estándar. Rust: serde 1.0 y serde_json 1.0, el estándar de hecho.
        • gRPC. Go: grpc-go 1.84. Rust: tonic 0.14.
        • Bases de datos. Go: database/sql en la estándar y GORM 1.31. Rust: sqlx 0.9 y Diesel 2.3.
        • Dependencias de nuestra API. Go: ninguna con la estándar y 55 módulos con Gin. Rust: 48 crates con axum.

        La gran baza de Go es que no necesitas un framework: su biblioteca estándar trae servidor HTTP, JSON, pruebas, criptografía y acceso a bases de datos, todo con la misma promesa de compatibilidad que el lenguaje. Nuestra API con la estándar ocupa 121 líneas, más o menos lo mismo que con Gin (113). En Rust casi todo vive en crates de la comunidad, muy buenas y muy usadas, pero varias piezas centrales del ecosistema web siguen por debajo de la 1.0. En el versionado semántico eso significa que cada versión «menor» puede romper la compatibilidad: pasar de axum 0.7 a 0.8 obligó a reescribir las rutas, de /:id a /{id}, entre otros cambios. Los cimientos sí son estables: Tokio, serde, hyper y clap ya pasaron la 1.0 hace años.

        Para la IA esto tiene doble filo. Los modelos han visto muchísimo código de net/http, que apenas cambia; con crates que rompen su API entre versiones es más fácil que el asistente mezcle la sintaxis de una versión vieja con la nueva. El compilador de Rust lo detecta al instante, pero es una vuelta más del bucle.

        Mantenimiento: estabilidad frente a evolución

        • Compatibilidad. Go se compromete a que los programas escritos para Go 1 sigan compilando y funcionando sin cambios. Rust lo consigue de otra forma: los cambios incompatibles van en «ediciones» (2015, 2018, 2021 y 2024, esta última desde Rust 1.85) que cada crate elige, y crates de ediciones distintas funcionan juntas.
        • Ritmo de versiones. Go saca dos versiones al año y corrige cada una hasta que salen dos más nuevas, así que tienes un año para actualizar. Rust publica una versión estable cada seis semanas y espera que actualices; su lema es «estabilidad sin estancamiento».
        • Un solo estilo. Los dos traen formateador oficial (gofmt y rustfmt) y analizador (go vet y Clippy). Go añade una gramática mínima con pocas formas de hacer lo mismo, lo que facilita revisar código que no has escrito, generado o no.
        • Despliegue. Los dos generan un único ejecutable. El de Rust es mucho más pequeño: 1.4 MB para nuestra API, frente a 6.7 MB con Go y 21.6 MB con Gin, ya sin símbolos de depuración.
        • Herramientas para agentes. El servidor de lenguaje de Go, gopls, incluye desde la versión 0.20 un servidor MCP experimental para que asistentes como Claude Code o Gemini CLI consulten el código. En Rust, rust-analyzer da a los editores esa misma información, y los mensajes del compilador hacen buena parte del trabajo.

        Cuál conviene cuando el código lo escribe una IA

        La IA ha borrado la ventaja más visible de Go, que era lo fácil que resulta escribirlo: el código de Rust, más largo y exigente, ahora también lo genera la máquina, y su compilador se convierte en un revisor incansable. Al mismo tiempo, lo que sigue costando dinero y tiempo, ejecutar y mantener, es justo donde cada uno brilla de forma distinta. Rust conviene cuando el rendimiento, la memoria o la latencia se pagan cada mes (servicios con mucho tráfico, herramientas que se ejecutan millones de veces, sistemas embebidos) y el equipo puede leer lo que el agente escribe. Go conviene para servicios y herramientas de negocio en los que un equipo grande tiene que entender, revisar y actualizar el código durante años, con dependencias mínimas y compilaciones casi instantáneas incluso en proyectos enormes.

        En nuestras pruebas, Rust fue entre 1.5 y 2 veces más rápido, sirvió un 58 % más de peticiones con menos memoria y, en un proyecto pequeño, no frenó más al agente que Go. Go respondió con compilaciones de un tercio de segundo, una biblioteca estándar que evita casi todas las dependencias y una promesa de estabilidad que Rust solo cumple en sus piezas centrales. Si vas a empezar con alguno de los dos, en decodigo.com tienes el curso de Go, el curso de Rust y guías para medir el rendimiento en Go y en Rust.

        Mediciones propias del 21 de octubre de 2026: Go 1.27.3 y Rust 1.99.1 en contenedores con 4 CPU y 4 GB (AMD Ryzen 7 PRO 6850H), hyperfine y wrk; Gin 1.12.0, axum 0.8.9, tokio 1.54.0 y serde_json 1.0.154. Datos: notas de Go 1.27, política de versiones de Go, compatibilidad de Go 1, encuesta de Go 2025, servidor MCP de gopls; Rust 1.99.0, encuesta del rendimiento del compilador de Rust, Rust 1.90.0 y LLD, guía de ediciones de Rust, Tokio, axum 0.8; versiones de proxy.golang.org y crates.io. Logotipos: Go y Rust Foundation.