
Cada letra de este texto ocupa en tu ordenador el mismo espacio, normalmente 8 bits. Pero no todas aparecen igual: la «e» y la «a» salen sin parar y la «k» casi nunca. ¿Y si las letras frecuentes usaran menos bits y las raras, más? Esa es la idea del código Huffman, un algoritmo de 1952 que sigue dentro de los ZIP, las imágenes PNG y JPEG y la compresión de las páginas web. Aquí lo verás construirse paso a paso con el texto que tú escribas.
Un trabajo de clase que superó a su profesor
En 1951, el profesor Robert Fano dio a sus alumnos de teoría de la información del MIT a elegir: hacer el examen final o un trabajo sobre un problema abierto, encontrar el código binario más eficiente posible. Fano y Claude Shannon, el padre de la teoría de la información, ya tenían un método, el código de Shannon-Fano, pero no siempre daba el mejor resultado. David Huffman, uno de los alumnos, estuvo a punto de rendirse y ponerse a estudiar para el examen cuando dio con la clave: construir el árbol al revés, de abajo arriba, empezando por los símbolos menos frecuentes. Y demostró que así el resultado es siempre el óptimo.
Lo publicó en septiembre de 1952 con el título «A Method for the Construction of Minimum-Redundancy Codes». Más de setenta años después, sigue siendo una pieza básica de la compresión de datos.
La idea: códigos cortos para lo frecuente
El código Morse ya hacía algo parecido: la «E» es un solo punto y la «Q», raya-raya-punto-raya. Pero en Morse hay pausas entre letras para saber dónde acaba cada una. Con bits no hay pausas: llega una tira de ceros y unos y hay que saber cortarla. Huffman lo resuelve con un código prefijo, en el que ningún código es el principio de otro. Si la «a» es 0, ninguna otra letra puede empezar por 0, y en cuanto se lee un 0 se sabe que es una «a».
Esos códigos salen de un árbol binario, y el algoritmo para construirlo cabe en cuatro pasos:
- Se cuenta cuántas veces aparece cada símbolo. Cada uno es una hoja con ese número como peso.
- Se meten todas las hojas en una cola ordenada de menor a mayor peso.
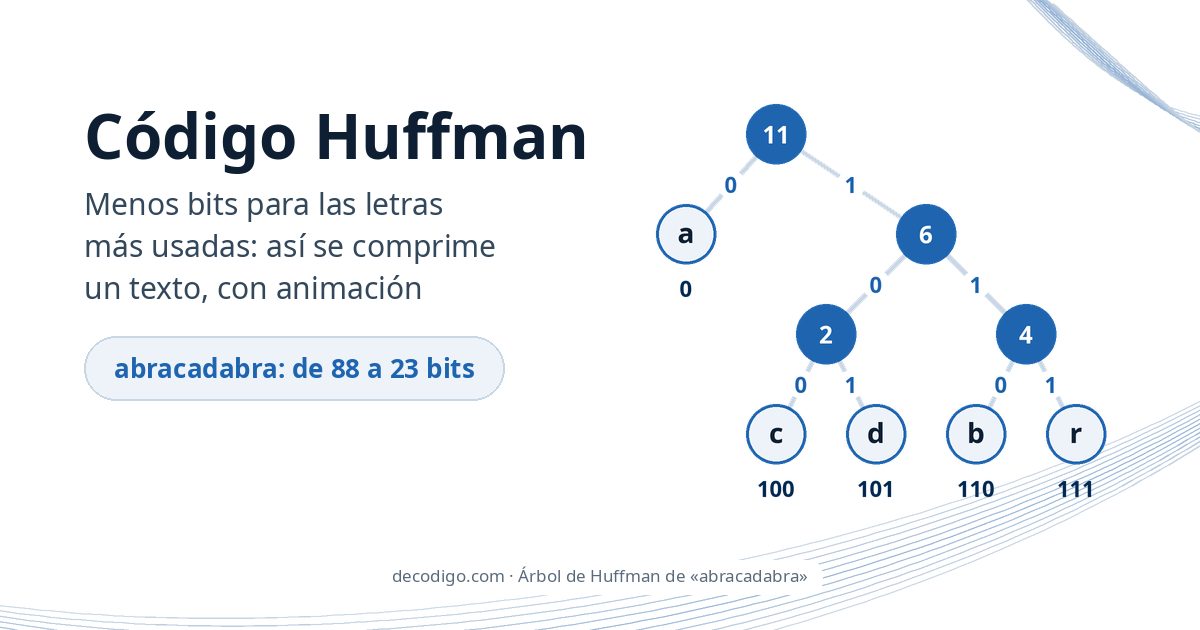
- Se sacan las dos más ligeras y se juntan bajo un nodo nuevo, cuyo peso es la suma de las dos. El nodo vuelve a la cola. Se repite hasta que solo queda uno: la raíz.
- Se lee el código de cada hoja recorriendo el camino desde la raíz: un 0 por cada rama a la izquierda y un 1 por cada rama a la derecha.
Como los símbolos raros se juntan primero, acaban en lo más hondo del árbol, con códigos largos, y los frecuentes se quedan cerca de la raíz, con códigos cortos.
Pruébalo
Elige un ejemplo o escribe tu propio texto, y pulsa «Paso» para ver cada unión o «Reproducir» para verlas seguidas. Arriba aparece la cola, con el peso de cada nodo; en rojo, los dos que se juntan en cada paso. Al terminar, verás el código de cada símbolo, el texto convertido en bits y cuánto ocupa comparado con los 8 bits por carácter de siempre.
Prueba a escribir «aaaaaaab» y luego «murciélago». En el primero, cada carácter queda en un solo bit, el mínimo posible con bits enteros, aunque el límite teórico sea de 0.544. En el segundo no se repite ninguna letra: Huffman les da códigos de 3 y 4 bits, lo mismo que necesitaría cualquier código para distinguir diez letras distintas, y el ahorro frente a los 8 bits viene solo de que el texto usa pocas letras. Huffman aprovecha que unos símbolos sean más frecuentes que otros; si todos aparecen lo mismo, no puede hacer milagros.
Cuánto se ahorra
Con «abracadabra», los 88 bits de siempre se quedan en 23. La clave es que, al leer, no hace falta ninguna marca entre letras:
Este programa en Python hace todo el proceso con la biblioteca estándar: cuenta los símbolos, construye el árbol con una cola de prioridad (heapq), saca los códigos, codifica el texto, lo decodifica para comprobar que sale igual y lo compara con el límite teórico:
from collections import Counter
import heapq
import math


def huffman(texto):
    """Devuelve las frecuencias de cada símbolo y su código de Huffman."""
    frec = Counter(texto)
    # Cada nodo de la cola es (peso, orden, contenido). El orden deshace los
    # empates: primero las hojas, de menos a más frecuentes, y después los
    # nodos nuevos en el orden en que se crean.
    hojas = sorted(frec.items(), key=lambda x: (x[1], x[0]))
    cola = [(f, i, s) for i, (s, f) in enumerate(hojas)]
    heapq.heapify(cola)
    orden = len(cola)
    while len(cola) > 1:
        a = heapq.heappop(cola)          # los dos nodos más ligeros
        b = heapq.heappop(cola)
        heapq.heappush(cola, (a[0] + b[0], orden, (a, b)))
        orden += 1

    codigos = {}

    def recorre(nodo, prefijo):
        contenido = nodo[2]
        if isinstance(contenido, tuple):   # nodo interno: 0 a la izquierda, 1 a la derecha
            recorre(contenido[0], prefijo + "0")
            recorre(contenido[1], prefijo + "1")
        else:
            codigos[contenido] = prefijo or "0"

    recorre(cola[0], "")
    return frec, codigos


def decodifica(bits, codigos):
    inverso = {c: s for s, c in codigos.items()}
    texto, actual = [], ""
    for b in bits:
        actual += b
        if actual in inverso:              # ningún código es el principio de otro
            texto.append(inverso[actual])
            actual = ""
    return "".join(texto)


def informe(texto):
    frec, codigos = huffman(texto)
    n = len(texto)
    bits = "".join(codigos[s] for s in texto)
    entropia = -sum(f / n * math.log2(f / n) for f in frec.values())
    print(f"Texto: {texto!r} ({n} caracteres, {len(frec)} distintos)")
    print("símbolo  veces  código")
    for s, f in sorted(frec.items(), key=lambda x: (-x[1], x[0])):
        print(f"  {s!r:5}  {f:5}   {codigos[s]}")
    print(f"Con 8 bits por carácter: {8 * n} bits")
    print(f"Con Huffman: {len(bits)} bits ({len(bits) / n:.3f} por carácter, "
          f"{100 * len(bits) / (8 * n):.1f} % del original)")
    print(f"Límite de Shannon (entropía): {entropia:.3f} bits por carácter")
    print(f"Se decodifica bien: {decodifica(bits, codigos) == texto}")
    print()
    return bits


bits = informe("abracadabra")
print("abracadabra codificado:", bits)
print()
informe("en un lugar de la mancha de cuyo nombre no quiero acordarme")salidaTexto: 'abracadabra' (11 caracteres, 5 distintos) símbolo veces código 'a' 5 0 'b' 2 110 'r' 2 111 'c' 1 100 'd' 1 101 Con 8 bits por carácter: 88 bits Con Huffman: 23 bits (2.091 por carácter, 26.1 % del original) Límite de Shannon (entropía): 2.040 bits por carácter Se decodifica bien: True abracadabra codificado: 01101110100010101101110 Texto: 'en un lugar de la mancha de cuyo nombre no quiero acordarme' (59 caracteres, 17 distintos) símbolo veces código ' ' 11 111 'a' 6 001 'e' 6 010 'n' 5 1100 'o' 5 1101 'r' 5 000 'u' 4 1001 'c' 3 0110 'd' 3 0111 'm' 3 1000 'l' 2 10100 'b' 1 101010 'g' 1 101011 'h' 1 101100 'i' 1 101101 'q' 1 101110 'y' 1 101111 Con 8 bits por carácter: 472 bits Con Huffman: 222 bits (3.763 por carácter, 47.0 % del original) Límite de Shannon (entropía): 3.710 bits por carácter Se decodifica bien: True
La última línea de cada bloque es la más interesante. En 1948, Shannon demostró que hay un límite para lo que se puede comprimir un mensaje sin perder información: la entropía, que depende solo de las frecuencias de los símbolos. Para «abracadabra» es de 2.040 bits por carácter, y Huffman consigue 2.091; para la frase del Quijote, 3.710 frente a 3.763. Huffman es el mejor código posible que asigna a cada símbolo un número entero de bits, y por eso se queda siempre a menos de un bit por símbolo del límite.
Hemos comprobado que la animación de arriba hace exactamente las mismas cuentas: en 300 textos, los tres de ejemplo y casi trescientos al azar con muchos empates, da los mismos códigos que el programa de Python, y todos se decodifican sin error.
Dónde está Huffman hoy
Casi nunca va solo. El formato DEFLATE, el de los archivos ZIP, gzip y las imágenes PNG, combina dos ideas: primero, el algoritmo LZ77 sustituye los trozos repetidos por referencias a donde ya aparecieron («copia los 12 caracteres de hace 300 posiciones»), y después Huffman comprime el resultado. Brotli, el formato de Google con el que viajan comprimidas muchas páginas web, usa la misma combinación de LZ77 y Huffman, más un modelo que tiene en cuenta el contexto de cada símbolo. Y el JPEG clásico usa códigos de Huffman en su último paso, después de quedarse con lo que el ojo nota de cada bloque de la imagen.
Precisamente, en el descompresor de Brotli acaba de aparecer un fallo crítico, Node2Shell, en la parte que lee esas estructuras: un recordatorio de que, por elegante que sea un algoritmo, el código que lo implementa también tiene que comprobar que los datos que recibe tienen sentido.
Si te gustan los algoritmos que se entienden mejor viéndolos, tenemos más con animación: los epiciclos de Fourier, que dibujan cualquier figura con círculos que giran, el algoritmo de Myers con el que Git encuentra las diferencias entre dos archivos, el juego del caos y los boids.
Fuentes: D. A. Huffman, «A Method for the Construction of Minimum-Redundancy Codes», Proceedings of the IRE 40(9), 1098–1101 (1952); la historia del trabajo de clase, en Wikipedia; C. E. Shannon, «A Mathematical Theory of Communication» (1948); DEFLATE, RFC 1951; Brotli, RFC 7932; JPEG, ITU-T T.81. El programa se ejecutó con Python 3.13 y la comparación, con Node.js 24. La animación, los esquemas y la portada: decodigo.com.