El algoritmo de Myers: así encuentra git diff las diferencias entre dos archivos, con animación

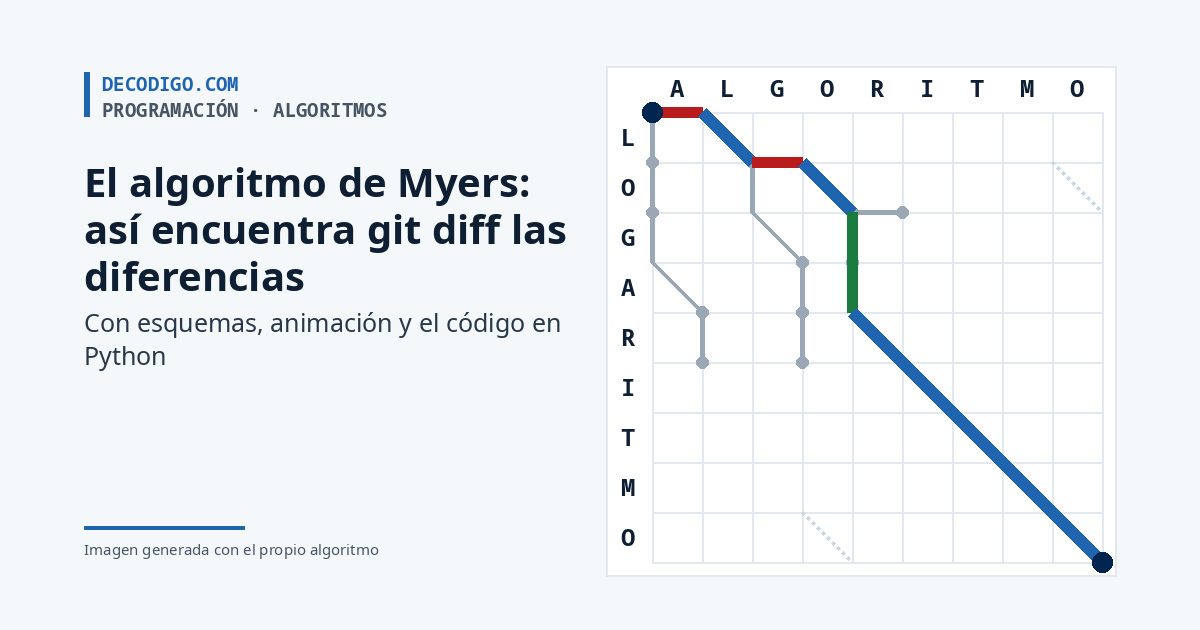
Cuadrícula de edición de ALGORITMO a LOGARITMO con el camino que encuentra el algoritmo de Myers

Cada vez que escribes git diff, Git compara dos versiones de un archivo y te enseña, en rojo y en verde, qué líneas se han quitado y cuáles se han añadido. Parece sencillo, pero detrás hay un problema que se resiste: entre los muchísimos caminos posibles para pasar de un texto a otro, hay que encontrar el más corto, y hacerlo rápido. La solución que usan Git y GNU diff, el algoritmo de Myers, la publicó Eugene Myers en 1986, y se entiende muy bien en un dibujo. Aquí la verás funcionar paso a paso, con tus propios textos.

Qué es un diff y por qué no es trivial

Un diff es una lista de instrucciones para convertir un texto A en otro texto B usando solo dos operaciones: borrar un elemento de A o insertar uno de B. Los elementos pueden ser letras, como en los ejemplos de este artículo, o líneas enteras, como hace Git. Lo que no se borra ni se inserta se conserva, y eso es lo que tienen en común los dos textos.

Pasar de A a B siempre se puede: basta con borrarlo todo y escribirlo todo de nuevo. Pero ese diff no sirve de nada, porque no dice qué ha cambiado de verdad. Lo que queremos es el diff con menos operaciones, el que conserva lo máximo posible. Lo que se conserva tiene nombre: es la subsecuencia común más larga (LCS, por sus siglas en inglés), la secuencia más larga de elementos que aparecen en los dos textos y en el mismo orden, aunque no estén seguidos. Encontrar el diff mínimo y encontrar la LCS son el mismo problema visto desde dos lados: si los textos miden N y M y la LCS mide L, el diff mínimo tiene N + M − 2L operaciones.

Lo que se conserva y lo que cambiaA = ABCABBA (antes) · B = CBABAC (después)A–B–C=B+A=B=B–A=C+Rojo: se borra de A. Verde: se inserta de B.Azul: lo común, la subsecuencia CABA.5 cambios: no hay forma de hacerlo con menos.
El ejemplo del artículo de Myers: de ABCABBA (7 letras) a CBABAC (6). La subsecuencia común más larga mide 4, CABA, así que el diff mínimo tiene 7 + 6 − 2 × 4 = 5 operaciones. Esquema: decodigo.com.

Lo difícil es que hay muchísimas formas de alinear dos textos. Con dos textos de mil líneas, las combinaciones posibles son astronómicas, y probarlas todas no es una opción. El método clásico, de programación dinámica, rellena una tabla de N × M casillas: para dos archivos de 10,000 líneas son 100 millones de casillas, aunque solo hayas cambiado una coma.

La cuadrícula de edición

La idea de Myers empieza por un dibujo. Escribe A en horizontal y B en vertical, y traza una cuadrícula. Cada punto de la cuadrícula es un estado a medio camino: «ya he recorrido tantas letras de A y tantas de B». Se empieza arriba a la izquierda, en (0, 0), y hay que llegar abajo a la derecha. Desde cada punto hay tres movimientos posibles:

  • A la derecha: borrar la siguiente letra de A. Cuesta 1.
  • Hacia abajo: insertar la siguiente letra de B. Cuesta 1.
  • En diagonal: solo se puede donde la letra de A y la de B son iguales, y no cuesta nada, porque esa letra se conserva.

Así, cada camino de una esquina a la otra es un diff, y su coste es el número de pasos que no son diagonales. El diff mínimo es el camino que aprovecha más diagonales. Myers llamó serpiente (snake) a cada tramo de diagonales seguidas, y D al número de pasos de pago.

La cuadrícula de ediciónArriba, A = GATO; a la izquierda, B = PATOGATOPATOiniciofinderecha: borrar una letra de Aabajo: insertar una letra de Bdiagonal: las letras coinciden, gratisLas diagonales k = x – yCada diagonal de la cuadrícula tiene su númeroGATOPATOk = -3k = -2k = -1k = 0k = 1k = 2k = 3Borrar (derecha) lleva a la diagonal k + 1.Insertar (abajo) lleva a la diagonal k – 1.Una coincidencia (diagonal) no cambia de k.
A la izquierda, el camino más barato de GATO a PATO: borra la G, inserta la P y baja en diagonal por A, T y O. Cuesta D = 2. A la derecha, las diagonales numeradas: el punto (x, y) está en la diagonal k = x − y. Esquemas: decodigo.com.

El truco de Myers: frentes y diagonales

Para orientarse en la cuadrícula, Myers numera sus diagonales: el punto (x, y) está en la diagonal k = x − y. La diagonal principal, la que sale de la esquina de inicio, es la k = 0; borrar te mueve a la diagonal de la derecha (k + 1), insertar te mueve a la de la izquierda (k − 1), y una coincidencia te deja en la misma.

Con eso, el algoritmo avanza por frentes. Primero mira hasta dónde se llega con D = 0 cambios: solo bajando en diagonal desde (0, 0) mientras las letras coincidan. Luego, con D = 1: un borrado o una inserción, seguidos de toda la diagonal gratis que haya. Luego con D = 2, y así sucesivamente. En cada frente solo guarda una cosa por diagonal: el punto más lejano al que se puede llegar en ella con D cambios. La clave, demostrada en el artículo, es que el punto más lejano con D cambios siempre sale de uno de los puntos más lejanos con D − 1, el de la diagonal de al lado, más un paso y la serpiente que venga detrás. No hace falta recordar nada más.

El primer frente que toca la esquina final da la respuesta, y como los frentes se prueban en orden, de menor a mayor, no puede haber un camino más corto. Para sacar el diff basta con guardar cada frente y recorrerlos hacia atrás desde la esquina.

Los frentes: D = 0, 1, 2…Hasta dónde llega cada diagonal con D cambiosABCABBACBABAC0112223343345445Cada círculo es el punto más lejano al que llegauna diagonal con D cambios. Con D = 5, uno llegaa la esquina: ese es el diff, el camino marcado.
Los frentes del ejemplo de Myers. Cada número es el punto más lejano al que llega una diagonal con ese número de cambios; con D = 5, el algoritmo llega a la esquina. Es la idea de la figura 3 del artículo original, y el camino marcado es el de su figura 1. Esquema: decodigo.com.

Pruébalo

Escribe dos textos, o elige un ejemplo, y pulsa «Reproducir». Cada paso de la animación es una diagonal de un frente: la arista roja es un borrado, la verde una inserción, y el tramo azul que sigue es la serpiente, las coincidencias que el algoritmo recorre gratis. La franja azul clara marca la diagonal que se está calculando, y las líneas discontinuas grises son todos los atajos que existen. Los frentes anteriores se quedan en gris. Cuando un frente llega a la esquina, se dibuja el camino elegido y, debajo, el diff. Con «Líneas», cada fila y cada columna son una línea entera, como en Git; los números de la cuadrícula son los números de línea.

Ejemplos:
Comparar por:

borrarinsertarcoincidenciaatajo posible

Prueba «Casi nada en común»: como GATO y PERRO no comparten ninguna letra salvo la O final, el algoritmo tiene que abrir casi todos los frentes, hasta D = 7. Con «El de Myers» basta con 19 pasos para encontrar el camino de D = 5.

Por qué es rápido

El frente D tiene D + 1 diagonales, y cada serpiente avanza sin volver atrás. En total, el algoritmo hace del orden de (N + M) × D operaciones, que Myers escribe O(ND) tomando N como la suma de las dos longitudes. Lo importante es la D: el trabajo no depende tanto del tamaño de los archivos como de cuánto han cambiado. Comparar dos versiones de un archivo de 10,000 líneas en las que has tocado tres líneas es casi instantáneo, porque el algoritmo llega a la esquina como mucho en el frente 6, sin haber mirado la mayor parte de la cuadrícula. Eso es justo lo que pasa casi siempre con el código: entre un commit y el siguiente, cambia poco.

Myers también demostró que, en promedio, el coste es de N + D², y propuso una variante que solo necesita memoria proporcional a N: busca a la vez desde las dos esquinas hasta que los dos recorridos se encuentran en una serpiente central, y repite el proceso a cada lado. Esa es la versión que usan GNU diff y Git.

Un detalle de la versión básica: cuando dos caminos llegan igual de lejos, la regla de elección del algoritmo hace que, en cada bloque de cambios, salgan primero los borrados y después las inserciones. Es como estamos acostumbrados a leer un diff: primero lo que había y luego lo que lo sustituye. Lo hemos comprobado en 2,006 pares de textos al azar: en ninguno aparece una inserción justo antes de un borrado.

El algoritmo en Python

Esta es la versión completa, con la vuelta atrás para sacar el diff. La función frentes es la figura 2 del artículo de Myers casi línea a línea; la única diferencia es que guarda una copia de cada frente para poder reconstruir el camino:

# Algoritmo de diferencias de Myers (1986), versión voraz hacia delante, con la vuelta atrás para sacar el
# script de edición. Referencia para comprobar el núcleo de articulos/myers.js (pruebas/myers/compara.js).
def frentes(a, b):
    """Recorre D = 0, 1, 2… y guarda, para cada D, el punto más lejano (x) alcanzado en cada diagonal k = x - y."""
    n, m = len(a), len(b)
    v = {1: 0}
    traza = []
    for d in range(n + m + 1):
        traza.append(dict(v))
        for k in range(-d, d + 1, 2):
            if k == -d or (k != d and v[k - 1] < v[k + 1]):
                x = v[k + 1]            # baja desde la diagonal k + 1: inserta
            else:
                x = v[k - 1] + 1        # avanza a la derecha desde k - 1: borra
            y = x - k
            while x < n and y < m and a[x] == b[y]:
                x, y = x + 1, y + 1     # serpiente: diagonal gratis mientras coinciden
            v[k] = x
            if x >= n and y >= m:
                return d, traza
    raise AssertionError("inalcanzable")


def diff(a, b):
    """Devuelve el script de edición: lista de ('=', a), ('-', a) y ('+', b), en orden."""
    d, traza = frentes(a, b)
    x, y = len(a), len(b)
    ops = []
    for d in range(d, -1, -1):
        v = traza[d]
        k = x - y
        if k == -d or (k != d and v[k - 1] < v[k + 1]):
            k_prev = k + 1
        else:
            k_prev = k - 1
        x_prev = v[k_prev]
        y_prev = x_prev - k_prev
        while x > x_prev and y > y_prev:
            x, y = x - 1, y - 1
            ops.append(("=", a[x]))
        if d > 0:
            if x == x_prev:
                y -= 1; ops.append(("+", b[y]))
            else:
                x -= 1; ops.append(("-", a[x]))
    ops.reverse()
    return ops


if __name__ == "__main__":
    a, b = "ABCABBA", "CBABAC"
    d, _ = frentes(a, b)
    ops = diff(a, b)
    print("D =", d)
    print(" ".join(s + c for s, c in ops))
    print("común:", "".join(c for s, c in ops if s == "="))
salidaD = 5
-A -B =C +B =A =B -B =A +C
común: CABA

Es el resultado de la figura 1 del artículo original: borrar A y B, conservar C, insertar B, conservar A y B, borrar B, conservar A e insertar C. Hemos comprobado que la animación de arriba usa exactamente el mismo cálculo: en 2,006 pares de textos al azar, las dos dan el mismo diff, letra a letra, y en todos ellos D es la mínima, la que da la LCS calculada con el método clásico.

Lo que hace Git: myers, minimal, patience e histogram

Git deja elegir el algoritmo con la opción --diff-algorithm. Hay cuatro: myers, el que usa por omisión; minimal, que gasta más tiempo para asegurarse de dar el diff más pequeño posible, porque la versión de Git recorta la búsqueda con algunos atajos en los casos difíciles; patience, que primero empareja las líneas que aparecen una sola vez en cada archivo y luego rellena lo que queda entre ellas, e histogram, una variante de patience que también aprovecha las líneas que se repiten poco.

¿Por qué hace falta más de uno? Porque el diff mínimo casi nunca es único: suele haber varios caminos con la misma D, y no todos se leen igual de bien. Un ejemplo clásico: en este programa en C hemos borrado la función fact, hemos añadido fib al principio y hemos quitado una línea de repite.

#include <stdio.h>

// Repite foo diez veces
int repite(int foo)
{
    int i;
    for (i = 0; i < 10; i++)
    {
        printf("Tu respuesta es: ");
        printf("%d\n", foo);
    }
}

int fact(int n)
{
    if (n > 1)
    {
        return fact(n - 1) * n;
    }
    return 1;
}

int main(int argc, char **argv)
{
    repite(fact(10));
}
#include <stdio.h>

int fib(int n)
{
    if (n > 2)
    {
        return fib(n - 1) + fib(n - 2);
    }
    return 1;
}

// Repite foo diez veces
int repite(int foo)
{
    int i;
    for (i = 0; i < 10; i++)
    {
        printf("%d\n", foo);
    }
}

int main(int argc, char **argv)
{
    repite(fib(10));
}

Esto es lo que da git diff --no-index --diff-algorithm=myers antes.c despues.c, con Git 2.39.5:

myers@@ -1,26 +1,25 @@
 #include <stdio.h>
 
-// Repite foo diez veces
-int repite(int foo)
+int fib(int n)
 {
-    int i;
-    for (i = 0; i < 10; i++)
+    if (n > 2)
     {
-        printf("Tu respuesta es: ");
-        printf("%d\n", foo);
+        return fib(n - 1) + fib(n - 2);
     }
+    return 1;
 }
 
-int fact(int n)
+// Repite foo diez veces
+int repite(int foo)
 {
-    if (n > 1)
+    int i;
+    for (i = 0; i < 10; i++)
     {
-        return fact(n - 1) * n;
+        printf("%d\n", foo);
     }
-    return 1;
 }
 
 int main(int argc, char **argv)
 {
-    repite(fact(10));
+    repite(fib(10));
 }

Y esto, con --diff-algorithm=patience:

patience@@ -1,26 +1,25 @@
 #include <stdio.h>
 
+int fib(int n)
+{
+    if (n > 2)
+    {
+        return fib(n - 1) + fib(n - 2);
+    }
+    return 1;
+}
+
 // Repite foo diez veces
 int repite(int foo)
 {
     int i;
     for (i = 0; i < 10; i++)
     {
-        printf("Tu respuesta es: ");
         printf("%d\n", foo);
     }
 }
 
-int fact(int n)
-{
-    if (n > 1)
-    {
-        return fact(n - 1) * n;
-    }
-    return 1;
-}
-
 int main(int argc, char **argv)
 {
-    repite(fact(10));
+    repite(fib(10));
 }

Los dos son igual de cortos: 10 líneas añadidas y 11 borradas. Pero el primero mezcla las llaves y las líneas en blanco de funciones distintas, y el segundo cuenta lo que de verdad ha pasado: una función nueva, una línea menos y una función borrada. Con este ejemplo, minimal da lo mismo que myers e histogram, lo mismo que patience. Curiosamente, la versión básica de Python de arriba, aplicada a estas líneas, da exactamente el diff de patience: recorre la cuadrícula en otro orden que la versión de Git, que busca desde las dos esquinas, y en el empate entre caminos igual de cortos elige otro. No es que sea mejor: con otros archivos puede pasar al revés. Si quieres que Git use otro algoritmo siempre, basta con git config --global diff.algorithm histogram.

Si te gustan los algoritmos que se entienden mejor viéndolos, tenemos más con animación: el juego de la vida, la hormiga de Langton y los boids. Y si Git te interesa por dentro, en esta explicación de Scion contamos por qué Anthropic ha dejado Git en su repositorio principal.

Fuentes: E. W. Myers, «An O(ND) Difference Algorithm and Its Variations», Algorithmica 1, 251–266 (1986) (figuras 1, 2 y 3, y secciones 3 y 4); la documentación de git diff (opción –diff-algorithm); el código de Git, xdiff/xdiffi.c, y el de GNU diff, diffseq.h de gnulib, que citan el artículo de Myers. El programa se ejecutó con Python 3.13 y el ejemplo de Git, con Git 2.39.5. La animación y las imágenes, incluida la portada, las genera el propio algoritmo: decodigo.com.
COBOL: historia, cuánto se usa hoy y si vale la pena aprenderlo en 2026

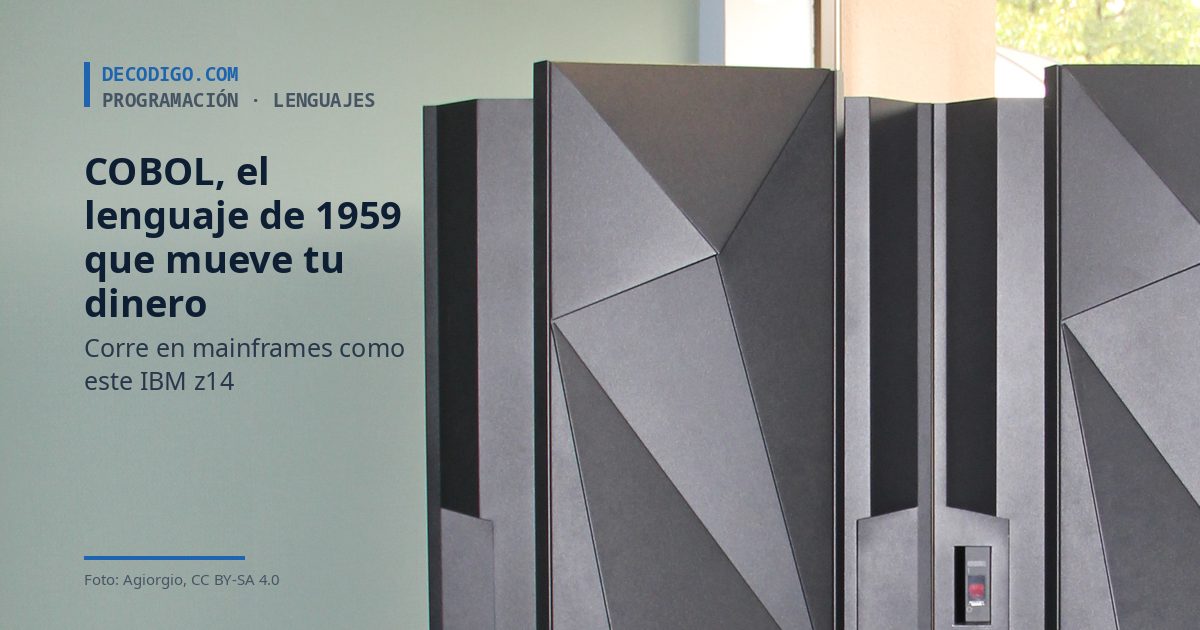
Mainframe IBM z14 junto a una pared lisa con el título del artículo sobre COBOL

COBOL es un lenguaje de programación de 1959, más viejo que el hombre en la Luna, y aun así es muy probable que hoy haya pasado por él tu dinero: es el lenguaje de los grandes sistemas de bancos, aseguradoras y administraciones, que corren en mainframes como el de la portada. Te contamos de dónde viene, por qué sigue ahí, cuánto se usa de verdad (y cuánto hay de mito en las cifras que circulan), qué está cambiando con la inteligencia artificial y si te conviene aprenderlo.

Su nombre son las siglas de COmmon Business-Oriented Language, lenguaje común orientado a los negocios, y lo describe bien: no se pensó para hacer cálculos científicos ni para programar videojuegos, sino para llevar cuentas, nóminas, inventarios y pólizas. Y se escribe casi como un documento en inglés, porque sus creadores querían que pudieran leerlo también los gerentes, no solo los programadores.

Así es un programa en COBOL

El clásico «Hola, mundo» ya deja ver su carácter: todo va en mayúsculas, cada instrucción termina en punto y el programa se divide en partes con nombre propio. Las siete primeras columnas de cada línea están reservadas, una herencia de las tarjetas perforadas en las que se escribía.

       IDENTIFICATION DIVISION.
       PROGRAM-ID. HOLA.
       PROCEDURE DIVISION.
           DISPLAY "Hola, mundo".
           STOP RUN.
Hola, mundo

Un programa completo tiene cuatro divisiones, siempre en el mismo orden. La más característica es la de datos: cada variable se declara con una «PIC» (de picture, imagen) que dice exactamente cuántas cifras tiene y dónde va la coma decimal. Esa idea, que COBOL tomó de COMTRAN, el lenguaje de IBM, es una de las razones por las que sigue en los bancos.

Un programa COBOL se lee como un documento cuatro divisiones, siempre en el mismo orden; a la derecha, trozos del programa de intereses de este artículo 1 IDENTIFICATION DIVISION Quién es El nombre del programa y, si se quiere, el autor y la fecha. PROGRAM-ID. INTERESES. 2 ENVIRONMENT DIVISION Dónde corre La máquina y los archivos que usa. En este ejemplo no hace falta. (no se usa en el ejemplo) 3 DATA DIVISION Con qué datos Cada variable con su «PIC»: cuántas cifras y dónde va la coma. 01 SALDO   PIC 9(7)V99. 01 SALDO-ED PIC $$,$$$,$$9.99. 4 PROCEDURE DIVISION Qué hace Las instrucciones, escritas casi como frases en inglés. COMPUTE INTERES ROUNDED =         SALDO * TASA-MENSUAL ADD INTERES TO SALDO
Las cuatro divisiones de un programa COBOL, con fragmentos del programa de intereses que aparece más abajo. Esquema: decodigo.com.

Una historia que empezó en el Pentágono

A finales de los años 50 cada fabricante de ordenadores tenía sus propios lenguajes, y cambiar de máquina significaba reescribirlo todo. En abril de 1959, Mary Hawes, programadora de Burroughs, convocó en la Universidad de Pensilvania una reunión para proponer un lenguaje común para los negocios. El 28 y el 29 de mayo de ese año, el Departamento de Defensa de EE. UU., el mayor comprador de ordenadores del país, reunió en el Pentágono a fabricantes, usuarios y Gobierno bajo la presidencia de Charles Phillips. De ahí salió CODASYL, el comité que escribió COBOL en pocos meses.

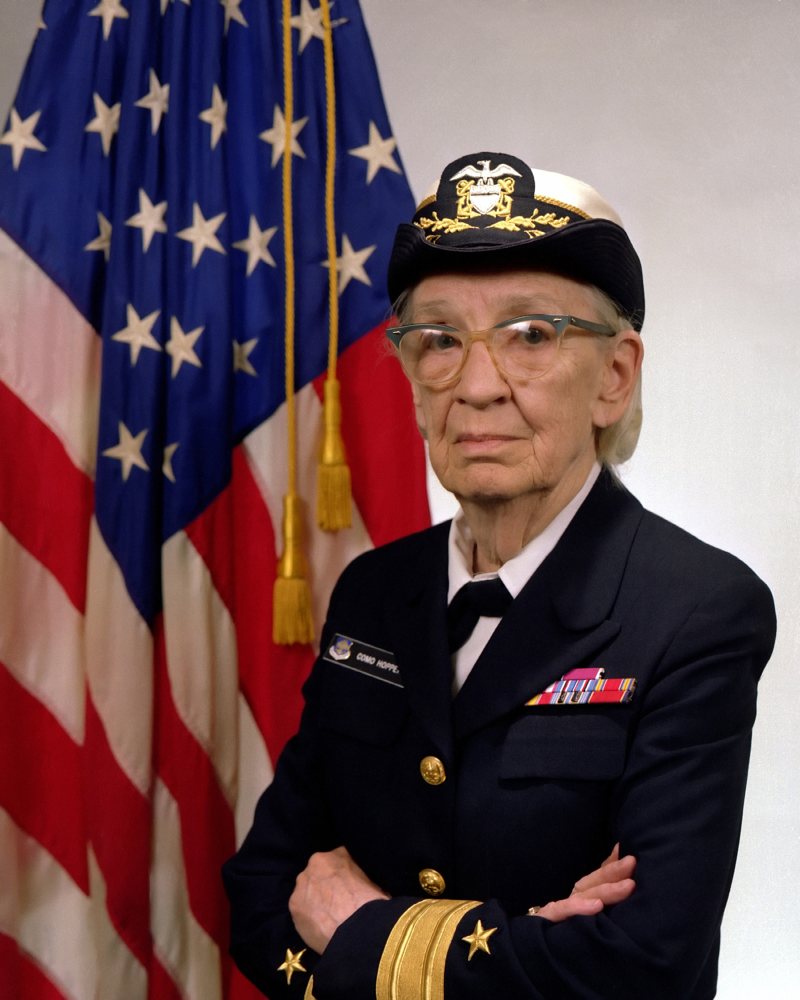
Retrato oficial de Grace Hopper con uniforme de comodoro de la Marina de Estados Unidos, en 1984
Grace Hopper en 1984. Su FLOW-MATIC fue el modelo principal de COBOL. Foto: James S. Davis, Marina de EE. UU., dominio público.

A Grace Hopper se la suele llamar «la madre de COBOL», y no es exacto. Hopper, oficial de la Marina y pionera de la programación, había creado FLOW-MATIC, el primer lenguaje con órdenes en inglés para negocios, y fue asesora técnica del comité; su lenguaje fue el modelo principal. Pero el diseño fue un trabajo colectivo en el que pesaron mucho otras personas, como Jean Sammet, de Sylvania. La propia Sammet escribió que Hopper «no fue la madre, la creadora ni la desarrolladora de COBOL», aunque sí su gran divulgadora.

La especificación, COBOL-60, se aprobó en enero de 1960, y en diciembre de ese año se demostró la gran promesa: el mismo programa funcionó en un ordenador de RCA y en un UNIVAC de Remington Rand, dos máquinas incompatibles. A partir de ahí vinieron los estándares oficiales y un reinado de décadas en la informática de empresa.

Casi 70 años de COBOL de una reunión en el Pentágono a los anuncios de migración con IA 1960 1970 1980 1990 2000 2010 2020 2030 1959 Nace en el Pentágono CODASYL, convocado por el Departamento de Defensa 1960 COBOL-60 el mismo programa corre en RCA y en UNIVAC 1968 Primer estándar ANSI; después 1974 y 1985 1999 Efecto 2000 EE. UU. gasta unos $100,000 millones de USD en arreglarlo 2002 Orientado a objetos norma ISO; nuevas ediciones en 2014 y 2023 2020 Pandemia Nueva Jersey pide programadores COBOL 2025 IBM z17 el mainframe más nuevo, con IA en el chip 2026 La IA lo traduce Anthropic y OpenAI anuncian migraciones
Los hitos de COBOL. Fuentes: Jean Sammet (1978), INCITS, Departamento de Comercio de EE. UU., CNBC, IBM, Anthropic y OpenAI. Esquema: decodigo.com.

Su momento de fama más incómodo fue el efecto 2000: muchos programas de los años 60 a 80 guardaban el año con dos cifras para ahorrar memoria, y había que revisarlos antes de que el «00» se confundiera con 1900. El Departamento de Comercio de EE. UU. calculó que el país gastó unos $100,000 millones de USD en el arreglo, buena parte sobre código COBOL. El lenguaje, mientras tanto, siguió evolucionando: en 2002 incorporó la programación orientada a objetos y la norma vigente, ISO/IEC 1989, es de 2023.

Por qué los bancos no lo sueltan: el dinero exacto

La mayoría de los lenguajes guardan los números con decimales en binario, en lo que se llama coma flotante. Es rápido, pero hay cantidades tan sencillas como 0.10 que no se pueden representar exactamente, y al sumar se acumulan pequeños errores. COBOL, en cambio, guarda los importes como cifras decimales exactas, igual que en el papel. Lo comprobamos sumando diez veces 10 centavos en los dos lenguajes:

Sumar diez veces 10 centavos COBOL guarda los importes como cifras decimales exactas; la mayoría de lenguajes, en binario y con redondeo COBOL: PIC 9V99 decimal fijo, como en el papel suma 1 0.10 suma 2 0.20 suma 3 0.30 suma 4 0.40 suma 5 0.50 suma 6 0.60 suma 7 0.70 suma 8 0.80 suma 9 0.90 suma 10 1.00 Python: float coma flotante binaria (IEEE 754) suma 1 0.1 suma 2 0.2 suma 3 0.30000000000000004 suma 4 0.4 suma 5 0.5 suma 6 0.6 suma 7 0.7 suma 8 0.7999999999999999 suma 9 0.8999999999999999 suma 10 0.9999999999999999 Probado con GnuCOBOL 3.2 y Python 3.13. Los bancos no pueden permitirse ese último centavo de menos.
Diez veces 0.10 en COBOL (GnuCOBOL 3.2) y en Python 3.13. Esquema: decodigo.com.

Existen formas de trabajar con decimales exactos en Python o Java, pero en COBOL es lo normal, sin pedir nada. Este programa aplica un interés mensual del 1.25 % a tres cuentas, redondea al centavo y da el resultado con formato de moneda, que en COBOL también se declara en la PIC:

       IDENTIFICATION DIVISION.
       PROGRAM-ID. INTERESES.
      *> Aplica el interes mensual a tres cuentas y muestra el saldo.
       DATA DIVISION.
       WORKING-STORAGE SECTION.
       01  TASA-MENSUAL     PIC V9999         VALUE .0125.
       01  SALDO            PIC 9(7)V99.
       01  INTERES          PIC 9(7)V99.
       01  TOTAL            PIC 9(8)V99       VALUE ZERO.
       01  SALDO-ED         PIC $$,$$$,$$9.99.
       01  INTERES-ED       PIC $$,$$$,$$9.99.
       01  TOTAL-ED         PIC $$$,$$$,$$9.99.
       01  CUENTAS.
           05  FILLER       PIC 9(7)V99       VALUE 1299.99.
           05  FILLER       PIC 9(7)V99       VALUE 250000.00.
           05  FILLER       PIC 9(7)V99       VALUE 0.10.
       01  TABLA REDEFINES CUENTAS.
           05  CUENTA       PIC 9(7)V99       OCCURS 3 TIMES.
       01  I                PIC 9.
       PROCEDURE DIVISION.
           PERFORM VARYING I FROM 1 BY 1 UNTIL I > 3
               MOVE CUENTA(I) TO SALDO
               COMPUTE INTERES ROUNDED = SALDO * TASA-MENSUAL
               ADD INTERES TO SALDO
               ADD SALDO TO TOTAL
               MOVE SALDO TO SALDO-ED
               MOVE INTERES TO INTERES-ED
               DISPLAY "Cuenta " I ": interes " INTERES-ED
                       "   saldo " SALDO-ED
           END-PERFORM
           MOVE TOTAL TO TOTAL-ED
           DISPLAY "Total de los saldos:              " TOTAL-ED
           STOP RUN.
Cuenta 1: interes        $16.25   saldo     $1,316.24
Cuenta 2: interes     $3,125.00   saldo   $253,125.00
Cuenta 3: interes         $0.00   saldo         $0.10
Total de los saldos:                 $254,441.34

Lo hemos compilado y ejecutado con GnuCOBOL 3.2, un compilador libre que funciona en Linux, macOS y Windows. Fíjate en la tercera cuenta: el interés de 10 centavos es $0.00125 y, al redondear al centavo, queda en $0.00. Ese tipo de reglas, escritas hace décadas y repetidas millones de veces al día, son las que hay que respetar al pie de la letra cuando alguien quiere sustituir un programa COBOL.

Dónde se ejecuta hoy

COBOL vive sobre todo en los mainframes, ordenadores centrales diseñados para procesar enormes volúmenes de operaciones sin detenerse. Hoy casi todos son de IBM, de su familia IBM Z: el último modelo, el z17, salió en junio de 2025 con un procesador que incluye un acelerador de IA. Y el negocio no está muerto: IBM contó a sus inversores en julio de 2026 que el z17 va camino de vender casi un 130 % de lo que vendió el anterior, y que los clientes que suman el 85 % de la capacidad instalada la mantienen o la amplían.

Dónde está COBOL cuando sacas dinero la parte que ves es moderna; la que decide y apunta el movimiento suele ser COBOL Cajero o terminal pides efectivo con tu tarjeta App, web y red Java, JavaScript, servicios en la nube Mainframe programa COBOL bajo CICS: ¿hay saldo? Base de datos Db2 o VSAM: resta y apunta el cargo ida: la petición · vuelta: «aprobada», en una fracción de segundo Y de noche, el proceso por lotes («batch») Intereses de millones de cuentas Extractos y estados de cuenta Nóminas y pagos programados Cierre contable del día
Dónde suele intervenir COBOL en una operación bancaria. CICS es el sistema de IBM que ejecuta las transacciones; Db2 y VSAM, dos formas de guardar los datos. Esquema: decodigo.com.

Las administraciones públicas también dependen de él. La Seguridad Social de EE. UU. tiene más de 60 millones de líneas de COBOL, según su Inspector General, y el registro maestro de las cuentas fiscales de los ciudadanos del IRS, la agencia tributaria, sigue escrito en COBOL y ensamblador desde los años 60. En 2020, con la pandemia, las solicitudes del subsidio de desempleo se dispararon y varios estados se quedaron sin capacidad. El gobernador de Nueva Jersey, Phil Murphy, llegó a pedir en público voluntarios que supieran COBOL: «¿Cómo hemos llegado a necesitar literalmente programadores de COBOL?».

¿Cuánto se usa de verdad?

Seguro que has leído que hay 220,000 millones de líneas de COBOL en uso o que el 95 % de las operaciones en cajeros pasan por él. Lo hemos rastreado: esas cifras salen de una sola infografía de Reuters de 2017 que daba seis fuentes juntas sin decir cuál respaldaba cada número, y desde entonces se repiten, y se deforman, sin más comprobación. La propia OpenAI las ha vuelto a usar este mes. La que más se cita para el tamaño, 800,000 millones de líneas, viene de una encuesta encargada en 2022 por Micro Focus, un fabricante de herramientas COBOL, que no publicó su método.

Las cifras que todo el mundo repite ¿de dónde salen y cuánto se puede fiar uno de ellas? 220,000 millones de líneas Reuters, 2017 · una infografía; seis fuentes sin decir cuál da cada cifra débil 43 % de los sistemas bancarios Reuters, 2017 · la misma infografía; hoy se repite como «40 % de la banca en línea» débil 95 % de las operaciones en cajeros Reuters, 2017 · se cita en círculo; la fuente «académica» la firman dos directivos de un fabricante débil 80 % de las transacciones en persona Reuters, 2017 · muchos medios la cambian por «con tarjeta de crédito», que no dice débil 800,000 millones de líneas Micro Focus, 2022 · encuesta encargada por el fabricante; método sin publicar media Más de 60 millones de líneas en la Seguridad Social de EE. UU. Inspector General, 2016 · medido por el propio organismo, ante el Congreso sólida
De dónde salen las cifras más repetidas sobre COBOL. Fuentes: Reuters (2017), Vanson Bourne para Micro Focus (2022), Inspector General de la Seguridad Social de EE. UU. (2016). Esquema: decodigo.com.

Lo que sí se puede medir es el interés. En el índice TIOBE, que ordena los lenguajes según cuánto se buscan y se mencionan en internet, COBOL ha pasado del puesto 23 en octubre de 2025 al 16 en octubre de 2026, por delante de Perl o MATLAB. La subida coincide con el ruido sobre la IA y la modernización. Entre los programadores en general, en cambio, es una rareza: en la encuesta de Stack Overflow de 2025 solo lo usaba el 1 % de los encuestados.

COBOL sube en el índice TIOBE puesto en la clasificación de lenguajes (más arriba, más popular en los buscadores) 15.º 20.º 25.º 23.º oct. 2025 19.º ago. 2026 20.º sep. 2026 16.º oct. 2026 TIOBE mide cuánto se busca y se menciona un lenguaje, no cuánto código hay en uso. Octubre de 2026: 0.89 % de las búsquedas.
Puesto de COBOL en el índice TIOBE. Fuentes: TIOBE (octubre de 2025 y 2026) y Blog du Modérateur (agosto y septiembre de 2026). Gráfica: decodigo.com.

COBOL en la era de la IA

El problema de los sistemas COBOL no es que el lenguaje sea malo, sino que quedan pocas personas que conozcan cada sistema, y que entender millones de líneas sin documentar es lento y caro. Ahí es donde se ha metido la IA. El 23 de febrero de 2026, Anthropic publicó cómo Claude Code puede explorar un sistema COBOL, trazar sus dependencias y documentarlo para modernizarlo por partes. Ese día las acciones de IBM cayeron en torno a un 13 %, su peor sesión desde octubre de 2000. IBM respondió que el valor del mainframe está en la plataforma, no en un lenguaje, y tiene sus propias herramientas: watsonx Code Assistant for Z y, desde abril, Bob, su entorno con agentes.

El 19 de octubre fue OpenAI quien presentó resultados: en su prueba interna de migrar programas COBOL a otros lenguajes, su modelo más nuevo aprueba casi todas las tareas, cuando el anterior apenas aprobaba el 5 %. En otra prueba, escribir una base de datos SQLite entera en veinte lenguajes, COBOL fue el más difícil.

Lo que dice OpenAI de sus modelos con COBOL pruebas de la propia empresa, publicadas el 19 de octubre de 2026 Migrar programas COBOL a otro lenguaje GPT-5.6 Sol 5.4 % GPT-6.1 Sol, poco razonamiento 86.6 % GPT-6.1 Sol, mucho razonamiento 97.9 % Escribir SQLite en COBOL (MultiLangBench) GPT-5.6 Sol 10.9 % GPT-6 Astra 72.1 % Porcentaje de tareas aprobadas. La propia OpenAI avisa: una migración real necesita revisión experta y pruebas.
Resultados que publica OpenAI sobre sus modelos (19 de octubre de 2026), según la cobertura de Dataconomy y SuperPowerDaily y el repositorio MultiLangBench. Son pruebas de la propia empresa. Gráfica: decodigo.com.

Conviene leerlo con calma. La propia OpenAI advierte que una migración real sigue necesitando revisión experta y pruebas contra las reglas del negocio, y pone un ejemplo que ya has visto aquí: COBOL trunca o redondea los decimales según se le pida, y una traducción que redondee distinto puede funcionar sin un solo error y dar otros resultados. La consultora Gartner va más allá y prevé que más del 70 % de los proyectos para abandonar el mainframe que arranquen en 2026 no conseguirán lo prometido por sobrestimar la IA generativa.

¿Vale la pena aprenderlo?

Depende de a qué te quieras dedicar. Estos son los datos a favor y en contra:

  • A favor: hay sistemas para rato. Los bancos y las administraciones siguen comprando mainframes, y Gartner desaconseja salir de ellos con prisas. Alguien tendrá que mantener ese código, y también migrarlo.
  • A favor: escasea la experiencia. En EE. UU. las ofertas para programadores COBOL rondan los $115,000 USD al año, según ZipRecruiter, aunque los sueldos que declaran los propios programadores en PayScale se quedan en unos $73,000 USD.
  • A favor: la IA necesita quien la revise. Todas las empresas que venden herramientas de migración insisten en la revisión humana. Quien entienda COBOL y sepa usar esas herramientas tiene un perfil poco común.
  • En contra: es un nicho. Lo usa el 1 % de los programadores y casi todo el trabajo está en banca, seguros y gobierno, a menudo en grandes consultoras.
  • En contra: fuera de EE. UU. no es una mina de oro. En España, un analista programador COBOL cobra de media unos 32,780 € al año, y en México unos $21,336 MXN al mes, según Indeed.
  • En contra: el lenguaje es lo fácil. Lo que lleva tiempo es el entorno del mainframe (z/OS, JCL, CICS, Db2) y, sobre todo, conocer las reglas de negocio de cada empresa, que no se aprenden en ningún curso.
DóndeSueldo medioFuente
Estados Unidos$115,475 USD al año (ofertas)
unos $73,000 USD (declarados)
ZipRecruiter y PayScale
España32,780 € al añoIndeed, 65 salarios
México$21,336 MXN al mesIndeed, solo 16 salarios
¿Te conviene aprender COBOL? una forma rápida de decidirlo ¿Te ves trabajando en banca, seguros o administraciones públicas? sí no ¿Te atrae entender sistemas grandes y viejos, más que crear desde cero? ¿Es tu primer lenguaje de programación? Sí, merece la pena COBOL + JCL + Db2, y las herramientas de IA para migrar Como segundo plan aprende lo básico; el negocio se aprende en la empresa Empieza por otro Python o Java primero; COBOL más adelante Como curiosidad un fin de semana con GnuCOBOL enseña mucha historia sí no sí no
Una forma rápida de decidir si te conviene aprender COBOL. Esquema: decodigo.com.
Para empezar gratis. GnuCOBOL te deja compilar en tu ordenador los programas de este artículo. IBM Z Xplore ofrece retos gratuitos con acceso a un mainframe real, sin conocimientos previos. Y el curso de COBOL del Open Mainframe Project, de la Linux Foundation, tiene más de 3,600 estrellas en GitHub y se sigue desde VS Code con las extensiones gratuitas de Zowe e IBM. La instalación, el primer programa y los errores típicos, paso a paso, en nuestra guía cómo empezar con COBOL.

En resumen: COBOL no va a desaparecer pronto, porque sustituirlo es caro y arriesgado, pero tampoco es el billete seguro a un sueldo enorme que prometen algunos titulares. Si te atraen la banca, los seguros o el sector público y te gusta entender sistemas grandes, aprenderlo junto con el entorno del mainframe y las nuevas herramientas de IA es una apuesta razonable. Si estás empezando a programar, mejor ve primero por Python o Java, y vuelve a COBOL más adelante: aprender cómo se programaba en 1959 también enseña mucho de cómo se programa hoy. Si te interesa ese debate, lo tratamos en qué lenguaje elegir cuando la IA escribe el código.

Fuentes: índice TIOBE; encuesta de Stack Overflow 2025; Inspector General de la Seguridad Social de EE. UU.; GAO sobre el IRS; IBM z17; carta de IBM a sus inversores; infografía de Reuters de 2017; encuesta de Vanson Bourne para Micro Focus; CNBC sobre Nueva Jersey; Anthropic; MultiLangBench de OpenAI y Dataconomy; Gartner; INCITS sobre la norma de 2023; GnuCOBOL; curso del Open Mainframe Project; IBM Z Xplore. Sueldos: Indeed España y México, ZipRecruiter y PayScale. Historia: Jean Sammet, «The early history of COBOL» (1978). Portada: mainframe IBM z14, foto de Agiorgio, licencia CC BY-SA 4.0, Wikimedia Commons.

Boids: las tres reglas que imitan el vuelo de una bandada, con animación

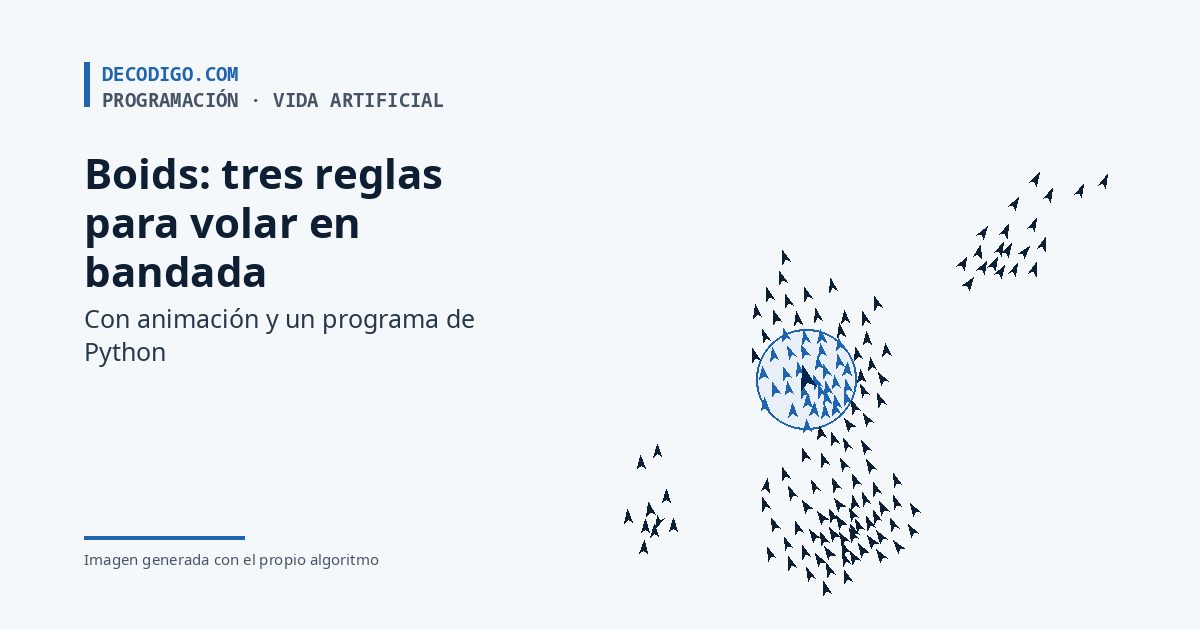
Bandada de boids: flechas azul marino que vuelan juntas; una, más grande, con su radio de visión y sus vecinos en azul

Miles de estorninos giran a la vez en el cielo del atardecer como si fueran un solo animal, y sin embargo ninguno manda. En 1986, el informático Craig Reynolds demostró que para imitar ese vuelo basta con que cada pájaro siga tres reglas sencillas mirando solo a sus vecinos. Llamó a sus pájaros de mentira boids, y su idea acabó en el cine, en los videojuegos y en los enjambres de drones. Aquí puedes ver la bandada, cambiar las reglas y asustarla con el ratón.

Tres reglas y ningún jefe

Reynolds trabajaba en animación por ordenador y quería que una bandada se moviera de forma natural sin tener que dibujar la trayectoria de cada pájaro a mano. Su solución fue no programar la bandada, sino a cada pájaro: un agente que solo ve lo que tiene alrededor, dentro de un radio, y decide hacia dónde girar. Presentó el modelo en 1987 en la conferencia de gráficos SIGGRAPH, con el artículo «Flocks, Herds, and Schools: A Distributed Behavioral Model» (bandadas, manadas y bancos de peces). El nombre boid viene de bird-oid object, «objeto parecido a un pájaro», y de paso imita cómo se pronuncia bird con acento de Nueva York. Cada boid sigue estas reglas:

  1. Separación: se aparta de los vecinos que tiene demasiado cerca, para no chocar.
  2. Alineación: gira hacia el rumbo medio de los vecinos que ve.
  3. Cohesión: se dirige hacia el centro de los vecinos que ve, para no quedarse solo.
SeparaciónSi un vecino está demasiado cerca,se aparta de él.AlineaciónGira hacia el rumbo mediode los vecinos que ve.CohesiónSe acerca al centrode los vecinos que ve.
Las tres reglas, vistas desde el boid azul. El círculo es lo que alcanza a ver, y el discontinuo de la separación, la distancia a la que empieza a apartarse; en la alineación, la flecha discontinua es su rumbo de antes y la continua, hacia dónde gira. Esquema: decodigo.com.

Ninguna regla habla de bandadas, de formas ni de líderes. Todo lo que se ve en la animación sale de que cada boid aplique las tres, a la vez, en cada instante.

Pruébalo

La animación tiene entre 50 y 170 boids, según el tamaño de tu pantalla, y el lienzo se cierra sobre sí mismo: lo que sale por un borde entra por el contrario. Los botones vuelven a empezar con los boids al azar y una de las reglas quitada, para ver qué papel juega cada una, y los deslizadores cambian su peso sobre la marcha, es decir, cuánto cuenta en la decisión de cada boid. Marca «Ver lo que ve un boid» para seguir a uno: el círculo grande es su radio de visión, el discontinuo es la distancia a la que empieza a apartarse, y los vecinos que tiene en cuenta salen en azul. Pasa el ratón por encima o toca el lienzo y los boids huirán de ti, como de un halcón. El orden mide cuánto se parecen sus rumbos: 0 si cada uno va a su aire y 1 si todos vuelan en la misma dirección.

Prueba:

Qué pasa si quitas una regla

Las tres reglas se necesitan unas a otras, y la mejor forma de entenderlo es quitarlas de una en una:

  • Sin separación, nada impide que se amontonen. Cada grupo se aprieta hasta que todos sus boids ocupan el mismo punto y vuelan uno encima de otro: parece que la bandada se ha quedado en unos pocos pájaros.
  • Sin alineación, los boids se buscan pero no copian el rumbo de nadie. Se forman corrillos que bullen y se deshacen, como una nube de mosquitos, y el orden se queda cerca de 0.
  • Sin cohesión, copian el rumbo de sus vecinos, pero nada los atrae hacia el grupo. Acaban repartidos por todo el cielo, a distancias casi iguales, como en una rejilla, sin formar grupos compactos. Eso sí, como siguen copiando el rumbo, a menudo terminan volando todos en la misma dirección.

Con las tres a la vez, la separación mantiene las distancias, la cohesión impide que el grupo se disperse y la alineación hace que viaje en una dirección. El equilibrio entre ellas decide la forma: sube la cohesión a 3 y saldrán unas pocas bolas apretadas; sube la separación y los boids se espaciarán como en una rejilla, en bandadas más anchas y ralas; sube la alineación y todos acabarán volando casi en paralelo.

Cómo se programa

En cada paso de la animación, cada boid recorre a todos los demás y se queda con los que están dentro de su radio de visión, aquí 50 píxeles. Con ellos calcula tres direcciones: la de huida de los que están a menos de 20 píxeles (cuanto más cerca, más empujan), el rumbo medio y el punto medio. Para cada una calcula una fuerza de dirección, la diferencia entre la velocidad que lleva y la que llevaría si fuera a toda velocidad hacia ese objetivo, y la limita para que no pueda girar de golpe. Las tres fuerzas, multiplicadas por sus pesos, se suman a su velocidad. Así funcionan las «conductas de dirección» que Reynolds desarrolló después, y por eso la bandada gira con suavidad, sin tirones.

Hay dos detalles importantes. El primero: todos los boids deciden mirando la misma foto de la bandada, la del paso anterior, y solo después se mueven todos a la vez; si cada uno se moviera nada más decidir, el orden en que se recorren cambiaría el resultado. El segundo es el coste: si cada boid mira a todos los demás, con 170 boids son casi 29,000 comparaciones por paso, y el número crece con el cuadrado de la bandada. Para miles de boids, los programas reparten el espacio en una rejilla y cada boid solo mira las casillas que tiene al lado.

Boids en Python

Este programa es exactamente el mismo cálculo que la animación de arriba: lo hemos comprobado pasando el mismo estado inicial a los dos y, tras 300 pasos, las posiciones coinciden hasta el último decimal. Simula 80 boids sin dibujarlos y mide el orden cada 60 pasos, primero con las tres reglas y después sin la alineación:

import math, random

# Mundo de 400 × 400 que se cierra sobre sí mismo: lo que sale por un borde entra por el contrario.
ANCHO = ALTO = 400.0
VISION, ESPACIO = 50.0, 20.0           # radio en el que un boid ve a los demás y radio en el que los aparta
VMAX, VMIN, FMAX = 3.0, 1.5, 0.05      # velocidad máxima y mínima, giro máximo por paso


def envolver(d, lado):
    """Diferencia más corta en un mundo que se cierra: de 390 a 10 hay 20, no 380."""
    if d > lado / 2: return d - lado
    if d < -lado / 2: return d + lado
    return d


def dirigir(dx, dy, vx, vy):
    """Fuerza para pasar de la velocidad (vx, vy) a ir a toda velocidad hacia (dx, dy), con un tope."""
    m = math.sqrt(dx * dx + dy * dy)
    if m == 0: return 0.0, 0.0
    fx, fy = dx / m * VMAX - vx, dy / m * VMAX - vy
    n = math.sqrt(fx * fx + fy * fy)
    if n > FMAX: fx, fy = fx / n * FMAX, fy / n * FMAX
    return fx, fy


def paso(bandada, separacion=1.5, alineacion=1.0, cohesion=1.0):
    """Un paso de la simulación. Cada boid es [x, y, vx, vy]. Todos deciden con la foto del paso anterior."""
    giros = []
    for i, (x, y, vx, vy) in enumerate(bandada):
        n = 0; mvx = mvy = cx = cy = sx = sy = 0.0; aparta = False
        for j, (x2, y2, vx2, vy2) in enumerate(bandada):
            if j == i: continue
            dx, dy = envolver(x2 - x, ANCHO), envolver(y2 - y, ALTO)
            d2 = dx * dx + dy * dy
            if d2 < VISION * VISION:
                n += 1; mvx += vx2; mvy += vy2; cx += dx; cy += dy
                if 0 < d2 < ESPACIO * ESPACIO:
                    sx -= dx / d2; sy -= dy / d2; aparta = True     # cuanto más cerca, más empuja
        ax = ay = 0.0
        if aparta:
            fx, fy = dirigir(sx, sy, vx, vy); ax += separacion * fx; ay += separacion * fy
        if n:
            fx, fy = dirigir(mvx, mvy, vx, vy); ax += alineacion * fx; ay += alineacion * fy   # rumbo medio
            fx, fy = dirigir(cx, cy, vx, vy); ax += cohesion * fx; ay += cohesion * fy         # centro del grupo
        giros.append((ax, ay))
    for b, (ax, ay) in zip(bandada, giros):
        b[2] += ax; b[3] += ay
        v = math.sqrt(b[2] * b[2] + b[3] * b[3])
        if v > VMAX: b[2] = b[2] / v * VMAX; b[3] = b[3] / v * VMAX
        elif 0 < v < VMIN: b[2] = b[2] / v * VMIN; b[3] = b[3] / v * VMIN
        b[0] += b[2]; b[1] += b[3]
        if b[0] < 0: b[0] += ANCHO
        elif b[0] >= ANCHO: b[0] -= ANCHO
        if b[1] < 0: b[1] += ALTO
        elif b[1] >= ALTO: b[1] -= ALTO


def orden(bandada):
    """De 0 (cada uno a su aire) a 1 (todos en la misma dirección): media de las direcciones."""
    ux = uy = 0.0
    for _, _, vx, vy in bandada:
        v = math.sqrt(vx * vx + vy * vy); ux += vx / v; uy += vy / v
    return math.sqrt(ux * ux + uy * uy) / len(bandada)


def nueva(n, semilla):
    r = random.Random(semilla)
    bandada = []
    for _ in range(n):
        a = r.uniform(0, 2 * math.pi)
        bandada.append([r.uniform(0, ANCHO), r.uniform(0, ALTO), 2 * math.cos(a), 2 * math.sin(a)])
    return bandada


if __name__ == "__main__":
    for titulo, pesos in [("Las tres reglas", (1.5, 1.0, 1.0)), ("Sin alineación", (1.5, 0.0, 1.0))]:
        bandada = nueva(80, semilla=7)
        print(titulo)
        for t in range(301):
            if t % 60 == 0:
                print(f"  paso {t:3d}: orden {orden(bandada):.2f}  " + "#" * round(orden(bandada) * 40))
            paso(bandada, *pesos)
salidaLas tres reglas
  paso   0: orden 0.14  ######
  paso  60: orden 0.34  #############
  paso 120: orden 0.47  ###################
  paso 180: orden 0.71  #############################
  paso 240: orden 0.94  #####################################
  paso 300: orden 0.97  #######################################
Sin alineación
  paso   0: orden 0.14  ######
  paso  60: orden 0.17  #######
  paso 120: orden 0.16  ######
  paso 180: orden 0.26  ##########
  paso 240: orden 0.22  #########
  paso 300: orden 0.26  ##########

Con las tres reglas, el orden empieza en 0.14, porque cada boid sale en una dirección al azar, y pasa de 0.9 en unos 240 pasos: la bandada ya vuela en un solo sentido. Sin alineación, en cambio, se queda por debajo de 0.3, por mucho que los boids se busquen unos a otros. El generador de números aleatorios lleva una semilla fija, así que la salida es idéntica en cada ejecución.

Del cine a los estorninos

La primera película con boids fue el corto Stanley and Stella in: Breaking the Ice, que se estrenó en el mismo SIGGRAPH de 1987. El gran salto llegó en 1992 con Batman Returns, de Tim Burton, que usó una versión modificada para los enjambres de murciélagos y los ejércitos de pingüinos. En 1998 la Academia de Hollywood premió a Reynolds con un Oscar técnico por su trabajo pionero en animación por ordenador. Los boids también están en videojuegos, como los pájaros de Half-Life (1998), que en los archivos del juego se llaman precisamente «boid», y en la robótica, donde las mismas reglas coordinan grupos de drones.

Y la naturaleza resultó parecerse al modelo, con un matiz. En 2008, un equipo italiano reconstruyó en tres dimensiones bandadas de miles de estorninos sobre Roma y descubrió que cada pájaro no sigue a todos los que tiene a cierta distancia, sino a un número fijo de vecinos: de seis a siete, estén cerca o lejos. Según sus simulaciones, esa regla mantiene la bandada unida aunque se estire o se comprima al esquivar a un halcón. Es una pequeña corrección a los boids de Reynolds, que miden por distancia, y una prueba de lo bien que funcionaba la idea de partida: comportamientos complejos que surgen de reglas locales, la misma emergencia que se ve en el juego de la vida o en la hormiga de Langton.

Fuentes: C. W. Reynolds, «Flocks, Herds, and Schools: A Distributed Behavioral Model», Computer Graphics 21(4), SIGGRAPH ’87, y su página sobre los boids; M. Ballerini y otros, «Interaction ruling animal collective behavior depends on topological rather than metric distance», PNAS 105(4), 2008; las páginas de Wikipedia sobre los boids y sobre Craig Reynolds. El programa se ejecutó con Python 3.13. La animación y las imágenes, incluida la portada, las genera el propio algoritmo: decodigo.com.
El motor de curvatura: la física real detrás del «warp» de Star Trek, con una burbuja en 3D que puedes girar

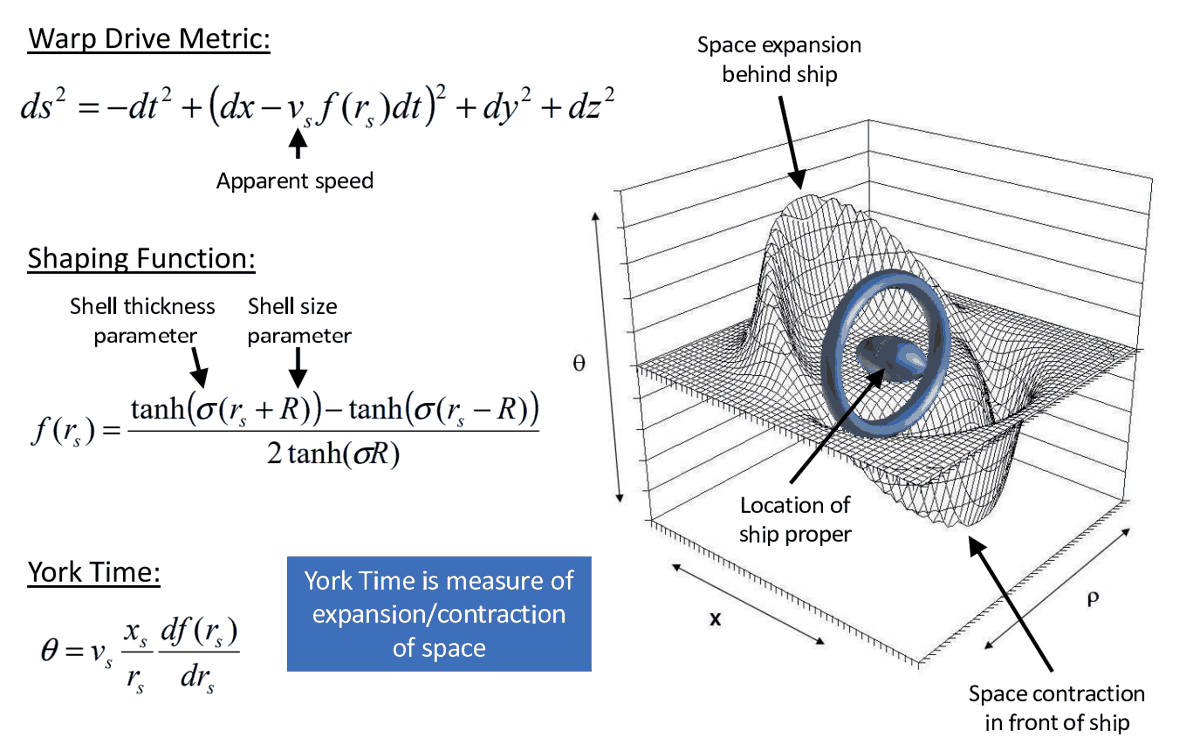
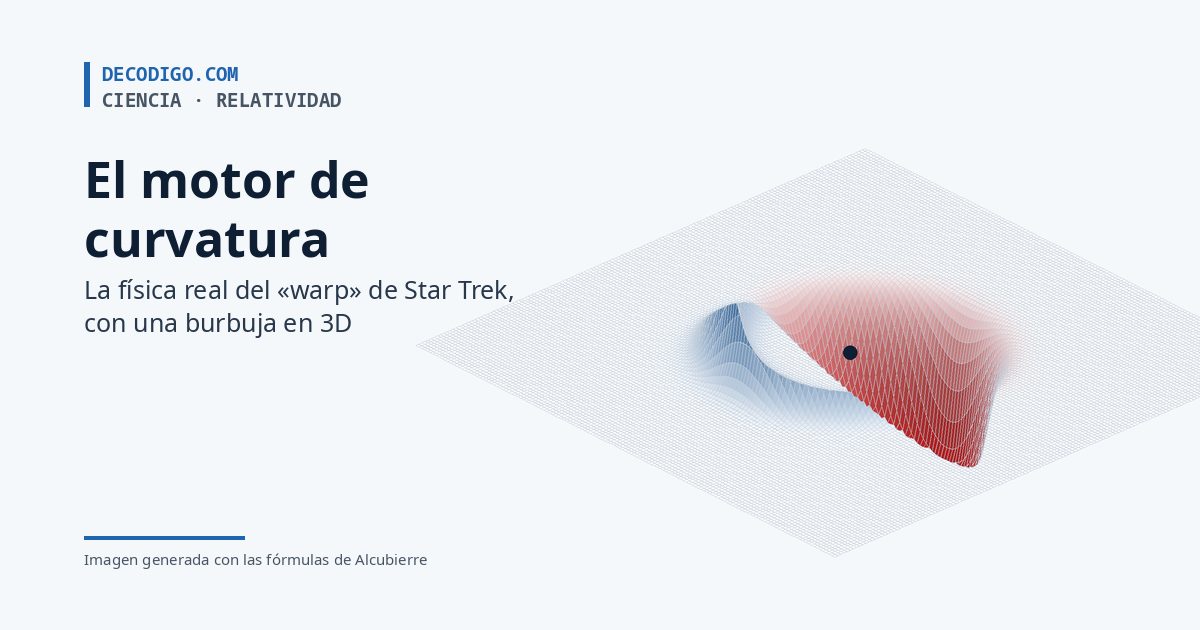
Superficie en 3D de la burbuja de Alcubierre: se eleva en azul detrás de la nave y se hunde en rojo delante, junto al título El motor de curvatura

En Star Trek, el capitán dice «velocidad de curvatura» y la nave cruza la galaxia en unos días. Parece pura fantasía, pero en 1994 un físico mexicano, Miguel Alcubierre, demostró que las ecuaciones de Einstein permiten algo parecido: una nave que no se mueve por el espacio, sino que deforma el espacio a su alrededor, encogiéndolo delante y estirándolo detrás. Es el motor de curvatura, o warp drive. Te contamos cómo funciona, por qué nadie sabe construirlo y qué se ha descubierto desde entonces, con una burbuja en 3D que puedes girar.

De la tele a una revista de física

La palabra warp («curvar», «deformar») la popularizó Star Trek desde 1966; en el doblaje de España se tradujo como «velocidad de curvatura» y en el de Latinoamérica se suele dejar como «velocidad warp». La serie nunca explicó cómo funcionaba: los personajes decían que curvaban el espacio, y listo. Alcubierre, que entonces terminaba su doctorado en la Universidad de Gales, en Cardiff, se preguntó si la relatividad general lo permitía de verdad, y la respuesta le salió en un artículo de cinco páginas: The warp drive: hyper-fast travel within general relativity, publicado en 1994 en la revista Classical and Quantum Gravity. Él mismo ha contado que el nombre lo tomó de la serie.

El físico mexicano Miguel Alcubierre dando una charla, con una diapositiva sobre el principio de equivalencia detrás
Miguel Alcubierre en una charla en la Campus Party de México, en 2011. Hoy es investigador de la UNAM, donde trabaja en relatividad numérica y agujeros negros. Foto: Campus Party México, CC BY 2.0, recortada.

El problema: el universo es enorme

La estrella más cercana al Sol, Próxima Centauri, está a 4.24 años luz: unos 40 billones de kilómetros. La luz tarda más de cuatro años en recorrerlos, y nuestras naves van muchísimo más despacio. La Voyager 1, lanzada en 1977 y hoy el objeto humano más lejano, tardaría unos 75,000 años en llegar.

Próxima Centauri vista por el telescopio Hubble: una estrella brillante con picos de difracción sobre un fondo de estrellas
Próxima Centauri vista por el telescopio Hubble. Es una enana roja, más pequeña y fría que el Sol, y tiene al menos un planeta en la zona en la que podría haber agua líquida. Foto: ESA/Hubble y NASA, CC BY 2.0.
¿Cuánto se tarda en llegar aPróxima Centauri (4.24 años luz)?1101001,000100,000Voyager 117 km/s, la nave más lejana75,000 añosParker Solar Probe192 km/s, lo más rápido construido6,600 añosBreakthrough Starshot20 % de la luz, una vela solo en papel21.2 añosLa luz300,000 km/s, el límite4.2 añosBurbuja a 10 veces la luzhipotética5 mesesaños, en escala logarítmica
Tiempo de viaje en línea recta y a velocidad constante, sin acelerar ni frenar. Breakthrough Starshot es un proyecto de velas de luz que no ha pasado de los estudios. Esquema: decodigo.com.

Y no se puede simplemente acelerar más: según la relatividad especial, nada con masa alcanza la velocidad de la luz, porque cuanto más se acerca, más energía hace falta para ganar un poco más de velocidad. Es el límite de velocidad del universo.

El truco: no moverse por el espacio, sino mover el espacio

La clave está en la letra pequeña de ese límite: lo que no puede superar la velocidad de la luz es algo que se mueve a través del espacio, comparado con lo que tiene justo al lado. El espacio en sí no tiene esa restricción. De hecho, ya lo hace: el universo se expande, y las galaxias muy lejanas se alejan de nosotros más deprisa que la luz, sin que ninguna de ellas viole nada, porque no se mueven por el espacio: es el espacio entre ellas el que crece.

Además, desde Einstein sabemos que el espacio no es un escenario rígido. La masa lo curva, y eso se ve: la luz de una galaxia lejana que pasa junto a otra muy pesada sigue el espacio curvado y nos llega deformada, a veces en forma de anillo.

El anillo de Einstein en forma de herradura LRG 3-757: la luz azul de una galaxia lejana curvada alrededor de una galaxia roja
La «herradura cósmica»: la galaxia roja del centro curva el espacio a su alrededor, y la luz de una galaxia azul que está detrás nos llega estirada en forma de arco, casi un anillo completo. Es una prueba visible de que el espacio se deforma. Foto: ESA/Hubble y NASA, dominio público.

La idea de Alcubierre junta las dos cosas. Imagina que pudieras encoger el espacio delante de la nave y estirarlo detrás. La nave quedaría dentro de una «burbuja» de espacio normal, plano, que se desliza como una ola: la nave no se mueve dentro de la burbuja, es la burbuja entera la que avanza. Es como estar de pie en un pasillo mecánico de aeropuerto: no caminas, pero llegas.

La nave no se mueve por el espacio:mueve el espacioaquí, todo normalhacia dónde vadetrás, se estiradelante, se encoge
La rejilla representa el espacio. En la pared de la burbuja se deforma: detrás las líneas se separan y delante se juntan. Dentro, la nave está quieta en espacio plano. Esquema: decodigo.com.

Y tiene ventajas sorprendentes. Como la nave no acelera dentro de la burbuja, la tripulación no nota ninguna fuerza: ni aplastamiento por la aceleración ni nada. Y como no se mueve por el espacio, su reloj marcha al mismo ritmo que los de la Tierra: no hay el «efecto gemelos» de la relatividad, en el que el viajero vuelve más joven. Las ecuaciones permiten además que la burbuja vaya a cualquier velocidad, también más deprisa que la luz.

La burbuja, en 3D

Alcubierre describió la forma de la burbuja con una fórmula, una función que vale 1 dentro, donde está la nave, y 0 lejos de ella, y pasa de un valor al otro en una «pared» cuyo grosor se ajusta con un número, σ. De ahí sale cuánto se estira o se encoge el espacio en cada punto. La animación dibuja exactamente eso, con las fórmulas de su artículo, sobre un corte del espacio que pasa por la nave: la altura indica cuánto se estira el espacio (hacia arriba, en azul) o se encoge (hacia abajo, en rojo). Arrastra el dibujo para girarlo (o usa las flechas del teclado) y prueba a cambiar la velocidad y el grosor de la pared. Con el botón de la energía verás el precio que hay que pagar, del que hablamos justo después.

Ver:

La nave está en el centro, en una zona completamente plana: allí no pasa nada. Toda la acción está en la pared. Fíjate en lo que pasa al hacer la pared más fina: los picos crecen mucho, porque el mismo cambio de espacio tiene que ocurrir en menos sitio. Es la misma figura que aparece en el artículo original, con los mismos valores (σ = 8 y la velocidad de la luz).

La trampa: hace falta energía negativa

En la relatividad general, lo que curva el espacio es la materia y la energía. Así que la pregunta obvia es: ¿qué materia hace falta para que el espacio adopte esa forma? Alcubierre hizo la cuenta, y la respuesta fue el gran jarro de agua fría: hace falta una densidad de energía negativa, menor que la del vacío. Es lo que los físicos llaman materia exótica, y nadie la ha visto nunca en cantidades grandes. Si pulsas «Energía que hace falta» en la animación, verás que forma un anillo alrededor de la nave y que es negativa en todos sus puntos.

No es del todo ciencia ficción: la física cuántica permite pequeñas regiones con energía negativa. El ejemplo más conocido es el efecto Casimir, una fuerza diminuta que aparece entre dos placas metálicas muy cercanas en el vacío y que se ha medido en el laboratorio. Pero son cantidades minúsculas, y la teoría pone límites a cuánta energía negativa puede juntarse, y durante cuánto tiempo.

Y además hace falta muchísima. La historia del motor de curvatura es, en buena parte, la historia de intentar rebajar esa factura:

  • 1994, Miguel Alcubierre: la burbuja original. Necesita energía negativa, aunque él no calculó cuánta.
  • 1997, Michael Pfenning y Lawrence Ford: al aplicarle los límites de la física cuántica, la pared tendría que ser finísima, de unos cientos de longitudes de Planck, y la energía negativa, unos diez órdenes de magnitud mayor que la masa de todo el universo visible.
  • 1999, Chris Van Den Broeck: una burbuja diminuta por fuera y grande por dentro baja la factura a unas pocas masas solares de energía negativa.
  • 2012, Harold White (NASA): con una burbuja en forma de rosquilla y que oscila, según sus cuentas bastaría la energía equivalente a unos 700 kg de masa, lo que pesa la sonda Voyager 1.
  • 2021, Erik Lentz: ondas solitarias (solitones) que podrían ir más deprisa que la luz con energía positiva, pero que necesitarían cientos de veces la masa de Júpiter para una nave de 100 metros.
  • 2021 y 2024, Alexey Bobrick, Gianni Martire, Jared Fuchs y otros: motores «físicos», hechos con materia y energía normales, pero que van más despacio que la luz.

Las cifras de 1997 y 1999 están en los artículos originales; la de White es su propia estimación, presentada en conferencias y no en una revista científica. Lo interesante de los trabajos más recientes es el cambio de enfoque: en lugar de pedir materia exótica, buscan burbujas hechas con materia y energía normales, aunque eso obligue a renunciar a superar la velocidad de la luz.

Más problemas: no se puede pilotar

Aunque tuviéramos la energía, quedan otros obstáculos. El más curioso lo señaló el físico ruso Serguéi Krasnikov en los años noventa: si la burbuja va más deprisa que la luz, la nave no puede controlarla. Para frenar, girar o incluso crear la burbuja, la nave tendría que enviar alguna señal a la pared delantera, y ninguna señal va más deprisa que la luz. La pared delantera queda fuera de su alcance, igual que el interior de un agujero negro queda fuera del nuestro.

¿Por qué no se puede pilotar másdeprisa que la luz?Al encender la señalUn rato despuéspared delanteraLa señal avanza, pero no alcanza la pared:esta se aleja más deprisa que la luz.
Si la burbuja va más deprisa que la luz, una señal que sale de la nave hacia delante nunca alcanza la pared delantera: para la nave, la pared está detrás de un horizonte. Esquema: decodigo.com.

Hay más. En 2009, Stefano Finazzi, Stefano Liberati y Carlos Barceló calcularon que, por efectos cuánticos, una burbuja más rápida que la luz acumularía energía en su pared delantera hasta volverse inestable. Y cualquier forma de viajar más deprisa que la luz permite, combinándola bien, viajar al pasado, con todas sus paradojas. Para rematar, en 2024 Katy Clough, Tim Dietrich y Sebastian Khan simularon en un superordenador qué pasaría si una burbuja de Alcubierre se viniera abajo: soltaría un breve estallido de ondas gravitacionales de frecuencia muy alta, que los detectores actuales no captarían.

La NASA y el laboratorio Eagleworks

La idea también llegó a la NASA. Harold «Sonny» White, del Centro Espacial Johnson, dirigió en la década de 2010 un pequeño laboratorio de propulsión avanzada, Eagleworks, que montó un interferómetro para intentar detectar una minúscula deformación del espacio. Nunca publicó una detección. En 2021, ya en una fundación privada y con un contrato de DARPA, White publicó un estudio teórico según el cual cierta estructura microscópica produciría una distribución de energía negativa parecida a la de la burbuja. La prensa lo presentó como «la primera burbuja de curvatura», pero era un cálculo, no un experimento, y muchos físicos criticaron que se vendiera así.

Diagrama de la NASA con la métrica de Alcubierre, su función de forma y una superficie que se eleva detrás de la nave y se hunde delante
La burbuja tal como la presentó Harold White en Warp Field Mechanics 101 (NASA, 2011): la fórmula de Alcubierre, la forma de la burbuja y la expansión del espacio, que sube detrás de la nave y baja delante, como en nuestra animación. Imagen: NASA, dominio público.

La burbuja en Python

Las fórmulas del artículo de Alcubierre caben en unas pocas líneas de numpy. El programa calcula, en un corte del espacio, cuánto se estira y se encoge el espacio y cuánta energía hace falta en cada punto, para paredes cada vez más finas. Usa las unidades habituales en relatividad, en las que la velocidad de la luz vale 1, con una burbuja de radio 1 que viaja a la velocidad de la luz:

import numpy as np

R, v = 1.0, 1.0          # radio de la burbuja y velocidad (unidades con c = G = 1)


def f(r, s):
    """Forma de la burbuja: vale 1 dentro, 0 fuera; s marca lo fina que es la pared."""
    return (np.tanh(s * (r + R)) - np.tanh(s * (r - R))) / (2 * np.tanh(s * R))


def df(r, s):
    sech2 = lambda z: 1 / np.cosh(z) ** 2
    return s * (sech2(s * (r + R)) - sech2(s * (r - R))) / (2 * np.tanh(s * R))


# Un corte del espacio: x en la dirección del viaje, rho a lo ancho. La nave está en x = 0.
x, rho = np.meshgrid(np.linspace(-3, 3, 1201), np.linspace(0, 3, 601), indexing="ij")
r = np.hypot(x, rho)
dV = 2 * np.pi * rho * (x[1, 0] - x[0, 0]) * (rho[0, 1] - rho[0, 0])   # volumen de cada anillo

for s in (2, 4, 8, 16):
    theta = v * (x / r.clip(1e-12)) * df(r, s)                 # expansión del espacio
    energia = -(v ** 2) * rho ** 2 * df(r, s) ** 2 / (32 * np.pi * r.clip(1e-12) ** 2)
    i, j = np.unravel_index(theta.argmax(), theta.shape)
    k, l = np.unravel_index(theta.argmin(), theta.shape)
    signo = "≤ 0" if energia.max() <= 0 else "> 0 en algún punto"
    print(f"s = {s:2d}: estira {theta.max():+.2f} en x = {x[i, j]:+.0f}, encoge {theta.min():+.2f} en x = {x[k, l]:+.0f}; "
          f"energía {signo}, total {(energia * dV).sum():.3f}")
salidas =  2: estira +1.04 en x = -1, encoge -1.04 en x = +1; energía ≤ 0, total -0.064
s =  4: estira +2.00 en x = -1, encoge -2.00 en x = +1; energía ≤ 0, total -0.114
s =  8: estira +4.00 en x = -1, encoge -4.00 en x = +1; energía ≤ 0, total -0.223
s = 16: estira +8.00 en x = -1, encoge -8.00 en x = +1; energía ≤ 0, total -0.445

La salida confirma tres cosas. El espacio se estira más justo detrás de la nave (x = −1, en la pared trasera) y se encoge lo mismo justo delante (x = +1). La energía no es positiva en ningún punto: el motor necesita energía negativa en toda la pared. Y cuanto más fina es la pared, más intensos son los picos, en proporción directa al número σ, y mayor es también la energía negativa total, que crece casi en la misma proporción.

¿Lo veremos?

Probablemente no, al menos no tal como lo imaginó Alcubierre. Nadie sabe fabricar materia exótica en las cantidades necesarias, y aunque se supiera, no está claro que una burbuja más rápida que la luz se pudiera controlar ni que fuera estable. Él mismo lo ha dicho muchas veces: su artículo no era un plano para construir una nave, sino una forma de explorar hasta dónde llegan las leyes de la física. Y en eso ha sido un éxito. Treinta años después, el motor de curvatura sigue sirviendo para estudiar qué permite y qué prohíbe la relatividad general, y hay equipos buscando versiones con materia normal. Más lentas que la luz, sí, pero menos imposibles.

Fuentes: M. Alcubierre, «The warp drive: hyper-fast travel within general relativity», Classical and Quantum Gravity 11, L73 (1994), en arXiv, del que salen las fórmulas de la animación y del programa; M. J. Pfenning y L. H. Ford, «The unphysical nature of “warp drive”», arXiv (1997); C. Van Den Broeck, «A “warp drive” with more reasonable total energy requirements», arXiv (1999); S. V. Krasnikov, «Hyperfast interstellar travel in general relativity», arXiv; S. Finazzi, S. Liberati y C. Barceló, «Semiclassical instability of dynamical warp drives», arXiv (2009); H. White, «Warp Field Mechanics 101», NASA (2011); E. W. Lentz, «Breaking the warp barrier», Classical and Quantum Gravity 38 (2021); A. Bobrick y G. Martire, «Introducing physical warp drives», arXiv (2021); J. Fuchs y otros, «Constant velocity physical warp drive solution», arXiv (2024); K. Clough, T. Dietrich y S. Khan, «What no one has seen before: gravitational waveforms from warp drive collapse», arXiv (2024). El programa se ejecutó con Python 3.13 y numpy 2.5.4. La animación y los esquemas: decodigo.com.

Reacción-difusión: cómo dos sustancias imaginarias dibujan manchas, rayas y laberintos, con animación

Figura de reacción-difusión generada por el algoritmo: un laberinto azul que se deshace en manchas hacia la izquierda, junto al título del artículo

¿Cómo sabe la piel de un leopardo dónde poner cada mancha, o la de una cebra dónde va cada raya? En 1952, Alan Turing propuso una respuesta sorprendente: no hace falta ningún plano. Bastan dos sustancias que reaccionan entre sí y se difunden a distinta velocidad para que, a partir de una mezcla casi uniforme, aparezcan solas manchas, rayas y laberintos. Es la reacción-difusión, y aquí puedes verla en marcha y jugar con ella.

Una idea de Turing

Turing es conocido sobre todo por sus trabajos sobre la computación y por descifrar códigos en la Segunda Guerra Mundial, pero uno de sus últimos artículos, The Chemical Basis of Morphogenesis (1952), trataba de biología: de cómo un embrión, que empieza siendo una bola de células casi iguales, desarrolla formas y dibujos. Su idea era que unas sustancias químicas, a las que llamó morfógenos, podían organizarse solas en patrones si se cumplían dos condiciones: que una de ellas se fabricara a sí misma (que fuera autocatalítica) y que las dos se extendieran por el tejido a velocidades distintas.

Durante décadas fue una curiosidad teórica. En 1990, un equipo francés de Burdeos consiguió por primera vez manchas de Turing en un laboratorio, con una reacción química en un gel. Y en 1995, Shigeru Kondo y Rihito Asai mostraron en Nature que las rayas del pez ángel emperador se mueven y se reorganizan a medida que el pez crece, justo como predice el modelo. Hoy se estudia su papel en las rayas del pez cebra, en el reparto de los folículos del pelo y en las huellas dactilares.

Las reglas del juego

El modelo más usado para verlo en un ordenador es el de Gray-Scott, de los químicos Peter Gray y Stephen Scott. Imagina un tablero en el que cada casilla tiene una cantidad de dos sustancias, U y V, y en cada paso pasan cuatro cosas:

Alimentación (F)Entra U nueva sin parar, másdeprisa donde queda poca.FUUUUReacciónDonde hay V, se come a U yla convierte en más V.U+VVVVVU + 2V → 3VRetirada (k)V se va eliminando poco apoco, al ritmo k + F.VVVVkDifusiónLas dos se reparten hacia lascasillas vecinas; U, el doble de rápido.UV
Las cuatro piezas del modelo de Gray-Scott. U, en azul claro, es el alimento; V, en azul marino, se reproduce comiéndose a U. Esquema: decodigo.com.

Lo importante es el equilibrio entre ellas. V se multiplica allí donde ya hay V (la reacción), pero gasta U, y U llega desde las casillas vecinas más deprisa de lo que V se extiende. Así, una mancha de V crece, agota la U que tiene alrededor y deja un anillo hambriento en el que ninguna otra mancha puede crecer. Ese «yo crezco aquí, tú no puedes crecer al lado» es lo que reparte las manchas a distancias regulares. Todo depende de dos números: F, lo rápido que entra U nueva, y k, lo rápido que se elimina V. Pequeños cambios en ellos dan figuras muy distintas.

Pruébalo

La animación simula el modelo en un tablero de 240 por 160 casillas, cerrado sobre sí mismo: lo que sale por un borde entra por el contrario. Cuanto más oscuro, más V hay. Empieza con unas gotas de V repartidas; elige una receta para ver cada tipo de figura, o toca el tablero para añadir gotas (con el ratón también puedes arrastrar). Los deslizadores cambian F y k sobre la marcha, y puedes ver cómo una figura se transforma en otra. Si te pierdes, «Empezar de nuevo» vuelve a la receta.

Receta:
Velocidad:

0 pasos

Un mapa de figuras

En 1993, John Pearson publicó en Science el artículo Complex Patterns in a Simple System, en el que recorrió con un ordenador cientos de combinaciones de F y k y clasificó las figuras que aparecían. Su hallazgo más llamativo fueron las manchas que se dividen como células: crecen hasta un tamaño crítico, se estiran y se parten en dos, una y otra vez. Estas son las recetas de la animación:

RecetaFkQué se ve
Manchas0.03670.0649Manchas que se dividen hasta llenar el tablero, como un cultivo de células
Laberinto0.0290.057Rayas que se ramifican, como una cebra o una huella dactilar
Coral0.05450.062Rayas gruesas que crecen por las puntas
Agujeros0.0390.058El negativo de las manchas: huecos redondos en un fondo de V
Gusanos0.0780.061Tiras y anillos sueltos que crecen despacio

Fuera de una franja estrecha de valores no pasa nada interesante: V desaparece o lo invade todo. Las figuras viven justo en la frontera entre esos dos extremos.

Reacción-difusión en Python

Con numpy, el modelo cabe en unas pocas líneas: np.roll desplaza el tablero entero una casilla para sumar las vecinas de todas las casillas a la vez. El programa empieza con una sola mancha en el centro, con los valores de la receta de las manchas, y cada 3,000 pasos cuenta cuántas hay:

import numpy as np

N = 100                     # tablero de 100 × 100 casillas, cerrado sobre sí mismo
F, K = 0.0367, 0.0649       # alimentación y retirada: la zona de las manchas que se dividen
DU, DV = 1.0, 0.5           # V se difunde a la mitad de velocidad que U


def laplaciano(Z):
    """Cuánto se diferencia cada casilla de la media de sus vecinas (lados 0.2, diagonales 0.05)."""
    lados = np.roll(Z, 1, 0) + np.roll(Z, -1, 0) + np.roll(Z, 1, 1) + np.roll(Z, -1, 1)
    diagonales = sum(np.roll(np.roll(Z, a, 0), b, 1) for a in (1, -1) for b in (1, -1))
    return 0.2 * lados + 0.05 * diagonales - Z


def manchas(V):
    """Cuenta las manchas: grupos de casillas con V > 0.2 que se tocan por un lado."""
    dentro, vistas, n = V > 0.2, np.zeros_like(V, dtype=bool), 0
    for y, x in zip(*np.nonzero(dentro)):
        if vistas[y, x]:
            continue
        n += 1
        pila = [(y, x)]
        vistas[y, x] = True
        while pila:
            cy, cx = pila.pop()
            for dy, dx in ((1, 0), (-1, 0), (0, 1), (0, -1)):
                ny, nx = (cy + dy) % N, (cx + dx) % N
                if dentro[ny, nx] and not vistas[ny, nx]:
                    vistas[ny, nx] = True
                    pila.append((ny, nx))
    return n


U = np.ones((N, N))         # todo lleno de U...
V = np.zeros((N, N))        # ...y nada de V, salvo una mancha cuadrada en el centro
U[45:55, 45:55], V[45:55, 45:55] = 0.5, 0.25

for paso in range(1, 30001):
    uvv = U * V * V                              # la reacción: U + 2V → 3V
    U += DU * laplaciano(U) - uvv + F * (1 - U)  # entra U nueva
    V += DV * laplaciano(V) + uvv - (K + F) * V  # sale V
    if paso % 3000 == 0:
        print(f"Paso {paso:>6}: {manchas(V):>3} manchas")

# Dibujo: más oscuro cuanto más V hay; cada carácter es un bloque de 2 × 4 casillas
for fila in range(0, N, 4):
    print("".join(" .:-=+*#%@"[min(9, int(V[fila:fila + 4, col:col + 2].mean() / 0.035))] for col in range(0, N, 2)))
salidaPaso   3000:   1 manchas
Paso   6000:   1 manchas
Paso   9000:   1 manchas
Paso  12000:   4 manchas
Paso  15000:  20 manchas
Paso  18000:  32 manchas
Paso  21000:  32 manchas
Paso  24000:  32 manchas
Paso  27000:  32 manchas
Paso  30000:  32 manchas
   .:..   :--:.      ..:.    .=**+:       :*%@#=. 
         -#@@%=.    :*@@%=.  -%@@@=.      -%@@@+. 
.-+*=:   :*@@%=.    :*@@@+.  .=**=.   .   .:==-.  
-#@@@+.   .::.       .:-:.         .=#%*-         
.=#%*-.         :+**-.     ....    -%@@@=.        
  ..    :+*=:  .+@@@#:   .=#@%*:   .-++-.  :+##+: 
       :*@@@*:  :=*+-.   .+@@@%-          .=@@@%- 
 .:::. .-*#*=.            .-==:    .:-:.   .=**-. 
:*@@%+.           .=**=.          :*@@@*:         
:+@@@+.    ...   .=@@@%=.  .:::.  .+%@%+.    ..   
 .:-:.   .+%@#=.  :=**=.  :*@@@+.   .:..  .-#%#=. 
         :#@@@+.          :*@@@+.         :*@@@#: 
  :=+=:   :-=-.   .:::.    .:::.   .-=-:   :=+=:  
 :#@@@*:         .+@@@*:          .+@@@#:         
 .=#%#-.  ..:.   .+@@@*:  .=**=:  .=#@%+.   .:-:. 
   ..    .+%@%+.  .:::.  .=%@@@=.   ...    .+@@@+:
         :*@@@*:          .=**=.           .+%@@*:
 .-**=.   .:-:.    :==-.            .=*#*-. .:::. 
 -%@@@=.          -%@@@+.   .-+*=:  :*@@@*:       
 :+##+:  .-++-.   :*%@#=.   :#@@@+.  :=*+:    ..  
        .=@@@%-    ....     .-**+:         .-*%#=.
         -*%#=.         .:-:.       .::.   .+@@@#-
  .-==:.   .   .=**=.  .+@@@*:    .=%@@*:   :=*+-.
 .+@@@%-      .=@@@%-  .=%@@*:    .=%@@#-         
 .=#@%*:       :+**=.    .:..      .:--:   ..:.   

Durante los primeros 9,000 pasos solo hay una mancha, que crece y cambia de forma. A los 12,000 pasos ya hay cuatro, a los 15,000 hay 20 y a los 18,000, 32. Ahí el tablero está lleno: cada mancha tiene a su alrededor el espacio justo para no estorbar a las demás, y la cuenta ya no cambia. El dibujo final muestra lo que más llama la atención del modelo: las manchas no están puestas al azar, sino a distancias casi iguales, aunque nadie les ha dicho dónde ponerse. Como el estado inicial es siempre el mismo, la salida es idéntica en cada ejecución.

Por qué fascina

Como el juego de la vida o la hormiga de Langton, la reacción-difusión muestra cómo reglas locales muy simples producen orden a gran escala. Pero aquí hay algo más: no es solo un juego matemático, sino una de las explicaciones que usa la biología para entender cómo se forman los dibujos de los seres vivos. Por eso también se usa en informática gráfica para generar texturas naturales, como pieles, cortezas o corales. Y tiene su ironía: el artículo con el que Turing abrió este campo se publicó dos años antes de su muerte, y tardó casi cuarenta en confirmarse en un laboratorio.

Fuentes: A. M. Turing, «The Chemical Basis of Morphogenesis», Philosophical Transactions of the Royal Society B (1952); J. E. Pearson, «Complex Patterns in a Simple System», Science 261 (1993), también en arXiv; V. Castets, E. Dulos, J. Boissonade y P. De Kepper, Physical Review Letters 64 (1990); S. Kondo y R. Asai, «A reaction-diffusion wave on the skin of the marine angelfish Pomacanthus», Nature 376 (1995); el tutorial de Karl Sims, cuyo esquema de cálculo usan la animación y el programa. El programa se ejecutó con Python 3.13 y numpy 2.5.4. La animación y las imágenes, incluida la portada, las genera el propio algoritmo: decodigo.com.
El juego de la vida de Conway: cuatro reglas, planeadores y un ordenador hecho de casillas, con animación

Pistola de planeadores de Gosper dibujada en una rejilla clara, con su chorro de planeadores bajando en diagonal, junto al título del artículo

Un tablero de casillas, cada una viva o muerta, y cuatro reglas que dicen qué pasa con ellas de una generación a la siguiente. Nadie juega: solo se mira. Y sin embargo, de esas reglas salen formas que se mueven solas por el tablero, otras que laten sin parar y hasta «pistolas» que disparan sin fin. Es el juego de la vida, que el matemático John Conway inventó en 1970, y con él se puede construir, en teoría, cualquier programa de ordenador.

Las reglas

Conway buscaba unas reglas lo más sencillas posible que dieran resultados impredecibles: ni que todo muriera enseguida ni que creciera sin control. Martin Gardner las dio a conocer en octubre de 1970, en su sección de juegos matemáticos de la revista Scientific American, y el juego se convirtió en una afición de miles de programadores, que dejaban sus ordenadores calculando generaciones por la noche. Es un autómata celular, como la hormiga de Langton: cada casilla mira a sus ocho vecinas (en horizontal, en vertical y en diagonal) y, en cada generación, todas cambian a la vez según estas reglas:

  1. Soledad: una casilla viva con menos de dos vecinas vivas muere.
  2. Supervivencia: una casilla viva con dos o tres vecinas vivas sigue viva.
  3. Superpoblación: una casilla viva con más de tres vecinas vivas muere.
  4. Nacimiento: una casilla muerta con exactamente tres vecinas vivas nace.
SoledadCon menos de 2 vecinas,una casilla viva muere.antesdespuésSupervivenciaCon 2 o 3 vecinas,una casilla viva sigue viva.antesdespuésSuperpoblaciónCon más de 3 vecinas,una casilla viva muere.antesdespuésNacimientoCon exactamente 3 vecinas,una casilla vacía nace.antesdespués
Las cuatro reglas, aplicadas a la casilla central (marcada en rojo). En «después» solo se muestra esa casilla: sus vecinas también cambian, cada una según sus propias vecinas. Esquema: decodigo.com.

Dicho de forma más corta: una casilla nace con 3 vecinas y sobrevive con 2 o 3. Por eso los aficionados escriben la regla como B3/S23, de born (nace) y survives (sobrevive).

Pruébalo

La animación muestra un tablero de 112 por 64 casillas. Las que acaban de nacer salen en azul, y las que sobreviven, en azul marino. Elige un patrón para ver los más famosos, que se explican más abajo, o toca el tablero para dar vida a las casillas que quieras (con el ratón también puedes arrastrar). «Un paso» avanza una sola generación, ideal para comprobar las reglas a mano. Lo que sale del tablero sigue vivo un rato fuera de la vista y luego desaparece, como si se alejara para siempre.

Patrón:
Velocidad:

Generación 0

Un zoo de patrones

En los primeros años, los aficionados se dedicaron a buscar y clasificar los patrones que aparecían. Estos son los tipos principales:

TipoQué haceEjemplos
Vidas quietasNo cambian nunca: cada casilla tiene justo las vecinas que necesitaEl bloque (cuatro casillas en cuadrado), la colmena
OsciladoresRepiten una serie de formas, siempre en el mismo sitioEl parpadeador (tres en fila, periodo 2), el púlsar (periodo 3)
Naves espacialesRecuperan su forma unas casillas más allá: se desplazan por el tableroEl planeador, que avanza una casilla en diagonal cada 4 generaciones
PistolasSe quedan en su sitio y disparan naves sin pararLa pistola de planeadores de Gosper
MatusalenesPatrones pequeños que tardan muchísimo en calmarseEl R-pentominó: 5 casillas, 1,103 generaciones

La pistola tiene su propia historia. Conway sospechaba que ningún patrón podía crecer sin límite, y ofreció 50 dólares a quien demostrara lo contrario. En noviembre de 1970, un equipo del MIT dirigido por Bill Gosper ganó el premio con una pistola que dispara un planeador cada 30 generaciones: como los planeadores se alejan para siempre, el número de casillas vivas crece sin fin. Es la que se ve al abrir la animación.

El R-pentominó, por su parte, es el ejemplo perfecto de lo difícil que es predecir el juego. Son solo cinco casillas con forma de R, pero se agitan durante 1,103 generaciones, llegan a tener 319 casillas vivas y lanzan seis planeadores, que fueron los primeros que se descubrieron. Al final quedan 116 casillas, que ya no cambian salvo los planeadores que se alejan.

Un ordenador hecho de casillas

Lo más sorprendente del juego de la vida es lo que se puede construir con él. Los planeadores pueden hacer de señales: un chorro de planeadores es una secuencia de unos y ceros, y cuando dos chorros se cruzan en el ángulo adecuado, las colisiones funcionan como puertas lógicas. Con pistolas, choques y otras piezas se pueden montar memorias, contadores y cualquier circuito. Conway y sus colegas demostraron que el juego de la vida es Turing completo: puede calcular cualquier cosa que calcule un ordenador, solo que de forma desesperadamente lenta. En el año 2000, Paul Rendell construyó dentro del juego una máquina de Turing completa, y desde entonces los aficionados han montado relojes digitales, patrones que van soltando los números primos uno a uno e incluso el propio juego de la vida simulado dentro del juego de la vida.

Esa potencia tiene un precio: como con un programa cualquiera, no hay un atajo general para saber qué hará un patrón. Para averiguar si un patrón acabará muriendo, quedándose quieto o creciendo para siempre, a menudo la única forma es simularlo generación a generación, igual que con la hormiga de Langton.

El juego de la vida en Python

Este programa guarda solo las casillas vivas, en un conjunto, así que el tablero es infinito. Para calcular la generación siguiente cuenta cuántas vecinas vivas tiene cada casilla con Counter y aplica la regla B3/S23 en una sola línea. Después comprueba que el planeador recupera su forma a las 4 generaciones y sigue al R-pentominó hasta que se calma:

from collections import Counter


def siguiente(vivas):
    """Una generación: cuenta los vecinos vivos de cada casilla y aplica las reglas."""
    vecinos = Counter((x + dx, y + dy) for x, y in vivas
                      for dx in (-1, 0, 1) for dy in (-1, 0, 1) if dx or dy)
    return {c for c, n in vecinos.items() if n == 3 or (n == 2 and c in vivas)}


def dibujo(vivas, ancho, alto):
    return ["".join("█" if (x, y) in vivas else "·" for x in range(ancho)) for y in range(alto)]


# 1. El planeador: cada cuatro generaciones recupera su forma, una casilla más abajo y a la derecha
planeador = {(1, 0), (2, 1), (0, 2), (1, 2), (2, 2)}
fases = [planeador]
for _ in range(4):
    fases.append(siguiente(fases[-1]))
for fila in zip(*(dibujo(f, 5, 5) for f in fases)):
    print("   ".join(fila))
print("Generación 4 = generación 0 desplazada (1, 1):", fases[4] == {(x + 1, y + 1) for x, y in planeador})
print()

# 2. El R-pentominó: cinco casillas que tardan más de mil generaciones en calmarse
vivas = {(1, 0), (2, 0), (0, 1), (1, 1), (1, 2)}
poblacion = [len(vivas)]
for _ in range(1500):
    vivas = siguiente(vivas)
    poblacion.append(len(vivas))
for g in range(0, 1201, 200):
    print(f"Generación {g:>5}: {poblacion[g]:>3} casillas vivas")
mayor = max(poblacion)
print("Máximo:", mayor, "casillas, en la generación", poblacion.index(mayor))
estable = len(poblacion) - 1
while poblacion[estable - 1] == poblacion[estable]:
    estable -= 1
print("Desde la generación", estable, "la población ya no cambia:", poblacion[estable], "casillas")
salida·█···   ·····   ·····   ·····   ·····
··█··   █·█··   ··█··   ·█···   ··█··
███··   ·██··   █·█··   ··██·   ···█·
·····   ·█···   ·██··   ·██··   ·███·
·····   ·····   ·····   ·····   ·····
Generación 4 = generación 0 desplazada (1, 1): True

Generación     0:   5 casillas vivas
Generación   200: 120 casillas vivas
Generación   400: 195 casillas vivas
Generación   600: 213 casillas vivas
Generación   800: 228 casillas vivas
Generación  1000: 156 casillas vivas
Generación  1200: 116 casillas vivas
Máximo: 319 casillas, en la generación 821
Desde la generación 1103 la población ya no cambia: 116 casillas

La función siguiente es todo el juego: una casilla está viva en la generación siguiente si tiene 3 vecinas, o si tiene 2 y ya estaba viva. El dibujo muestra las cinco primeras generaciones del planeador: en la quinta tiene la misma forma que en la primera, una casilla más abajo y a la derecha. Y el recuento del R-pentominó confirma las cifras clásicas: un máximo de 319 casillas en la generación 821 y, desde la 1,103, siempre las mismas 116. Como no hay azar, la salida es idéntica en cada ejecución.

Por qué fascina

Conway llegó a cansarse de que lo recordaran sobre todo por este juego, cuando había hecho aportaciones importantes en teoría de grupos y teoría de números. Pero el juego de la vida sigue enganchando a programadores más de cincuenta años después, y por buenos motivos. Es fácil de programar, cabe en unas pocas líneas y es un ejercicio clásico para aprender a manejar matrices o conjuntos. Y, como la hormiga de Langton, muestra la idea de emergencia: el planeador no está escrito en ninguna de las cuatro reglas, y aun así existe, se mueve y se puede usar para calcular. Conway murió en abril de 2020, pero los aficionados siguen descubriendo patrones nuevos cada año.

Fuentes: Martin Gardner, «The fantastic combinations of John Conway’s new solitaire game «life»», Scientific American (octubre de 1970); E. Berlekamp, J. Conway y R. Guy, Winning Ways for your Mathematical Plays (1982); la página de Wikipedia sobre el juego de la vida y LifeWiki. Las cifras del R-pentominó y del planeador las hemos comprobado con el programa, ejecutado con Python 3.13. La animación y las imágenes, incluida la portada, las genera el propio algoritmo: decodigo.com.
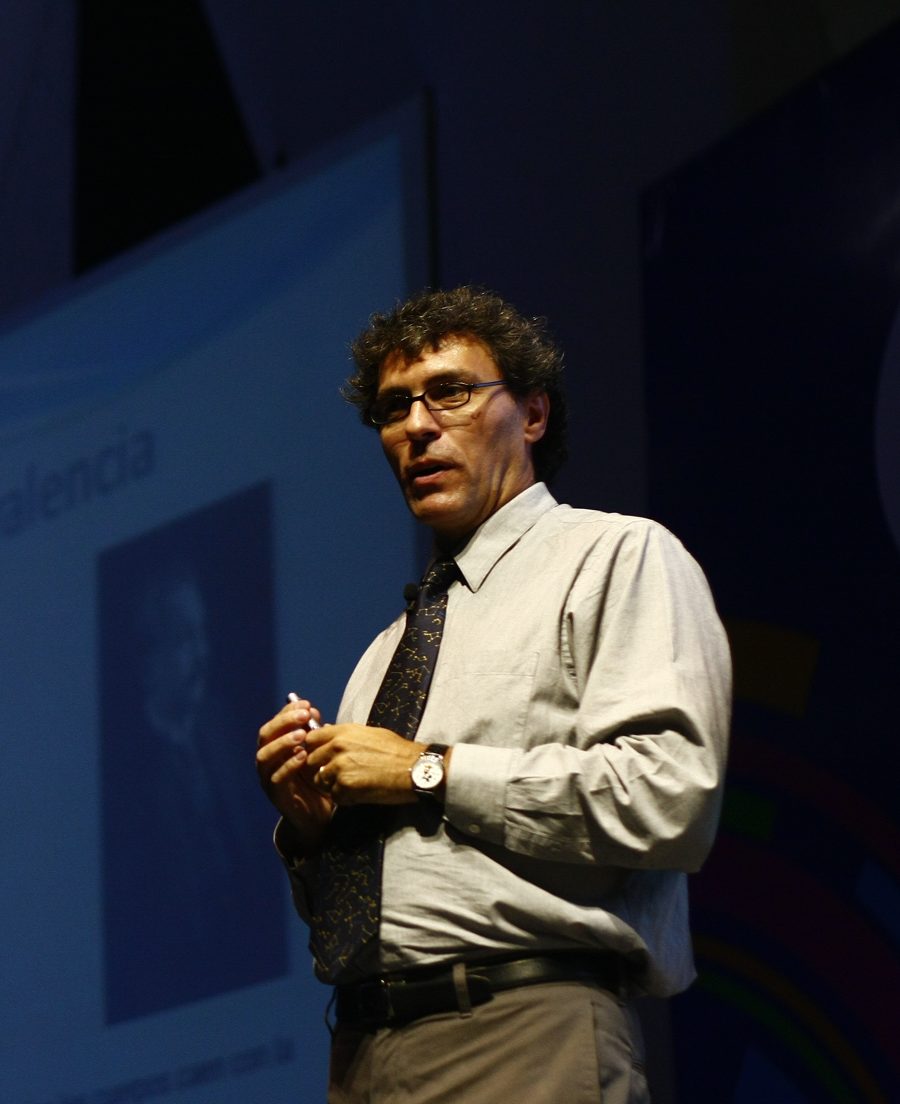
La hormiga de Langton: dos reglas, 10,000 pasos de caos y una autopista que nadie ha sabido explicar, con animación

La hormiga de Langton dibujada por el propio algoritmo: una mancha irregular de casillas oscuras de la que sale en diagonal una franja azul, la autopista, con la hormiga en rojo al final

Imagina una hormiga sobre un tablero infinito de casillas blancas. Solo sigue dos reglas: si está en una casilla blanca, gira a la derecha; si está en una negra, gira a la izquierda. En los dos casos cambia el color de la casilla y avanza una. Nada más: no hay azar ni memoria. Y sin embargo, durante unos 10,000 pasos deja un rastro que parece puro caos, hasta que de repente se pone a construir una «autopista» perfecta que se aleja para siempre. Es la hormiga de Langton, y todavía nadie ha sabido demostrar por qué lo hace.

Las reglas

La inventó en 1986 Chris Langton, un investigador estadounidense que estudiaba cómo surgen comportamientos complejos a partir de reglas sencillas y que poco después dio nombre a un campo entero, la vida artificial. La hormiga es un autómata celular, como el famoso juego de la vida de Conway: un tablero de casillas que cambian según unas reglas fijas. Estas son todas:

  1. El tablero empieza todo en blanco, y la hormiga, en una casilla cualquiera mirando hacia arriba.
  2. Si la casilla en la que está es blanca, la hormiga gira 90° a la derecha. Si es negra, gira 90° a la izquierda.
  3. Cambia el color de la casilla: la blanca pasa a negra y la negra, a blanca.
  4. Avanza una casilla en la dirección en la que mira, y vuelve al paso 2.
Casilla blancaGira 90° a la derecha,la pinta de negro y avanza.antesdespuésCasilla negraGira 90° a la izquierda,la pinta de blanco y avanza.antesdespués
Las dos reglas de la hormiga, que en el esquema mira hacia arriba. Esquema: decodigo.com.

Pruébalo

La animación simula la hormiga en un tablero de 160 por 160 casillas. La hormiga es el cuadrado rojo. Con la regla de Langton, el texto de debajo te dice en qué fase está, y cuando aparece la autopista te avisa del paso exacto en que empezó. Usa «Paso a paso» para ver las reglas en acción y «Rápida» para llegar antes al final. Puedes también tocar el tablero para pintar casillas mientras la hormiga camina, y ver cómo reacciona a los obstáculos. Los otros botones cambian la regla, como se explica más abajo.

Regla:
Velocidad:

0 pasos

Tres fases: orden, caos y orden

Si se empieza con el tablero en blanco, la hormiga siempre pasa por las mismas tres fases:

  • Simplicidad. Durante los primeros cientos de pasos dibuja formas pequeñas y ordenadas, a menudo simétricas.
  • Caos. Después, el dibujo se vuelve irregular. La hormiga va y viene sin ningún patrón a la vista, y deja una mancha de casillas negras que crece despacio. Esta fase dura casi diez mil pasos.
  • Orden. En el paso 9,976, la hormiga empieza a repetir un mismo recorrido de 104 pasos. Al final de cada uno ha avanzado dos casillas en diagonal y ha dejado doce casillas negras más, siempre con la misma forma. Ese ciclo, repetido sin fin, va trazando una franja diagonal: la autopista. Como el tablero es infinito, nada la detiene.

Lo inquietante es que no hay ninguna pista de lo que va a pasar. A los 9,000 pasos, el tablero parece tan desordenado como a los 2,000, y la única forma de saber que la hormiga acabará construyendo la autopista es dejarla caminar hasta el paso 9,976.

Lo que se sabe y lo que no

Con reglas tan sencillas, cabría esperar que los matemáticos lo tuvieran todo resuelto. No es así. Esto es lo que se sabe:

  • La hormiga nunca se queda encerrada. Empiece el tablero como empiece, aunque tenga casillas negras en cualquier posición, su recorrido no tiene límite: siempre acaba alejándose tanto como se quiera del punto de partida. Es el llamado teorema de Cohen-Kong, demostrado a principios de los noventa.
  • La autopista parece inevitable, pero nadie lo ha demostrado. Con todas las configuraciones iniciales finitas que se han probado, la hormiga acaba construyendo la misma autopista, antes o después. Es la conjetura de la autopista, y sigue sin demostrar. Si pintas casillas en la animación, lo más probable es que veas lo mismo: más caos, pero al final la autopista.
  • Puede calcular cualquier cosa. En 2002, Anahí Gajardo, Andrés Moreira y Eric Goles demostraron que, colocando bien las casillas negras al principio, la trayectoria de la hormiga puede calcular cualquier circuito lógico. Es decir, que este juego de dos reglas puede hacer, en teoría, cualquier cálculo que haga un ordenador.

Más colores, otras figuras

Greg Turk y Jim Propp extendieron la idea a más de dos colores. Las casillas pasan por los colores en orden, y la regla se escribe con una letra por color: R (derecha) o L (izquierda), según hacia dónde gira la hormiga al pisar ese color. La hormiga original es RL. Algunas de las variantes que puedes probar en la animación:

ReglaColoresQué hace
RL2La hormiga de Langton: caos y, al final, la autopista
LLRR4Crece de forma simétrica, cada vez más despacio
LRRRRRLLR9Rellena un cuadrado a su alrededor y lo va agrandando
RRLLLRLLLRRR12Tras unos 15,900 pasos, dibuja un triángulo relleno que crece y se desplaza

Hay incluso una regla para saber qué variantes crecen con simetría: basta con que en la palabra, leída en círculo, todas las letras vayan en parejas iguales seguidas, como en LLRR o RLLR. Otras, como RLR, crecen de forma caótica, y nadie sabe si alguna vez construirán una autopista.

La hormiga en Python

Este programa simula 11,000 pasos sobre un tablero infinito: solo guarda las casillas negras, en un conjunto. Después busca el paso desde el que la hormiga repite el ciclo de 104 pasos y dibuja el tablero en la terminal con caracteres de medio bloque, que meten dos casillas en cada carácter:

negras = set()                     # casillas negras; todas las demás son blancas
x, y, dx, dy = 0, 0, 0, -1         # posición y dirección: empieza mirando hacia arriba
posiciones = [(x, y)]

for paso in range(11000):
    if (x, y) in negras:           # casilla negra: gira a la izquierda y la vuelve blanca
        dx, dy = dy, -dx
        negras.remove((x, y))
    else:                          # casilla blanca: gira a la derecha y la vuelve negra
        dx, dy = -dy, dx
        negras.add((x, y))
    x, y = x + dx, y + dy
    posiciones.append((x, y))

# La autopista empieza en el primer paso desde el que cada 104 pasos la hormiga se mueve igual
def avance(i):
    return posiciones[i + 104][0] - posiciones[i][0], posiciones[i + 104][1] - posiciones[i][1]

inicio = len(posiciones) - 105
while avance(inicio - 1) == avance(inicio):
    inicio -= 1
print("Casillas negras:", len(negras))
print("La autopista empieza en el paso", inicio, "y avanza", avance(inicio), "cada 104 pasos")

# Dibujo: cada carácter son dos casillas, una encima de otra
xs = [c[0] for c in negras]
ys = [c[1] for c in negras]
for fila in range(min(ys), max(ys) + 1, 2):
    print("".join(" ▀▄█"[((col, fila) in negras) + 2 * ((col, fila + 1) in negras)]
                  for col in range(min(xs), max(xs) + 1)))
salidaCasillas negras: 834
La autopista empieza en el paso 9976 y avanza (-2, 2) cada 104 pasos
                            ▄▀▀▄▄██▀▀▀▀▀▀▀▀▀▀▄ ▀█▄                 
                           █▀█  ▄▀▀       ▄  ▄ ▀▀ █                
                    ▄▄▄▀█  █▀ ▀▄▀    ▄    ▀██ ▄▄  ▄▄█              
                     █ █▄▄▀██  █▀▄█▀▀█▄█▀▄ ▄▀ ▀  █▄█▀  ██▄         
                  ▄█▄ ▄▄ ▀ ▄ ████▀ █▄▀▄▄▀███▄▄█ ▄ ███ █ ▀ █        
                  ▀ ▀▀█ █ ▀▀▄▀▄█ ██▄▀▀ █▀ ▀▄ ▄▀▀███▄▀▀▀ █▀▄▄       
                  ▄█▄ ▀ ▄ ▄ ▄▄ ▄██ ▀█  ▄█  ▀▀ ▄   ██▄▀▄▄  ▄█▀▄     
                ▄█▄ ▀▀█  ▀█ ▄ ▀█ █▀▄▄▄█▀█▄ ▀▄ ▄▄▀▄▄█▀ █▀▀▀  ▄▀     
              ▄█▄ ▀▀█  ▀ ▀█ ▄▄ █ ▄█ ▀██  █▄▄▄▄ ▄███ ▀█▄█▄ █▄ ▀▀▄   
            ▄█▄ ▀▀█  █▄▀▄█▄ ▀▄█▀█ ▀ █▄▀▀     ▄██▄ ▄█▄█ ▀ ▄  ▀   █  
          ▄█▄ ▀▀█  █▄▀  ▀  ▄▀█▄▄█▀▀██▀▀████▄█▄▄█▀▀█  █▄   ▀▄  ▄█   
        ▄█▄ ▀▀█  █▄▀  ▄▀▀▄ █▄██▄▄ ██ █▀▄█▀█ █▀▀  ▄█▄ █▄█▀  ██▀▀ █  
      ▄█▄ ▀▀█  █▄▀   █     █▀██▀▄█▄██▀██  ▄ ▄▀ ▀▄ ▀█ ▀▄▄ ▄▀▀▄  █   
    ▄█▄ ▀▀█  █▄▀     █ ▄▄ ▀ ▄▄▀▀▀█ ▀▄ ▀▀███▄▀▀▄  ▀██▀████▀█▄  ▀▀   
  ▄█▄ ▀▀█  █▄▀        ▀██▀▀▄█ ▄▀█ ▄ ▀▀ █▄ ▄█ ▄ ▄▀▄█  █  █▄ ▀▄█     
▄█▄▄█▀█  █▄▀                 █  █   ▄▀ ▀▀▀▀▀██▀▄█ ▀ █▀ ▄▀▀██ █     
▀█▀  █ █▄▀                    ▀▄▄▀  █      ▀▄▄▀▀▄▄▀▀  ▄▀▀ █▀██▄    
▄▀  ██▄▀                            ▀▄█▀ ▄███▀   ▄█▀▀█ ██▀▄▀█▀▀▄   
▀▄█▀ ▀                                ▀▀    ▀▀    ▀▀ █▀█▄▀█ ▀████  
  ▀▀                                                     ██ ▀▀ ▀▀  
                                                      ▄▀ █▀▄▄█▀▀█▄█
                                                      ▀▄█▀ ▀  ▀▄▄▀ 
                                                        ▀▀         

El giro se hace sin ángulos: con y creciendo hacia abajo, como en una pantalla, girar a la derecha es convertir la dirección (dx, dy) en (-dy, dx), y girar a la izquierda, en (dy, -dx). En la salida se ve la mancha del caos arriba a la derecha y la autopista bajando en diagonal hacia la izquierda. Como no hay ningún azar, el resultado es idéntico cada vez que se ejecuta, en cualquier ordenador.

Por qué fascina

En el juego del caos, el azar acababa dibujando una figura perfecta. La hormiga de Langton es lo contrario: no tiene nada de azar, sus reglas caben en una línea y se puede simular con lápiz y papel, y aun así su comportamiento no se puede predecir sin ejecutarla paso a paso. Es uno de los ejemplos más claros de emergencia: un comportamiento complejo que no está escrito en ninguna de las reglas, sino que sale de cómo se combinan. Es la misma idea que ayuda a entender cómo las hormigas reales organizan un hormiguero sin que ninguna lo dirija. Y es también un recordatorio útil para cualquier programador: que un código sea corto no quiere decir que sea fácil saber lo que hará.

Fuentes: Christopher G. Langton, «Studying artificial life with cellular automata», Physica D (1986); A. Gajardo, A. Moreira y E. Goles, «Complexity of Langton’s ant», Discrete Applied Mathematics (2002); la página de Wikipedia sobre la hormiga de Langton. Las cifras de la autopista (paso 9,976, ciclo de 104 pasos, dos casillas en diagonal y doce casillas negras por ciclo) las hemos comprobado simulándola. El programa se ejecutó con Python 3.13. La animación y las imágenes, incluida la portada, las genera el propio algoritmo: decodigo.com.
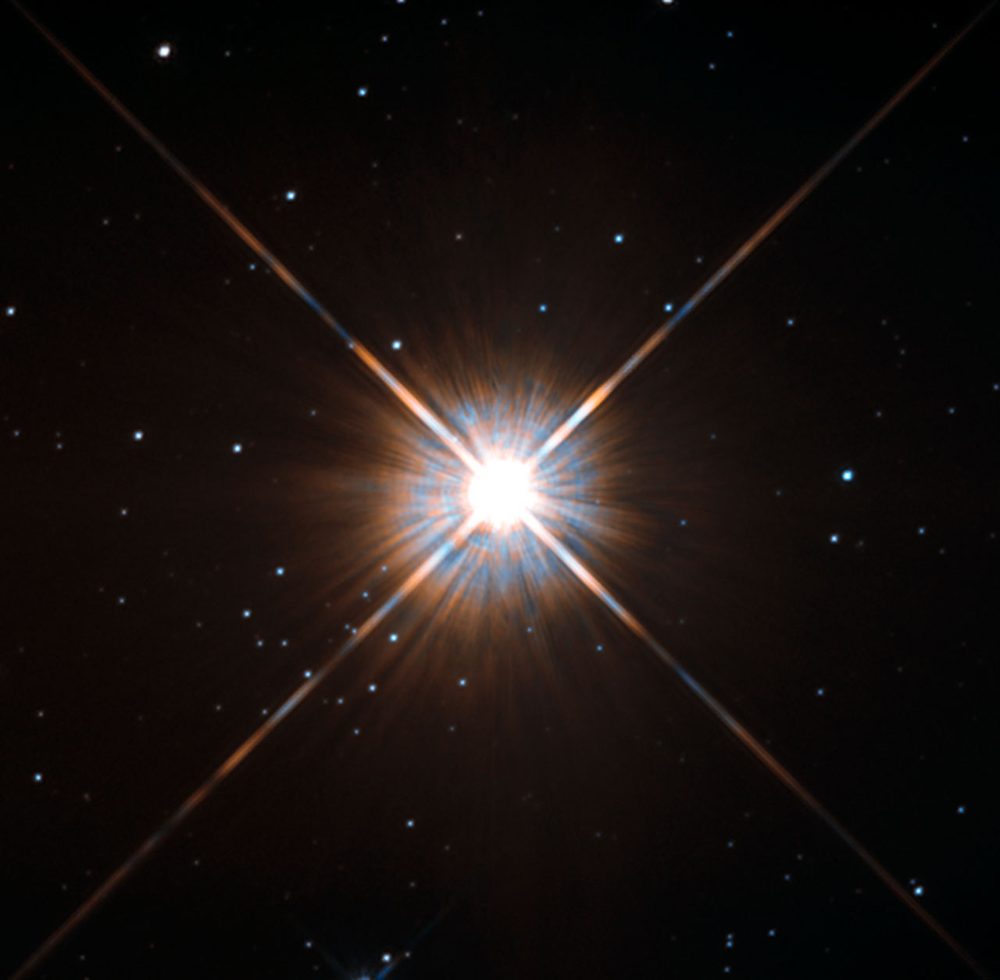
El juego del caos: cómo puntos al azar dibujan un fractal perfecto, con animación

Triángulo de Sierpinski de tres colores y helecho de Barnsley dibujados con el juego del caos, junto al título del artículo

Coge un triángulo, un punto cualquiera y un dado. Tira el dado, mira a qué vértice le toca y mueve el punto a mitad de camino hacia ese vértice. Apunta dónde ha caído y repite. Parece la receta perfecta para un borrón de puntos sin orden, pero después de unos miles de tiradas aparece una figura perfecta, siempre la misma: el triángulo de Sierpinski, un fractal hecho de triángulos dentro de triángulos. Es el juego del caos, y con unas reglas casi iguales dibuja también un helecho.

Cómo funciona

El triángulo de Sierpinski lo describió el matemático polaco Wacław Sierpiński en 1915: se parte de un triángulo, se le quita el triángulo del centro que une los puntos medios de sus lados, y se repite lo mismo con los tres triángulos que quedan, y con los nueve siguientes, sin fin. El resultado es un fractal: una figura que se parece a sí misma a cualquier escala, porque cada una de sus tres esquinas es una copia exacta del todo, a la mitad de tamaño.

El juego del caos llega a la misma figura por un camino muy distinto, sin quitar nada. Lo popularizó el matemático británico Michael Barnsley en su libro Fractals Everywhere (1988). Estas son todas las reglas:

  1. Se marcan los tres vértices del triángulo: A, B y C.
  2. Se elige un punto de partida cualquiera.
  3. Se elige uno de los tres vértices al azar, con la misma probabilidad para cada uno (un dado sirve: 1 y 2 son A, 3 y 4 son B, 5 y 6 son C).
  4. Se mueve el punto a mitad de camino entre donde está y el vértice elegido, y se dibuja.
  5. Se vuelve al paso 3.
ABCinicio121El dado sale C:el punto avanza la mitaddel camino hacia C.2El dado sale A:desde ahí, otra vez la mitad,ahora hacia A.…Y así miles de veces.No se dibujan las líneas,solo los puntos.
Dos pasos del juego. En la animación de abajo, los primeros treinta pasos van despacio y con el salto dibujado, como aquí. Esquema: decodigo.com.

Pruébalo

La animación juega al juego del caos en tu navegador. Elige la figura y mira cómo aparece: los primeros puntos van uno a uno y después cada vez más deprisa, hasta más de cien mil. En el triángulo, cada punto toma el color del vértice al que acaba de saltar, y eso deja ver algo importante: todos los puntos azules forman la copia de arriba, los verdes la de la izquierda y los ámbar la de la derecha.

0 puntos

Por qué sale un triángulo y no un borrón

La clave está en ese reparto de colores. Saltar a mitad de camino hacia el vértice A es lo mismo que encoger toda la figura a la mitad, pegada a A. Lo mismo pasa con B y con C. Y el triángulo de Sierpinski es precisamente la única figura que, encogida a la mitad hacia cada uno de sus tres vértices, se convierte en sus tres esquinas, es decir, en sí misma. Por eso, una vez que un punto cae dentro del fractal, ya no puede salir: cada salto lo lleva a otra parte del fractal.

¿Y si el punto de partida está fuera? Cada salto reduce a la mitad la distancia al fractal, así que después de diez saltos el error es mil veces más pequeño, y después de veinte, un millón de veces. Por eso los programas suelen descartar los primeros puntos: son los únicos que pueden caer fuera. El azar se encarga del resto: como los vértices se eligen sin ningún patrón, los puntos acaban visitando todos los rincones de la figura.

Los matemáticos llaman a esto un sistema de funciones iteradas (IFS, por sus siglas en inglés): unas pocas transformaciones que encogen el plano, aplicadas una y otra vez en orden aleatorio. La figura a la que se acercan los puntos es su atractor.

El cuadrado: cuando una regla lo cambia todo

Si se juega igual con los cuatro vértices de un cuadrado, no sale ningún dibujo: los puntos rellenan el cuadrado entero, de manera uniforme. Pero basta añadir una regla, no elegir dos veces seguidas el mismo vértice, para que aparezca el fractal de la animación, con sus cruces y sus huecos en forma de cuadrado. Al prohibir un salto, desaparece la copia del cuadrado que ese salto habría dibujado, y desaparece también, a escala, dentro de todas las demás copias.

El helecho de Barnsley

Barnsley fue más allá: si las transformaciones no solo encogen, sino que también giran e inclinan, el atractor puede parecerse a una planta. Su helecho usa cuatro, cada una con su probabilidad:

TransformaciónQué dibujaProbabilidad
x' = 0
y' = 0.16·y
El tallo1 %
x' = 0.85·x + 0.04·y
y' = −0.04·x + 0.85·y + 1.6
Cada hoja más pequeña, encima de la anterior85 %
x' = 0.20·x − 0.26·y
y' = 0.23·x + 0.22·y + 1.6
La primera hoja de la izquierda7 %
x' = −0.15·x + 0.28·y
y' = 0.26·x + 0.24·y + 0.44
La primera hoja de la derecha7 %

La segunda es la que da la forma: copia el helecho entero un poco más pequeño y un poco girado, encima de sí mismo, y por eso cada hoja tiene a su vez hojas, y estas otras. Son veinticuatro números, y con ellos se dibuja una planta que se distingue con dificultad de una real.

El programa más corto

Para jugar al juego del caos no hace falta ninguna biblioteca. Este programa de Python dibuja el triángulo con caracteres en la terminal, en una rejilla de 64 por 32:

import random

ANCHO, ALTO = 64, 32
vertices = [(32, 0), (0, 32), (64, 32)]       # arriba, abajo a la izquierda, abajo a la derecha
rejilla = [[" "] * ANCHO for _ in range(ALTO)]

x, y = random.uniform(0, 64), random.uniform(0, 32)
for paso in range(100_000):
    vx, vy = random.choice(vertices)          # un vértice al azar
    x, y = (x + vx) / 2, (y + vy) / 2          # a mitad de camino
    if paso >= 20:                             # los primeros puntos, fuera
        rejilla[min(int(y), ALTO - 1)][min(int(x), ANCHO - 1)] = "#"

for fila in rejilla:
    print("".join(fila).rstrip())
salida                               ##
                              ####
                             ##  ##
                            ########
                           ##      ##
                          ####    ####
                         ##  ##  ##  ##
                        ################
                       ##              ##
                      ####            ####
                     ##  ##          ##  ##
                    ########        ########
                   ##      ##      ##      ##
                  ####    ####    ####    ####
                 ##  ##  ##  ##  ##  ##  ##  ##
                ################################
               ##                              ##
              ####                            ####
             ##  ##                          ##  ##
            ########                        ########
           ##      ##                      ##      ##
          ####    ####                    ####    ####
         ##  ##  ##  ##                  ##  ##  ##  ##
        ################                ################
       ##              ##              ##              ##
      ####            ####            ####            ####
     ##  ##          ##  ##          ##  ##          ##  ##
    ########        ########        ########        ########
   ##      ##      ##      ##      ##      ##      ##      ##
  ####    ####    ####    ####    ####    ####    ####    ####
 ##  ##  ##  ##  ##  ##  ##  ##  ##  ##  ##  ##  ##  ##  ##  ##
################################################################

Aunque cada ejecución elige vértices distintos, con cien mil puntos la salida es siempre exactamente la misma: lo comprobamos ejecutándolo varias veces. El tamaño de la rejilla tampoco es casual: con 32 filas, una potencia de dos, cada mitad de camino cae justo en el borde de una casilla, y la figura sale sin dientes.

Más allá de un truco bonito

El juego del caos se enseña porque muestra en pocas líneas una idea profunda: reglas simples y azar pueden producir un orden complejo y perfectamente predecible. No importa qué vértices salgan en cada tirada: el resultado final no depende del azar, solo de las reglas. La misma idea sirvió en los años noventa para comprimir imágenes describiéndolas como sistemas de funciones iteradas, y la naturaleza parece usar algo parecido: los helechos, las ramas de los árboles o el romanesco repiten su forma a distintas escalas. Y si quieres jugar con las reglas, prueba a cambiar en el programa la fracción del salto o el número de vértices: con un hexágono y saltos de dos tercios, por ejemplo, sale otra familia de fractales.

Fuentes: Michael F. Barnsley, Fractals Everywhere (Academic Press, 1988); las páginas de Wikipedia sobre el juego del caos, el helecho de Barnsley y el triángulo de Sierpinski. El programa se ejecutó con Python 3.13. La animación y las imágenes, incluida la portada, las genera el propio algoritmo: decodigo.com.
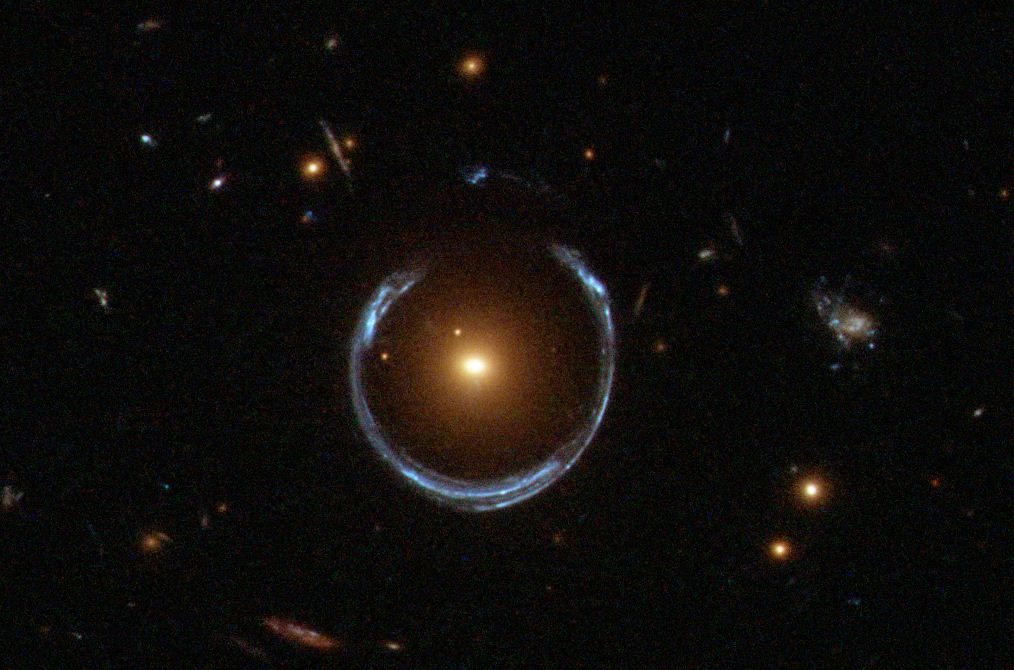
Qué lenguaje elegir cuando la IA escribe el código

Código de colores en un monitor, con el título del artículo sobre qué lenguaje elegir cuando la IA escribe el código

Durante décadas, elegir un lenguaje de programación era, en buena parte, elegir cuánto ibas a teclear. Python ganaba porque se escribía rápido; Rust o C++ asustaban porque había que pelearse con el compilador. Con asistentes y agentes de IA que generan cientos de líneas en segundos, escribir código ha dejado de ser el cuello de botella, y los criterios para elegir lenguaje cambian. Esta guía repasa cuáles pesan ahora y qué lenguaje conviene en cada caso.

Lo que no se ha abaratado es todo lo demás: entender el problema, comprobar que el código hace lo que debe, mantenerlo años y pagar las máquinas donde se ejecuta. Ya lo contamos en qué cambia en el oficio cuando escribir código deja de ser el centro. Visto desde ahí, la pregunta ya no es en qué lenguaje se escribe más rápido, sino en cuál es más fácil saber que el código generado está bien y en cuál sale más barato tenerlo funcionando.

Los criterios que cambian

1. Que el lenguaje detecte los errores antes de ejecutar. Un modelo de lenguaje no comprende el programa como un compilador: predice texto. Por eso se equivoca en lo que el compilador comprueba mejor. En un estudio presentado en PLDI 2025, investigadores de la ETH de Zúrich y de Berkeley midieron que, de media, el 94 % de los errores de compilación del código generado por modelos de IA eran fallos de tipos: pasar un dato del tipo equivocado, llamar a un método que no existe, olvidar un caso. Cassidy Williams, de GitHub, usó ese dato para explicar por qué la IA está empujando a los desarrolladores hacia los lenguajes con tipos. En un lenguaje con tipos estrictos, esos errores aparecen en segundos y el agente los corrige solo; en uno sin tipos, llegan a las pruebas, a la revisión o directamente a producción.

Dónde aparece un error del código generadoLa IA escribeel cambioCompiladortipos: segundosPruebasminutosRevisiónhumana: horasProducciónel peor sitioel agente corrige y repiteTipado estrictoRust, Go, Java, C#, TypeScript en modo strictmuchos errores se paran en el compiladorTipado opcionalPython con anotaciones y mypy o Pyrightsolo si se activa el comprobadorSin tiposJavaScript o Python sin anotacionesel error llega a las pruebas o a producción
Cuanto antes aparece un error del código generado, más barato es arreglarlo. Con tipos estrictos, el agente puede compilar, leer el error y corregirlo sin intervención humana. Esquema: decodigo.com.

2. Que la máquina trabaje menos. Antes se aceptaba un lenguaje lento a cambio de programar más rápido. Si la IA escribe tanto el código sencillo como el farragoso, esa compensación pierde fuerza: el coste de escribir un servicio en Go o en Rust en lugar de en Python baja mucho, y el ahorro en servidores, memoria y energía sigue ahí cada mes. El estudio más citado sobre energía, de Rui Pereira y otros investigadores portugueses, resolvió los mismos problemas en 27 lenguajes. C, Rust y C++ consumieron lo mínimo, Java y Go, entre dos y tres veces más, y Python, unas 76 veces más.

Energía para resolver los mismos problemas (C = 1)Escala logarítmica: cada línea vertical es diez veces más energía×1×10×100C1,00Rust1,03C++1,34Java1,98C#3,14Go3,23JavaScript4,45TypeScript21,50PHP29,30Ruby69,91Python75,88
Energía media de cada lenguaje en las pruebas de Pereira y otros (Science of Computer Programming, 2021), tomando C como 1. El mal resultado de TypeScript frente a JavaScript, que acaba ejecutándose en el mismo motor, solo se explica porque los programas de prueba de uno y otro eran distintos: un estudio de 2024 de Emery Berger y su equipo muestra que, si se comparan bien, la energía depende sobre todo del tiempo de ejecución y de cómo está escrito cada programa. Esquema: decodigo.com.

Hay que leer esa gráfica con cuidado. Un estudio posterior del equipo de Emery Berger, de la Universidad de Massachusetts, revisó la metodología y concluyó que el lenguaje no gasta energía por sí mismo: gasta la que corresponde al tiempo que tarda el programa. Pero eso no cambia la conclusión práctica: un programa que tarda menos consume menos, y los lenguajes compilados a código nativo, o con un buen compilador JIT como Java y C#, siguen siendo mucho más rápidos que los interpretados para el mismo trabajo.

3. Que el ecosistema ya tenga resuelto el problema. Una biblioteca madura, probada por millones de usuarios, vale más que mil líneas generadas desde cero, por bien que estén. Y un ecosistema grande también significa que los modelos lo conocen mejor: han visto muchísimo código en Python, TypeScript, Java o Go, y mucho menos en lenguajes minoritarios o en bibliotecas que cambian de una versión a otra. Eso sí, cada dependencia es una puerta: el intento de ataque a Zod de septiembre, que contamos hoy, recuerda que un ecosistema enorme es también un objetivo enorme.

4. Que el código se pueda revisar. Si una persona va a leer código que no ha escrito, ayuda que el lenguaje tenga pocas formas de hacer lo mismo, un formato único y un estilo predecible. Go está diseñado justo para eso. En el otro extremo, los lenguajes que permiten cualquier truco y crear lenguajes propios dentro del lenguaje producen código generado más difícil de auditar.

Qué lenguaje para cada caso

Para construir…Primera opciónAlternativasPor qué
Aplicaciones web completasTypeScript (modo strict)Go o C# en el servidorUn solo lenguaje en el navegador y en el servidor, el ecosistema más grande y tipos que frenan los errores del modelo.
Datos, aprendizaje automático y prototipos con IAPython con anotaciones de tiposJulia para cálculo numéricoLas bibliotecas que importan están en Python: PyTorch, pandas y los SDK de los modelos. Lo pesado se ejecuta en C, C++ o Rust por debajo.
APIs, microservicios y herramientas de línea de órdenesGoRust, Java, C#Compila en segundos, genera un único binario, consume poca memoria y su código es muy uniforme: fácil de generar y de revisar.
Sistemas, rendimiento extremo y seguridad de memoriaRustC++ en bases de código existentes, ZigEl compilador es el revisor más exigente: si compila, se descartan clases enteras de errores de memoria y de concurrencia. Ideal para agentes que iteran contra él.
Sistemas de empresa grandes y de larga vidaJava o KotlinC# y .NETTipos, herramientas de análisis y refactorización muy maduras, y décadas de bibliotecas. Las versiones modernas son mucho menos verbosas, y lo verboso ya lo escribe la IA.
Aplicaciones móvilesKotlin (Android) y Swift (iOS)Dart con Flutter, o React Native con TypeScriptLos lenguajes nativos acceden antes a lo nuevo de cada plataforma; las opciones multiplataforma reducen el trabajo a una sola base de código.
Electrónica y sistemas embebidosCRust embebido, MicroPython para prototiposC sigue estando en todos los fabricantes y herramientas; Rust gana terreno donde la seguridad importa.
Scripts y automatizaciónPythonBash para lo muy corto, Go si debe ser rápidoEstá instalado casi en cualquier sistema y tiene biblioteca para todo.
Nota: los frameworks maduros de cada lenguaje. Con IA, apoyarse en un framework consolidado vale todavía más que antes. Resuelve de serie la seguridad, el acceso a datos y la configuración, impone una estructura que el modelo conoce de sobra porque la ha visto en miles de proyectos y reduce la cantidad de código propio que hay que revisar. Además, recibe parches de seguridad sin que tengas que escribirlos tú. Estos son los más asentados en cada lenguaje.
LenguajeWeb y serviciosDatos, pruebas y otras piezas
TypeScriptReact y Next.js, Angular, Vue y Nuxt en la interfaz; NestJS, Express y Fastify en el servidorPrisma y Drizzle para bases de datos, Zod para validar datos, Vitest y Playwright para pruebas
PythonDjango, FastAPI y FlaskNumPy, pandas, scikit-learn y PyTorch para datos e IA; SQLAlchemy, Pydantic y pytest
GoLa biblioteca estándar net/http basta en muchos casos; Gin, Echo y Chi por encima; gRPC para servicios internosCobra para herramientas de línea de órdenes; database/sql con sqlc o GORM
RustAxum y Actix Web, sobre el motor asíncrono TokioSerde para serializar, SQLx y Diesel para bases de datos, Clap para línea de órdenes
Java y KotlinSpring Boot, Quarkus y Micronaut; Ktor en KotlinHibernate y JPA para persistencia, JUnit para pruebas
C#ASP.NET Core, con Blazor para la interfaz webEntity Framework Core para datos, xUnit para pruebas
MóvilJetpack Compose (Kotlin) y SwiftUI (Swift)Flutter (Dart) y React Native (TypeScript) para varias plataformas a la vez
EmbebidosFreeRTOS y Zephyr como sistemas operativos de tiempo real; ESP-IDF para los chips ESP32Embassy para programar microcontroladores en Rust
Python no pierde, cambia de papel. Según el informe Octoverse 2025 de GitHub, Python está en casi la mitad de los repositorios nuevos de IA, y más de 1,1 millones de repositorios públicos ya importan el SDK de algún modelo de lenguaje. Lo que cambia es dónde se usa: como lenguaje para explorar, entrenar y unir piezas, y no tanto para el servicio que atiende miles de peticiones por segundo. Si se escribe Python con IA, conviene añadir anotaciones de tipos y pasar un comprobador como mypy o Pyright, para recuperar parte de la red de seguridad.

Lo que ya se nota en GitHub

En agosto de 2025, TypeScript se convirtió en el lenguaje más usado en GitHub por número de contribuidores: más de 2,6 millones al mes, un 66 % más que un año antes, por delante de Python y de JavaScript. GitHub lo calificó como el mayor cambio de lenguaje en más de una década, y lo atribuyó en parte a la IA: los tipos funcionan como un contrato que entienden por igual las personas, los frameworks y los modelos, y que permite detectar los errores del modelo antes de que lleguen a producción. Ayuda también que frameworks como Next.js, Astro o SvelteKit creen ya los proyectos en TypeScript por defecto.

Es la misma tendencia que se ve con Rust en los componentes críticos de sistemas operativos y navegadores, o con la llegada de tipos a lenguajes que nacieron sin ellos, como Python o PHP. Cuando una parte creciente del código la escribe una máquina, el compilador deja de verse como un obstáculo y pasa a ser la primera línea de revisión, y la más barata.

Cómo elegir, en cinco preguntas

  1. ¿Qué tiene ya resuelto el ecosistema? Si el problema depende de una biblioteca concreta, como PyTorch, un SDK de pagos o un framework de interfaz, esa biblioteca decide el lenguaje casi siempre.
  2. ¿Cuántas veces se va a ejecutar? Un script que se ejecuta una vez al mes puede estar en cualquier lenguaje. Un servicio que atiende millones de peticiones merece un lenguaje compilado: lo que antes costaba escribirlo ahora lo escribe la IA.
  3. ¿Quién va a revisar el código? Si hay poca revisión humana, se necesita más ayuda del compilador: tipos estrictos y advertencias activadas como errores.
  4. ¿Cuánto tiempo va a vivir? Para un sistema que se mantendrá diez años, conviene un lenguaje estable, con herramientas de refactorización y gente que lo conozca. Un lenguaje de moda o que cambia mucho entre versiones es un riesgo, y además los modelos lo conocen peor.
  5. ¿Sabe alguien del equipo leerlo? La IA no elimina la necesidad de entender lo que se despliega. Elegir un lenguaje que nadie del equipo domina porque «lo escribe la IA» es dejar el sistema sin nadie que pueda responder por él.

Conclusión

La IA no ha hecho que dé igual el lenguaje: ha cambiado lo que importa al elegirlo. Pesa menos lo cómodo que es escribirlo y más cuánto ayuda a verificar lo que otro, humano o máquina, ha escrito, cuánto cuesta ejecutarlo y cuánto trabajo ahorra su ecosistema. Por eso ganan terreno los lenguajes con tipos estrictos y buenas herramientas, como TypeScript, Go, Rust, Java, Kotlin o C#, y Python se consolida donde su ecosistema no tiene rival. Si quieres empezar por alguno, en decodigo.com tienes cursos de Python, Go, Rust y Java, y diez consejos para aprender a programar cuando la IA ya escribe el código.

Datos: GitHub Octoverse 2025; Cassidy Williams, «Why AI is pushing developers toward typed languages» (GitHub Blog, 2026); Mündler y otros, «Type-Constrained Code Generation with Language Models» (PLDI 2025); Pereira y otros, «Ranking programming languages by energy efficiency» (2021); van Kempen y otros, «It’s Not Easy Being Green» (2024). Portada: código en un monitor, foto de Markus Spiske, Wikimedia Commons, CC0 (recortada y teñida).

Cómo funcionaba el software que alunizó: el sistema operativo del Apolo, explicado con su código fuente

El rostro de Margaret Hamilton, desenfocado, al fondo de la portada, junto al título «Cómo funcionaba el software que alunizó» y una DSKY dibujada con el código 1202

Del software del Apolo se repiten siempre las mismas dos frases: que cabía en menos memoria que una foto del móvil y que una alarma estuvo a punto de abortar el alunizaje. Las dos son ciertas y ninguna explica nada. Lo interesante es cómo estaba hecho por dentro, y lo bueno es que se puede mirar: el código fuente de la misión está publicado, línea a línea, con los comentarios que escribieron sus autores en 1969.

La máquina con la que había que apañarse

El ordenador de guiado del Apolo —el AGC— no era pequeño para la época: era pequeño a secas.

El AGCPara comparar
Memoria de trabajo2.048 palabras de núcleos de ferritaunos 4 KB
Programa36.864 palabras de memoria fijaunos 72 KB, y no se podía cambiar
Palabra15 bits más uno de paridadhoy, 64
Reloj2,048 MHzunas mil veces menos que un móvil
Peso y consumo32 kg y 55 Wuna bombilla

Y el programa no estaba grabado: estaba tejido. Cada uno y cada cero era un cable que pasaba por dentro o por fuera de un anillo de ferrita, a mano, y la memoria entera llevaba semanas de telar. Una vez tejida no se podía corregir ni una coma. Eso cambia por completo lo que significa «equivocarse».

Y el programa no podía pararse nunca. A la vez, y sin descanso, tenía que hacer todo esto: leer los acelerómetros, ir sumando esas lecturas para saber dónde estaba la nave, mover los motores que orientan la plataforma de navegación, atender al radar, llevar la cuenta del tiempo, refrescar los números de la pantalla y, por si fuera poco, hacer caso a un astronauta que teclea. Todo eso, con un solo procesador. No había un segundo núcleo al que mandarle la mitad.

La respuesta a ese problema es lo que hoy llamaríamos un sistema operativo de tiempo real, y es la aportación de fondo del equipo que dirigía Margaret Hamilton. Tiene cuatro ideas, y las cuatro se siguen usando.

Idea 1: una cola con prioridades, no una lista de tareas

Lo intuitivo, y lo que hacía casi todo el mundo entonces, es un ciclo mayor: haz A, luego B, luego C, vuelve a empezar. Funciona mientras todo dure lo previsto. El problema es que nada dura lo previsto, y cuando A se alarga, C llega tarde aunque C sea lo único que de verdad importa.

El Executive del AGC no hace eso. Cada unidad de trabajo —un job— se registra con un número de prioridad, y el sistema ejecuta siempre el de prioridad más alta que esté listo. Si mientras corre uno aparece otro más urgente, el primero se suspende a medias y se retoma después.

EXECUTIVE.agc, Luminary 1A (Apolo 11)# TO ENTER A JOB REQUEST REQUIRING NO VAC AREA:

NOVAC		INHINT
		AD	FAKEPRET	# LOC(MPAC +6) - LOC(QPRET)
		TS	NEWPRIO		# PRIORITY OF NEW JOB + NOVAC C(FIXLOC)

Y esta es la decisión de «¿me cambio de trabajo o sigo con este?», tal cual está escrita:

EXECUTIVE.agc		INDEX	NEWJOB		# THIS INDEX INSTRUCTION INSURES THAT THE
		CS	PRIORITY	# HIGHEST ACTIVE PRIORITY WILL BE COMPARED
		AD	NEWPRIO		# WITH THE NEW PRIORITY TO SEE IF NEWJOB
		EXTEND			# SHOULD BE SET TO SIGNAL A SWITCH.
		BZMF	ENDFIND

Si no has visto nunca ensamblador del AGC, no te pelees con las siglas: lo que hacen esas cinco líneas es una resta. Coge la prioridad del trabajo que está corriendo, le resta la del recién llegado y mira el signo. Si sale negativo, el nuevo manda y hay cambio; si no, el de ahora sigue. Eso es todo el «planificador»: una resta y un salto según el signo.

Las mayúsculas de los comentarios no las hemos puesto nosotros: el AGC se programaba con un juego de caracteres que no tenía minúsculas. Todos los listados de esta página están copiados tal cual del fuente de la misión, erratas incluidas: unas líneas más abajo, en ese mismo archivo, pone REQUIREING.

Ocho bandejas y cinco cuadernos

Si vas a interrumpir un trabajo a medias y retomarlo luego, tienes que apuntar en algún sitio por dónde iba: sus cuentas a medio hacer, en qué línea estaba, con qué trozo de memoria trabajaba. Piensa en una mesa con varias bandejas: cada trabajo que se aparta deja su papeleo en una bandeja y la mesa queda libre para el siguiente. Esa bandeja es lo que ellos llamaban core set.

Y aquí está el problema: cada bandeja ocupa memoria, y había 2.048 palabras en total para todo. Así que las bandejas se contaron y se repartieron de antemano, una por una:

ERASABLE_ASSIGNMENTS.agc# DYNAMICALLY ALLOCATED CORE SETS FOR JOBS	(84D)

MPAC		ERASE	+6		# MULTI-PURPOSE ACCUMULATOR.
MODE		ERASE			# +1 FOR TP, +0 FOR DP, OR -1 FOR VECTOR.
LOC		ERASE			# LOCATION ASSOCIATED WITH JOB.
BANKSET		ERASE			# USUALLY CONTAINS BBANK SETTING.
PUSHLOC		ERASE			# WORD OF PACKED INTERPRETIVE PARAMETERS.
PRIORITY	ERASE			# PRIORITY OF PRESENT JOB AND WORK AREA.

		ERASE	+83D		# EIGHT SETS OF 12 REGISTERS EACH

Ocho. Ocho bandejas. Ocho trabajos como mucho a la vez en toda la nave, y ni uno más.

Hay un segundo cupo. Los trabajos que hacen cuentas con vectores necesitan además un cuaderno de borrador bastante más grande, 43 palabras, para ir dejando los resultados intermedios. A ese cuaderno lo llamaban área VAC, y de esos había cinco. De ahí que en el fuente haya dos puertas de entrada distintas: NOVAC para el trabajo que no necesita cuaderno y FINDVAC para el que sí.

ERASABLE_ASSIGNMENTS.agc# VAC AREAS. -- BE CAREFUL OF PLACEMENT --	(220D)

VAC1USE		ERASE
VAC1		ERASE	+42D
VAC2USE		ERASE
VAC2		ERASE	+42D

¿Y si alguien pide bandeja o cuaderno y no queda ninguno libre? Pues pasa lo que todo el mundo ha oído contar mil veces sin saber qué era. Las dos alarmas famosas del alunizaje son literalmente eso: «no me quedan cuadernos» y «no me quedan bandejas». Están escritas ahí, en el mismo archivo, una debajo de la otra:

EXECUTIVE.agc — la alarma 1201		CCS	VAC5USE
		TCF	VACFOUND
		LXCH	EXECTEM1
		CA	Q
		TC	BAILOUT1
		OCT	1201		# NO VAC AREAS.
EXECUTIVE.agc — la alarma 1202NEXTCORE	CAF	COREINC
		ADS	LOCCTR
		CCS	EXECTEM2
		TCF	NOVAC3
		LXCH	EXECTEM1
		CA	Q
		TC	BAILOUT1	# NO CORE SETS AVAILABLE.
		OCT	1202
Esto conviene leerlo despacio. El 1202 no es un fallo del programa ni un error de nadie: es el mensaje que el sistema emite a propósito cuando pide una bandeja y no queda ninguna. Es una condición prevista, con su código, su rutina y su documentación. La diferencia entre un sistema que se cuelga y uno que avisa está, casi siempre, en si alguien se molestó en escribir estas seis líneas.

Idea 2: las tareas con reloj

El Executive responde a «esto es importante». Falta quien responda a «esto es a tal hora», que no es lo mismo: leer el acelerómetro dentro de 10 milisegundos, apagar el motor dentro de 4 segundos. De eso se encarga el segundo planificador, el Waitlist, y lo que gestiona no se llama trabajo sino tarea: un encargo corto que entra, hace lo suyo y sale sin que nadie lo interrumpa.

WAITLIST.agc# FUNCTIONAL DESCRIPTION --
#	PART OF A SECTION OF PROGRAMS -- WAITLIST, TASKOVER, T3RUPT, USED TO CALL A PROGRAM (CALLED A TASK),
#	WHICH IS TO BEGIN IN C(A) CENTISECONDS.
#
# WARNINGS --
#	1)	1 <= C(A) <= 16250D (1 CENTISECOND TO 162.5 SEC)
#	2)	9 TASKS MAXIMUM
#	3)	TASKS CALLED UNDER INTERRUPT INHIBITED
#	4)	TASKS END BY TC TASKOVER

Nueve tareas, hasta 162,5 segundos de plazo, resolución de una centésima de segundo. La división es la misma que hoy: tareas cortas y puntuales que no pueden interrumpirse, y trabajos largos que sí. Una tarea que necesita hacer algo lento no lo hace: encola un trabajo y se va.

Idea 3: reiniciar sin perder nada

Aquí está, seguramente, lo más elegante del diseño. Un ordenador de 1969 hecho de núcleos de ferrita y transistores sueltos, metido en una nave llena de vibraciones y radiación, se iba a reiniciar tarde o temprano. Hacer como si eso no fuera a pasar no era una opción; impedirlo, tampoco. Así que lo convirtieron en algo normal.

El truco son los puntos de control: la misma idea que guardar la partida en un videojuego. A lo largo de cada operación delicada, el programa va dejando constancia de por dónde va con una llamada a PHASCHNG:

PHASE_TABLE_MAINTENANCE.agc# PHASCHNG IS THE MAIN WAY OF MAKING PHASE CHANGES FOR RESTARTS.  THERE ARE THREE FORMS OF PHASCHNG, KNOWN AS TYPE
# A, TYPE B, AND TYPE C.  THEY ARE ALL CALLED AS FOLLOWS, WHERE OCT XXXXX CONTAINS THE PHASE INFORMATION,
#		TC	PHASCHNG
#		OCT	XXXXX

Y el código se escribe de manera que volver al último punto anunciado sea inofensivo. Don Eyles, que programó el descenso, lo resume en tres líneas:

el patrónNEW_X = X + 1
    registrar el punto de control
X = NEW_X

Parece una tontería y no lo es. Primero se calcula el valor nuevo aparte, sin tocar el bueno; luego se marca el punto de control; y solo entonces se guarda. Mira los dos casos posibles: si el ordenador se reinicia antes de la marca, al volver repite el cálculo y listo, porque no había llegado a cambiar nada. Si se reinicia después, el valor ya está guardado y tampoco hay que hacer nada. No existe ningún instante intermedio en el que el corte te deje las cosas a medio hacer.

Si esto te suena, es porque lo usas sin pensarlo: es exactamente lo que hay detrás de una transacción de base de datos, de un commit y de que una API se pueda reintentar sin duplicar nada. Lo escribieron veinte años antes de que a nadie le hiciera falta ponerle esos nombres.

Al arrancar de nuevo, la rutina RESTARTS recorre la tabla de fases y vuelve a poner en marcha cada cosa que estaba pendiente, desde su último punto de control. El programa en curso sigue, la pantalla se repinta y el astronauta ve, como mucho, un parpadeo.

Hay un registro en la memoria que se llama REDOCTR y cuyo comentario en el fuente dice CONTAINS NUMBER OF RESTARTS: un contador de reinicios. No era una excepción, era una estadística.

Idea 4: una máquina virtual, para que el código cupiera

El guiado es matemática de vectores: productos escalares, productos vectoriales, matrices de rotación, raíces, todo en doble precisión. Escribir eso en el ensamblador del AGC —que trabaja con palabras de 15 bits y tiene una aritmética mínima— ocupa una barbaridad de memoria.

Así que hicieron algo que suena a herejía y es de puro sentido común: se inventaron un segundo idioma. Un idioma en el que «multiplica estos dos vectores» se dice con una sola palabra, en vez de con las decenas de instrucciones que hacen falta en el idioma de la máquina. Y escribieron un programa, el intérprete, que lee ese idioma y lo va traduciendo sobre la marcha.

Es, literalmente, una máquina virtual metida dentro del AGC, con su propio juego de instrucciones. Lo mismo que hace Java con su bytecode, pero en 1969 y por un motivo muy concreto: que el programa cupiera.

INTERPRETER.agc — la tabla de saltoINDJUMP		TCF	VLOAD		# 00 -- LOAD MPAC WITH A VECTOR.
		TCF	TAD		# 01 -- TRIPLE PRECISION ADD TO MPAC.
		TCF	SIGN		# 02 -- COMPLEMENT MPAC (V OR SC) IF X NEG.
		TCF	VXSC		# 03 -- VECTOR TIMES SCALAR.
		...
		TCF	VAD		# 24 -- VECTOR ADD.
		TCF	VSU		# 25 -- VECTOR SUBTRACT.
		TCF	BVSU		# 26 -- VECTOR SUBTRACT FROM.
		TCF	DOT		# 27 -- VECTOR DOT PRODUCT.
		TCF	VXV		# 30 -- VECTOR CROSS PRODUCT.
		TCF	VPROJ		# 31 -- VECTOR PROJECTION.

Las tablas de salto del intérprete suman más de setenta operaciones: cargar un vector, multiplicarlo por un escalar, producto escalar, producto vectorial, matriz por vector, raíz cuadrada, seno, arcoseno, vector unitario. Un programa interpretado es entre cinco y diez veces más lento que el equivalente escrito a mano, y a cambio ocupa una fracción del espacio. Cuando tienes 36.864 palabras y una misión entera que meter dentro, ese cambio no se discute: se firma.

Las dos capas conviven en el mismo archivo y se distinguen a simple vista. Esto es un trozo del programa del alunizaje: las primeras líneas son instrucciones interpretadas, y EXIT es la que devuelve el control al ensamblador de la máquina.

THE_LUNAR_LANDING.agcP63SPOT2	VLOAD	UNIT		# INITIALIZE KALCMANU FOR BURN ATTITUDE
			R60VSAVE
		STOVL	POINTVSM
			UNITX
		STORE	SCAXIS
		EXIT

		CAF	EBANK7
		TS	EBANK

20 de julio de 1969: todo esto, a la vez

Con las cuatro piezas sobre la mesa, lo que pasó en el descenso se explica solo.

Empieza con un interruptor. El radar de encuentro —el que sirve para volver a acoplarse con el módulo de mando al final, no para alunizar— se había quedado en una posición que lo dejaba despierto. No estorbaba a nadie, en principio.

El detalle está en cómo le cuenta ese radar al ordenador hacia dónde apunta. Los dos aparatos se sincronizan con una señal eléctrica de 800 Hz, y el documento que describía esa conexión exigía que las dos señales tuvieran la misma frecuencia… pero no decía nada de que tuvieran que ir a compás. Era una línea que faltaba en el documento, y nadie la echó de menos hasta ese día.

Aquel día no iban a compás: estaban desfasadas casi un cuarto de onda. Y con ese desfase, la electrónica del radar se volvía loca midiendo: creía ver que la antena se movía todo el rato, y le mandaba al ordenador 6.400 avisos por segundo por cada uno de los dos ángulos, cuando la antena en realidad estaba quieta.

Aquí está la parte que hay que entender. Atender cada aviso no era «ejecutar un programa»: el hardware del AGC paraba el procesador un instante, le quitaba un ciclo para actualizar el contador, y lo devolvía. Nada en el software se enteraba. Simplemente, el ordenador iba más lento sin que nadie supiera por qué. Eyles lo mide:

«Moviéndose a su velocidad máxima, los contadores del radar de encuentro consumían aproximadamente el 15 % del tiempo de cálculo disponible. En su momento, siendo conservadores, supusimos que la pérdida de tiempo (que llamábamos TLOSS) era de un 13 %.»Don Eyles, Tales from the Lunar Module Guidance Computer (2004). Grumman midió después un máximo del 13,36 %.

Un 13 % no suena a catástrofe. Y no lo habría sido si el ordenador hubiera ido holgado, pero iba al límite. Aquí es donde se juntan las cuatro ideas.

El trabajo gordo del descenso se llama SERVICER: es el que lee los sensores, calcula dónde está la nave y decide qué hacer con el motor. Se lanza cada dos segundos y tiene que haber terminado antes de que le toque otra vez. Con el radar robando ciclos, dejó de llegar a tiempo.

Y el reloj no espera a nadie. Cada dos segundos encolaba un SERVICER nuevo, aunque el anterior siguiera a medias. Cada copia se llevaba su bandeja y su cuaderno. Dos copias, tres, cuatro… y las bandejas eran ocho.

1 · Descenso normalSERVICERP63pantallaradarlibrelibrelibrelibre4 de 8 bandejas ocupadasCuatro trabajos en la cola. SERVICER terminadentro de su ciclo de 2 segundos y liberasu bandeja antes de que llegue el siguiente.2 · El radar roba el 13 % del tiempoSERVICERSERVICERSERVICERSERVICERP63pantallaradarradar8 de 8 bandejas ocupadasALARMA 1202SERVICER ya no acaba a tiempo, pero el relojsigue encolando una copia nueva cada dossegundos. Las ocho bandejas se agotan.3 · Tras el reinicioSERVICERP63pantallalibrelibrelibrelibrelibre3 de 8 bandejas ocupadasEl reinicio revive solo la copia más recientede cada trabajo desde su último punto decontrol. La cola queda limpia y el descenso sigue.

Cuando se agotaron, el Executive hizo exactamente lo que estaba escrito que hiciera: BAILOUT1, código 1202, y reinicio. Hasta aquí es una historia de un ordenador que se satura. Lo que la convierte en otra cosa es lo que pasó al reiniciar.

El reinicio no solo recuperaba el estado: tiraba el atasco. Al revivir desde la tabla de fases, de cada trabajo duplicado solo se restauraba la copia más reciente. Las copias a medias de SERVICER que se habían ido amontonando desaparecían de golpe, y el ordenador se encontraba otra vez con la cola despejada y tiempo de sobra para lo importante: el guiado, los motores y la pantalla.

«Un sistema de protección ante reinicios motivado sobre todo por la posibilidad de fallos del hardware proporcionó, por sinergia, una manera de soltar carga de cálculo ante un atasco de software causado por el TLOSS.»Don Eyles, en el mismo texto

Dicho de otro modo: el ordenador se atragantó, escupió lo que le sobraba y siguió. Pero eso, desde Houston y con el módulo lunar bajando hacia la superficie, no se ve. Lo único que se ve es una luz de aviso encendida y un número en la pantalla.

Steve Bales y Jack Garman tenían que decidir, en cuestión de segundos, si aquel 1202 quería decir «me estoy muriendo» o «me he atragantado y ya lo he resuelto». Sabían que era lo segundo porque lo habían visto en los simuladores unas semanas antes. Garman dijo «go», y detrás fueron Bales, Kranz y Duke.

Durante el descenso saltaron cinco alarmas de esas: primero 1202, «no quedan bandejas», y más tarde 1201, «no quedan cuadernos». El alunizaje no se interrumpió ni una sola vez.

Lo que de aquello seguimos haciendo

En el AGCHoy se llama
Trabajos con prioridad que se expulsanplanificador apropiativo por prioridades
Soltar lo secundario al saturarsedegradación elegante, backpressure
Puntos de control antes de cada paso críticotransacciones, commit, idempotencia
Reiniciar como mecanismo normal de recuperacióncrash-only software, reinicio supervisado
Un intérprete para que el código ocupe menosuna máquina virtual, un bytecode
Un código numérico por cada condición previstacódigos de error y observabilidad

La lista no es una analogía forzada: son las mismas decisiones, tomadas por las mismas razones y casi siempre antes. Y hay una séptima que no cabe en la tabla, que es la que Hamilton defendió cuando le dijeron que los astronautas no se equivocan: que el programa tiene que hacerse cargo de lo que puede salir mal, incluida la persona que está al otro lado.

Margaret Hamilton sonriendo, tumbada en el asiento de la maqueta del módulo de mando del Apolo, con el brazo levantado hacia el panel de mandos lleno de interruptores
Margaret Hamilton en la maqueta del módulo de mando del Apolo, en noviembre de 1969. El panel que tiene encima es el otro extremo de todo lo que cuenta esta página: los interruptores y la DSKY por los que un astronauta hablaba con los ocho trabajos, las nueve tareas y los puntos de control. Foto de la NASA, en dominio público.

Dónde mirarlo tú mismo

Todo lo citado en esta página sale de archivos que puedes abrir ahora mismo.

QuéDónde
El fuente del Apolo 11, módulo lunar y de mandogithub.com/chrislgarry/Apollo-11
El proyecto que lo transcribió, con los escaneos originales y un emuladorVirtual AGC
El relato de quien programó el descenso«Tales from the Lunar Module Guidance Computer»
El ordenador por dentroApollo Guidance Computer

Si abres el repositorio, empieza por Luminary099/EXECUTIVE.agc: son quinientas líneas y es el corazón de todo lo que cuenta esta página. Y si quieres el momento exacto, THE_LUNAR_LANDING.agc, que son trescientas treinta y cinco.

Las cifras de esta página —ocho core sets de 12 registros, cinco áreas VAC de 43, nueve tareas, las operaciones del intérprete, los códigos 1201 y 1202— están comprobadas una a una en el fuente de Luminary 1A build 099, que es el que voló en el Apolo 11, y coinciden con lo que cuenta Don Eyles. Los listados están copiados literalmente, con sus comentarios y sus erratas. Sobre Margaret Hamilton y su equipo escribimos cuando murió, el 30 de septiembre de 2026.