El FBI culpa a Corea del Norte del robo de más de $6,000 millones de USD a Binance; la empresa afirma que ya cubrió el 90 % de los activos afectados

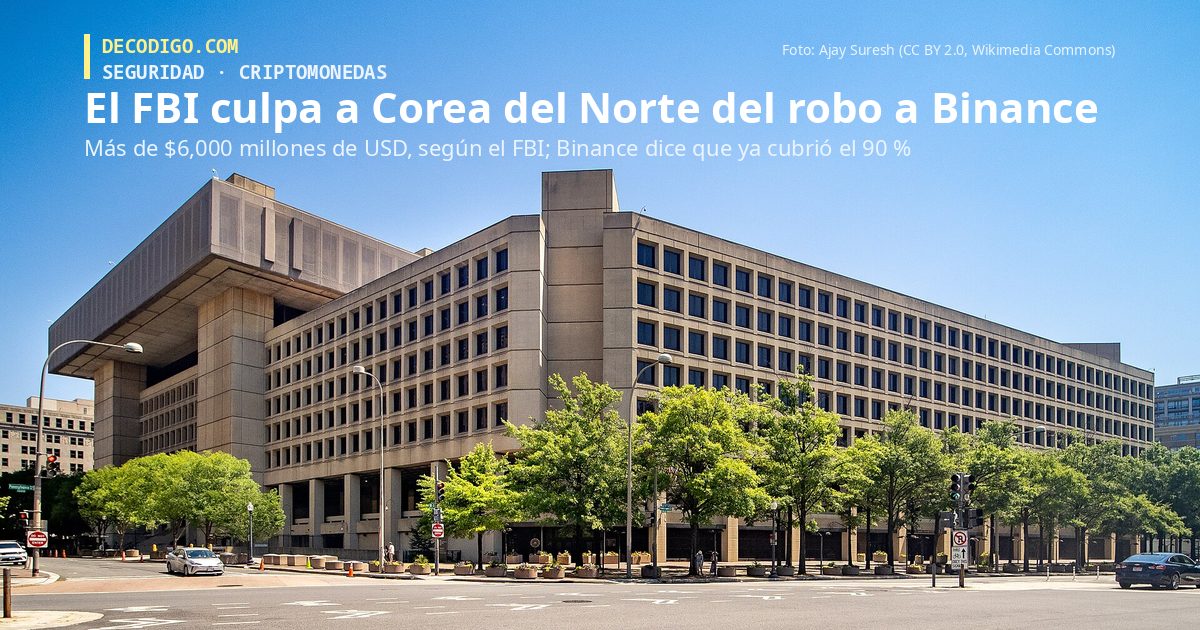
Sede del FBI, el edificio J. Edgar Hoover, en Washington
Del robo a la cobertura: el recorrido simplificado de los fondos, el bloqueo que pide el FBI y lo que Binance cubrió con dinero propio. Esquema de decodigo.com con datos del FBI y de Binance.

El FBI confirmó lo que los analistas sospechaban desde el primer día: Corea del Norte está detrás del robo a Binance, el mayor robo de criptomonedas de la historia. El FBI habla de más de $6,000 millones de USD; Binance estimó el impacto en unos $6,300 millones. El sábado 31 de octubre la agencia lo atribuyó a la actividad que llama «TraderTraitor» y pidió a toda la industria bloquear las direcciones de los atacantes. Binance, por su parte, afirma que ya cubrió el 90 % de los activos afectados con fondos propios y empezó a reabrir los retiros. Eso no quiere decir que haya recuperado lo robado: lo está reponiendo de su bolsillo.

El robo ocurrió el jueves 29 de octubre. Según el informe preliminar de la propia Binance, que resumimos en nuestra nota del día siguiente, el atacante entró por la laptop comprometida de un ingeniero, saltó a su infraestructura y puso a firmar retiros al propio sistema de la empresa. En pocos minutos salieron fondos en diez blockchains. El aviso del FBI no describe cómo fue el acceso. La firma TRM Labs ya había apuntado a TraderTraitor, un grupo norcoreano ligado a Lazarus, pero Binance no había dicho quién estaba detrás. Ahora lo dice el gobierno de EE. UU.

29 oct El robo Binance estima unos $6,300 M robados y suspende los retiros. 30 oct Primer informe Binance cuenta que todo empezó en la laptop de un ingeniero. 31 oct Atribución El FBI culpa a Corea del Norte: actividad TraderTraitor. 31 oct–1 nov Cobertura Binance cubre el 90 % con fondos propios y reabre retiros. Las cifras de Binance son estimaciones de la empresa; el FBI habla de más de $6,000 millones de USD.
Del robo a la atribución, en tres días. Gráfica: decodigo.com con datos de Binance, el FBI, NBC News y Yahoo Finance.

Claves de la atribución y de la respuesta de Binance

  • Lo que dice el FBI. La agencia responsabiliza a la República Popular Democrática de Corea del robo de más de $6,000 millones en activos virtuales, ocurrido «el 29 de octubre de 2026 o alrededor de esa fecha», y lo agrupa bajo el nombre TraderTraitor, el mismo que usó en febrero de 2025 para el robo de unos $1,500 millones a Bybit.
  • A dónde va el dinero. El FBI, el Servicio Secreto y la unidad de investigación criminal del IRS vieron a los atacantes convertir lo robado sobre todo en ether, y esperan que lo sigan lavando con servicios de finanzas descentralizadas (DeFi) y de intercambio instantáneo, que cambian una criptomoneda por otra sin pedir identificación.
  • Lo que pide a la industria. Plataformas de intercambio, operadores de nodos, empresas de análisis de blockchain y demás proveedores deben bloquear cualquier transacción con las direcciones ligadas al robo. Cuantas más empresas lo hagan, más difícil será convertir esos fondos en dinero utilizable.
  • Cuánto cubrió Binance. Según su codirector, Richard Teng, la empresa ya cubrió con fondos propios el 90 % de los activos afectados y se compromete a cubrir el 10 % restante, que son tokens menos líquidos y más lentos de comprar. Apartó unos $6,340 millones de su fondo de emergencia SAFU, de su fondo de seguro de futuros y de su tesorería. Bitcoin, ether, USDT y BNB ya están respaldados por completo.
  • Los retiros vuelven por partes. Binance empezó por la red de Bitcoin y siguió con USDC, USDT y ether en Ethereum y con USDC, USDT y BNB en BNB Smart Chain. El resto de las redes se irá abriendo tras revisiones de seguridad. También prepara una nueva prueba de reservas para diez monedas, que permitirá a cada usuario comprobar que su saldo está respaldado al menos uno a uno.

Lo que cambia con la firma del FBI

Que lo diga el FBI, y no solo una firma privada de análisis, pesa. La atribución da respaldo oficial a las alertas sobre esas direcciones y aumenta el riesgo para cualquier plataforma que acepte fondos vinculados al robo, aunque las consecuencias concretas dependen de cada transacción y de cada jurisdicción. Eso no devuelve lo robado, pero estrecha las salidas. Tras el robo a Bybit, el mismo grupo tardó pocas semanas en mover casi todo, así que la rapidez cuenta: esta vez la atribución llegó en dos días.

Para los usuarios de Binance, el panorama es mejor de lo que sugiere la cifra: la empresa afirma que cubrirá las pérdidas y que los usuarios no asumirán el impacto, y al cierre de esta nota decía haber cubierto el 90 %. Lo que sí conviene es seguir desconfiando de cualquier mensaje que ofrezca «recuperar fondos», pida datos de la cuenta o urja a mover dinero, y consultar solo los canales oficiales de la empresa. Para las demás plataformas, la lección sigue siendo la del primer día: según el informe preliminar de Binance, el punto débil no fue la criptografía, sino la laptop comprometida de un ingeniero con acceso a la infraestructura. Aislar las máquinas que administran la producción, limitar cuánto puede salir de una cartera caliente en poco tiempo y exigir aprobaciones independientes para los movimientos grandes son las defensas que más se repiten.

Más fuentes: Binance, actualización del 31 de octubre de 2026; NBC News, 31 de octubre de 2026; Fox Business, 31 de octubre de 2026; Yahoo Finance, 1 de noviembre de 2026. Foto de portada: sede del FBI en Washington, Ajay Suresh (CC BY 2.0, Wikimedia Commons).

Fuente: FBI, «North Korea Responsible for $6 Billion+ Binance Attack», 31 de octubre de 2026
Anthropic pide salir a la bolsa: registró $16,300 millones de USD de ingresos en seis meses y cientos de miles de millones en compromisos de cómputo

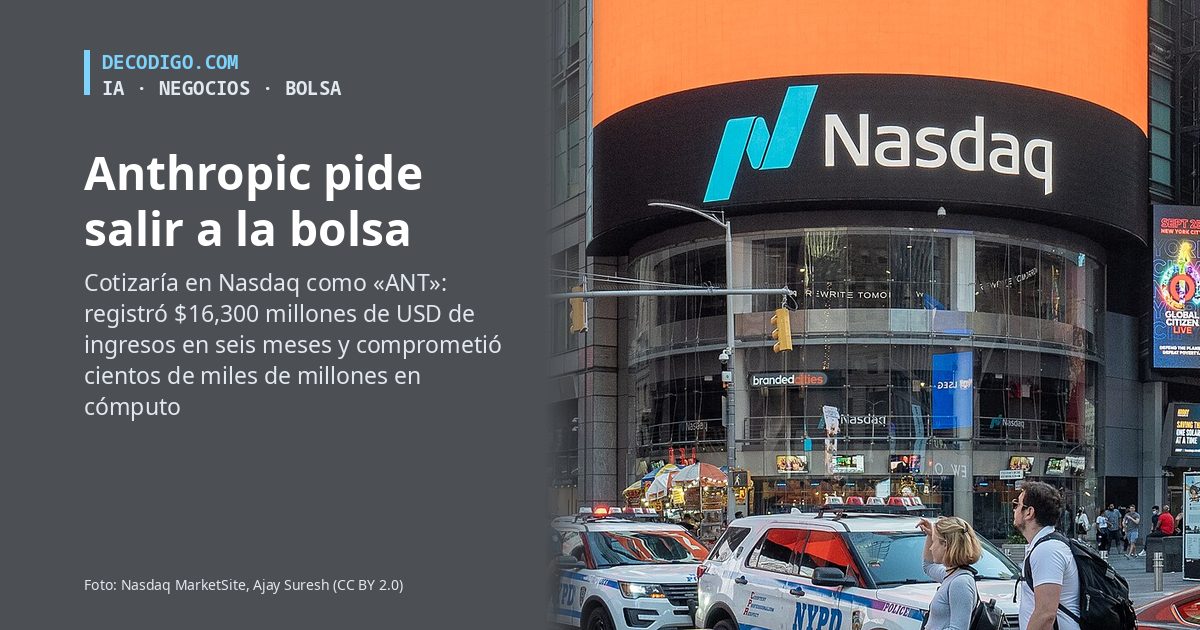
Edificio de Nasdaq en Times Square, con su letrero, donde Anthropic planea cotizar
Los ingresos registrados por Anthropic, sus compromisos de cómputo, que no se suman, y quién elige a su consejo. Esquema de decodigo.com con datos del S-1 presentado ante la SEC.

Anthropic, la empresa que desarrolla Claude, quiere cotizar en la bolsa. El 26 de octubre presentó ante la Comisión de Bolsa y Valores de EE. UU. (SEC) su S-1, la declaración de registro que una empresa debe presentar antes de vender acciones al público, y planea cotizar en Nasdaq con la clave «ANT». El documento, de cientos de páginas, abre por primera vez sus números: $16,300 millones de USD de ingresos registrados en el primer semestre de 2026, casi catorce veces más que un año antes, y cientos de miles de millones de dólares en compromisos de cómputo a varios años.

Hasta ahora, lo que se sabía de las finanzas de los grandes laboratorios de IA salía de filtraciones y de rondas de inversión privadas. Una salida a bolsa obliga a publicar estados financieros, los riesgos del negocio y quién manda en la empresa. Anthropic presentó primero un borrador confidencial en junio y ahora lo hizo público, un paso que la deja por delante de OpenAI en la carrera por cotizar. Todavía no hay número de acciones ni precio. Y aunque se habla de «aprobación», la SEC no aprueba ni desaprueba las acciones ni opina sobre si son buena inversión: revisa que el documento cumpla las reglas de información, y solo cuando la declaración de registro se vuelve efectiva se puede vender la primera acción. Hoy todavía no lo es.

0 3 6 9 12 15 18 Miles de millones de USD $41 M 2023 $386 M 2024 $4,585 M 2025 $1,163 M ene–jun 2025 $16,286 M ene–jun 2026 Año completo Primer semestre
Ingresos registrados por Anthropic por año (auditados) y en el primer semestre (sin auditar). Gráfica: decodigo.com con datos del S-1 presentado ante la SEC.

Claves del S-1 de Anthropic

  • Ingresos que se disparan. Registró ingresos de $41 millones de USD en 2023, $386 millones en 2024 y $4,585 millones en 2025, cifras anuales auditadas. En los primeros seis meses de 2026 registró $16,286 millones, contra $1,163 millones en el mismo periodo de 2025; las cifras semestrales no están auditadas. Son ingresos reconocidos en la contabilidad, no efectivo cobrado. La propia empresa advierte que no espera mantener ese ritmo.
  • Una pérdida enorme, en buena parte contable. La pérdida neta del semestre fue de $80,748 millones. El rubro más grande, $72,388 millones, es el cambio en el valor razonable de sus notas convertibles, pasivos derivados y otros instrumentos: cuanto más vale la empresa, más valen en el papel esos instrumentos que deben convertirse en acciones. Ese rubro no explica toda la pérdida: también suman $8,757 millones de otros gastos netos y la pérdida operativa, la del negocio en sí, que fue de $693 millones, frente a $2,135 millones un año antes. Los $1,111 millones de intereses cobrados restan algo de esa cifra.
  • Cómputo a 20 años. El S-1 da varias cifras de compromisos, de periodos distintos que se solapan, así que no deben sumarse. En sus estados anuales informa que, después del 31 de diciembre de 2025, firmó o amplió acuerdos de centros de datos, equipos y nube con pagos mínimos de unos $417,000 millones. Al 30 de junio de 2026, sus compromisos fijos o mínimos sumaban unos $265,600 millones. Y en los hechos posteriores a ese cierre añade nuevos acuerdos, firmados después del 30 de junio, con pagos mínimos futuros de unos $245,000 millones, algunos sujetos a condiciones, que empiezan entre 2026 y 2036 y duran hasta 20 años, además de unos $21,000 millones en contratos de corto plazo. Aparte, estima entre $125,000 y $150,000 millones por cómputo adicional que no entra en esas tablas. Solo con Amazon se comprometió a gastar al menos $110,000 millones entre mayo de 2026 y abril de 2036, los use o no, con algunos ajustes y excepciones.
  • Clientes grandes. Más de 11,900 clientes le pagaron $100,000 o más en los últimos 12 meses, frente a unos 950 un año antes; más de 1,900 superan el millón y unos 250, los $10 millones. La mayor parte de sus ingresos depende del consumo, es decir, de cuánto usan Claude sus clientes, no de contratos a largo plazo.
  • Plantilla. Pasó de unos 940 empleados a finales de 2024 a unos 5,300 en septiembre de 2026, con más de $6.6 millones de ingresos por empleado al año.
  • Costos que también vienen del pasado. En 2025 registró $1,500 millones por el acuerdo Bartz, la demanda de autores por usar sus libros para entrenar modelos.

Quién manda en Anthropic después de la bolsa

Anthropic es una «corporación de beneficio público»: por estatutos tiene que equilibrar las ganancias de sus accionistas con su propósito, que define como desarrollar IA avanzada de forma responsable. El S-1 detalla cómo se traduce eso en el control de la empresa. Comprar acciones en Nasdaq dará voz, pero no el mando.

Consejo de administración dirige la empresa CLASE T Fideicomiso LTBT Elige y destituye a la mayoría del consejo. Sin derechos económicos. mayoría CLASE F Los 7 cofundadores 50.1 % de los votos de los accionistas, incluido el resto del consejo. 50.1 % CLASE A Quien compre en bolsa Un voto por acción, dentro del 49.9 % restante. Cotiza como ANT. el resto Sin voto en lo general Clase N: socios estratégicos. Mismos derechos económicos que la A, pero sin voto. Clase E: empleados. Solo vota asuntos limitados y no tiene derechos económicos.
Las clases de acciones de Anthropic y quién elige a su consejo, según el S-1. Esquema: decodigo.com.
  • El fideicomiso LTBT. Un fideicomiso sin interés económico en la empresa, el Long-Term Benefit Trust, tiene las acciones clase T, que le permiten elegir y destituir a la mayoría del consejo.
  • Los siete cofundadores. A través de una sociedad propia tienen las acciones clase F, que suman el 50.1 % de los votos en las decisiones de los accionistas, incluida la elección del resto del consejo.
  • El público. Quien compre en la bolsa recibirá acciones clase A, con un voto cada una. Hay además una clase N, sin voto, para socios estratégicos, y una clase E para empleados, que solo vota asuntos limitados.

Por esa estructura, Nasdaq la considera una «empresa controlada», una categoría que permite exenciones concretas, como no tener un consejo mayoritariamente independiente o ciertos comités formados solo por consejeros independientes. No la libra de todas las reglas: las del comité de auditoría siguen aplicando. Anthropic dice que solo usará la exención para su comité de nombramientos y gobierno corporativo, que no será del todo independiente; hoy la mayoría de su consejo es independiente, igual que sus comités de auditoría y de compensación.

Lo que la salida a bolsa revela del negocio de la IA

El S-1 es la primera radiografía oficial de cómo funciona un laboratorio de IA de punta, y la imagen tiene dos caras. Por un lado, la demanda es real: pasar de $386 millones de ingresos en todo 2024 a $16,300 millones solo en el primer semestre de 2026 es un salto con pocos precedentes. Por otro, el modelo exige apostar cientos de miles de millones en cómputo con años de anticipación, mientras que los ingresos dependen del uso mes a mes. Si la demanda se frena, los contratos siguen ahí.

La sección de riesgos, de más de 90 páginas, también deja ver tensiones que no son técnicas. Según la versión de la propia empresa, a principios de 2026 el Departamento de Guerra de EE. UU. sugirió usar la Ley de Producción para la Defensa para obligarla a quitar los límites que pone al uso de sus modelos en armas autónomas y vigilancia masiva; después, el presidente ordenó a las agencias federales dejar de usar su tecnología y el Departamento la designó como un riesgo para la cadena de suministro. Anthropic llevó el caso a los tribunales con resultados mixtos. El 27 de agosto, un tribunal federal de California falló en gran medida a su favor y consideró esas medidas una represalia contra expresiones protegidas por la Primera Enmienda; el gobierno apeló. Pero el 25 de septiembre, el tribunal de apelaciones de Washington, D. C., por dos votos contra uno, rechazó su impugnación de la designación hecha bajo la ley de seguridad de la cadena de suministro federal. La empresa dice que evalúa sus siguientes pasos. Menciona además la dependencia de los chips avanzados, que se fabrican sobre todo en Taiwán.

Para los desarrolladores que usan Claude, el cambio inmediato es nulo, pero cotizar en bolsa obliga a rendir cuentas cada trimestre, y eso suele pesar en precios, prioridades y ritmo de lanzamientos. Falta saber a qué precio saldrán las acciones, cuándo empezarán a cotizar y cuánto dinero buscará levantar Anthropic. Esos datos llegarán en una versión actualizada del S-1.

Más fuentes: el S-1 completo en EDGAR, la base de datos de la SEC; CNBC, 26 de octubre de 2026. Foto de portada: Nasdaq MarketSite, Ajay Suresh (CC BY 2.0, Wikimedia Commons).

Fuente: Anthropic, «Anthropic files S-1 with the SEC for proposed initial public offering», 26 de octubre de 2026

Microsoft prohíbe la ingeniería inversa y el scraping en todos sus servicios en línea, justo cuando la IA abarata desarmar el software

Edificio del campus de Microsoft en Redmond junto al titular: Microsoft prohíbe la ingeniería inversa de sus servicios en línea
A qué servicios de Microsoft llegan ahora las prohibiciones de ingeniería inversa y scraping, qué prohíben y qué dice la ley. Esquema de decodigo.com con datos de los términos de Microsoft y de SAMexpert; no es asesoría legal.

Microsoft cambió las reglas de uso de todos sus servicios en línea, de Azure a Microsoft 365. Sus términos ahora prohíben de forma general hacer ingeniería inversa de cualquiera de ellos, extraer datos con scraping, sacar los pesos de sus modelos de IA y saltarse los límites de sus API. Según el análisis de la consultora SAMexpert, hasta mediados de junio esas prohibiciones solo valían para sus servicios de IA generativa. El cambio llega cuando los agentes de IA convierten la ingeniería inversa, antes un trabajo de especialistas, en algo que casi cualquiera puede intentar.

La ingeniería inversa es el arte de desarmar un programa para entender cómo funciona sin tener su código fuente. Siempre fue lenta y cara: había que leer código máquina, adivinar qué hace cada función y documentarlo a mano. En los últimos meses eso cambió. Herramientas como REA ponen a agentes de IA a analizar programas completos, y proyectos como ArtCraft rehicieron aplicaciones de Adobe y de Office con ayuda de modelos como Claude. Las empresas de software empezaron a responder por la vía que tienen más a mano: sus contratos.

Claves del cambio de Microsoft

  • Qué prohíbe ahora. Según la política de uso aceptable de sus términos de producto, nadie puede usar un servicio en línea de Microsoft para hacerle ingeniería inversa, sacar los pesos de un modelo de IA o descubrir sus componentes, algoritmos o sistemas internos; para extraer datos con scraping u otros métodos; ni para intentar saltarse los límites que Microsoft fija a sus API.
  • Qué cambió. SAMexpert explica que en la actualización del 15 de junio esas prohibiciones pasaron de la sección de IA generativa a las reglas generales que cubren todos los servicios en línea. La prohibición de saltarse los límites de las API es nueva. Microsoft lo resumió en su registro de cambios como una actualización «para mayor claridad».
  • Copiar funciones, también. Desde el 1 de mayo, los términos prohíben usar un servicio en línea «para replicar funciones del producto». No definen qué es replicar, lo que deja el límite a la interpretación de Microsoft.
  • Las consecuencias. Incumplir la política de uso aceptable puede llevar a que Microsoft suspenda el servicio. SAMexpert advierte que la prohibición del scraping no tiene una excepción explícita para los datos del propio cliente: las herramientas de exportación que Microsoft documenta siguen permitidas, pero las de migración, respaldo o carga de datos que extraigan información por caminos no soportados conviene revisarlas.

Lo que dice la ley, más allá del contrato

Un contrato no siempre tiene la última palabra. En la Unión Europea, la directiva sobre la protección jurídica del software, la 2009/24/CE, permite observar, estudiar y probar el funcionamiento de un programa que se usa legalmente, y descompilarlo bajo condiciones estrictas cuando hace falta para que otro programa sea compatible con él; las cláusulas de una licencia que lo prohíban son nulas. La directiva de secretos comerciales también considera lícito estudiar un producto obtenido legalmente, aunque ahí sí cuenta lo que diga el contrato. En Estados Unidos, el caso Sega contra Accolade, de 1992, aceptó desensamblar un programa para lograr compatibilidad, y la ley de derechos de autor digitales tiene una excepción de interoperabilidad, pero tribunales como el del caso Bowers contra Baystate han dado validez a las licencias que prohíben la ingeniería inversa.

Hay un matiz importante: los términos de Microsoft hablan de sus servicios en línea, que corren en sus servidores, no de un programa instalado en tu computadora. Desarmar un servicio en la nube suele exigir atacarlo o abusar de su API, algo que las leyes protegen mucho menos que estudiar un archivo que compraste. Por eso el cambio pesa sobre todo en quien construye herramientas automáticas encima de esos servicios: agentes, extractores de datos o productos que imitan sus funciones.

Qué significa para desarrolladores y empresas

La ingeniería inversa con IA sigue siendo legítima en muchos usos: auditar la seguridad de un programa propio, recuperar software abandonado, estudiar malware o lograr que dos sistemas se entiendan. Pero el terreno se está moviendo. Si tu empresa usa Azure, Microsoft 365 u otro servicio en la nube, conviene revisar qué herramientas automatizadas extraen datos o tocan las API y si lo hacen por las vías documentadas. Y si desarrollas con agentes de IA que analizan software ajeno, conviene leer la licencia antes de empezar: lo que la IA vuelve barato técnicamente puede seguir saliendo caro en un contrato.

Más fuentes: los términos de producto de Microsoft para servicios en línea; SAMexpert, la prohibición de replicar funciones (mayo); la Directiva 2009/24/CE. Lee también: ArtCraft y el software creativo abierto con IA. Foto de portada: Coolcaesar (CC BY-SA 4.0, Wikimedia Commons).

Fuente: SAMexpert, «Microsoft Product Terms July 2026: Scraping Ban», 1 de julio de 2026

Linux 7.4 tuvo la mayor ventana de integración registrada desde 2011, y un parche propone quitar KGDB, el depurador del kernel, en x86

Linus Torvalds con micrófono junto al titular: Linux 7.4 rompe el récord de cambios
Los commits de la ventana de integración de Linux 7.4 frente a las versiones anteriores, y a quién afecta el parche sobre KGDB: solo a x86. Esquema de decodigo.com con datos de Phoronix y del parche.

El kernel Linux 7.4 rompió una marca antes de salir: en su ventana de integración, el periodo en el que Linus Torvalds acepta funciones nuevas, recibió 19,671 commits, la cifra más alta en los registros de Phoronix, que empiezan en 2011. Es un recuento provisional, hecho antes de la primera versión de prueba. Phoronix atribuye el aumento sobre todo a reportes de fallos y parches generados con IA. Aparte, el desarrollador Peter Zijlstra envió un parche para quitar el soporte de KGDB, el depurador del kernel, en la arquitectura x86, la de los procesadores de Intel y AMD; no en las demás.

Cada versión de Linux sigue el mismo ritmo: tras publicarse una versión estable, se abre una ventana de integración, normalmente de dos semanas, en la que los responsables de cada área envían a Torvalds los cambios que prepararon durante meses. Al cerrarla sale la primera versión de prueba, la rc1, y siguen unas siete u ocho semanas dedicadas a corregir errores. Linux 7.3 salió el 18 de octubre, y la ventana de la 7.4 coincidió con unas vacaciones de Torvalds. Hasta este domingo 1 de noviembre, la 7.4-rc1 todavía no aparecía en el repositorio del kernel.

Claves de la ventana récord

  • Casi 20,000 commits. Phoronix contó 19,671 desde la versión 7.3. En sus datos, que van de Linux 3.1, en 2011, a hoy, las ventanas solían quedarse en unos 13,000 o 14,000, y ninguna había pasado de unos 16,300. La cifra puede crecer un poco hasta que salga la rc1.
  • Un código fuente más grande. Comparando el tamaño del árbol del kernel en dos momentos, la versión 7.3 publicada y la 7.4 justo antes de la rc1, pasó de unos 41.0 a 41.6 millones de líneas; sin comentarios ni líneas en blanco, unas 456,000 líneas de código más. Phoronix calcula que superará los 42 millones con la versión 7.5.
  • La IA, según Phoronix. El sitio interpreta que buena parte del aumento son correcciones que nacen de reportes y parches generados con modelos de IA, y describe a los mantenedores, las personas que revisan y aceptan cada cambio, como «completamente desbordados». Es su lectura del fenómeno, no un dato medido commit por commit. El ciclo anterior, de la 7.2 a la 7.3, ya había sido el primero en superar los 20,000 commits.
  • Mejoras concretas. Entre lo integrado hay un sistema de archivos FAT32 hasta 265 veces más rápido en algunas operaciones, soporte para el almacenamiento NVMe de los chips M4 de Apple y la eliminación de __get_user() y __put_user(), dos funciones antiguas para copiar datos entre el kernel y los programas que no hacían todas las comprobaciones de seguridad de sus versiones sin guiones bajos.
0 5,000 10,000 15,000 20,000 Como referencia, Linux 6.7: 16,203 12,468 Linux 7.0 13,963 Linux 7.1 14,395 Linux 7.2 16,267 Linux 7.3 19,671 Linux 7.4 Commits en la ventana de integración de cada versión La cifra de la 7.4 es provisional: se contó antes de publicar la 7.4-rc1. Datos: Phoronix.
Commits en la ventana de integración de Linux 7.0 a 7.4. La cifra de la 7.4 es provisional. Gráfica: decodigo.com con datos de Phoronix.

KGDB en x86, en duda

El 28 de octubre, Peter Zijlstra, veterano desarrollador del kernel en Intel, envió a la lista de correo del kernel un parche titulado «x86: Drop KGDB support», es decir, quitar el soporte de KGDB en x86. KGDB permite detener un kernel en marcha y revisarlo paso a paso desde otra computadora conectada por un cable serie o por red, como se hace con cualquier programa en un depurador. El parche no elimina KGDB de todo el kernel: las demás arquitecturas, como ARM o RISC-V, lo conservarían.

Zijlstra sostiene que KGDB «hace cosas horribles» en x86: se queda atascado en un modo especial de interrupciones, puede desajustar el reloj interno del kernel y causa problemas con los puntos de ruptura. En su opinión, no hay razón para usarlo en lugar del servidor de depuración de QEMU, el emulador más usado, cuando el kernel corre en una máquina virtual. Para fallos que solo aparecen en hardware real propone pasar el dispositivo a la máquina virtual, emularlo o depurar con mensajes de printk(). Esas son sus alternativas; no está claro que cubran todos los casos en los que hoy se usa KGDB con hardware real. Él mismo admite que lo usó «una vez, hace unos 20 años».

No hay decisión todavía. El hilo recibió respuestas de otros desarrolladores, y una propuesta intermedia es desactivarlo primero en la configuración del kernel y retirarlo unas versiones después, para dar tiempo a quienes aún dependen de él. KGDB está en el kernel desde la versión 2.6.26, de 2008.

Qué cambia para quien trabaja con el kernel

Son dos noticias distintas. La ventana récord muestra cuánto trabajo llega hoy a los mantenedores, y Phoronix lo relaciona con la IA. La propuesta sobre KGDB responde a problemas técnicos del propio depurador en x86; nada en el parche indica que la motive el aumento de commits, aunque ambas cosas apuntan a mantenedores que buscan quitarse de encima código difícil de sostener. Para quien desarrolla controladores o depura el kernel en x86, el mensaje práctico es seguir el hilo y, si depende de KGDB, contarlo en la discusión o preparar la transición a la depuración con QEMU. Para el resto, la 7.4 debería llegar a principios de 2027.

Más fuentes: Phoronix, commits y líneas de código; el parche «x86: Drop KGDB support» y su discusión; Phoronix, la retirada de __get_user() y __put_user(); kernel.org, versiones publicadas. Lee también: los fallos del kernel publicados por error. Foto de portada: Beraldo Leal (CC BY 2.0, Wikimedia Commons).

Fuente: Phoronix, «The Linux 7.4 Merge Window Is Easily The Largest In Kernel History», 1 de noviembre de 2026

Un «universo» de átomos fríos con un reloj interno: el tiempo entrópico solo avanza cuando algo cambia en el sistema

Mesa óptica de un experimento de átomos fríos junto al titular: un reloj que solo avanza cuando algo cambia
El «universo» de átomos fríos: la región iluminada se expande y se contrae, y el tiempo entrópico, construido con la entropía de esa región, solo avanza mientras esta cambia. Esquema ilustrativo de decodigo.com.

¿Se puede ordenar lo que pasa en un sistema sin usar un reloj externo como referencia? En la Universidad de Birmingham, el físico Giovanni Barontini usó unos 24,000 átomos enfriados casi al cero absoluto, bien aislados del entorno, como un universo en miniatura, y construyó dentro de él un «tiempo entrópico»: una variable que avanza cuando cambia la entropía de una región del sistema y que se detiene cuando esta no cambia. Es una medida interna del tiempo en un modelo cuántico, no una respuesta a de dónde sale el tiempo del universo.

El experimento ataca uno de los grandes problemas de la física teórica. Cuando se intenta unir la relatividad general con la mecánica cuántica, aparece la ecuación de Wheeler-DeWitt, que describe el universo entero como un estado cuántico que no cambia y en el que el tiempo, sencillamente, no aparece. Si fuera así, ¿de dónde sale el paso del tiempo que vivimos? Una idea es que el tiempo puede definirse de forma relacional, a partir de los cambios dentro del propio sistema. Barontini quiso ponerla a prueba en el laboratorio. El artículo se publicó el 11 de junio de 2026 en Physical Review Research; la Universidad de Birmingham lo difundió a finales de octubre.

Claves del experimento

  • Un universo en una caja. Los átomos, a pocas milmillonésimas de grado del cero absoluto, quedan bien aislados del entorno: durante el experimento, la pérdida de energía hacia afuera es despreciable. Dos rayos láser de frecuencias distintas forman una barrera delgada que separa una región «iluminada», la que se observa, de otra «oscura». Los átomos pueden pasar de una a la otra.
  • Expansión y contracción. La región iluminada crece y luego se encoge una y otra vez, una versión muy simplificada de un universo que nace en un Big Bang y termina en un Big Crunch.
  • El reloj interno. El laboratorio mide el sistema, pero no usa el tiempo externo para ordenar lo que pasa dentro. En su lugar, el reloj se construye con una medida de entropía definida para la región iluminada, que depende de cómo se reparten en ella los átomos; no se trata de contar cada movimiento. Cuando esa entropía cambia, el reloj avanza; cuando no, se detiene. La variable construida ordena los sucesos en una sola dirección, incluso durante los ciclos de expansión y contracción, y puede avanzar más rápido o más despacio.
  • Sirve para hacer física. Con ese tiempo interno puede escribirse una versión de la ecuación de Schrödinger, la que describe cómo evoluciona un sistema cuántico, y hacer predicciones.

Lo que muestra y lo que no

Según Barontini, es la primera evidencia experimental controlada de que el tiempo puede definirse a partir de los cambios dentro de un sistema. Pero conviene no exagerar: el resultado muestra una forma de definir y medir un tiempo interno en un sistema cuántico controlado, no que el tiempo de nuestro universo surja de la entropía. Tampoco demuestra que el tiempo sea una ilusión ni que el universo carezca de un tiempo fundamental. Es un modelo cuántico muy simplificado y no reproduce ningún suceso cósmico real. Que el reloj entrópico «se detenga» tampoco quiere decir que el tiempo se haya parado en el laboratorio: solo que, en ese sistema, no hay nada que lo marque.

El valor del trabajo es convertir una pregunta casi filosófica en algo que se puede medir. El siguiente paso, según el autor, es probar la idea en sistemas más complejos e incluso en modelos de agujeros negros. Si te gustan las simulaciones de física, también puedes jugar con nuestro simulador de lente gravitacional.

Más fuentes: el artículo en Physical Review Research, 11 de junio de 2026. Esquema: decodigo.com. Foto de portada: Tomasz Kawalec (CC BY-SA 4.0, Wikimedia Commons).

Fuente: Universidad de Birmingham vía ScienceDaily, «Physicists created a tiny universe and watched time emerge without a clock», comunicado publicado el 30 de octubre de 2026

Startorus prueba un imán superconductor para fusión que cambia su campo a 63 teslas por segundo, un récord según la empresa

Plasma dentro de un tokamak esférico junto al titular: un imán que cambia 63 teslas por segundo
Cómo funciona el imán que probó Startorus: el solenoide central sube su campo y, mientras cambia, induce corriente en el plasma. Esquema de decodigo.com con cifras que reporta Startorus Fusion.

La empresa china de fusión nuclear Startorus Fusion probó a -253 °C un imán de prueba del solenoide central de su futuro reactor CTRFR-1, hecho con superconductores de alta temperatura. Según la empresa, su campo llegó a 10 teslas y cambió a un ritmo de 63 teslas por segundo, lo que Startorus presenta como un récord mundial entre los imanes superconductores para fusión que se conocen.

Startorus nació en 2021 en Xi’an y hoy tiene su base principal en Shanghai. Apuesta por los tokamaks esféricos, una versión compacta del clásico reactor en forma de dona en la que el plasma se ve casi como una manzana con un hueco muy estrecho en el centro. Ese hueco es el problema: ahí tiene que caber el solenoide central, el imán que funciona como el primario de un transformador. Mientras su campo cambia, induce una corriente eléctrica en el plasma, y esa corriente ayuda a calentarlo y a confinarlo; no lo hace solo, porque el calentamiento y el confinamiento dependen también de otros sistemas, como las bobinas que rodean el reactor y el calentamiento externo. Como hay poco espacio, el solenoide tiene que concentrar mucha corriente y ser capaz de cambiar su campo muy rápido.

Lo que se probó no es el solenoide definitivo. Startorus lo llama «modelo» del solenoide central y lo describe como un prototipo de verificación de ingeniería: una bobina de prueba que sirve para comprobar el diseño, la fabricación y el funcionamiento en frío antes de construir el imán del reactor. La empresa no detalla si tiene el tamaño del imán final.

Claves de la prueba

  • Las cifras que reporta la empresa. La bobina de prueba trabajó a 20 kelvin con 6,350 amperes. Alcanzó un campo máximo de 10 teslas, del orden de 200,000 veces el campo magnético de la Tierra, que en la superficie va de unas 25 a 65 millonésimas de tesla según el lugar. La corriente subió a 40,000 amperes por segundo, con picos de 2,850 volts.
  • Por qué importa la rapidez. En un tokamak, la corriente del plasma se induce mientras el campo del solenoide cambia. Un imán que cambia rápido da más margen para arrancar esa corriente y controlarla en un espacio reducido, algo especialmente útil en los diseños esféricos.
  • Superconductores de alta temperatura. El imán trabaja a 20 kelvin, no a los 4 kelvin del helio líquido que necesitan los superconductores clásicos. Enfriar a 20 kelvin suele exigir menos al sistema de refrigeración, aunque eso no basta para decir que el conjunto sea más barato: dependerá de la potencia de refrigeración, los materiales y el diseño. Estos superconductores también permiten campos más intensos en menos espacio.
  • Un récord según la empresa. Los 10 teslas y los 63 teslas por segundo son mediciones que reporta Startorus. Que sea un récord mundial es su propia comparación: no explica con qué imanes se comparó ni con qué criterio, y no hay todavía una revisión independiente. Startorus planea pruebas por encima de 12 teslas, descargas rápidas repetidas y medir las pérdidas de energía al cambiar el campo.

Una carrera china hacia la fusión comercial

La prueba forma parte de un calendario ambicioso, que es el de la propia empresa. Según su página de avances, la fabricación en serie de los imanes del reactor CTRFR-1 empezará en Shanghai en 2027. Según Nuclear Engineering International, Startorus quiere terminar el CTRFR-1 en 2028 con el objetivo de producir más energía de la que consume y tener en 2032 una planta piloto que entregue electricidad a la red. La misma publicación informa que la empresa levantó en enero una ronda de 1,000 millones de yuanes, unos $143 millones de USD, encabezada por fondos de capital estatal, y que suma más de 1,500 millones de yuanes de más de 50 inversionistas.

Son plazos que pocos proyectos de fusión han cumplido, y un imán récord es solo una pieza: falta confinar el plasma, calentarlo y extraer la energía de forma estable. Pero la prueba muestra que en China se empuja por varios frentes a la vez, desde los grandes reactores públicos hasta empresas privadas como esta, en la misma carrera en la que compiten estadounidenses como General Fusion o Helion.

Más fuentes: Nuclear Engineering International, plazos del CTRFR-1 y de la planta piloto y financiación; The Fusion Report. Esquema: decodigo.com. Foto de portada: Eye Steel Film (CC BY 2.0, Wikimedia Commons).

Fuente: Startorus Fusion, avances del proyecto, octubre de 2026

China publica sus primeras normas para robots humanoides mientras se prepara para fabricar más de 100,000 este año

Robot humanoide Unitree G1 en un escenario, junto al titular: China pone normas a sus robots humanoides
Los humanoides en China: cuántos se fabrican, a qué ritmo sale una línea de montaje y qué cubren sus primeras normas. Esquema de decodigo.com con datos del Ministerio de Industria de China, Gasgoo y la SAMR.

China ya tiene sus primeras normas nacionales para robots humanoides. Son seis, entrarán en vigor el 1 de abril de 2027 y llegan en el año en que su gobierno prevé fabricar más de 100,000 humanoides. Para darse una idea del salto: en 2025 se enviaron en todo el mundo entre 13,000 y 16,000, según las estimaciones que recoge la prensa especializada china.

Los robots con forma humana dejaron de ser solo demostraciones de baile o de kung fu. Pekín los considera una industria estratégica, junto con la llamada IA corpórea, la que aprende moviéndose en el mundo físico. En febrero, el Ministerio de Industria y Tecnologías de la Información presentó un marco para ordenar sus normas, y en julio uno de sus funcionarios, Gan Xiaobin, dijo que la producción del país superaría las 100,000 unidades este año. Ahora la Administración Estatal de Regulación del Mercado, la SAMR, publicó las seis primeras normas en su anuncio número 43 de 2026.

Claves del auge de los humanoides en China

  • Qué regulan las normas. Cubren las reglas generales, la percepción del entorno, la toma de decisiones y la planeación, el control del movimiento, la ejecución de tareas y las plataformas para probarlos en simulación. Según la prensa especializada, son recomendadas y no obligatorias, y una norma de seguridad que sí lo sería sigue en preparación. En su redacción participaron fabricantes como Unitree, UBTech y Xiaomi.
  • Quién fabrica. En 2025, Unitree entregó más de 5,500 humanoides; AgiBot, más de 5,000, y UBTech, 1,079 de tamaño completo. AgiBot sacó su robot número 10,000 en marzo y el 15,000 a finales de junio, que fue a parar a una fábrica de electrónica.
  • Líneas de montaje de verdad. La línea de Dongfang Precision y Leju Robotics, la primera del país capaz de hacer más de 10,000 al año, arma un humanoide cada 30 minutos. La de Engine AI en Shenzhen, inaugurada en mayo, uno cada 15.
  • Un pronóstico, no una cifra cerrada. Los 100,000 son una previsión del gobierno, sin datos independientes de ventas. Para cumplirla, la producción tendría que multiplicarse por más de seis respecto a lo que se envió en todo el mundo el año pasado.

Por qué importan unas normas para robots

Las normas son la parte poco vistosa de una industria, pero deciden mucho. Si cada fabricante mide a su manera qué tan bien ve, se mueve o completa una tarea su robot, comparar modelos es imposible y venderlos a una fábrica, más difícil. Fijar esas reglas primero le da a China una ventaja: las empresas que las escribieron, como Unitree o UBTech, ya trabajan con ellas, y quien quiera venderle robots a su enorme mercado tendrá que cumplirlas.

Queda la gran pregunta de para qué se usarán tantos robots. Fabricar 100,000 no es lo mismo que tenerlos trabajando: buena parte de los humanoides de hoy van a laboratorios, escuelas, exhibiciones y pruebas piloto, y pocos hacen todavía tareas productivas a jornada completa. Las líneas de montaje y las normas apuntan a que China quiere estar lista cuando eso cambie, como ya intentan fábricas como la de Schaeffler en Taicang o robots como el H2-X de Unitree.

Más fuentes: CGTN, el pronóstico del Ministerio de Industria; Gasgoo, producción por empresa; SCIO, el marco de normas de febrero. Lee también: lo que se sabe del Optimus V3 de Tesla. Esquema: decodigo.com. Foto de portada: RuinDig/Yuki Uchida (CC BY 4.0, Wikimedia Commons).

Fuente: Gasgoo, las seis normas nacionales para humanoides (anuncio n.º 43 de 2026 de la SAMR), 21 de octubre de 2026

Venus pudo tener una luna y destruirla: su giro cada vez más lento la habría hecho caer en espiral hasta despedazarla

Venus fotografiada por la Mariner 10 junto al titular: Venus pudo tener una luna y destruirla
Cómo una luna de Venus pudo acabar despedazada: el planeta se frena, el radio sincrónico rebasa la órbita y la luna cae en espiral. Simulación ilustrativa de decodigo.com basada en el estudio de Kane y otros.

¿Por qué la Tierra tiene una luna y Venus, su vecina casi gemela, ninguna? Un estudio de la Universidad de California en Riverside propone una respuesta sin catástrofes: Venus pudo tener una luna, pero su giro cada vez más lento la habría hecho caer en espiral hasta despedazarla. Según las simulaciones, una luna como la nuestra habría durado entre 30 y 1,700 millones de años, según su tamaño.

Venus y Mercurio son los únicos planetas del Sistema Solar sin lunas. En el caso de Mercurio, tan pegado al Sol, se entiende; en el de Venus, que es casi del tamaño de la Tierra, siempre ha sido un misterio. Las explicaciones más citadas eran que nunca se formó una luna o que un gran impacto la arrancó después. El astrofísico Stephen Kane y tres colegas probaron una tercera vía: simularon qué le pasaría a una luna hipotética de Venus bajo las mareas, las mismas que hacen que nuestra Luna se aleje unos 4 centímetros cada año. El trabajo salió a mediados de septiembre y se publicó en The Astrophysical Journal.

Claves del estudio

  • Todo depende de qué tan rápido gire el planeta. La Tierra gira en 24 horas, más rápido de lo que la Luna le da la vuelta, así que el abultamiento de las mareas va un poco adelantado y la empuja hacia afuera. Venus hoy tarda 243 días en dar una vuelta, y además gira al revés que casi todos los planetas. Con un giro tan lento, ese empujón se invierte y la luna cae.
  • La carrera entre la luna y el radio sincrónico. El radio sincrónico es la distancia a la que una luna tardaría en dar la vuelta lo mismo que dura un día del planeta. Si Venus nació girando rápido, su luna empezó alejándose. Pero las mareas del Sol y de la propia luna fueron frenando al planeta, y ese radio creció. Cuando rebasa la órbita, la luna deja de alejarse y empieza a caer.
  • El final: el límite de Roche. Muy cerca del planeta, su gravedad tira más fuerte del lado cercano de la luna que del lejano, y la parte. Los restos caerían a Venus.
  • Cuestión de masa y de giro. Los autores probaron giros iniciales de 5 a 100 horas y lunas de hasta 10 veces la masa de la nuestra. Si Venus giraba en 15 horas o más, o si la luna tenía más de dos masas lunares, la destrucción llegaba en algún momento entre 30 y 1,700 millones de años. Una luna de media masa lunar habría aguantado unos 1,700 millones de años; una del doble, apenas unos 30 millones.
  • No prueba que existió. El estudio muestra que la desaparición es posible sin un choque, no que Venus haya tenido luna. Y las pistas son difíciles de encontrar: cerca del 80 % de su superficie tiene una edad parecida, porque un repavimentado volcánico de hace unos mil millones de años borró las huellas anteriores.

Lo que dice sobre las lunas de otros mundos

«Mi estudio muestra que Venus no necesitó una catástrofe para llegar a lo que vemos hoy», dijo Kane. El resultado tiene una lectura más amplia: no basta con que un planeta forme una luna, también tiene que poder conservarla. Las simulaciones de los grandes choques que crean lunas sugieren que Venus quedó girando en unas 12 horas o más, justo en la frontera en la que una luna como la nuestra sobrevive o se pierde, así que el destino de Venus pudo decidirse por muy poco. Lo mismo valdría para los planetas parecidos a la Tierra que giran despacio alrededor de otras estrellas, que podrían perder sus lunas. Kane cree que tener una luna ayuda, pero que «no es un requisito para la habitabilidad».

Si Venus tuvo una luna, su choque final le habría transferido energía y giro, con efectos en su geología y quizá en su clima. Comprobarlo exigirá buscar rastros en su interior, como los que los sismólogos creen haber encontrado en el manto de la Tierra del choque que formó nuestra Luna. Mientras tanto, la idea cambia la pregunta: quizá Venus no es el planeta raro por no tener luna, y la Tierra es la afortunada por haber conservado la suya.

Más fuentes: el artículo científico en arXiv; Gizmodo, los tiempos de supervivencia. Lee también: por qué la Luna tiene dos caras tan distintas. Esquema: decodigo.com. Imagen de portada: NASA/JPL-Caltech (dominio público).

Fuente: Universidad de California en Riverside vía ScienceDaily, «Venus may have swallowed its own moon», septiembre de 2026

Apple vuelve a ser la empresa más valiosa del mundo: Nvidia cayó 4.2 % en plena desconfianza por el gasto en IA

Sede de Nvidia en Santa Clara con el titular: Apple le quita la corona a Nvidia
Apple y Nvidia, antes y después del viernes 30 de octubre: las dos cayeron, pero Nvidia más, y se invirtió el orden. Esquema de decodigo.com con datos de Bloomberg y companiesmarketcap.

Apple volvió a ser la empresa más valiosa del mundo. Al cierre del viernes 30 de octubre, todas sus acciones juntas valían unos $5.03 billones de USD (millones de millones), frente a unos $4.94 billones de Nvidia. Las dos bajaron ese día, pero no igual: Apple perdió 1.2 % y Nvidia 4.2 %, en plena desconfianza de los inversionistas sobre el gasto en inteligencia artificial. Es la primera vez que Apple la rebasa desde finales de julio.

Nvidia ocupa el primer lugar casi sin interrupción desde junio de 2025, cuando pasó a Microsoft gracias a la demanda de sus chips para entrenar y ejecutar modelos de IA. Apple ya le había quitado el puesto unos días a finales de julio: el 27 de ese mes cerró con $4.95 billones frente a $4.77 de Nvidia, según CNBC. A principios de octubre Apple cruzó por primera vez los $5 billones y Nvidia volvió a adelantarse, hasta que la caída del viernes invirtió otra vez el orden.

Claves del cambio de lugar

  • Los números del viernes. La acción de Apple cerró en $344.63 y la de Nvidia en $204.64. La diferencia entre las dos empresas quedó en unos $90,000 millones de USD, menos del 2 % de su valor, así que el orden puede volver a cambiar con cualquier sesión movida.
  • El miedo al gasto en IA. Los inversionistas empiezan a dudar de que los miles de millones que se invierten en centros de datos vayan a recuperarse pronto. Alphabet gastó $51,400 millones de USD en un solo trimestre y su flujo de caja libre, el dinero que le queda después de invertir, quedó en negativo. El de Amazon en los últimos 12 meses pasó de +$14,800 millones a -$42,400 millones.
  • Un mal mes para los chips. El viernes, Intel se desplomó un 29 % tras sus previsiones y arrastró al resto del sector. En octubre, el índice Nasdaq 100 cayó 6.7 %, su peor mes desde marzo de 2025, y empresas de infraestructura para IA como CoreWeave y Nebius perdieron más de 30 %.
  • Apple como refugio. Apple casi no compite en la carrera de los centros de datos, así que gasta mucho menos. Según Bloomberg, su flujo de caja libre crecería 38 % hasta unos $142,000 millones en el año fiscal que cerró en septiembre, y sus acciones suben 27 % en 2026, casi el triple que las de Nvidia (9.7 %).

Lo que el cambio dice sobre la fiebre de la IA

Que Apple pase a Nvidia no significa que a Nvidia le vaya mal: sigue vendiendo todos los chips que puede fabricar y vale casi cinco billones de dólares. Lo que cambió es el humor del mercado. Durante dos años, los inversionistas premiaron a quien más gastaba en IA y a quien le vendía las palas de esa fiebre del oro, que es justamente Nvidia. Ahora miran con más cuidado cuánto dinero sale de las grandes tecnológicas y cuándo regresa, y prefieren a las empresas que generan efectivo sin depender de esa apuesta. Las propias empresas, además, intentan fabricar sus propios chips de IA para depender menos de Nvidia.

El primer lugar entre las dos ha cambiado de manos varias veces este año y la distancia es mínima, así que lo más probable es que siga moviéndose. Lo que conviene vigilar no es tanto quién va primero, sino si el gasto en IA empieza a traducirse en ganancias: de eso dependerá hacia dónde se inclina la balanza en los próximos trimestres.

Más fuentes: Coinpaper, las cuentas de Alphabet y Amazon; CNBC, el cruce de julio; companiesmarketcap, valores al cierre. Esquema: decodigo.com. Foto de portada: Coolcaesar (CC BY-SA 4.0, Wikimedia Commons).

Fuente: Notebookcheck, «Nvidia loses its $5 trillion crown as Apple takes the top spot», con datos de Bloomberg, 31 de octubre de 2026

WireClaw: el proyecto que convierte un ESP32 de $5 USD en un agente de IA que crea sus propias automatizaciones

Módulo ESP32 de Espressif con su blindaje metálico, junto al titular sobre WireClaw
Cómo funciona WireClaw: la IA solo interviene al crear la regla; después, el ESP32 la cumple por su cuenta. Esquema de decodigo.com con datos de la documentación del proyecto.

WireClaw es un firmware de código abierto que convierte un ESP32, una placa que su autor calcula en unos $5 USD, en un pequeño agente de IA. Le escribes por Telegram algo como «si la temperatura pasa de 28 °C, prende el ventilador», y la placa configura sus pines y crea una regla que después cumple sola, sin IA y sin internet. El proyecto nació en febrero y en octubre llegó a Adafruit y a Electronics For You, que lo presentaron como «OpenClaw para el ESP32».

El ESP32 es un microcontrolador de Espressif con WiFi integrado, muy usado en proyectos caseros de domótica. A diferencia de una Raspberry Pi, no tiene sistema operativo ni memoria suficiente para correr un modelo de lenguaje: el chip tiene 320 KB de RAM. Por eso WireClaw no mete la IA en la placa, sino que la usa como intérprete. El ESP32 manda tu mensaje a un modelo en la nube por OpenRouter, o a uno que corra en tu propia red con Ollama, y el modelo le responde con instrucciones concretas, como «crear una regla sobre el sensor de temperatura con umbral de 28». Su autor, que publica en GitHub como M64GitHub, lo resume así: «la IA crea las reglas; las reglas funcionan sin la IA».

Claves de WireClaw

  • Dos momentos distintos. Mientras conversas, cada mensaje pasa por el modelo de IA, que puede encadenar hasta cinco llamadas a herramientas. Una vez creada la regla, la placa revisa el sensor cada 5 segundos y actúa por su cuenta: prende o apaga un pin, cambia el color del LED, manda un aviso por Telegram o publica un mensaje en la red. Las reglas se guardan en la memoria flash y sobreviven a un apagón.
  • Se instala desde el navegador. Funciona con el ESP32-C6, el S3 y el C3, siempre que tengan 4 MB de flash. Se graba desde wireclaw.io con Chrome o Edge, sin instalar nada. La primera vez, la placa crea una red WiFi llamada «WireClaw-Setup» para que le pongas desde el celular tu red, la clave del modelo de IA y el token de Telegram.
  • Veinte herramientas. La IA puede leer sensores, mover pines, crear reglas encadenadas con esperas («avísame, espera 5 segundos y prende el LED en verde»), programarlas a una hora gracias al reloj de internet y guardar notas en una memoria que conserva tus preferencias tras reiniciar. También puede hablar por el puerto serie con un Arduino, un GPS o un sensor de CO2.
  • Un modelo rápido marca la diferencia. En las pruebas del autor, Gemini 2.5 Flash responde en unos 4 segundos, Claude Sonnet 4.5 en unos 10 y DeepSeek V3.2 en unos 44, los tres con buenos resultados. Un modelo pequeño como Qwen 2.5 7B falló: se saltaba pasos y confundía las esperas. Para usarlo sin la nube recomienda gpt-oss de 20B, que ocupa 13 GB y necesita una computadora aparte.
  • Pensado para conectarse. Por NATS, un sistema de mensajería ligero, puede recibir datos de Home Assistant, de un script de Python o de otras placas WireClaw, y otro agente como OpenClaw puede usar sus herramientas directamente, sin pasar por el modelo de la placa. Todo el firmware ocupa 196 KB de RAM y 1.3 MB de flash, y tiene licencia MIT.

Lo bueno de separar a la IA de la regla, y lo que hay que cuidar

La idea resuelve uno de los problemas de poner un modelo de lenguaje a controlar cosas físicas: la IA es lenta, cuesta dinero en cada consulta y a veces se equivoca, pero aquí solo interviene una vez. Lo que se queda funcionando es una regla sencilla y predecible, que no depende de que haya internet ni de que el modelo esté de buenas. Es el mismo enfoque que siguen muchas empresas con los agentes de IA: dejar que el modelo traduzca lo que quieres, y que lo ejecute algo más simple y revisable.

Pero es un proyecto experimental, y conviene tratarlo así. Según su documentación, el control por NATS no pide contraseña, y el portal web, desde el que se pueden cambiar la configuración y las instrucciones de la IA, tampoco menciona ninguna: cualquiera que esté en tu misma red podría usarlos. La placa guarda además la clave de tu WiFi, la del modelo de IA y el token de Telegram, así que vale la pena usar una clave de API con límite de gasto. Tampoco es un controlador de tiempo real, y la propia reseña de Electronics For You recomienda no usarlo para nada crítico: un relé con un ventilador de 5 V está bien; una cerradura, un calentador o un aparato conectado a la corriente, no. Y un último aviso: a mediados de octubre aparecieron copias del repositorio en cuentas ajenas al autor que ofrecían supuestas «versiones» para descargar, un truco que se usa para repartir malware. Ya no existen, pero el proyecto original nunca publicó versiones: se instala desde wireclaw.io o compilando su código.

Con todo, WireClaw es un buen ejemplo de hacia dónde va la electrónica casera: menos código escrito a mano y más instrucciones en lenguaje normal, con la IA como traductora y no como piloto. Para aprender, para un prototipo o para recibir en Telegram la temperatura de tu cuarto, es difícil encontrar una forma más barata de probarlo.

Más fuentes: Electronics For You; Adafruit; documentación de configuración de WireClaw. Esquema: decodigo.com. Foto de portada: Ubahnverleih (CC0, Wikimedia Commons).

Fuente: WireClaw, repositorio oficial en GitHub