
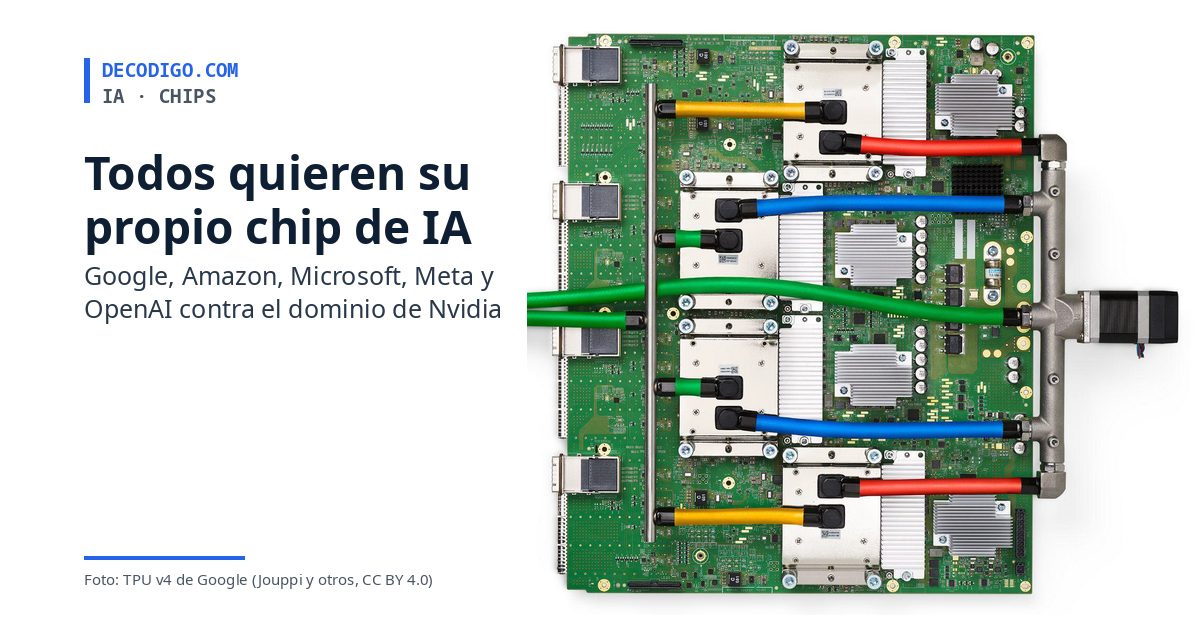
OpenAI ya está instalando en sus centros de datos Jalapeño, el primer chip de IA que ha diseñado ella misma. No es un caso aislado: Google, Amazon, Microsoft, Meta y Tesla tienen chip propio o lo están preparando, y una generación de startups compite por el mismo mercado. Todos persiguen lo mismo: depender menos de Nvidia y abaratar la tarea que más crece, que es responder a millones de usuarios. Este es el mapa de quién fabrica qué en octubre de 2026 y hacia dónde va la tecnología.
La idea no es nueva. Google empezó a usar internamente su primera TPU (Tensor Processing Unit) en 2015, cuando calculó que, si cada usuario hablaba con su buscador por voz unos minutos al día, tendría que duplicar sus centros de datos. Durante años fue la excepción: el resto del sector compraba GPU de Nvidia, que con su software CUDA se convirtió en el estándar para entrenar y ejecutar modelos. El auge de la IA generativa cambió las cuentas. Las GPU más potentes escasean, cuestan decenas de miles de dólares y Nvidia gana alrededor de un 75 % de margen en ellas. Para una empresa que gasta miles de millones al año en cómputo, diseñar un chip a medida empieza a salir a cuenta.
Un chip a medida, o ASIC, sacrifica flexibilidad a cambio de eficiencia: hace menos cosas que una GPU, pero las que hace las hace con menos energía y menos coste. Casi ninguna de estas empresas fabrica nada: diseñan el chip, a menudo con ayuda de Broadcom, y lo produce TSMC en Taiwán.
Claves del mapa de los chips de IA
- OpenAI, Jalapeño: presentado en junio con Broadcom, es solo para inferencia y para uso interno. Según los datos que dio en la conferencia Hot Chips de agosto, tiene 216 GB de memoria HBM4 con hasta 15.4 TB/s, consume 700 W y se agrupa en racks de 128 chips. OpenAI asegura que rinde entre 1.5 y 1.9 veces más por vatio que los sistemas GB200 y GB300 de Nvidia, y que lo llevó a fabricación en nueve meses con ayuda de sus propios modelos. Ya se instala junto a procesadores AMD EPYC. Forma parte de un acuerdo con Broadcom para desplegar 10 GW de chips propios hasta 2029.
- Google, TPU de octava generación: en abril dividió la familia en dos: la TPU 8t, para entrenar, que se agrupa en «superpods» de 9,600 chips con 121 exaflops, y la TPU 8i, para inferencia, con 288 GB de HBM y 384 MB de memoria dentro del chip. Es la única gran alternativa a Nvidia que se puede alquilar en la nube a gran escala; Anthropic es uno de sus grandes clientes.
- Amazon, Trainium3: su primer chip de 3 nanómetros, disponible desde diciembre de 2025, se monta en servidores de 144 chips. Anthropic entrena a Claude con más de un millón de chips Trainium2, y AWS ya prepara Trainium4, compatible con la tecnología de conexión de Nvidia.
- Microsoft, Maia 200: presentado en enero, fabricado a 3 nanómetros, con 216 GB de HBM3e, más de 10 petaflops en FP4 y 750 W. Es para inferencia en Azure y no se alquila directamente.
- Meta, MTIA: en marzo anunció cuatro generaciones en dos años, del MTIA 300 al 500, basadas en la arquitectura abierta RISC-V y desarrolladas con Broadcom. Empezaron con las recomendaciones de Facebook e Instagram y ahora se extienden a la IA generativa. Aun así, Meta sigue comprando GPU en masa, como muestra su superordenador Prometheus.
- Tesla, AI5 y AI6: en 2025 abandonó Dojo, su superordenador de entrenamiento, para centrarse en dos chips para coches, robots y centros de datos: el AI5, que fabricará TSMC, y el AI6, de Samsung.
- Las startups: Cerebras, que fabrica chips del tamaño de una oblea entera, salió a bolsa en mayo recaudando unos $5,550 millones de USD. Nvidia pagó en diciembre de 2025 unos $20,000 millones de USD, según la prensa, por licenciar la tecnología de Groq y contratar a su fundador, Jonathan Ross, que había trabajado en la primera TPU. Etched apuesta por un chip que solo ejecuta modelos transformer.
- China: sin acceso a los chips más potentes de Nvidia por los controles de exportación, su gran alternativa es Huawei. Su Ascend 950PR, de marzo, es para inferencia y usa memoria HBM de diseño propio. Según la consultora TrendForce, la última generación de DeepSeek ya se apoya en él.
Enfrente, Nvidia no se queda quieta. Su nueva generación, Vera Rubin, con 288 GB de HBM4 por GPU, empieza a llegar a las nubes este otoño, y la empresa está invirtiendo en todo el ecosistema, como hizo hace dos semanas en Europa. AMD, la otra gran alternativa comercial, responde con el MI455X y sus 432 GB de HBM4, y OpenAI firmó con ella un acuerdo de 6 GW en 2025.
El estado del arte: lo que tienen en común
Aunque cada empresa sigue su camino, los chips de 2026 comparten varias tendencias:
- Primero, la inferencia. Entrenar un modelo sigue siendo terreno de Nvidia. Pero responder a cientos de millones de usuarios, cada día, es ya el gasto que más crece, y ahí un chip especializado ahorra más. Por eso Jalapeño, Maia, la TPU 8i y casi todas las startups se centran en la inferencia.
- La memoria manda. Al generar texto, el chip pasa más tiempo esperando datos que calculando. De ahí las cifras de memoria cada vez mayores y los diseños que acercan la memoria al cálculo: Jalapeño divide el chip en 64 porciones, cada una con su propia memoria; la TPU 8i triplica la memoria dentro del chip; Cerebras usa una oblea entera.
- Números más pequeños. Los nuevos chips trabajan con números de 8 y hasta 4 bits (FP8, FP4) en lugar de 16 o 32. Se pierde algo de precisión, que en inferencia apenas se nota, y a cambio el rendimiento se multiplica.
- Se compite por sistemas, no por chips. Ya no se compara un chip con otro, sino racks y grupos de miles de chips, con su red de conexión, su refrigeración líquida y su consumo. Google conecta 9,600 TPU en un solo superpod y Jalapeño escala hasta 2,048 chips.
- La IA diseña chips. OpenAI usó sus modelos para llevar Jalapeño a fabricación en nueve meses, cuando un chip de este tipo suele tardar dos o tres años.
Lo que se juega Nvidia
Ninguna de estas empresas va a dejar de comprar GPU de Nvidia a corto plazo: siguen siendo las más versátiles, y su software CUDA es el que conocen casi todos los ingenieros. Lo que cambia es la relación de fuerzas. Con un chip propio para la parte más repetitiva del trabajo, cada gran cliente puede negociar mejor, garantizarse el suministro y reservar las GPU para lo que solo ellas hacen bien. Para Nvidia, el riesgo no es perder clientes de golpe, sino que sus mayores compradores se queden con la parte que más crece.
Los ganadores silenciosos son las empresas que hacen posibles esos chips: Broadcom, que diseña o fabrica los de Google, Meta y OpenAI, y TSMC, que produce casi todos, incluidos los de Nvidia. Y hay una pregunta abierta: cuánto de lo que prometen estos chips se confirmará fuera de las pruebas de sus propios fabricantes. Casi todas las cifras de rendimiento publicadas hasta ahora son de las empresas que los venden o los usan.
Más fuentes: Tom’s Hardware, Jalapeño en Hot Chips 2026; Tom’s Hardware, Jalapeño con AMD EPYC (2 de octubre); TechCrunch, Trainium3; Network World, Maia 200; ServeTheHome, MTIA en Hot Chips 2026; TechSpot, Nvidia y Groq; TechCrunch, salida a bolsa de Cerebras; TrendForce, Ascend 950PR; TechCrunch, el fin de Dojo. Foto: placa TPU v4 de Google (Norman P. Jouppi y otros, Wikimedia Commons, CC BY 4.0).