Qué lenguaje elegir cuando la IA escribe el código

Código de colores en un monitor, con el título del artículo sobre qué lenguaje elegir cuando la IA escribe el código

Durante décadas, elegir un lenguaje de programación era, en buena parte, elegir cuánto ibas a teclear. Python ganaba porque se escribía rápido; Rust o C++ asustaban porque había que pelearse con el compilador. Con asistentes y agentes de IA que generan cientos de líneas en segundos, escribir código ha dejado de ser el cuello de botella, y los criterios para elegir lenguaje cambian. Esta guía repasa cuáles pesan ahora y qué lenguaje conviene en cada caso.

Lo que no se ha abaratado es todo lo demás: entender el problema, comprobar que el código hace lo que debe, mantenerlo años y pagar las máquinas donde se ejecuta. Ya lo contamos en qué cambia en el oficio cuando escribir código deja de ser el centro. Visto desde ahí, la pregunta ya no es en qué lenguaje se escribe más rápido, sino en cuál es más fácil saber que el código generado está bien y en cuál sale más barato tenerlo funcionando.

Los criterios que cambian

1. Que el lenguaje detecte los errores antes de ejecutar. Un modelo de lenguaje no comprende el programa como un compilador: predice texto. Por eso se equivoca en lo que el compilador comprueba mejor. En un estudio presentado en PLDI 2025, investigadores de la ETH de Zúrich y de Berkeley midieron que, de media, el 94 % de los errores de compilación del código generado por modelos de IA eran fallos de tipos: pasar un dato del tipo equivocado, llamar a un método que no existe, olvidar un caso. Cassidy Williams, de GitHub, usó ese dato para explicar por qué la IA está empujando a los desarrolladores hacia los lenguajes con tipos. En un lenguaje con tipos estrictos, esos errores aparecen en segundos y el agente los corrige solo; en uno sin tipos, llegan a las pruebas, a la revisión o directamente a producción.

Dónde aparece un error del código generadoLa IA escribeel cambioCompiladortipos: segundosPruebasminutosRevisiónhumana: horasProducciónel peor sitioel agente corrige y repiteTipado estrictoRust, Go, Java, C#, TypeScript en modo strictmuchos errores se paran en el compiladorTipado opcionalPython con anotaciones y mypy o Pyrightsolo si se activa el comprobadorSin tiposJavaScript o Python sin anotacionesel error llega a las pruebas o a producción
Cuanto antes aparece un error del código generado, más barato es arreglarlo. Con tipos estrictos, el agente puede compilar, leer el error y corregirlo sin intervención humana. Esquema: decodigo.com.

2. Que la máquina trabaje menos. Antes se aceptaba un lenguaje lento a cambio de programar más rápido. Si la IA escribe tanto el código sencillo como el farragoso, esa compensación pierde fuerza: el coste de escribir un servicio en Go o en Rust en lugar de en Python baja mucho, y el ahorro en servidores, memoria y energía sigue ahí cada mes. El estudio más citado sobre energía, de Rui Pereira y otros investigadores portugueses, resolvió los mismos problemas en 27 lenguajes. C, Rust y C++ consumieron lo mínimo, Java y Go, entre dos y tres veces más, y Python, unas 76 veces más.

Energía para resolver los mismos problemas (C = 1)Escala logarítmica: cada línea vertical es diez veces más energía×1×10×100C1,00Rust1,03C++1,34Java1,98C#3,14Go3,23JavaScript4,45TypeScript21,50PHP29,30Ruby69,91Python75,88
Energía media de cada lenguaje en las pruebas de Pereira y otros (Science of Computer Programming, 2021), tomando C como 1. El mal resultado de TypeScript frente a JavaScript, que acaba ejecutándose en el mismo motor, solo se explica porque los programas de prueba de uno y otro eran distintos: un estudio de 2024 de Emery Berger y su equipo muestra que, si se comparan bien, la energía depende sobre todo del tiempo de ejecución y de cómo está escrito cada programa. Esquema: decodigo.com.

Hay que leer esa gráfica con cuidado. Un estudio posterior del equipo de Emery Berger, de la Universidad de Massachusetts, revisó la metodología y concluyó que el lenguaje no gasta energía por sí mismo: gasta la que corresponde al tiempo que tarda el programa. Pero eso no cambia la conclusión práctica: un programa que tarda menos consume menos, y los lenguajes compilados a código nativo, o con un buen compilador JIT como Java y C#, siguen siendo mucho más rápidos que los interpretados para el mismo trabajo.

3. Que el ecosistema ya tenga resuelto el problema. Una biblioteca madura, probada por millones de usuarios, vale más que mil líneas generadas desde cero, por bien que estén. Y un ecosistema grande también significa que los modelos lo conocen mejor: han visto muchísimo código en Python, TypeScript, Java o Go, y mucho menos en lenguajes minoritarios o en bibliotecas que cambian de una versión a otra. Eso sí, cada dependencia es una puerta: el intento de ataque a Zod de septiembre, que contamos hoy, recuerda que un ecosistema enorme es también un objetivo enorme.

4. Que el código se pueda revisar. Si una persona va a leer código que no ha escrito, ayuda que el lenguaje tenga pocas formas de hacer lo mismo, un formato único y un estilo predecible. Go está diseñado justo para eso. En el otro extremo, los lenguajes que permiten cualquier truco y crear lenguajes propios dentro del lenguaje producen código generado más difícil de auditar.

Qué lenguaje para cada caso

Para construir…Primera opciónAlternativasPor qué
Aplicaciones web completasTypeScript (modo strict)Go o C# en el servidorUn solo lenguaje en el navegador y en el servidor, el ecosistema más grande y tipos que frenan los errores del modelo.
Datos, aprendizaje automático y prototipos con IAPython con anotaciones de tiposJulia para cálculo numéricoLas bibliotecas que importan están en Python: PyTorch, pandas y los SDK de los modelos. Lo pesado se ejecuta en C, C++ o Rust por debajo.
APIs, microservicios y herramientas de línea de órdenesGoRust, Java, C#Compila en segundos, genera un único binario, consume poca memoria y su código es muy uniforme: fácil de generar y de revisar.
Sistemas, rendimiento extremo y seguridad de memoriaRustC++ en bases de código existentes, ZigEl compilador es el revisor más exigente: si compila, se descartan clases enteras de errores de memoria y de concurrencia. Ideal para agentes que iteran contra él.
Sistemas de empresa grandes y de larga vidaJava o KotlinC# y .NETTipos, herramientas de análisis y refactorización muy maduras, y décadas de bibliotecas. Las versiones modernas son mucho menos verbosas, y lo verboso ya lo escribe la IA.
Aplicaciones móvilesKotlin (Android) y Swift (iOS)Dart con Flutter, o React Native con TypeScriptLos lenguajes nativos acceden antes a lo nuevo de cada plataforma; las opciones multiplataforma reducen el trabajo a una sola base de código.
Electrónica y sistemas embebidosCRust embebido, MicroPython para prototiposC sigue estando en todos los fabricantes y herramientas; Rust gana terreno donde la seguridad importa.
Scripts y automatizaciónPythonBash para lo muy corto, Go si debe ser rápidoEstá instalado casi en cualquier sistema y tiene biblioteca para todo.
Nota: los frameworks maduros de cada lenguaje. Con IA, apoyarse en un framework consolidado vale todavía más que antes. Resuelve de serie la seguridad, el acceso a datos y la configuración, impone una estructura que el modelo conoce de sobra porque la ha visto en miles de proyectos y reduce la cantidad de código propio que hay que revisar. Además, recibe parches de seguridad sin que tengas que escribirlos tú. Estos son los más asentados en cada lenguaje.
LenguajeWeb y serviciosDatos, pruebas y otras piezas
TypeScriptReact y Next.js, Angular, Vue y Nuxt en la interfaz; NestJS, Express y Fastify en el servidorPrisma y Drizzle para bases de datos, Zod para validar datos, Vitest y Playwright para pruebas
PythonDjango, FastAPI y FlaskNumPy, pandas, scikit-learn y PyTorch para datos e IA; SQLAlchemy, Pydantic y pytest
GoLa biblioteca estándar net/http basta en muchos casos; Gin, Echo y Chi por encima; gRPC para servicios internosCobra para herramientas de línea de órdenes; database/sql con sqlc o GORM
RustAxum y Actix Web, sobre el motor asíncrono TokioSerde para serializar, SQLx y Diesel para bases de datos, Clap para línea de órdenes
Java y KotlinSpring Boot, Quarkus y Micronaut; Ktor en KotlinHibernate y JPA para persistencia, JUnit para pruebas
C#ASP.NET Core, con Blazor para la interfaz webEntity Framework Core para datos, xUnit para pruebas
MóvilJetpack Compose (Kotlin) y SwiftUI (Swift)Flutter (Dart) y React Native (TypeScript) para varias plataformas a la vez
EmbebidosFreeRTOS y Zephyr como sistemas operativos de tiempo real; ESP-IDF para los chips ESP32Embassy para programar microcontroladores en Rust
Python no pierde, cambia de papel. Según el informe Octoverse 2025 de GitHub, Python está en casi la mitad de los repositorios nuevos de IA, y más de 1,1 millones de repositorios públicos ya importan el SDK de algún modelo de lenguaje. Lo que cambia es dónde se usa: como lenguaje para explorar, entrenar y unir piezas, y no tanto para el servicio que atiende miles de peticiones por segundo. Si se escribe Python con IA, conviene añadir anotaciones de tipos y pasar un comprobador como mypy o Pyright, para recuperar parte de la red de seguridad.

Lo que ya se nota en GitHub

En agosto de 2025, TypeScript se convirtió en el lenguaje más usado en GitHub por número de contribuidores: más de 2,6 millones al mes, un 66 % más que un año antes, por delante de Python y de JavaScript. GitHub lo calificó como el mayor cambio de lenguaje en más de una década, y lo atribuyó en parte a la IA: los tipos funcionan como un contrato que entienden por igual las personas, los frameworks y los modelos, y que permite detectar los errores del modelo antes de que lleguen a producción. Ayuda también que frameworks como Next.js, Astro o SvelteKit creen ya los proyectos en TypeScript por defecto.

Es la misma tendencia que se ve con Rust en los componentes críticos de sistemas operativos y navegadores, o con la llegada de tipos a lenguajes que nacieron sin ellos, como Python o PHP. Cuando una parte creciente del código la escribe una máquina, el compilador deja de verse como un obstáculo y pasa a ser la primera línea de revisión, y la más barata.

Cómo elegir, en cinco preguntas

  1. ¿Qué tiene ya resuelto el ecosistema? Si el problema depende de una biblioteca concreta, como PyTorch, un SDK de pagos o un framework de interfaz, esa biblioteca decide el lenguaje casi siempre.
  2. ¿Cuántas veces se va a ejecutar? Un script que se ejecuta una vez al mes puede estar en cualquier lenguaje. Un servicio que atiende millones de peticiones merece un lenguaje compilado: lo que antes costaba escribirlo ahora lo escribe la IA.
  3. ¿Quién va a revisar el código? Si hay poca revisión humana, se necesita más ayuda del compilador: tipos estrictos y advertencias activadas como errores.
  4. ¿Cuánto tiempo va a vivir? Para un sistema que se mantendrá diez años, conviene un lenguaje estable, con herramientas de refactorización y gente que lo conozca. Un lenguaje de moda o que cambia mucho entre versiones es un riesgo, y además los modelos lo conocen peor.
  5. ¿Sabe alguien del equipo leerlo? La IA no elimina la necesidad de entender lo que se despliega. Elegir un lenguaje que nadie del equipo domina porque «lo escribe la IA» es dejar el sistema sin nadie que pueda responder por él.

Conclusión

La IA no ha hecho que dé igual el lenguaje: ha cambiado lo que importa al elegirlo. Pesa menos lo cómodo que es escribirlo y más cuánto ayuda a verificar lo que otro, humano o máquina, ha escrito, cuánto cuesta ejecutarlo y cuánto trabajo ahorra su ecosistema. Por eso ganan terreno los lenguajes con tipos estrictos y buenas herramientas, como TypeScript, Go, Rust, Java, Kotlin o C#, y Python se consolida donde su ecosistema no tiene rival. Si quieres empezar por alguno, en decodigo.com tienes cursos de Python, Go, Rust y Java, y diez consejos para aprender a programar cuando la IA ya escribe el código.

Datos: GitHub Octoverse 2025; Cassidy Williams, «Why AI is pushing developers toward typed languages» (GitHub Blog, 2026); Mündler y otros, «Type-Constrained Code Generation with Language Models» (PLDI 2025); Pereira y otros, «Ranking programming languages by energy efficiency» (2021); van Kempen y otros, «It’s Not Easy Being Green» (2024). Portada: código en un monitor, foto de Markus Spiske, Wikimedia Commons, CC0 (recortada y teñida).
Cómo funcionaba el software que alunizó: el sistema operativo del Apolo, explicado con su código fuente

El rostro de Margaret Hamilton, desenfocado, al fondo de la portada, junto al título «Cómo funcionaba el software que alunizó» y una DSKY dibujada con el código 1202

Del software del Apolo se repiten siempre las mismas dos frases: que cabía en menos memoria que una foto del móvil y que una alarma estuvo a punto de abortar el alunizaje. Las dos son ciertas y ninguna explica nada. Lo interesante es cómo estaba hecho por dentro, y lo bueno es que se puede mirar: el código fuente de la misión está publicado, línea a línea, con los comentarios que escribieron sus autores en 1969.

La máquina con la que había que apañarse

El ordenador de guiado del Apolo —el AGC— no era pequeño para la época: era pequeño a secas.

El AGCPara comparar
Memoria de trabajo2.048 palabras de núcleos de ferritaunos 4 KB
Programa36.864 palabras de memoria fijaunos 72 KB, y no se podía cambiar
Palabra15 bits más uno de paridadhoy, 64
Reloj2,048 MHzunas mil veces menos que un móvil
Peso y consumo32 kg y 55 Wuna bombilla

Y el programa no estaba grabado: estaba tejido. Cada uno y cada cero era un cable que pasaba por dentro o por fuera de un anillo de ferrita, a mano, y la memoria entera llevaba semanas de telar. Una vez tejida no se podía corregir ni una coma. Eso cambia por completo lo que significa «equivocarse».

Y el programa no podía pararse nunca. A la vez, y sin descanso, tenía que hacer todo esto: leer los acelerómetros, ir sumando esas lecturas para saber dónde estaba la nave, mover los motores que orientan la plataforma de navegación, atender al radar, llevar la cuenta del tiempo, refrescar los números de la pantalla y, por si fuera poco, hacer caso a un astronauta que teclea. Todo eso, con un solo procesador. No había un segundo núcleo al que mandarle la mitad.

La respuesta a ese problema es lo que hoy llamaríamos un sistema operativo de tiempo real, y es la aportación de fondo del equipo que dirigía Margaret Hamilton. Tiene cuatro ideas, y las cuatro se siguen usando.

Idea 1: una cola con prioridades, no una lista de tareas

Lo intuitivo, y lo que hacía casi todo el mundo entonces, es un ciclo mayor: haz A, luego B, luego C, vuelve a empezar. Funciona mientras todo dure lo previsto. El problema es que nada dura lo previsto, y cuando A se alarga, C llega tarde aunque C sea lo único que de verdad importa.

El Executive del AGC no hace eso. Cada unidad de trabajo —un job— se registra con un número de prioridad, y el sistema ejecuta siempre el de prioridad más alta que esté listo. Si mientras corre uno aparece otro más urgente, el primero se suspende a medias y se retoma después.

EXECUTIVE.agc, Luminary 1A (Apolo 11)# TO ENTER A JOB REQUEST REQUIRING NO VAC AREA:

NOVAC		INHINT
		AD	FAKEPRET	# LOC(MPAC +6) - LOC(QPRET)
		TS	NEWPRIO		# PRIORITY OF NEW JOB + NOVAC C(FIXLOC)

Y esta es la decisión de «¿me cambio de trabajo o sigo con este?», tal cual está escrita:

EXECUTIVE.agc		INDEX	NEWJOB		# THIS INDEX INSTRUCTION INSURES THAT THE
		CS	PRIORITY	# HIGHEST ACTIVE PRIORITY WILL BE COMPARED
		AD	NEWPRIO		# WITH THE NEW PRIORITY TO SEE IF NEWJOB
		EXTEND			# SHOULD BE SET TO SIGNAL A SWITCH.
		BZMF	ENDFIND

Si no has visto nunca ensamblador del AGC, no te pelees con las siglas: lo que hacen esas cinco líneas es una resta. Coge la prioridad del trabajo que está corriendo, le resta la del recién llegado y mira el signo. Si sale negativo, el nuevo manda y hay cambio; si no, el de ahora sigue. Eso es todo el «planificador»: una resta y un salto según el signo.

Las mayúsculas de los comentarios no las hemos puesto nosotros: el AGC se programaba con un juego de caracteres que no tenía minúsculas. Todos los listados de esta página están copiados tal cual del fuente de la misión, erratas incluidas: unas líneas más abajo, en ese mismo archivo, pone REQUIREING.

Ocho bandejas y cinco cuadernos

Si vas a interrumpir un trabajo a medias y retomarlo luego, tienes que apuntar en algún sitio por dónde iba: sus cuentas a medio hacer, en qué línea estaba, con qué trozo de memoria trabajaba. Piensa en una mesa con varias bandejas: cada trabajo que se aparta deja su papeleo en una bandeja y la mesa queda libre para el siguiente. Esa bandeja es lo que ellos llamaban core set.

Y aquí está el problema: cada bandeja ocupa memoria, y había 2.048 palabras en total para todo. Así que las bandejas se contaron y se repartieron de antemano, una por una:

ERASABLE_ASSIGNMENTS.agc# DYNAMICALLY ALLOCATED CORE SETS FOR JOBS	(84D)

MPAC		ERASE	+6		# MULTI-PURPOSE ACCUMULATOR.
MODE		ERASE			# +1 FOR TP, +0 FOR DP, OR -1 FOR VECTOR.
LOC		ERASE			# LOCATION ASSOCIATED WITH JOB.
BANKSET		ERASE			# USUALLY CONTAINS BBANK SETTING.
PUSHLOC		ERASE			# WORD OF PACKED INTERPRETIVE PARAMETERS.
PRIORITY	ERASE			# PRIORITY OF PRESENT JOB AND WORK AREA.

		ERASE	+83D		# EIGHT SETS OF 12 REGISTERS EACH

Ocho. Ocho bandejas. Ocho trabajos como mucho a la vez en toda la nave, y ni uno más.

Hay un segundo cupo. Los trabajos que hacen cuentas con vectores necesitan además un cuaderno de borrador bastante más grande, 43 palabras, para ir dejando los resultados intermedios. A ese cuaderno lo llamaban área VAC, y de esos había cinco. De ahí que en el fuente haya dos puertas de entrada distintas: NOVAC para el trabajo que no necesita cuaderno y FINDVAC para el que sí.

ERASABLE_ASSIGNMENTS.agc# VAC AREAS. -- BE CAREFUL OF PLACEMENT --	(220D)

VAC1USE		ERASE
VAC1		ERASE	+42D
VAC2USE		ERASE
VAC2		ERASE	+42D

¿Y si alguien pide bandeja o cuaderno y no queda ninguno libre? Pues pasa lo que todo el mundo ha oído contar mil veces sin saber qué era. Las dos alarmas famosas del alunizaje son literalmente eso: «no me quedan cuadernos» y «no me quedan bandejas». Están escritas ahí, en el mismo archivo, una debajo de la otra:

EXECUTIVE.agc — la alarma 1201		CCS	VAC5USE
		TCF	VACFOUND
		LXCH	EXECTEM1
		CA	Q
		TC	BAILOUT1
		OCT	1201		# NO VAC AREAS.
EXECUTIVE.agc — la alarma 1202NEXTCORE	CAF	COREINC
		ADS	LOCCTR
		CCS	EXECTEM2
		TCF	NOVAC3
		LXCH	EXECTEM1
		CA	Q
		TC	BAILOUT1	# NO CORE SETS AVAILABLE.
		OCT	1202
Esto conviene leerlo despacio. El 1202 no es un fallo del programa ni un error de nadie: es el mensaje que el sistema emite a propósito cuando pide una bandeja y no queda ninguna. Es una condición prevista, con su código, su rutina y su documentación. La diferencia entre un sistema que se cuelga y uno que avisa está, casi siempre, en si alguien se molestó en escribir estas seis líneas.

Idea 2: las tareas con reloj

El Executive responde a «esto es importante». Falta quien responda a «esto es a tal hora», que no es lo mismo: leer el acelerómetro dentro de 10 milisegundos, apagar el motor dentro de 4 segundos. De eso se encarga el segundo planificador, el Waitlist, y lo que gestiona no se llama trabajo sino tarea: un encargo corto que entra, hace lo suyo y sale sin que nadie lo interrumpa.

WAITLIST.agc# FUNCTIONAL DESCRIPTION --
#	PART OF A SECTION OF PROGRAMS -- WAITLIST, TASKOVER, T3RUPT, USED TO CALL A PROGRAM (CALLED A TASK),
#	WHICH IS TO BEGIN IN C(A) CENTISECONDS.
#
# WARNINGS --
#	1)	1 <= C(A) <= 16250D (1 CENTISECOND TO 162.5 SEC)
#	2)	9 TASKS MAXIMUM
#	3)	TASKS CALLED UNDER INTERRUPT INHIBITED
#	4)	TASKS END BY TC TASKOVER

Nueve tareas, hasta 162,5 segundos de plazo, resolución de una centésima de segundo. La división es la misma que hoy: tareas cortas y puntuales que no pueden interrumpirse, y trabajos largos que sí. Una tarea que necesita hacer algo lento no lo hace: encola un trabajo y se va.

Idea 3: reiniciar sin perder nada

Aquí está, seguramente, lo más elegante del diseño. Un ordenador de 1969 hecho de núcleos de ferrita y transistores sueltos, metido en una nave llena de vibraciones y radiación, se iba a reiniciar tarde o temprano. Hacer como si eso no fuera a pasar no era una opción; impedirlo, tampoco. Así que lo convirtieron en algo normal.

El truco son los puntos de control: la misma idea que guardar la partida en un videojuego. A lo largo de cada operación delicada, el programa va dejando constancia de por dónde va con una llamada a PHASCHNG:

PHASE_TABLE_MAINTENANCE.agc# PHASCHNG IS THE MAIN WAY OF MAKING PHASE CHANGES FOR RESTARTS.  THERE ARE THREE FORMS OF PHASCHNG, KNOWN AS TYPE
# A, TYPE B, AND TYPE C.  THEY ARE ALL CALLED AS FOLLOWS, WHERE OCT XXXXX CONTAINS THE PHASE INFORMATION,
#		TC	PHASCHNG
#		OCT	XXXXX

Y el código se escribe de manera que volver al último punto anunciado sea inofensivo. Don Eyles, que programó el descenso, lo resume en tres líneas:

el patrónNEW_X = X + 1
    registrar el punto de control
X = NEW_X

Parece una tontería y no lo es. Primero se calcula el valor nuevo aparte, sin tocar el bueno; luego se marca el punto de control; y solo entonces se guarda. Mira los dos casos posibles: si el ordenador se reinicia antes de la marca, al volver repite el cálculo y listo, porque no había llegado a cambiar nada. Si se reinicia después, el valor ya está guardado y tampoco hay que hacer nada. No existe ningún instante intermedio en el que el corte te deje las cosas a medio hacer.

Si esto te suena, es porque lo usas sin pensarlo: es exactamente lo que hay detrás de una transacción de base de datos, de un commit y de que una API se pueda reintentar sin duplicar nada. Lo escribieron veinte años antes de que a nadie le hiciera falta ponerle esos nombres.

Al arrancar de nuevo, la rutina RESTARTS recorre la tabla de fases y vuelve a poner en marcha cada cosa que estaba pendiente, desde su último punto de control. El programa en curso sigue, la pantalla se repinta y el astronauta ve, como mucho, un parpadeo.

Hay un registro en la memoria que se llama REDOCTR y cuyo comentario en el fuente dice CONTAINS NUMBER OF RESTARTS: un contador de reinicios. No era una excepción, era una estadística.

Idea 4: una máquina virtual, para que el código cupiera

El guiado es matemática de vectores: productos escalares, productos vectoriales, matrices de rotación, raíces, todo en doble precisión. Escribir eso en el ensamblador del AGC —que trabaja con palabras de 15 bits y tiene una aritmética mínima— ocupa una barbaridad de memoria.

Así que hicieron algo que suena a herejía y es de puro sentido común: se inventaron un segundo idioma. Un idioma en el que «multiplica estos dos vectores» se dice con una sola palabra, en vez de con las decenas de instrucciones que hacen falta en el idioma de la máquina. Y escribieron un programa, el intérprete, que lee ese idioma y lo va traduciendo sobre la marcha.

Es, literalmente, una máquina virtual metida dentro del AGC, con su propio juego de instrucciones. Lo mismo que hace Java con su bytecode, pero en 1969 y por un motivo muy concreto: que el programa cupiera.

INTERPRETER.agc — la tabla de saltoINDJUMP		TCF	VLOAD		# 00 -- LOAD MPAC WITH A VECTOR.
		TCF	TAD		# 01 -- TRIPLE PRECISION ADD TO MPAC.
		TCF	SIGN		# 02 -- COMPLEMENT MPAC (V OR SC) IF X NEG.
		TCF	VXSC		# 03 -- VECTOR TIMES SCALAR.
		...
		TCF	VAD		# 24 -- VECTOR ADD.
		TCF	VSU		# 25 -- VECTOR SUBTRACT.
		TCF	BVSU		# 26 -- VECTOR SUBTRACT FROM.
		TCF	DOT		# 27 -- VECTOR DOT PRODUCT.
		TCF	VXV		# 30 -- VECTOR CROSS PRODUCT.
		TCF	VPROJ		# 31 -- VECTOR PROJECTION.

Las tablas de salto del intérprete suman más de setenta operaciones: cargar un vector, multiplicarlo por un escalar, producto escalar, producto vectorial, matriz por vector, raíz cuadrada, seno, arcoseno, vector unitario. Un programa interpretado es entre cinco y diez veces más lento que el equivalente escrito a mano, y a cambio ocupa una fracción del espacio. Cuando tienes 36.864 palabras y una misión entera que meter dentro, ese cambio no se discute: se firma.

Las dos capas conviven en el mismo archivo y se distinguen a simple vista. Esto es un trozo del programa del alunizaje: las primeras líneas son instrucciones interpretadas, y EXIT es la que devuelve el control al ensamblador de la máquina.

THE_LUNAR_LANDING.agcP63SPOT2	VLOAD	UNIT		# INITIALIZE KALCMANU FOR BURN ATTITUDE
			R60VSAVE
		STOVL	POINTVSM
			UNITX
		STORE	SCAXIS
		EXIT

		CAF	EBANK7
		TS	EBANK

20 de julio de 1969: todo esto, a la vez

Con las cuatro piezas sobre la mesa, lo que pasó en el descenso se explica solo.

Empieza con un interruptor. El radar de encuentro —el que sirve para volver a acoplarse con el módulo de mando al final, no para alunizar— se había quedado en una posición que lo dejaba despierto. No estorbaba a nadie, en principio.

El detalle está en cómo le cuenta ese radar al ordenador hacia dónde apunta. Los dos aparatos se sincronizan con una señal eléctrica de 800 Hz, y el documento que describía esa conexión exigía que las dos señales tuvieran la misma frecuencia… pero no decía nada de que tuvieran que ir a compás. Era una línea que faltaba en el documento, y nadie la echó de menos hasta ese día.

Aquel día no iban a compás: estaban desfasadas casi un cuarto de onda. Y con ese desfase, la electrónica del radar se volvía loca midiendo: creía ver que la antena se movía todo el rato, y le mandaba al ordenador 6.400 avisos por segundo por cada uno de los dos ángulos, cuando la antena en realidad estaba quieta.

Aquí está la parte que hay que entender. Atender cada aviso no era «ejecutar un programa»: el hardware del AGC paraba el procesador un instante, le quitaba un ciclo para actualizar el contador, y lo devolvía. Nada en el software se enteraba. Simplemente, el ordenador iba más lento sin que nadie supiera por qué. Eyles lo mide:

«Moviéndose a su velocidad máxima, los contadores del radar de encuentro consumían aproximadamente el 15 % del tiempo de cálculo disponible. En su momento, siendo conservadores, supusimos que la pérdida de tiempo (que llamábamos TLOSS) era de un 13 %.»Don Eyles, Tales from the Lunar Module Guidance Computer (2004). Grumman midió después un máximo del 13,36 %.

Un 13 % no suena a catástrofe. Y no lo habría sido si el ordenador hubiera ido holgado, pero iba al límite. Aquí es donde se juntan las cuatro ideas.

El trabajo gordo del descenso se llama SERVICER: es el que lee los sensores, calcula dónde está la nave y decide qué hacer con el motor. Se lanza cada dos segundos y tiene que haber terminado antes de que le toque otra vez. Con el radar robando ciclos, dejó de llegar a tiempo.

Y el reloj no espera a nadie. Cada dos segundos encolaba un SERVICER nuevo, aunque el anterior siguiera a medias. Cada copia se llevaba su bandeja y su cuaderno. Dos copias, tres, cuatro… y las bandejas eran ocho.

1 · Descenso normalSERVICERP63pantallaradarlibrelibrelibrelibre4 de 8 bandejas ocupadasCuatro trabajos en la cola. SERVICER terminadentro de su ciclo de 2 segundos y liberasu bandeja antes de que llegue el siguiente.2 · El radar roba el 13 % del tiempoSERVICERSERVICERSERVICERSERVICERP63pantallaradarradar8 de 8 bandejas ocupadasALARMA 1202SERVICER ya no acaba a tiempo, pero el relojsigue encolando una copia nueva cada dossegundos. Las ocho bandejas se agotan.3 · Tras el reinicioSERVICERP63pantallalibrelibrelibrelibrelibre3 de 8 bandejas ocupadasEl reinicio revive solo la copia más recientede cada trabajo desde su último punto decontrol. La cola queda limpia y el descenso sigue.

Cuando se agotaron, el Executive hizo exactamente lo que estaba escrito que hiciera: BAILOUT1, código 1202, y reinicio. Hasta aquí es una historia de un ordenador que se satura. Lo que la convierte en otra cosa es lo que pasó al reiniciar.

El reinicio no solo recuperaba el estado: tiraba el atasco. Al revivir desde la tabla de fases, de cada trabajo duplicado solo se restauraba la copia más reciente. Las copias a medias de SERVICER que se habían ido amontonando desaparecían de golpe, y el ordenador se encontraba otra vez con la cola despejada y tiempo de sobra para lo importante: el guiado, los motores y la pantalla.

«Un sistema de protección ante reinicios motivado sobre todo por la posibilidad de fallos del hardware proporcionó, por sinergia, una manera de soltar carga de cálculo ante un atasco de software causado por el TLOSS.»Don Eyles, en el mismo texto

Dicho de otro modo: el ordenador se atragantó, escupió lo que le sobraba y siguió. Pero eso, desde Houston y con el módulo lunar bajando hacia la superficie, no se ve. Lo único que se ve es una luz de aviso encendida y un número en la pantalla.

Steve Bales y Jack Garman tenían que decidir, en cuestión de segundos, si aquel 1202 quería decir «me estoy muriendo» o «me he atragantado y ya lo he resuelto». Sabían que era lo segundo porque lo habían visto en los simuladores unas semanas antes. Garman dijo «go», y detrás fueron Bales, Kranz y Duke.

Durante el descenso saltaron cinco alarmas de esas: primero 1202, «no quedan bandejas», y más tarde 1201, «no quedan cuadernos». El alunizaje no se interrumpió ni una sola vez.

Lo que de aquello seguimos haciendo

En el AGCHoy se llama
Trabajos con prioridad que se expulsanplanificador apropiativo por prioridades
Soltar lo secundario al saturarsedegradación elegante, backpressure
Puntos de control antes de cada paso críticotransacciones, commit, idempotencia
Reiniciar como mecanismo normal de recuperacióncrash-only software, reinicio supervisado
Un intérprete para que el código ocupe menosuna máquina virtual, un bytecode
Un código numérico por cada condición previstacódigos de error y observabilidad

La lista no es una analogía forzada: son las mismas decisiones, tomadas por las mismas razones y casi siempre antes. Y hay una séptima que no cabe en la tabla, que es la que Hamilton defendió cuando le dijeron que los astronautas no se equivocan: que el programa tiene que hacerse cargo de lo que puede salir mal, incluida la persona que está al otro lado.

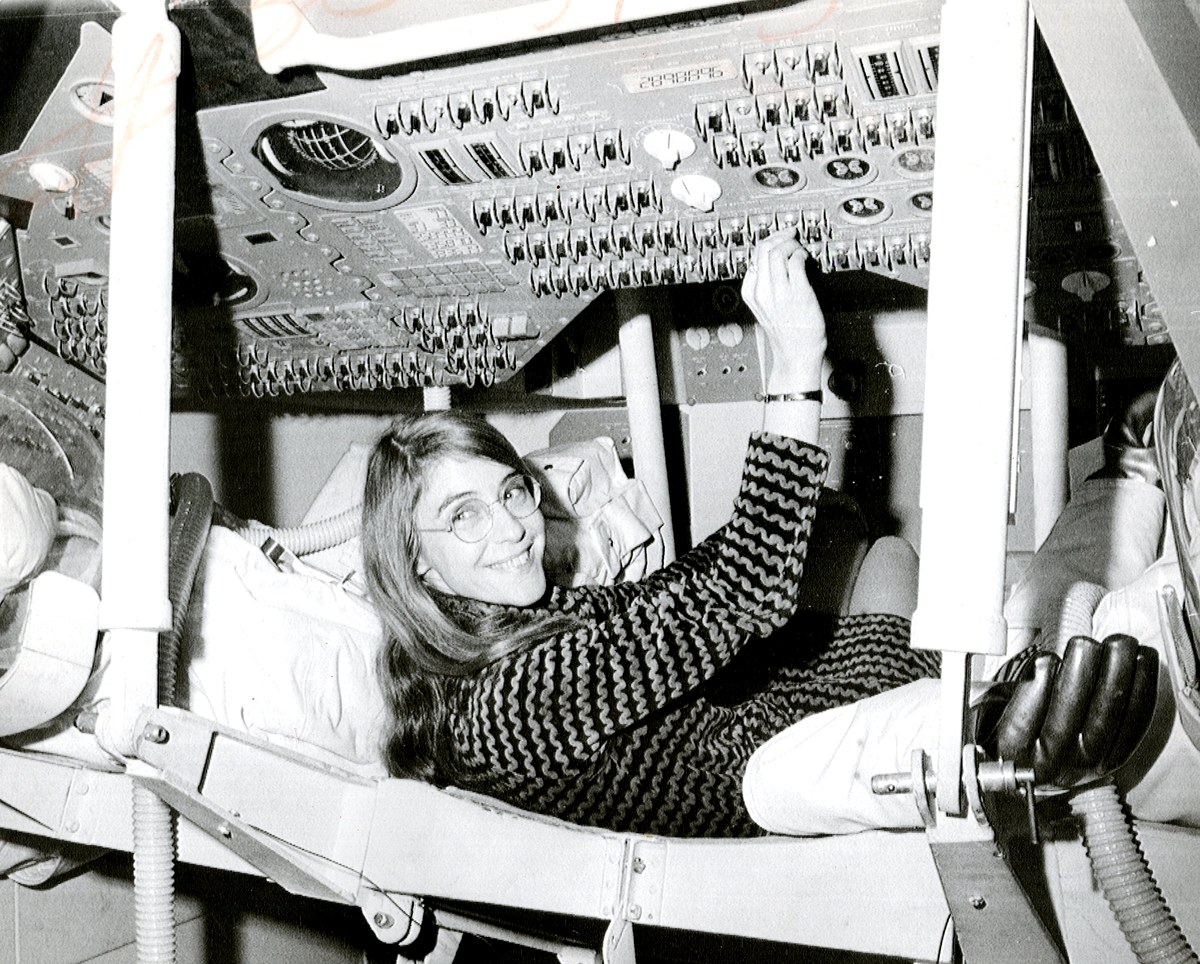
Margaret Hamilton sonriendo, tumbada en el asiento de la maqueta del módulo de mando del Apolo, con el brazo levantado hacia el panel de mandos lleno de interruptores
Margaret Hamilton en la maqueta del módulo de mando del Apolo, en noviembre de 1969. El panel que tiene encima es el otro extremo de todo lo que cuenta esta página: los interruptores y la DSKY por los que un astronauta hablaba con los ocho trabajos, las nueve tareas y los puntos de control. Foto de la NASA, en dominio público.

Dónde mirarlo tú mismo

Todo lo citado en esta página sale de archivos que puedes abrir ahora mismo.

QuéDónde
El fuente del Apolo 11, módulo lunar y de mandogithub.com/chrislgarry/Apollo-11
El proyecto que lo transcribió, con los escaneos originales y un emuladorVirtual AGC
El relato de quien programó el descenso«Tales from the Lunar Module Guidance Computer»
El ordenador por dentroApollo Guidance Computer

Si abres el repositorio, empieza por Luminary099/EXECUTIVE.agc: son quinientas líneas y es el corazón de todo lo que cuenta esta página. Y si quieres el momento exacto, THE_LUNAR_LANDING.agc, que son trescientas treinta y cinco.

Las cifras de esta página —ocho core sets de 12 registros, cinco áreas VAC de 43, nueve tareas, las operaciones del intérprete, los códigos 1201 y 1202— están comprobadas una a una en el fuente de Luminary 1A build 099, que es el que voló en el Apolo 11, y coinciden con lo que cuenta Don Eyles. Los listados están copiados literalmente, con sus comentarios y sus erratas. Sobre Margaret Hamilton y su equipo escribimos cuando murió, el 30 de septiembre de 2026.

Cómo se construye el pensamiento lógico para programar: lo que dice la investigación

Una escalera de cuatro peldaños —conocer, trazar, explicar, escribir— junto al título del artículo

«Es que yo no tengo cabeza para esto.» Lo dice mucha gente que empieza a programar y se atasca, y detrás hay una creencia muy extendida: que existe un tipo de mente lógica, que unos la tienen y otros no, y que sin ella no hay nada que hacer. Resulta que esa pregunta se ha estudiado bastante, y lo que ha salido no se parece casi nada a lo que se repite.

Primero: el «gen del programador» no existe, y quien lo propuso se retractó

En 2006 circuló un artículo con un título que hizo fortuna: The camel has two humps, «el camello tiene dos jorobas». Sostenía que los estudiantes de programación no se reparten en una campana de Gauss sino en dos grupos separados —los que lo pillan y los que no lo pillarán nunca— y que un test sencillo podía distinguirlos antes de empezar el curso. La idea se citó durante años.

En julio de 2014, su autor, Richard Bornat, publicó una retractación. No una matización: una retractación.

«Dehnadi no descubrió un test de aptitud para programar. No encontró una manera de separar a las ovejas programadoras de las cabras no programadoras. No habíamos demostrado que la naturaleza gane a la crianza.»Richard Bornat, Camels and humps: a retraction, 24 de julio de 2014

El texto es insólito por lo franco. Bornat explica que escribió el artículo original mientras un antidepresivo le había provocado un episodio maníaco —se describe a sí mismo como «grandioso, extremadamente autojustificado y muy combativo»— y que las réplicas posteriores no sostuvieron sus afirmaciones. Un estudio en Toronto pasó el test a 59 estudiantes y no encontró diferencia con los no evaluados; otro no halló correlación entre los resultados del test y varias medidas de rendimiento en el curso.

Pero hay un matiz que suele perderse, y es la parte interesante. Bornat mantiene que su doctorando sí había encontrado algo:

Lo que Saeed Dehnadi observó fue que, al preguntar a estudiantes novatos qué hacía un programa de tres o cuatro líneas, muchos respondían como si ya tuvieran un modelo mental de lo que pasaba. No eran los modelos correctos. Eran, en palabras de Bornat, «reconociblemente racionales». Y los que respondían de forma consistente —aplicando siempre el mismo modelo, aunque fuera equivocado— acababan el curso mejor que los que iban cambiando de criterio pregunta a pregunta.

Si eso se sostiene, cambia el consejo. Lo que separaría no es tener el modelo correcto, sino tener un modelo y aplicarlo con coherencia. Es decir: leer un trozo de código y poder decir, equivocándote si hace falta, «esto hace esto y luego esto». Lo que mata no es equivocarse, es no tener ninguna hipótesis.

La pregunta del test, y qué medía en realidad

Merece la pena verla, porque la retractación de Bornat la incluye en su apéndice y explica el asunto mejor que cualquier resumen. Esta es, literalmente, una de las preguntas que se pasaba a estudiantes que nunca habían programado:

int a = 5;
int b = 3;
int c = 7;

c = b;
b = a;
a = c;

Debajo venía una lista de posibles valores finales de a, b y c para marcar. La respuesta correcta es esta:

ejecutadoa=3  b=5  c=3

Ahora viene lo interesante. Las opciones equivocadas de la lista no eran ruido: cada una es el resultado de aplicar, con total coherencia, un modelo mental distinto de lo que hace el signo igual. Programé los tres más comunes para comprobarlo:

Qué cree quien respondeA qué respuesta lleva¿Estaba en la lista?
Lo correcto: cada línea copia el valor de la derecha en la variable de la izquierda, y el cambio se arrastraa=3 b=5 c=3Sí
Que se lee al revés: c = b significa «b recibe c»a=7 b=7 c=7Sí
Que cada asignación intercambia los dos valoresa=3 b=5 c=7Sí
Que no se arrastra: cada línea usa siempre los valores de partidaa=7 b=5 c=3Sí

Las cuatro figuran entre las opciones del cuestionario original. No es casualidad: el test estaba construido así a propósito. Y de ahí sale lo que de verdad medía, que no era acertar.

Quien marcaba a=7 b=7 c=7 en todas las preguntas del test estaba equivocado, pero estaba aplicando una regla y aplicándola siempre igual. Quien marcaba una respuesta por un criterio en la primera pregunta y otro distinto en la tercera no tenía ninguna regla: estaba adivinando. Según los datos de Dehnadi, los primeros acababan el curso mejor que los segundos.

La moraleja práctica. Cuando leas código y no lo entiendas, lo peor que puedes hacer es encogerte de hombros. Lo que hay que hacer es comprometerse con una predicción: «yo creo que esto deja a en 7». Si ejecutas y sale 3, acabas de localizar exactamente qué parte de tu modelo está mal, y eso se arregla. Si no predijiste nada, no has aprendido nada aunque veas el resultado correcto.

Qué predice de verdad aprender a programar

En 2020, un equipo de la Universidad de Washington publicó en Scientific Reports el estudio más directo que conozco sobre la pregunta. Midieron a 36 personas sin experiencia previa en una batería de pruebas —aptitud para los idiomas, razonamiento fluido, memoria de trabajo, aritmética y actividad cerebral en reposo— y después las pusieron a aprender Python en diez sesiones de 45 minutos, midiendo cuánto avanzaba cada una.

Qué predice aprender a programar, según Prat et al. 2020Qué explica lo que una persona avanza aprendiendo a programarVarianza explicada, promedio de las tres medidas de resultado. Prat et al. (2020), 36 participantesRazonamiento fluido y memoria de trabajoRazonamiento fluido y memoria de trabajo: 34 %34 %Aptitud para los idiomasAptitud para los idiomas: 17 %17 %Actividad cerebral en reposoActividad cerebral en reposo: 10 %10 %AritméticaAritmética: 2 %2 %Los modelos explican entre el 50 % y el 72 % del resultado. El resto no lo explica ninguna de estas cuatro cosasMirando solo la velocidad de aprendizaje, la aptitud para los idiomas sube al 43 %

La aritmética explica el 2 %. No es que no sirva de nada; es que, frente a lo que casi todo el mundo da por supuesto, no es ni de lejos lo que marca la diferencia. Los propios autores lo dicen en el resumen: «la importancia de la aritmética puede estar sobrevalorada en los entornos modernos de educación en programación».

Lo que sí pesa es la combinación de razonamiento fluido y memoria de trabajo —la capacidad de sostener varias cosas en la cabeza y relacionarlas— y, de manera llamativa, la aptitud para aprender idiomas. La hipótesis del estudio era precisamente esa: que aprender un lenguaje de programación de adulto se parece más a aprender un segundo idioma que a hacer cuentas.

Cuidado con cómo se ha contado esto. Verás titulares del tipo «los idiomas predicen más que las matemáticas». Esa versión sale de mirar solo una de las tres medidas, la velocidad de aprendizaje, donde la aptitud lingüística llega al 43 % según la nota de prensa de la propia universidad. En el promedio de las tres medidas, que es lo que publica el artículo, el primer puesto lo ocupan el razonamiento fluido y la memoria de trabajo. Y son 36 personas: es un estudio pequeño, sugerente, no una ley.

La escalera: trazar y explicar van antes que escribir

La segunda línea de investigación útil no mira lo que traes de casa, sino el orden en que se adquieren las habilidades. En 2008, un grupo analizó las respuestas de 38 estudiantes a un examen de final de primer semestre y buscó qué tipos de pregunta predecían el resultado en la parte de escribir código.

La escalera de habilidades antes de escribir códigoLa escalera: lo que hay que saber hacer antes de escribir códigoConocer las piezasqué hace un if, qué hace un bucleTrazarseguir el código a mano y decir qué vale cada cosaExplicardecir en una frase para qué sirve el conjuntoEscribirproducir código propio que funcioneCuánto predice cada unaTrazar, por sí solo15 %Explicar, por sí solo7 %Las dos juntas46 %de lo que varía al escribir códigoLopez et al. (2008), 38 estudiantes. Una réplica de 2022 con más de 600 halló otras ordenaciones igual de válidas

El resultado es el que da nombre a la idea de una escalera. Saber trazar código —seguirlo a mano, línea a línea, y decir qué vale cada variable— explicaba por sí solo el 15 % de lo que variaba al escribir. Saber explicar en una frase para qué sirve un fragmento explicaba un 7 %. Pero las dos juntas explicaban el 46 %: casi la mitad.

La lectura práctica es bastante clara, y es lo contrario de lo que hace casi todo el mundo cuando empieza: antes de ponerte a escribir, acostúmbrate a coger código ajeno y responder dos preguntas. Qué vale cada cosa después de cada línea. Y para qué sirve el conjunto, dicho en una frase, sin repetir el código con palabras.

Y aquí el escepticismo obligatorio. Ese estudio tenía 38 estudiantes. Una réplica de 2009 lo encontró «en líneas generales consistente», pero avisó de que la fuerza de la relación entre explicar y escribir «es particularmente sensible a las preguntas concretas que se hagan». Y una réplica de 2022 con más de 600 estudiantes concluyó que la jerarquía original no aparece entre los modelos que mejor encajan, aunque sí otros parecidos; y añadió algo importante: estos análisis muestran correlaciones entre habilidades, no en qué orden conviene enseñarlas.

¿Y programar enseña a pensar?

La pregunta del revés también se ha estudiado, y mucho. La promesa de «enseñar a programar a los niños para que aprendan a pensar» se apoya en la idea de que la habilidad se transfiere a otros terrenos. En 2019, un metaanálisis reunió 105 estudios y 539 tamaños de efecto para comprobarlo.

TransferenciaEfecto (g de Hedges)Qué significa
Global0,49Moderada. Intervalo de confianza del 95 %: 0,37 a 0,61
Cercana0,75Fuerte, pero con mucha incertidumbre: 0,39 a 1,11
Lejana0,47Moderada: 0,35 a 0,59

Dicho en claro: sí, aprender a programar deja algo fuera de la programación. Donde más se notó fue en pensamiento creativo, habilidades matemáticas y metacognición —pensar sobre el propio pensamiento—, seguidas de las habilidades espaciales y el razonamiento. Donde menos, en el rendimiento escolar general y en la lectoescritura.

Dos avisos que vienen en el propio metaanálisis, y que explican por qué no conviene agitar el 0,49 como bandera. El primero: los efectos eran significativamente mayores en los estudios cuyo grupo de control no hacía nada que en los que lo comparaban con otra actividad. Parte de la mejora puede ser simplemente «hacer algo exigente» en vez de «programar». El segundo: los estudios publicados daban efectos mayores que los no publicados, que es la firma clásica del sesgo de publicación.

Entonces, ¿cómo se entrena?

Juntando las tres líneas sale un programa bastante concreto, y ninguna de sus piezas es «ser bueno en matemáticas».

1. Ten un modelo de la máquina, aunque sea tosco

Es la lección que queda en pie del episodio del camello. Antes de escribir, hay que poder decir qué está pasando: dónde se guardan las cosas, cuándo cambian, en qué orden se ejecutan las líneas. Coge un programa de cinco líneas y predice el resultado antes de ejecutarlo. Si aciertas, bien. Si fallas, mejor todavía: acabas de encontrar dónde tu modelo no coincide con la realidad, que es exactamente lo que había que encontrar.

Y conviene saber qué modelo usa el lenguaje que estás aprendiendo, porque no todos funcionan igual. El caso que más desconcierta a los principiantes es este:

x = [1, 2, 3]
y = x
y.append(4)

print(x)
print(y)
salida[1, 2, 3, 4]
[1, 2, 3, 4]

Casi todo el mundo espera que x siga valiendo [1, 2, 3], porque arrastra de las matemáticas del colegio la idea de que una variable es una caja con un valor dentro. En Python no es así, y el modelo correcto explica la salida sin esfuerzo:

El modelo de cajas frente al modelo de etiquetas para las variablesDos modelos de qué es una variable. Solo uno explica lo que pasa de verdadEl modelo de cajascada nombre guarda su copiax[1, 2, 3]y[1, 2, 3, 4]Predice que x sigue valiendo [1, 2, 3]y eso NO es lo que ocurreEl modelo de etiquetaslos nombres apuntan al mismo objeto[1, 2, 3, 4]xyx e y son dos nombres de una sola listatocar una es tocar la otray = x no copia nada: le pone otra etiqueta al mismo objeto. Para copiar hay que pedirlo: y = x[:]Tener claro cuál de los dos modelos usa tu lenguaje evita una familia entera de errores

La prueba está en el propio lenguaje: x is y devuelve True, porque no hay dos listas, hay una con dos nombres. Si lo que quieres es una copia de verdad, hay que pedirla:

u = [1, 2, 3]
v = u[:]          # ahora sí, una copia
v.append(4)

print(u, v, u is v)
salida[1, 2, 3] [1, 2, 3, 4] False

No hace falta aprenderse esto de memoria. Hace falta tener un modelo de qué pasa al escribir y = x, y ponerlo a prueba en cuanto algo no cuadre.

2. Traza a mano antes de escribir

Papel y lápiz, una tabla con una columna por variable, y una fila por cada vuelta del bucle. Es lento y es aburrido, y es lo que más correlaciona con llegar a escribir código que funcione. También es lo primero que la gente se salta.

Veámoslo con un caso concreto. ¿Qué devuelve esto?

def misterio(nums):
    tope = nums[0]
    for n in nums:
        if n > tope:
            tope = n
    return tope

misterio([3, 9, 4, 1, 7])

La tentación es ejecutarlo y ver qué sale. El ejercicio es el contrario: rellenar esta tabla a mano, una fila por vuelta, antes de tocar el teclado.

Vueltann > topetope al terminar
antes de empezar——3
1.ª3no3
2.ª9sí9
3.ª4no9
4.ª1no9
5.ª7no9

Devuelve 9. Lo valioso no es el número: es que al rellenar la tabla has tenido que decidir, en cada fila, qué valía cada cosa. Si te equivocas en una fila, esa casilla te señala el punto exacto donde tu modelo falla. Es un depurador de papel, y funciona igual de bien en cualquier lenguaje.

Dos preguntas que conviene hacerse siempre al acabar la tabla: ¿qué pasa si la lista está vacía? ¿Y si todos los números son iguales? Ahí es donde aparecen la mitad de los errores de verdad.

3. Explica en una frase

Después de entender un fragmento, resúmelo sin describirlo línea a línea: no «recorre el array y compara cada elemento con el siguiente», sino «comprueba si está ordenado». Esa diferencia —ver el bosque y no solo los árboles— es la que distinguía en los estudios a quien iba bien de quien iba regular.

Un ejemplo. Este fragmento:

def otro(nums):
    for i in range(len(nums) - 1):
        if nums[i] > nums[i + 1]:
            return False
    return True
Tipo de respuestaQué se dice
Línea a línea«Recorre los índices hasta el penúltimo, compara cada elemento con el siguiente y, si uno es mayor, devuelve falso; si acaba el bucle, devuelve verdadero.»
En una frase«Comprueba si la lista está ordenada de menor a mayor.»

La primera no está mal: es correcta y completa. Pero es una traducción del código a castellano, no una comprensión. La segunda exige haber visto para qué sirve el conjunto, que es la habilidad que en los estudios aparecía como escalón intermedio.

Hay una manera limpia de comprobar si de verdad lo has entendido: ponerle nombre. Si tu frase es buena, se convierte en el nombre de la función casi sola. Aquí otro pasaría a llamarse esta_ordenada, y el código deja de necesitar explicación.

4. Ponte a prueba en vez de releer

Aquí no hay que inventar nada: hay un informe de 2013 que revisó las técnicas de estudio más usadas y las puntuó por utilidad real. Las dos mejor valoradas fueron ponerse a prueba —intentar recuperar lo aprendido sin mirar— y repartir el estudio en el tiempo en vez de concentrarlo. Entre las peor valoradas: releer, subrayar y resumir, que son justo las tres que hace todo el mundo.

Llevado a programar: cerrar el tutorial y rehacer el ejercicio de memoria vale más que volver a leerlo tres veces. Y veinte minutos al día durante dos semanas valen más que una tarde entera de sábado.

5. Acepta la carga y redúcela

Si lo que más pesa es la memoria de trabajo, la consecuencia práctica es que hay que dejar de pedirle cosas. Nombres de variable que se entiendan sin recordar nada. Funciones cortas. Un problema a la vez. No es estilo: es quitarle peso a la parte de tu cabeza que resultó ser la más limitante.

Lo que no sabemos

Conviene terminar por aquí, porque la literatura es más modesta de lo que parecen sus titulares. Los estudios son pequeños —36 personas, 38 estudiantes—, las réplicas matizan o no confirman, y el metaanálisis grande viene con problemas de diseño reconocidos. Nadie ha demostrado qué orden de enseñanza es el mejor; se han demostrado correlaciones entre habilidades, que no es lo mismo.

Lo que sí se puede afirmar con cierta tranquilidad es lo que no hay: no hay evidencia de un don innato que reparta a la gente en dos grupos, y lo más parecido que se publicó acabó retractado por su propio autor. Lo que hay son habilidades que se entrenan, un par de ellas identificadas con bastante consistencia, y una creencia muy cara —«no tengo cabeza para esto»— que no se sostiene en los datos.

Si lo que buscas es la versión práctica y aplicada al día a día, con la IA ya de por medio, está en los diez consejos para quien empieza.

Las fuentes, de un vistazo

EstudioQué midióTamañoQué hay que tener en cuenta
Prat et al. (2020), Scientific ReportsQué predice aprender Python36Muestra pequeña; los titulares usan solo una de las tres medidas
Bornat (2014), retractaciónRetira el «test de aptitud» de 2006—El autor mantiene que hay un fenómeno real sin explicar
Lopez et al. (2008)Trazar y explicar frente a escribir38Réplica de 2022 con 600+: la jerarquía original no es la que mejor encaja
Scherer et al. (2019), J. Educ. Psychol.Si programar transfiere a otras capacidades105 estudiosGrupos de control pasivos y sesgo de publicación inflan el efecto
Dunlosky et al. (2013)Qué técnicas de estudio funcionanrevisiónNo es específico de programación

Todas las cifras se comprobaron contra la fuente original, no contra resúmenes: Prat, Madhyastha, Mottarella y Kuo (2020); la retractación de Bornat; el metaanálisis de Scherer, Siddiq y Sánchez Viveros; la réplica de Fowler et al. (2022), y el informe de Dunlosky, Rawson, Marsh, Nathan y Willingham en Psychological Science in the Public Interest. Los datos de Lopez et al. (2008) se tomaron de la réplica de Venables, Tan y Lister (2009), que los reproduce y los discute.

Aprender a programar cuando la IA ya escribe el código: diez consejos para quien empieza

Una persona señalando una lección de programación en la pantalla de su portátil

En 2013 publicamos aquí diez consejos para programadores que empiezan. Casi todos siguen valiendo: lee mucho, prueba tu código, no acumules malas prácticas, diviértete. Lo que ha cambiado en estos trece años no es la lista, es una cosa concreta: ahora puedes producir código que funciona sin haber entendido nada. Eso es nuevo, y cambia por dónde hay que tener cuidado.

El problema de fondo, en cuatro cifras

No hace falta opinar sobre si la IA es buena o mala para aprender. Hay datos, y apuntan todos en la misma dirección: la herramienta se ha vuelto universal y la confianza en ella ha bajado.

DatoCifraDe dónde sale
Programadores que usan o van a usar IA84 %Encuesta de Stack Overflow, 2025
Que confían en que acierta33 %Solo un 3,1 % confía «mucho»
Que se topan con respuestas «casi bien, pero no»66 %Su queja número uno
Que tardan más en depurar código generado45 %Su queja número dos

Y hay un dato más incómodo. En 2025, METR hizo un experimento con dieciséis programadores veteranos trabajando sobre sus propios proyectos, 246 tareas reales repartidas al azar entre «con IA» y «sin IA». Esperaban ir un 24 % más rápido con ella. Tardaron un 19 % más. Y lo más llamativo: al terminar seguían creyendo que habían ido un 20 % más rápido.

Cuidado con lo que ese estudio dice y lo que no. Los propios autores advierten de que no prueba que la IA frene a la mayoría de programadores: eran dieciséis veteranos, en repositorios enormes que conocían de memoria y con un listón de calidad alto. El dato que sí importa para quien empieza no es el 19 %, es el otro: la diferencia entre lo que creían y lo que medían. La sensación de ir rápido no es fiable, y es justo la sensación que engancha.

Los dos bucles

Dos maneras de usar la IA al aprender a programarLos dos bucles. Los dos producen código que funciona; solo uno enseñaEl bucle que no enseñadescribes el problemapegas lo que te danfuncionapasas al siguienteAl mes siguiente no sabesqué hace tu propio proyectoEl bucle que enseñalo intentas tú primerote atascas y preguntascomparas con lo tuyolo ejecutas y lo rompesTardas más hoy y muchomenos dentro de tres mesesLa diferencia no está en usar o no usar la IA: está en si llegas a ella con una pregunta o sin ella

Aquí está todo el asunto. Los dos bucles producen código que funciona. En el primero el proyecto avanza y tú no; en el segundo avanzan los dos. La diferencia no es usar o no usar la IA, sino si llegas a ella con una pregunta formada o sin ella.

Diez consejos

1. Escribe a mano hasta que el patrón te salga solo

Un bucle, una condición, abrir un archivo, recorrer una lista. Mientras eso no te salga sin pensar, escríbelo tú aunque tardes diez veces más. No es masoquismo: es que lo que no has escrito nunca tampoco sabrás leerlo después, y vas a pasarte la vida leyendo código. Cuando el patrón ya sea aburrido, delégalo sin remordimiento.

2. Pide explicaciones, no soluciones

«Escríbeme una función que ordene esta lista» te deja donde estabas. «Explícame por qué mi función devuelve la lista vacía» te deja mejor. Es la misma herramienta y el mismo minuto, y el resultado para ti es completamente distinto.

Un truco que funciona muy bien: pídele que critique tu código en lugar de escribirlo. «¿Qué le ves mal a esto?» suele dar más que cualquier cosa que te genere de cero.

3. Ejecuta todo. Siempre. Sin excepción

Que el código tenga buen aspecto no significa nada. Esta guía misma sale de un sitio donde todo lo que se publica se compila y se ejecuta antes, y esa costumbre ha pillado cosas que ninguna lectura habría pillado.

Un caso real de esta casa. Preparando un artículo sobre medir el rendimiento en Rust, un programa de prueba sumaba tres millones de cuadrados y daba un tiempo de 40 nanosegundos. Era imposible, y la explicación no era un error de medición: el compilador se había dado cuenta de que el resultado se podía calcular con una fórmula cerrada y había eliminado el bucle entero. El código era correcto y la medición no medía nada. Leyéndolo no se veía; ejecutándolo y desconfiando del número, sí.

4. Desconfía de las versiones y de los nombres

Es el fallo más frecuente y el más silencioso: la IA te da una versión de biblioteca o un nombre de función que suena perfectamente razonable y no existe, o existía hace dos años. No miente a propósito; reproduce lo que vio.

Otro caso de aquí: en una lección de Rust apareció una dependencia con la versión 0.9.2. Parecía correcta. La versión real era la 0.10.3, y en medio había una función que se había mudado de sitio, así que el ejemplo no compilaba. La regla que salió de ahí es sencilla: las versiones se preguntan a la herramienta del lenguaje —cargo add, npm view, pip index—, nunca de memoria. Ni de la tuya ni de la suya.

5. Aprende a depurar, que es lo que peor hace

Un 45 % de los programadores dice que depurar código generado le lleva más tiempo, y tiene sentido: para arreglar algo hay que tener un modelo mental de cómo funciona, y si el código no lo escribiste tú, no lo tienes.

Depurar no es pedirle a la IA que arregle el error. Es leer el mensaje entero —entero, no la primera línea—, reducir el problema hasta el caso más pequeño que falla, e imprimir valores hasta encontrar dónde deja de ser lo que creías. Esa habilidad es la que separa a quien avanza de quien se queda bloqueado, y es la única de esta lista que no se puede delegar.

6. Aprende la terminal y Git antes que ningún framework

Toda herramienta de IA da por hecho que sabes moverte por un sistema de archivos, leer un error en una consola y deshacer un cambio. Si no, cada sugerencia te deja más perdido que antes. Son dos tardes de inversión y valen para el resto de tu carrera: aquí tienes los comandos de Linux que de verdad se usan y las órdenes de Git.

Lo de Git tiene un motivo extra ahora: si vas a aceptar código que no escribiste, más te vale poder volver atrás con una orden.

7. El contexto lo pones tú

La IA sabe de código; de tu problema no sabe nada. No sabe qué datos vas a recibir de verdad, qué pasa si el usuario deja el campo vacío, ni por qué en tu empresa las fechas se guardan así. Cuando le pides algo sin contarle eso, rellena los huecos con lo más común, que casi nunca es tu caso.

De ahí sale el consejo práctico: antes de pedir nada, escribe en una frase qué entra, qué tiene que salir y qué pasa cuando algo va mal. Si no sabes escribir esa frase, el problema no es la herramienta.

8. No aceptes nada que no sabrías defender

La prueba es sencilla: si alguien te preguntara por qué esa línea está ahí, ¿sabrías contestar? Si no, no la publiques. No porque esté mal —puede estar perfecta—, sino porque el día que falle vas a estar tú delante y no vas a tener por dónde empezar.

Qué conviene delegar a la IA mientras se aprende y qué noQué puedes delegar mientras aprendes, y qué te tienes que quedardelega sin miedono lo deleguesDelegalo repetitivo que ya sabes escribirbuscar en la documentacióntraducir un error a lenguaje llanogenerar datos de pruebaRevisacódigo que no sabrías escribirnombres de funciones y versioneslo que toque archivos o la redsus explicaciones: suenan segurasHazlo túdecidir qué problema resuelvesejecutar y comprobar que sirvedepurar cuando fallaentender lo que vas a publicar

9. Termina cosas, aunque sean pequeñas

Con la IA es facilísimo empezar diez proyectos ambiciosos y no acabar ninguno, porque los primeros pasos salen gratis y los últimos no. Y lo que de verdad enseña está al final: el caso raro, el despliegue, el error que solo aparece con datos reales, la parte aburrida de dejarlo presentable.

Un programa pequeño y terminado enseña más que tres grandes a medias. Esto no es nuevo: ya estaba en la lista de 2013 y sigue siendo verdad.

10. Lee código que no sea tuyo

Entra en un proyecto de código abierto que uses y lee cómo está hecho. Verás decisiones que no se te habrían ocurrido y, sobre todo, verás cómo se organiza algo que lleva años vivo, que es exactamente lo que ninguna herramienta te va a enseñar de un tirón.

Aquí la IA sí ayuda mucho, y de la forma correcta: como lector infinito al que puedes preguntarle «¿qué hace este archivo?» sin que se canse.

Lo que está pasando con el código de todos

Hay una razón para insistir tanto en entender lo que se acepta, y no es moral: se está midiendo en los repositorios reales. La empresa GitClear analizó 623 millones de cambios de código entre 2023 y 2026, y el patrón es consistente.

Qué mide20232026
Bloques de código duplicados (por millón de líneas)40,373,0
Copiar y pegar dentro de un mismo commit9,4 %15,7 %
Líneas movidas, es decir, refactorizadas13 %3,8 %
Llamadas a funciones de otros archivos (reutilización)343223

Se duplica más y se reordena mucho menos. Los propios autores piden no leerlo como «la IA escribe mal»: lo que dicen es que el flujo de trabajo habitual con IA premia lo inmediato y lo visible, mientras «grava en silencio lo invisible y lo aplazado». Reordenar código que ya funciona es trabajo invisible, y es el primero que desaparece cuando generar una versión nueva cuesta diez segundos.

Para alguien que empieza esto se traduce en algo muy concreto: la habilidad que va a escasear no es escribir código, es ordenarlo.

Lo que no ha cambiado

Conviene cerrar por donde empezamos. De aquella lista de 2013, lo que sigue intacto es casi todo: leer mucho, no adoptar una tecnología solo porque es nueva pero probarlas igualmente, compartir lo que aprendes, cuidarte y pasarlo bien. Nada de eso depende de qué herramienta tengas abierta.

Y hay algo que la irrupción de la IA ha puesto más claro todavía: el trabajo nunca fue teclear. Era entender un problema lo bastante bien como para explicárselo a una máquina sin ambigüedades. Eso es lo que estás aprendiendo cuando aprendes a programar, y es exactamente lo que no se delega, porque es lo único que hay que saber para poder delegar el resto.

Sobre la imagen de portada. Es un montaje sobre la fotografía «Learning to Code», de Preply.com Images, bajo licencia CC BY 2.0, vía Wikimedia Commons.

Las cifras de este artículo están comprobadas contra sus fuentes originales: la encuesta a desarrolladores de Stack Overflow de 2025 (33 662 respuestas en la pregunta sobre confianza), el experimento de METR con programadores veteranos y el informe de GitClear sobre mantenibilidad. Los dos ejemplos de errores reales salen de artículos publicados en este sitio, donde todo el código se ejecuta antes de publicarse. Si quieres el otro lado del asunto, está qué cambia en el oficio cuando escribir código deja de ser el centro.

Cómo escribir buenos prompts para crear aplicaciones web y móviles

Portada con un documento de prompt estructurado en secciones: producto, flujos, criterios de aceptación y forma de trabajo

Un buen prompt no garantiza una aplicación excelente por sí solo. La calidad depende de que las instrucciones describan qué problema resolver, para quién, cómo debe funcionar y cómo se comprobará el resultado. En proyectos grandes, conviene trabajar en etapas: primero definir y diseñar; luego implementar por partes; finalmente revisar y corregir.

1. Describe el producto antes que la tecnología

Empieza explicando el contexto y el objetivo:

  • Qué es la aplicación: «Una plataforma para que pequeños restaurantes administren pedidos para llevar».
  • Quién la usará: «Dueños y empleados con poca experiencia técnica».
  • Qué problema resuelve: «Evitar pedidos perdidos en llamadas y mensajes».
  • Qué acción principal debe facilitar: «Recibir, confirmar y actualizar pedidos».
  • Qué queda fuera del alcance inicial: «No incluir entregas propias ni facturación electrónica».

Esto ayuda a que la IA tome decisiones coherentes en vez de añadir funciones por su cuenta.

2. Explica los flujos con ejemplos concretos

Las funciones vagas producen resultados vagos. En lugar de pedir «agrega inicio de sesión», especifica lo que debe ocurrir:

Un empleado ingresa su correo y contraseña. Si los datos son correctos, llega al panel de pedidos. Si son incorrectos, ve un mensaje claro sin que la aplicación revele si el correo existe. Debe poder solicitar un enlace para restablecer su contraseña.

Incluye, cuando corresponda:

  • Qué inicia cada flujo.
  • Qué datos ingresa la persona.
  • Qué resultado espera.
  • Qué pasa si hay errores, falta información o se pierde la conexión.
  • Qué permisos necesita cada tipo de usuario.

3. Define cómo se reconocerá una entrega completa

Convierte expectativas en criterios observables. Por ejemplo:

  • El usuario puede crear, editar y cancelar un pedido.
  • Los pedidos se ordenan del más reciente al más antiguo.
  • Un usuario no puede consultar pedidos de otro restaurante.
  • El formulario explica qué campos faltan.
  • La interfaz funciona con teclado y lector de pantalla.

Estos criterios sirven tanto para guiar la implementación como para revisar si quedó bien.

4. Da contexto técnico y límites

Si ya existen un proyecto o tecnologías elegidas, indícalos:

  • Lenguaje, framework y versiones relevantes.
  • Base de datos, proveedor de autenticación y servicios externos.
  • Estructura actual del repositorio y convenciones del equipo.
  • Dispositivos, navegadores o sistemas que se deben soportar.
  • Límites de tiempo, presupuesto, rendimiento o compatibilidad.

Pide que la IA inspeccione el proyecto antes de proponer cambios y que respete sus patrones existentes. Si todavía no hay decisiones técnicas, pídele que proponga opciones y explique sus ventajas y costos antes de implementar.

5. Separa los requisitos comunes de los específicos de plataforma

Frontend web

Aclara:

  • Qué páginas y rutas necesita la aplicación.
  • Qué componentes se reutilizan.
  • Cómo se adapta a móvil, tableta y escritorio.
  • Qué estados debe mostrar cada pantalla: carga, vacío, error, éxito y acceso denegado.
  • Cómo se manejan formularios, validación, navegación y permisos.
  • Qué nivel de accesibilidad se espera.

Puedes pedir que siga WCAG 2.2 como referencia para accesibilidad web: teclado, foco visible, etiquetas, contraste, ampliación de texto y mensajes de estado. Referencia WCAG 2.2.

Backend y API

Especifica:

  • Entidades y relaciones principales.
  • Operaciones disponibles y quién puede ejecutarlas.
  • Formato de entradas y respuestas, incluidos errores.
  • Reglas de validación y consistencia de datos.
  • Autenticación, autorización, auditoría y límites de solicitudes.
  • Qué información es confidencial y cómo debe protegerse.

No basta con pedir «una API segura». Explica, por ejemplo, que cada operación debe comprobar que la persona tiene permiso sobre ese recurso específico, y no solo que inició sesión. OWASP destaca fallos de autorización, autenticación y consumo de recursos entre los riesgos importantes para APIs. OWASP API Security Top 10.

Aplicaciones móviles

Indica:

  • Si será iOS, Android o ambas plataformas, y si usarás desarrollo nativo o multiplataforma.
  • Versiones mínimas y tamaños de pantalla que hay que soportar.
  • Qué debe funcionar sin conexión y qué datos se guardarán localmente.
  • Cómo se manejan permisos, notificaciones y enlaces profundos.
  • Qué pasa cuando el sistema suspende o cierra la aplicación.
  • Reglas de diseño y accesibilidad propias de cada plataforma.

Para Android, la guía oficial recomienda separar responsabilidades, mantener los datos fuera de componentes de pantalla y adaptar la interfaz a distintos tamaños y cambios de configuración. Guía de arquitectura para Android. Para iOS, utiliza las Human Interface Guidelines de Apple como referencia de diseño y accesibilidad.

6. Pide una interfaz específica, no solo «moderna»

Describe la experiencia visual con referencias concretas:

  • «Interfaz clara para uso frecuente en una cocina».
  • «La lista de pedidos es la información principal».
  • «Botones grandes y legibles en una tableta».
  • «Usa colores para acompañar el texto, no como única señal del estado».
  • «Incluye estados vacíos y mensajes de error útiles».

Si tienes diseños, capturas o una guía visual, adjúntalos y señala qué debe conservarse y qué puede cambiar. «Hazlo bonito» no define jerarquía, comportamiento ni identidad visual.

7. Pide arquitectura proporcional al problema

Indica el tamaño y la etapa del producto para evitar tanto una estructura improvisada como una complejidad innecesaria.

Para esta primera versión, mantén una arquitectura sencilla y modular. Separa la interfaz, las reglas del negocio y el acceso a datos. No introduzcas servicios distribuidos ni dependencias nuevas sin justificar por qué hacen falta.

Las guías oficiales de Android también aconsejan separar capas y responsabilidades para facilitar el mantenimiento y las pruebas. Ese principio es útil como orientación general, aunque la arquitectura adecuada depende de la plataforma y el producto. Arquitectura de apps Android.

8. Especifica cómo revisar el trabajo

Pide una entrega verificable:

  • Qué comprobaciones ejecutar, como compilación, análisis estático o pruebas existentes.
  • Qué recorridos principales revisar manualmente.
  • Qué dispositivos, navegadores o tamaños de pantalla comprobar.
  • Qué documentación actualizar.
  • Qué resultado presentar: archivos modificados, decisiones tomadas, límites conocidos y pasos para ejecutar la aplicación.

Mejor pedir pruebas asociadas a criterios concretos que decir simplemente «asegúrate de que todo funcione». Si no quieres que se ejecuten pruebas o se modifiquen ciertos archivos, dilo explícitamente.

9. Trabaja en pasos pequeños

Para una aplicación completa, evita un único prompt del tipo «crea una app profesional». Divide el trabajo:

  1. Definir: resume el problema, usuarios, alcance y criterios de aceptación.
  2. Diseñar: propone pantallas, flujos, modelo de datos y arquitectura.
  3. Implementar: construye una función o recorrido completo cada vez.
  4. Revisar: compara lo hecho con los criterios, identifica fallos y corrígelos.
  5. Entregar: explica cómo ejecutar el proyecto y qué queda pendiente.

Si la IA tiene acceso al repositorio, puede empezar inspeccionando la estructura y los patrones existentes. Pide que informe cualquier incertidumbre que afecte decisiones importantes, en lugar de inventar requisitos.

Plantilla reutilizable

Actúa como [rol o especialidad]. Ayúdame a construir [tipo de aplicación].

## Producto
- Problema que resuelve:
- Usuarios principales:
- Objetivo de la primera versión:
- Fuera de alcance:

## Plataforma y contexto técnico
- Frontend:
- Backend/API:
- Móvil:
- Base de datos y servicios:
- Versiones, dispositivos y navegadores:
- Repositorio o convenciones existentes:

## Flujos y funciones
1. [Flujo descrito paso a paso]
2. [Flujo descrito paso a paso]

## Reglas del negocio y permisos
- [Regla]
- [Quién puede ver o cambiar cada dato]
- [Validaciones y errores esperados]

## Diseño y experiencia
- Prioridad de cada pantalla:
- Estilo o referencias:
- Requisitos responsive:
- Accesibilidad:
- Estados de carga, vacío, error y éxito:

## Requisitos de calidad
- Seguridad y privacidad:
- Rendimiento:
- Funcionamiento sin conexión:
- Arquitectura y límites de complejidad:
- Compatibilidad:

## Criterios de aceptación
- [Resultado comprobable]

## Forma de trabajo
Primero inspecciona el proyecto y resume el plan. Señala las decisiones importantes que falten.
Después implementa [función o etapa concreta], siguiendo los patrones existentes.
Al terminar, indica qué cambiaste, qué comprobaciones realizaste y qué limitaciones quedan.
No inventes requisitos ni añadas dependencias o funciones fuera del alcance sin explicarlo.

La regla práctica

Escribe el prompt como una especificación breve: contexto, usuarios, flujos, restricciones y criterios de aceptación. Luego avanza función por función y revisa el resultado contra esos criterios.

Accesos directos en Visual Studio Code

Los accesos directos o shortcuts te permiten ser más productivo. Es por eso que te enlistamos algunos de los Accesos directos en Visual Studio Code, al menos algunos de los más útiles. si estás comenzando a desarrollar es bueno que te familiarices con ellos desde el inicio.

Ctrl + P – Muestra la barra de búsqueda para buscar archivos

En Mac es: Cmd + P

Con este acceso directo navegarás entre archivos todo el tiempo. Puedes escribir el nombre del archivo y abrirlo presionando Enter.

Ctrl + Shift + P – Muestra la paleta de comandos

En Mac es: Cmd + Mayús + P

Te muestra la paleta de comandos donde puedes buscar una acción.

Ctrl + B – Alternar la barra lateral

En Mac es: Cmd + B

Muestra u oculta la barra lateral donde puedes navegar por el explorador.

Ctrl + Shift + E – Ir a la ventana del Explorador

En Mac es: Cmd + Mayús + E

Va a la ventana del Explorador donde tiene su árbol de archivos y puede navegar usando las teclas de flecha.

Ctrl + Shift + M – Muestra rápidamente errores y advertencias

En Mac es: Cmd + Mayús + M

A todo el mundo le gusta el código libre de errores. Este comando muestra el panel de problemas donde puede ver los errores y advertencias identificados.

Ctrl + Shift + L – Selección multi cursor

En Mac es: Cmd + Mayús + L

Agregue cursores adicionales para editar todas las apariciones de la selección actual. Por lo general, es menos propenso a errores que buscar y reemplazar todo.

Ctrl + D – Selección uno por uno

En Mac es: Cmd + D

Similar al anterior, pero usa Ctrl + D si deseas agregar las ocurrencias de la selección actual una por una. Cada vez que presionas la combinación de teclas, agregas una nueva aparición a la selección.

Ctrl + / – alternar comentario de línea

En Mac es: Cmd + /

Alternar entre comportamiento de línea comentado y no comentado.

Ctrl + Shift + I – formatea todo el archivo

En Mac es: Mayús + Opt + F

En Windows: Mayús + Alt + F de Windows

Formatea todo el archivo activo o le solicita que instale una extensión de formateador. Puedes usar la extensión Prettier para formatear el código JS, por ejemplo.

Alt + Arriba o Alt + Abajo – Mover línea

En Mac es: Opt + Down u Opt + Up

Muy claro. Mueva la línea hacia arriba y hacia abajo.

Ctrl + Espacio – Mostrar sugerencias

Muestra sugerencias para completar rápidamente propiedades y otras cosas.

Y uno de mis favoritos:

Shift + Alt + Abajo o Shift + Alt + Arriba – Duplica la línea de código

En Mac es Mayus + Opt + Arriba o Mayus + Opt + Abajo

Este acceso directo te facilita duplicar el contenido de una línea de código hacia por debajo o arriba.

Accesos directos en Visual Studio Code

Estos son algunos de los accesos directos más útiles para Visual Studio Code, pero desde luego hay más y los puedes consultar en los siguientes enlaces:

Windows: https://code.visualstudio.com/shortcuts/keyboard-shortcuts-windows.pdf

Mac : https://code.visualstudio.com/shortcuts/keyboard-shortcuts-windows.pdf

Linux: https://code.visualstudio.com/shortcuts/keyboard-shortcuts-linux.pdf

Boilerplate code: qué es el código repetitivo y cómo se reduce

En programación se llama boilerplate code, o simplemente boilerplate, al código que hay que escribir una y otra vez, casi sin cambios, para que un programa funcione: no aporta nada propio del problema que se resuelve, pero sin él el programa no compila o no arranca. En español se suele decir código repetitivo o código de plantilla.

Placa metálica de 1913 de la Reid Newfoundland Company, constructora de calderas
Una placa de fabricante de calderas de 1913. El nombre del boilerplate viene de este tipo de piezas de metal.

El nombre viene de la imprenta. A finales del siglo XIX, en Estados Unidos, las agencias enviaban a los periódicos pequeños textos ya compuestos en planchas de metal, listos para imprimir sin cambiar una coma: anuncios, columnas fijas, avisos legales. Aquellas planchas recordaban a las de acero con que se fabricaban las calderas, las boiler plates, y el nombre se quedó para cualquier texto que se reutiliza tal cual. Hoy se usa también en derecho, para las cláusulas que se copian de un contrato a otro, y en programación.

Ejemplos de boilerplate

Todos los lenguajes tienen su ración. Algunos de los ejemplos más conocidos:

  • El esqueleto de una página HTML: <!doctype html>, <html>, <head>, el charset y el viewport se repiten en cada página antes de escribir una sola línea de contenido.
  • El if __name__ == "__main__": de Python, que separa lo que se ejecuta al lanzar un archivo de lo que se ejecuta al importarlo.
  • El if err != nil { return err } de Go, que aparece después de casi cada llamada que puede fallar.
  • Las clases de datos en Java: constructor, métodos para leer cada campo, equals, hashCode y toString. Es el ejemplo clásico, y lo vemos ahora.

Esta clase solo guarda un nombre y una edad, y ocupa 29 líneas. Casi todas son boilerplate: si se añade un campo, hay que acordarse de tocar el constructor, el método de lectura, equals, hashCode y toString. Si se olvida uno, el error no salta al compilar.

import java.util.Objects;

public final class PersonaClasica {
    private final String nombre;
    private final int edad;

    public PersonaClasica(String nombre, int edad) {
        this.nombre = nombre;
        this.edad = edad;
    }

    public String getNombre() { return nombre; }
    public int getEdad() { return edad; }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (!(o instanceof PersonaClasica p)) return false;
        return edad == p.edad && Objects.equals(nombre, p.nombre);
    }

    @Override
    public int hashCode() { return Objects.hash(nombre, edad); }

    @Override
    public String toString() {
        return "PersonaClasica[nombre=" + nombre + ", edad=" + edad + "]";
    }
}

Desde Java 16, un record hace lo mismo en una línea. El compilador genera el constructor, los métodos para leer los campos, equals, hashCode y toString:

public record Persona(String nombre, int edad) { }
public class Prueba {
    public static void main(String[] args) {
        var a = new PersonaClasica("Ana", 30);
        var b = new PersonaClasica("Ana", 30);
        System.out.println(a + " | iguales: " + a.equals(b));

        var c = new Persona("Ana", 30);
        var d = new Persona("Ana", 30);
        System.out.println(c + " | iguales: " + c.equals(d) + " | nombre: " + c.nombre());
    }
}
java PruebaPersonaClasica[nombre=Ana, edad=30] | iguales: true
Persona[nombre=Ana, edad=30] | iguales: true | nombre: Ana

Las dos versiones se comportan igual: las dos personas con el mismo nombre y edad son iguales, y se imprimen con todos sus campos. La diferencia es que en la segunda no hay nada que mantener a mano.

Cómo se reduce el boilerplate

  • El propio lenguaje. Es la mejor solución, porque no añade dependencias: los record de Java, las data class de Kotlin, las dataclass de Python o los #[derive(Debug, Clone, PartialEq)] de Rust generan el código repetitivo por ti.
  • Bibliotecas que generan código. En Java, Lombok añade getters, setters y constructores con anotaciones como @Data. Funciona, pero es una dependencia más, que además se mete en el proceso de compilación.
  • Frameworks. Spring Boot, Django o Ruby on Rails existen en buena parte para ahorrar boilerplate: configuran solos lo habitual y solo hay que escribir lo que se sale de lo normal.
  • Generadores y plantillas de proyecto. Herramientas como npm create, cargo new o Spring Initializr crean la estructura inicial completa con una orden.
  • El editor y la IA. Los IDE generan constructores y métodos con un atajo, y los asistentes de IA escriben el boilerplate en segundos. Es justo el tipo de código que mejor generan, porque lo han visto millones de veces.
Que lo escriba la IA no lo hace gratis. El boilerplate generado hay que leerlo, revisarlo y mantenerlo igual que el escrito a mano. Si un campo nuevo no se añade a equals, el error es el mismo lo haya escrito quien lo haya escrito. Por eso, cuando el lenguaje ofrece una forma de no tener que escribirlo, como un record, sigue siendo mejor opción que generarlo. Lo explicamos en qué lenguaje elegir cuando la IA escribe el código.

¿Es siempre malo?

No. Parte del boilerplate existe por buenas razones: el if err != nil de Go obliga a decidir qué hacer con cada error, en lugar de dejar que una excepción suba sin control, y declarar los tipos de forma explícita hace que el código se lea mejor meses después. El problema aparece cuando la repetición no aporta información y solo multiplica los sitios donde equivocarse. La regla práctica: si al leer un bloque no aprendes nada sobre lo que hace el programa, es boilerplate y conviene que lo genere el lenguaje, un framework o una herramienta.

Los ejemplos de Java se compilaron y ejecutaron con Java 25 (Eclipse Temurin 25.0.4). Más información: Boilerplate code en Wikipedia y JEP 395: Records.