«Es que yo no tengo cabeza para esto.» Lo dice mucha gente que empieza a programar y se atasca, y detrás hay una creencia muy extendida: que existe un tipo de mente lógica, que unos la tienen y otros no, y que sin ella no hay nada que hacer. Resulta que esa pregunta se ha estudiado bastante, y lo que ha salido no se parece casi nada a lo que se repite.
Primero: el «gen del programador» no existe, y quien lo propuso se retractó
En 2006 circuló un artículo con un título que hizo fortuna: The camel has two humps, «el camello tiene dos jorobas». Sostenía que los estudiantes de programación no se reparten en una campana de Gauss sino en dos grupos separados —los que lo pillan y los que no lo pillarán nunca— y que un test sencillo podía distinguirlos antes de empezar el curso. La idea se citó durante años.
En julio de 2014, su autor, Richard Bornat, publicó una retractación. No una matización: una retractación.
El texto es insólito por lo franco. Bornat explica que escribió el artículo original mientras un antidepresivo le había provocado un episodio maníaco —se describe a sí mismo como «grandioso, extremadamente autojustificado y muy combativo»— y que las réplicas posteriores no sostuvieron sus afirmaciones. Un estudio en Toronto pasó el test a 59 estudiantes y no encontró diferencia con los no evaluados; otro no halló correlación entre los resultados del test y varias medidas de rendimiento en el curso.
Pero hay un matiz que suele perderse, y es la parte interesante. Bornat mantiene que su doctorando sí había encontrado algo:
Lo que Saeed Dehnadi observó fue que, al preguntar a estudiantes novatos qué hacía un programa de tres o cuatro líneas, muchos respondían como si ya tuvieran un modelo mental de lo que pasaba. No eran los modelos correctos. Eran, en palabras de Bornat, «reconociblemente racionales». Y los que respondían de forma consistente —aplicando siempre el mismo modelo, aunque fuera equivocado— acababan el curso mejor que los que iban cambiando de criterio pregunta a pregunta.
La pregunta del test, y qué medía en realidad
Merece la pena verla, porque la retractación de Bornat la incluye en su apéndice y explica el asunto mejor que cualquier resumen. Esta es, literalmente, una de las preguntas que se pasaba a estudiantes que nunca habían programado:
int a = 5;
int b = 3;
int c = 7;

c = b;
b = a;
a = c;
Debajo venía una lista de posibles valores finales de a, b y c para marcar. La respuesta correcta es esta:
ejecutadoa=3 b=5 c=3
Ahora viene lo interesante. Las opciones equivocadas de la lista no eran ruido: cada una es el resultado de aplicar, con total coherencia, un modelo mental distinto de lo que hace el signo igual. Programé los tres más comunes para comprobarlo:
| Qué cree quien responde | A qué respuesta lleva | ¿Estaba en la lista? |
|---|---|---|
| Lo correcto: cada línea copia el valor de la derecha en la variable de la izquierda, y el cambio se arrastra | a=3 b=5 c=3 |
Sí |
Que se lee al revés: c = b significa «b recibe c» |
a=7 b=7 c=7 |
Sí |
| Que cada asignación intercambia los dos valores | a=3 b=5 c=7 |
Sí |
| Que no se arrastra: cada línea usa siempre los valores de partida | a=7 b=5 c=3 |
Sí |
Las cuatro figuran entre las opciones del cuestionario original. No es casualidad: el test estaba construido así a propósito. Y de ahí sale lo que de verdad medía, que no era acertar.
Quien marcaba a=7 b=7 c=7 en todas las preguntas del test estaba equivocado, pero estaba aplicando una regla y aplicándola siempre igual. Quien marcaba una respuesta por un criterio en la primera pregunta y otro distinto en la tercera no tenía ninguna regla: estaba adivinando. Según los datos de Dehnadi, los primeros acababan el curso mejor que los segundos.
Qué predice de verdad aprender a programar
En 2020, un equipo de la Universidad de Washington publicó en Scientific Reports el estudio más directo que conozco sobre la pregunta. Midieron a 36 personas sin experiencia previa en una batería de pruebas —aptitud para los idiomas, razonamiento fluido, memoria de trabajo, aritmética y actividad cerebral en reposo— y después las pusieron a aprender Python en diez sesiones de 45 minutos, midiendo cuánto avanzaba cada una.
La aritmética explica el 2 %. No es que no sirva de nada; es que, frente a lo que casi todo el mundo da por supuesto, no es ni de lejos lo que marca la diferencia. Los propios autores lo dicen en el resumen: «la importancia de la aritmética puede estar sobrevalorada en los entornos modernos de educación en programación».
Lo que sí pesa es la combinación de razonamiento fluido y memoria de trabajo —la capacidad de sostener varias cosas en la cabeza y relacionarlas— y, de manera llamativa, la aptitud para aprender idiomas. La hipótesis del estudio era precisamente esa: que aprender un lenguaje de programación de adulto se parece más a aprender un segundo idioma que a hacer cuentas.
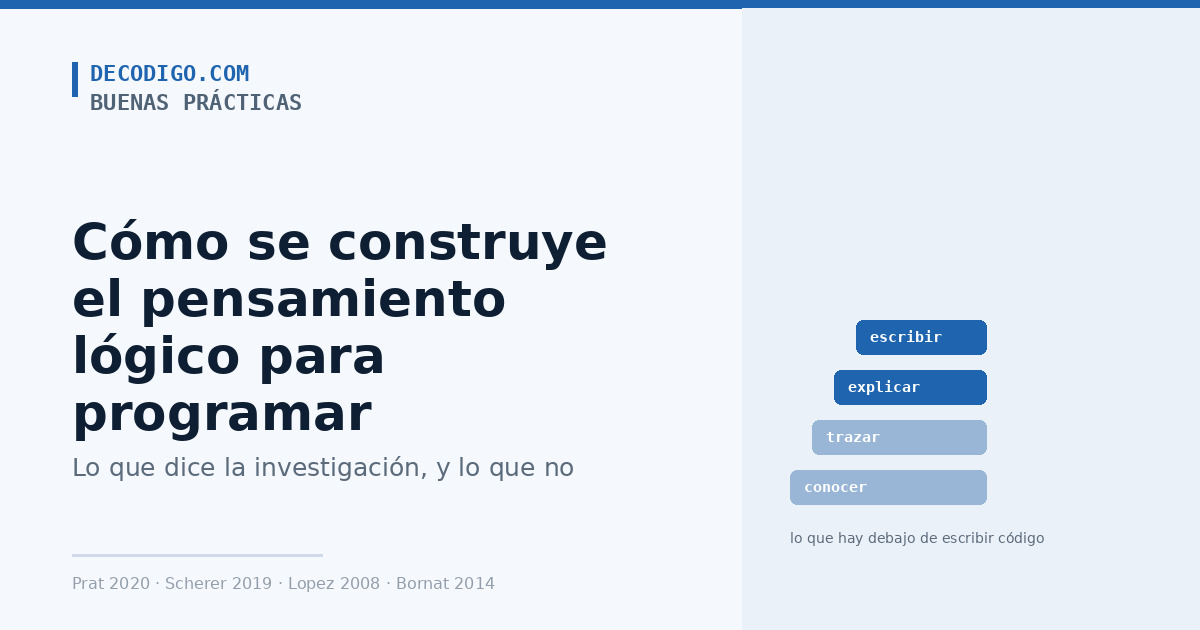
La escalera: trazar y explicar van antes que escribir
La segunda línea de investigación útil no mira lo que traes de casa, sino el orden en que se adquieren las habilidades. En 2008, un grupo analizó las respuestas de 38 estudiantes a un examen de final de primer semestre y buscó qué tipos de pregunta predecían el resultado en la parte de escribir código.
El resultado es el que da nombre a la idea de una escalera. Saber trazar código —seguirlo a mano, línea a línea, y decir qué vale cada variable— explicaba por sí solo el 15 % de lo que variaba al escribir. Saber explicar en una frase para qué sirve un fragmento explicaba un 7 %. Pero las dos juntas explicaban el 46 %: casi la mitad.
La lectura práctica es bastante clara, y es lo contrario de lo que hace casi todo el mundo cuando empieza: antes de ponerte a escribir, acostúmbrate a coger código ajeno y responder dos preguntas. Qué vale cada cosa después de cada línea. Y para qué sirve el conjunto, dicho en una frase, sin repetir el código con palabras.
¿Y programar enseña a pensar?
La pregunta del revés también se ha estudiado, y mucho. La promesa de «enseñar a programar a los niños para que aprendan a pensar» se apoya en la idea de que la habilidad se transfiere a otros terrenos. En 2019, un metaanálisis reunió 105 estudios y 539 tamaños de efecto para comprobarlo.
| Transferencia | Efecto (g de Hedges) | Qué significa |
|---|---|---|
| Global | 0,49 | Moderada. Intervalo de confianza del 95 %: 0,37 a 0,61 |
| Cercana | 0,75 | Fuerte, pero con mucha incertidumbre: 0,39 a 1,11 |
| Lejana | 0,47 | Moderada: 0,35 a 0,59 |
Dicho en claro: sí, aprender a programar deja algo fuera de la programación. Donde más se notó fue en pensamiento creativo, habilidades matemáticas y metacognición —pensar sobre el propio pensamiento—, seguidas de las habilidades espaciales y el razonamiento. Donde menos, en el rendimiento escolar general y en la lectoescritura.
Entonces, ¿cómo se entrena?
Juntando las tres líneas sale un programa bastante concreto, y ninguna de sus piezas es «ser bueno en matemáticas».
1. Ten un modelo de la máquina, aunque sea tosco
Es la lección que queda en pie del episodio del camello. Antes de escribir, hay que poder decir qué está pasando: dónde se guardan las cosas, cuándo cambian, en qué orden se ejecutan las líneas. Coge un programa de cinco líneas y predice el resultado antes de ejecutarlo. Si aciertas, bien. Si fallas, mejor todavía: acabas de encontrar dónde tu modelo no coincide con la realidad, que es exactamente lo que había que encontrar.
Y conviene saber qué modelo usa el lenguaje que estás aprendiendo, porque no todos funcionan igual. El caso que más desconcierta a los principiantes es este:
x = [1, 2, 3]
y = x
y.append(4)

print(x)
print(y)
salida[1, 2, 3, 4]
[1, 2, 3, 4]
Casi todo el mundo espera que x siga valiendo [1, 2, 3], porque arrastra de las matemáticas del colegio la idea de que una variable es una caja con un valor dentro. En Python no es así, y el modelo correcto explica la salida sin esfuerzo:
La prueba está en el propio lenguaje: x is y devuelve True, porque no hay dos listas, hay una con dos nombres. Si lo que quieres es una copia de verdad, hay que pedirla:
u = [1, 2, 3]
v = u[:]          # ahora sí, una copia
v.append(4)

print(u, v, u is v)
salida[1, 2, 3] [1, 2, 3, 4] False
No hace falta aprenderse esto de memoria. Hace falta tener un modelo de qué pasa al escribir y = x, y ponerlo a prueba en cuanto algo no cuadre.
2. Traza a mano antes de escribir
Papel y lápiz, una tabla con una columna por variable, y una fila por cada vuelta del bucle. Es lento y es aburrido, y es lo que más correlaciona con llegar a escribir código que funcione. También es lo primero que la gente se salta.
Veámoslo con un caso concreto. ¿Qué devuelve esto?
def misterio(nums):
    tope = nums[0]
    for n in nums:
        if n > tope:
            tope = n
    return tope

misterio([3, 9, 4, 1, 7])
La tentación es ejecutarlo y ver qué sale. El ejercicio es el contrario: rellenar esta tabla a mano, una fila por vuelta, antes de tocar el teclado.
| Vuelta | n | n > tope |
tope al terminar |
|---|---|---|---|
| antes de empezar | — | — | 3 |
| 1.ª | 3 | no | 3 |
| 2.ª | 9 | sí | 9 |
| 3.ª | 4 | no | 9 |
| 4.ª | 1 | no | 9 |
| 5.ª | 7 | no | 9 |
Devuelve 9. Lo valioso no es el número: es que al rellenar la tabla has tenido que decidir, en cada fila, qué valía cada cosa. Si te equivocas en una fila, esa casilla te señala el punto exacto donde tu modelo falla. Es un depurador de papel, y funciona igual de bien en cualquier lenguaje.
Dos preguntas que conviene hacerse siempre al acabar la tabla: ¿qué pasa si la lista está vacía? ¿Y si todos los números son iguales? Ahí es donde aparecen la mitad de los errores de verdad.
3. Explica en una frase
Después de entender un fragmento, resúmelo sin describirlo línea a línea: no «recorre el array y compara cada elemento con el siguiente», sino «comprueba si está ordenado». Esa diferencia —ver el bosque y no solo los árboles— es la que distinguía en los estudios a quien iba bien de quien iba regular.
Un ejemplo. Este fragmento:
def otro(nums):
    for i in range(len(nums) - 1):
        if nums[i] > nums[i + 1]:
            return False
    return True
| Tipo de respuesta | Qué se dice |
|---|---|
| Línea a línea | «Recorre los índices hasta el penúltimo, compara cada elemento con el siguiente y, si uno es mayor, devuelve falso; si acaba el bucle, devuelve verdadero.» |
| En una frase | «Comprueba si la lista está ordenada de menor a mayor.» |
La primera no está mal: es correcta y completa. Pero es una traducción del código a castellano, no una comprensión. La segunda exige haber visto para qué sirve el conjunto, que es la habilidad que en los estudios aparecía como escalón intermedio.
Hay una manera limpia de comprobar si de verdad lo has entendido: ponerle nombre. Si tu frase es buena, se convierte en el nombre de la función casi sola. Aquí otro pasaría a llamarse esta_ordenada, y el código deja de necesitar explicación.
4. Ponte a prueba en vez de releer
Aquí no hay que inventar nada: hay un informe de 2013 que revisó las técnicas de estudio más usadas y las puntuó por utilidad real. Las dos mejor valoradas fueron ponerse a prueba —intentar recuperar lo aprendido sin mirar— y repartir el estudio en el tiempo en vez de concentrarlo. Entre las peor valoradas: releer, subrayar y resumir, que son justo las tres que hace todo el mundo.
Llevado a programar: cerrar el tutorial y rehacer el ejercicio de memoria vale más que volver a leerlo tres veces. Y veinte minutos al día durante dos semanas valen más que una tarde entera de sábado.
5. Acepta la carga y redúcela
Si lo que más pesa es la memoria de trabajo, la consecuencia práctica es que hay que dejar de pedirle cosas. Nombres de variable que se entiendan sin recordar nada. Funciones cortas. Un problema a la vez. No es estilo: es quitarle peso a la parte de tu cabeza que resultó ser la más limitante.
Lo que no sabemos
Conviene terminar por aquí, porque la literatura es más modesta de lo que parecen sus titulares. Los estudios son pequeños —36 personas, 38 estudiantes—, las réplicas matizan o no confirman, y el metaanálisis grande viene con problemas de diseño reconocidos. Nadie ha demostrado qué orden de enseñanza es el mejor; se han demostrado correlaciones entre habilidades, que no es lo mismo.
Lo que sí se puede afirmar con cierta tranquilidad es lo que no hay: no hay evidencia de un don innato que reparta a la gente en dos grupos, y lo más parecido que se publicó acabó retractado por su propio autor. Lo que hay son habilidades que se entrenan, un par de ellas identificadas con bastante consistencia, y una creencia muy cara —«no tengo cabeza para esto»— que no se sostiene en los datos.
Si lo que buscas es la versión práctica y aplicada al día a día, con la IA ya de por medio, está en los diez consejos para quien empieza.
Las fuentes, de un vistazo
| Estudio | Qué midió | Tamaño | Qué hay que tener en cuenta |
|---|---|---|---|
| Prat et al. (2020), Scientific Reports | Qué predice aprender Python | 36 | Muestra pequeña; los titulares usan solo una de las tres medidas |
| Bornat (2014), retractación | Retira el «test de aptitud» de 2006 | — | El autor mantiene que hay un fenómeno real sin explicar |
| Lopez et al. (2008) | Trazar y explicar frente a escribir | 38 | Réplica de 2022 con 600+: la jerarquía original no es la que mejor encaja |
| Scherer et al. (2019), J. Educ. Psychol. | Si programar transfiere a otras capacidades | 105 estudios | Grupos de control pasivos y sesgo de publicación inflan el efecto |
| Dunlosky et al. (2013) | Qué técnicas de estudio funcionan | revisión | No es específico de programación |
Todas las cifras se comprobaron contra la fuente original, no contra resúmenes: Prat, Madhyastha, Mottarella y Kuo (2020); la retractación de Bornat; el metaanálisis de Scherer, Siddiq y Sánchez Viveros; la réplica de Fowler et al. (2022), y el informe de Dunlosky, Rawson, Marsh, Nathan y Willingham en Psychological Science in the Public Interest. Los datos de Lopez et al. (2008) se tomaron de la réplica de Venables, Tan y Lister (2009), que los reproduce y los discute.