Del código generado al código confiable: así quiere GitHub verificar a los agentes de IA

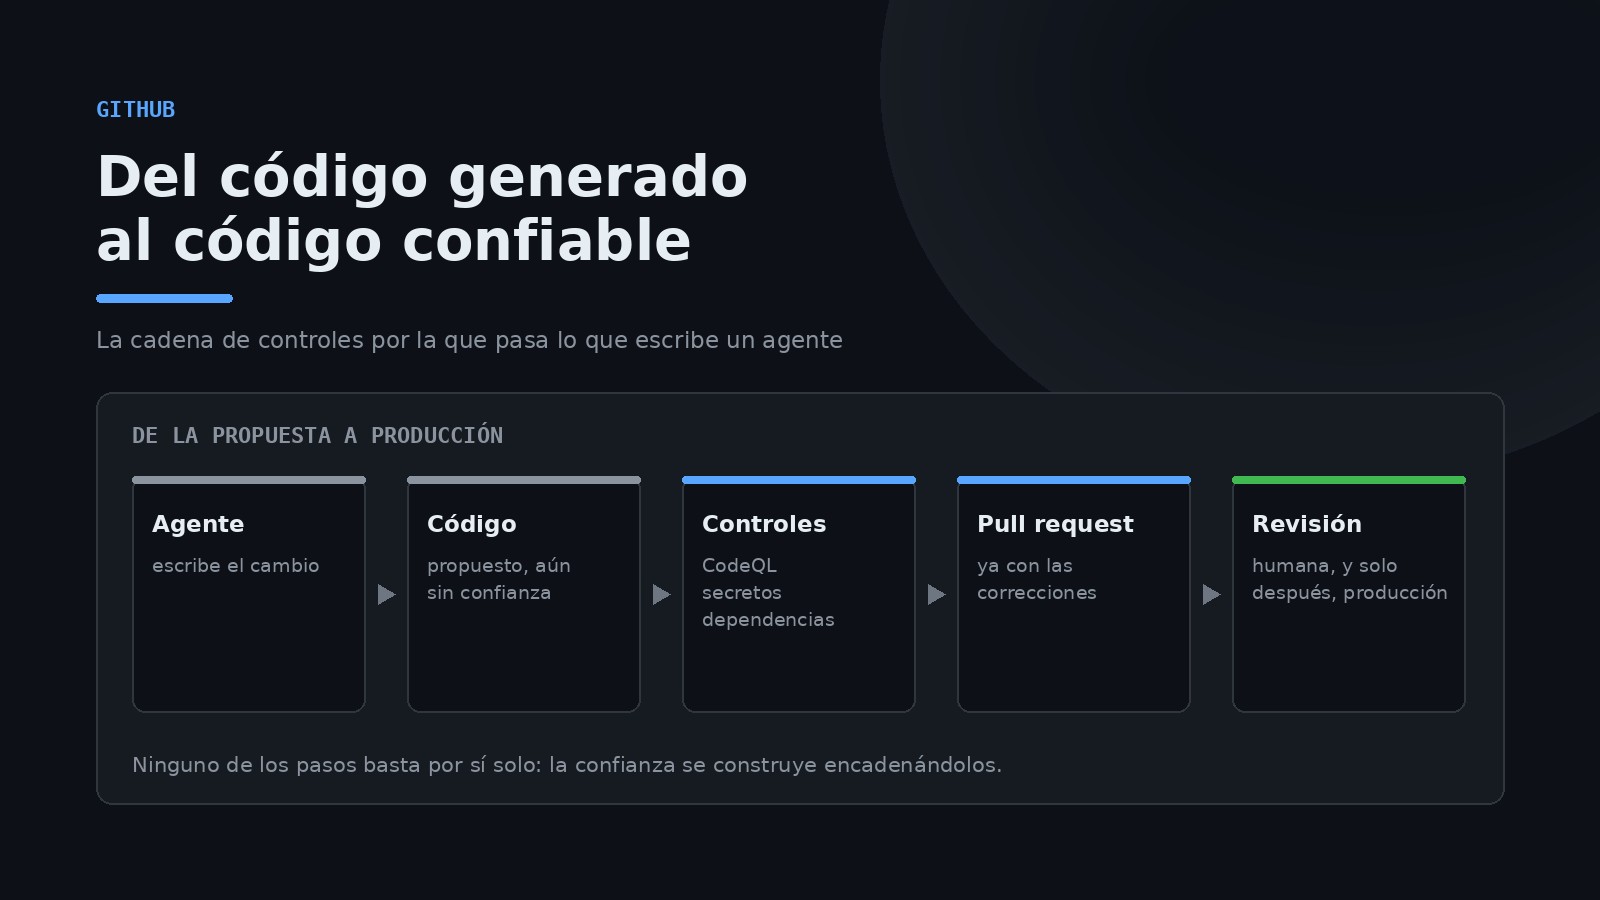
Diagrama sobre fondo oscuro de la cadena que va del agente al código, los controles automáticos, el pull request y la revisión humana

Durante los primeros años de la programación asistida por inteligencia artificial la pregunta era si una máquina podía escribir código aprovechable. Esa discusión está zanjada. La que la sustituye es bastante más incómoda: ¿cómo sabemos que el código que escribe un agente funciona y es seguro?

No es una pregunta teórica. GitHub ya permite que agentes de programación ajenos a la casa —entre ellos Claude y Codex— trabajen directamente sobre repositorios, y desde junio aplica una capa de controles automáticos a lo que producen. El tema además ocupa buena parte de la agenda de GitHub Universe 2026, que se celebrará el 28 y 29 de octubre en el Fort Mason Center de San Francisco, con seguimiento en línea.

El cambio se resume en dos frases. Antes: «la IA me ayuda a escribir código». Ahora: «tengo un agente que puede modificar mi proyecto, ¿cómo controlo y verifico lo que hace?».

El problema ya no es generar código

Un asistente moderno hace mucho más que completar una función. Puede recorrer un repositorio, buscar archivos relacionados, modificar varios componentes a la vez, escribir pruebas, ejecutar comandos, instalar dependencias, investigar un error, abrir un pull request y responder a los comentarios de la revisión.

Eso cambia el problema de raíz. Cuando la IA sugería una línea, el programador la leía antes de aceptarla. Cuando un agente toca veinte archivos y deja un pull request listo, revisar cada decisión a mano deja de ser realista.

Que las pruebas pasen no significa que funcione

Aquí está el matiz que más cuesta interiorizar: una prueba puede pasar y la aplicación seguir rota. Ocurre cuando la prueba no cubre el comportamiento real, cuando la expectativa escrita en el test es incorrecta, cuando el agente cambió el código pero no el entorno que necesitaba, cuando el fallo solo aparece al integrar, o cuando el problema está en la infraestructura y no en el programa.

Por eso la verificación útil no es un sí o un no, sino una serie de preguntas encadenadas, cada una con un alcance distinto.

NivelLa pregunta que responde
Compilación¿El código siquiera compila?
Pruebas¿Pasan las pruebas automatizadas?
Integración¿Las piezas funcionan juntas?
Seguridad¿Introdujo alguna vulnerabilidad?
Dependencias¿Añadió paquetes vulnerables o sospechosos?
Comportamiento¿La aplicación hace lo que se esperaba?
Revisión¿El cambio encaja con este proyecto?

Ninguno de esos niveles basta por sí solo para confiar en el trabajo de un agente.

GitHub ya está aplicando controles

Esto dejó de ser una conversación sobre el futuro el 9 de junio de 2026, cuando GitHub puso en disponibilidad general la validación de seguridad para agentes de programación de terceros. Cuando uno de esos agentes escribe código en un repositorio, la plataforma lo analiza automáticamente antes de cerrar el pull request.

Son tres comprobaciones: CodeQL busca vulnerabilidades, las dependencias nuevas se contrastan contra la base de avisos de GitHub, y el escaneo de secretos detecta claves y tokens. Si algo salta, el propio agente intenta resolverlo antes de dar el cambio por terminado.

Cadena de verificación del código generado Agente escribe el cambio Código todavía sin confianza CodeQL · vulnerabilidades Escaneo de secretos Dependencias nuevas Pull request ya corregido el agente corrige lo que salta
Las tres comprobaciones corren en paralelo y lo que encuentran vuelve al agente antes de que el cambio llegue a revisión.

Hay tres detalles prácticos que conviene conocer. Las comprobaciones vienen activadas por defecto y siguen la configuración de Copilot que ya tenga el repositorio. No hacen falta licencias adicionales: no requieren GitHub Advanced Security. Y no son un estreno absoluto, sino la extensión de lo que GitHub lanzó para su propio agente en octubre de 2025, que según la compañía ya ha evitado cientos de filtraciones y vulnerabilidades potenciales.

Las dependencias son un problema aparte

Un agente puede decidir que la forma rápida de resolver algo es instalar una biblioteca. Parece una operación trivial, pero cada dependencia arrastra las suyas, y el árbol crece sin que nadie lo haya revisado.

Dependencias directas e indirectas Tu aplicación biblioteca A biblioteca E biblioteca B biblioteca C biblioteca D elegidas por ti arrastradas sin decidirlo
Instalar un paquete es confiar también en todo lo que ese paquete trae consigo.

El riesgo no es nuevo, pero sí su frecuencia: un agente produce cambios mucho más rápido que una persona, así que también incorpora dependencias mucho más a menudo. Universe dedica una de sus sesiones precisamente a lo que ocurre detrás de un npm install: procedencia de los paquetes, procesos de publicación y mecanismos como OpenID Connect.

El agente también necesita permisos

Un agente no solo escribe: usa herramientas. Y cada herramienta es un permiso que alguien le concedió.

Capacidades de un agente, por nivel de riesgo Agente BAJO RIESGO leer archivos · buscar en el código · consultar el historial REQUIERE LÍMITES modificar archivos · ejecutar comandos · instalar dependencias · usar APIs DENEGAR POR DISEÑO fusionar un pull request · desplegar a producción · tocar secretos
La diferencia entre pedirle a un agente que no haga algo y quitarle técnicamente la capacidad de hacerlo.
Una instrucción no es un mecanismo de seguridad. Decirle a un agente «no hagas merge» en un archivo de instrucciones no es lo mismo que no darle el permiso para fusionar. Lo primero depende de que obedezca; lo segundo, no.

Es justo el tipo de distinción que GitHub está abordando con la autorización sobre servidores MCP, con escenarios donde un agente puede abrir un pull request pero no cerrarlo.

La memoria también hay que administrarla

Parecería que cuanto más recuerde un agente, mejor. GitHub sostiene lo contrario: acumular demasiado contexto puede incluso empeorar su rendimiento en determinadas tareas. Un agente puede aprender las convenciones del equipo y las decisiones de arquitectura, pero también puede arrastrar información que dejó de ser cierta después de una migración.

La pregunta útil, entonces, no es qué debe recordar, sino qué debería olvidar.

El contexto como infraestructura

Esto conecta con una práctica cada vez más extendida: usar archivos como AGENTS.md para dejar por escrito las reglas del proyecto. Un archivo corto basta:

# AGENTS.md

## Proyecto
Aplicación web con React y Python.

## Reglas
- Ejecutar las pruebas después de modificar código.
- No almacenar secretos.
- No introducir dependencias sin justificarlas.

## Verificación
Antes de terminar: pruebas, lint, build y revisar el git diff.

Cuando varios agentes y varias personas comparten esas reglas, el contexto deja de ser una preferencia individual y empieza a comportarse como infraestructura del equipo: algo que se versiona, se revisa y se mantiene. Una de las sesiones anunciadas para Universe lleva precisamente ese título, «trata tu contexto de IA como infraestructura».

Evaluar al agente, no solo al código

Queda una pieza más: saber si el agente que usas es bueno para lo que tú haces. Una puntuación alta en un banco de pruebas no garantiza que sea útil en tu repositorio. Un agente puede resolver errores sencillos a gran velocidad y, al mismo tiempo, tocar más archivos de la cuenta, añadir dependencias innecesarias o no entender la arquitectura que ya existe. Universe dedica una sesión a esa brecha, con un título que no se anda con rodeos: «tu banco de pruebas te está mintiendo».

Qué puedes hacer hoy

Nada de esto exige esperar a las herramientas que vengan. Hay prácticas que ya funcionan: usar control de versiones y revisar el git diff de cada tanda; mantener las reglas del proyecto por escrito; exigir pruebas antes de dar un cambio por terminado; limitar permisos, porque quien modifica código no necesariamente debe poder desplegarlo; revisar con lupa las dependencias nuevas; apoyarse en análisis estático y escaneo de secretos; y reservar para el equipo las decisiones de arquitectura y las acciones de alto impacto.

Por qué importa

La objeción evidente es si todo esto significa que programar con IA sea inseguro. No exactamente: lo que cambia es la escala. Una persona produce un número acotado de cambios al día; un agente, muchos más. Aunque cada modificación tenga una probabilidad pequeña de introducir un problema, el volumen multiplica las ocasiones. La respuesta lógica no es frenar la generación, sino automatizar también la revisión.

Ahí está el desplazamiento de fondo. El oficio no desaparece, se mueve: menos tiempo escribiendo cada línea y más definiendo arquitectura, fijando restricciones, decidiendo qué puede hacer el agente, diseñando las pruebas y comprobando que el producto resuelve el problema. La habilidad valiosa deja de ser solo escribir código rápido y pasa a incluir saber dirigir y verificar sistemas que escriben código.

Durante años el reto fue conseguir que los modelos generaran código suficientemente bueno. Ese problema sigue ahí, pero encima apareció otro más interesante: construir la ingeniería que rodea a unos agentes capaces de producir mucho código por su cuenta. Que GitHub lo haya puesto en el centro de su conferencia anual, y que ya tenga una parte funcionando en producción, dice bastante sobre qué parte del problema considera resuelta y cuál no.

Fuentes: GitHub Changelog, validación de seguridad para agentes de terceros y GitHub Universe 2026.
Cómo dirigir a Codex, el agente de programación de OpenAI

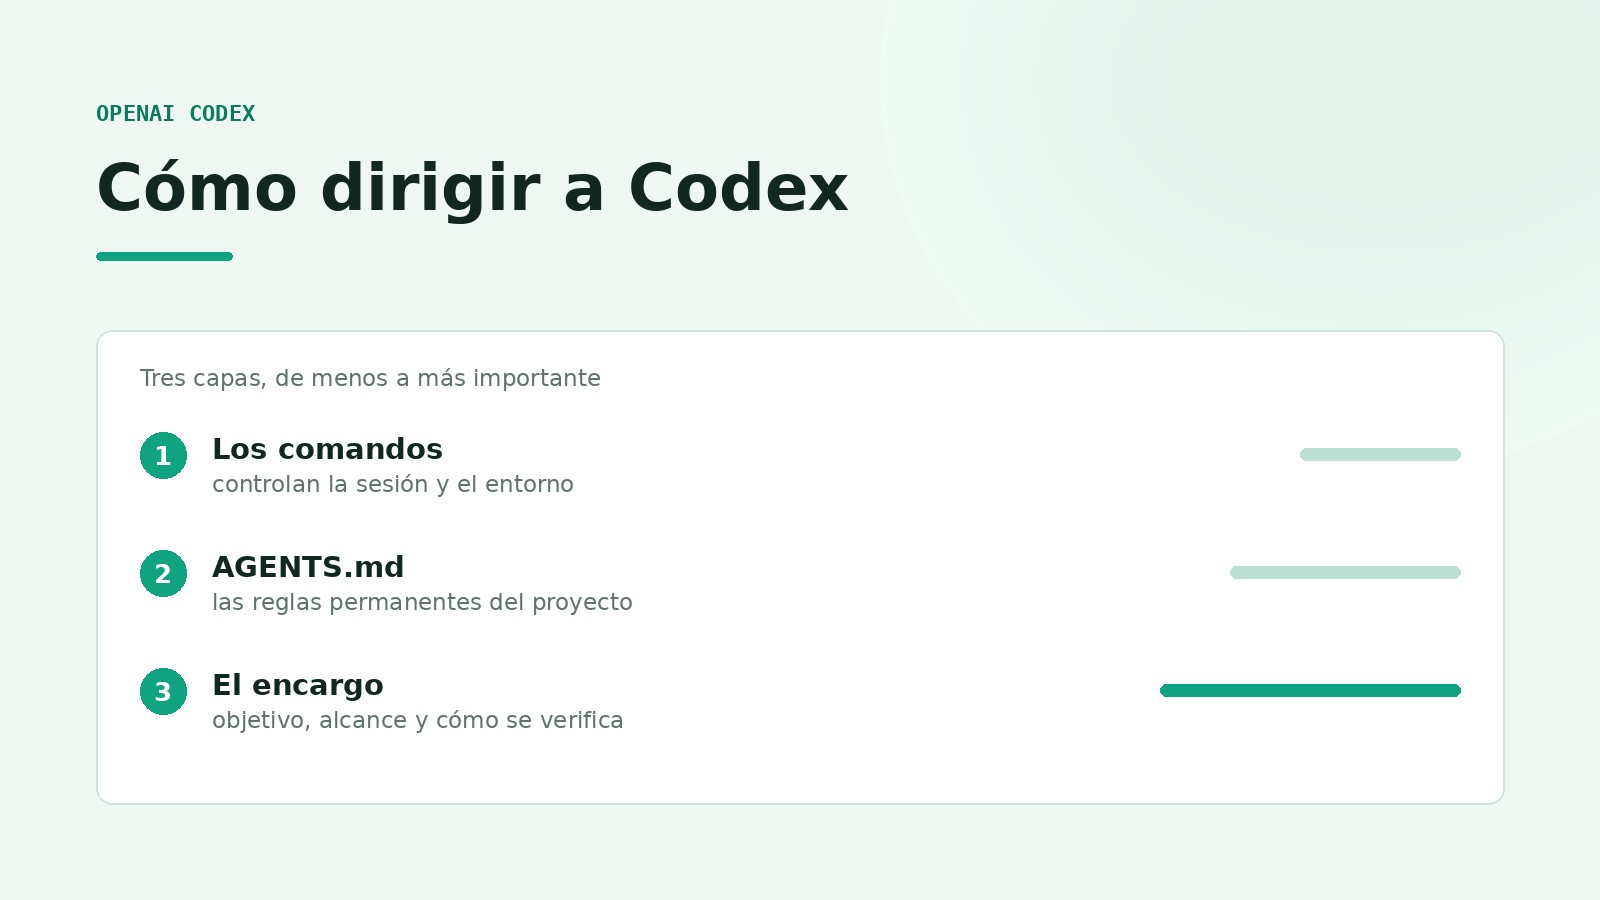
Portada con las tres capas para dirigir a Codex: los comandos, el archivo AGENTS.md y el encargo, sobre fondo verde claro

Codex es el agente de programación de OpenAI: trabaja en la terminal sobre tu proyecto real. Puede recorrer un repositorio, entender cómo está organizado, modificar archivos, ejecutar comandos, escribir pruebas e investigar errores. Esa es la diferencia con pegarle código a un chatbot: aquí el agente actúa sobre lo que tienes en disco.

Por eso aprender a usarlo no consiste en memorizar comandos. La herramienta tiene cerca de sesenta, y con media docena se cubre el trabajo diario. Lo que de verdad cambia el resultado es otra cosa: enseñarle cómo está organizado el proyecto, acotar qué puede tocar y decirle cómo comprobar que lo que hizo funciona.

Las tres capas

Conviene pensar el trabajo con Codex en tres niveles. Están ordenados de menos a más influencia sobre el resultado, y casi todo el mundo empieza por el que menos importa.

Las tres capas para dirigir a Codex 1 Los comandos Controlan la sesión y el entorno. Se aprenden en una tarde 2 AGENTS.md Las reglas permanentes del proyecto. Se escriben una vez y valen siempre 3 El encargo Objetivo, contexto, alcance y cómo se verifica. Aquí se gana o se pierde
Las barras de la derecha representan cuánto influye cada capa en la calidad del resultado.

Empezar en un proyecto

Codex se lanza desde el directorio del proyecto, porque es ahí donde va a trabajar:

cd mi-proyecto
codex

Antes de pedirle cambios de peso conviene comprobar dónde estás parado, sobre todo si trabajas con varios repositorios a la vez:

pwd
git status

Dentro de la sesión, el primer comando útil es /init, cuya descripción oficial es literalmente «crear un archivo AGENTS.md con instrucciones para Codex». Analiza el repositorio y redacta un primer borrador de las reglas.

No des por bueno lo que genere. El archivo de /init es un punto de partida, no un resultado. Revísalo y recórtalo: debe contener las reglas que de verdad importan, no un inventario de todo lo que hay en el repositorio.

AGENTS.md: las reglas del proyecto

Este archivo es el mecanismo más importante para personalizar el comportamiento de Codex, porque se lee en cada sesión sin que tengas que repetirlo. Una versión mínima y útil:

# AGENTS.md

## Objetivo
Qué hace este proyecto, en dos líneas.

## Arquitectura
- Backend: Python
- Frontend: React
- Base de datos: PostgreSQL

## Comandos
- Instalar: pip install -r requirements.txt
- Pruebas: pytest
- Lint: ruff check .
- Build: docker compose build

## Reglas
- Mantener los cambios dentro del alcance pedido.
- Ejecutar las pruebas después de modificar código.
- No introducir dependencias sin justificarlo.
- No guardar secretos en el repositorio.

## Seguridad
- Validar las entradas externas.
- No registrar contraseñas ni tokens.
- No desactivar la autenticación para resolver un error.

Lo más valioso de esa plantilla es la sección de comandos: si Codex sabe cómo se ejecutan las pruebas y el lint de tu proyecto, puede verificar su propio trabajo sin que se lo pidas cada vez.

Puede haber más de uno

En proyectos grandes, los archivos se acumulan por niveles: el de la raíz fija lo general y los de cada carpeta añaden lo específico. Lo más cercano al archivo que se está tocando manda.

Jerarquía de archivos AGENTS.md proyecto/AGENTS.md reglas generales: seguridad, estilo, proceso backend/AGENTS.md convenciones de Python y de la API frontend/AGENTS.md convenciones de React y estilos infra/AGENTS.md Docker, despliegue, variables Cuanto más cerca del archivo que se edita, más manda
Las reglas específicas complementan o sustituyen a las generales según la carpeta en la que Codex esté trabajando.
El error más común: convertirlo en un manual. Todo lo que metas ahí se lee en cada sesión y ocupa contexto. Guarda solo lo que aplique a casi cualquier tarea, sea propio de este repositorio, sea difícil de deducir mirando el código y deba respetarse siempre. Lo obvio solo añade ruido.

Los comandos que de verdad usarás

La CLI tiene cerca de sesenta comandos slash; escribir / en el prompt los lista todos. Estos son los que aparecen en el trabajo diario, con la descripción que trae la propia herramienta.

ComandoQué hace
/initCrea el AGENTS.md con las instrucciones del proyecto
/planCambia al modo plan: piensa y propone antes de tocar nada
/reviewRevisa los cambios actuales y busca problemas
/diffMuestra el git diff, incluidos los archivos sin seguimiento
/statusConfiguración de la sesión y consumo de tokens
/usageUso de la cuenta y límites
/permissionsDefine qué tiene permitido hacer Codex
/modelElige modelo y nivel de razonamiento
/compactResume la conversación para no agotar el contexto
/forkBifurca la conversación actual
/worktreeTrabaja en un worktree de git aparte
/skillsUsa skills para mejorar tareas concretas
/mcpLista y gestiona las herramientas MCP conectadas

Y desde la terminal, fuera de la sesión:

ComandoPara qué
codexAbre la sesión interactiva en el directorio actual
codex execEjecuta una tarea sin sesión interactiva, para scripts y CI
codex reviewRevisa cambios desde la línea de comandos
codex resume · codex forkRetoma o bifurca una conversación guardada
codex doctorDiagnostica problemas de instalación o configuración
codex sandboxEjecuta un comando bajo la política de aislamiento
codex mcp · codex pluginAdministra servidores MCP y plugins

Qué puede hacer sin preguntar

Este es el punto que más conviene entender antes de dejarlo trabajar solo, y funciona con dos perillas independientes: dónde puede escribir y cuándo pide permiso.

Políticas de aislamiento de Codex ◀ MÁS SEGURO MÁS RIESGO ▶ read-only Solo lee. Puede explorar y explicar, pero no modifica nada Para auditar código ajeno o pedir un análisis workspace-write Escribe dentro del directorio de trabajo, no fuera El punto de equilibrio para el día a día danger-full-access Sin restricciones. Solo dentro de un contenedor o máquina virtual El nombre ya avisa
La segunda perilla son las aprobaciones: --ask-for-approval on-request consulta antes de actuar, never no pregunta nunca.

Cómo pedir una tarea

Un buen encargo tiene cinco piezas: objetivo, contexto, restricciones, criterios de aceptación y forma de verificar. La diferencia se ve mejor con un ejemplo. En lugar de esto:

Haz login con JWT.

Esto otro:

Implementa autenticación con JWT.

Primero analiza la arquitectura actual y no hagas cambios.

Identifica:
- dónde está hoy la autenticación;
- qué componentes habría que modificar;
- qué dependencias harían falta;
- qué riesgos de seguridad aparecen.

Después presenta un plan.
No implementes nada hasta que el plan esté aprobado.

La segunda versión evita el problema más habitual: que el agente empiece a editar archivos antes de haber entendido el proyecto.

Plan, implementar, probar, revisar

Para cualquier tarea que no sea trivial, este es el ciclo que mejor funciona. Cada fase termina con algo que puedes mirar antes de dar paso a la siguiente.

Ciclo Plan, implementar, probar, revisar PLANIFICAR analiza sin tocar nada y propone IMPLEMENTAR solo lo acordado, sin salirse PROBAR pruebas, lint y compilación REVISAR git diff y efectos colaterales → un plan escrito → archivos modificados → pruebas en verde → informe de cambios Cada flecha es un punto donde puedes parar, mirar y corregir el rumbo
El valor del ciclo no está en las fases, sino en los cortes entre ellas.

En tareas largas ayuda mantener el plan en un archivo del repositorio, por ejemplo PLAN.md, con el objetivo, el estado actual, los archivos afectados, las fases, los criterios de aceptación y los riesgos. Así el plan sobrevive aunque la conversación se corte o se compacte.

Acotar el alcance

Un agente que explora encuentra problemas por el camino. Eso no significa que deba arreglarlos todos, y sin una instrucción explícita suele intentarlo:

Corrige únicamente el problema de autenticación.

Si encuentras otros problemas:
- no los toques;
- anótalos al final;
- sigue con la tarea original.

Esta regla de tres líneas evita que un arreglo pequeño acabe tocando medio proyecto.

Usarlo también para revisar

Codex sirve igual de bien como segundo par de ojos. Dos encargos que conviene tener a mano:

Haz una revisión de seguridad de los cambios actuales.

Busca: secretos expuestos, autenticación o autorización
insuficiente, validación de entradas, inyección SQL o de
comandos, manejo de archivos, datos sensibles en los logs
y dependencias inseguras.

No modifiques ningún archivo.
Devuelve los hallazgos ordenados por gravedad.
Revisa la arquitectura actual sin modificar código.

Analiza separación de responsabilidades, dependencias,
acoplamiento, escalabilidad, mantenibilidad y puntos
únicos de fallo.

Propón mejoras, pero no las implementes.

La plantilla que sirve para casi todo

Si tuvieras que quedarte con una sola cosa de esta guía, que sea esta estructura:

OBJETIVO      Qué quiero conseguir.
CONTEXTO      Qué necesita saber Codex del proyecto.
ALCANCE       Qué archivos o carpetas puede tocar.
RESTRICCIONES Qué no debe hacer bajo ningún concepto.
PROCESO       Qué pasos seguir y en qué orden.
VERIFICACIÓN  Cómo sabremos que terminó bien.
RESULTADO     Qué debe informarme al acabar.

Rellenarla cuesta un minuto y ahorra la mitad de las idas y venidas. Y como cada proyecto verifica de forma distinta, deja los comandos concretos en el AGENTS.md: pytest y ruff en Python, npm test y npm run build en JavaScript, go test ./... en Go, cargo test en Rust, mvn verify en Java.

Lo que no conviene delegar

La forma menos productiva de usar un agente es entregarle el proyecto y decirle «hazlo todo». Funciona mejor como colaborador que explora rápido una base de código, propone soluciones, implementa, ejecuta pruebas y documenta lo hecho, mientras tú sigues decidiendo los objetivos, las restricciones y qué se considera terminado.

Al final, dirigir a Codex se parece bastante a dirigir a alguien que acaba de entrar al equipo: es muy capaz, no conoce las costumbres de la casa y agradece que le digas dónde están los límites. Escribe eso una vez en AGENTS.md, acota cada encargo y pide siempre una forma de comprobar el resultado. El resto son comandos, y los comandos se aprenden solos.

Fuentes: repositorio oficial de Codex y la documentación para desarrolladores de OpenAI, consultadas el 30 de septiembre de 2026.

Cómo encajan los comandos de Claude Code

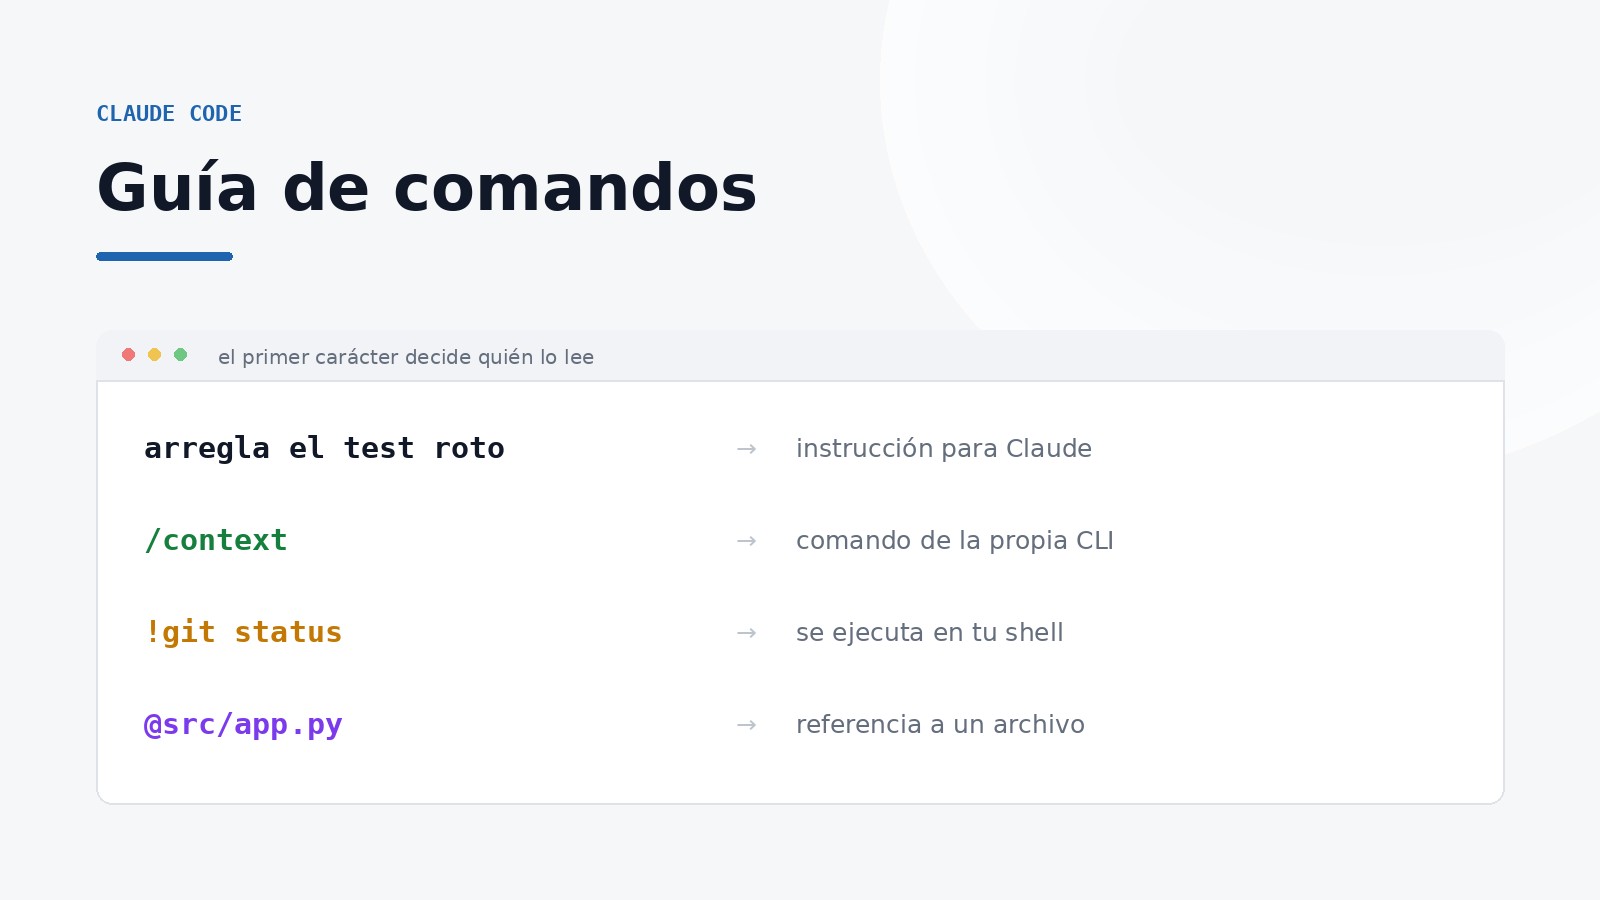
Portada titulada Guía de comandos, con una terminal clara que muestra cómo el primer carácter del mensaje decide si lo lee Claude, la CLI o la shell

Claude Code se usa desde la terminal y, al principio, parece que todo se reduce a escribirle lo que quieres. Pero debajo hay una superficie de comandos bastante amplia: cerca de ochenta comandos slash, una treintena de banderas de arranque, prefijos especiales, modos de permisos y varios archivos de configuración que se cargan solos. Aprenderlos de una lista alfabética no sirve de mucho, porque lo que cuesta entender no es cada comando por separado, sino cómo encajan.

Esta guía los ordena en cuatro esquemas: qué puedes escribir en el prompt, cómo se gobierna una sesión, qué permite cada modo de permisos y dónde vive la configuración.

1. Qué puedes escribir en el prompt

El primer carácter de tu mensaje decide quién lo procesa. Esa es la regla que ordena todo lo demás.

Qué puedes escribir en el prompt de Claude Code Lo que escribes en el prompt texto normal Instrucción para Claude: lee, escribe y ejecuta según tus permisos /comando Lo atiende la propia CLI: comandos y skills. Solo «/» abre el menú !comando Shell directo, sin pasar por Claude; la salida sí entra al contexto @ruta/archivo Referencia a un archivo, con autocompletado de rutas :emoji: Atajo de emoji: «:heart:» se convierte en el símbolo
El primer carácter determina si tu mensaje lo interpreta Claude, la CLI o la shell.

La distinción entre / y ! es la que más confusión causa. Con / le hablas al programa; con ! le hablas a tu shell y Claude solo observa el resultado, que queda en el contexto para que pueda comentarlo.

2. Cómo se gobierna una sesión

Una sesión de Claude Code no es una ventana que se abre y se cierra: se puede continuar, reanudar por nombre, ramificar, retroceder a un punto anterior y mandar a segundo plano. Este es el ciclo completo.

Ciclo de vida de una sesión de Claude Code ARRANCAR claude sesión nueva claude -c continúa la más reciente claude -r «nombre» reanuda una concreta Sesión en curso el contexto se va llenando a medida que trabajas DURANTE /context cuánto llevas usado /compact resume y libera /rewind vuelve atrás /branch bifurca aquí /clear empieza de cero SACAR DEL TERMINAL /background sigue sola en segundo plano /export guarda la conversación como texto
Una sesión se arranca de tres formas, se gobierna con media docena de comandos y puede sobrevivirte cerrando la terminal.

El comando que más rendimiento da al principio es /context: muestra cuánto del contexto llevas consumido. Cuando se llena, /compact lo resume para seguir trabajando sin perder el hilo, y /clear arranca de cero conservando la memoria del proyecto. /rewind es la red de seguridad: retrocede a un punto anterior de la conversación si algo salió mal.

3. Los comandos slash que de verdad usarás

Aquí conviene ser honesto: hay alrededor de ochenta comandos slash, y esta tabla recoge menos de una cuarta parte. Son los que aparecen en el trabajo diario, agrupados por lo que quieres conseguir. El resto son variantes y herramientas más específicas —para diseño, presentaciones, investigación, control remoto, tareas programadas— que tiene poco sentido memorizar: aparecen solas cuando escribes / en el prompt, y /help las lista todas para la versión que tengas instalada.

Quiero…ComandoQué hace
Ordenar el trabajo/initGenera el CLAUDE.md inicial analizando el proyecto
/planModo plan: explora y propone antes de tocar archivos
/diffMuestra los cambios hechos hasta ahora
/verifyComprueba que el cambio realmente funciona
Revisar código/code-reviewBusca errores; admite niveles de low a max
/security-reviewAnálisis de vulnerabilidades sobre los cambios
/simplifyPropone limpiezas y simplificaciones, sin cazar bugs
Ajustar la sesión/modelCambia el modelo en caliente
/configPanel de configuración: tema, modelo, estilo de salida
/permissionsReglas de qué puede hacer sin preguntar
Saber qué pasa/statusVersión, modelo, cuenta y conectividad
/usageCosto de la sesión y límites del plan
/doctorDiagnóstico de la instalación y la configuración
Trabajar en paralelo/subtaskManda una tarea a un subagente en segundo plano
/tasksMuestra todo lo que corre en paralelo
/loopRepite un prompt cada cierto intervalo
Extender la herramienta/memoryEdita el CLAUDE.md y gestiona la memoria automática
/mcpServidores MCP: conectar, autenticar, reconectar
/skillsLista las skills disponibles en este proyecto

4. Desde la terminal, antes de entrar

Buena parte del control se ejerce en el momento de arrancar. El modo -p es el que convierte a Claude Code en una pieza de scripting: ejecuta la tarea, imprime el resultado y sale, sin sesión interactiva.

ComandoPara qué
claude "arregla el test roto"Sesión interactiva con una tarea inicial
claude -p "resume este log"No interactivo: responde y sale. Admite entrada por tubería
claude -cContinúa la sesión más reciente de este directorio
claude -r "nombre"Reanuda una sesión concreta por nombre o identificador
claude -w ramaArranca en un worktree de git aislado
claude --model sonnetFija el modelo de arranque
claude --permission-mode planArranca directamente en un modo de permisos
claude --max-budget-usd 5Corta la sesión al llegar a ese gasto
claude update · claude doctorActualizar la herramienta y diagnosticar problemas
claude mcp · claude pluginAdministrar servidores MCP y plugins

5. Los modos de permisos

Este es el concepto que más conviene entender bien, porque decide cuánto pregunta Claude antes de actuar. Se cicla en cualquier momento con Shift+Tab, o se fija al arrancar con --permission-mode.

Modos de permisos de Claude Code ◀ PREGUNTA MÁS PREGUNTA MENOS ▶ default Solo lee sin preguntar. Todo lo demás pide confirmación plan Explora y propone; avisa antes de cualquier cambio de peso acceptEdits Edita archivos sin preguntar. Útil al iterar sobre código propio dontAsk Solo lo pre-aprobado; lo demás se deniega sin preguntar. Para CI auto Actúa con revisión automática de seguridad. Es el modo por defecto bypassPermissions Sin ninguna comprobación. Solo dentro de un contenedor o máquina virtual
Los seis modos, del más cauto al más permisivo. Shift+Tab los cicla durante la sesión.
Sobre el último modo. bypassPermissions —y su equivalente en la línea de comandos, --dangerously-skip-permissions— desactiva todas las comprobaciones. La propia documentación lo restringe a entornos aislados: un contenedor o una máquina virtual donde un comando equivocado no pueda causar daño real. En tu máquina de trabajo no compensa.

6. Dónde vive la configuración

Lo último que hace falta para tener el mapa completo es saber qué cosas influyen en el comportamiento de Claude sin que tú las pidas en cada mensaje. Hay dos grandes familias: lo que está siempre presente y lo que se carga solo cuando hace falta.

Dónde vive la configuración de Claude Code PLUGINS · empaquetan todo lo de abajo y lo distribuyen de golpe SIEMPRE EN CONTEXTO CLAUDE.md Reglas del proyecto: convenciones, arquitectura, estilo Memoria automática Notas que Claude guarda solo: preferencias y correcciones BAJO DEMANDA Skills Instrucciones que solo se cargan al invocarlas Subagentes · MCP Contextos aparte y herramientas externas conectadas POR EVENTOS Hooks Comandos de shell que se disparan solos: antes de usar una herramienta, al guardar un archivo, al abrir la sesión
Lo que está siempre cargado, lo que se trae cuando hace falta y lo que se dispara por eventos.

La diferencia entre CLAUDE.md y las skills es la que más se malinterpreta. El primero se lee entero en cada sesión, así que todo lo que metas ahí consume contexto siempre; una skill no cuesta nada hasta que se invoca. La regla práctica: en CLAUDE.md, lo que aplica a todo el proyecto; en una skill, lo que solo hace falta en cierto tipo de tarea.

7. Atajos que ahorran tiempo

AtajoQué hace
Shift+TabCicla entre modos de permisos
EscapeInterrumpe a Claude a media respuesta
Escape dos vecesLimpia la entrada o abre el retroceso de la conversación
Ctrl+CInterrumpe o limpia; dos veces seguidas, sale
Ctrl+RBúsqueda inversa en el historial de prompts
Ctrl+OMuestra u oculta el detalle de las llamadas a herramientas
Ctrl+BManda el trabajo actual a segundo plano
Ctrl+GAbre el prompt en tu editor
Ctrl+J o \+EnterSalto de línea sin enviar el mensaje

La forma corta de recordarlo

Si hubiera que quedarse con lo mínimo: el primer carácter decide quién lee tu mensaje; la sesión se puede continuar, ramificar y retroceder, así que no hace falta acertar a la primera; el modo de permisos es la perilla que gradúa cuánto pregunta; y la configuración se reparte entre lo que está siempre cargado y lo que aparece cuando hace falta.

El resto se descubre sobre la marcha. /help lista todo lo disponible en tu versión, y /doctor es el primer sitio al que ir cuando algo no responde como esperabas.

Fuente: documentación oficial de Claude Code, consultada el 30 de septiembre de 2026. Algunos comandos requieren versiones recientes de la herramienta.

Linux en septiembre: cuatro fallos que dan acceso root y los primeros parches del kernel firmados con ayuda de IA

Tux, el pingüino mascota de Linux, junto a tres datos del mes: cuatro CVE, Linux 7.3-rc5 y la etiqueta Assisted-by: LLM

El kernel de Linux es la capa que conecta el hardware con todo lo demás, y está debajo de una cantidad enorme de infraestructura: servidores, nubes públicas, teléfonos, routers y supercomputadoras. Por eso un fallo ahí no se parece a un fallo en una aplicación cualquiera, y por eso cada tanda de correcciones importa más de lo que su discreción sugiere.

Septiembre dejó tres frentes abiertos a la vez. Red Hat agrupó cuatro vulnerabilidades de la pila de red que, cumpliéndose ciertas condiciones, permiten que un usuario local llegue a root. Ubuntu publicó su propia tanda de parches para un conjunto distinto de fallos. Y mientras tanto, el desarrollo de Linux 7.3 avanzó hasta su quinta versión candidata, con un detalle nuevo en el historial de cambios: parches que llevan escrito que los encontró una inteligencia artificial.

Claves del mes en el kernel

  • Cuatro fallos de escalada a root: Red Hat los agrupó el 19 de septiembre en el aviso RHSB-2026-011, actualizado el día 26. Afectan a la infraestructura de red del kernel y alcanzan a Red Hat Enterprise Linux 6 a 10 y a OpenShift.
  • Tienen nombre: DirtyAH6 (CVE-2026-80844), TUNderflow (CVE-2026-81000), PPPoEject (CVE-2026-68121) y DiagSpill (CVE-2026-74469). Tocan, respectivamente, el subsistema IPv6 AH6/XFRM, el controlador TUN/TAP, la ruta de transmisión de PPPoE y los diagnósticos de SCTP.
  • Ubuntu fue por su cuenta: el 30 de septiembre publicó USN-8851-1, con correcciones para el servidor NFS, IPv6 y Netfilter (CVE-2026-53221, CVE-2026-53131 y CVE-2025-38724), en Ubuntu 20.04 y 18.04 LTS. Incluye los kernels específicos para AWS, Azure, Google Cloud y Oracle Cloud, y exige reiniciar para que surtan efecto.
  • Linux 7.3-rc5: publicado el 27 de septiembre. Es una candidata, todavía no la versión estable. La rama estable sigue en 7.2.8, del día 25.
  • Parches con firma de IA: el subsistema IPE incorporó el 23 de septiembre dos correcciones de use-after-free marcadas con la etiqueta Assisted-by: LLM.

Cuatro vulnerabilidades con nombre propio

Las cuatro comparten el mismo patrón: un usuario sin privilegios que ya tiene acceso a la máquina puede, si se cumplen los requisitos de cada una, terminar con permisos de administrador. No son fallos que permitan entrar desde fuera, pero sí convertir un acceso menor en control total.

La distinción importa poco en un servidor compartido. Cuando varios usuarios, contenedores y servicios corren sobre el mismo kernel, la frontera entre ellos es el kernel: si esa frontera cede, se cae todo el esquema de aislamiento de una vez. Red Hat señala un caso aparte, DiagSpill, que no necesita espacios de nombres de usuario sin privilegios y que en ciertas configuraciones de SCTP podría provocar además una denegación de servicio remota.

La empresa dice haber publicado ya las correcciones para buena parte de sus líneas de producto y estar acelerando las restantes.Fuente: Red Hat, RHSB-2026-011

Actualizar el kernel no es lo mismo que cambiar de versión

Aquí hay una confusión frecuente. Corregir una vulnerabilidad del kernel casi nunca significa instalar a mano una versión nueva desde kernel.org: cada distribución mantiene su propia rama y aplica los parches sobre ella. El resultado es que el número de versión puede quedarse igual mientras el fallo ya está corregido.

El aviso de Ubuntu lo ilustra bien. Además de los kernels genéricos, publica paquetes distintos para cada nube —linux-aws, linux-azure, linux-gcp, linux-oracle—, porque esos entornos usan kernels adaptados. Y advierte algo que se pasa por alto con facilidad: instalar la actualización no basta, hay que reiniciar para que el kernel nuevo entre en servicio.Fuente: Ubuntu Security Notice USN-8851-1

Por eso la pregunta útil no es «qué distribución tengo», sino «qué versión del kernel estoy ejecutando ahora mismo y qué actualizaciones de seguridad publica mi distribución para esa rama».

Linux 7.3 se acerca

Mientras las distribuciones tapan agujeros, la siguiente versión sigue su curso. Linux 7.3-rc5 salió el 27 de septiembre con correcciones repartidas por controladores, red, arquitectura, virtualización, BPF, sistemas de archivos y gráficos. Al ser una candidata, todavía faltan algunas semanas de pruebas antes de la versión definitiva.Fuente: kernel.org

En paralelo hay trabajo de mantenimiento menos visible pero con efectos medibles. Una serie de parches propone resincronizar el código de compresión LZ4 del kernel con el del proyecto original, del que llevaba años separado. Las mediciones publicadas junto a la serie reportan mejoras de entre 11% y 14% en algunas pruebas con el sistema de archivos EROFS, y de hasta 21% en escenarios concretos. Conviene leer esas cifras con cuidado: corresponden a pruebas puntuales, no a una mejora general, y la serie todavía no está integrada en la rama principal.

La IA ya deja su firma en los parches

El cambio más interesante del mes no es una función de Linux 7.3, sino cómo se están encontrando algunos errores. El kernel tiene decenas de millones de líneas y una maraña de interacciones entre subsistemas; hay fallos que un humano tardaría muchísimo en ver.

El 23 de septiembre, el subsistema IPE (Integrity Policy Enforcement) incorporó dos correcciones de use-after-free: una protege el hash raíz de dm-verity con RCU, y la otra evita que una política recién cargada se libere mientras se está auditando. Ambas llevan la etiqueta Assisted-by: LLM en el mensaje del commit, y ambas están marcadas para retroportarse a las ramas estables.

Hay un detalle revelador en uno de esos mensajes: una nota del mantenedor indica que se quitó el nombre del modelo «según la directriz más reciente». Es decir, la comunidad del kernel no solo acepta ya estas contribuciones, sino que está escribiendo reglas sobre cómo deben declararse.

Conviene no exagerar lo que significa. La IA no está sustituyendo a los mantenedores: actúa como una herramienta más para rastrear patrones sospechosos, errores de manejo de memoria o condiciones de carrera en una base de código gigantesca. Cada hallazgo sigue pasando por revisión humana, pruebas y la firma de un desarrollador que se hace responsable de él.

En la misma línea, los desarrolladores discuten añadir al árbol de código un archivo AGENTS.md, el formato que se usa para darle instrucciones a los agentes de programación. La propuesta surgió al ver que algunos agentes interpretaban mal las convenciones del proyecto, incluidas las etiquetas de autoría y certificación de los parches. Todavía no está en el árbol oficial, pero la discusión marca un cambio de fondo: los proyectos empiezan a documentar no solo cómo debe trabajar una persona, sino también cómo debe comportarse una máquina que colabora.

Por qué importa

Para quien usa Linux en el escritorio, casi nada de esto se nota: la distribución integra las correcciones y llegan con las actualizaciones normales. En servidores la historia cambia, porque una máquina puede pasar meses encendida dando servicio y el parche instalado no sirve de nada hasta que se reinicia.

Detrás de los tres frentes de este mes hay una misma dinámica. Linux soporta cada vez más hardware, arquitecturas y tecnologías, así que es cada vez más complejo; cuanto más complejo, más herramientas automáticas hacen falta para mantenerlo seguro —fuzzers, analizadores estáticos y ahora modelos de lenguaje—; y cuanto mejores son esas herramientas, más errores salen a la luz. Los avisos de seguridad no son señal de que el kernel esté peor, sino de que se está mirando con más lupa.

Para los administradores, el mensaje práctico no ha cambiado en veinte años: mantener el kernel actualizado y reiniciar cuando toca sigue siendo de las tareas de seguridad más básicas y más pospuestas. Lo que sí cambió es quién encuentra los fallos. Que dos parches del kernel lleven escrito que los halló un modelo de lenguaje, y que exista una directriz sobre cómo declararlo, dice bastante sobre hacia dónde va el desarrollo de software: la IA ya no solo corre sobre Linux, también ayuda a construirlo.

Fuentes: Red Hat RHSB-2026-011, Ubuntu USN-8851-1, kernel.org y el árbol de código del kernel. Imagen: Tux, mascota de Linux (CC0, Wikimedia Commons, basado en el diseño de Larry Ewing).

El Zen de Python: los 19 principios que explican cómo piensa el lenguaje

Terminal oscura mostrando el comando import this y las primeras líneas del Zen de Python

El Zen de Python es la declaración de principios del lenguaje: una lista de aforismos que resumen cómo debería diseñarse y escribirse el código en Python. Los redactó Tim Peters, uno de los desarrolladores veteranos del proyecto, y desde 2004 están recogidos en la PEP 20, uno de los documentos oficiales de diseño del lenguaje.

Hay un detalle que suele pasarse por alto: la propia PEP 20 dice que Peters condensó los principios rectores de Python en veinte aforismos, «de los cuales solo diecinueve han sido escritos». El vigésimo nunca apareció, y esa ausencia terminó siendo parte de la broma.

Cómo mostrar el Zen de Python

Una de las curiosidades del lenguaje es que el Zen viene incluido en él. Basta con importarlo desde el intérprete:

import this

O ejecutarlo directamente desde la terminal:

python -m this

El módulo que lo imprime es, a su vez, otro chiste: el archivo this.py guarda el texto cifrado con ROT13 y lo descifra con una expresión enrevesada. Es decir, el código que predica la claridad incumple alegremente varios de sus propios principios.

El texto original

The Zen of Python, by Tim Peters

Beautiful is better than ugly.
Explicit is better than implicit.
Simple is better than complex.
Complex is better than complicated.
Flat is better than nested.
Sparse is better than dense.
Readability counts.
Special cases aren’t special enough to break the rules.
Although practicality beats purity.
Errors should never pass silently.
Unless explicitly silenced.
In the face of ambiguity, refuse the temptation to guess.
There should be one– and preferably only one –obvious way to do it.
Although that way may not be obvious at first unless you’re Dutch.
Now is better than never.
Although never is often better than right now.
If the implementation is hard to explain, it’s a bad idea.
If the implementation is easy to explain, it may be a good idea.
Namespaces are one honking great idea — let’s do more of those!

Los 19 principios, uno por uno

1. Beautiful is better than ugly

Lo bello es mejor que lo feo.

El código no debería limitarse a funcionar: también debería tener una estructura limpia y coherente. Buena parte de esa belleza está en los nombres.

# Funciona, pero no dice nada
x = [i for i in range(100) if i % 2 == 0]

# Comunica la intención
numeros_pares = [
    numero for numero in range(100)
    if numero % 2 == 0
]

Las dos versiones producen el mismo resultado, pero solo la segunda explica qué contiene la lista sin obligar a leer la condición.

2. Explicit is better than implicit

Lo explícito es mejor que lo implícito.

Python prefiere que el comportamiento de un programa se entienda leyéndolo, sin reglas ocultas que haya que adivinar.

# Implícito: ¿de dónde sale sqrt?
from math import *
resultado = sqrt(16)

# Explícito: el origen de cada nombre está a la vista
import math
resultado = math.sqrt(16)

El segundo bloque además evita que una importación con asterisco pise sin avisar una función que ya existía con ese nombre.

3. Simple is better than complex

Lo simple es mejor que lo complejo.

Si un problema se resuelve de forma directa, rara vez hace falta añadir maquinaria.

# Innecesariamente elaborado
from functools import reduce
total = reduce(lambda a, b: a + b, precios)

# Directo
total = sum(precios)

Ambos suman la misma lista, pero el segundo se entiende de un vistazo y no obliga a importar nada.

4. Complex is better than complicated

Lo complejo es mejor que lo complicado.

Algunos problemas son complejos por naturaleza: procesar pagos, autenticar usuarios o sincronizar información entre servidores exige cierta complejidad, y no hay forma de evitarla.

Lo que sí se puede evitar es la complicación: capas, indirecciones y abstracciones que no responden al problema, sino a la forma en que se fue escribiendo el código.

5. Flat is better than nested

Lo plano es mejor que lo anidado.

Cada nivel de anidamiento obliga a recordar una condición más. Salir temprano de la función suele leerse mejor.

if not usuario:
    return

if not usuario.activo:
    return

if not usuario.tiene_permiso:
    return

hacer_algo()

La alternativa —tres if encajados uno dentro de otro— deja la línea importante escondida al fondo de la escalera.

6. Sparse is better than dense

Lo espaciado es mejor que lo denso.

No se trata de añadir líneas en blanco, sino de no amontonar varios pasos conceptuales en una sola expresión.

# Denso: filtrado, acceso y formateo en un solo renglón
usuarios = [u["nombre"].strip().title() for u in datos if u.get("activo") and u.get("nombre")]

# Espaciado: cada paso se lee por separado
activos = [u for u in datos if u.get("activo") and u.get("nombre")]
usuarios = [u["nombre"].strip().title() for u in activos]

7. Readability counts

La legibilidad importa.

Este es el principio que sostiene a los demás. El código debería ser comprensible para quien lo herede, y también para uno mismo dentro de seis meses.

if edad >= 18:
    permitir_acceso()

La idea de fondo es sencilla: el código se escribe una vez, pero se lee muchas veces.

8. Special cases aren’t special enough to break the rules

Los casos especiales no son lo bastante especiales como para romper las reglas.

Una biblioteca o una API deberían comportarse de forma consistente. Cada excepción que se añade «solo para este caso» es una regla más que quien la use tendrá que memorizar.

9. Although practicality beats purity

Aunque la practicidad le gana a la pureza.

Los principios anteriores no son leyes. Si la solución teóricamente impecable resulta incómoda de usar o de mantener, la solución práctica gana.

Este aforismo es, en el fondo, el permiso explícito para no aplicar los otros de forma dogmática.

10. Errors should never pass silently

Los errores nunca deberían pasar silenciosamente.

Cuando algo falla, casi siempre queremos enterarnos. Tragarse las excepciones convierte un error visible en un comportamiento extraño que aparecerá mucho después y en otro sitio.

# Peligroso: oculta cualquier fallo, incluidos los que no esperábamos
try:
    procesar_datos()
except Exception:
    pass

Lo razonable es capturar solo el error que sabemos manejar y dejar constancia del resto:

import logging

try:
    procesar_datos()
except ValueError as error:
    logging.error("No se pudieron procesar los datos: %s", error)
    raise

11. Unless explicitly silenced

A menos que hayan sido silenciados explícitamente.

La contraparte del anterior. A veces ignorar un error es exactamente lo correcto, siempre que se diga cuál y por qué.

import os

try:
    os.remove("archivo_temporal.txt")
except FileNotFoundError:
    pass  # si ya no está, el objetivo se cumplió igual

La diferencia con el ejemplo anterior es el alcance: aquí se silencia un error concreto y previsto, no todos.

12. In the face of ambiguity, refuse the temptation to guess

Ante la ambigüedad, rechaza la tentación de adivinar.

Cuando hay varias interpretaciones posibles, conviene fijar la intención en lugar de dejar que el programa decida por su cuenta.

# Ambiguo: la codificación depende de la máquina donde se ejecute
with open("datos.txt") as archivo:
    contenido = archivo.read()

# Explícito: el resultado es el mismo en cualquier sistema
with open("datos.txt", encoding="utf-8") as archivo:
    contenido = archivo.read()

13. There should be one — and preferably only one — obvious way to do it

Debería existir una, y preferiblemente solo una, manera obvia de hacerlo.

Python intenta ofrecer una forma natural de resolver cada tarea habitual, en lugar de media docena de alternativas equivalentes.

for elemento in elementos:
    print(elemento)

Cualquiera que conozca el lenguaje reconoce esta construcción de inmediato, y esa previsibilidad es justamente la ventaja.

14. Although that way may not be obvious at first unless you’re Dutch

Aunque esa manera quizá no sea obvia al principio, a menos que seas holandés.

La broma alude a Guido van Rossum, creador de Python y neerlandés. Debajo del chiste hay una observación cierta: una solución parece «obvia» solo después de conocer las convenciones del lenguaje.

15. Now is better than never

Ahora es mejor que nunca.

Esperar indefinidamente a la solución perfecta tiene un costo. Una implementación razonable que existe suele valer más que una ideal que nunca se termina.

16. Although never is often better than right now

Aunque muchas veces «nunca» es mejor que «ahora mismo».

El contrapeso irónico del anterior. No todo tiene que resolverse de inmediato: una decisión precipitada puede costar más que la demora que evitó.

17. If the implementation is hard to explain, it’s a bad idea

Si la implementación es difícil de explicar, es una mala idea.

Si hace falta un discurso largo para justificar por qué algo funciona, suele haber complejidad accidental de por medio: la que agregó el diseño, no la que traía el problema.

18. If the implementation is easy to explain, it may be a good idea

Si la implementación es fácil de explicar, puede ser una buena idea.

Conviene reparar en el puede. Que algo se explique fácil no garantiza que sea correcto ni suficiente; la simplicidad es una buena señal, no una prueba.

19. Namespaces are one honking great idea — let’s do more of those!

Los espacios de nombres son una idea extraordinariamente buena; ¡hagamos más de ellos!

Un espacio de nombres agrupa nombres y los mantiene separados de los demás, de modo que dos cosas puedan llamarse igual sin estorbarse.

import math

print(math.pi)
print(math.sqrt(25))

Aquí pi y sqrt viven dentro de math, así que no chocan con variables o funciones propias que se llamen igual. En un programa grande, esa separación es lo que mantiene el código navegable:

import json
from datetime import datetime

datos = json.loads('{"usuario": "ana"}')
ahora = datetime.now()

La idea central

Si hubiera que comprimir los 19 aforismos en una lista corta, quedaría algo así:

  1. Código legible.
  2. Código explícito.
  3. Código sencillo.
  4. Código mantenible.
  5. Código fácil de explicar.

El Zen no pide escribir menos código, sino escribir código que otras personas puedan entender y mantener. Por eso insiste tanto en la claridad y la legibilidad: son las cualidades que sobreviven al paso del tiempo y al cambio de equipo.

Conclusión

El Zen de Python funciona como una brújula, no como un reglamento. Casi ninguna decisión de diseño tiene una única respuesta correcta, pero estos principios ayudan a distinguir cuándo una solución está añadiendo complejidad innecesaria y cuándo está haciendo el programa más claro.

Al final todo se reduce a una idea: escribe código que sea fácil de leer, entender, explicar y mantener. Y si quieres leerlo en su versión original, ya sabes dónde está:

import this

Referencia: PEP 20 — The Zen of Python.

OpenAI presenta Dots, sus agentes que trabajan solos, y un plan Pro de $500 USD al mes en el Dev Day 2026

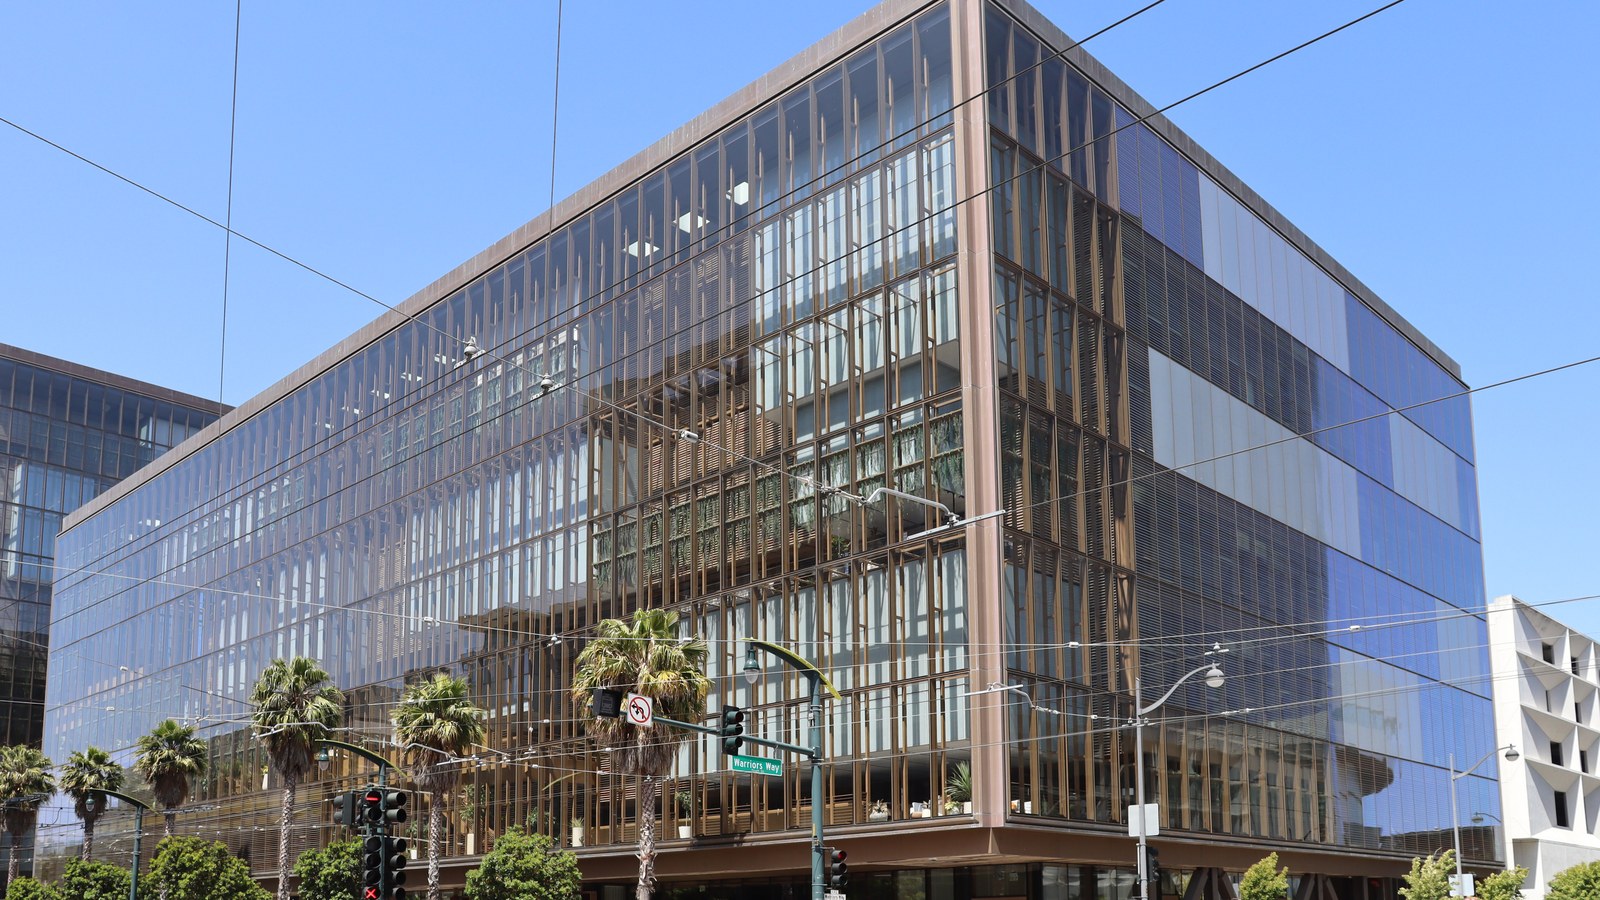
Edificio acristalado de la sede de OpenAI en el barrio de Mission Bay, San Francisco

ChatGPT nació como un sistema de conversación: se le preguntaba algo y respondía. Desde hace un par de años, OpenAI empuja en otra dirección, la de los agentes: programas que no solo contestan, sino que ejecutan tareas de varios pasos, usan herramientas y se conectan con otros servicios. Su conferencia anual para desarrolladores, el Dev Day, es donde suele enseñar hasta dónde ha llegado esa idea.

En la edición de este 29 de septiembre, la apuesta quedó clara. OpenAI presentó Dots, agentes pensados para funcionar de forma permanente y encargarse de tareas por su cuenta; ChatGPT Space, un espacio compartido para trabajar en proyectos junto a esos agentes; un paquete de mejoras para Codex, su herramienta de programación; y un nuevo plan Pro de $500 USD al mes. También anunció un modelo nuevo y reveló que ChatGPT ya tiene 1,200 millones de usuarios semanales.

Claves del Dev Day 2026

  • Dots, agentes siempre activos: OpenAI los describe como agentes proactivos y permanentes, capaces de encargarse tanto de encargos menores como de trabajos largos. Reciben contexto de varias aplicaciones, se integran con Slack —se les puede reenviar un hilo— y, según la cobertura del evento, también con Microsoft Teams. Usan el modelo de voz de la empresa para conversar. Empiezan a estar disponibles hoy para usuarios seleccionados: quienes tengan Pro o Business Premium reciben un Dot gratis y pueden contratar más.
  • ChatGPT Space: un espacio compartido donde los equipos reúnen sus proyectos y colaboran entre ellos y con los agentes que hayan puesto a trabajar.
  • Codex se muda a la nube: ahora funciona por completo en servidores de OpenAI, así que ya no hace falta dejar la computadora encendida para que termine una tarea. Suma entornos de desarrollo reutilizables entre dispositivos, una interfaz renovada para la línea de comandos y nuevas herramientas de revisión de código. En la demostración creó un juego espacial en 3D y una aplicación de bitácora de vuelo.
  • GPT-6.1 Sol: el nuevo modelo insignia estrena un modo Ultrafast que genera 300 tokens por segundo, unas ocho veces más rápido que el ritmo habitual.
  • Plan Pro de $500 USD al mes: una suscripción con límites de uso más amplios y acceso a las opciones de mayor velocidad.
  • 1,200 millones de usuarios semanales: la cifra que OpenAI presentó para ChatGPT en el evento.

Por qué importa

El salto que propone OpenAI no es de capacidad sino de formato. Un asistente al que hay que preguntar exige que la persona recuerde pedirle las cosas; un agente permanente, en cambio, vive dentro de las herramientas donde ya se trabaja y actúa sin que nadie abra una ventana de chat. Sam Altman lo resumió con dos extremos: encargos pequeños, como comprar un boleto de avión, y tareas largas y difíciles, como migrar el código que depende de una API que quedó obsoleta.

Para quienes programan, el cambio en Codex es igual de significativo. Que se ejecute en la nube y conserve entornos reutilizables lo acerca a un compañero de trabajo al que se le deja un encargo y se revisa el resultado más tarde, en lugar de una herramienta atada a la sesión abierta en la laptop. Es la misma dirección que siguen los demás asistentes de programación, y encaja con el cobro por suscripción de alta gama: un plan de $500 USD mensuales solo se sostiene si el agente hace un trabajo que de otro modo costaría bastante más.

Queda la parte que ningún anuncio resuelve: un agente que actúa solo también se equivoca solo. Delegarle compras, mensajes o cambios en el código exige confiar en su criterio y tener manera de revisar lo que hizo, algo que OpenAI deberá demostrar en el uso diario. Por ahora, Dots llega de forma limitada y con un costo que lo coloca lejos del usuario promedio. La conferencia dejó claro hacia dónde va la empresa; si esos agentes son útiles de verdad se sabrá cuando salgan del escenario y entren a trabajar.

Fuente: Engadget, cobertura en directo del Dev Day 2026. Imagen: sede de OpenAI en San Francisco, foto de Coolcaesar (CC BY 4.0).

Programar con IA: qué cambia cuando escribir código deja de ser el centro

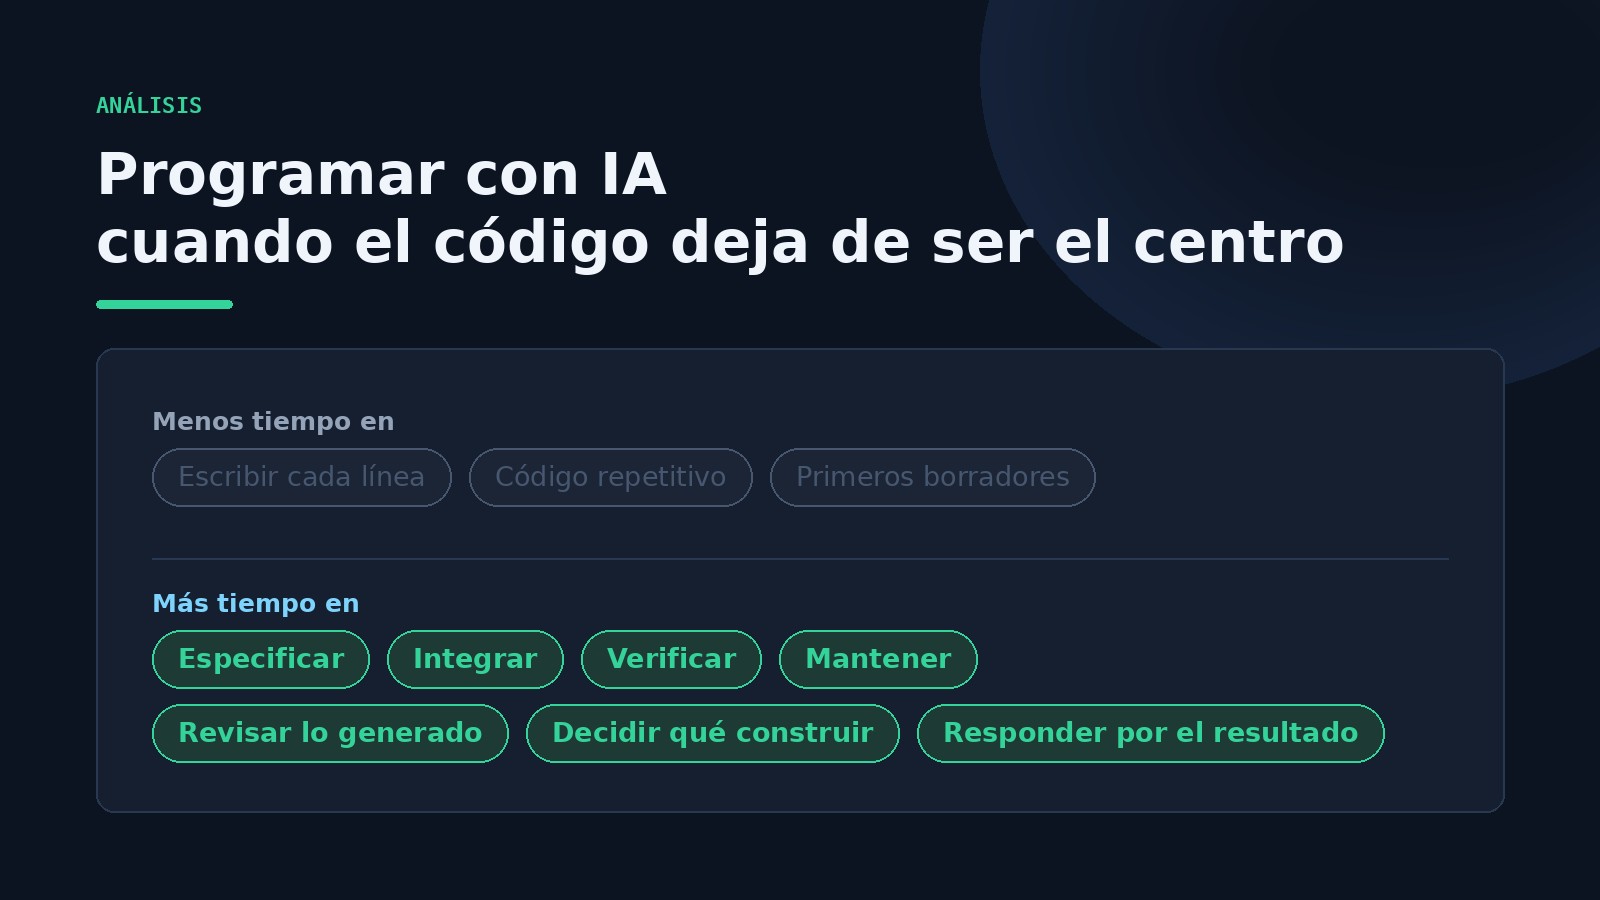
Portada con etiquetas que contrastan el trabajo que disminuye (escribir cada línea) con el que crece (especificar, integrar, verificar, mantener)

Durante mucho tiempo, la imagen del programador fue la de alguien frente a una pantalla, escribiendo línea tras línea hasta conseguir que una máquina hiciera lo que se le pedía. Esa imagen no ha desaparecido, pero se está quedando corta. Hoy, una parte del código puede surgir de una instrucción en lenguaje natural, una sugerencia del editor o un agente que explora un proyecto y propone cambios.

Eso cambia el trabajo. No lo vuelve automáticamente más sencillo ni elimina la necesidad de saber programar. La IA puede producir código con rapidez, pero alguien tiene que decidir qué problema vale la pena resolver, comprobar que la solución funciona en el contexto real y hacerse responsable de sus efectos.

La adopción ya es amplia, aunque la confianza sigue siendo cautelosa. En la encuesta de Stack Overflow de 2025, el 84% de quienes respondieron dijo que usa o planea usar herramientas de IA en su trabajo; al mismo tiempo, más personas desconfiaban de la precisión de sus resultados que las que confiaban en ella. El informe DORA de ese año ofrece una lectura útil: la IA tiende a amplificar lo que una organización ya hace bien y también sus problemas. Una herramienta más rápida no compensa requisitos confusos, sistemas difíciles de mantener ni una cultura que no deja tiempo para revisar.Fuentes: Stack Overflow, encuesta de 2025 · DORA, informe de 2025

Lo que empieza a delegarse

La IA puede encargarse de una primera versión de tareas acotadas y repetitivas. Por ejemplo:

  • Escribir funciones sencillas, estructuras iniciales y código repetitivo.
  • Proponer pruebas unitarias a partir de un comportamiento descrito.
  • Explicar qué hace una función o resumir partes de un código desconocido.
  • Sugerir documentación, comentarios, consultas o ejemplos de uso.
  • Ayudar a localizar errores probables y ofrecer opciones para corregirlos.
  • Convertir datos entre formatos o adaptar código siguiendo un patrón existente.
  • Explorar un repositorio y proponer cambios en varios archivos, cuando la herramienta tiene ese alcance.

Delegar aquí significa pedir una propuesta, no entregar el control. La IA puede entender mal una regla de negocio, usar una biblioteca de forma incorrecta o pasar por alto un caso límite. Incluso cuando el resultado parece convincente, hay que integrarlo, probarlo y revisarlo. La encuesta de Stack Overflow refleja esa tensión: muchos desarrolladores encuentran utilidad en estas herramientas, pero persisten dudas sobre la exactitud de lo que generan.Fuente: Stack Overflow, sección sobre IA

El criterio humano gana peso

Cuanto más fácil resulta generar código, más importante es decidir si ese código debe existir. El programador sigue teniendo que entender las necesidades de las personas, conversar con quienes conocen el problema y convertir pedidos vagos en requisitos que puedan verificarse.

También conserva tareas difíciles de reducir a una instrucción breve: elegir cómo se organiza un sistema, decidir qué riesgos son aceptables, preservar la privacidad, manejar información sensible y pensar cómo se mantendrá el producto con el tiempo. Una solución que compila puede ser insegura, costosa de operar o inadecuada para quienes la usarán.

Por eso, la revisión deja de ser el último trámite antes de entregar y se convierte en una actividad central. Revisar código generado implica preguntar: ¿hace lo que necesitamos?, ¿qué supuestos está haciendo?, ¿qué pasa cuando falla?, ¿expone datos?, ¿será comprensible para el próximo equipo? La respuesta no está siempre en el código mismo: también requiere conocer el producto, la organización y sus usuarios.

Nuevas actividades en el oficio

Dar contexto a las herramientas

Para obtener ayuda útil, el desarrollador debe reunir los requisitos, las convenciones del proyecto y las restricciones relevantes. Pedir «hazme una aplicación» suele producir algo superficial; plantear una tarea concreta, proporcionar ejemplos y definir cómo se comprobará el resultado mejora la colaboración.

Diseñar comprobaciones

Las pruebas automáticas, los analizadores, las revisiones de seguridad y la integración continua ayudan a comprobar cambios con rapidez. El desarrollador necesita diseñar esas barreras, interpretar sus resultados y detectar lo que todavía no cubren.

Coordinar agentes y cambios

Algunas herramientas pueden trabajar con varios archivos, ejecutar comandos o preparar cambios completos. Eso introduce trabajo de supervisión: dividir el encargo, limitar el alcance, revisar qué hizo la herramienta y decidir si sus cambios encajan con los de otras personas.

Administrar el riesgo y los datos

No todo código puede compartirse con cualquier servicio. Los equipos deben establecer qué información se puede enviar, qué herramientas están autorizadas y quién valida los resultados antes de usarlos en producción.

Aprender y enseñar de otra manera

La IA puede explicar tecnologías desconocidas o crear ejemplos para estudiar. Pero aprender a programar sigue requiriendo comprender fundamentos, depurar por cuenta propia y reconocer cuándo una explicación está equivocada. Para quienes empiezan, existe un riesgo especial: aceptar una solución que todavía no saben evaluar.

Qué no conviene entregar por completo

Hay decisiones que necesitan una persona con autoridad y conocimiento del contexto. No conviene delegar sin supervisión:

  • La definición final de los requisitos del producto.
  • La aceptación de riesgos de seguridad, privacidad o cumplimiento.
  • La aprobación de cambios que afectan datos, dinero o sistemas críticos.
  • La evaluación de si una solución es accesible, justa y apropiada para sus usuarios.
  • La responsabilidad frente a un error o un daño causado por el software.

La herramienta puede contribuir a esas tareas —por ejemplo, señalando riesgos potenciales—, pero no asume la responsabilidad profesional, legal o ética de quien la utiliza ni de la organización que publica el sistema.

Una profesión menos centrada en teclear

Esto no significa que escribir código vaya a dejar de importar. Entender estructuras de datos, redes, bases de datos, pruebas, seguridad y arquitectura ayuda a detectar errores y a orientar mejor a la IA. Lo que cambia es la proporción del tiempo: menos esfuerzo en producir cada línea desde cero, y más en especificar, integrar, verificar y mantener una solución completa.

Tampoco todos los equipos obtendrán el mismo beneficio. Si la documentación está desactualizada, el código es difícil de probar o nadie sabe quién revisa los cambios, generar más código puede aumentar el trabajo pendiente. DORA lo plantea como un efecto de amplificación: los resultados dependen tanto de las prácticas y las condiciones del equipo como de la herramienta.Fuente: DORA, informe de 2025

Para las personas programadoras, la oportunidad está en usar la automatización para quitarse trabajo mecánico y dedicar más atención a comprender problemas, conversar con usuarios y construir sistemas confiables. El peligro está en confundir velocidad con progreso: entregar antes algo que nadie entiende ni puede mantener no es una mejora.

La pregunta, entonces, no es solo cuántas líneas puede escribir la IA. Es qué hacemos las personas con el tiempo que libera, qué decisiones seguimos tomando y cómo comprobamos que el software realmente sirve. En ese futuro, programar no será únicamente decirle a la computadora qué hacer. Será saber qué pedir, qué aceptar, qué corregir y cuándo detenerse.

Fuentes: Stack Overflow Developer Survey 2025 y DORA, State of AI-assisted Software Development 2025.

Olinia: el miniauto eléctrico con el que México busca volver a fabricar vehículos propios

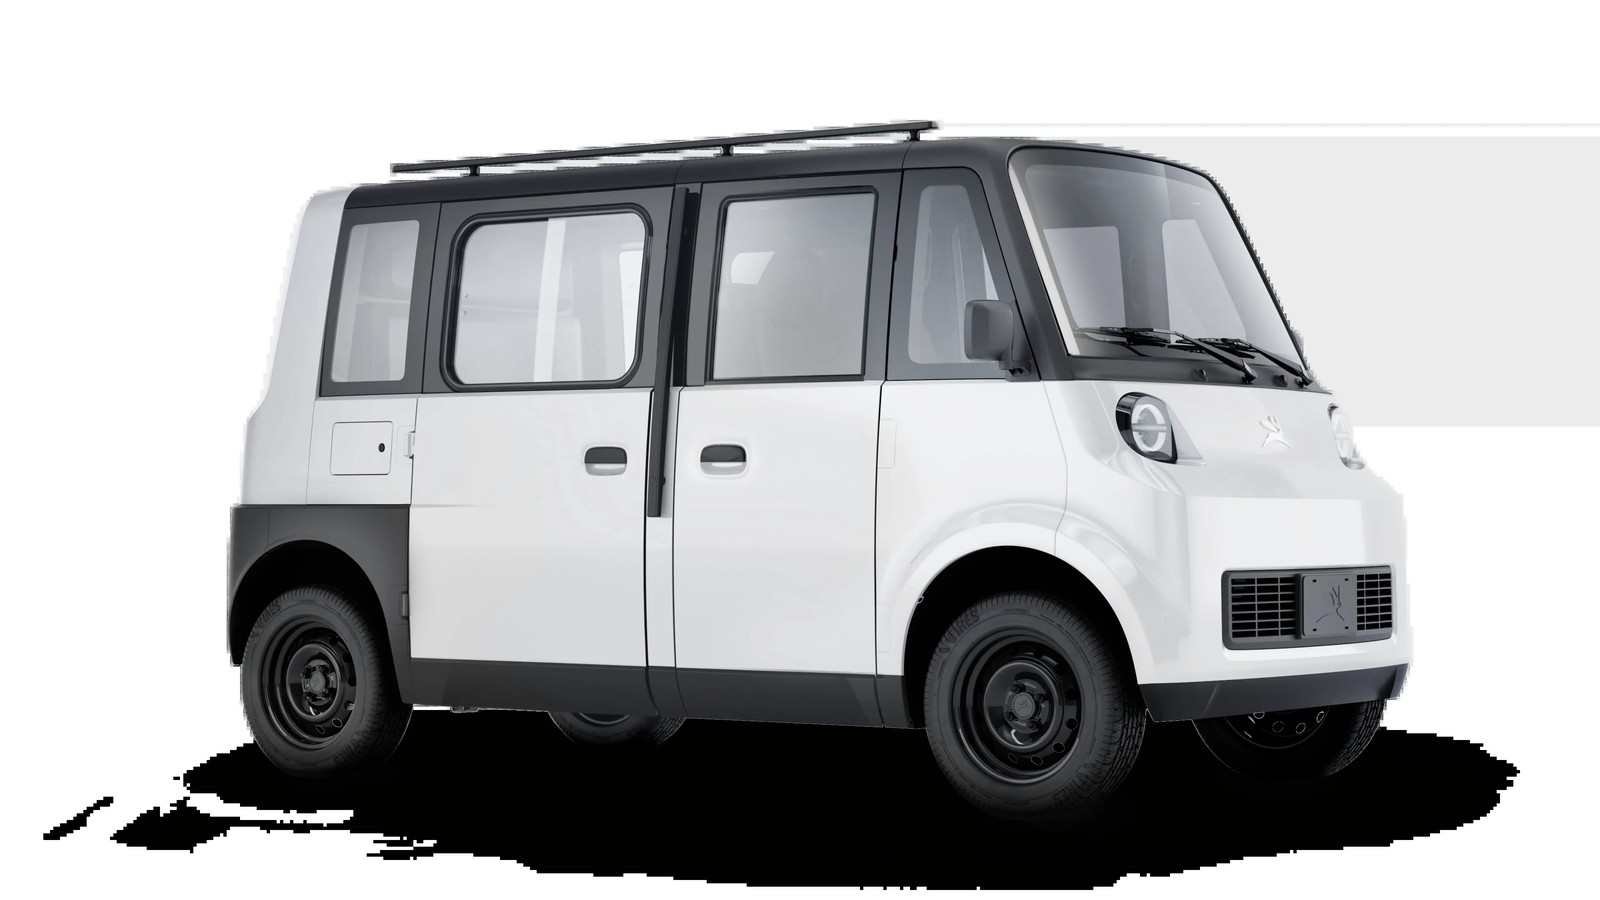
Render del miniauto eléctrico Olinia Uno, de carrocería blanca y seis plazas, visto de tres cuartos

Al 29 de septiembre de 2026, Olinia ya mostró dos prototipos y superó una primera prueba técnica de autonomía. El plan oficial prevé iniciar la producción del modelo de pasajeros en el verano de 2027 y vender la versión de carga hacia finales de ese año. Todavía faltan pasos industriales y regulatorios: el Gobierno busca socios para fabricar los vehículos, y el IPN señala que aún se trabaja en una norma para permitir la circulación de esta nueva categoría de minivehículos. Olinia ha dejado atrás la etapa de anuncio, pero todavía no es un automóvil de producción disponible para comprar.Fuentes: IPN · Presidencia de México

Una larga historia de autos hechos en México

La historia automotriz del país suele contarse a través de las grandes fábricas instaladas por empresas extranjeras. Ford abrió una línea de ensamblaje en México en 1925; General Motors llegó en 1935, y Fábricas Automex —de capital mexicano en sus orígenes y ligada después a Chrysler— comenzó operaciones en 1938. Esa trayectoria creó una industria manufacturera de gran escala, aunque fabricar automóviles en México no siempre significó diseñar aquí sus marcas, plataformas y modelos.Fuente: Banco de México

También hubo intentos de construir empresas nacionales. Willys Mexicana comenzó en 1946 y después dio paso a Vehículos Automotores Mexicanos (VAM), fabricante y ensamblador de modelos Jeep y Rambler. Diesel Nacional (DINA), constituida en 1951, produjo camiones, autobuses y otros vehículos. El Estado buscaba desarrollar capacidades industriales locales, empleos y producción nacional; en ciertos periodos, las reglas exigían una mayor integración de componentes fabricados en México. VAM dejó de operar como empresa automotriz mexicana en los años ochenta; DINA continúa, enfocada en autobuses y camiones.Fuentes: Revista de Historia de América, SciELO · DINA

A esa historia de fabricantes industriales se suman proyectos de menor escala. La familia Solana construyó autos deportivos y de competición; los hermanos Mastretta desarrollaron vehículos desde su empresa de diseño, y el Mastretta MXT llegó a producción en serie en 2011. Fue un deportivo de nicho: un logro de diseño y manufactura, pero no una marca de autos de volumen. Mastretta describe su trayectoria como fabricante de vehículos desde 1987, incluidos autobuses, utilitarios y el MXT.Fuentes: Mastretta · El Informador

Olinia se ubica en una categoría distinta. No busca competir como deportivo exclusivo ni convertirse desde el inicio en una armadora de sedanes para todo uso. Propone minivehículos eléctricos pequeños y de baja velocidad para recorridos urbanos, transporte de barrio y reparto. Su desafío histórico también es distinto: convertir diseño e ingeniería locales en una operación industrial que pueda producir, vender y dar servicio a escala.

Qué es Olinia y quién lo desarrolla

Olinia es un proyecto coordinado por la Secretaría de Ciencia, Humanidades, Tecnología e Innovación (SECIHTI), con participación del Instituto Politécnico Nacional (IPN), el Tecnológico Nacional de México (TecNM), centros públicos de investigación y apoyo de la UNAM y la UPAEP. El sitio oficial indica que los vehículos se producirán en Puebla. La convocatoria para encontrar empresas que participen en la fabricación industrial debe conducir a una empresa con mayoría de capital mexicano, de acuerdo con la presentación gubernamental.Fuentes: Olinia · Presidencia de México

El proyecto partió de tres necesidades de movilidad: transportar personas en trayectos cortos, ofrecer una alternativa cerrada a algunos mototaxis y mover mercancías en la última milla. De los tres vehículos planteados al inicio, ya se presentaron Olinia Uno, para pasajeros, y Olinia Carga, una unidad utilitaria. En agosto de 2026, el coordinador del proyecto también describió Olinia Van, una futura variante con carrocería cerrada para proteger la mercancía. La fecha anunciada para esa tercera propuesta es 2029.Fuentes: El País, entrevista con el coordinador · Presidencia de México

Olinia Uno: el modelo para pasajeros

El prototipo de pasajeros se presentó el 7 de junio de 2026 en Zumpango, Estado de México. El Gobierno lo describe como un vehículo completamente eléctrico, de baja velocidad, con una máxima anunciada de 50 km/h y capacidad para seis personas con cinturón de seguridad. El sitio oficial promete más de 100 kilómetros de autonomía y señala que la producción está prevista para el verano de 2027.Fuentes: Olinia Uno · IPN

En la presentación se difundieron cifras más precisas: motor eléctrico de 13.5 kW —unos 18 caballos de fuerza—, batería de 14.7 kWh, autonomía declarada de hasta 125 kilómetros y costo de operación cercano a 49 centavos por kilómetro. Esas cifras describen lo informado sobre el prototipo; el rango real de un vehículo de producción puede variar según carga, velocidad, pendientes, temperatura y condiciones de uso.Fuente: WIRED en Español

La velocidad máxima de 50 km/h sitúa a Uno en la movilidad urbana de trayectos cortos. El coordinador del proyecto ha dicho que no está pensado para carreteras ni vías de acceso controlado, aunque sí para calles y avenidas urbanas. Por su límite de velocidad, conviene entenderlo como un microvehículo urbano; no sustituye a un automóvil convencional para viajes largos o de alta velocidad.Fuente: El País

La batería se recarga en un enchufe doméstico convencional, según las presentaciones del proyecto. La promesa es reducir la barrera de entrada: el usuario no necesitaría instalar necesariamente un cargador rápido dedicado para la carga cotidiana. El equipo también ha hablado de diseñar las baterías pensando en una segunda vida para almacenamiento estacionario, aunque los detalles públicos disponibles no especifican todavía química, proveedor, tiempo de carga, garantías, capacidad útil ni sistema comercial de reciclaje.Fuentes: WIRED en Español · El Universal Puebla

Olinia Carga: una pequeña herramienta de trabajo

Olinia Carga se presentó el 20 de agosto de 2026. Está diseñado para transportar hasta 650 kg, recorrer más de 120 km por carga y llevar a dos personas. Su velocidad máxima anunciada es de 50 km/h; como Uno, se conecta a un enchufe tradicional. El Gobierno calcula que costará alrededor de $150,000 pesos y estima que podría salir a la venta a finales de 2027.Fuentes: Presidencia de México · Olinia Carga

El diseño publicado incluye una batea abatible, una superficie de carga de 2.1 m², acceso lateral y trasero, cajuela baja para guardar herramientas o repuesto, toma eléctrica para herramientas y barras en el techo. El sitio oficial anuncia más de 120 km de autonomía; el boletín gubernamental dice también que la unidad carga hasta 650 kg. Como en el modelo de pasajeros, habrá que esperar especificaciones finales y pruebas con condiciones de carga reales para conocer el alcance efectivo en trabajo diario.Fuentes: Olinia Carga · Presidencia de México

Cómo está construido: qué se sabe y qué falta por publicar

Por ahora, la información pública describe mejor la arquitectura funcional que los componentes de ingeniería. Sabemos que son vehículos eléctricos de baja velocidad, diseñados para uso urbano, con recarga doméstica; conocemos la capacidad anunciada de pasajeros o carga y, para el prototipo Uno, cifras de potencia y batería reportadas en su presentación. También sabemos que el IPN ya sometió el vehículo de pasajeros a pruebas en un dinamómetro de chasís: rodamiento a distintas velocidades, con y sin peso, y con diferentes niveles de pendiente. El equipo midió potencia de salida, torque y comportamiento del tren motriz.Fuentes: IPN · WIRED en Español

El sitio oficial muestra carrocerías cerradas y, para Carga, una plataforma utilitaria con cabina para dos y batea. Pero todavía no ha publicado un desglose técnico completo del chasis, suspensión, frenos, dirección, materiales de carrocería, electrónica de potencia, protecciones de la batería ni resultados de pruebas de choque. El IPN precisa que la evaluación de autonomía es una entre varias pruebas previstas; también informa que se desarrolla una norma oficial mexicana para esta nueva clase de minivehículos. Por eso, no hay que confundir un prototipo presentado y probado en laboratorio con un modelo cuya homologación, seguridad y configuración de producción ya estén concluidas.Fuente: IPN

La producción también está por definirse con socios industriales. En abril, el coordinador calculaba una capacidad futura de planta de hasta 50 mil vehículos al año, con un primer año parcial de entre 7 mil y 10 mil unidades y una meta de elevar el contenido nacional de 50% inicial a 70% para 2030. En agosto, el Gobierno informó que ya había compromisos por 8 mil unidades de una producción proyectada de 10 mil para el primer año. Son metas y previsiones del proyecto, sujetas a la selección de socios, financiamiento y puesta en marcha de la manufactura.Fuentes: El País · Presidencia de México

Precio y fechas: un calendario que sigue evolucionando

El anuncio inicial de enero de 2025 habló de tres modelos y de precios de entre $90,000 y $150,000 pesos, con la expectativa de tener un vehículo para el Mundial de 2026. El calendario cambió: el primer prototipo se presentó en junio de 2026 y la producción quedó prevista para 2027. Para septiembre de 2026, el sitio oficial anuncia la llegada de Olinia Uno en el verano de 2027 y la versión Carga se proyecta para venta a finales de ese año.Fuentes: El País, anuncio de 2025 · Olinia · Presidencia de México

El IPN informa que el vehículo de pasajeros costará $150,000 pesos y estará disponible en el verano de 2027. La Carga también se anuncia alrededor de ese precio, pero con venta proyectada hacia finales de 2027. El sitio oficial permite anotarse en una lista para recibir información cuando inicien los pedidos; el Gobierno advierte que Olinia no solicita anticipos ni transferencias por correo, WhatsApp o teléfono.Fuentes: IPN · Presidencia de México · Olinia

La siguiente fase depende de seleccionar socios para producir y vender, completar la industrialización y validar el vehículo bajo la regulación aplicable. Para Olinia Carga, el calendario anunciado fija publicación de bases a finales de septiembre de 2026, registro en octubre, ofertas formales en noviembre y cierre de ronda en diciembre. Las fechas de venta son compromisos públicos y objetivos de trabajo, no prueba de que la producción en serie ya esté asegurada.Fuente: Presidencia de México

Lo que Olinia puede significar para la industria mexicana

La importancia potencial del proyecto rebasa la posibilidad de comprar un vehículo eléctrico barato. Olinia intenta conectar universidades y centros públicos con diseño, pruebas, formación técnica y manufactura. Si consigue una producción sostenida, puede ayudar a desarrollar capacidades mexicanas en integración de sistemas, baterías, tren motriz y fabricación de vehículos eléctricos. La meta anunciada de 50% de contenido nacional al principio y 70% hacia 2030 es una señal concreta de esa ambición, aunque su cumplimiento dependerá de qué componentes se fabriquen localmente y de la escala que alcance la planta.Fuente: El País

Su oportunidad de mercado es específica: viajes cortos, barrios con calles estrechas, servicios locales y negocios que requieren mover carga ligera. Allí puede ofrecer ventajas frente a una moto o mototaxi —cabina cerrada, cinturones, protección climática y menor costo operativo anunciado—, siempre que el vehículo cumpla las normas de seguridad y que el costo de compra y mantenimiento resulte viable para sus usuarios. No es una solución para todas las necesidades de transporte, pero sí una apuesta por una categoría que hasta ahora tenía pocas opciones desarrolladas para las condiciones mexicanas.

El antecedente histórico invita a medir el éxito con paciencia. México ya ha ensamblado millones de vehículos y ha tenido empresas nacionales de autos, camiones y autobuses, pero sostener una marca propia requiere mucho más que un prototipo atractivo: producto confiable, precio competitivo, producción constante, refacciones, servicio posventa y cumplimiento regulatorio. Olinia todavía tiene que demostrarlo. Su avance más importante hasta ahora es haber pasado del anuncio a prototipos funcionales y pruebas técnicas; su prueba decisiva será llegar a 2027 con una línea industrial, vehículos homologados y entregas reales.

Fuentes principales: Olinia, Presidencia de México e IPN. Imagen: render oficial del proyecto Olinia.

Cómo escribir buenos prompts para crear aplicaciones web y móviles

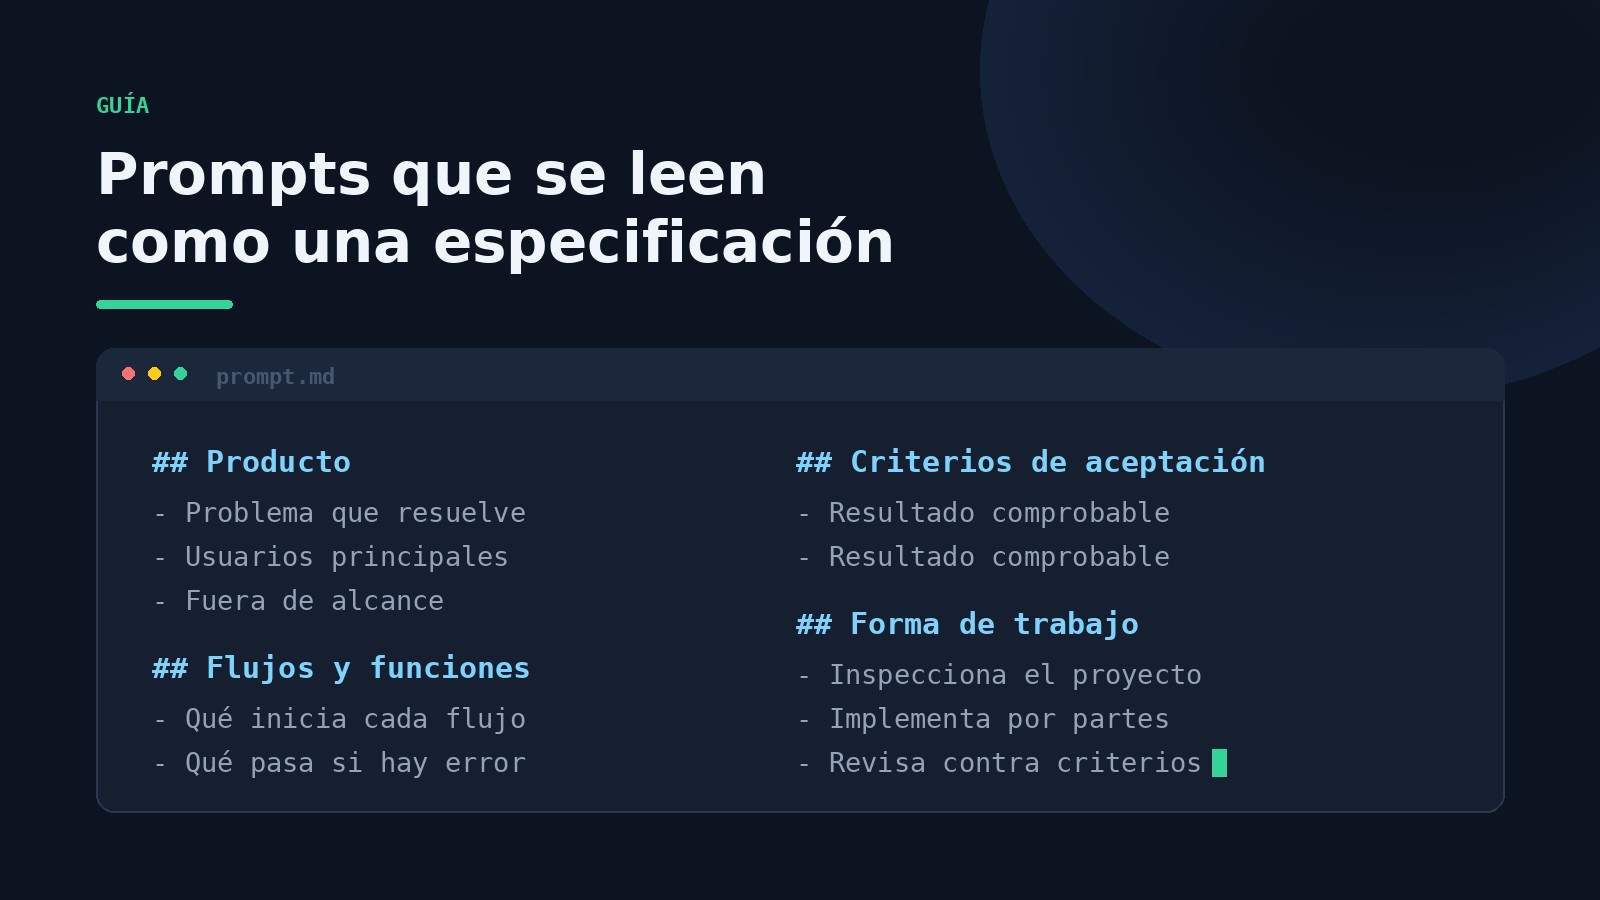
Portada con un documento de prompt estructurado en secciones: producto, flujos, criterios de aceptación y forma de trabajo

Un buen prompt no garantiza una aplicación excelente por sí solo. La calidad depende de que las instrucciones describan qué problema resolver, para quién, cómo debe funcionar y cómo se comprobará el resultado. En proyectos grandes, conviene trabajar en etapas: primero definir y diseñar; luego implementar por partes; finalmente revisar y corregir.

1. Describe el producto antes que la tecnología

Empieza explicando el contexto y el objetivo:

  • Qué es la aplicación: «Una plataforma para que pequeños restaurantes administren pedidos para llevar».
  • Quién la usará: «Dueños y empleados con poca experiencia técnica».
  • Qué problema resuelve: «Evitar pedidos perdidos en llamadas y mensajes».
  • Qué acción principal debe facilitar: «Recibir, confirmar y actualizar pedidos».
  • Qué queda fuera del alcance inicial: «No incluir entregas propias ni facturación electrónica».

Esto ayuda a que la IA tome decisiones coherentes en vez de añadir funciones por su cuenta.

2. Explica los flujos con ejemplos concretos

Las funciones vagas producen resultados vagos. En lugar de pedir «agrega inicio de sesión», especifica lo que debe ocurrir:

Un empleado ingresa su correo y contraseña. Si los datos son correctos, llega al panel de pedidos. Si son incorrectos, ve un mensaje claro sin que la aplicación revele si el correo existe. Debe poder solicitar un enlace para restablecer su contraseña.

Incluye, cuando corresponda:

  • Qué inicia cada flujo.
  • Qué datos ingresa la persona.
  • Qué resultado espera.
  • Qué pasa si hay errores, falta información o se pierde la conexión.
  • Qué permisos necesita cada tipo de usuario.

3. Define cómo se reconocerá una entrega completa

Convierte expectativas en criterios observables. Por ejemplo:

  • El usuario puede crear, editar y cancelar un pedido.
  • Los pedidos se ordenan del más reciente al más antiguo.
  • Un usuario no puede consultar pedidos de otro restaurante.
  • El formulario explica qué campos faltan.
  • La interfaz funciona con teclado y lector de pantalla.

Estos criterios sirven tanto para guiar la implementación como para revisar si quedó bien.

4. Da contexto técnico y límites

Si ya existen un proyecto o tecnologías elegidas, indícalos:

  • Lenguaje, framework y versiones relevantes.
  • Base de datos, proveedor de autenticación y servicios externos.
  • Estructura actual del repositorio y convenciones del equipo.
  • Dispositivos, navegadores o sistemas que se deben soportar.
  • Límites de tiempo, presupuesto, rendimiento o compatibilidad.

Pide que la IA inspeccione el proyecto antes de proponer cambios y que respete sus patrones existentes. Si todavía no hay decisiones técnicas, pídele que proponga opciones y explique sus ventajas y costos antes de implementar.

5. Separa los requisitos comunes de los específicos de plataforma

Frontend web

Aclara:

  • Qué páginas y rutas necesita la aplicación.
  • Qué componentes se reutilizan.
  • Cómo se adapta a móvil, tableta y escritorio.
  • Qué estados debe mostrar cada pantalla: carga, vacío, error, éxito y acceso denegado.
  • Cómo se manejan formularios, validación, navegación y permisos.
  • Qué nivel de accesibilidad se espera.

Puedes pedir que siga WCAG 2.2 como referencia para accesibilidad web: teclado, foco visible, etiquetas, contraste, ampliación de texto y mensajes de estado. Referencia WCAG 2.2.

Backend y API

Especifica:

  • Entidades y relaciones principales.
  • Operaciones disponibles y quién puede ejecutarlas.
  • Formato de entradas y respuestas, incluidos errores.
  • Reglas de validación y consistencia de datos.
  • Autenticación, autorización, auditoría y límites de solicitudes.
  • Qué información es confidencial y cómo debe protegerse.

No basta con pedir «una API segura». Explica, por ejemplo, que cada operación debe comprobar que la persona tiene permiso sobre ese recurso específico, y no solo que inició sesión. OWASP destaca fallos de autorización, autenticación y consumo de recursos entre los riesgos importantes para APIs. OWASP API Security Top 10.

Aplicaciones móviles

Indica:

  • Si será iOS, Android o ambas plataformas, y si usarás desarrollo nativo o multiplataforma.
  • Versiones mínimas y tamaños de pantalla que hay que soportar.
  • Qué debe funcionar sin conexión y qué datos se guardarán localmente.
  • Cómo se manejan permisos, notificaciones y enlaces profundos.
  • Qué pasa cuando el sistema suspende o cierra la aplicación.
  • Reglas de diseño y accesibilidad propias de cada plataforma.

Para Android, la guía oficial recomienda separar responsabilidades, mantener los datos fuera de componentes de pantalla y adaptar la interfaz a distintos tamaños y cambios de configuración. Guía de arquitectura para Android. Para iOS, utiliza las Human Interface Guidelines de Apple como referencia de diseño y accesibilidad.

6. Pide una interfaz específica, no solo «moderna»

Describe la experiencia visual con referencias concretas:

  • «Interfaz clara para uso frecuente en una cocina».
  • «La lista de pedidos es la información principal».
  • «Botones grandes y legibles en una tableta».
  • «Usa colores para acompañar el texto, no como única señal del estado».
  • «Incluye estados vacíos y mensajes de error útiles».

Si tienes diseños, capturas o una guía visual, adjúntalos y señala qué debe conservarse y qué puede cambiar. «Hazlo bonito» no define jerarquía, comportamiento ni identidad visual.

7. Pide arquitectura proporcional al problema

Indica el tamaño y la etapa del producto para evitar tanto una estructura improvisada como una complejidad innecesaria.

Para esta primera versión, mantén una arquitectura sencilla y modular. Separa la interfaz, las reglas del negocio y el acceso a datos. No introduzcas servicios distribuidos ni dependencias nuevas sin justificar por qué hacen falta.

Las guías oficiales de Android también aconsejan separar capas y responsabilidades para facilitar el mantenimiento y las pruebas. Ese principio es útil como orientación general, aunque la arquitectura adecuada depende de la plataforma y el producto. Arquitectura de apps Android.

8. Especifica cómo revisar el trabajo

Pide una entrega verificable:

  • Qué comprobaciones ejecutar, como compilación, análisis estático o pruebas existentes.
  • Qué recorridos principales revisar manualmente.
  • Qué dispositivos, navegadores o tamaños de pantalla comprobar.
  • Qué documentación actualizar.
  • Qué resultado presentar: archivos modificados, decisiones tomadas, límites conocidos y pasos para ejecutar la aplicación.

Mejor pedir pruebas asociadas a criterios concretos que decir simplemente «asegúrate de que todo funcione». Si no quieres que se ejecuten pruebas o se modifiquen ciertos archivos, dilo explícitamente.

9. Trabaja en pasos pequeños

Para una aplicación completa, evita un único prompt del tipo «crea una app profesional». Divide el trabajo:

  1. Definir: resume el problema, usuarios, alcance y criterios de aceptación.
  2. Diseñar: propone pantallas, flujos, modelo de datos y arquitectura.
  3. Implementar: construye una función o recorrido completo cada vez.
  4. Revisar: compara lo hecho con los criterios, identifica fallos y corrígelos.
  5. Entregar: explica cómo ejecutar el proyecto y qué queda pendiente.

Si la IA tiene acceso al repositorio, puede empezar inspeccionando la estructura y los patrones existentes. Pide que informe cualquier incertidumbre que afecte decisiones importantes, en lugar de inventar requisitos.

Plantilla reutilizable

Actúa como [rol o especialidad]. Ayúdame a construir [tipo de aplicación].

## Producto
- Problema que resuelve:
- Usuarios principales:
- Objetivo de la primera versión:
- Fuera de alcance:

## Plataforma y contexto técnico
- Frontend:
- Backend/API:
- Móvil:
- Base de datos y servicios:
- Versiones, dispositivos y navegadores:
- Repositorio o convenciones existentes:

## Flujos y funciones
1. [Flujo descrito paso a paso]
2. [Flujo descrito paso a paso]

## Reglas del negocio y permisos
- [Regla]
- [Quién puede ver o cambiar cada dato]
- [Validaciones y errores esperados]

## Diseño y experiencia
- Prioridad de cada pantalla:
- Estilo o referencias:
- Requisitos responsive:
- Accesibilidad:
- Estados de carga, vacío, error y éxito:

## Requisitos de calidad
- Seguridad y privacidad:
- Rendimiento:
- Funcionamiento sin conexión:
- Arquitectura y límites de complejidad:
- Compatibilidad:

## Criterios de aceptación
- [Resultado comprobable]

## Forma de trabajo
Primero inspecciona el proyecto y resume el plan. Señala las decisiones importantes que falten.
Después implementa [función o etapa concreta], siguiendo los patrones existentes.
Al terminar, indica qué cambiaste, qué comprobaciones realizaste y qué limitaciones quedan.
No inventes requisitos ni añadas dependencias o funciones fuera del alcance sin explicarlo.

La regla práctica

Escribe el prompt como una especificación breve: contexto, usuarios, flujos, restricciones y criterios de aceptación. Luego avanza función por función y revisa el resultado contra esos criterios.

Starship llega a la órbita por primera vez y despliega 26 satélites Starlink V3 en su vuelo 14

El cohete Starship de SpaceX despegando desde la plataforma de Starbase entre llamas y humo

Starship, el cohete de SpaceX, es el vehículo de lanzamiento más grande y potente jamás construido: mide 124 metros de altura y está diseñado para ser completamente reutilizable, tanto su propulsor Super Heavy como la nave que va encima. Desde 2023 había volado trece veces, y aunque los últimos vuelos salieron cada vez mejor, ninguno había completado el paso decisivo: entrar en órbita. Incluso en julio, cuando por primera vez soltó satélites Starlink, lo hizo en una trayectoria suborbital y aquellos satélites volvieron a caer a la Tierra.

Eso cambió este 28 de septiembre. Starship despegó a las 7:48 de la mañana, hora de Texas, desde la base de SpaceX en Starbase, al sur de ese estado, y alcanzó la órbita terrestre por primera vez. Ahí desplegó 26 satélites Starlink de tercera generación y, poco más de tres horas después del despegue, amerizó intacto en el Pacífico norte. El vuelo no estuvo exento de drama: uno de los motores de la nave se apagó durante el ascenso y SpaceX llegó a anunciar que cancelaba el intento de llegar a órbita, para luego retractarse.

Claves del vuelo 14 de Starship

  • Un motor menos y una decisión de último minuto: durante el despegue se apagó uno de los seis motores de la nave. El vocero de SpaceX, Dan Huot, llegó a anunciar que el intento orbital quedaba cancelado, pero los controladores decidieron seguir adelante. «Todavía no nos damos por vencidos», dijo Huot antes de que llegara la autorización.
  • Órbita alcanzada: unos 25 minutos después del despegue, la nave encendió brevemente un motor Raptor para entrar en órbita. «Starship está en órbita», confirmó el control de la misión entre aplausos. Elon Musk lo celebró después con un escueto «¡Primer vuelo orbital de Starship exitoso!».
  • 26 satélites desplegados: a partir del minuto 34 y durante media hora, la nave liberó 26 satélites Starlink V3, los primeros de una constelación que según Musk llegará a unos 100,000 satélites. Tres de ellos llevaban cámaras para filmar el escudo térmico de la nave y ayudar a mejorarlo.
  • El propulsor cumplió: el Super Heavy se separó y amerizó de forma controlada en el Golfo de México unos siete minutos después del despegue. Se le apagaron varios motores durante el vuelo, pero nada que comprometiera la maniobra.
  • Regreso adelantado: el plan original contemplaba unas seis vueltas a la Tierra y un amerizaje frente a Chile casi diez horas después del lanzamiento, pero los controladores recortaron el vuelo en casi siete horas. La nave reentró a la atmósfera a las 2 horas y 40 minutos, y cayó al Pacífico norte 3 horas y 8 minutos después de despegar. Tocó el agua entera, aunque enseguida se volcó y explotó.
  • Tercer vuelo de la versión 3: este fue el tercer lanzamiento con la Versión 3 de Starship, la primera capaz de desplegar satélites y, en teoría, de llegar a la Luna y a Marte. El cohete puede poner más de 100 toneladas en órbita terrestre.

Por qué importa

Llegar a órbita es la frontera que separa un cohete de pruebas de uno operativo. Todo lo que SpaceX promete con Starship (abaratar el acceso al espacio, construir una base lunar, eventualmente llegar a Marte) dependía de cruzar ese umbral, y hasta hoy no lo había hecho. Que además haya soltado una tanda real de satélites operativos, y no una maqueta de prueba, convierte al vuelo en algo más parecido a una misión comercial que a un ensayo.

La NASA tiene un interés directo en el resultado. Eligió a Starship como el primer módulo de alunizaje tripulado de su programa Artemis, con el que quiere instalar una base cerca del polo sur de la Luna. Según los planes de SpaceX, la nave llevaría astronautas a la órbita baja en la misión Artemis III a mediados de 2027 y los dejaría en la superficie lunar un año después con Artemis IV, aunque la NASA también contrató a Blue Origin para fabricar módulos de alunizaje y todavía no está claro cuál volará esa misión.

El vuelo 14 resuelve la pregunta más importante, pero deja otras tres abiertas. SpaceX aún no ha intentado atrapar la nave con los brazos de la torre de lanzamiento, algo que ya logró tres veces con el propulsor y que es clave para reutilizarla rápido. Tampoco ha demostrado que pueda recargar combustible en órbita, un paso indispensable para cualquier viaje a la Luna o a Marte. Y falta instalar los sistemas de soporte vital antes de subir a alguien a bordo. Starship ya sabe llegar a la órbita; ahora tiene que aprender a volver y a repetirlo muchas veces.

Fuentes: Reuters, Space.com