
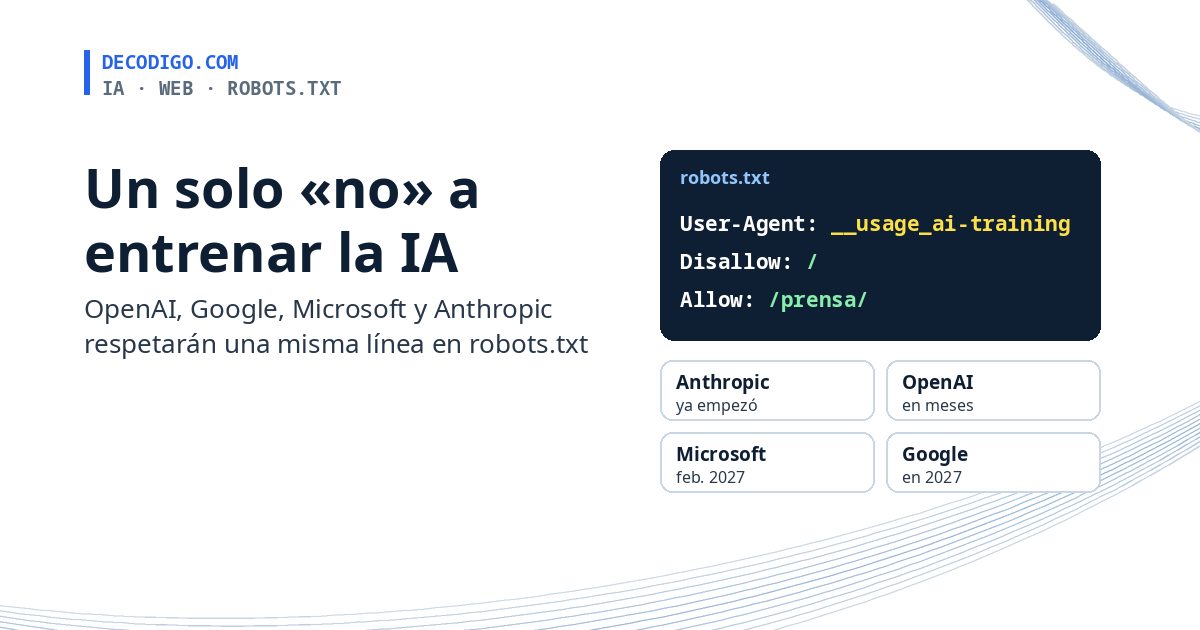
Hasta ahora, quien no quería que su web sirviera para entrenar modelos de inteligencia artificial tenía que bloquear rastreador por rastreador: GPTBot de OpenAI, ClaudeBot de Anthropic, Google-Extended de Google y una lista que no para de crecer. Eso va a cambiar. OpenAI, Google, Microsoft y Anthropic han anunciado que respetarán una señal común en robots.txt: una sola regla con la que una web dice «no» al entrenamiento de IA generativa de todas ellas a la vez.
La propuesta es un borrador presentado el 30 de octubre en el IETF, el organismo que define los estándares de internet, por Kevin Kelley, de Anthropic. Sale del trabajo del grupo AIPREF, donde llevan más de un año discutiendo cómo deben expresar las webs sus preferencias ante la IA, con participantes de las propias empresas de IA, de medios como News Corp, del Internet Archive y de grupos de la sociedad civil. No inventa nada nuevo: aprovecha el mismo archivo robots.txt que los buscadores leen desde los años noventa.
Claves de la nueva señal
- Un «agente» que no es un robot. La regla usa un nombre especial en la línea User-Agent,
__usage_ai-training, que no corresponde a ningún rastreador real sino a un uso: el entrenamiento de IA. ConDisallow: /la web se niega a todo; conAllowse pueden dejar fuera carpetas concretas, por ejemplo la de prensa. - El asterisco no vale. Un
User-Agent: *conDisallowno cuenta como negativa al entrenamiento: hay que escribir el nombre especial. Y si no aparece en el archivo, se entiende que la web no ha expresado ninguna preferencia. - Solo entrenamiento, y solo de IA generativa. La señal cubre el uso de los contenidos para ajustar un modelo de IA generativa. No es una orden de rastreo, no afecta a los modelos que no generan contenido y no saca a la web de los buscadores: Google recuerda que Google-Extended no cambia el posicionamiento en su buscador, y Microsoft, que nada de esto cambia la presencia en Bing.
- Cada una a su ritmo. Anthropic ya ha empezado a aplicarla, según el autor del borrador. Microsoft la tendrá en vigor desde el 1 de febrero de 2027, OpenAI dice que llegará en los próximos meses y Google, durante 2027. Google la interpretará como si la web hubiera bloqueado Google-Extended, salvo que la web tenga una regla propia para ese agente, que manda.
- Microsoft va más allá. Además del entrenamiento, ofrecerá un control llamado AI Grounding para impedir que sus asistentes lean una página para responder en el momento a una pregunta, con tres opciones: permitir, limitarlo a servicios de Microsoft o prohibirlo. Ese control va en una etiqueta meta o en una cabecera HTTP de cada página, no en robots.txt.
- Todavía es un borrador. Es un borrador individual, el primer paso del proceso del IETF, sin respaldo formal del organismo, y caduca en mayo de 2027 si no se actualiza. Meta, según SiliconANGLE, apoya la idea pero no se ha comprometido a aplicarla.
Así quedaría un robots.txt que no quiere que su contenido entrene modelos de IA, salvo la carpeta de prensa, y que sigue dejando pasar a todos los buscadores:
User-Agent: __usage_ai-training
Disallow: /
Allow: /prensa/

User-Agent: *
Allow: /
Qué conviene hacer con tu robots.txt
De momento, nada de borrar lo que ya funciona. Mientras la señal común no esté activa en todas las empresas, las reglas para cada rastreador, como las de GPTBot, ClaudeBot o Google-Extended, siguen siendo la forma segura de negarse; la línea nueva se puede añadir ya, porque los programas que no la entienden simplemente la ignoran, como cualquier agente desconocido. Hay que tener claro también su límite: robots.txt es una petición, no un candado. Las cuatro grandes se comprometen a respetarla, pero un rastreador que no quiera hacerlo puede seguir leyendo la web, y la señal no resuelve las demandas por derechos de autor ni quién cobra por los textos con los que ya se entrenó.
Aun así, es la primera vez que los principales desarrolladores de IA se ponen de acuerdo en un mismo mecanismo, en un momento en que el código de buenas prácticas de la ley europea de IA ya reconoce robots.txt como la forma principal de que los editores expresen esas preferencias. Para millones de webs pequeñas, que no tienen tiempo de seguir la lista de rastreadores nuevos, una sola línea puede ser la diferencia entre tener voz o no tenerla.
Más fuentes: borrador «Machine-Readable Training Preference Signal» en el IETF; blog de Bing; SiliconANGLE. Imagen: ilustración de decodigo.com.
Fuente: Google Search Central, «Supporting a shared AI training control for websites», 30 de octubre de 2026