Python 3.15 ya está aquí: importaciones perezosas, frozendict y UTF-8 por defecto

Portada: Python 3.15 ya está aquí, con el logotipo de Python sobre fondo claro y las novedades lazy import, frozendict, sentinel, UTF-8, JIT y Tachyon

La Python Software Foundation publicó el 9 de octubre Python 3.15.0, la nueva versión estable del lenguaje. Trae dos tipos integrados nuevos, una palabra clave para importar módulos solo cuando se usan y un cambio que acaba con muchos problemas de acentos: UTF-8 pasa a ser la codificación por defecto. Compilamos la versión final desde el código fuente oficial y probamos cada novedad.

Python publica una versión nueva cada octubre, con un ciclo de soporte de cinco años: dos de correcciones y tres más solo de seguridad. La 3.14 salió hace un año; la 3.15 es la primera versión estable que recoge el trabajo de estos doce meses, y es la que conviene empezar a probar con tus proyectos.

Las novedades se reparten entre el lenguaje (importaciones perezosas, frozendict, sentinel, desempaquetado en comprensiones), el comportamiento por defecto (UTF-8 en todas partes), las herramientas (un perfilador por muestreo en la biblioteca estándar) y el rendimiento, con un compilador JIT experimental mejorado.

Claves de Python 3.15

Importaciones perezosas con lazy import

import sys, time

inicio = time.perf_counter()
lazy import json
lazy import xml.dom.minidom
print("tras las importaciones:", "json" in sys.modules, "xml.dom.minidom" in sys.modules)
print(f"tiempo: {(time.perf_counter() - inicio) * 1000:.2f} ms")

print(json.dumps({"listo": True}))
print("después de usar json:", "json" in sys.modules, "xml.dom.minidom" in sys.modules)
python3.15 perezoso.pytras las importaciones: False False
tiempo: 0.01 ms
{"listo": true}
después de usar json: True False

Con lazy import, el módulo no se carga al llegar a esa línea sino la primera vez que se usa. Por eso, tras las dos importaciones, ninguno está en sys.modules; json se carga al llamar a json.dumps, y xml.dom.minidom, que no se llega a usar, no se carga nunca. En programas con muchas dependencias, sobre todo herramientas de línea de órdenes, esto acorta el arranque. También se puede activar para todo un programa con python -X lazy_imports=all o la variable PYTHON_LAZY_IMPORTS. Es una palabra clave nueva: Python 3.14 no la entiende.

el mismo código en Python 3.14.8  File "//v.py", line 1
    lazy import json
         ^^^^^^
SyntaxError: invalid syntax

frozendict: diccionarios inmutables

config = frozendict(host="localhost", puerto=5432)
print(config, config["puerto"])

try:
    config["puerto"] = 3306
except TypeError as e:
    print("TypeError:", e)

a = frozendict(x=1, y=2)
b = frozendict(y=2, x=1)
print(a == b, hash(a) == hash(b))

cache = {frozendict(lenguaje="python", version="3.15"): "lista"}
print(cache[frozendict(version="3.15", lenguaje="python")])
print(isinstance(config, dict))
salidafrozendict({'host': 'localhost', 'puerto': 5432}) 5432
TypeError: 'frozendict' object does not support item assignment
True True
lista
False

Es el equivalente de frozenset para los diccionarios: no se puede modificar y, si sus claves y valores lo son, se puede usar como clave de otro diccionario o meter en un conjunto. Conserva el orden de inserción, pero dos frozendict con el mismo contenido son iguales aunque estén en distinto orden. No hereda de dict (de ahí el False final), así que para aceptar ambos conviene comprobar collections.abc.Mapping.

sentinel: marcadores únicos sin trucos

FALTA = sentinel("FALTA")
print(FALTA, type(FALTA).__name__)

def buscar(datos, clave, por_defecto=FALTA):
    if clave in datos:
        return datos[clave]
    if por_defecto is FALTA:
        raise KeyError(clave)
    return por_defecto

datos = {"a": None}
print(buscar(datos, "a"))
print(buscar(datos, "b", 0))
try:
    buscar(datos, "b")
except KeyError as e:
    print("KeyError:", e)

import copy
print(copy.deepcopy(FALTA) is FALTA)
salidaFALTA sentinel
None
0
KeyError: 'b'
True

Sirve para distinguir «no me han pasado nada» de «me han pasado None», algo que hasta ahora se hacía con un object() anónimo. El nuevo tipo tiene un nombre legible, sobrevive a una copia sin dejar de ser el mismo objeto y se puede usar en las anotaciones de tipo (FALTA | None).

Desempaquetado dentro de las comprensiones

listas = [[1, 2], [3, 4], [5]]
print([*l for l in listas])

conjuntos = [{1, 2}, {2, 3}, {3, 4}]
print({*s for s in conjuntos})

ajustes = [{"tema": "claro"}, {"idioma": "es"}, {"tema": "oscuro"}]
print({**d for d in ajustes})
salida[1, 2, 3, 4, 5]
{1, 2, 3, 4}
{'tema': 'oscuro', 'idioma': 'es'}

El * y el ** ahora funcionan dentro de una comprensión. [*l for l in listas] aplana una lista de listas sin el doble for de antes, y {**d for d in ajustes} une diccionarios: si una clave se repite, gana el último.

UTF-8 por defecto

import sys, locale
with open("saludo.txt", "w") as f:
    f.write("Año, niño, café ☕")
with open("saludo.txt", "rb") as f:
    print(f.read())
print("modo UTF-8:", sys.flags.utf8_mode, "| locale:", locale.getpreferredencoding(False))
LANG=C python3.15 utf8.pyb'A\xc3\xb1o, ni\xc3\xb1o, caf\xc3\xa9 \xe2\x98\x95'
modo UTF-8: 1 | locale: utf-8

Aunque el sistema esté configurado con la codificación más básica (LANG=C), open() escribe en UTF-8 sin que se lo pidas. Hasta ahora usaba la del sistema, y por eso un programa que funcionaba en Linux fallaba con los acentos en Windows. Si algún programa antiguo depende del comportamiento anterior, se puede volver a él con PYTHONUTF8=0; así se ve lo que pasaba antes:

LANG=C PYTHONUTF8=0 python3.15 utf8.pyUnicodeEncodeError: 'ascii' codec can't encode character '\xf1' in position 1: ordinal not in range(128)

Errores que sugieren el método correcto

python3.15 -c …, cuatro errores típicos de quien viene de otro lenguajeAttributeError: 'list' object has no attribute 'push'. Did you mean '.append'?
AttributeError: 'str' object has no attribute 'toUpperCase'. Did you mean '.upper'?
AttributeError: 'dict' object has no attribute 'put'. Use d[k] = v.
AttributeError: 'tuple' object has no attribute 'append'. Did you mean to use a 'list' object?

Cuando alguien escribe un método de JavaScript o de Java, Python 3.15 sugiere el suyo: push → append, toUpperCase → upper. Las sugerencias aparecen en el mensaje que se imprime cuando el error no se captura; el texto de la excepción, si lo capturas con except, sigue siendo solo la primera parte. En Python 3.14 los mismos errores no sugieren nada.

Un perfilador nuevo: Tachyon

python3.15 -m profiling.sampling run lento.py
salida (recortada)Captured 262 samples in 0.26 seconds
Sample rate: 1000.00 samples/sec
       nsamples   sample%  tottime (ms)    cumul%  cumtime (ms)  filename:lineno(function)
        156/216      67.0       156.000      92.7       216.000  lento.py:7(ordenar)
          60/60      25.8        60.000      25.8        60.000  lento.py:7(ordenar.<locals>.<genexpr>)
          16/17       6.9        16.000       7.3        17.000  lento.py:2(fib)

El nuevo paquete profiling reúne los perfiladores de la biblioteca estándar. profiling.sampling, al que llaman Tachyon, mira cada poco qué está ejecutando el programa en lugar de medir cada llamada, así que casi no lo frena y puede incluso engancharse a un proceso que ya está en marcha (attach). Aquí señala que el 67 % del tiempo se va en la función ordenar. También genera gráficos de llama en HTML. cProfile sigue funcionando: ahora es un alias de profiling.tracing.

Lo demás

QuéEn resumen
Compilador JITSigue siendo experimental y no viene activado por defecto. Según el anuncio, rinde entre un 7 y un 8 % más (media geométrica) en x86-64 con Linux. No lo hemos medido.
TipadoTypedDict con claves extra tipadas (PEP 728), TypeForm (PEP 747) y bases disjuntas (PEP 800)
CompilaciónPunteros de marco activados por defecto (PEP 831), que facilitan perfilar desde fuera; en Windows, el intérprete con llamadas de cola; en macOS, la versión sin GIL se instala por defecto
RetiradoLos módulos sre_* (hay que usar re), el atributo __cached__ de los módulos y funciones obsoletas de ast, pathlib, typing y otros módulos

Por qué importa

La mayoría de estos cambios ahorran trabajo repetido. Las importaciones perezosas se hacían hasta ahora con importaciones escondidas dentro de las funciones; los diccionarios inmutables, con types.MappingProxyType o paquetes externos; los centinelas, con un object() sin nombre que aparecía en los mensajes de error como <object object at 0x7f…>. Ahora todo eso viene con el lenguaje y con una forma única de hacerlo.

El cambio a UTF-8 es el que más se notará sin hacer nada. Es la causa de una parte enorme de los errores con acentos y eñes en Windows, y para quien programa en español era un tropiezo habitual. Eso sí: un programa que dependía de la codificación del sistema puede comportarse de otra forma. Lo más prudente sigue siendo indicar siempre encoding="utf-8" al abrir archivos.

Python 3.15 se puede descargar ya desde python.org. Antes de pasar un proyecto a producción conviene esperar a que tus dependencias publiquen versiones para la 3.15, algo que suele llevar unas semanas, y probarlo primero en un entorno virtual. Para empezar con el lenguaje, nuestro curso de Python y los ejemplos de Python siguen sirviendo tal cual.

Probado compilando el código fuente oficial de Python 3.15.0 (Python-3.15.0.tar.xz) en un contenedor Debian; las salidas están copiadas de esa ejecución, y las de comparación, de Python 3.14.8. Detalle de cada cambio en What’s New in Python 3.15.
Fuente: Python Software Foundation, «Python 3.15.0»

El James Webb encuentra de dónde salió la ráfaga rápida de radio más lejana jamás medida

Portada: la ráfaga de radio más lejana jamás medida, con la galaxia anfitriona vista por el telescopio James Webb

Las ráfagas rápidas de radio son destellos de unos milisegundos que llegan desde otras galaxias, y casi veinte años después de descubrirlas nadie sabe con certeza qué las produce. El telescopio James Webb acaba de encontrar la galaxia de la más lejana medida hasta ahora, y lo que ha visto en ella inclina la balanza hacia una de las dos grandes explicaciones.

La primera ráfaga rápida de radio (FRB, por sus siglas en inglés) se identificó en 2007. Son pulsos de ondas de radio que duran milisegundos y que, en su gran mayoría, se ven una sola vez y nunca más. Eso las hace muy difíciles de estudiar: para saber qué las produce hay que localizar con mucha precisión el punto del cielo del que vienen y, después, encontrar y estudiar la galaxia que hay en ese lugar.

El 4 de marzo de 2024, el equipo MeerTRAP detectó con el radiotelescopio MeerKAT, en Sudáfrica, una ráfaga a la que se llamó FRB 20240304B. Los datos de radio indicaban que venía de muy lejos, quizá de más lejos que ninguna otra. Para confirmarlo hacía falta ver su galaxia, pero en ese punto exacto los mayores telescopios terrestres no veían nada. El equipo recurrió al Webb.

La cámara infrarroja NIRCam encontró una galaxia justo en ese lugar, y el espectrógrafo NIRSpec midió su corrimiento al rojo: 2.148. Eso significa que la ráfaga se produjo cuando el universo tenía unos 3,000 millones de años, y que su luz lleva viajando más de 10,000 millones de años. La sorpresa fue la galaxia: en vez de una galaxia grande, era una galaxia enana y muy joven. El estudio, dirigido por la astrofísica Manisha Caleb, de la Universidad de Sídney, se publicó el 8 de octubre en la revista Science.

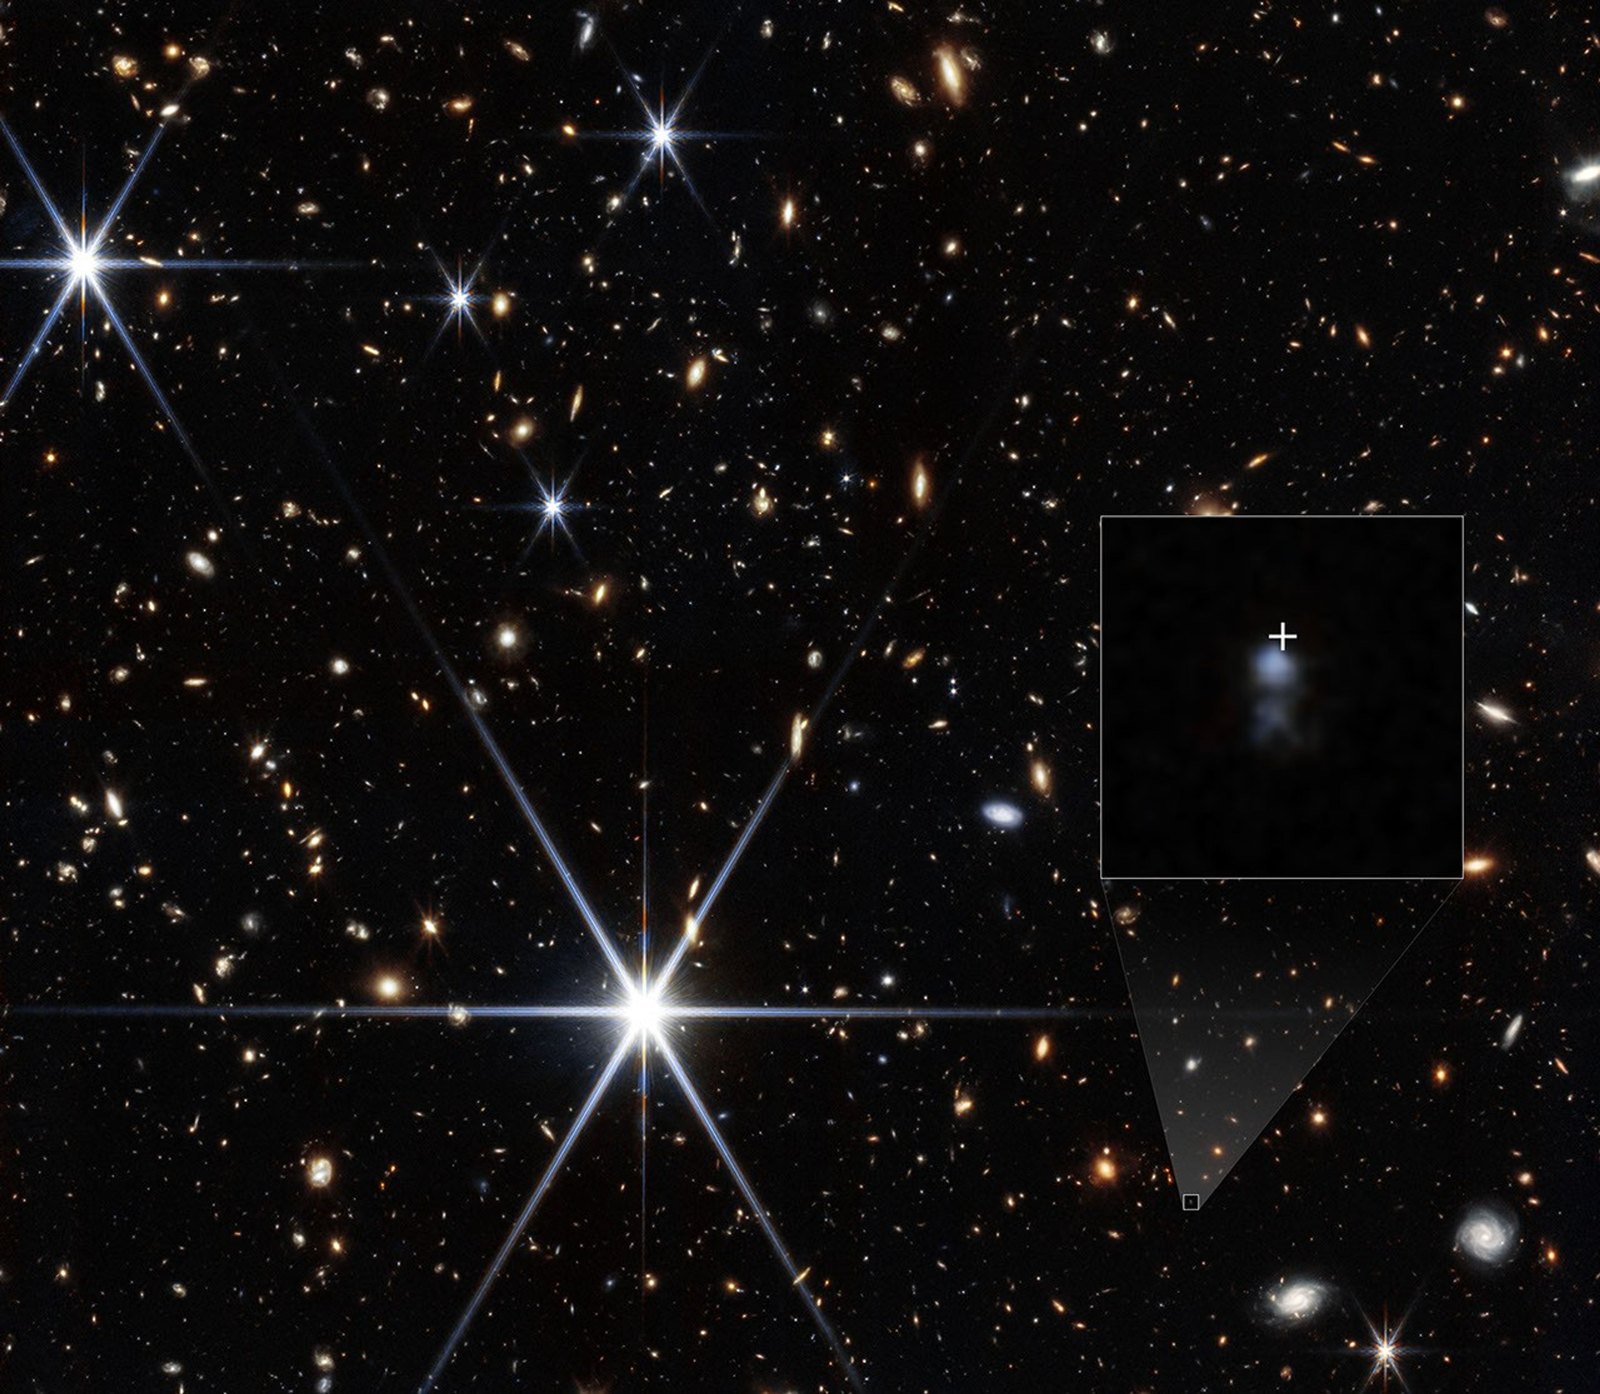
Campo de galaxias captado por NIRCam del telescopio James Webb, con un recuadro ampliado de la pequeña galaxia anfitriona de la ráfaga FRB 20240304B, marcada con una cruz
La galaxia de FRB 20240304B, en el recuadro ampliado. La cruz blanca marca el punto del que salió la ráfaga. Imagen: NASA, ESA, CSA, STScI, Themiya Nanayakkara (USYD); procesado: Joseph DePasquale (STScI).

«Si lo pones en perspectiva humana, cuando la luz salió de la fuente, el Sol no existía, el sistema solar no existía, no existía ningún ser humano.»Manisha Caleb, Universidad de Sídney, en declaraciones a la ABC australiana

Claves del hallazgo

  • Un récord de distancia. Con un corrimiento al rojo de 2.148, es la ráfaga más lejana confirmada. La gran mayoría de las detectadas hasta ahora ocurrieron miles de millones de años después.
  • Una galaxia inesperada. Casi todas las galaxias en las que se han localizado ráfagas son grandes y forman estrellas. Esta tiene unas 1,000 veces menos masa de lo que se esperaba. «Pensábamos que sería una galaxia grande y bien formada, y en su lugar era una pequeña galaxia enana», explica Caleb.
  • Muy joven. La galaxia existía en el llamado «mediodía cósmico», la época en la que el universo formaba estrellas a mayor ritmo. Por su ritmo de formación estelar, la mayoría de sus estrellas pudo nacer en solo 30 millones de años.
  • Una pista sobre el origen. Esa juventud encaja mal con que la ráfaga la produjera el choque de dos estrellas de neutrones, y bien con un magnetar. Lo explicamos más abajo.
  • Una linterna cósmica. La señal guarda la huella de lo que atravesó por el camino. En ella aparecen un cúmulo de galaxias desconocido hasta ahora, a unos 3,500 millones de años luz (corrimiento al rojo 0.3), y el cúmulo de Virgo, a 54 millones de años luz.
  • Un trabajo a dos bandas. MeerKAT detectó y localizó la ráfaga en radio; el Webb, en infrarrojo, encontró la galaxia y midió su distancia. Ningún telescopio podía hacerlo solo.

La pista sobre el origen es lo más interesante del estudio. Hay dos explicaciones principales para estas ráfagas, y la edad de la galaxia permite distinguirlas:

Choque de dos estrellas de neutronesUn magnetar
Qué esDos estrellas de neutrones que orbitan una alrededor de la otra hasta que chocanUna estrella de neutrones joven con un campo magnético enorme, que liberaría la ráfaga en una especie de terremoto estelar
Cuánto tardaMiles de millones de años desde que se forman hasta que chocanPoco después de la supernova que lo deja
Dónde se esperaríaGalaxias viejas, con estrellas evolucionadasGalaxias jóvenes que forman estrellas
¿Encaja con esta galaxia?No: no ha dado tiempoSí

«Nuestro trabajo sugiere que es muy improbable que esta ráfaga la produjera una fusión», resume Caleb.

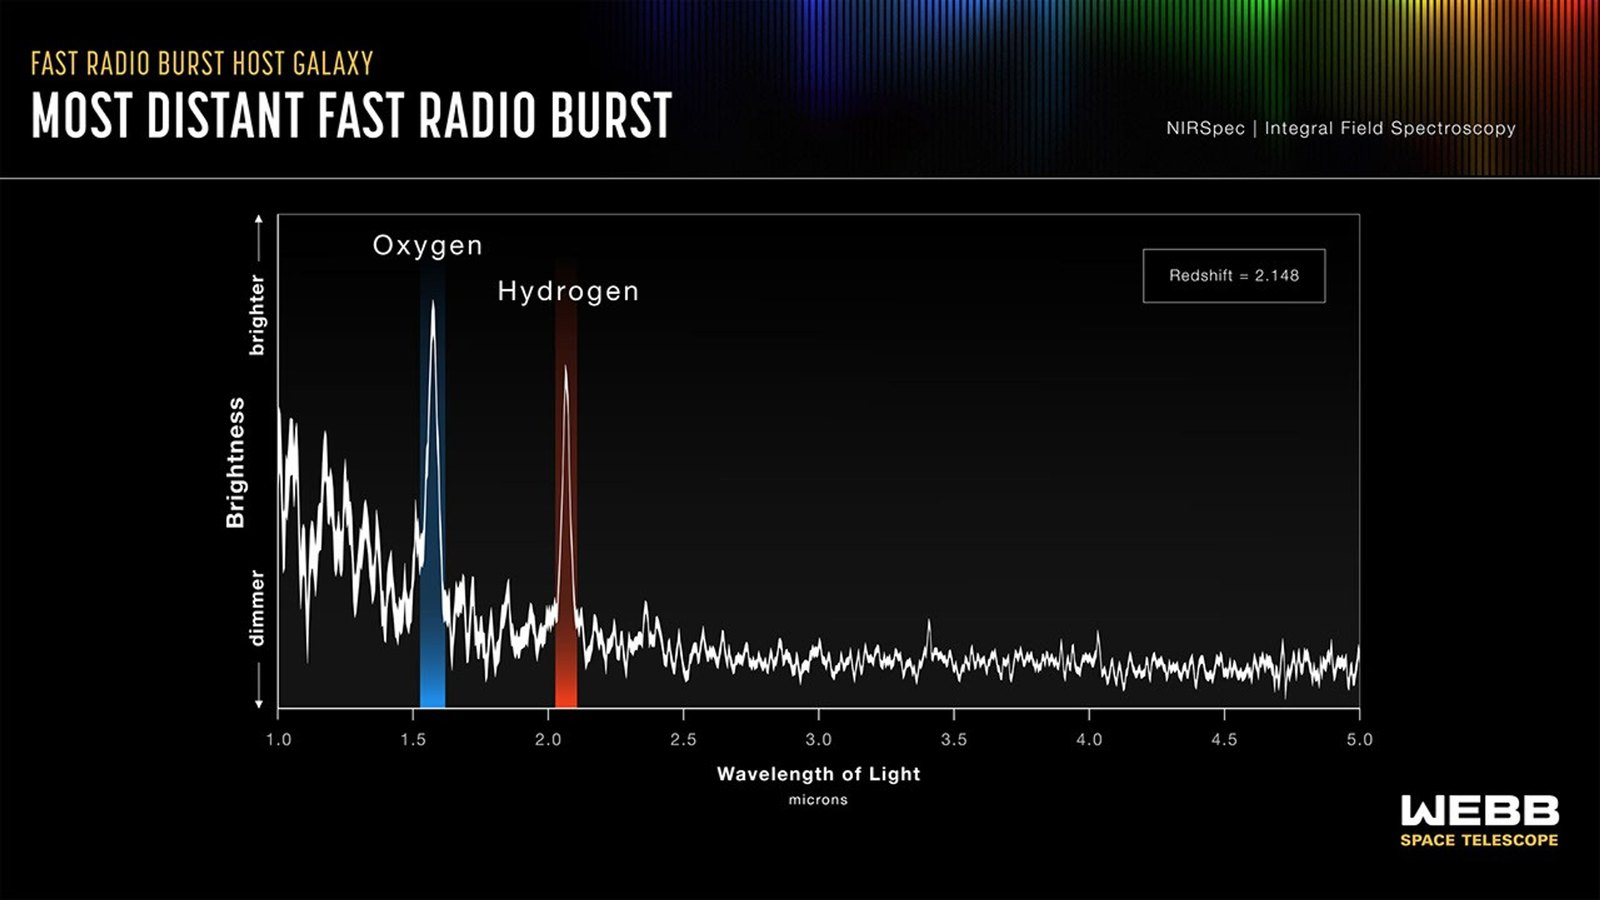
Espectro de NIRSpec de la galaxia anfitriona de la ráfaga más lejana, con las líneas del oxígeno y del hidrógeno y un corrimiento al rojo de 2.148
El espectro de la galaxia tomado con NIRSpec. El eje horizontal es la longitud de onda (en micras) y el vertical, el brillo. Los dos picos son el oxígeno (oxygen) y el hidrógeno (hydrogen). Ilustración: NASA, ESA, CSA, Joseph Olmsted (STScI); ciencia: Manisha Caleb (SIfA).
Cómo se mide la distancia en ese gráfico. El hidrógeno de una galaxia cercana brilla en una longitud de onda de 0.656 micras, que es luz roja. En esta galaxia, ese mismo pico aparece en torno a 2.07 micras, en el infrarrojo. La expansión del universo ha estirado su luz 3.148 veces, y ese factor es justamente 1 + 2.148: el corrimiento al rojo. Por eso hacía falta un telescopio infrarrojo como el Webb, y por eso los telescopios de tierra no la veían.

Por qué importa

Cada galaxia anfitriona que se estudia bien es una prueba más en un debate que lleva casi dos décadas abierto, y esta es especialmente valiosa: por su edad, es difícil de explicar con el choque de dos estrellas de neutrones. Un solo caso no cierra la discusión, pero apunta en una dirección concreta, la de los magnetares.

Además, las ráfagas lejanas sirven para algo más que entenderse a sí mismas. Como explica el coautor J. Xavier Prochaska, de la Universidad de California en Santa Cruz, una ráfaga «es casi como una linterna cósmica: ilumina todo lo que encuentra en su camino». Su señal permite rastrear la llamada red cósmica, la materia y las estructuras que no se ven de otra forma, y en este caso ya ha revelado un cúmulo de galaxias que nadie había detectado.

El equipo calcula que MeerKAT podría detectar y localizar cada año varias ráfagas con un corrimiento al rojo mayor que 1, es decir, de cuando el universo tenía menos de la mitad de su edad actual. Los nuevos radiotelescopios aumentarán ese ritmo, y el Webb será la herramienta para estudiar sus galaxias.

Lo que empezó como un destello de milisegundos captado en Sudáfrica termina como un récord, una galaxia que nadie esperaba y una pista sólida sobre uno de los misterios más persistentes de la astronomía reciente. Para la propia Caleb, lo más llamativo es el azar: la civilización se formó, construimos radiotelescopios «y resulta que miramos a la porción correcta del cielo en el momento justo».

Estudio: Manisha Caleb y otros, Science, 8 de octubre de 2026. Datos contrastados con la Universidad de California en Santa Cruz y la ABC. La portada combina dos imágenes del Webb del comunicado: el campo de galaxias de NIRCam, desenfocado, y la ampliación de la galaxia anfitriona (NASA, ESA, CSA, STScI, Themiya Nanayakkara; procesado de Joseph DePasquale).

Fuente: NASA, «Webb Measures Distance to Farthest Fast Radio Burst, Suggesting Origin»

Cómo funcionaba el software que alunizó: el sistema operativo del Apolo, explicado con su código fuente

El rostro de Margaret Hamilton, desenfocado, al fondo de la portada, junto al título «Cómo funcionaba el software que alunizó» y una DSKY dibujada con el código 1202

Del software del Apolo se repiten siempre las mismas dos frases: que cabía en menos memoria que una foto del móvil y que una alarma estuvo a punto de abortar el alunizaje. Las dos son ciertas y ninguna explica nada. Lo interesante es cómo estaba hecho por dentro, y lo bueno es que se puede mirar: el código fuente de la misión está publicado, línea a línea, con los comentarios que escribieron sus autores en 1969.

La máquina con la que había que apañarse

El ordenador de guiado del Apolo —el AGC— no era pequeño para la época: era pequeño a secas.

El AGCPara comparar
Memoria de trabajo2.048 palabras de núcleos de ferritaunos 4 KB
Programa36.864 palabras de memoria fijaunos 72 KB, y no se podía cambiar
Palabra15 bits más uno de paridadhoy, 64
Reloj2,048 MHzunas mil veces menos que un móvil
Peso y consumo32 kg y 55 Wuna bombilla

Y el programa no estaba grabado: estaba tejido. Cada uno y cada cero era un cable que pasaba por dentro o por fuera de un anillo de ferrita, a mano, y la memoria entera llevaba semanas de telar. Una vez tejida no se podía corregir ni una coma. Eso cambia por completo lo que significa «equivocarse».

Y el programa no podía pararse nunca. A la vez, y sin descanso, tenía que hacer todo esto: leer los acelerómetros, ir sumando esas lecturas para saber dónde estaba la nave, mover los motores que orientan la plataforma de navegación, atender al radar, llevar la cuenta del tiempo, refrescar los números de la pantalla y, por si fuera poco, hacer caso a un astronauta que teclea. Todo eso, con un solo procesador. No había un segundo núcleo al que mandarle la mitad.

La respuesta a ese problema es lo que hoy llamaríamos un sistema operativo de tiempo real, y es la aportación de fondo del equipo que dirigía Margaret Hamilton. Tiene cuatro ideas, y las cuatro se siguen usando.

Idea 1: una cola con prioridades, no una lista de tareas

Lo intuitivo, y lo que hacía casi todo el mundo entonces, es un ciclo mayor: haz A, luego B, luego C, vuelve a empezar. Funciona mientras todo dure lo previsto. El problema es que nada dura lo previsto, y cuando A se alarga, C llega tarde aunque C sea lo único que de verdad importa.

El Executive del AGC no hace eso. Cada unidad de trabajo —un job— se registra con un número de prioridad, y el sistema ejecuta siempre el de prioridad más alta que esté listo. Si mientras corre uno aparece otro más urgente, el primero se suspende a medias y se retoma después.

EXECUTIVE.agc, Luminary 1A (Apolo 11)# TO ENTER A JOB REQUEST REQUIRING NO VAC AREA:

NOVAC		INHINT
		AD	FAKEPRET	# LOC(MPAC +6) - LOC(QPRET)
		TS	NEWPRIO		# PRIORITY OF NEW JOB + NOVAC C(FIXLOC)

Y esta es la decisión de «¿me cambio de trabajo o sigo con este?», tal cual está escrita:

EXECUTIVE.agc		INDEX	NEWJOB		# THIS INDEX INSTRUCTION INSURES THAT THE
		CS	PRIORITY	# HIGHEST ACTIVE PRIORITY WILL BE COMPARED
		AD	NEWPRIO		# WITH THE NEW PRIORITY TO SEE IF NEWJOB
		EXTEND			# SHOULD BE SET TO SIGNAL A SWITCH.
		BZMF	ENDFIND

Si no has visto nunca ensamblador del AGC, no te pelees con las siglas: lo que hacen esas cinco líneas es una resta. Coge la prioridad del trabajo que está corriendo, le resta la del recién llegado y mira el signo. Si sale negativo, el nuevo manda y hay cambio; si no, el de ahora sigue. Eso es todo el «planificador»: una resta y un salto según el signo.

Las mayúsculas de los comentarios no las hemos puesto nosotros: el AGC se programaba con un juego de caracteres que no tenía minúsculas. Todos los listados de esta página están copiados tal cual del fuente de la misión, erratas incluidas: unas líneas más abajo, en ese mismo archivo, pone REQUIREING.

Ocho bandejas y cinco cuadernos

Si vas a interrumpir un trabajo a medias y retomarlo luego, tienes que apuntar en algún sitio por dónde iba: sus cuentas a medio hacer, en qué línea estaba, con qué trozo de memoria trabajaba. Piensa en una mesa con varias bandejas: cada trabajo que se aparta deja su papeleo en una bandeja y la mesa queda libre para el siguiente. Esa bandeja es lo que ellos llamaban core set.

Y aquí está el problema: cada bandeja ocupa memoria, y había 2.048 palabras en total para todo. Así que las bandejas se contaron y se repartieron de antemano, una por una:

ERASABLE_ASSIGNMENTS.agc# DYNAMICALLY ALLOCATED CORE SETS FOR JOBS	(84D)

MPAC		ERASE	+6		# MULTI-PURPOSE ACCUMULATOR.
MODE		ERASE			# +1 FOR TP, +0 FOR DP, OR -1 FOR VECTOR.
LOC		ERASE			# LOCATION ASSOCIATED WITH JOB.
BANKSET		ERASE			# USUALLY CONTAINS BBANK SETTING.
PUSHLOC		ERASE			# WORD OF PACKED INTERPRETIVE PARAMETERS.
PRIORITY	ERASE			# PRIORITY OF PRESENT JOB AND WORK AREA.

		ERASE	+83D		# EIGHT SETS OF 12 REGISTERS EACH

Ocho. Ocho bandejas. Ocho trabajos como mucho a la vez en toda la nave, y ni uno más.

Hay un segundo cupo. Los trabajos que hacen cuentas con vectores necesitan además un cuaderno de borrador bastante más grande, 43 palabras, para ir dejando los resultados intermedios. A ese cuaderno lo llamaban área VAC, y de esos había cinco. De ahí que en el fuente haya dos puertas de entrada distintas: NOVAC para el trabajo que no necesita cuaderno y FINDVAC para el que sí.

ERASABLE_ASSIGNMENTS.agc# VAC AREAS. -- BE CAREFUL OF PLACEMENT --	(220D)

VAC1USE		ERASE
VAC1		ERASE	+42D
VAC2USE		ERASE
VAC2		ERASE	+42D

¿Y si alguien pide bandeja o cuaderno y no queda ninguno libre? Pues pasa lo que todo el mundo ha oído contar mil veces sin saber qué era. Las dos alarmas famosas del alunizaje son literalmente eso: «no me quedan cuadernos» y «no me quedan bandejas». Están escritas ahí, en el mismo archivo, una debajo de la otra:

EXECUTIVE.agc — la alarma 1201		CCS	VAC5USE
		TCF	VACFOUND
		LXCH	EXECTEM1
		CA	Q
		TC	BAILOUT1
		OCT	1201		# NO VAC AREAS.
EXECUTIVE.agc — la alarma 1202NEXTCORE	CAF	COREINC
		ADS	LOCCTR
		CCS	EXECTEM2
		TCF	NOVAC3
		LXCH	EXECTEM1
		CA	Q
		TC	BAILOUT1	# NO CORE SETS AVAILABLE.
		OCT	1202
Esto conviene leerlo despacio. El 1202 no es un fallo del programa ni un error de nadie: es el mensaje que el sistema emite a propósito cuando pide una bandeja y no queda ninguna. Es una condición prevista, con su código, su rutina y su documentación. La diferencia entre un sistema que se cuelga y uno que avisa está, casi siempre, en si alguien se molestó en escribir estas seis líneas.

Idea 2: las tareas con reloj

El Executive responde a «esto es importante». Falta quien responda a «esto es a tal hora», que no es lo mismo: leer el acelerómetro dentro de 10 milisegundos, apagar el motor dentro de 4 segundos. De eso se encarga el segundo planificador, el Waitlist, y lo que gestiona no se llama trabajo sino tarea: un encargo corto que entra, hace lo suyo y sale sin que nadie lo interrumpa.

WAITLIST.agc# FUNCTIONAL DESCRIPTION --
#	PART OF A SECTION OF PROGRAMS -- WAITLIST, TASKOVER, T3RUPT, USED TO CALL A PROGRAM (CALLED A TASK),
#	WHICH IS TO BEGIN IN C(A) CENTISECONDS.
#
# WARNINGS --
#	1)	1 <= C(A) <= 16250D (1 CENTISECOND TO 162.5 SEC)
#	2)	9 TASKS MAXIMUM
#	3)	TASKS CALLED UNDER INTERRUPT INHIBITED
#	4)	TASKS END BY TC TASKOVER

Nueve tareas, hasta 162,5 segundos de plazo, resolución de una centésima de segundo. La división es la misma que hoy: tareas cortas y puntuales que no pueden interrumpirse, y trabajos largos que sí. Una tarea que necesita hacer algo lento no lo hace: encola un trabajo y se va.

Idea 3: reiniciar sin perder nada

Aquí está, seguramente, lo más elegante del diseño. Un ordenador de 1969 hecho de núcleos de ferrita y transistores sueltos, metido en una nave llena de vibraciones y radiación, se iba a reiniciar tarde o temprano. Hacer como si eso no fuera a pasar no era una opción; impedirlo, tampoco. Así que lo convirtieron en algo normal.

El truco son los puntos de control: la misma idea que guardar la partida en un videojuego. A lo largo de cada operación delicada, el programa va dejando constancia de por dónde va con una llamada a PHASCHNG:

PHASE_TABLE_MAINTENANCE.agc# PHASCHNG IS THE MAIN WAY OF MAKING PHASE CHANGES FOR RESTARTS.  THERE ARE THREE FORMS OF PHASCHNG, KNOWN AS TYPE
# A, TYPE B, AND TYPE C.  THEY ARE ALL CALLED AS FOLLOWS, WHERE OCT XXXXX CONTAINS THE PHASE INFORMATION,
#		TC	PHASCHNG
#		OCT	XXXXX

Y el código se escribe de manera que volver al último punto anunciado sea inofensivo. Don Eyles, que programó el descenso, lo resume en tres líneas:

el patrónNEW_X = X + 1
    registrar el punto de control
X = NEW_X

Parece una tontería y no lo es. Primero se calcula el valor nuevo aparte, sin tocar el bueno; luego se marca el punto de control; y solo entonces se guarda. Mira los dos casos posibles: si el ordenador se reinicia antes de la marca, al volver repite el cálculo y listo, porque no había llegado a cambiar nada. Si se reinicia después, el valor ya está guardado y tampoco hay que hacer nada. No existe ningún instante intermedio en el que el corte te deje las cosas a medio hacer.

Si esto te suena, es porque lo usas sin pensarlo: es exactamente lo que hay detrás de una transacción de base de datos, de un commit y de que una API se pueda reintentar sin duplicar nada. Lo escribieron veinte años antes de que a nadie le hiciera falta ponerle esos nombres.

Al arrancar de nuevo, la rutina RESTARTS recorre la tabla de fases y vuelve a poner en marcha cada cosa que estaba pendiente, desde su último punto de control. El programa en curso sigue, la pantalla se repinta y el astronauta ve, como mucho, un parpadeo.

Hay un registro en la memoria que se llama REDOCTR y cuyo comentario en el fuente dice CONTAINS NUMBER OF RESTARTS: un contador de reinicios. No era una excepción, era una estadística.

Idea 4: una máquina virtual, para que el código cupiera

El guiado es matemática de vectores: productos escalares, productos vectoriales, matrices de rotación, raíces, todo en doble precisión. Escribir eso en el ensamblador del AGC —que trabaja con palabras de 15 bits y tiene una aritmética mínima— ocupa una barbaridad de memoria.

Así que hicieron algo que suena a herejía y es de puro sentido común: se inventaron un segundo idioma. Un idioma en el que «multiplica estos dos vectores» se dice con una sola palabra, en vez de con las decenas de instrucciones que hacen falta en el idioma de la máquina. Y escribieron un programa, el intérprete, que lee ese idioma y lo va traduciendo sobre la marcha.

Es, literalmente, una máquina virtual metida dentro del AGC, con su propio juego de instrucciones. Lo mismo que hace Java con su bytecode, pero en 1969 y por un motivo muy concreto: que el programa cupiera.

INTERPRETER.agc — la tabla de saltoINDJUMP		TCF	VLOAD		# 00 -- LOAD MPAC WITH A VECTOR.
		TCF	TAD		# 01 -- TRIPLE PRECISION ADD TO MPAC.
		TCF	SIGN		# 02 -- COMPLEMENT MPAC (V OR SC) IF X NEG.
		TCF	VXSC		# 03 -- VECTOR TIMES SCALAR.
		...
		TCF	VAD		# 24 -- VECTOR ADD.
		TCF	VSU		# 25 -- VECTOR SUBTRACT.
		TCF	BVSU		# 26 -- VECTOR SUBTRACT FROM.
		TCF	DOT		# 27 -- VECTOR DOT PRODUCT.
		TCF	VXV		# 30 -- VECTOR CROSS PRODUCT.
		TCF	VPROJ		# 31 -- VECTOR PROJECTION.

Las tablas de salto del intérprete suman más de setenta operaciones: cargar un vector, multiplicarlo por un escalar, producto escalar, producto vectorial, matriz por vector, raíz cuadrada, seno, arcoseno, vector unitario. Un programa interpretado es entre cinco y diez veces más lento que el equivalente escrito a mano, y a cambio ocupa una fracción del espacio. Cuando tienes 36.864 palabras y una misión entera que meter dentro, ese cambio no se discute: se firma.

Las dos capas conviven en el mismo archivo y se distinguen a simple vista. Esto es un trozo del programa del alunizaje: las primeras líneas son instrucciones interpretadas, y EXIT es la que devuelve el control al ensamblador de la máquina.

THE_LUNAR_LANDING.agcP63SPOT2	VLOAD	UNIT		# INITIALIZE KALCMANU FOR BURN ATTITUDE
			R60VSAVE
		STOVL	POINTVSM
			UNITX
		STORE	SCAXIS
		EXIT

		CAF	EBANK7
		TS	EBANK

20 de julio de 1969: todo esto, a la vez

Con las cuatro piezas sobre la mesa, lo que pasó en el descenso se explica solo.

Empieza con un interruptor. El radar de encuentro —el que sirve para volver a acoplarse con el módulo de mando al final, no para alunizar— se había quedado en una posición que lo dejaba despierto. No estorbaba a nadie, en principio.

El detalle está en cómo le cuenta ese radar al ordenador hacia dónde apunta. Los dos aparatos se sincronizan con una señal eléctrica de 800 Hz, y el documento que describía esa conexión exigía que las dos señales tuvieran la misma frecuencia… pero no decía nada de que tuvieran que ir a compás. Era una línea que faltaba en el documento, y nadie la echó de menos hasta ese día.

Aquel día no iban a compás: estaban desfasadas casi un cuarto de onda. Y con ese desfase, la electrónica del radar se volvía loca midiendo: creía ver que la antena se movía todo el rato, y le mandaba al ordenador 6.400 avisos por segundo por cada uno de los dos ángulos, cuando la antena en realidad estaba quieta.

Aquí está la parte que hay que entender. Atender cada aviso no era «ejecutar un programa»: el hardware del AGC paraba el procesador un instante, le quitaba un ciclo para actualizar el contador, y lo devolvía. Nada en el software se enteraba. Simplemente, el ordenador iba más lento sin que nadie supiera por qué. Eyles lo mide:

«Moviéndose a su velocidad máxima, los contadores del radar de encuentro consumían aproximadamente el 15 % del tiempo de cálculo disponible. En su momento, siendo conservadores, supusimos que la pérdida de tiempo (que llamábamos TLOSS) era de un 13 %.»Don Eyles, Tales from the Lunar Module Guidance Computer (2004). Grumman midió después un máximo del 13,36 %.

Un 13 % no suena a catástrofe. Y no lo habría sido si el ordenador hubiera ido holgado, pero iba al límite. Aquí es donde se juntan las cuatro ideas.

El trabajo gordo del descenso se llama SERVICER: es el que lee los sensores, calcula dónde está la nave y decide qué hacer con el motor. Se lanza cada dos segundos y tiene que haber terminado antes de que le toque otra vez. Con el radar robando ciclos, dejó de llegar a tiempo.

Y el reloj no espera a nadie. Cada dos segundos encolaba un SERVICER nuevo, aunque el anterior siguiera a medias. Cada copia se llevaba su bandeja y su cuaderno. Dos copias, tres, cuatro… y las bandejas eran ocho.

1 · Descenso normalSERVICERP63pantallaradarlibrelibrelibrelibre4 de 8 bandejas ocupadasCuatro trabajos en la cola. SERVICER terminadentro de su ciclo de 2 segundos y liberasu bandeja antes de que llegue el siguiente.2 · El radar roba el 13 % del tiempoSERVICERSERVICERSERVICERSERVICERP63pantallaradarradar8 de 8 bandejas ocupadasALARMA 1202SERVICER ya no acaba a tiempo, pero el relojsigue encolando una copia nueva cada dossegundos. Las ocho bandejas se agotan.3 · Tras el reinicioSERVICERP63pantallalibrelibrelibrelibrelibre3 de 8 bandejas ocupadasEl reinicio revive solo la copia más recientede cada trabajo desde su último punto decontrol. La cola queda limpia y el descenso sigue.

Cuando se agotaron, el Executive hizo exactamente lo que estaba escrito que hiciera: BAILOUT1, código 1202, y reinicio. Hasta aquí es una historia de un ordenador que se satura. Lo que la convierte en otra cosa es lo que pasó al reiniciar.

El reinicio no solo recuperaba el estado: tiraba el atasco. Al revivir desde la tabla de fases, de cada trabajo duplicado solo se restauraba la copia más reciente. Las copias a medias de SERVICER que se habían ido amontonando desaparecían de golpe, y el ordenador se encontraba otra vez con la cola despejada y tiempo de sobra para lo importante: el guiado, los motores y la pantalla.

«Un sistema de protección ante reinicios motivado sobre todo por la posibilidad de fallos del hardware proporcionó, por sinergia, una manera de soltar carga de cálculo ante un atasco de software causado por el TLOSS.»Don Eyles, en el mismo texto

Dicho de otro modo: el ordenador se atragantó, escupió lo que le sobraba y siguió. Pero eso, desde Houston y con el módulo lunar bajando hacia la superficie, no se ve. Lo único que se ve es una luz de aviso encendida y un número en la pantalla.

Steve Bales y Jack Garman tenían que decidir, en cuestión de segundos, si aquel 1202 quería decir «me estoy muriendo» o «me he atragantado y ya lo he resuelto». Sabían que era lo segundo porque lo habían visto en los simuladores unas semanas antes. Garman dijo «go», y detrás fueron Bales, Kranz y Duke.

Durante el descenso saltaron cinco alarmas de esas: primero 1202, «no quedan bandejas», y más tarde 1201, «no quedan cuadernos». El alunizaje no se interrumpió ni una sola vez.

Lo que de aquello seguimos haciendo

En el AGCHoy se llama
Trabajos con prioridad que se expulsanplanificador apropiativo por prioridades
Soltar lo secundario al saturarsedegradación elegante, backpressure
Puntos de control antes de cada paso críticotransacciones, commit, idempotencia
Reiniciar como mecanismo normal de recuperacióncrash-only software, reinicio supervisado
Un intérprete para que el código ocupe menosuna máquina virtual, un bytecode
Un código numérico por cada condición previstacódigos de error y observabilidad

La lista no es una analogía forzada: son las mismas decisiones, tomadas por las mismas razones y casi siempre antes. Y hay una séptima que no cabe en la tabla, que es la que Hamilton defendió cuando le dijeron que los astronautas no se equivocan: que el programa tiene que hacerse cargo de lo que puede salir mal, incluida la persona que está al otro lado.

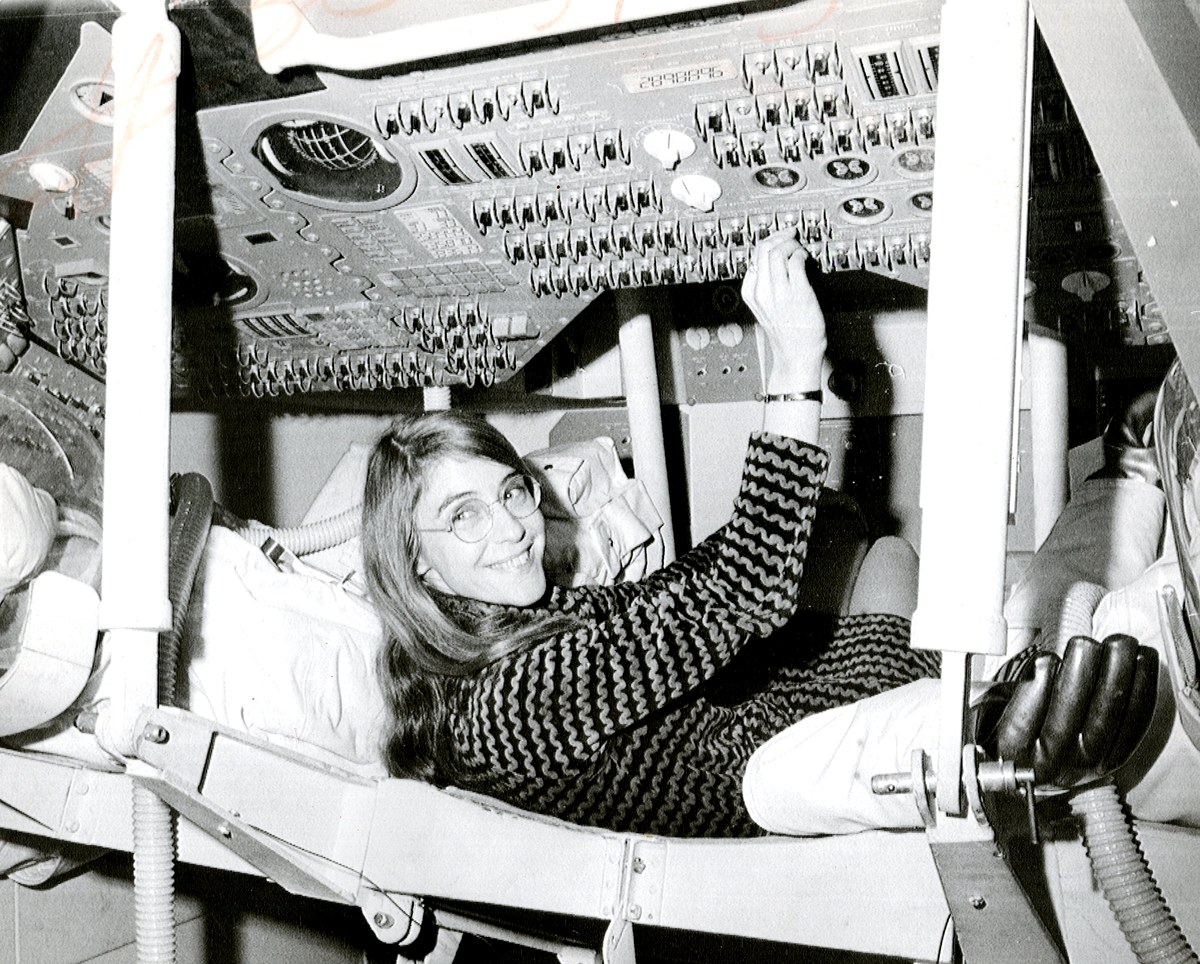
Margaret Hamilton sonriendo, tumbada en el asiento de la maqueta del módulo de mando del Apolo, con el brazo levantado hacia el panel de mandos lleno de interruptores
Margaret Hamilton en la maqueta del módulo de mando del Apolo, en noviembre de 1969. El panel que tiene encima es el otro extremo de todo lo que cuenta esta página: los interruptores y la DSKY por los que un astronauta hablaba con los ocho trabajos, las nueve tareas y los puntos de control. Foto de la NASA, en dominio público.

Dónde mirarlo tú mismo

Todo lo citado en esta página sale de archivos que puedes abrir ahora mismo.

QuéDónde
El fuente del Apolo 11, módulo lunar y de mandogithub.com/chrislgarry/Apollo-11
El proyecto que lo transcribió, con los escaneos originales y un emuladorVirtual AGC
El relato de quien programó el descenso«Tales from the Lunar Module Guidance Computer»
El ordenador por dentroApollo Guidance Computer

Si abres el repositorio, empieza por Luminary099/EXECUTIVE.agc: son quinientas líneas y es el corazón de todo lo que cuenta esta página. Y si quieres el momento exacto, THE_LUNAR_LANDING.agc, que son trescientas treinta y cinco.

Las cifras de esta página —ocho core sets de 12 registros, cinco áreas VAC de 43, nueve tareas, las operaciones del intérprete, los códigos 1201 y 1202— están comprobadas una a una en el fuente de Luminary 1A build 099, que es el que voló en el Apolo 11, y coinciden con lo que cuenta Don Eyles. Los listados están copiados literalmente, con sus comentarios y sus erratas. Sobre Margaret Hamilton y su equipo escribimos cuando murió, el 30 de septiembre de 2026.

Muere Margaret Hamilton a los 90 años: la ingeniera que puso nombre al oficio y llevó el software a la Luna

Margaret Hamilton sonriendo tumbada en la maqueta del módulo de mando del Apolo, junto al rótulo Margaret Hamilton 1936-2026

En 1965, cuando el Laboratorio de Instrumentación del MIT contrató a su primera programadora para el proyecto Apolo, el trabajo que iba a hacer no tenía nombre. No había carrera que lo enseñara, ni libros, ni una palabra para distinguirlo de la ingeniería eléctrica de la que colgaba. El software era lo que hacían unas personas en una sala mientras los ingenieros de verdad construían la nave.

Esa programadora se llamaba Margaret Hamilton, tenía 29 años y venía de un camino improvisado: matemáticas en Earlham College, un puesto temporal en el departamento de meteorología del MIT escribiendo programas de predicción con Edward Lorenz —el del efecto mariposa—, y cuatro años en el Lincoln Laboratory programando el prototipo del AN/FSQ-7, el ordenador del sistema de defensa aérea SAGE.

Margaret Hamilton murió el 30 de septiembre de 2026, a los 90 años. El MIT lo anunció el 7 de octubre. Entre aquel puesto temporal y hoy hay una carrera que explica por qué el oficio se llama como se llama.

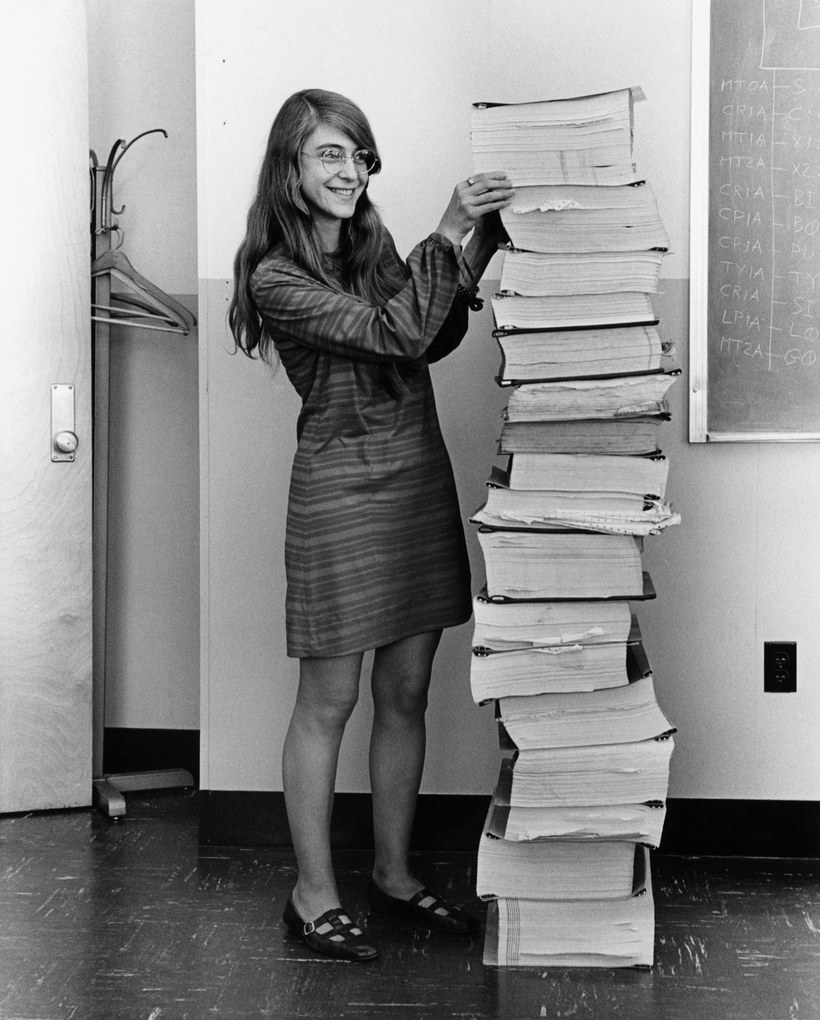
Margaret Hamilton en 1969 de pie junto a una pila de listados impresos del software del Apolo tan alta como ella
La foto que todo el mundo ha visto: Hamilton en 1969 junto a los listados del software que su equipo escribió para el módulo lunar y el de mando. Foto de Draper Laboratory, dominio público; restauración de Adam Cuerden.

Claves de una carrera

  • Paoli, Indiana, 1936. Empezó matemáticas en la Universidad de Michigan en 1955 y se licenció en Earlham College en 1958, con filosofía como asignatura secundaria. Se mudó a Boston en 1959.
  • Lincoln Laboratory, 1961. Programó para la Fuerza Aérea el prototipo del ordenador de SAGE, un sistema de defensa aérea que tenía que responder en tiempo real. Ahí aprendió lo que significa que un programa no pueda pararse.
  • 1965: la primera del Apolo. El Laboratorio de Instrumentación la contrata como primera programadora del proyecto, y es además la primera mujer que programa en él. En 1968 ya era directora adjunta al frente del equipo del módulo de mando y de servicio: más de 400 personas trabajando en el software del Apolo.
  • «No había una segunda oportunidad. Lo sabíamos. Nos tomábamos el trabajo en serio.» Es suya, y resume el método: en un programa que va a ejecutarse una sola vez, a 380.000 kilómetros, no hay versión 1.1.
  • El error de Lauren. Su hija de cuatro años, jugando en el simulador, lanzó el programa P01 —el de prelanzamiento— en pleno vuelo simulado y lo tiró abajo. Hamilton pidió añadir una comprobación que lo impidiera y le dijeron que los astronautas no se equivocan. En el Apolo 8, Jim Lovell lanzó el P01 en vuelo y borró los datos de navegación. Su equipo lo arregló desde tierra, y a partir de ahí la programación defensiva dejó de ser una manía suya.
  • El sistema de prioridades. Diseñó un ejecutivo asíncrono: las tareas no iban en fila, iban por importancia, y el ordenador podía reiniciarse y retomar el trabajo crítico sin perderlo. Es la pieza que hizo posible lo que pasó después.
  • La alarma 1202. Durante el descenso del Apolo 11, el ordenador se saturó y avisó. La causa real fue un documento de interfaz mal cerrado: el radar de encuentro, que se había dejado en espera, tenía su señal de 800 Hz sin sincronizar con la del ordenador y le robaba ciclos. El software soltó las tareas secundarias, se quedó con el guiado y el alunizaje siguió. Un ordenador que se cae en ese momento no deja un informe de fallo: deja un cráter.
  • La máquina con la que se hizo. El ordenador del Apolo trabajaba con palabras de 15 bits más uno de paridad, tenía 2.048 palabras de memoria borrable y 36.864 de memoria fija tejida a mano, iba a 2,048 MHz, pesaba 32 kg y consumía 55 vatios. Toda la memoria de trabajo cabe hoy en una línea de una hoja de cálculo.
  • Le puso nombre al oficio. Empezó a decir «ingeniería de software» para separarlo del hardware y reclamar para él el mismo rango. Según cuenta el MIT, «se consideraba bastante gracioso. Fue un chiste recurrente durante mucho tiempo».
  • Después del Apolo, empresa propia. Fundó Higher Order Software en 1976 y Hamilton Technologies en 1986, y desarrolló el Universal Systems Language, un lenguaje de modelado cuya idea central es la misma de siempre: que el error no se corrija, que no se pueda cometer.
  • Reconocimientos. NASA Exceptional Space Act Award en 2003, con $37,200 USD, la mayor cantidad que la agencia había dado nunca a una sola persona hasta entonces. Medalla Presidencial de la Libertad en 2016: «su arquitectura de software llevó a saltos de gigante para la humanidad», decía la mención. Premio del Computer History Museum en 2017, Intrepid en 2019 y el National Aviation Hall of Fame en 2022.
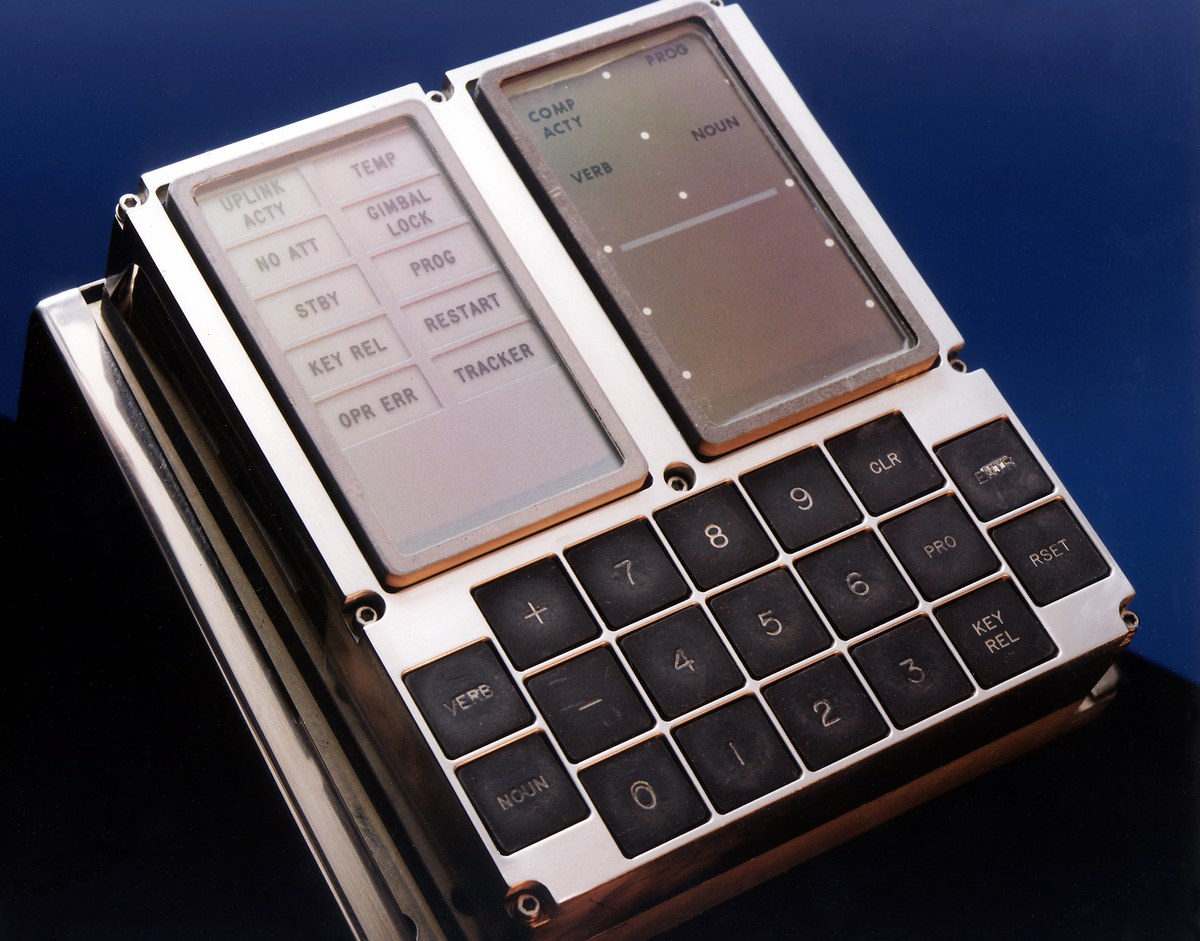
La unidad DSKY del ordenador de guiado del Apolo: teclado numérico, teclas VERB y NOUN y luces de aviso entre las que se ve PROG y RESTART
Así se hablaba con el ordenador del Apolo: dos dígitos de verbo, dos de nombre. Arriba a la izquierda están las luces de aviso, y entre ellas PROG, la que se encendió con la 1202, y RESTART. Foto: NASA / Dennis Taylor, dominio público.

Por qué importa

Es fácil quedarse con la anécdota del alunizaje, y la anécdota es buena. Pero lo que Hamilton dejó no es una hazaña, es una manera de trabajar que hoy damos por supuesta sin saber de dónde viene.

La primera idea es que el error se previene en el diseño, no se parchea después. Cuando pidió proteger el P01 y le contestaron que los astronautas no se equivocan, estaba discutiendo algo que seguimos discutiendo: si el trabajo del programador es cumplir la especificación o hacerse cargo de todo lo que puede salir mal, incluida la persona que está al otro lado. El Apolo 8 zanjó la discusión a su favor.

La segunda es la degradación elegante. Un sistema sobrecargado no tiene que caerse: puede soltar lastre y seguir con lo importante. Eso, que en 1969 era una decisión de diseño peleada, está hoy en el planificador de cualquier sistema operativo en tiempo real, en el backpressure de un servicio web y en el modo degradado de un coche. La alarma 1202 es el ejemplo canónico, y por eso se sigue contando.

Y la tercera es el nombre. Llamar «ingeniería» al software no fue vanidad: fue reclamar presupuesto, método, revisión y responsabilidad para una actividad a la que se trataba como un apaño. Ella lo dijo sin rodeos en 2018: «peleé por dar al software legitimidad, para que a él —y a quienes lo construyen— se le diera el respeto que merece».

Sesenta años después, cuando una empresa cuenta que su cohete vuela con Linux, C++ y un navegador, ese respeto ya no hay que pelearlo. Esa es la diferencia, y tiene nombre y apellidos.

Deja una hija, Lauren —la del error—, un yerno, dos nietos, cuatro bisnietos y tres hermanos.

Sobre las imágenes. Las tres son de dominio público. La de portada es un montaje sobre una foto de la NASA de Hamilton en la maqueta del módulo de mando del Apolo 12, del 24 de noviembre de 1969. La de los listados es de Draper Laboratory, publicada en 1969 sin aviso de copyright, con restauración de Adam Cuerden. La de la DSKY es de NASA / Dennis Taylor: es una unidad del Apolo, fotografiada en 1996 cuando el sistema se reutilizó en el F-8, el primer avión de mando digital.

En decodigo.com: la entrada que le dedicamos en 2016 · el software de vuelo de SpaceX.
Y las fuentes de esta noticia: el obituario del MIT · CNN · las características del ordenador de guiado y la causa de las alarmas 1201 y 1202 · el Smithsonian sobre el premio de la NASA de 2003.

Fuente: «Margaret Hamilton, computing pioneer who led software development for the Apollo program, dies at 90», MIT News, 7 de octubre de 2026.

Boston Dynamics ficha al que construyó Alexa: la robótica más famosa del mundo pone a un jefe de IA al mando

El robot cuadrúpedo Spot, amarillo y negro, caminando sobre un escenario con iluminación azul

Durante treinta años, Boston Dynamics fue la empresa que resolvía lo que nadie sabía resolver. Primero fueron robots que recuperaban el equilibrio de una patada, luego uno que daba volteretas hacia atrás, después un perro mecánico que sube escaleras y un humanoide que corre y salta sin cables. Cada vídeo suyo marcaba el límite de lo que una máquina podía hacer con su cuerpo, y lo marcaba por bastante margen.

El problema es que resolver el cuerpo resultó ser la mitad fácil. Un robot que da volteretas sigue necesitando que alguien le diga qué hacer, y esa parte —mirar una caja desconocida, entender que hay que moverla, decidir cómo agarrarla— llevaba décadas atascada. Lo que la ha desatascado en los últimos tres años no ha salido de la robótica, sino de los modelos de lenguaje y de visión.

Ese es el contexto del movimiento que la empresa anunció ayer.

Boston Dynamics tiene nuevo director desde hoy, y no viene de la robótica. Es Rohit Prasad, que pasó doce años en Amazon construyendo Alexa y, al final, creando la familia de modelos fundacionales Nova. Antes había estado casi catorce años en Raytheon BBN Technologies. El puesto llevaba vacío de pleno derecho desde febrero, cuando Robert Playter se marchó tras treinta años en la casa y seis al frente; la directora financiera, Amanda McMaster, ha cubierto el interinato desde entonces.

La nota de prensa no se esconde sobre el porqué. Jaehoon Chang, vicepresidente de Hyundai Motor Group —dueña de la empresa—, lo resume en una frase: la robótica de Boston Dynamics y «la capacidad demostrada de Rohit para convertir la IA en productos a escala global» son, dice, «una base sólida para construir y escalar la IA física».

Claves del relevo

  • Quién entra. Rohit Prasad, hasta ahora vicepresidente sénior y científico jefe de Alexa e inteligencia artificial general en Amazon. La nota lo presenta como quien «construyó y escaló Alexa» y «creó la familia de modelos fundacionales Amazon Nova».
  • Quién sale. Robert Playter, que anunció su marcha por memorándum interno el 10 de febrero. Treinta años en la empresa, seis como director. No se ha dado ningún motivo, ni entonces ni ahora.
  • Ocho meses de interinidad. Los ha cubierto Amanda McMaster, la directora financiera. Es mucho tiempo sin mando definitivo para una empresa que acaba de empezar a fabricar su producto más ambicioso.
  • Lo que dice el nuevo. «Juntando IA avanzada y robótica podemos construir sistemas inteligentes que creen valor real en entornos del mundo real.» Nótese dónde está el acento: en el producto y en el entorno industrial, no en la investigación.
  • Tres robots en catálogo. Spot, el cuadrúpedo de inspección industrial; Stretch, el que descarga cajas de los contenedores; y Atlas, el humanoide eléctrico, que es la apuesta.

Lo que estaba pasando antes de esto

El nombramiento se entiende mejor con dos fechas delante.

Enero de 2026. Boston Dynamics anuncia que empieza la producción comercial de la versión definitiva de Atlas. Toda la tirada del año está comprometida antes de fabricarse, y los nuevos clientes tendrán que esperar a principios de 2027. Los primeros destinos son el centro de aplicaciones robóticas que Hyundai ha montado en su planta de Georgia —un sitio para aprender a meter el Atlas en una línea de montaje de verdad— y Google DeepMind, con quien se están integrando los modelos Gemini Robotics en el robot. Hyundai, por su parte, habla de fabricar treinta mil robots al año.

Quien firmaba las declaraciones optimistas de ese anuncio era Robert Playter. Un mes después se iba.

Octubre de 2024. La empresa se alía con el Toyota Research Institute para llevar al Atlas los large behavior models, que son a los movimientos lo que un modelo de lenguaje es a las frases: en lugar de programar cada tarea, se entrena una red con demostraciones y acaba encadenando acciones largas por su cuenta. En agosto de 2025 enseñaron el resultado, y el detalle técnico que importa es que un único modelo controla el robot entero, tratando las manos y los pies casi igual. Nadie escribió el código de «agarra esa pieza y camina hasta la estantería».

Dicho de otro modo: la parte de Boston Dynamics que más ha avanzado últimamente no es la mecánica. Es el software que decide.

Por qué importa

Lo fácil es leer esto como una nota de personal. Lo que de verdad dice es dónde está ahora el cuello de botella.

Durante veinte años, el problema de los robots fue el cuerpo: que no se cayeran, que agarraran sin romper, que funcionaran una semana sin un técnico al lado. Boston Dynamics ganó esa carrera por goleada y aun así vendía pocas unidades, porque un robot que hace exactamente lo que le programaste solo sirve donde el entorno no cambia nunca. Esa es la razón de que llevemos décadas viendo demostraciones espectaculares y casi ningún robot en sitios normales.

Lo que ha cambiado es que ahora hay una forma plausible de que la máquina decida sola, y viene de la misma tecnología que escribe texto. Poner al frente al que industrializó Alexa —un producto que no destacaba por su inteligencia, sino por llegar a cien millones de dispositivos— es decir en voz alta que la prioridad ya no es la demostración, sino la unidad vendida.

Y hay una lectura menos cómoda. Boston Dynamics es una empresa admirada que ha ganado poco dinero en toda su historia, comprada primero por Google, luego por SoftBank y desde 2021 por Hyundai. El socio nuevo con el que integra su cerebro, Google DeepMind, es también el de su primer dueño. Un director fichado para «convertir la IA en productos a escala global», tras ocho meses de interinidad y justo cuando arranca la producción, suena a que a alguien se le ha acabado la paciencia con los vídeos virales.

Lo que esto no es

Tres precisiones, porque este tipo de noticia se cuenta mal con facilidad.

No hay ningún anuncio de producto. Lo de ayer es un nombramiento. Atlas sigue donde estaba en enero, Spot y Stretch también, y nada de lo que se ha dicho cambia una fecha.

No se sabe por qué se fue Playter. Ni la empresa ni él lo han explicado. Todo lo que se escriba sobre discrepancias o presiones es especulación, y por eso aquí no está.

Y que la IA decida no significa que el robot ya sirva. Los large behavior models funcionan en demostraciones cuidadas; que aguanten un turno completo en una fábrica, con ruido, polvo y piezas que llegan torcidas, está por ver. Es exactamente el mismo salto que separa a un asistente de voz que entiende el 95 % de las frases de uno que te resuelve el día.

Con esas reservas, el movimiento es coherente y vale la pena anotarlo. La empresa que durante treinta años demostró que un robot puede moverse como un animal acaba de contratar a alguien cuyo mérito es haber puesto software en cien millones de aparatos. Dice bastante sobre qué parte del problema queda por resolver.

Sobre la imagen de portada. Es un montaje sobre una foto de Spot en el Centre Stage del Web Summit 2025, tomada en Lisboa el 12 de noviembre de 2025 por Lukas Schulze / Web Summit vía Sportsfile y publicada bajo CC BY 4.0. Se ha recortado y oscurecido por la izquierda para que se lea el titular.

Más sobre robots humanoides en decodigo.com: Figure Helix 2.5, un humanoide probando tareas en casas que no conoce · LeRobot y el Unitree G1, programar un humanoide con herramientas abiertas.
Y las fuentes de esta noticia: The Robot Report sobre el nombramiento · TechCrunch sobre la marcha de Playter · The Register sobre el inicio de producción de Atlas · la alianza con el Toyota Research Institute.

Fuente: «Boston Dynamics Appoints Rohit Prasad as Chief Executive Officer», nota de prensa de Boston Dynamics del 6 de octubre de 2026, con efecto el día 7.

mold 3.0: el enlazador más rápido de Linux se reescribe en Rust y va a por el puesto de GNU ld

De todos los pasos que hay entre el código y un programa que funciona, el último es el que menos atención recibe y el que más suele hacer esperar. El compilador traduce cada archivo por separado, y después el enlazador tiene que coser todas esas piezas —más las bibliotecas— en un único ejecutable: resolver cada símbolo, colocar cada sección, ajustar cada dirección. Es un trabajo que no se puede repartir fácilmente y que hay que rehacer entero cada vez que cambias una línea.

En proyectos grandes eso se nota. Enlazar un navegador o una biblioteca de aprendizaje automático con el enlazador clásico de GNU puede llevar decenas de segundos, cada vez, al final de cada compilación. Ese es el hueco que vino a ocupar mold, que escribió Rui Ueyama partiendo de cero. No es un recién llegado al asunto: Ueyama es el autor original de lld, el enlazador de LLVM, y empezó mold precisamente porque se topó con límites de diseño que ya no podía arreglar optimizando aquel.

El resultado es, con diferencia, el enlazador más rápido que hay para Linux. Y aun así, la inmensa mayoría de las distribuciones siguen trayendo GNU ld como /usr/bin/ld. «Me parece una situación desafortunada para la comunidad de Linux», dijo Ueyama en septiembre, asumiendo parte de la responsabilidad.

El 5 de octubre de 2026 publicó la versión con la que pretende cambiarlo. Y lo primero que ha hecho ha sido tirar el código y volver a escribirlo.

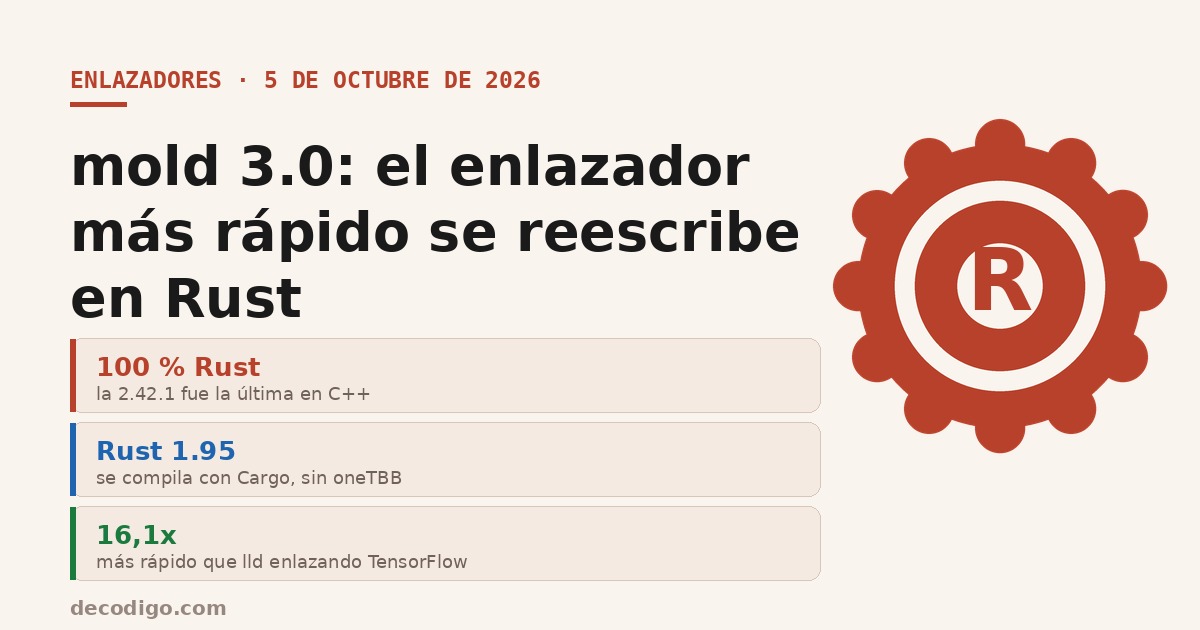
mold 3.0 es la primera versión escrita en Rust. La 2.42.1, del 11 de septiembre, fue la última del código en C++. No es una bifurcación ni un experimento paralelo: es la rama principal, y se presenta como sustituto directo de la anterior. Mismas opciones de línea de órdenes, mismas arquitecturas, misma salida salvo las correcciones de errores, y —esto es lo que no era evidente— la misma velocidad: «el rendimiento al enlazar sigue a la par con 2.42.1», dicen las notas de la versión.

Lo interesante es que la reescritura no es el objetivo. Es el medio.

Claves de mold 3.0

  • Escrito entero en Rust. Requiere Rust 1.95 o posterior y un compilador de C. Se construye con Cargo en vez de CMake.
  • Una dependencia menos. Ya no necesita oneTBB, la biblioteca de paralelismo de Intel; el paralelismo lo resuelve ahora con las herramientas del propio Rust. Sigue enlazando estáticamente mimalloc 3.5.3 como reservador de memoria.
  • Sustituto directo de la 2.42.1. Acepta las mismas opciones y produce la misma salida. El equipo pasó la batería de pruebas en todas las arquitecturas soportadas y no encontró regresiones.
  • Sin coste en velocidad. El rendimiento se mantiene igual que en la última versión en C++, que es lo que había que demostrar: una reescritura que fuera más lenta no habría servido de nada.
  • El objetivo de la serie 3.x es cerrar lo que falta para ser compatible con GNU ld, y muy en concreto el soporte de linker scripts.
  • Licencia MIT, como la 2.x.

Las cifras

De la tabla de pruebas del propio proyecto, medida en 2026 sobre un Threadripper 7980X y en compilación de depuración, que es el caso que de verdad importa porque es el que repites cien veces al día:

Programamoldlld
Blender0,86 s4,72 s5,5×
Chromium1,65 s16,64 s10,1×
TensorFlow3,15 s50,73 s16,1×

Y conviene leer bien contra quién se compara: lld, el enlazador de LLVM, que ya es bastante más rápido que GNU ld. Los cincuenta segundos de TensorFlow son con el rival bueno.

Por qué importa

Lo primero es lo evidente: medio minuto de espera al final de cada compilación no es solo tiempo perdido, es tiempo en el que te vas a otra cosa y pierdes el hilo. Un ciclo de tres segundos y uno de cincuenta producen formas distintas de trabajar.

Pero lo segundo es más importante, y es el motivo real de esta versión. Casi nadie cambia su enlazador. Hay que saber que existe la alternativa, saber que se puede cambiar y saber cómo; la mayoría de la gente que compila software en Linux usa lo que venga puesto. Por eso Ueyama no quiere que mold sea una opción que instalas: quiere que sea /usr/bin/ld.

Y ahí está el obstáculo técnico que explica todo lo demás. Para ser el enlazador del sistema no basta con enlazar programas de usuario: hay que poder enlazar también el núcleo, los cargadores de arranque y el software empotrado, y todo eso depende de los linker scripts, unos archivos que describen al detalle cómo colocar cada sección en memoria. GNU ld los soporta por completo. mold, todavía no del todo. Cerrar esa distancia es, literalmente, el propósito declarado de la serie 3.x.

¿Y por qué reescribirlo en Rust justo ahora, antes de esa tarea? Ueyama lo atribuye a las garantías de seguridad del lenguaje y a otras comodidades que le resultan útiles como desarrollador principal. Dicho de otro modo: no es un cambio pensado para el usuario, sino para quien tiene por delante años de mantener y extender un programa muy concurrente y muy manipulador de memoria.

Rust ya está en los cimientos de Linux

mold no es un caso aislado. Es una pieza más de un movimiento que lleva un tiempo ocurriendo por debajo, y que este último año ha dejado de ser una promesa.

En el núcleo. El 12 de diciembre de 2025, Miguel Ojeda envió a la lista del kernel un parche con un título que lo resume: «rust: conclude the Rust experiment». No añadía ninguna funcionalidad; quitaba dieciocho líneas de documentación, las que avisaban de que el soporte de Rust era experimental y que ningún controlador en Rust servía para producción. «En la cumbre de mantenedores de 2025 el experimento acaba de darse por concluido», explicaba el mensaje. «El experimento ha terminado, es decir: Rust se queda.»

No es una declaración simbólica. Hay controladores en Rust funcionando y en la lista del propio proyecto Rust for Linux: el Binder de Android —que va en millones de teléfonos—, el controlador de GPU Nova para hardware de NVIDIA, Tyr para las GPU Mali de Arm, el controlador de dispositivo de bloques nulo, y controladores de red PHY.

En el espacio de usuario. Ubuntu 25.10 fue la primera versión que puso por omisión uutils, la reimplementación en Rust de las utilidades básicas —ls, cat, cp y compañía—, junto con sudo-rs en lugar del sudo de toda la vida. En la 26.04 LTS la transición se frenó a propósito: cp, mv y rm se quedaron en sus versiones GNU porque una auditoría externa encontró problemas de tipo TOCTOU en las implementaciones nuevas. Esos tres son los que faltan, y Ubuntu 26.10 —que sale el 15 de octubre— está previsto que complete el cambio.

Ese episodio merece subrayarse, porque es el contrapeso honesto de toda esta historia: escribir algo en Rust no lo hace correcto. Evita una familia concreta de errores, la de memoria; no evita que una comprobación se haga en el momento equivocado.

En las herramientas. mold tampoco es el único enlazador nuevo en Rust. wild, de David Lattimore, persigue un objetivo distinto: ser rápido en el desarrollo iterativo, y a la larga hacer enlazado incremental, rehacer solo la parte que cambió en vez del ejecutable entero. Eso último todavía no está implementado, según su propia documentación, y aun así ya es lo bastante rápido como para que las pruebas de mold lo incluyan entre los rivales a los que medirse. El proyecto lo respalda el Rust Innovation Lab de la Fundación Rust.

Lo que esto no es

Tres precisiones, porque este tipo de noticias se cuenta mal con facilidad.

mold 3.0 todavía no enlaza el kernel de Linux. Poder hacerlo es el objetivo de la serie 3.x, no algo que esta versión traiga ya resuelto. Lo que se ha publicado es la misma funcionalidad de antes, sobre una base nueva.

No hace tus programas más seguros. Un fallo de memoria en un enlazador produce un binario roto o un enlazador que se cae, no una vulnerabilidad en el programa que estás compilando. El beneficio de Rust aquí es para quien mantiene mold, no para quien lo usa.

Ninguna distribución ha anunciado el cambio. Que mold aspire a ser el enlazador por omisión no significa que vaya a serlo. Eso se decide distribución por distribución, y pasa por convencer a gente que tiene buenas razones para ser conservadora con una pieza de la que depende absolutamente todo lo demás.

Con esas tres salvedades, lo que queda sigue siendo notable. Un programa de sistema, de los de verdad, de los que están debajo de todo lo demás, ha cambiado de lenguaje sin perder un ápice de rendimiento y sin que sus usuarios tengan que tocar nada. Hace cinco años ese era el argumento que se usaba para decir que no se podía hacer.

Más referencias sobre Rust en Linux: «rust: conclude the Rust experiment», de Miguel Ojeda (LKML, 12 de diciembre de 2025) · Rust for Linux, con la lista de controladores en el núcleo · Phoronix sobre el fin del experimento · documentación de sudo-rs en Ubuntu · OMG! Ubuntu sobre el final de la transición a uutils · wild, el otro enlazador en Rust · Phoronix sobre el anuncio de la reescritura.

Fuente: notas de la versión mold 3.0.0 (5 de octubre de 2026) y el repositorio de mold, de donde salen las cifras de las pruebas.

Cómo se construye el pensamiento lógico para programar: lo que dice la investigación

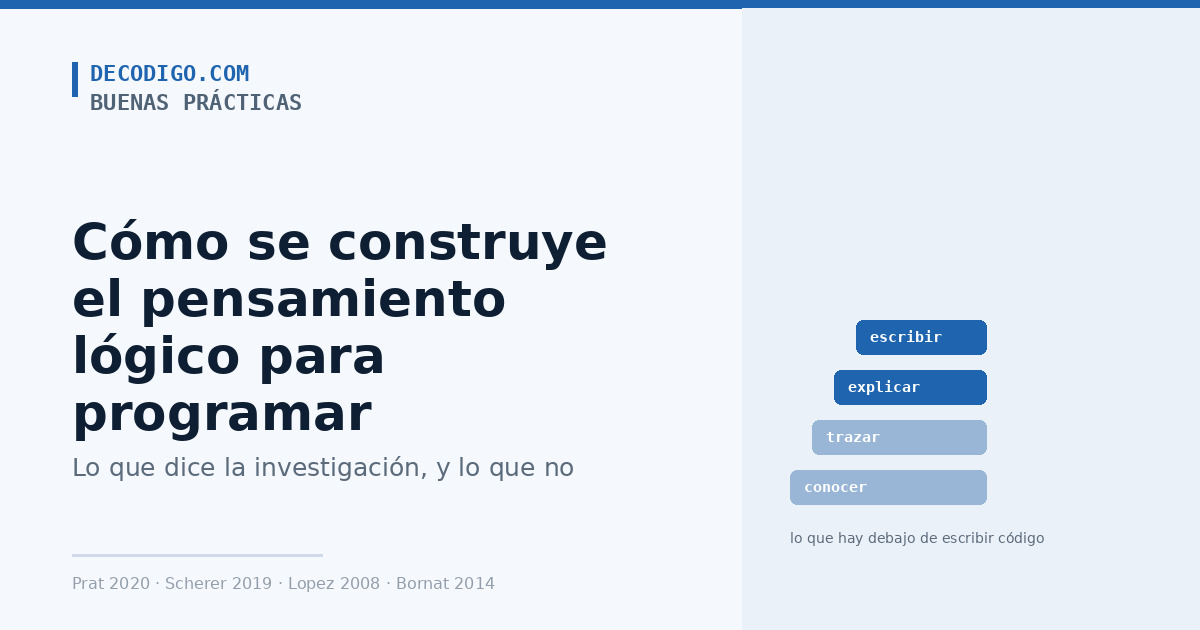
Una escalera de cuatro peldaños —conocer, trazar, explicar, escribir— junto al título del artículo

«Es que yo no tengo cabeza para esto.» Lo dice mucha gente que empieza a programar y se atasca, y detrás hay una creencia muy extendida: que existe un tipo de mente lógica, que unos la tienen y otros no, y que sin ella no hay nada que hacer. Resulta que esa pregunta se ha estudiado bastante, y lo que ha salido no se parece casi nada a lo que se repite.

Primero: el «gen del programador» no existe, y quien lo propuso se retractó

En 2006 circuló un artículo con un título que hizo fortuna: The camel has two humps, «el camello tiene dos jorobas». Sostenía que los estudiantes de programación no se reparten en una campana de Gauss sino en dos grupos separados —los que lo pillan y los que no lo pillarán nunca— y que un test sencillo podía distinguirlos antes de empezar el curso. La idea se citó durante años.

En julio de 2014, su autor, Richard Bornat, publicó una retractación. No una matización: una retractación.

«Dehnadi no descubrió un test de aptitud para programar. No encontró una manera de separar a las ovejas programadoras de las cabras no programadoras. No habíamos demostrado que la naturaleza gane a la crianza.»Richard Bornat, Camels and humps: a retraction, 24 de julio de 2014

El texto es insólito por lo franco. Bornat explica que escribió el artículo original mientras un antidepresivo le había provocado un episodio maníaco —se describe a sí mismo como «grandioso, extremadamente autojustificado y muy combativo»— y que las réplicas posteriores no sostuvieron sus afirmaciones. Un estudio en Toronto pasó el test a 59 estudiantes y no encontró diferencia con los no evaluados; otro no halló correlación entre los resultados del test y varias medidas de rendimiento en el curso.

Pero hay un matiz que suele perderse, y es la parte interesante. Bornat mantiene que su doctorando sí había encontrado algo:

Lo que Saeed Dehnadi observó fue que, al preguntar a estudiantes novatos qué hacía un programa de tres o cuatro líneas, muchos respondían como si ya tuvieran un modelo mental de lo que pasaba. No eran los modelos correctos. Eran, en palabras de Bornat, «reconociblemente racionales». Y los que respondían de forma consistente —aplicando siempre el mismo modelo, aunque fuera equivocado— acababan el curso mejor que los que iban cambiando de criterio pregunta a pregunta.

Si eso se sostiene, cambia el consejo. Lo que separaría no es tener el modelo correcto, sino tener un modelo y aplicarlo con coherencia. Es decir: leer un trozo de código y poder decir, equivocándote si hace falta, «esto hace esto y luego esto». Lo que mata no es equivocarse, es no tener ninguna hipótesis.

La pregunta del test, y qué medía en realidad

Merece la pena verla, porque la retractación de Bornat la incluye en su apéndice y explica el asunto mejor que cualquier resumen. Esta es, literalmente, una de las preguntas que se pasaba a estudiantes que nunca habían programado:

int a = 5;
int b = 3;
int c = 7;

c = b;
b = a;
a = c;

Debajo venía una lista de posibles valores finales de a, b y c para marcar. La respuesta correcta es esta:

ejecutadoa=3  b=5  c=3

Ahora viene lo interesante. Las opciones equivocadas de la lista no eran ruido: cada una es el resultado de aplicar, con total coherencia, un modelo mental distinto de lo que hace el signo igual. Programé los tres más comunes para comprobarlo:

Qué cree quien respondeA qué respuesta lleva¿Estaba en la lista?
Lo correcto: cada línea copia el valor de la derecha en la variable de la izquierda, y el cambio se arrastraa=3 b=5 c=3Sí
Que se lee al revés: c = b significa «b recibe c»a=7 b=7 c=7Sí
Que cada asignación intercambia los dos valoresa=3 b=5 c=7Sí
Que no se arrastra: cada línea usa siempre los valores de partidaa=7 b=5 c=3Sí

Las cuatro figuran entre las opciones del cuestionario original. No es casualidad: el test estaba construido así a propósito. Y de ahí sale lo que de verdad medía, que no era acertar.

Quien marcaba a=7 b=7 c=7 en todas las preguntas del test estaba equivocado, pero estaba aplicando una regla y aplicándola siempre igual. Quien marcaba una respuesta por un criterio en la primera pregunta y otro distinto en la tercera no tenía ninguna regla: estaba adivinando. Según los datos de Dehnadi, los primeros acababan el curso mejor que los segundos.

La moraleja práctica. Cuando leas código y no lo entiendas, lo peor que puedes hacer es encogerte de hombros. Lo que hay que hacer es comprometerse con una predicción: «yo creo que esto deja a en 7». Si ejecutas y sale 3, acabas de localizar exactamente qué parte de tu modelo está mal, y eso se arregla. Si no predijiste nada, no has aprendido nada aunque veas el resultado correcto.

Qué predice de verdad aprender a programar

En 2020, un equipo de la Universidad de Washington publicó en Scientific Reports el estudio más directo que conozco sobre la pregunta. Midieron a 36 personas sin experiencia previa en una batería de pruebas —aptitud para los idiomas, razonamiento fluido, memoria de trabajo, aritmética y actividad cerebral en reposo— y después las pusieron a aprender Python en diez sesiones de 45 minutos, midiendo cuánto avanzaba cada una.

Qué predice aprender a programar, según Prat et al. 2020Qué explica lo que una persona avanza aprendiendo a programarVarianza explicada, promedio de las tres medidas de resultado. Prat et al. (2020), 36 participantesRazonamiento fluido y memoria de trabajoRazonamiento fluido y memoria de trabajo: 34 %34 %Aptitud para los idiomasAptitud para los idiomas: 17 %17 %Actividad cerebral en reposoActividad cerebral en reposo: 10 %10 %AritméticaAritmética: 2 %2 %Los modelos explican entre el 50 % y el 72 % del resultado. El resto no lo explica ninguna de estas cuatro cosasMirando solo la velocidad de aprendizaje, la aptitud para los idiomas sube al 43 %

La aritmética explica el 2 %. No es que no sirva de nada; es que, frente a lo que casi todo el mundo da por supuesto, no es ni de lejos lo que marca la diferencia. Los propios autores lo dicen en el resumen: «la importancia de la aritmética puede estar sobrevalorada en los entornos modernos de educación en programación».

Lo que sí pesa es la combinación de razonamiento fluido y memoria de trabajo —la capacidad de sostener varias cosas en la cabeza y relacionarlas— y, de manera llamativa, la aptitud para aprender idiomas. La hipótesis del estudio era precisamente esa: que aprender un lenguaje de programación de adulto se parece más a aprender un segundo idioma que a hacer cuentas.

Cuidado con cómo se ha contado esto. Verás titulares del tipo «los idiomas predicen más que las matemáticas». Esa versión sale de mirar solo una de las tres medidas, la velocidad de aprendizaje, donde la aptitud lingüística llega al 43 % según la nota de prensa de la propia universidad. En el promedio de las tres medidas, que es lo que publica el artículo, el primer puesto lo ocupan el razonamiento fluido y la memoria de trabajo. Y son 36 personas: es un estudio pequeño, sugerente, no una ley.

La escalera: trazar y explicar van antes que escribir

La segunda línea de investigación útil no mira lo que traes de casa, sino el orden en que se adquieren las habilidades. En 2008, un grupo analizó las respuestas de 38 estudiantes a un examen de final de primer semestre y buscó qué tipos de pregunta predecían el resultado en la parte de escribir código.

La escalera de habilidades antes de escribir códigoLa escalera: lo que hay que saber hacer antes de escribir códigoConocer las piezasqué hace un if, qué hace un bucleTrazarseguir el código a mano y decir qué vale cada cosaExplicardecir en una frase para qué sirve el conjuntoEscribirproducir código propio que funcioneCuánto predice cada unaTrazar, por sí solo15 %Explicar, por sí solo7 %Las dos juntas46 %de lo que varía al escribir códigoLopez et al. (2008), 38 estudiantes. Una réplica de 2022 con más de 600 halló otras ordenaciones igual de válidas

El resultado es el que da nombre a la idea de una escalera. Saber trazar código —seguirlo a mano, línea a línea, y decir qué vale cada variable— explicaba por sí solo el 15 % de lo que variaba al escribir. Saber explicar en una frase para qué sirve un fragmento explicaba un 7 %. Pero las dos juntas explicaban el 46 %: casi la mitad.

La lectura práctica es bastante clara, y es lo contrario de lo que hace casi todo el mundo cuando empieza: antes de ponerte a escribir, acostúmbrate a coger código ajeno y responder dos preguntas. Qué vale cada cosa después de cada línea. Y para qué sirve el conjunto, dicho en una frase, sin repetir el código con palabras.

Y aquí el escepticismo obligatorio. Ese estudio tenía 38 estudiantes. Una réplica de 2009 lo encontró «en líneas generales consistente», pero avisó de que la fuerza de la relación entre explicar y escribir «es particularmente sensible a las preguntas concretas que se hagan». Y una réplica de 2022 con más de 600 estudiantes concluyó que la jerarquía original no aparece entre los modelos que mejor encajan, aunque sí otros parecidos; y añadió algo importante: estos análisis muestran correlaciones entre habilidades, no en qué orden conviene enseñarlas.

¿Y programar enseña a pensar?

La pregunta del revés también se ha estudiado, y mucho. La promesa de «enseñar a programar a los niños para que aprendan a pensar» se apoya en la idea de que la habilidad se transfiere a otros terrenos. En 2019, un metaanálisis reunió 105 estudios y 539 tamaños de efecto para comprobarlo.

TransferenciaEfecto (g de Hedges)Qué significa
Global0,49Moderada. Intervalo de confianza del 95 %: 0,37 a 0,61
Cercana0,75Fuerte, pero con mucha incertidumbre: 0,39 a 1,11
Lejana0,47Moderada: 0,35 a 0,59

Dicho en claro: sí, aprender a programar deja algo fuera de la programación. Donde más se notó fue en pensamiento creativo, habilidades matemáticas y metacognición —pensar sobre el propio pensamiento—, seguidas de las habilidades espaciales y el razonamiento. Donde menos, en el rendimiento escolar general y en la lectoescritura.

Dos avisos que vienen en el propio metaanálisis, y que explican por qué no conviene agitar el 0,49 como bandera. El primero: los efectos eran significativamente mayores en los estudios cuyo grupo de control no hacía nada que en los que lo comparaban con otra actividad. Parte de la mejora puede ser simplemente «hacer algo exigente» en vez de «programar». El segundo: los estudios publicados daban efectos mayores que los no publicados, que es la firma clásica del sesgo de publicación.

Entonces, ¿cómo se entrena?

Juntando las tres líneas sale un programa bastante concreto, y ninguna de sus piezas es «ser bueno en matemáticas».

1. Ten un modelo de la máquina, aunque sea tosco

Es la lección que queda en pie del episodio del camello. Antes de escribir, hay que poder decir qué está pasando: dónde se guardan las cosas, cuándo cambian, en qué orden se ejecutan las líneas. Coge un programa de cinco líneas y predice el resultado antes de ejecutarlo. Si aciertas, bien. Si fallas, mejor todavía: acabas de encontrar dónde tu modelo no coincide con la realidad, que es exactamente lo que había que encontrar.

Y conviene saber qué modelo usa el lenguaje que estás aprendiendo, porque no todos funcionan igual. El caso que más desconcierta a los principiantes es este:

x = [1, 2, 3]
y = x
y.append(4)

print(x)
print(y)
salida[1, 2, 3, 4]
[1, 2, 3, 4]

Casi todo el mundo espera que x siga valiendo [1, 2, 3], porque arrastra de las matemáticas del colegio la idea de que una variable es una caja con un valor dentro. En Python no es así, y el modelo correcto explica la salida sin esfuerzo:

El modelo de cajas frente al modelo de etiquetas para las variablesDos modelos de qué es una variable. Solo uno explica lo que pasa de verdadEl modelo de cajascada nombre guarda su copiax[1, 2, 3]y[1, 2, 3, 4]Predice que x sigue valiendo [1, 2, 3]y eso NO es lo que ocurreEl modelo de etiquetaslos nombres apuntan al mismo objeto[1, 2, 3, 4]xyx e y son dos nombres de una sola listatocar una es tocar la otray = x no copia nada: le pone otra etiqueta al mismo objeto. Para copiar hay que pedirlo: y = x[:]Tener claro cuál de los dos modelos usa tu lenguaje evita una familia entera de errores

La prueba está en el propio lenguaje: x is y devuelve True, porque no hay dos listas, hay una con dos nombres. Si lo que quieres es una copia de verdad, hay que pedirla:

u = [1, 2, 3]
v = u[:]          # ahora sí, una copia
v.append(4)

print(u, v, u is v)
salida[1, 2, 3] [1, 2, 3, 4] False

No hace falta aprenderse esto de memoria. Hace falta tener un modelo de qué pasa al escribir y = x, y ponerlo a prueba en cuanto algo no cuadre.

2. Traza a mano antes de escribir

Papel y lápiz, una tabla con una columna por variable, y una fila por cada vuelta del bucle. Es lento y es aburrido, y es lo que más correlaciona con llegar a escribir código que funcione. También es lo primero que la gente se salta.

Veámoslo con un caso concreto. ¿Qué devuelve esto?

def misterio(nums):
    tope = nums[0]
    for n in nums:
        if n > tope:
            tope = n
    return tope

misterio([3, 9, 4, 1, 7])

La tentación es ejecutarlo y ver qué sale. El ejercicio es el contrario: rellenar esta tabla a mano, una fila por vuelta, antes de tocar el teclado.

Vueltann > topetope al terminar
antes de empezar——3
1.ª3no3
2.ª9sí9
3.ª4no9
4.ª1no9
5.ª7no9

Devuelve 9. Lo valioso no es el número: es que al rellenar la tabla has tenido que decidir, en cada fila, qué valía cada cosa. Si te equivocas en una fila, esa casilla te señala el punto exacto donde tu modelo falla. Es un depurador de papel, y funciona igual de bien en cualquier lenguaje.

Dos preguntas que conviene hacerse siempre al acabar la tabla: ¿qué pasa si la lista está vacía? ¿Y si todos los números son iguales? Ahí es donde aparecen la mitad de los errores de verdad.

3. Explica en una frase

Después de entender un fragmento, resúmelo sin describirlo línea a línea: no «recorre el array y compara cada elemento con el siguiente», sino «comprueba si está ordenado». Esa diferencia —ver el bosque y no solo los árboles— es la que distinguía en los estudios a quien iba bien de quien iba regular.

Un ejemplo. Este fragmento:

def otro(nums):
    for i in range(len(nums) - 1):
        if nums[i] > nums[i + 1]:
            return False
    return True
Tipo de respuestaQué se dice
Línea a línea«Recorre los índices hasta el penúltimo, compara cada elemento con el siguiente y, si uno es mayor, devuelve falso; si acaba el bucle, devuelve verdadero.»
En una frase«Comprueba si la lista está ordenada de menor a mayor.»

La primera no está mal: es correcta y completa. Pero es una traducción del código a castellano, no una comprensión. La segunda exige haber visto para qué sirve el conjunto, que es la habilidad que en los estudios aparecía como escalón intermedio.

Hay una manera limpia de comprobar si de verdad lo has entendido: ponerle nombre. Si tu frase es buena, se convierte en el nombre de la función casi sola. Aquí otro pasaría a llamarse esta_ordenada, y el código deja de necesitar explicación.

4. Ponte a prueba en vez de releer

Aquí no hay que inventar nada: hay un informe de 2013 que revisó las técnicas de estudio más usadas y las puntuó por utilidad real. Las dos mejor valoradas fueron ponerse a prueba —intentar recuperar lo aprendido sin mirar— y repartir el estudio en el tiempo en vez de concentrarlo. Entre las peor valoradas: releer, subrayar y resumir, que son justo las tres que hace todo el mundo.

Llevado a programar: cerrar el tutorial y rehacer el ejercicio de memoria vale más que volver a leerlo tres veces. Y veinte minutos al día durante dos semanas valen más que una tarde entera de sábado.

5. Acepta la carga y redúcela

Si lo que más pesa es la memoria de trabajo, la consecuencia práctica es que hay que dejar de pedirle cosas. Nombres de variable que se entiendan sin recordar nada. Funciones cortas. Un problema a la vez. No es estilo: es quitarle peso a la parte de tu cabeza que resultó ser la más limitante.

Lo que no sabemos

Conviene terminar por aquí, porque la literatura es más modesta de lo que parecen sus titulares. Los estudios son pequeños —36 personas, 38 estudiantes—, las réplicas matizan o no confirman, y el metaanálisis grande viene con problemas de diseño reconocidos. Nadie ha demostrado qué orden de enseñanza es el mejor; se han demostrado correlaciones entre habilidades, que no es lo mismo.

Lo que sí se puede afirmar con cierta tranquilidad es lo que no hay: no hay evidencia de un don innato que reparta a la gente en dos grupos, y lo más parecido que se publicó acabó retractado por su propio autor. Lo que hay son habilidades que se entrenan, un par de ellas identificadas con bastante consistencia, y una creencia muy cara —«no tengo cabeza para esto»— que no se sostiene en los datos.

Si lo que buscas es la versión práctica y aplicada al día a día, con la IA ya de por medio, está en los diez consejos para quien empieza.

Las fuentes, de un vistazo

EstudioQué midióTamañoQué hay que tener en cuenta
Prat et al. (2020), Scientific ReportsQué predice aprender Python36Muestra pequeña; los titulares usan solo una de las tres medidas
Bornat (2014), retractaciónRetira el «test de aptitud» de 2006—El autor mantiene que hay un fenómeno real sin explicar
Lopez et al. (2008)Trazar y explicar frente a escribir38Réplica de 2022 con 600+: la jerarquía original no es la que mejor encaja
Scherer et al. (2019), J. Educ. Psychol.Si programar transfiere a otras capacidades105 estudiosGrupos de control pasivos y sesgo de publicación inflan el efecto
Dunlosky et al. (2013)Qué técnicas de estudio funcionanrevisiónNo es específico de programación

Todas las cifras se comprobaron contra la fuente original, no contra resúmenes: Prat, Madhyastha, Mottarella y Kuo (2020); la retractación de Bornat; el metaanálisis de Scherer, Siddiq y Sánchez Viveros; la réplica de Fowler et al. (2022), y el informe de Dunlosky, Rawson, Marsh, Nathan y Willingham en Psychological Science in the Public Interest. Los datos de Lopez et al. (2008) se tomaron de la réplica de Venables, Tan y Lister (2009), que los reproduce y los discute.

Aprender a programar cuando la IA ya escribe el código: diez consejos para quien empieza

Una persona señalando una lección de programación en la pantalla de su portátil

En 2013 publicamos aquí diez consejos para programadores que empiezan. Casi todos siguen valiendo: lee mucho, prueba tu código, no acumules malas prácticas, diviértete. Lo que ha cambiado en estos trece años no es la lista, es una cosa concreta: ahora puedes producir código que funciona sin haber entendido nada. Eso es nuevo, y cambia por dónde hay que tener cuidado.

El problema de fondo, en cuatro cifras

No hace falta opinar sobre si la IA es buena o mala para aprender. Hay datos, y apuntan todos en la misma dirección: la herramienta se ha vuelto universal y la confianza en ella ha bajado.

DatoCifraDe dónde sale
Programadores que usan o van a usar IA84 %Encuesta de Stack Overflow, 2025
Que confían en que acierta33 %Solo un 3,1 % confía «mucho»
Que se topan con respuestas «casi bien, pero no»66 %Su queja número uno
Que tardan más en depurar código generado45 %Su queja número dos

Y hay un dato más incómodo. En 2025, METR hizo un experimento con dieciséis programadores veteranos trabajando sobre sus propios proyectos, 246 tareas reales repartidas al azar entre «con IA» y «sin IA». Esperaban ir un 24 % más rápido con ella. Tardaron un 19 % más. Y lo más llamativo: al terminar seguían creyendo que habían ido un 20 % más rápido.

Cuidado con lo que ese estudio dice y lo que no. Los propios autores advierten de que no prueba que la IA frene a la mayoría de programadores: eran dieciséis veteranos, en repositorios enormes que conocían de memoria y con un listón de calidad alto. El dato que sí importa para quien empieza no es el 19 %, es el otro: la diferencia entre lo que creían y lo que medían. La sensación de ir rápido no es fiable, y es justo la sensación que engancha.

Los dos bucles

Dos maneras de usar la IA al aprender a programarLos dos bucles. Los dos producen código que funciona; solo uno enseñaEl bucle que no enseñadescribes el problemapegas lo que te danfuncionapasas al siguienteAl mes siguiente no sabesqué hace tu propio proyectoEl bucle que enseñalo intentas tú primerote atascas y preguntascomparas con lo tuyolo ejecutas y lo rompesTardas más hoy y muchomenos dentro de tres mesesLa diferencia no está en usar o no usar la IA: está en si llegas a ella con una pregunta o sin ella

Aquí está todo el asunto. Los dos bucles producen código que funciona. En el primero el proyecto avanza y tú no; en el segundo avanzan los dos. La diferencia no es usar o no usar la IA, sino si llegas a ella con una pregunta formada o sin ella.

Diez consejos

1. Escribe a mano hasta que el patrón te salga solo

Un bucle, una condición, abrir un archivo, recorrer una lista. Mientras eso no te salga sin pensar, escríbelo tú aunque tardes diez veces más. No es masoquismo: es que lo que no has escrito nunca tampoco sabrás leerlo después, y vas a pasarte la vida leyendo código. Cuando el patrón ya sea aburrido, delégalo sin remordimiento.

2. Pide explicaciones, no soluciones

«Escríbeme una función que ordene esta lista» te deja donde estabas. «Explícame por qué mi función devuelve la lista vacía» te deja mejor. Es la misma herramienta y el mismo minuto, y el resultado para ti es completamente distinto.

Un truco que funciona muy bien: pídele que critique tu código en lugar de escribirlo. «¿Qué le ves mal a esto?» suele dar más que cualquier cosa que te genere de cero.

3. Ejecuta todo. Siempre. Sin excepción

Que el código tenga buen aspecto no significa nada. Esta guía misma sale de un sitio donde todo lo que se publica se compila y se ejecuta antes, y esa costumbre ha pillado cosas que ninguna lectura habría pillado.

Un caso real de esta casa. Preparando un artículo sobre medir el rendimiento en Rust, un programa de prueba sumaba tres millones de cuadrados y daba un tiempo de 40 nanosegundos. Era imposible, y la explicación no era un error de medición: el compilador se había dado cuenta de que el resultado se podía calcular con una fórmula cerrada y había eliminado el bucle entero. El código era correcto y la medición no medía nada. Leyéndolo no se veía; ejecutándolo y desconfiando del número, sí.

4. Desconfía de las versiones y de los nombres

Es el fallo más frecuente y el más silencioso: la IA te da una versión de biblioteca o un nombre de función que suena perfectamente razonable y no existe, o existía hace dos años. No miente a propósito; reproduce lo que vio.

Otro caso de aquí: en una lección de Rust apareció una dependencia con la versión 0.9.2. Parecía correcta. La versión real era la 0.10.3, y en medio había una función que se había mudado de sitio, así que el ejemplo no compilaba. La regla que salió de ahí es sencilla: las versiones se preguntan a la herramienta del lenguaje —cargo add, npm view, pip index—, nunca de memoria. Ni de la tuya ni de la suya.

5. Aprende a depurar, que es lo que peor hace

Un 45 % de los programadores dice que depurar código generado le lleva más tiempo, y tiene sentido: para arreglar algo hay que tener un modelo mental de cómo funciona, y si el código no lo escribiste tú, no lo tienes.

Depurar no es pedirle a la IA que arregle el error. Es leer el mensaje entero —entero, no la primera línea—, reducir el problema hasta el caso más pequeño que falla, e imprimir valores hasta encontrar dónde deja de ser lo que creías. Esa habilidad es la que separa a quien avanza de quien se queda bloqueado, y es la única de esta lista que no se puede delegar.

6. Aprende la terminal y Git antes que ningún framework

Toda herramienta de IA da por hecho que sabes moverte por un sistema de archivos, leer un error en una consola y deshacer un cambio. Si no, cada sugerencia te deja más perdido que antes. Son dos tardes de inversión y valen para el resto de tu carrera: aquí tienes los comandos de Linux que de verdad se usan y las órdenes de Git.

Lo de Git tiene un motivo extra ahora: si vas a aceptar código que no escribiste, más te vale poder volver atrás con una orden.

7. El contexto lo pones tú

La IA sabe de código; de tu problema no sabe nada. No sabe qué datos vas a recibir de verdad, qué pasa si el usuario deja el campo vacío, ni por qué en tu empresa las fechas se guardan así. Cuando le pides algo sin contarle eso, rellena los huecos con lo más común, que casi nunca es tu caso.

De ahí sale el consejo práctico: antes de pedir nada, escribe en una frase qué entra, qué tiene que salir y qué pasa cuando algo va mal. Si no sabes escribir esa frase, el problema no es la herramienta.

8. No aceptes nada que no sabrías defender

La prueba es sencilla: si alguien te preguntara por qué esa línea está ahí, ¿sabrías contestar? Si no, no la publiques. No porque esté mal —puede estar perfecta—, sino porque el día que falle vas a estar tú delante y no vas a tener por dónde empezar.

Qué conviene delegar a la IA mientras se aprende y qué noQué puedes delegar mientras aprendes, y qué te tienes que quedardelega sin miedono lo deleguesDelegalo repetitivo que ya sabes escribirbuscar en la documentacióntraducir un error a lenguaje llanogenerar datos de pruebaRevisacódigo que no sabrías escribirnombres de funciones y versioneslo que toque archivos o la redsus explicaciones: suenan segurasHazlo túdecidir qué problema resuelvesejecutar y comprobar que sirvedepurar cuando fallaentender lo que vas a publicar

9. Termina cosas, aunque sean pequeñas

Con la IA es facilísimo empezar diez proyectos ambiciosos y no acabar ninguno, porque los primeros pasos salen gratis y los últimos no. Y lo que de verdad enseña está al final: el caso raro, el despliegue, el error que solo aparece con datos reales, la parte aburrida de dejarlo presentable.

Un programa pequeño y terminado enseña más que tres grandes a medias. Esto no es nuevo: ya estaba en la lista de 2013 y sigue siendo verdad.

10. Lee código que no sea tuyo

Entra en un proyecto de código abierto que uses y lee cómo está hecho. Verás decisiones que no se te habrían ocurrido y, sobre todo, verás cómo se organiza algo que lleva años vivo, que es exactamente lo que ninguna herramienta te va a enseñar de un tirón.

Aquí la IA sí ayuda mucho, y de la forma correcta: como lector infinito al que puedes preguntarle «¿qué hace este archivo?» sin que se canse.

Lo que está pasando con el código de todos

Hay una razón para insistir tanto en entender lo que se acepta, y no es moral: se está midiendo en los repositorios reales. La empresa GitClear analizó 623 millones de cambios de código entre 2023 y 2026, y el patrón es consistente.

Qué mide20232026
Bloques de código duplicados (por millón de líneas)40,373,0
Copiar y pegar dentro de un mismo commit9,4 %15,7 %
Líneas movidas, es decir, refactorizadas13 %3,8 %
Llamadas a funciones de otros archivos (reutilización)343223

Se duplica más y se reordena mucho menos. Los propios autores piden no leerlo como «la IA escribe mal»: lo que dicen es que el flujo de trabajo habitual con IA premia lo inmediato y lo visible, mientras «grava en silencio lo invisible y lo aplazado». Reordenar código que ya funciona es trabajo invisible, y es el primero que desaparece cuando generar una versión nueva cuesta diez segundos.

Para alguien que empieza esto se traduce en algo muy concreto: la habilidad que va a escasear no es escribir código, es ordenarlo.

Lo que no ha cambiado

Conviene cerrar por donde empezamos. De aquella lista de 2013, lo que sigue intacto es casi todo: leer mucho, no adoptar una tecnología solo porque es nueva pero probarlas igualmente, compartir lo que aprendes, cuidarte y pasarlo bien. Nada de eso depende de qué herramienta tengas abierta.

Y hay algo que la irrupción de la IA ha puesto más claro todavía: el trabajo nunca fue teclear. Era entender un problema lo bastante bien como para explicárselo a una máquina sin ambigüedades. Eso es lo que estás aprendiendo cuando aprendes a programar, y es exactamente lo que no se delega, porque es lo único que hay que saber para poder delegar el resto.

Sobre la imagen de portada. Es un montaje sobre la fotografía «Learning to Code», de Preply.com Images, bajo licencia CC BY 2.0, vía Wikimedia Commons.

Las cifras de este artículo están comprobadas contra sus fuentes originales: la encuesta a desarrolladores de Stack Overflow de 2025 (33 662 respuestas en la pregunta sobre confianza), el experimento de METR con programadores veteranos y el informe de GitClear sobre mantenibilidad. Los dos ejemplos de errores reales salen de artículos publicados en este sitio, donde todo el código se ejecuta antes de publicarse. Si quieres el otro lado del asunto, está qué cambia en el oficio cuando escribir código deja de ser el centro.

El cohete vuela con Linux, C++ y un navegador web: lo que SpaceX ha contado de su software

Interior de una cápsula Crew Dragon con dos astronautas, junto al titular sobre el software de vuelo de SpaceX

El software que lleva a una persona al espacio tiene fama de ser una cosa aparte: lenguajes raros, procesadores endurecidos contra la radiación que cuestan una fortuna, sistemas operativos de tiempo real diseñados para aviones y décadas de certificación. Durante mucho tiempo fue exactamente así, y en buena parte de la industria lo sigue siendo.

SpaceX lo hace de otra manera, y lo ha contado. No hay código abierto ni documentación oficial, pero su equipo de software se ha sentado tres veces a responder preguntas en abierto —en 2013, en 2015 y sobre todo en junio de 2020, unos días después del primer vuelo tripulado de la Crew Dragon—, y de ahí sale casi todo lo que se sabe. Esto es lo que dijeron, y lo que conviene no dar por cierto.

Claves

  • Sistema operativo: Linux. No un sistema de tiempo real clásico, sino un Linux poco modificado con los parches PREEMPT_RT, con núcleo y cadena de herramientas propios.
  • Lenguajes: C++ para el software de vuelo, Python para las pruebas y HTML, CSS y JavaScript para las pantallas de la Crew Dragon.
  • Sí, un navegador: esas pantallas las dibuja Chromium, el mismo motor que hay debajo de Chrome. Solo dibuja; no pilota.
  • Nada de silicio especial: componentes comerciales corrientes en vez de procesadores endurecidos, y la radiación se compensa con el diseño del sistema.
  • Triple redundancia: cada decisión se calcula tres veces y se vota antes de emitirla.
  • Un equipo pequeño: unas 35 personas en 2013 y en torno a 50 hacia 2019 para todo el software de vuelo de todos los vehículos.

Cómo se toma una decisión a bordo

Esta es la parte interesante, y la que explica por qué se pueden usar procesadores de los que lleva cualquier portátil. En vez de comprar un chip carísimo que aguante la radiación, SpaceX asume que un chip corriente va a equivocarse de vez en cuando y monta el sistema para que una equivocación no llegue a ninguna parte.

El esquema de redundancia triple con el que el Falcon 9 toma cada decisiónCómo se toma una sola decisión a bordo del Falcon 9hilo de vuelo 1núcleo 1núcleo 2¿coinciden?si no, no emite nadahilo de vuelo 2núcleo 1núcleo 2¿coinciden?si no, no emite nadahilo de vuelo 3núcleo 1núcleo 2¿coinciden?si no, no emite nadael controlador compara los tressi uno discrepa, hace caso al que venía acertandola orden sale al motorProcesadores comerciales corrientes: la radiación se compensa con el diseño, no con silicio especial

El mecanismo se conoce como actor-juez. Hay tres «hilos de vuelo» independientes, cada uno con dos núcleos que ejecutan lo mismo. Un hilo solo emite una orden si sus dos núcleos coinciden; si discrepan, calla. Después, el controlador que recibe las órdenes compara los tres hilos: si los tres dicen lo mismo, adelante; si uno se sale, se hace caso al que venía acertando y se ignora al discrepante.

Los motores Merlin del Falcon 9 llevan su propia versión del mismo reparto: tres ordenadores que votan, cada uno con dos procesadores que se vigilan entre ellos.

Por qué esto importa más de lo que parece. Un procesador endurecido contra la radiación suele ir una década por detrás en potencia de cálculo, porque el proceso de fabricación que lo hace resistente es antiguo. Resolver la fiabilidad con arquitectura en vez de con silicio deja usar piezas actuales, baratas y potentes. Es la misma decisión de fondo que hace que un Falcon 9 cueste lo que cuesta.

Qué corre dónde

Las capas del software de un vehículo de SpaceXLas capas, de lo que ve el astronauta a lo que hay debajoPantallas de la Crew Dragoncon botones físicos de respaldoHTML · CSS · JavaScript, dibujado por ChromiumSoftware de vuelolo que de verdad pilota; Chromium no entra aquíC++Sistema operativonúcleo y cadena de herramientas propiosLinux con los parches PREEMPT_RTProcesadortriple redundancia en lugar de silicio especialcomponentes comerciales, no endurecidosNada de esto es código público: sale de lo que el propio equipo ha contado en abierto

La capa de arriba es la que dio que hablar. Cuando los astronautas de la Demo-2 pilotaron la cápsula con pantallas táctiles, resultó que lo que veían era HTML y JavaScript dibujados por el mismo núcleo que hay debajo del navegador Chrome. SpaceX usa Chromium únicamente como motor de dibujo, con una biblioteca reactiva propia encima, y lo mantiene aislado del resto: según el equipo, una pestaña colgada no se lleva por delante la cápsula. Y hay botones físicos de respaldo para lo esencial.

Debajo, lo que de verdad vuela la nave es C++ sobre Linux, y ahí Chromium no entra.

Starlink juega con otras reglas

Lo más revelador de la sesión de 2020 fue la comparación entre las dos mitades de la casa, porque enseña que no hay «una» manera de hacer software en SpaceX, sino dos muy distintas según lo que pase si algo falla.

Crew DragonStarlink
Qué pasa si falla unoEs una pérdida de misiónPerder un satélite no es una pérdida de misión
Ritmo de cambiosEl código se congela meses antes del vueloActualizaciones aproximadamente semanales
Forma de trabajarVerificación exhaustiva antes de volarIteración rápida, «como armarios de servidores en un centro de datos»

De esa diferencia sale un detalle que resume bien la escala: los satélites Starlink recién lanzados suelen llegar a órbita con el código ya atrasado respecto al resto de la constelación, porque entre que se cargó y que llegaron arriba el software ha seguido avanzando. En 2020 el equipo hablaba de más de treinta mil nodos Linux en órbita y más de seis mil microcontroladores.

Esa misma constelación es la que Starship empezó a desplegar en su primer vuelo orbital, y es también la razón de que la cifra no pare de crecer.

Lo que circula y no está claro

Buena parte de lo que se lee sobre este asunto son relatos de segunda mano de aquellas sesiones, y por el camino se han colado cosas que conviene marcar.

Se dice que…Qué pasa con eso
Los procesadores son x86Es lo que repiten la mayoría de fuentes, pero el relato de una charla en la GDC habla de tres procesadores ARM de doble núcleo en placas propias. No hay una declaración oficial que lo zanje
Usan VxWorksChoca de frente con lo que el propio equipo dijo en 2020 sobre Linux y PREEMPT_RT. Aparece en algún resumen y no en las fuentes directas
Certifican según la norma DO-178BNo he encontrado ninguna fuente primaria. Es una norma del mundo aeronáutico, no del lanzamiento espacial comercial
El simulador de atraque de su web lleva el código realEl equipo lo desmintió expresamente: no es el mismo código que vuela en la Crew Dragon
Y una cosa que no es menor: las pantallas de la sala de control de Hawthorne, las que salen en las retransmisiones, están hechas con LabVIEW. Es software de instrumentación industrial, no de vuelo, pero sirve de recordatorio de que «el software de SpaceX» son en realidad muchos programas distintos con requisitos muy diferentes.

Por qué importa

Importa porque desmonta una idea muy extendida: que el software crítico exige herramientas exóticas. Aquí hay un vehículo tripulado volando con el mismo núcleo que corre en cualquier servidor y con el mismo lenguaje que se usa para escribir videojuegos. La diferencia no está en las piezas, está en cómo se combinan: la fiabilidad la aporta la arquitectura —tres cálculos y una votación—, no la etiqueta del componente.

Importa también porque enseña que el nivel de rigor se elige según lo que cuesta un fallo, y no de manera uniforme. El mismo equipo congela el código de una cápsula durante meses y despliega en la constelación cada semana. Esa es una decisión de ingeniería deliberada, no una incoherencia, y es trasladable a cualquier proyecto en el que convivan partes que no pueden fallar con partes que pueden reintentarse.

Y conviene cerrar con la advertencia que atraviesa todo lo anterior: esto no es documentación, son declaraciones. Son respuestas en un foro, sin referencias, algunas ya con años encima y sin forma de contrastarlas. Lo mejor que se puede decir de ellas es que vienen del propio equipo; lo peor, que es lo único que hay.

Sobre la imagen de portada. Es una fotografía de archivo del interior de una Crew Dragon, con Robert Behnken y Douglas Hurley antes de la misión Demo-2, tomada en marzo de 2020. No tiene relación directa con el software del que habla el artículo, más allá de ser la nave cuyas pantallas se mencionan. Fotografía de SpaceX, bajo dominio público (CC0), vía Wikimedia Commons.

Fuentes: las sesiones de preguntas del equipo de software de SpaceX en Reddit (2013, 2015 y junio de 2020, recogida por Hackaday), InfoQ sobre el uso de JavaScript en la Dragon, la ficha del Falcon 9 v1.0 en Wikipedia para la aviónica y el hilo de Hacker News sobre el ordenador de vuelo.

Linux afina qué página de memoria expulsa primero: los parches MGLRU-FG

Tux junto a cuatro cajas de generaciones de memoria sobre fondo crema, con el titular sobre los parches MGLRU-FG

Cuando a un servidor se le acaba la memoria no se cae: empieza a elegir. El núcleo decide qué páginas saca de la RAM para hacer sitio, y de ese criterio depende que el sistema siga respondiendo o se arrastre. Durante décadas el algoritmo fue el mismo, el LRU: dos listas, una de páginas activas y otra de inactivas, y se expulsa por el final de la inactiva.

Ese esquema envejeció mal. Con cientos de gigabytes de RAM y miles de procesos, recorrer las listas sale caro y la distinción entre «activa» e «inactiva» es demasiado tosca. Por eso Linux incorporó en la versión 6.1 el MGLRU, Multi-Gen LRU: en lugar de dos listas hay varias generaciones, las páginas envejecen de una a otra y se expulsa siempre de la más vieja.

Lo que acaba de proponerse es el siguiente paso. Kairui Song, ingeniero de Tencent, envió el 3 de octubre a la lista de correo de gestión de memoria del kernel la tercera revisión de MGLRU-FG, diecisiete parches que cambian el criterio por el que una página sube de generación. En sus pruebas reporta «entre un 10 % y un 40 % más de rendimiento o menos refaults en distintas pruebas». Conviene decir cuanto antes que es una serie RFC: una propuesta para discutir, no algo que vaya a estar en tu servidor el mes que viene.

LRU clásico con dos listas frente a MGLRU con varias generacionesLas dos formas de decidir qué página de memoria se expulsa primeroLRU clásicodos listasactivainactivaal 2.º accesose expulsa del final de la inactivaMGLRUvarias generacionesgen 0la másviejagen 1gen 2gen 3la másjovenenvejecen hacia la izquierdase expulsa de aquíMGLRU ya está en el kernel desde la versión 6.1. Lo que cambia ahora es cómo se sube de generación

Claves de la propuesta

  • Qué significan las siglas: FG es frequency guided, promoción guiada por frecuencia. No es «fine-grained», un error que circula estos días.
  • Qué cambia: hoy una página sube de generación cuando se la toca; con FG sube en función de cuántas veces se la ha tocado. El núcleo deja de preguntarse «¿se ha usado?» para preguntarse «¿cuánto se usa?».
  • Quién y cuándo: Kairui Song, de Tencent, el 3 de octubre de 2026. Es la revisión 3 de una idea presentada en el congreso LSF/MM/BPF.
  • Tamaño: 17 parches, 21 archivos, 882 líneas añadidas y 526 eliminadas. El grueso está en mm/vmscan.c, el corazón de la recuperación de memoria.
  • Un efecto colateral bueno: gasta un bit menos de las banderas de página, que son un recurso escaso y muy disputado dentro del kernel.
  • Estado: RFC. El propio autor dice que lo mantiene así a propósito «porque es un cambio importante del LRU».

Qué hace distinto

La idea es contar. Cada página lleva ahora una cuenta de accesos, y esa cuenta determina a qué generación sube, con unos cuantos umbrales con nombre propio que fijan los parches:

La escala de accesos con la que MGLRU-FG promociona una páginaLo que añade FG: la página sube según cuántas veces se la ha tocado0recién leída1REFERENCED2WORKINGSET3PROTECTED…7MAXaccesos contados a la página → generación a la que subeMGLRU hoy gasta un bit más de las banderas de página para esto; FG lo hace con uno menos

Parece un detalle menor y no lo es, porque arregla un defecto conocido. En el MGLRU actual, una página leída por adelantado —lo que hace el sistema cuando detecta una lectura secuencial— entra con la cuenta a cero, en la generación más vieja, y que luego se use de verdad apenas la mueve. Una página leída al azar, en cambio, entra ya un escalón por encima. El resultado es que el núcleo protege lo aleatorio y sacrifica lo secuencial, aunque lo secuencial sea lo que más se está usando.

El propio autor señala que eso no es una decisión de diseño sino un accidente, y que depende de detalles de temporización interna. Con FG la cuenta de accesos es la que manda, venga la página de donde venga.

Los números, prueba por prueba

Song publica resultados de ocho bancos de pruebas distintos, en servidores de varias arquitecturas, equipos de escritorio y dos móviles Android. Estos son los que importan para un servidor.

Compilar el kernel bajo presión de memoria

Una compilación con 96 hilos dentro de un cgroup de 3 GB, usando ZRAM como espacio de intercambio. Es el caso que el titular describe como «presión de memoria»: cuadruplica el trabajo de recuperación respecto a la prueba de 48 hilos.

Compilación con 96 hilos, cgroup de 3 GB, intercambio en ZRAM. Media de 3-4 pasadas.
MedidaMGLRU actualCon FGDiferencia
Tiempo real1 m 54 s1 m 45 s−9,5 s
Tiempo de sistema72 m 12 s57 m 10 s−21 %
Refaults de archivo488 k362 k−25,8 %
Páginas leídas de disco111,3 M100,0 M−10,1 %

El titular aquí no son los nueve segundos de reloj, sino los quince minutos de tiempo de CPU en modo núcleo que deja de gastarse. Eso es trabajo que la máquina estaba haciendo para moverse páginas a sí misma en vez de compilar.

Qué es un refault. Ocurre cuando el núcleo expulsa una página y, poco después, el programa vuelve a pedirla y hay que traerla otra vez. Es la medida directa de haberse equivocado al elegir. Bajar los refaults un 25 % significa que el sistema acierta bastante más en qué puede tirar.

Bases de datos y servicios

Cada prueba con su configuración; «LRU clásico» es el algoritmo anterior a MGLRU, incluido como referencia.
PruebaLRU clásicoMGLRU actualCon FG
MongoDB YCSB, cgroup de 16 GB, 48 hilos (ops/s)98 39083 70094 951 (+13,4 %)
Chromium y Node.js con ZRAM, 1 hora (peticiones)63 822132 763233 774 (+76 %)
LevelDB scan/get (ops/s)4 6695 0275 030
FIO con acceso zipf, cgroup de 16 GB (IOPS medias)—referencia+11,5 %

El caso más vistoso no está en esa tabla. Song reproduce el problema del acceso secuencial con dos programas corrientes: una base SQLite que relee una y otra vez una parte pequeña de un archivo, y un grep recorriendo muchos archivos que juntos no caben en RAM.

SQLite recorriendo y consultando una parte caliente, con grep machacando la caché en paralelo.
AlgoritmoConsulta en SQLiteRecorrido de grep
LRU clásico14,51 ms13 281 ms
MGLRU actual567,05 ms13 694 ms
Con FG10,58 ms12 930 ms

Esos 567 milisegundos frente a 14 son el defecto del que hablábamos: el MGLRU que hay hoy en el kernel es casi cuarenta veces más lento que el LRU clásico en ese patrón concreto. Con los parches no solo lo recupera, sino que queda por debajo de los dos.

Android, de propina

Song hizo también un portado informal a un Pixel 9 Pro con Android 17, lanzando y rotando 34 aplicaciones y 20 pestañas de Chrome hasta agotar la memoria en cada iteración, con unas dieciocho horas de pruebas en total. Los refaults de archivo bajan un 14 %, el intercambio un 12 % y las páginas leídas de disco un 18 %. En la prueba de fluidez, en cambio, no se midió ninguna diferencia perceptible.

Lo que no sale bien

Esta es la parte que la mayoría de los resúmenes se salta, y es la que decide si una serie de parches entra o no en el kernel. El autor la publica él mismo.

Hay una regresión. La misma compilación del kernel, pero intercambiando contra un SSD en vez de contra ZRAM, va doce segundos más lenta que el MGLRU actual, con un 9 % más de tiempo de sistema y un 17,5 % más de páginas escritas al intercambio. La explicación que da Song es que, al proteger mejor los archivos, el cgroup de 3 GB acaba empujando más memoria anónima fuera. Reconoce que la versión 3 «se ve más afectada por el exceso de recuperación de memoria anónima» que la anterior.

MongoDB sigue por detrás del LRU clásico. Mejora un 13,4 % respecto al MGLRU actual, pero se queda en 94 951 operaciones por segundo frente a las 98 390 del algoritmo antiguo. Es la única prueba en la que eso ocurre, y el autor lo atribuye a un umbral de escritura que habría que ajustar.

El 76 % de Chromium hay que cogerlo con pinzas. El propio Song avisa de que «algún cambio reciente parece haber roto la garantía de equidad de MGLRU» y ha hecho esa prueba muchísimo más rápida que hace unos meses, por motivos ajenos a esta serie.

Y falta una pieza. El trabajo no incluye todavía la distancia de refault, lo que significa que MGLRU puede tardar más en reaccionar cuando el conjunto de páginas en uso cambia de golpe. Song dice que se puede añadir después. Es exactamente el tipo de cabo suelto que hace que una serie siga en RFC.

Por qué importa

Importa porque el cuello de botella de los servidores se ha desplazado. Durante años la respuesta a un sistema lento era poner más RAM; hoy la memoria es cara —lo bastante como para que haya otra línea de trabajo en el mismo kernel reescribiendo la compresión de ZRAM por el mismo motivo— y la pregunta pasa a ser cuánto se puede exprimir la que ya hay. Un 20 % menos de tiempo de núcleo en una máquina bajo presión no es una cifra de laboratorio: es capacidad que se recupera sin comprar nada.

Importa también por dónde se nota. Las mejoras aparecen en contenedores con límite de memoria, que es como se ejecuta hoy prácticamente todo. Las pruebas de Song están hechas dentro de cgroups de 3 y 16 GB precisamente porque ahí es donde el algoritmo tiene que elegir de verdad; en una máquina con memoria de sobra, ninguno de estos números se mueve.

Y hay un detalle que dice bastante sobre cómo se escribe hoy el kernel: la serie lleva la etiqueta Assisted-by: LLM, con el autor explicando que usó un modelo de lenguaje para mejorar los comentarios y las pruebas. Es la misma convención que empezó a aparecer en los parches del kernel el mes pasado, y aquí se usa para lo que estaba pensada: declarar la ayuda sin esconderla y sin que sustituya a nadie.

Qué esperar

Nada inmediato. Una serie RFC de diecisiete parches que toca el corazón de la recuperación de memoria no entra en una ventana de integración sin varias rondas más de revisión, y el propio autor lo mantiene en RFC a conciencia. La regresión con intercambio en disco tendrá que resolverse o justificarse, y los nombres y umbrales pueden cambiar por el camino.

Lo que sí se puede dar por bueno es el diagnóstico. Que el MGLRU actual trata peor las lecturas secuenciales que las aleatorias no es una opinión: son 567 milisegundos contra 14 en una prueba que cualquiera puede reproducir con SQLite y grep. Se arregle con estos parches o con otros, ese problema está ahora documentado y medido, y eso ya es media reparación.

Sobre las cifras de este artículo. Todas salen de la carta de presentación de la propia serie de parches, leída en el archivo público de la lista linux-mm, no de resúmenes de terceros. Son mediciones del autor en su propio hardware y no han sido reproducidas de forma independiente; en una serie RFC eso es lo normal, y es parte de lo que la revisión del kernel sirve para comprobar.

Fuentes: «[PATCH RFC v3 00/17] mm/mglru: frequency guided promotion», de Kairui Song en la lista linux-mm (3 de octubre de 2026) y Phoronix, «MGLRU-FG Delivering Up To 10~40% Higher Performance For Linux In Some Tests».