GitLab publicó el lunes 12 de octubre una versión de emergencia para todas las instalaciones propias: 19.4.2, 19.3.5 y 19.2.8, con 24 correcciones de seguridad. La más grave, la CVE-2026-97229, tiene la nota máxima del sistema CVSS, un 10.0. Es un desbordamiento de entero en el compilador de expresiones regulares del CI/CD que, según el aviso, podía permitir a un usuario sin cuenta ni sesión iniciada ejecutar código en el servidor con una expresión regular manipulada en la configuración de CI/CD. GitLab.com ya tiene la corrección; quien tenga su propio servidor tiene que actualizar.
GitLab es una de las plataformas más usadas para alojar código y automatizar su compilación y despliegue, y muchas empresas la instalan en sus propios servidores para no sacar el código de casa. Esa versión instalada, llamada self-managed, es la que recibe estas correcciones. La compañía publica parches de seguridad programados el segundo y el cuarto miércoles de cada mes, y versiones extraordinarias cuando aparece un fallo grave: la de este lunes es de las segundas.
No es la primera de este otoño. El 10 de septiembre GitLab corrigió otro fallo con un CVSS de 10.0, la CVE-2026-85706, un recorrido de rutas en la API de commits que permitía leer archivos del servidor sin autenticarse. Ese fallo acabó en el catálogo de vulnerabilidades explotadas de la CISA, la agencia de ciberseguridad de Estados Unidos, y GitLab tuvo que llevar la corrección también a las versiones 19.0 y 18.11, ya fuera de su política de mantenimiento.
Claves de la actualización
Qué falla. Según GitLab, es un desbordamiento de entero en el compilador de expresiones regulares del CI/CD, causado por una validación insuficiente de las expresiones que recibe, y podía acabar en la ejecución de código arbitrario. Las expresiones regulares aparecen en la configuración de CI/CD, por ejemplo en las condiciones rules:if con =~, aunque GitLab no detalla por dónde entra la expresión del ataque. Lo descubrió el investigador joaxcar y lo comunicó por el programa de recompensas de HackerOne.
Por qué un 10.0. El vector CVSS lo explica pieza a pieza: se ataca por la red, con poca complejidad, sin privilegios y sin que nadie haga nada; el daño va más allá del componente vulnerable (alcance «cambiado») y el impacto es alto en confidencialidad, integridad y disponibilidad. No se puede puntuar peor.
Versiones afectadas. Todas las de la 19.2 anteriores a la 19.2.8, las de la 19.3 anteriores a la 19.3.5 y las de la 19.4 anteriores a la 19.4.2, tanto Community Edition como Enterprise Edition. En la rama 19.3 hay que ir a la 19.3.5: la 19.3.4 tenía un error en las páginas de merge requests con la integración de Ona activada.
Hay otras 23 correcciones. Cinco son de gravedad alta: un XSS en el resaltado de sintaxis (8.7), un fallo de autorización que dejaba a un desarrollador lanzar pipelines en ramas protegidas (8.5), un envenenamiento de caché de archivos del repositorio que podía exponer variables protegidas de CI/CD (8.2), otro de autorización en las políticas de ejecución de pipelines (7.7) y una inyección de instrucciones en el agente de IA de GitLab Duo (7.3). Las otras 18 son de gravedad media o baja.
Una pista en las notas. Las tres versiones incluyen dos parches para el motor de expresiones regulares de Ruby 3.3 y 3.4, el lenguaje en que está escrita la mayor parte de GitLab: uno sobre el tamaño del programa compilado de una expresión regular y otro sobre una doble liberación de memoria en las repeticiones. GitLab no los relaciona con la CVE, y el detalle de cada fallo no se publicará hasta 90 días después.
La actualización tiene coste. Incluye migraciones de base de datos: en una instalación de un solo servidor habrá una parada mientras terminan, y en las de varios nodos se puede aplicar sin cortar el servicio siguiendo el procedimiento de actualización sin parada. GitLab Dedicated no necesita hacer nada.
¿Tienes un GitLab propio? Mira la versión en la página /help de tu instancia, o en el servidor con sudo gitlab-rake gitlab:env:info. Si está en la 19.2, la 19.3 o la 19.4 y no es una de las corregidas, actualiza ya, sin esperar a la ventana de mantenimiento. Si usas una versión más antigua, este fallo concreto no te afecta, pero otros del mismo aviso sí: lo recomendable es pasar a una versión con soporte.
Por qué importa
Un servidor de GitLab guarda mucho más que código: las variables secretas de los pipelines, las claves para desplegar en producción, los tokens de acceso a la nube y los registros de contenedores. Quien ejecuta código en ese servidor tiene, en la práctica, las llaves de toda la cadena de entrega de software. Por eso un fallo que no exige ni siquiera una cuenta es de lo peor que le puede pasar a una instancia expuesta a internet.
El precedente de septiembre es el motivo para no esperar. GitLab no ha dicho que este fallo se esté aprovechando, pero el anterior de nota 10.0 acabó en la lista de vulnerabilidades explotadas de la CISA, y GitLab tuvo que publicar reglas para detectar los intentos de ataque. Dos fallos de gravedad máxima en poco más de un mes, uno de ellos en algo tan básico como validar una expresión regular, recuerdan que alojar tu propio GitLab también significa encargarte de parchearlo el mismo día.
Datos contrastados con el aviso de la versión 19.4.2 y con los avisos anteriores de GitLab: el de la 19.3.2 (10 de septiembre), donde se corrigió la CVE-2026-85706, y el de la 19.0.9 (23 de septiembre), que la llevó a las ramas antiguas. Portada: técnico trabajando en un rack del NERSC, foto de Derrick Coetzee, Wikimedia Commons, CC0 (recortada y teñida).
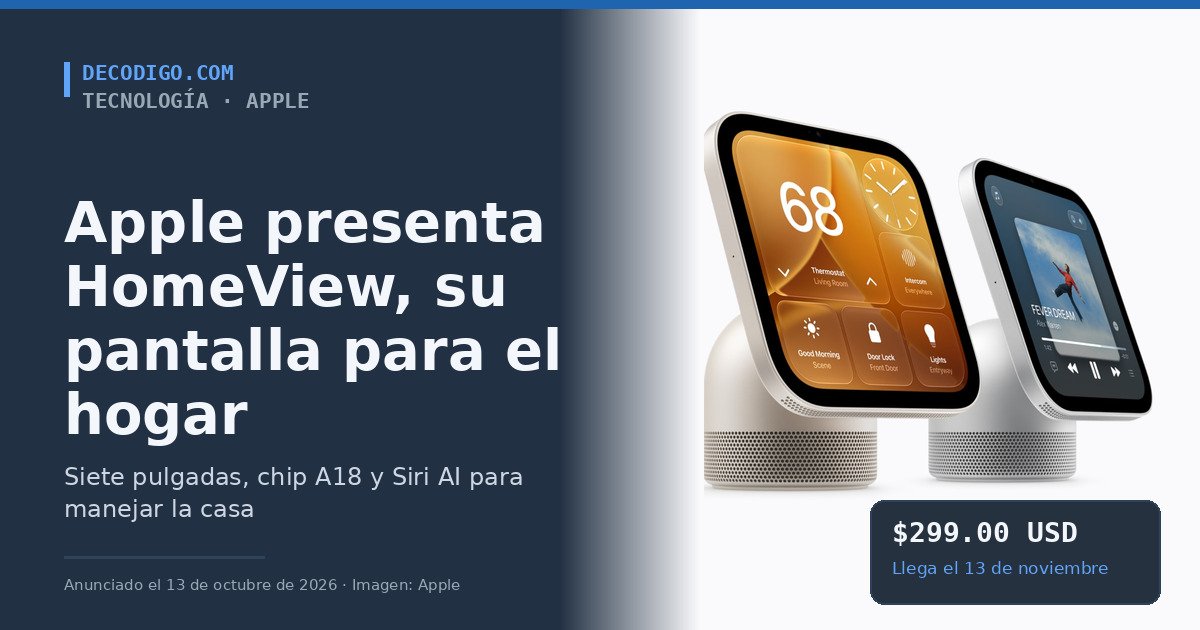
Apple presentó este martes HomeView, su primera pantalla pensada para quedarse en casa: un dispositivo de 7 pulgadas con chip A18 que se coloca en la cocina o en la mesilla, o se cuelga en la pared, para escuchar música, hacer videollamadas y controlar las luces, las cerraduras y las cámaras. Reconoce por la cara a cada persona de la casa y es el gran escaparate de Siri AI, la nueva versión de su asistente. Cuesta $299.00 USD, se puede reservar desde hoy y llega el 13 de noviembre.
Las pantallas inteligentes para el hogar llevan casi una década en el mercado, con el Echo Show de Amazon y el Nest Hub de Google como referentes, y Apple era el único de los tres grandes asistentes que no tenía una. Hasta ahora, en su ecosistema, el centro de la casa era un HomePod o un Apple TV, sin pantalla propia para ver las cámaras o tocar un interruptor. HomeView llega junto a un HomePod mini nuevo, un Apple TV 4K de cuarta generación y una línea de accesorios propios, Apple Home Collection, en lo que Apple llamó su evento «Welcome home».
El equipo tiene una pantalla cuadrada de 1088 × 1088 píxeles unida por una bisagra de acero a una base con altavoces, y una versión para la pared con la misma pantalla. Su interfaz cambia con la distancia: desde el otro lado de la habitación muestra información simple y grande, y de cerca, más detalle. Cada miembro de la casa tiene su propia pantalla de inicio, y los mensajes o el calendario de cada uno solo aparecen cuando HomeView reconoce su cara y su iPhone está cerca y desbloqueado hace poco.
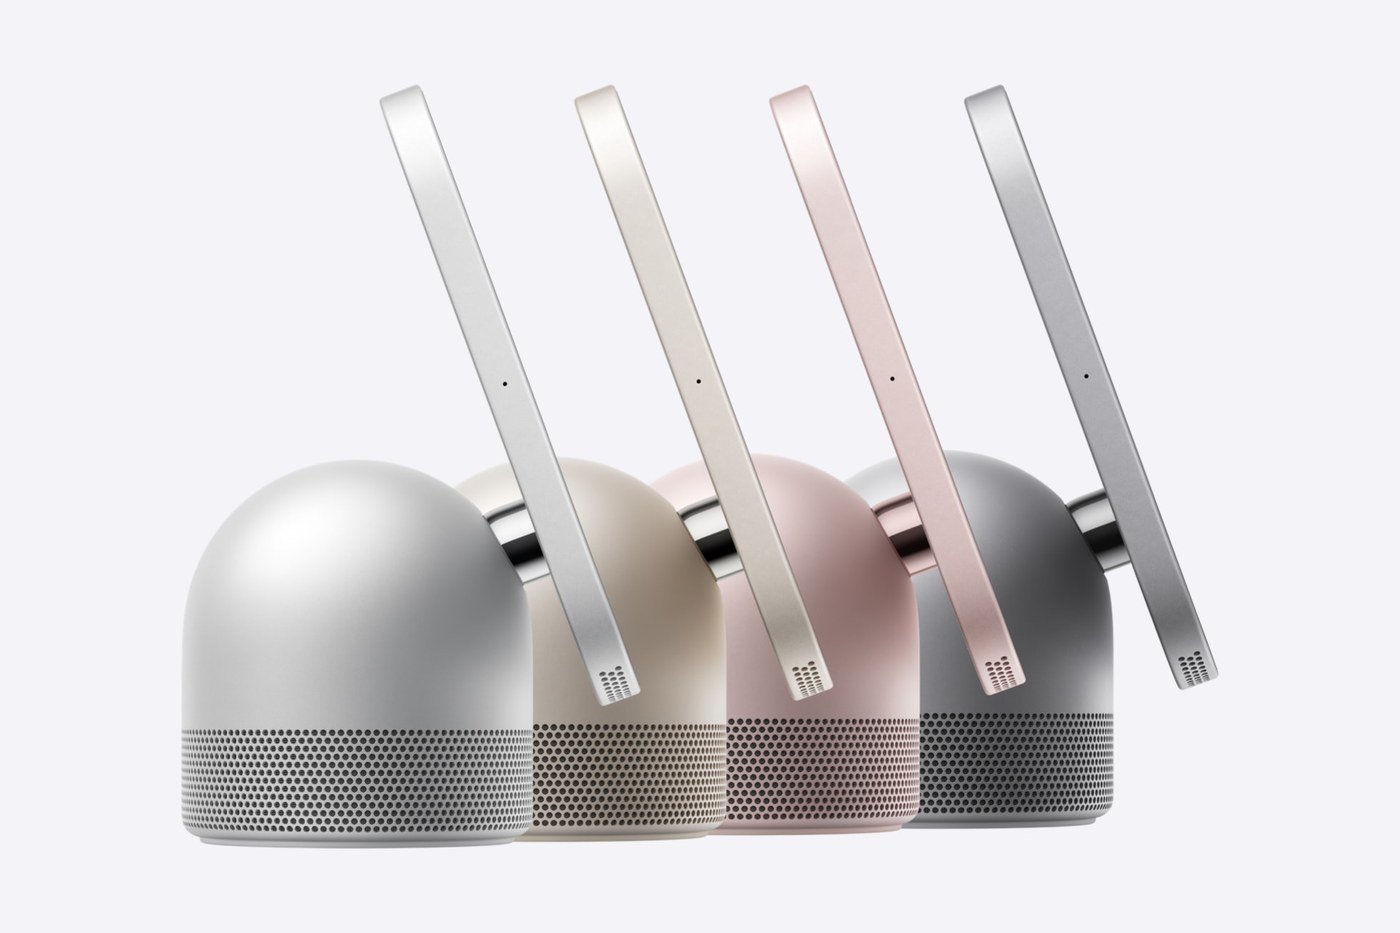
HomeView en sus cuatro colores. La pantalla se inclina sobre la base de altavoces gracias a una bisagra de acero. Imagen: Apple.
Claves de HomeView
Pantalla y diseño. Liquid Retina de 6,98 pulgadas en diagonal, 220 píxeles por pulgada y brillo automático de 500 a solo 0,3 nits para que no moleste de noche. Cuerpo de aluminio en plata, blanco estelar, rosa y gris espacial, y 952 gramos en el modelo de mesa. El de pared viene en gris espacial y plata.
Chip, cámara y sensores. Chip A18, cámara de 12 MP con Center Stage para FaceTime, cuatro micrófonos para hablarle desde lejos y sensores de luz, temperatura y humedad. Se conecta por Wi-Fi 6E, Bluetooth 6.0 y Thread.
Sonido. Dos altavoces de rango completo en la pantalla, con audio espacial, y un woofer orientado hacia abajo con dos radiadores pasivos en la base. Funciona como un altavoz más junto a los HomePod y los equipos AirPlay de la casa.
Siri AI. La nueva Siri, más conversacional, responde sobre casi cualquier tema y entiende lo que hay en pantalla. Con un iPhone o iPad compatible con Apple Intelligence también usa el contexto personal de cada usuario, como sus mensajes, su calendario o sus listas de Apple Music. Las peticiones se resuelven en el propio equipo o en los servidores Private Cloud Compute de Apple, que según la empresa no guardan los datos. En HomeView llega en beta.
Hasta seis personas. Reconoce a seis usuarios por la cara, y cada uno tiene sus aplicaciones, widgets y contenido privado. Las fotos y la música compartidas las ve todo el mundo, invitados incluidos.
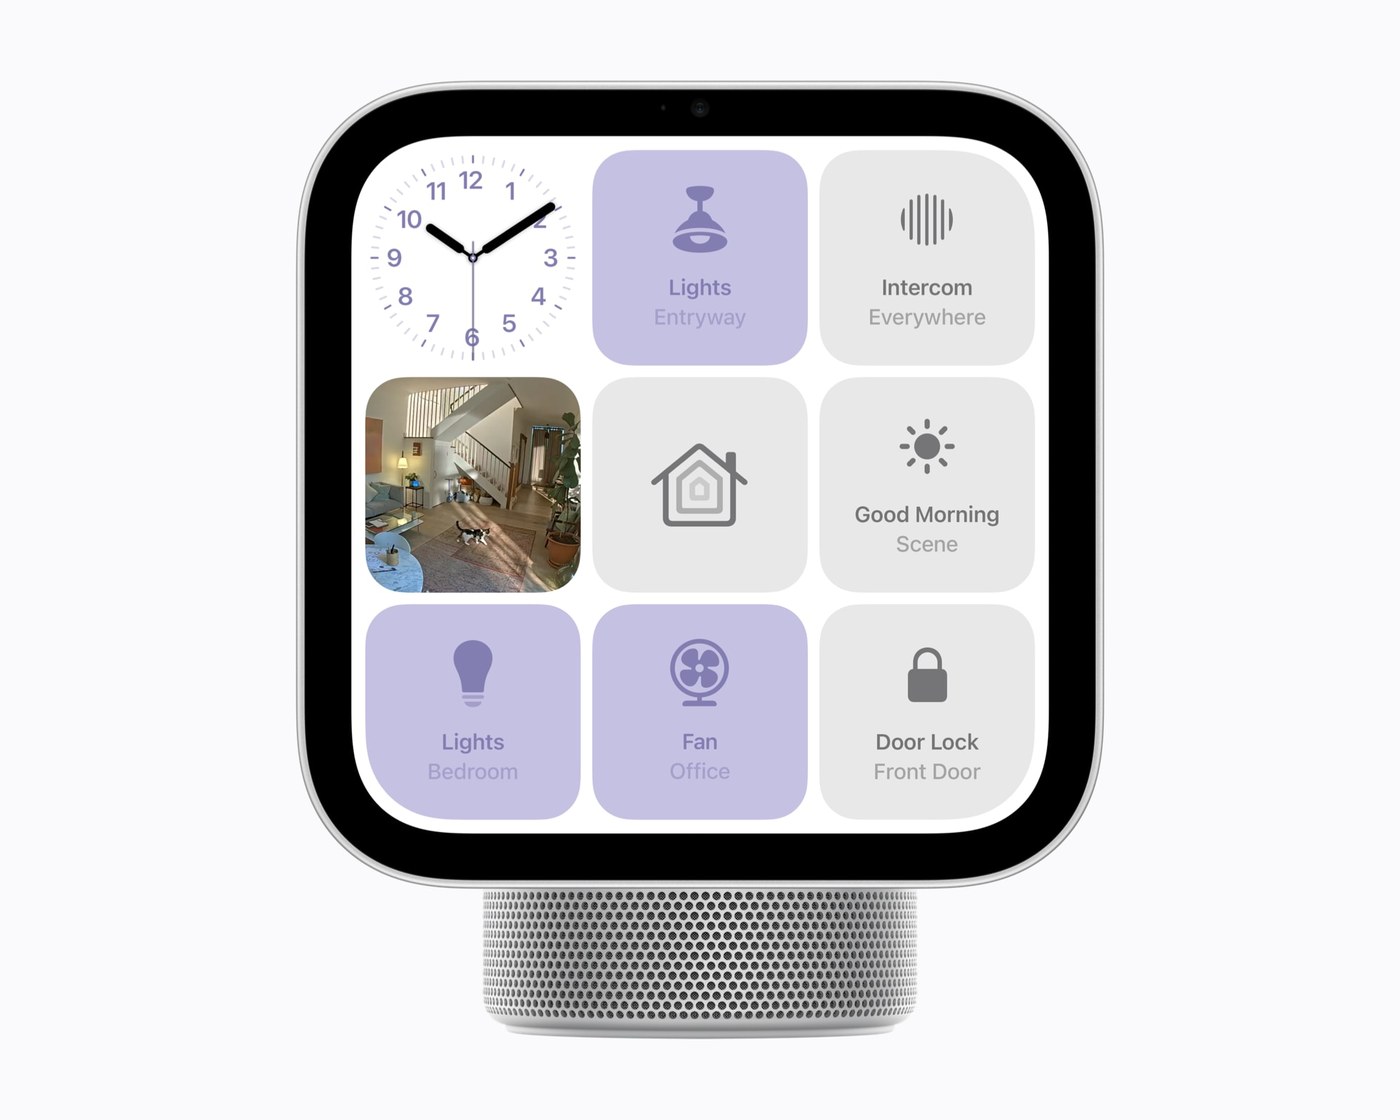
Centro de la casa. Controla luces, termostatos, cerraduras, persianas y cámaras compatibles con Matter o con «Works with Apple Home», por voz o con el dedo. La esfera Home Camera muestra hasta nueve cámaras a la vez, y el equipo avisa al iPhone si oye una alarma de humo o de monóxido de carbono.
Privacidad. La imagen de la cámara y el sonido de los micrófonos se procesan en Secure Exclaves, una zona aislada del chip A18. Según Apple, ni el sistema de HomeView ni las aplicaciones, el usuario o la propia Apple pueden acceder a esos datos.
La esfera Home Modular reúne los accesorios favoritos de la casa: luces, ventilador, cerradura, escenas y una cámara. Imagen: Apple.
Producto
Precio en EE. UU.
A la venta
Lo más nuevo
HomeView (mesa o pared)
$299.00 USD
13 de noviembre
Pantalla de 7″, A18, Siri AI en beta
Soportes de pared de Schneider Home
Desde $59.95 USD (USB-C), $79.95 USD (corriente alterna) y $129.95 USD (PoE)
Ya, el PoE a principios de 2027
Instalación propia o profesional
HomePod mini 2
$149.00 USD
30 de octubre
Cinco colores, luz que sigue la música; Siri AI en una actualización posterior
Apple TV 4K (4.ª generación)
$299.00 USD
13 de noviembre
Chip A19, tres micrófonos de campo lejano, Siri AI en pantalla completa
Apple Home Collection
Sin anunciar
Desde diciembre
Cámaras, termostatos, timbre y cerradura con LG y Schneider Electric
¿Y en España y Latinoamérica? De momento, no. HomeView solo se vende en Estados Unidos, Canadá, Reino Unido, Australia, Nueva Zelanda, India, Singapur y Sudáfrica, y Siri AI solo funciona en inglés; el francés de Canadá llegará más adelante, pero Apple no ha dado fecha para el español. Además, no se venderá en la Unión Europea, porque Siri AI todavía no está disponible allí en iOS; Apple dice que trabaja con la UE para encontrar una solución.
Por qué importa
HomeView es la apuesta más clara de Apple por llevar su inteligencia artificial a la casa. Amazon y Google llevan años vendiendo pantallas baratas para tener su asistente en la cocina; Apple entra tarde y más cara, pero con algo que ellos no tienen tan integrado: el iPhone de cada persona. Al reconocer la cara de quien tiene delante y usar el contexto de su teléfono, la misma pantalla sirve para toda la familia sin mezclar los mensajes ni el calendario de nadie, uno de los problemas que estos aparatos nunca habían resuelto bien.
También es una prueba para Siri AI. El asistente ha sido durante años el punto débil de Apple frente a Alexa y Google Assistant, y la nueva versión llega aquí en beta, en un solo idioma y en ocho países. Un equipo pensado para hablarle desde el otro lado de la cocina depende por completo de que el asistente funcione, así que la acogida de HomeView dirá mucho de si la nueva Siri está lista.
Y confirma la apuesta por Matter, el estándar común de la domótica que impulsan Apple, Google, Amazon y Samsung: HomeView y Apple Home Collection funcionan con los accesorios de cualquier marca certificada. Para quien ya tiene la casa llena de dispositivos de otros fabricantes, esa es la mejor noticia del día. Para el público hispanohablante, sin embargo, HomeView tendrá que esperar hasta que Siri AI hable español.
Este martes se abrió en el repositorio de Rust una incidencia que en pocas horas se convirtió en lo más comentado de Hacker News. Con un truco tan simple como crear un struct vacío y asignar después uno de sus campos, el compilador deja pasar una referencia que no cumple las reglas de vida del tipo. El resultado es un programa sin una sola línea unsafe que lee memoria ya liberada. El fallo está en el Rust actual, y en Compiler Explorer el mismo código compila desde Rust 1.4, publicado el 29 de octubre de 2015.
La promesa central de Rust es que el código seguro, el que no usa unsafe, no puede provocar errores de memoria: ni accesos a memoria liberada ni carreras de datos. Quien lo vigila es el borrow checker, la parte del compilador que comprueba que ninguna referencia viva más que el valor al que apunta. Cuando alguien encuentra una forma de engañarlo, el equipo lo llama un fallo de soundness y lo marca con la etiqueta I-unsound. No es la primera vez que ocurre: hay 140 incidencias abiertas con esa etiqueta, y la más famosa, la #25860, lleva abierta desde mayo de 2015.
La nueva, la #164250, la publicó un usuario a las 08:45 (hora UTC) con un ejemplo que guarda una referencia a un texto, lo libera y después imprime otro texto distinto que acabó en la misma memoria. En menos de una hora varios colaboradores habituales del compilador habían publicado variantes más cortas, una de ellas sin variables globales, y tras discutirlo en el chat del proyecto recibió prioridad alta. A las 13:41, los moderadores bloquearon los comentarios para evitar el spam. Todavía no hay ninguna corrección propuesta.
Claves del fallo
Una restricción que se comprueba al crear, pero no al asignar. Un struct puede exigir que lo que guarda viva el tiempo suficiente; por ejemplo, struct Guarda<'a: 'static> solo debería admitir referencias que vivan durante todo el programa. Si se crea con el valor dentro, Guarda(Some(&x)), el compilador lo rechaza. Si se crea vacío y el campo se asigna después, g.0 = Some(&x), la vida de la referencia se deduce de esa asignación y la restricción del struct ya no se vuelve a comprobar.
El daño lo hace un Drop. En todos los ejemplos publicados, el struct implementa Drop, el código que se ejecuta al destruir el valor. Ese código confía en la restricción del tipo, por ejemplo guardando la referencia en una lista global como si fuera eterna, y cuando se ejecuta la referencia ya apunta a algo que no existe.
Desde 2015. El autor lo comprobó en las versiones estables hasta la 1.85, como mínimo; un colaborador encontró una variante que compila desde la 1.18, de 2017, y otro llevó la suya hasta la 1.4. En Compiler Explorer, esa última la rechaza Rust 1.3 y la acepta Rust 1.4, la 1.18 y las actuales.
No depende de la asignación de campos. Otra variante llega al mismo sitio mezclando en un array dos valores del mismo struct y luego intercambiando sus campos, lo que apunta a un problema más general en cómo el compilador unifica tipos con restricciones de vida. Un colaborador lo relaciona con otra incidencia abierta desde julio de 2024.
Sigue en las versiones actuales. Lo hemos reproducido en Rust 1.99, la versión estable publicada el 1 de octubre, y en las ramas beta y nightly.
Este es el fallo reducido a lo esencial, con nombres en español. La lista global solo admite referencias 'static, y el Drop de Guarda mete en ella la suya porque su tipo promete que lo es:
use std::sync::Mutex;

// Una lista global: solo admite referencias que vivan para siempre ('static)
static GUARDADAS: Mutex<Vec<&'static String>> = Mutex::new(Vec::new());

struct Guarda<'a: 'static>(Option<&'a String>);

impl<'a: 'static> Drop for Guarda<'a> {
    fn drop(&mut self) {
        if let Some(r) = self.0 {
            GUARDADAS.lock().unwrap().push(r); // el compilador cree que r es 'static
        }
    }
}

fn main() {
    {
        let nombre = String::from("Ana García");
        let mut g = Guarda(None);
        g.0 = Some(&nombre); // &nombre vive solo hasta la llave: debería ser un error
    } // aquí se libera `nombre`... y su referencia sigue en GUARDADAS
    let otra = String::from("¡memoria reutilizada!");
    println!("{}", GUARDADAS.lock().unwrap()[0]);
    drop(otra);
}
rustc --edition 2021 guarda.rs && ./guarda¡memoria r
Compila sin un solo aviso. Al ejecutarlo, en lugar de «Ana García», imprime el principio de otro texto. El texto de nombre ya se había liberado, el programa reutilizó esa memoria para otra, y la referencia guardada lee los 11 bytes que medía «Ana García». Es un comportamiento indefinido: según el sistema y el asignador de memoria podría imprimir basura o hacer que el programa falle, que es lo que pasó en otra de las variantes. Basta con cambiar una línea para que el compilador haga su trabajo:
let g = Guarda(Some(&nombre)); // error[E0597]: `nombre` does not live long enough
¿Afecta a tu código? Muy probablemente no. Para que el fallo cause daño hace falta un struct con restricciones de vida, un Drop que dependa de ellas y crear el valor vacío para rellenar el campo después: una combinación rara en código normal y que nadie escribe por accidente. No hay que actualizar nada ni hay forma de evitarlo con una opción del compilador, porque todavía no existe la corrección. Lo que sí rompe es la garantía: hasta que se arregle, «compila sin unsafe» no basta para asegurar que un programa no lee memoria liberada.
Por qué importa
Rust ha ganado su sitio en el núcleo de Linux, en Android, en Windows y en buena parte de la infraestructura de la nube gracias a esa garantía. Cada fallo de soundness no suele ser peligroso en la práctica, pero sí demuestra que la garantía depende de que el compilador no tenga errores, y un error que ha pasado casi once años sin que nadie lo viera recuerda que el borrow checker también es software.
Además, los ejemplos de hoy no son rebuscados. A diferencia de la #25860, que requiere combinar varias reglas avanzadas del sistema de tipos, este se reproduce con unas pocas líneas y una asignación que cualquier programador escribiría. Eso lo hace más fácil de aprovechar a propósito, por ejemplo en una dependencia maliciosa que quisiera parecer segura.
La corrección tampoco será trivial. Exigir que el compilador vuelva a comprobar las restricciones de vida cada vez que se asigna un campo o se unifican dos tipos puede hacer que deje de compilar código correcto que ya existe, así que el equipo de tipos tendrá que medir el efecto en el ecosistema, normalmente con una pasada de crater sobre todos los paquetes publicados, antes de cambiar nada. Hasta entonces, la incidencia #164250 se queda como la última prueba de que ningún compilador es perfecto.
Datos contrastados con la propia incidencia y su historial en la API de GitHub, la incidencia #25860, las notas de versión de Rust y Compiler Explorer, donde probamos el código en Rust 1.3, 1.4, 1.18 y 1.99, beta y nightly. Portada: módulos de memoria DDR, foto de Mixabest, Wikimedia Commons, dominio público (recortada y teñida).
Durante décadas, elegir un lenguaje de programación era, en buena parte, elegir cuánto ibas a teclear. Python ganaba porque se escribía rápido; Rust o C++ asustaban porque había que pelearse con el compilador. Con asistentes y agentes de IA que generan cientos de líneas en segundos, escribir código ha dejado de ser el cuello de botella, y los criterios para elegir lenguaje cambian. Esta guía repasa cuáles pesan ahora y qué lenguaje conviene en cada caso.
Lo que no se ha abaratado es todo lo demás: entender el problema, comprobar que el código hace lo que debe, mantenerlo años y pagar las máquinas donde se ejecuta. Ya lo contamos en qué cambia en el oficio cuando escribir código deja de ser el centro. Visto desde ahí, la pregunta ya no es en qué lenguaje se escribe más rápido, sino en cuál es más fácil saber que el código generado está bien y en cuál sale más barato tenerlo funcionando.
Los criterios que cambian
1. Que el lenguaje detecte los errores antes de ejecutar. Un modelo de lenguaje no comprende el programa como un compilador: predice texto. Por eso se equivoca en lo que el compilador comprueba mejor. En un estudio presentado en PLDI 2025, investigadores de la ETH de Zúrich y de Berkeley midieron que, de media, el 94 % de los errores de compilación del código generado por modelos de IA eran fallos de tipos: pasar un dato del tipo equivocado, llamar a un método que no existe, olvidar un caso. Cassidy Williams, de GitHub, usó ese dato para explicar por qué la IA está empujando a los desarrolladores hacia los lenguajes con tipos. En un lenguaje con tipos estrictos, esos errores aparecen en segundos y el agente los corrige solo; en uno sin tipos, llegan a las pruebas, a la revisión o directamente a producción.
Cuanto antes aparece un error del código generado, más barato es arreglarlo. Con tipos estrictos, el agente puede compilar, leer el error y corregirlo sin intervención humana. Esquema: decodigo.com.
2. Que la máquina trabaje menos. Antes se aceptaba un lenguaje lento a cambio de programar más rápido. Si la IA escribe tanto el código sencillo como el farragoso, esa compensación pierde fuerza: el coste de escribir un servicio en Go o en Rust en lugar de en Python baja mucho, y el ahorro en servidores, memoria y energía sigue ahí cada mes. El estudio más citado sobre energía, de Rui Pereira y otros investigadores portugueses, resolvió los mismos problemas en 27 lenguajes. C, Rust y C++ consumieron lo mínimo, Java y Go, entre dos y tres veces más, y Python, unas 76 veces más.
Energía media de cada lenguaje en las pruebas de Pereira y otros (Science of Computer Programming, 2021), tomando C como 1. El mal resultado de TypeScript frente a JavaScript, que acaba ejecutándose en el mismo motor, solo se explica porque los programas de prueba de uno y otro eran distintos: un estudio de 2024 de Emery Berger y su equipo muestra que, si se comparan bien, la energía depende sobre todo del tiempo de ejecución y de cómo está escrito cada programa. Esquema: decodigo.com.
Hay que leer esa gráfica con cuidado. Un estudio posterior del equipo de Emery Berger, de la Universidad de Massachusetts, revisó la metodología y concluyó que el lenguaje no gasta energía por sí mismo: gasta la que corresponde al tiempo que tarda el programa. Pero eso no cambia la conclusión práctica: un programa que tarda menos consume menos, y los lenguajes compilados a código nativo, o con un buen compilador JIT como Java y C#, siguen siendo mucho más rápidos que los interpretados para el mismo trabajo.
3. Que el ecosistema ya tenga resuelto el problema. Una biblioteca madura, probada por millones de usuarios, vale más que mil líneas generadas desde cero, por bien que estén. Y un ecosistema grande también significa que los modelos lo conocen mejor: han visto muchísimo código en Python, TypeScript, Java o Go, y mucho menos en lenguajes minoritarios o en bibliotecas que cambian de una versión a otra. Eso sí, cada dependencia es una puerta: el intento de ataque a Zod de septiembre, que contamos hoy, recuerda que un ecosistema enorme es también un objetivo enorme.
4. Que el código se pueda revisar. Si una persona va a leer código que no ha escrito, ayuda que el lenguaje tenga pocas formas de hacer lo mismo, un formato único y un estilo predecible. Go está diseñado justo para eso. En el otro extremo, los lenguajes que permiten cualquier truco y crear lenguajes propios dentro del lenguaje producen código generado más difícil de auditar.
Qué lenguaje para cada caso
Para construir…
Primera opción
Alternativas
Por qué
Aplicaciones web completas
TypeScript (modo strict)
Go o C# en el servidor
Un solo lenguaje en el navegador y en el servidor, el ecosistema más grande y tipos que frenan los errores del modelo.
Datos, aprendizaje automático y prototipos con IA
Python con anotaciones de tipos
Julia para cálculo numérico
Las bibliotecas que importan están en Python: PyTorch, pandas y los SDK de los modelos. Lo pesado se ejecuta en C, C++ o Rust por debajo.
APIs, microservicios y herramientas de línea de órdenes
Go
Rust, Java, C#
Compila en segundos, genera un único binario, consume poca memoria y su código es muy uniforme: fácil de generar y de revisar.
Sistemas, rendimiento extremo y seguridad de memoria
Rust
C++ en bases de código existentes, Zig
El compilador es el revisor más exigente: si compila, se descartan clases enteras de errores de memoria y de concurrencia. Ideal para agentes que iteran contra él.
Sistemas de empresa grandes y de larga vida
Java o Kotlin
C# y .NET
Tipos, herramientas de análisis y refactorización muy maduras, y décadas de bibliotecas. Las versiones modernas son mucho menos verbosas, y lo verboso ya lo escribe la IA.
Aplicaciones móviles
Kotlin (Android) y Swift (iOS)
Dart con Flutter, o React Native con TypeScript
Los lenguajes nativos acceden antes a lo nuevo de cada plataforma; las opciones multiplataforma reducen el trabajo a una sola base de código.
Electrónica y sistemas embebidos
C
Rust embebido, MicroPython para prototipos
C sigue estando en todos los fabricantes y herramientas; Rust gana terreno donde la seguridad importa.
Scripts y automatización
Python
Bash para lo muy corto, Go si debe ser rápido
Está instalado casi en cualquier sistema y tiene biblioteca para todo.
Nota: los frameworks maduros de cada lenguaje. Con IA, apoyarse en un framework consolidado vale todavía más que antes. Resuelve de serie la seguridad, el acceso a datos y la configuración, impone una estructura que el modelo conoce de sobra porque la ha visto en miles de proyectos y reduce la cantidad de código propio que hay que revisar. Además, recibe parches de seguridad sin que tengas que escribirlos tú. Estos son los más asentados en cada lenguaje.
Lenguaje
Web y servicios
Datos, pruebas y otras piezas
TypeScript
React y Next.js, Angular, Vue y Nuxt en la interfaz; NestJS, Express y Fastify en el servidor
Prisma y Drizzle para bases de datos, Zod para validar datos, Vitest y Playwright para pruebas
Python
Django, FastAPI y Flask
NumPy, pandas, scikit-learn y PyTorch para datos e IA; SQLAlchemy, Pydantic y pytest
Go
La biblioteca estándar net/http basta en muchos casos; Gin, Echo y Chi por encima; gRPC para servicios internos
Cobra para herramientas de línea de órdenes; database/sql con sqlc o GORM
Rust
Axum y Actix Web, sobre el motor asíncrono Tokio
Serde para serializar, SQLx y Diesel para bases de datos, Clap para línea de órdenes
Java y Kotlin
Spring Boot, Quarkus y Micronaut; Ktor en Kotlin
Hibernate y JPA para persistencia, JUnit para pruebas
C#
ASP.NET Core, con Blazor para la interfaz web
Entity Framework Core para datos, xUnit para pruebas
Móvil
Jetpack Compose (Kotlin) y SwiftUI (Swift)
Flutter (Dart) y React Native (TypeScript) para varias plataformas a la vez
Embebidos
FreeRTOS y Zephyr como sistemas operativos de tiempo real; ESP-IDF para los chips ESP32
Embassy para programar microcontroladores en Rust
Python no pierde, cambia de papel. Según el informe Octoverse 2025 de GitHub, Python está en casi la mitad de los repositorios nuevos de IA, y más de 1,1 millones de repositorios públicos ya importan el SDK de algún modelo de lenguaje. Lo que cambia es dónde se usa: como lenguaje para explorar, entrenar y unir piezas, y no tanto para el servicio que atiende miles de peticiones por segundo. Si se escribe Python con IA, conviene añadir anotaciones de tipos y pasar un comprobador como mypy o Pyright, para recuperar parte de la red de seguridad.
Lo que ya se nota en GitHub
En agosto de 2025, TypeScript se convirtió en el lenguaje más usado en GitHub por número de contribuidores: más de 2,6 millones al mes, un 66 % más que un año antes, por delante de Python y de JavaScript. GitHub lo calificó como el mayor cambio de lenguaje en más de una década, y lo atribuyó en parte a la IA: los tipos funcionan como un contrato que entienden por igual las personas, los frameworks y los modelos, y que permite detectar los errores del modelo antes de que lleguen a producción. Ayuda también que frameworks como Next.js, Astro o SvelteKit creen ya los proyectos en TypeScript por defecto.
Es la misma tendencia que se ve con Rust en los componentes críticos de sistemas operativos y navegadores, o con la llegada de tipos a lenguajes que nacieron sin ellos, como Python o PHP. Cuando una parte creciente del código la escribe una máquina, el compilador deja de verse como un obstáculo y pasa a ser la primera línea de revisión, y la más barata.
Cómo elegir, en cinco preguntas
¿Qué tiene ya resuelto el ecosistema? Si el problema depende de una biblioteca concreta, como PyTorch, un SDK de pagos o un framework de interfaz, esa biblioteca decide el lenguaje casi siempre.
¿Cuántas veces se va a ejecutar? Un script que se ejecuta una vez al mes puede estar en cualquier lenguaje. Un servicio que atiende millones de peticiones merece un lenguaje compilado: lo que antes costaba escribirlo ahora lo escribe la IA.
¿Quién va a revisar el código? Si hay poca revisión humana, se necesita más ayuda del compilador: tipos estrictos y advertencias activadas como errores.
¿Cuánto tiempo va a vivir? Para un sistema que se mantendrá diez años, conviene un lenguaje estable, con herramientas de refactorización y gente que lo conozca. Un lenguaje de moda o que cambia mucho entre versiones es un riesgo, y además los modelos lo conocen peor.
¿Sabe alguien del equipo leerlo? La IA no elimina la necesidad de entender lo que se despliega. Elegir un lenguaje que nadie del equipo domina porque «lo escribe la IA» es dejar el sistema sin nadie que pueda responder por él.
Conclusión
La IA no ha hecho que dé igual el lenguaje: ha cambiado lo que importa al elegirlo. Pesa menos lo cómodo que es escribirlo y más cuánto ayuda a verificar lo que otro, humano o máquina, ha escrito, cuánto cuesta ejecutarlo y cuánto trabajo ahorra su ecosistema. Por eso ganan terreno los lenguajes con tipos estrictos y buenas herramientas, como TypeScript, Go, Rust, Java, Kotlin o C#, y Python se consolida donde su ecosistema no tiene rival. Si quieres empezar por alguno, en decodigo.com tienes cursos de Python, Go, Rust y Java, y diez consejos para aprender a programar cuando la IA ya escribe el código.
El 21 de septiembre alguien subió seis commits maliciosos a la rama principal de Zod, la biblioteca de validación de datos más usada de TypeScript, con una credencial de git robada. Su mantenedor los revirtió ese mismo día y ninguna versión publicada en npm los llegó a incluir. El incidente se hizo público el 11 de octubre en las notas de la versión 4.6.6 y desde entonces circula por redes y medios de desarrolladores como un posible compromiso de Zod.
Zod permite describir la forma que deben tener unos datos, por ejemplo el cuerpo de una petición o la respuesta de un modelo de IA, y comprobar en tiempo de ejecución que la cumplen, con los tipos de TypeScript deducidos a partir de esa descripción. Lo usan frameworks, SDK de IA y miles de proyectos, y en npm se descargó más de 346 millones de veces solo la semana pasada. Esa popularidad lo convierte en un objetivo perfecto para un ataque a la cadena de suministro: quien consiga meter código en una versión de Zod lo ejecuta en millones de máquinas de desarrolladores y de servidores de integración continua.
Eso es exactamente lo que se intentó. Los commits aparecieron entre las 11:56 y las 15:16 (hora UTC) a nombre de «colinhacks», la cuenta de Colin McDonnell, creador de Zod, aunque sin firma verificada. A las 21:33, McDonnell fusionó la PR #6620, «Cleanup bad commits», que deshacía los seis, y más tarde reescribió el historial de la rama para eliminarlos. Las notas de la 4.6.6 lo cuentan en un párrafo y explican que la procedencia de esa versión apunta a una copia del commit anterior a esa reescritura, con el mismo contenido.
Claves del incidente
Un script que se instalaba solo. El primer commit, titulado «Fix bugs and improve performance», añadía un archivo meta.test.mjs a los paquetes zod y @zod/mini, lo incluía en lo que se sube a npm y lo declaraba como preinstall, la orden que se ejecuta al instalar un paquete. Además, subía el número de versión a 4.6.6.
Un servidor escondido en la cadena de bloques. El script no llevaba ninguna dirección de servidor. Consultaba un contrato de Ethereum a través de tres nodos públicos, sacaba de él una lista de dominios, pedía a cada uno un archivo y ejecutaba el código que recibía, para después borrar el rastro. Así, el atacante podía cambiar de servidor sin tocar el paquete y sin dejar un dominio fácil de bloquear.
El objetivo era publicar sin pedir permiso. Los otros commits iban a por el proceso de publicación: uno quitaba la aprobación manual que exigía el entorno de npm en GitHub Actions, otro añadía un flujo que publicaba con un token en cada push a la rama principal y dos más subían la versión a 4.6.7 y 4.6.8.
Nada llegó a npm. En el registro, después de la 4.6.5 del 13 de septiembre, la siguiente versión es la 4.6.6 del 11 de octubre. Esa versión y la 4.6.7, publicada hoy, se generaron en GitHub Actions con certificado de procedencia SLSA y no tienen ningún script de instalación.
Publicar ahora necesita a una persona. Tres días después del ataque, la PR #6622 hizo que la integración continua ya no pudiera publicar: solo deja cada versión en una cola de espera de npm, donde no se puede instalar, hasta que un mantenedor la aprueba con doble factor. En palabras de la propia PR, una credencial robada que llegue a ese flujo «puede llenar una cola y nada más». La PR #6638, del 30 de septiembre, deja la ejecución en pausa en un entorno de aprobación durante un máximo de 30 días.
La alarma vino del historial. El 11 de octubre, un usuario abrió la incidencia #6658 porque una auditoría de seguridad le marcó el commit malicioso dentro del historial de la 4.6.6. Otros usuarios señalaron enseguida que el código no está en el paquete de npm. A la hora de escribir esta nota, la incidencia sigue abierta y sin respuesta de los mantenedores.
Del primer commit malicioso a la versión que lo cuenta. Esquema: decodigo.com, a partir de las notas de la versión 4.6.6, del historial del repositorio y del registro de npm.Lo que intentaban los commits y cómo publica Zod desde finales de septiembre. Esquema: decodigo.com, a partir de las PR #6622 y #6638.
Si usas Zod. Las versiones de npm están limpias, incluidas la 4.6.6 y la 4.6.7. Las versiones 4.6.7 y 4.6.8 de los commits maliciosos nunca existieron en el registro, y la 4.6.7 que hay hoy es la legítima. Si quieres comprobarlo, npm audit signatures verifica las firmas y la procedencia de los paquetes que tienes instalados. Un detalle curioso: el atacante puso el preinstall fuera del bloque scripts del package.json, que es donde npm busca lo que tiene que ejecutar al instalar, así que, tal como estaba escrito, probablemente no se habría ejecutado solo. No es algo con lo que convenga contar la próxima vez.
Por qué importa
Los ataques a npm de los últimos años se han apoyado casi siempre en lo mismo: un token o una cuenta robados que permiten publicar una versión maliciosa en minutos, antes de que nadie lo note. En este caso la credencial robada solo daba acceso al repositorio, y la publicación todavía exigía una aprobación manual que el atacante intentó quitar en el propio repositorio. Esa capa de más bastó para que el ataque se quedara en el historial de git.
La respuesta de Zod va más allá: ya no hay ningún camino para que una máquina publique sola. La función de publicación en espera de npm convierte cada versión en una propuesta que un humano tiene que aprobar con su segundo factor, y eso cuesta poco cuando se publica unas pocas veces al mes. Es un modelo fácil de copiar para cualquier proyecto con muchos usuarios, que hasta ahora confiaba sobre todo en tokens y en la procedencia de la versión.
También deja una lección sobre cómo se comunican estos incidentes. Las notas de la 4.6.6 lo contaron en pocas líneas, tres semanas después, y sin aviso de seguridad. Las herramientas de auditoría, que miran el historial y no solo el paquete, lo encontraron por su cuenta, y lo que empezó como una buena noticia, un ataque detenido a tiempo, se difundió como un posible compromiso. Mientras los mantenedores no respondan a la incidencia #6658, la mejor forma de saber qué pasó es leer las notas de la versión y el propio registro de npm.
Por primera vez hay relojes que miden el tiempo con el núcleo de un átomo y no con sus electrones. Dos equipos, uno de la Universidad Técnica de Viena con el instituto de metrología alemán PTB y otro de la Universidad Tsinghua de Pekín, publicaron el 7 de octubre en Nature sendos relojes basados en el torio-229. El de Viena funcionó más de 24 horas seguidas sin que nadie lo tocara; el de Pekín resultó unas seis veces más estable.
Un reloj, en el fondo, es algo que oscila a un ritmo constante y un mecanismo que cuenta esas oscilaciones. En los relojes atómicos lo que oscila es la luz o la radiación que hace saltar a los electrones de un átomo entre dos niveles de energía. Desde 1967 el segundo se define así, con átomos de cesio, y los relojes ópticos más modernos, que usan luz visible o ultravioleta, ya se equivocan menos de un segundo en toda la edad del universo. Pero los electrones están en la parte exterior del átomo y notan cualquier perturbación: campos eléctricos y magnéticos, cambios de temperatura.
El núcleo está mucho mejor protegido. Es más de diez mil veces más pequeño que el átomo y apenas reacciona a lo que pasa fuera. El problema es que sus saltos de energía suelen ser enormes, propios de los rayos gamma, y ningún láser puede provocarlos. El torio-229 es la excepción: tiene dos estados de energía tan próximos que basta un láser ultravioleta de unos 148 nanómetros para pasar de uno a otro. Llevaba décadas señalado como candidato a reloj nuclear, pero hasta abril de 2024 nadie había conseguido excitarlo con un láser. Lo lograron precisamente los grupos de Viena y del PTB, y en otoño de ese mismo año, junto con el JILA de Colorado, lo conectaron por primera vez a un reloj atómico óptico.
Faltaba el paso decisivo: que el núcleo de torio no fuera solo algo que se mide, sino lo que marca el ritmo del reloj. Es lo que publican ahora los dos equipos.
Claves de los dos relojes
El corazón es un cristal. Ambos relojes usan un cristal de fluoruro de calcio con núcleos de torio-229 incrustados. En el de Viena mide un milímetro y funciona a temperatura ambiente, sin necesidad de enfriarlo ni de atrapar átomos uno a uno, como en los relojes ópticos.
Un bucle que se corrige solo. Los núcleos solo absorben la luz del láser si su frecuencia es exactamente la correcta. Si el láser se desvía, aunque sea un poco por un cambio de temperatura, la absorción baja; el sistema lo detecta y reajusta la frecuencia. Así, el reloj de Viena no depende de un reloj atómico convencional para funcionar. La idea, explica Thorsten Schumm, que dirige el equipo de la TU Wien, es que sean los propios núcleos de torio los que estabilicen la frecuencia del láser.
Más de 24 horas sin intervención. El reloj de Viena funcionó un día entero de forma continua. Para medir su calidad, su frecuencia se comparó todo ese tiempo con un reloj atómico de ion de iterbio. Tras un día de promedio, su inestabilidad se acercó a 10⁻¹⁵, que equivale a equivocarse en un segundo cada 30 millones de años.
El de Pekín, seis veces más estable. El equipo de Tsinghua, dirigido por Ding Shiqian, genera su luz ultravioleta haciendo pasar láseres por vapor de cadmio y lee la absorción con un método rápido y con mucha señal frente al ruido. Con un segundo de promedio, su inestabilidad es de 5 × 10⁻¹³, frente a 3 × 10⁻¹² del de Viena: seis veces menor.
Dos cristales, la misma hora. Pekín probó su reloj con dos cristales fabricados por separado, y sus frecuencias coincidieron con una diferencia de una parte en 10 billones (10⁻¹³). También encajan con medidas anteriores en otros cristales. Es una prueba de que el reloj no depende de un cristal concreto, algo imprescindible si algún día se fabrican en serie.
Una primera búsqueda de materia oscura. El equipo de Viena aprovechó el reloj para buscar materia oscura ultraligera, que haría variar levemente la energía del salto del torio en plazos de entre 20 segundos y un día. No encontró señal, pero los límites que fija compiten con los de los mejores relojes atómicos y mejoran los anteriores en algunos tipos de interacción.
El bucle de realimentación del reloj de Viena. El reloj de iterbio no participa en el funcionamiento: solo sirve de referencia para medir su estabilidad. Esquema: decodigo.com, a partir del comunicado de la TU Wien y del artículo.La inestabilidad indica cuánto se aleja la frecuencia de su valor de una medida a otra: cuanto más pequeña, mejor. La escala es logarítmica: cada línea vertical es diez veces mejor que la anterior. Esquema: decodigo.com, con los datos de los dos artículos.
Todavía no son los mejores relojes. Los propios autores lo dicen: el prototipo de Viena aún no está al nivel de los mejores relojes atómicos ópticos, y los dos equipos lo consideran un primer paso. La ventaja del núcleo es teórica por ahora: al ser tan insensible a las perturbaciones, debería permitir una precisión mayor cuando mejoren los láseres y los cristales. Los de Viena calculan que la inestabilidad puede mejorar en varios órdenes de magnitud.
Por qué importa
Los relojes atómicos son una infraestructura invisible: el GPS calcula tu posición a partir de diferencias de tiempo de millonésimas de segundo, las redes de telecomunicaciones y los mercados financieros se sincronizan con ellos, y los mejores relojes de laboratorio sirven para comprobar las leyes de la física. Un reloj que funciona con un cristal a temperatura ambiente, sin trampas de átomos ni vacío extremo, apunta a algo que hoy no existe: relojes de altísima precisión compactos y robustos, que se puedan sacar del laboratorio.
El torio-229 tiene además una sensibilidad especial. Su salto de energía depende del equilibrio entre la fuerza nuclear fuerte y la electromagnética, así que, si alguna constante de la naturaleza variara mínimamente, o si la materia oscura interactuara con la materia normal, este reloj lo notaría mucho antes que uno atómico. La primera búsqueda ya da límites competitivos con un prototipo de un día de funcionamiento.
Que el mismo hallazgo llegue a la vez desde Europa y desde China, con dos técnicas distintas, también dice algo: la carrera por el reloj nuclear ha empezado en serio. El equipo de Viena ya trabaja en láseres más potentes y mejores cristales, y el de Pekín ha demostrado que el resultado se puede reproducir. El siguiente hito será que un reloj nuclear iguale, y después supere, a los mejores relojes atómicos.
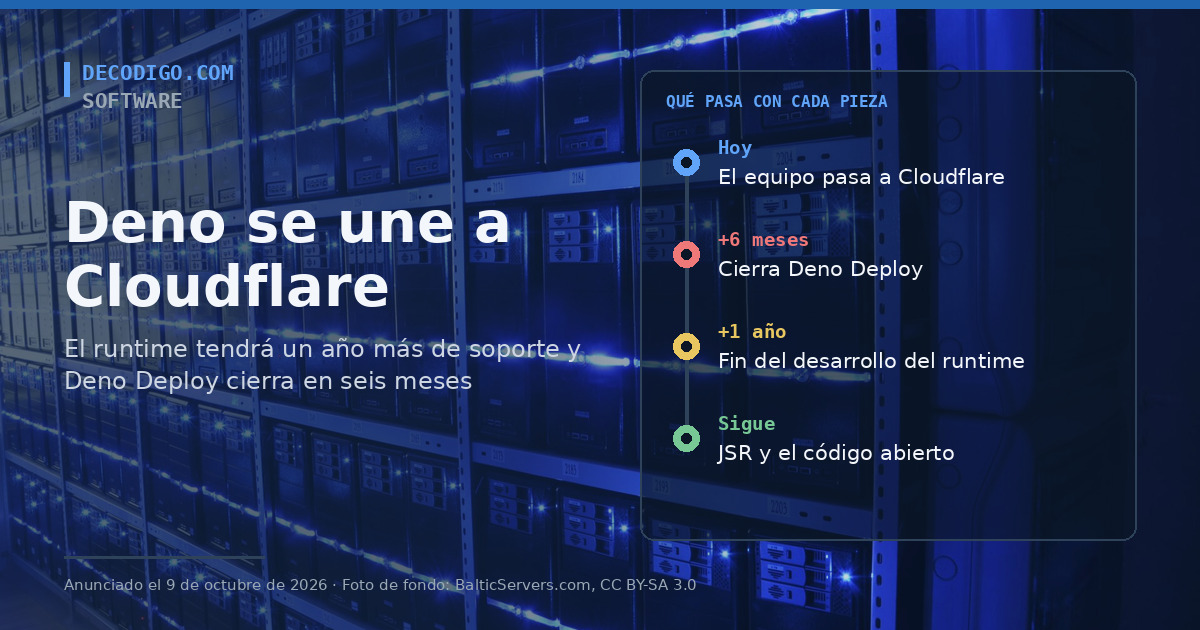
Todo el equipo de Deno, empezando por su creador, Ryan Dahl, pasa a trabajar en Cloudflare. El anuncio, del 9 de octubre, viene con fecha de caducidad para casi todo lo que la empresa había construido: el runtime de Deno recibirá correcciones durante un año más y después dejará de desarrollarse, y el servicio de alojamiento Deno Deploy cerrará dentro de seis meses.
Deno nació de un arrepentimiento. En 2018, en la conferencia JSConf EU, Ryan Dahl, que años antes había creado Node.js, dio una charla sobre las decisiones de diseño de Node que ya no volvería a tomar, y presentó un runtime nuevo para corregirlas: escrito en Rust sobre el motor V8, seguro por defecto, sin acceso a la red ni a los archivos salvo permiso explícito, y con TypeScript de serie. Deno 1.0 llegó en 2020 y Deno 2.0, en 2024, con compatibilidad con los paquetes de npm. Alrededor del runtime, la empresa montó Deno Deploy para ejecutar código en la nube y el registro de paquetes JSR.
Cloudflare jugaba en el mismo terreno con Workers, su plataforma para ejecutar JavaScript en sus centros de datos repartidos por todo el mundo. En 2022 publicó como código abierto workerd, el runtime de Workers, después de que clientes grandes como Shopify le dijeran que no podían construir sobre una plataforma de la que no tuvieran salida. Y en agosto de este año el equipo de Deno publicó celld, su propia implementación del modelo de Workers pensada para ejecutarlo en servidores propios.
Ese es el punto de encuentro. Según el comunicado que firman juntos Ryan Dahl y Kenton Varda, de Cloudflare, el objetivo es fusionar celld con workerd para que montar aplicaciones distribuidas en infraestructura propia sea, en sus palabras, «radicalmente fácil». Ninguno de los dos anuncios habla de importe ni de condiciones de la operación.
Claves del anuncio
El runtime, un año más. Deno seguirá recibiendo una versión al mes con correcciones de errores y de seguridad durante un año. Pasado ese plazo, Cloudflare dejará de desarrollarlo. El código seguirá siendo abierto, y Dahl invita a quien quiera a continuar su desarrollo.
Deno Deploy cierra en seis meses. El servicio de alojamiento seguirá funcionando medio año y después se apagará. Los clientes de pago tendrán ayuda para migrar a Cloudflare Workers.
JSR sigue. El registro de paquetes continuará funcionando y su infraestructura pasará a Cloudflare.
celld se funde con workerd. celld es un único programa escrito en Rust cuya única dependencia externa es un almacenamiento de objetos. Para usarlo basta con levantar varias instancias y un bucket. Cloudflare llevará su código y sus ideas a workerd.
Durable Objects en servidores propios. Es lo que le faltaba a workerd. Un Durable Object es, como lo define Dahl, un «singleton distribuido con una base de datos SQLite»: un objeto que existe una sola vez en todo el sistema, por ejemplo uno por cada canal de un chat, con su propio estado y sus conexiones WebSocket. Cloudflare lo usa por debajo de servicios como sus colas o su almacén KV, pero en workerd solo funcionaba con una instancia, suficiente para pruebas en local y no para producción. Varda reconoce que un intento de resolverlo la primavera pasada no salió bien.
Quién lo dirige. Ryan Dahl y Bert Belder, cofundador de Deno, encabezarán el trabajo para que el autoalojamiento de workerd sea una forma de primera clase, con soporte, de ejecutar aplicaciones con el modelo de Workers. Cloudflare también seguirá manteniendo rusty_v8, la capa que une V8 con Rust, y la integrará en workerd.
Lo que pasa con cada pieza de Deno a partir del anuncio. Los plazos se cuentan desde el 9 de octubre de 2026. Esquema: decodigo.com, a partir del comunicado de Deno.De dónde sale el nuevo workerd. Esquema: decodigo.com, a partir del comunicado conjunto en el blog de Cloudflare.
Si tienes proyectos en Deno. Nada deja de funcionar mañana. El runtime seguirá recibiendo parches de seguridad durante un año, y los paquetes publicados en JSR siguen disponibles. Lo urgente es Deno Deploy: quien tenga allí aplicaciones tiene medio año para moverlas. Para el código, Deno 2 ya ejecuta paquetes de npm y buena parte de la API de Node.js, así que pasar a Node o a otro runtime compatible suele ser más llevadero que antes de 2024, aunque conviene revisar los usos de las APIs propias de Deno, como Deno.serve o los permisos.
Por qué importa
Es el final de una de las alternativas a Node.js más conocidas. Durante ocho años Deno empujó ideas que acabaron en el resto del ecosistema: permisos explícitos, TypeScript sin configuración, APIs web estándar como fetch en el servidor. Ahora su equipo deja de competir por el runtime y se pone a construir sobre el de Cloudflare. Quien haya apostado por Deno en producción tiene un año para decidir si sigue con un proyecto mantenido por la comunidad o si migra.
Para Cloudflare la jugada va en otra dirección. Su gran argumento de venta es su red, y aun así su mayor esfuerzo aquí es que su modelo de programación funcione fuera de ella. Varda lo explica sin rodeos: algunos de sus clientes más grandes no habrían firmado sin una salida de emergencia. Un Workers que se pueda instalar en servidores propios, con Durable Objects de verdad, hace que construir sobre Workers deje de ser una apuesta por un único proveedor. Y Dahl lo presenta pensando en los agentes de IA, que necesitan ejecución barata, estado persistente y conexiones abiertas, justo lo que ofrecen los Durable Objects.
Quedan preguntas sin respuesta: qué pasará con el framework Fresh, la biblioteca estándar o Deno KV, que ninguno de los dos comunicados menciona, y si alguien recogerá el desarrollo del runtime cuando Cloudflare lo suelte. Ambas empresas prometen más anuncios en los próximos meses.
Datos contrastados con el comunicado de Ryan Dahl en el blog de Deno, del 9 de octubre de 2026. Portada: sala de servidores de BalticServers, foto de BalticServers.com, Wikimedia Commons, CC BY-SA 3.0 (recortada y teñida).
Ves una función en una aplicación y te preguntas cómo está hecha, pero no tienes su código fuente: solo el programa ya compilado. Eso es la ingeniería inversa, un trabajo lento y muy especializado. REA (Reverse Engineer Anything, «haz ingeniería inversa de cualquier cosa») es una herramienta de código abierto que se lo encarga a los agentes de programación con IA, y en seis meses se ha convertido en uno de los proyectos más populares de GitHub.
Cuando un programa se compila, el código que escribió una persona se convierte en instrucciones para el procesador. Los nombres de las variables, los comentarios y buena parte de la estructura desaparecen por el camino. Recuperar cómo funciona exige herramientas como Ghidra, el desensamblador gratuito publicado por la NSA, o los comerciales IDA Pro y Hopper, que traducen el binario a ensamblador y a un pseudocódigo aproximado. A partir de ahí, alguien con experiencia tiene que leer miles de instrucciones, seguir llamadas entre funciones e interpretar constantes guardadas en memoria. Se usa para estudiar malware, auditar la seguridad de un programa, conservar software antiguo cuyo código se perdió o entender formatos y protocolos no documentados.
REA no sustituye a esos programas: los conecta con el agente. Se integra a través de MCP (Model Context Protocol), el estándar con el que los agentes de IA acceden a herramientas externas. El agente le hace preguntas concretas, REA ejecuta el análisis en Hopper, Ghidra o IDA y le devuelve el pseudocódigo, el ensamblador, las cadenas de texto o las referencias entre funciones, junto con las pruebas y las limitaciones de cada conclusión. Con eso el agente explica el comportamiento y, si se le pide, escribe y prueba una versión propia.
Cómo trabaja REA. El agente no lee el binario directamente: le pide a REA análisis concretos, REA los ejecuta en el motor adecuado y le devuelve los resultados con sus pruebas. Esquema: decodigo.com, a partir de la documentación de REA.
El proyecto lo publica en GitHub el desarrollador conocido como morluto, con licencia MIT. El repositorio se creó en abril de 2026, la versión 1.0 salió el 13 de julio y el 11 de octubre llegó la 6.4.0. Para entonces ya pasaba de las 100,000 estrellas y las 22,000 bifurcaciones. Se instala con una sola orden, npx rea-agents setup, que lo registra en el agente elegido: Claude Code, Codex, Cursor, Gemini CLI, Grok Build u otros compatibles con MCP. También se puede usar desde la terminal con la orden rea.
Claves de REA
Muchos tipos de programa. Binarios nativos, aplicaciones de JavaScript y Electron, ensamblados de .NET, aplicaciones de Android (APK), módulos WebAssembly, código de contratos de Ethereum (EVM), firmware y sitios web, entre otros. Cada tipo tiene sus requisitos: los binarios nativos necesitan Hopper, Ghidra o IDA, mientras que JavaScript y .NET se analizan sin motor externo.
Análisis estático y en ejecución. Puede leer los archivos sin ejecutarlos, o lanzar el programa y observar lo que escribe en la terminal y en el disco, sus peticiones de red o el contenido de un móvil Android conectado.
Todo en local. El programa analizado no se sube a ningún servicio de REA. Eso sí, los resultados le llegan al modelo de IA que usa el agente, y ahí rige la política de datos de cada proveedor.
Pruebas, no solo respuestas. Cada conclusión viene acompañada de las direcciones, instrucciones o fragmentos de código que la respaldan, para que se pueda comprobar.
Sin promesas de clonar. REA no recupera el código fuente original. Devuelve pseudocódigo y relaciones entre módulos; la reconstrucción la escribe el agente y hay que validarla.
Tres casos de uso
El sitio del proyecto, rea.tools, documenta paso a paso tres investigaciones reales. Las tres muestran el mismo método: preguntar algo muy concreto, dejar que el agente consulte a REA y comprobar el resultado contra el original.
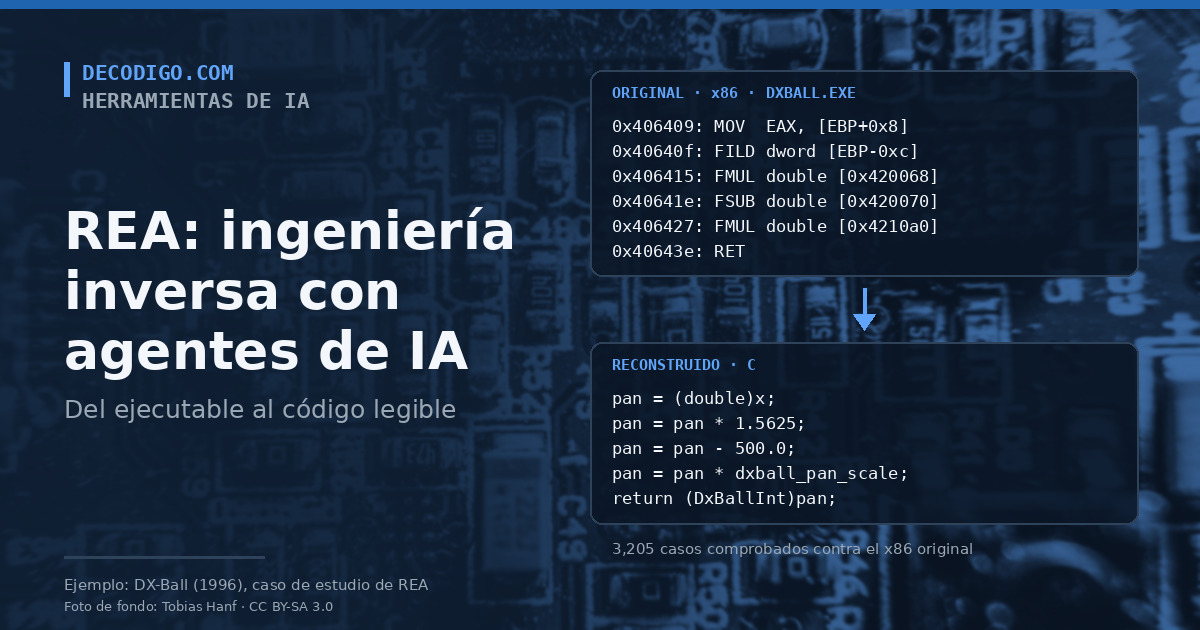
DX-Ball: reconstruir un juego de 1996 función a función. DX-Ball es un clásico de Windows del estilo de Arkanoid, y un proyecto busca reescribirlo en C mantenible partiendo solo de su ejecutable. En el caso documentado, la pregunta era cómo decide el juego si el sonido de un ladrillo roto suena más a la izquierda o a la derecha. El primer pseudocódigo del decompilador solo mostraba una conversión de números sin datos de entrada. Pero REA también devolvió las instrucciones, y en ellas aparecía el dato que faltaba. Siguiendo la función que la llama, el agente descubrió que recibe la posición del ladrillo en pantalla, y leyendo los bytes del ejecutable recuperó las constantes: la posición se multiplica por 1.5625, se le resta 500 y se aplica una escala. La función reconstruida en C da el mismo resultado que el código x86 original en 3,205 casos de prueba, y al compilarla con el compilador de la época produce exactamente los mismos 63 bytes. A 7 de octubre, el proyecto llevaba 55 funciones reescritas y 45,380 comparaciones con el original.
El cálculo recuperado de DX-Ball. Los valores 1.5625 y 500 estaban guardados en el ejecutable y REA los leyó byte a byte. Esquema: decodigo.com, a partir del caso de estudio de REA.
Notion: seguir el camino de un «copiar». La aplicación de escritorio de Notion está hecha con Electron, que separa la parte visible de la aplicación del proceso principal, el que tiene acceso al sistema. Analizando el paquete de la versión 7.6.1, REA localizó en el código minificado la función que la página usa para copiar y la llamada que envía la petición entre procesos. Con esas dos pistas, el agente siguió el recorrido completo: la página llama a clipboard.write, la petición viaja por el canal notion:clipboard:write y el proceso principal comprueba que el remitente sea una página de Notion antes de escribir en el portapapeles del sistema. De paso se aclaró cómo conserva Notion la estructura de los bloques al copiar y pegar: guarda los datos en local y añade al HTML copiado un identificador que los enlaza.
El camino de un «copiar» en la aplicación de escritorio de Notion 7.6.1, según el caso de estudio de REA. Los nombres de las funciones son los de Electron; el texto de ejemplo es ilustrativo. Esquema: decodigo.com.
Touhou 4: la matemática de un anillo de balas.Touhou 4: Lotus Land Story es un juego de disparos para el ordenador japonés PC-98, escrito para DOS de 16 bits. Un proyecto lo está reconstruyendo en C++, y la pregunta era cómo genera un anillo de balas que apunta al jugador. REA comprobó primero que el código cargado correspondía al ejecutable original y después devolvió las instrucciones de la función que fija la dirección de cada bala. De ahí salió el cálculo: el juego divide una vuelta completa en 256 unidades, reparte las balas a intervalos iguales (16 unidades cada una en un anillo de 16), suma la dirección hacia el jugador y guarda el resultado en un solo byte. La comprobación con el compilador original coincide en 2,139 bytes del código que genera las balas.
El anillo de 16 balas de Touhou 4. Sumar la dirección hacia el jugador gira el anillo entero sin cambiar la separación entre balas. Esquema: decodigo.com, a partir del caso de estudio de REA.
Un aviso legal. La ingeniería inversa es legal en muchos supuestos, como la interoperabilidad, la investigación de seguridad o la conservación de software, pero depende del país y de la licencia del programa. El propio proyecto lo advierte: REA está pensado para investigación legítima, y es responsabilidad de cada usuario contar con la autorización necesaria y cumplir la ley aplicable.
Por qué importa
La ingeniería inversa siempre ha sido cosa de pocos, porque exige leer ensamblador con soltura y mucha paciencia. Las herramientas como Ghidra o IDA ya hacían el trabajo mecánico de desensamblar, pero interpretar lo que salía seguía siendo humano. REA cubre ese hueco con agentes de IA que pueden hacer cientos de consultas, seguir referencias y contrastar hipótesis sin cansarse, mientras la persona decide qué preguntar y revisa las pruebas.
Los casos publicados muestran también el límite: el pseudocódigo inicial puede ser engañoso, como pasó con DX-Ball, y la reconstrucción solo es fiable cuando se compara con el original, ya sea ejecutando miles de casos o compilando hasta obtener los mismos bytes. En manos de equipos de seguridad, de proyectos de conservación de software o de desarrolladores que necesitan entender un formato sin documentación, eso puede ahorrar semanas de trabajo. La misma facilidad obliga a tener presente la parte legal.
REA es un buen ejemplo de hacia dónde van los agentes de programación: menos generar código desde cero y más usar herramientas especializadas para investigar, siempre con pruebas que respalden cada conclusión. Su crecimiento en GitHub indica que la idea ha conectado, y los casos de DX-Ball, Notion y Touhou 4 muestran que funciona en programas reales, desde un juego de DOS hasta una aplicación de escritorio actual.
¿Quieres probarlo? Hemos preparado una guía práctica de REA: cómo instalarlo, conectarlo con Claude Code, Codex o Cursor, analizar una app de Electron y un binario de Go, tenerlo al día y desinstalarlo, con todas las órdenes ejecutadas y sus salidas reales.
Actualización del 17 de octubre. Desde esta noticia, REA ha pasado de 100,000 a más de 300,000 estrellas en GitHub. Repasamos qué programas se han abierto ya con REA: de la calculadora de Windows y Aegis Authenticator a QuickBooks, CapCut y el mando del Apple TV, junto con las primeras polémicas.
Casos de estudio: DX-Ball, Notion y Touhou 4, en rea.tools. Cifras de versiones, estrellas y bifurcaciones tomadas de GitHub el 11 de octubre de 2026. Portada: elaboración propia con el código del caso de DX-Ball, sobre una foto de una placa de circuito de Tobias Hanf (Wikimedia Commons, CC BY-SA 3.0).
El Premio Nobel de Física 2026 es para Francis Halzen, de la Universidad de Wisconsin–Madison. Hace casi cuarenta años propuso algo que sonaba a disparate: usar el hielo del Polo Sur como un detector gigante para atrapar neutrinos, las partículas más esquivas que existen. Esa idea se convirtió en IceCube, y con él se detectaron por primera vez neutrinos de alta energía llegados de muy lejos del sistema solar.
Los neutrinos están por todas partes. No tienen carga eléctrica, casi no tienen masa y atraviesan la materia sin dejar rastro: cada segundo pasan por la uña de tu dedo meñique unos 65,000 millones de neutrinos procedentes del Sol, y no los notas. Solo muy de vez en cuando uno de ellos choca con el núcleo de un átomo, y ese choque es lo único que permite detectarlo.
La astronomía de neutrinos no es nueva. En los años sesenta Raymond Davis Jr. captó los primeros neutrinos del Sol, y en 1987 el detector japonés Kamiokande, dirigido por Masatoshi Koshiba, registró una lluvia de neutrinos de una supernova en la Gran Nube de Magallanes. Ambos recibieron el Nobel de Física en 2002, y en 2015 el premio fue para Takaaki Kajita y Arthur B. McDonald por demostrar que los neutrinos cambian de tipo durante su viaje. Pero todos esos neutrinos venían del Sol, de la atmósfera o de una galaxia vecina. Faltaba lo más difícil: los neutrinos de altísima energía que se producen en los lugares más violentos del universo.
Ahí entra uno de los grandes misterios de la astrofísica. La Tierra recibe continuamente rayos cósmicos, sobre todo protones, que a veces llegan con una energía hasta un millón de veces mayor que la que logran los aceleradores de partículas terrestres. Nadie sabe con certeza dónde se aceleran. Los procesos capaces de hacerlo deberían producir también neutrinos de alta energía, así que encontrarlos podía señalar el camino hacia esos aceleradores cósmicos.
La Real Academia Sueca de Ciencias anunció el premio el 6 de octubre. Halzen lo recibe en solitario «por sus contribuciones decisivas al Observatorio de Neutrinos IceCube y el descubrimiento de neutrinos de alta energía de origen astrofísico». Nació en 1944 en Tienen, Bélgica, se doctoró en 1969 en la Universidad Católica de Lovaina (KU Leuven) y poco después se trasladó a Wisconsin, donde es profesor. El premio está dotado con 12 millones de coronas suecas.
«Francis Halzen ha dirigido a un equipo internacional de investigadores e ingenieros que nos ha dado un instrumento fantástico. Su tenacidad y su visión científica han abierto el camino a un nuevo tipo de astronomía.»Mark Pearce, presidente del Comité Nobel de Física
Claves del premio
Una idea de 1988. A mediados de los ochenta Halzen supo que investigadores soviéticos querían captar neutrinos en la Antártida con antenas de radio. Pensó en otra vía: cuando un neutrino choca con un núcleo en un material transparente, produce una partícula cargada que emite un destello de luz azul, y ese destello puede registrarse con sensores de luz. Junto a John G. Learned, que trabajaba en un proyecto parecido en el mar frente a Hawái, presentó la propuesta de un observatorio en el hielo del Polo Sur en un congreso en Polonia en 1988.
Por qué el hielo del Polo Sur. A suficiente profundidad está siempre oscuro, no hay seres vivos que emitan luz como en el océano, tiene muy poca radiactividad y es una zona sin terremotos. Además ya había allí una estación científica con transporte regular. La pega es el frío: solo se puede trabajar en el breve verano antártico, de noviembre a febrero.
Un primer intento decepcionante. En 1992 el equipo empezó a bajar sensores al glaciar con perforaciones de agua caliente. Halzen recuerda haber pasado la Nochebuena de 1993 con el portátil en las rodillas, esperando la confirmación de que el primer cable estaba instalado. Los resultados iniciales fueron malos: las burbujas del hielo superficial dispersaban la luz. Pero por debajo de los 1,400 metros el hielo resultó ser purísimo, y la luz recorría hasta 300 metros antes de apagarse, mucho más de lo que nadie esperaba. Así nació AMANDA, el precursor de IceCube, que se construyó hasta el año 2000.
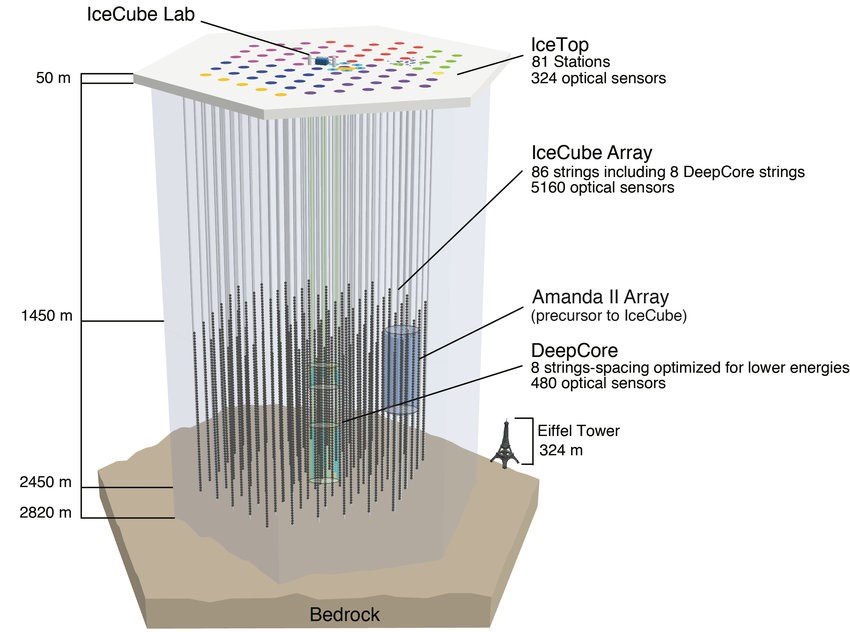
IceCube, un kilómetro cúbico de hielo. AMANDA funcionaba, pero se quedaba corto para los neutrinos cósmicos, que son rarísimos. IceCube se completó en 2011 con 5,160 sensores de luz repartidos en 86 cables, enterrados entre 1,450 y 2,450 metros de profundidad.
El descubrimiento. En 2013 el equipo presentó las primeras pruebas de neutrinos de alta energía llegados de fuera del sistema solar, y un par de años después reunió datos suficientes para confirmarlo.
Las primeras pistas de su origen. IceCube ha registrado 79 neutrinos que parecen venir de la galaxia activa NGC 1068 (M77), aunque la evidencia aún no basta para darla por fuente segura. También ha detectado neutrinos de alta energía de nuestra propia galaxia, que se formarían cuando los rayos cósmicos chocan con el gas tenue que hay entre las estrellas.
Así es IceCube por dentro. Los cables con sensores (IceCube Array) ocupan el hielo entre 1,450 y 2,450 metros de profundidad; en el centro está DeepCore, una zona más densa para neutrinos de menor energía, y a un lado AMANDA, su precursor. En la superficie están el laboratorio (IceCube Lab) y la red IceTop. La torre Eiffel, a la derecha, da la escala. Ilustración: Karen Andeen y Matthias Plum para IceCube Collaboration, CC BY 4.0.
Buscar una aguja en un pajar de hielo. IceCube no solo ve los neutrinos que busca. Cada día registra más de cien millones de partículas producidas por los rayos cósmicos al chocar con la atmósfera sobre la Antártida, y unos cientos de neutrinos atmosféricos que llegan tras atravesar la Tierra entera desde el hemisferio norte. Para encontrar los cósmicos, los investigadores seleccionan los choques ocurridos dentro del hielo y comprueban si, en conjunto, sus propiedades encajan con las de neutrinos llegados de lejos y no con los que se forman en nuestra atmósfera.
Por qué importa
Hasta ahora, casi todo lo que sabemos del universo lejano llega en forma de luz, y la luz tiene límites: el polvo la bloquea, y en los viajes más largos se debilita al interactuar con la materia y otras radiaciones. Los rayos cósmicos tampoco sirven para ubicar su origen, porque son partículas con carga eléctrica y los campos magnéticos del espacio desvían su trayectoria. Cuando llegan a la Tierra, ya no apuntan al lugar del que salieron.
Los neutrinos no tienen esos problemas. Viajan en línea recta y sin perder energía, atraviesan nubes de polvo y llegan desde distancias a las que otras señales no llegan. Si un neutrino de alta energía apunta a una galaxia, es muy probable que haya nacido allí. Por eso el trabajo de Halzen abre algo más que un nuevo instrumento: una forma distinta de mirar el cielo, capaz de mostrar los entornos más violentos del universo y quizá fenómenos que todavía no conocemos.
IceCube sigue registrando neutrinos cada día, y cuantos más capte, más fácil será identificar sus fuentes. Ya se prepara su sucesor, IceCube-Gen2, que ocupará ocho kilómetros cúbicos de hielo, y en el hemisferio norte se construyen telescopios parecidos en agua: en el lago Baikal, en el Mediterráneo, en el mar de la China Meridional y frente a la costa oeste de Canadá. La idea que Halzen presentó en 1988, y que tardó un cuarto de siglo en dar su primer resultado, es hoy el punto de partida de toda una rama de la astronomía.
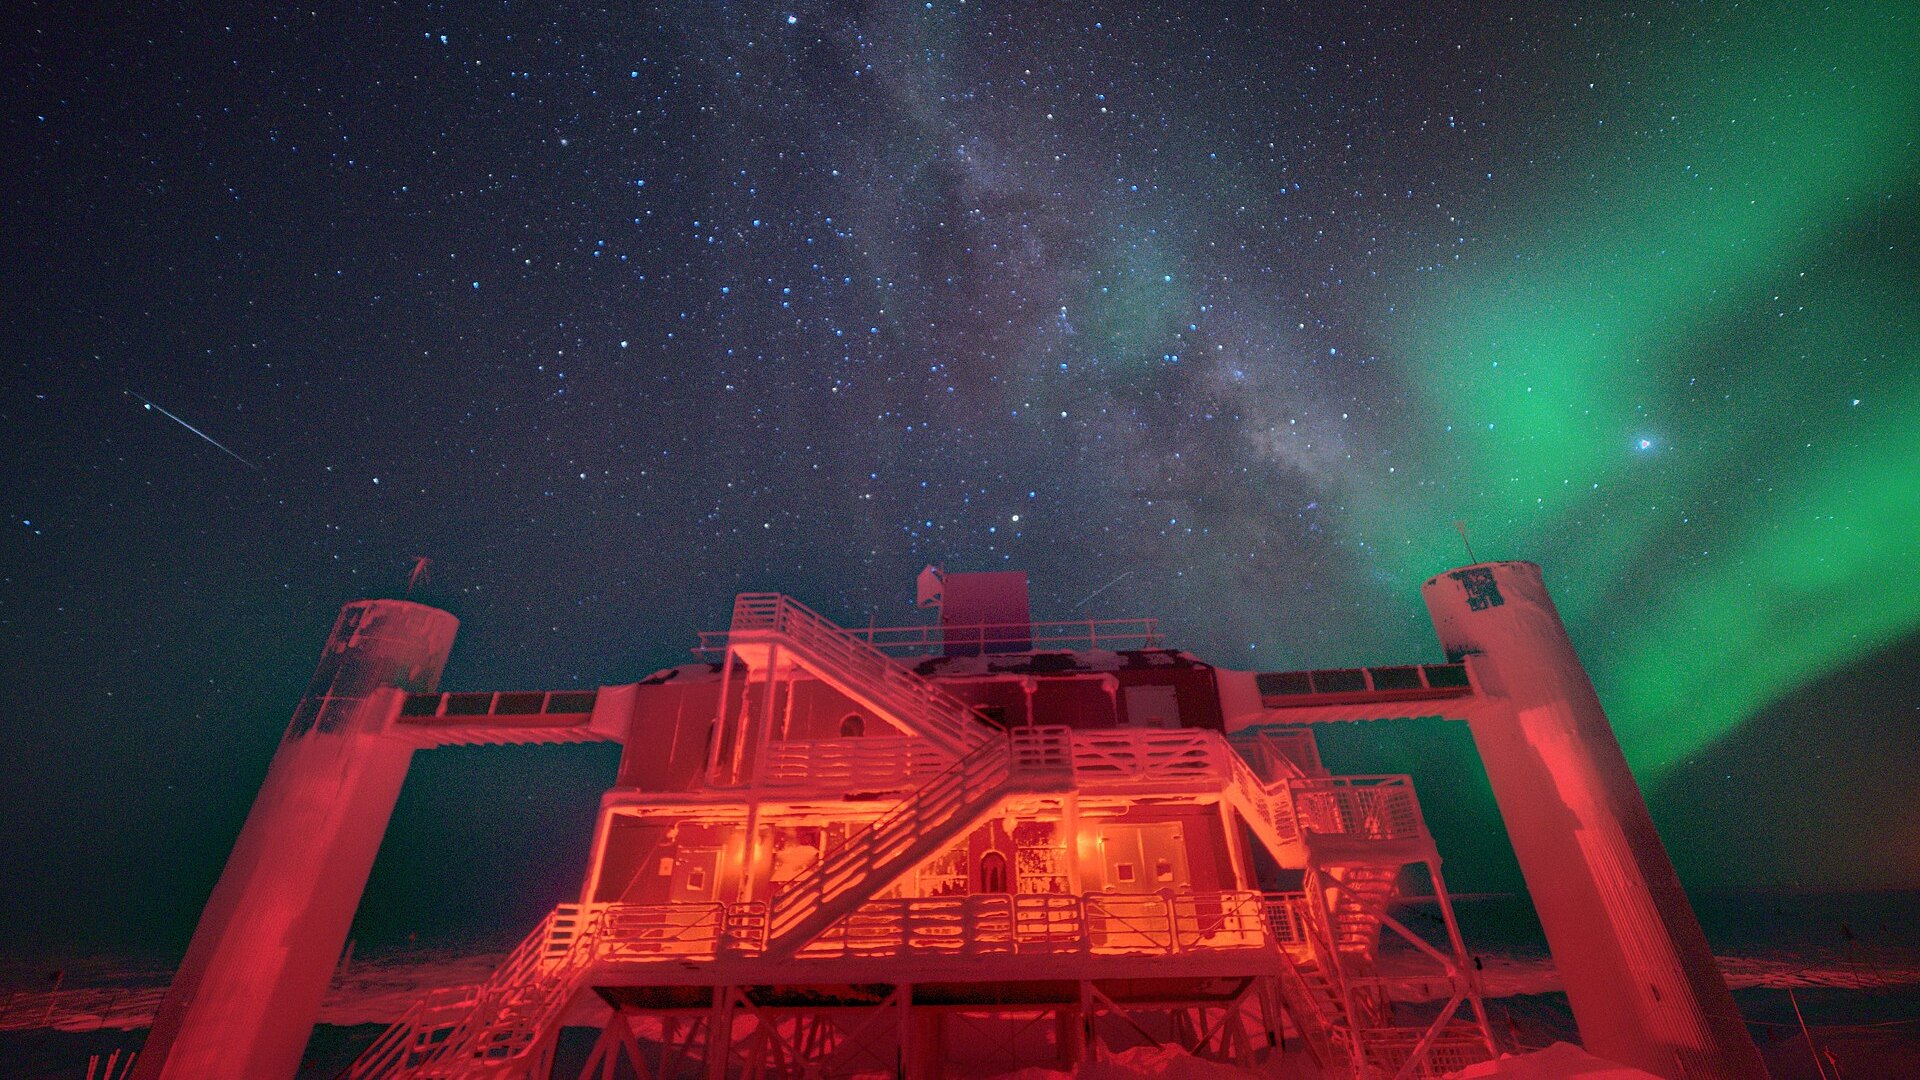
Datos contrastados con la información divulgativa del premio publicada por la Real Academia Sueca de Ciencias. Portada: el laboratorio de IceCube en el invierno del Polo Sur, con la Vía Láctea y una aurora austral de fondo. Foto de John Hardin, Wikimedia Commons, CC BY 4.0 (recortada).
Hoy, 11 de octubre de 2026, la raíz del DNS empieza a firmarse con una clave nueva. Es un cambio previsto desde que la clave nueva se publicó, en enero de 2025, y para casi todos invisible, pero tiene una cara incómoda: un resolutor que valide DNSSEC y no conozca la clave nueva dejará de resolver todos los nombres, no solo algunos. Aquí explicamos qué cambia, cómo se comprueba que tu resolutor está listo y qué ocurre en uno que no lo está, porque lo reprodujimos con dos copias de Unbound.
Cuando tu navegador pide decodigo.com, el resolutor de tu proveedor se lo pregunta al DNS. Con DNSSEC, además de la respuesta recibe firmas que demuestran que no la ha alterado nadie por el camino, y esas firmas forman una cadena: la raíz firma a .com, y .com firma a cada dominio que use DNSSEC. Todo cuelga de un punto de partida que el resolutor ya conoce de antemano, llamado ancla de confianza: la clave pública de la raíz.
Esa clave se llama KSK (Key Signing Key). La raíz está firmada desde julio de 2010, según el archivo de anclas de IANA, y en todo ese tiempo ha tenido dos KSK: la de 2010 y la de 2017. La que se ha usado hasta hoy es KSK-2017 (etiqueta 20326), y esta es solo la segunda vez que se cambia. A partir de hoy la sustituye KSK-2024 (etiqueta 38696), que lleva en la raíz desde el 11 de enero de 2025 esperando su turno.
El calendario completo de la rotación. Fuente: IANA.
Claves del cambio
Qué cambia exactamente
La raíz publica dos tipos de clave. La KSK firma solo un registro, el conjunto de claves (DNSKEY); la ZSK (Zone Signing Key), que se renueva con mucha más frecuencia, firma todo lo demás. Lo que cambia hoy es quién firma el conjunto de claves: hasta ayer, la KSK-2017; desde hoy, la KSK-2024. Las dos están ahora mismo en la raíz:
consulta del 11 de octubre de 2026, 14:20 UTC$ dig DNSKEY . @1.1.1.1 +multi +noall +answer | grep -E "KSK|ZSK"
				) ; ZSK; alg = RSASHA256 ; key id = 8763
				) ; ZSK; alg = RSASHA256 ; key id = 57780
				) ; KSK; alg = RSASHA256 ; key id = 20326
				) ; KSK; alg = RSASHA256 ; key id = 38696
La prueba de que el cambio ya está en marcha es quién firma ese conjunto. Preguntando directamente a un servidor raíz, la firma lleva ya la etiqueta de la clave nueva y es válida desde las 00:00 UTC de hoy. Preguntando a un resolutor público, todavía sale la antigua: es la copia que tiene en caché.
la misma consulta a un servidor raíz y a un resolutor, 14:20 UTC$ dig +dnssec DNSKEY . @a.root-servers.net +norecurse +noall +answer | awk '$4=="RRSIG"{print "firma de la clave", $11, "válida", $10, "→", $9}'
firma de la clave 38696 válida 20261011000000 → 20261101000000

$ dig +dnssec DNSKEY . @1.1.1.1 +noall +answer | awk '$4=="RRSIG"{print "firma de la clave", $11, "válida", $10, "→", $9}'
firma de la clave 20326 válida 20261001000000 → 20261022000000
Las fechas son formato AAAAMMDDhhmmss. La segunda respuesta es una firma anterior, válida del 1 al 22 de octubre, que el resolutor guarda hasta que caduque su caché. Los resolutores que se actualizan bien no tienen problema: ya aceptaban las dos claves.
Quién se ve afectado
Si administras un sitio web, normalmente nada: según Cloudflare, la mayoría de los operadores de sitios no necesitan cambiar nada, y la clave de tu dominio no es esta.
Si usas un resolutor público grande, lo normal es que ya esté preparado: Cloudflare lleva KSK-2024 integrada en su resolutor desde julio de 2024, y el archivo de anclas de IANA la da por válida desde el 18 de julio de 2024. Las pruebas de más abajo lo confirman para Cloudflare y Quad9; el de tu proveedor conviene comprobarlo.
Si administras un resolutor que valida DNSSEC (Unbound, BIND, Knot Resolver, PowerDNS Recursor, o el que lleva un cortafuegos, un balanceador o una pasarela), sí. Si no confía en la clave nueva, todos los nombres darán error, incluidos los de dominios que ni usan DNSSEC.
La clave nueva se distribuye por dos caminos. Los resolutores con el estándar RFC 5011 la aprenden solos: la ven en la raíz y, tras esperar 30 días sin que desaparezca, la aceptan; eso ocurrió en febrero de 2025. Y el software actualizado la trae ya de serie. Las dos vías fallan en los mismos sitios: una máquina que estuvo apagada o aislada durante esos 30 días, un archivo de claves de solo lectura, una copia de seguridad con la clave vieja, o un equipo olvidado cuyo software nadie actualiza.
Qué ocurre cuando el resolutor no conoce la clave nueva: la validación falla en el primer eslabón y no se llega a comprobar nada más.
Cómo se ve el fallo: lo reprodujimos
Para ver el fallo de verdad, no en un diagrama, levantamos dos copias de Unbound 1.26.1 en contenedores limpios, que hablan directamente con los servidores raíz. Una solo conoce la clave antigua, como un resolutor que no se actualizó; la otra solo la nueva. El único cambio entre las dos es la línea del ancla de confianza, con los datos del archivo root-anchors.xml de IANA:
server:
    interface: 127.0.0.1
    port: 5301
    root-hints: "/home/ana/root.hints"
    # solo la clave antigua, KSK-2017 (etiqueta 20326)
    trust-anchor: ". DS 20326 8 2 E06D44B80B8F1D39A95C0B0D7C65D08458E880409BBC683457104237C7F8EC8D"
    # en la otra copia:
    # trust-anchor: ". DS 38696 8 2 683D2D0ACB8C9B712A1948B27F741219298D0A450D612C483AF444A4C0FB2B16"
dig @127.0.0.1 -p 5301 y -p 5302 para tres dominios, 11 de octubre de 2026== resolutor vieja: solo KSK-2017 (20326)
  example.com.     status: SERVFAIL
  wikipedia.org.   status: SERVFAIL
  decodigo.com.    status: SERVFAIL

== resolutor nueva: solo KSK-2024 (38696)
  example.com.     status: NOERROR  ad   104.20.23.154
  wikipedia.org.   status: NOERROR       208.80.153.224
  decodigo.com.    status: NOERROR       3.151.169.32
La copia que solo conoce la clave antigua da SERVFAIL para los tres dominios, y entre ellos wikipedia.org y decodigo.com, que ni siquiera están firmados con DNSSEC. No hay un dominio roto: lo que se rompe es la cadena desde la raíz. Sin ella, el resolutor no puede comprobar ni siquiera que .com no haya firmado esos dominios, así que no se fía de la respuesta y devuelve un error. Su registro lo dice claramente:
registro de Unbound en la copia con la clave antiguainfo: failed to prime trust anchor -- DNSKEY rrset is not secure . DNSKEY IN
La copia con la clave nueva resuelve todo con normalidad. La marca ad (authenticated data) solo aparece en example.com, el único de los tres que usa DNSSEC: significa que el resolutor ha verificado la cadena completa.
Esta prueba es más brusca que lo que verá una red real. Aquí la copia consulta a los servidores raíz, que ya sirven la firma nueva, así que falla al instante. Un resolutor normal conserva en caché el conjunto de claves firmado con la clave antigua, así que el fallo aparece cuando caduca esa caché, como mucho dos días después, que es el tiempo de vida de ese registro (172,800 segundos). Por eso se habla de «las próximas 48 horas» como la ventana en la que se descubren los problemas.
Cómo comprobar tu resolutor
1. La prueba del centinela (RFC 8509). Es la forma estándar de preguntarle a un resolutor, sin acceso a su configuración, si confía en una clave concreta. Se hacen dos consultas a dominios especiales; Cloudflare mantiene unos en dnstest.dev:
dig @IP_DE_TU_RESOLUTOR root-key-sentinel-is-ta-38696.dnstest.dev A +noall +comments | grep status
dig @IP_DE_TU_RESOLUTOR root-key-sentinel-not-ta-38696.dnstest.dev A +noall +comments | grep status
Consulta
Confía en KSK-2024
No confía en KSK-2024
is-ta-38696
respuesta válida (NOERROR)
SERVFAIL
not-ta-38696
SERVFAIL
respuesta válida (NOERROR)
Lo curioso es que un SERVFAIL en la segunda consulta es la señal buena. Si las dos consultas resuelven bien, el resultado es indeterminado: el resolutor probablemente no implementa la prueba, y hay que mirar su configuración. Esto es lo que respondieron tres resolutores públicos:
Resolutor
is-ta-38696
not-ta-38696
Conclusión
1.1.1.1 (Cloudflare)
NOERROR
SERVFAIL
Confía en la clave nueva
9.9.9.9 (Quad9)
NOERROR
SERVFAIL
Confía en la clave nueva
8.8.8.8 (Google)
NOERROR
NOERROR
Indeterminado: no implementa la prueba
Que Google salga como «indeterminado» no significa que tenga un problema, solo que esta prueba no sirve para él. Si tu resolutor es público y muy usado, lo más probable es que el operador ya lo haya preparado.
2. Las anclas de confianza de tu software. Si administras el resolutor, comprueba que la etiqueta 38696 está en sus archivos de claves y que el proceso en marcha la ha cargado. Según Akamai, los archivos habituales son bind.keys (BIND), root.key (Unbound y algunas configuraciones de PowerDNS Recursor) y root.keys (Knot Resolver). Y para el proceso en marcha, rndc managed-keys status en BIND. Un archivo correcto no garantiza que el demonio lo haya leído.
En Debian, el paquete dns-root-data trae las anclas en /usr/share/dns/root.ds. Con la versión 2025080400 que instala Debian 13, el archivo ya incluye las dos:
dns-root-data 2025080400~deb13u1$ cat /usr/share/dns/root.ds
. IN DS 20326 8 2 E06D44B80B8F1D39A95C0B0D7C65D08458E880409BBC683457104237C7F8EC8D
. IN DS 38696 8 2 683D2D0ACB8C9B712A1948B27F741219298D0A450D612C483AF444A4C0FB2B16
Si falta la clave nueva, lo habitual es actualizar el software. Para Unbound existe unbound-anchor, que descarga el archivo de anclas de IANA y verifica su firma con el certificado de ICANN. Lo probamos con un usuario normal y un archivo que no existía:
Unbound 1.26.1, paquete unbound-anchor de Debian$ unbound-anchor -a root.key -v
/home/ana/root.key does not exist
success: the anchor is ok

$ grep -v '^;' root.key | cut -c1-80
.	86400	IN	DNSKEY	257 3 8 AwEAAaz/tAm8yTn4Mfeh5eyI96WSVexTBAvkMgJzkKTOiW1vkIbzxe
.	86400	IN	DNSKEY	257 3 8 AwEAAa96jeuknZlaeSrvyAJj6ZHv28hhOKkx3rLGXVaC6rXTsDc449
El archivo resultante contiene las dos claves raíz. Si no puedes actualizar, la guía de Akamai recomienda obtener el ancla directamente de IANA y, sobre todo, actualizar las imágenes base y las copias de seguridad, para que un equipo restaurado no vuelva con el ancla antigua.
Si solo fallan algunos dominios, el culpable no es la clave raíz. Cuando el problema es de la raíz, falla todo lo que se resuelve a través de ese resolutor. Si unos nombres funcionan y otros no, mira las firmas caducadas, un registro DS que ya no coincide con la clave del dominio o una migración mal hecha entre proveedores de DNS.
Por qué importa
DNSSEC solo protege si todas las piezas se actualizan a tiempo, y el cambio de clave raíz es la prueba más dura para esa promesa. Cambia muy pocas veces y obliga a tocar cosas que nadie mira durante años: las anclas guardadas en un dispositivo de red, una imagen de máquina virtual, el contenedor de un resolutor interno. La lección de la rotación anterior, según Cloudflare, es que los resolutores pueden perder la confianza que habían aprendido cuando se actualiza el software o se mueve la instalación a otra máquina. Por eso el software reciente incluye la clave nueva de serie.
El coste de un fallo es asimétrico. Si todo está bien, nadie nota nada. Si un resolutor corporativo no está preparado, deja sin internet a toda la oficina, y desde fuera parece una caída general: los sitios funcionan, pero no se llega a ellos. Lo más práctico es comprobarlo hoy, con dos consultas de dig contra el resolutor de la red.
El proceso no termina hoy. Según IANA, la clave antigua se publicará con el bit de revocación el 11 de enero de 2027, que es la señal para que los resolutores la descarten, y se retirará de la raíz el 22 de marzo de 2027. El cambio de hoy afecta a pocos, pero conviene dejar la comprobación hecha mientras el tema está fresco.