Los propulsores del nuevo Tesla Roadster, el deportivo que «vuela» a saltos, no funcionan con aire, como se dijo en la presentación, sino con nitrógeno a 10,000 psi, según Lars Moravy, jefe de ingeniería de vehículos de Tesla. Cada carga da para unos cinco segundos de empuje, y volver a llenar los depósitos lleva hoy de dos a siete horas en una estación especial. Esa proporción, y lo poco que ha aclarado Tesla sobre cómo se recargará, ha centrado las críticas.
Tesla presentó el Roadster el 15 de octubre en el campo de pruebas de SpaceX en McGregor (Texas), con una demostración en la que el coche, sin nadie dentro, saltaba por encima de otros vehículos y giraba en el aire gracias a propulsores de gas frío diseñados con SpaceX. Habrá tres versiones y, de momento, ninguna tiene precio. En los días siguientes, Moravy y el jefe de diseño, Franz von Holzhausen, dieron más detalles en entrevistas con Top Gear y con Hagerty, y ahí apareció el nitrógeno.
En resumen: los propulsores son un recurso de un solo uso, pensado para un arranque o un salto, que se vacía en segundos y se rellena en horas. El propio Musk había dicho en la presentación que el coche rellenaría sus depósitos con aire, sin necesidad de un propelente especial, y Tesla todavía no ha explicado cómo encajan las dos versiones.
Claves del sistema de nitrógeno
Nitrógeno, no aire. «El nitrógeno parecía un buen combustible», dijo Moravy a Hagerty. Va guardado en depósitos de fibra de carbono como los de los cohetes de SpaceX (COPV), a hasta 10,000 psi, unas 690 veces la presión atmosférica. Es un gas inerte: no arde, solo empuja al salir.
Dos tamaños de depósito. La versión Thrust lleva un depósito de 200 litros y cuatro toberas traseras que, según Tesla, dan más de 80 kilonewtons de empuje, pero no puede flotar. La Rocket añade otro de 400 litros en el sitio del pasajero, hasta 600 litros, y reparte diez propulsores por el contorno: es la única que salta y gira en el aire. La Performance no lleva propulsores, y ese espacio queda para el equipaje.
Unos segundos por carga. En la Thrust, el empuje dura unos cinco segundos, lo que cubre las dos terceras partes de una carrera de cuarto de milla. Moravy lo describió como algo de «una sola vez». Cuando el gas se acaba, el coche sigue funcionando con sus motores eléctricos, pero sin el empujón extra.
Horas para rellenarlo. El depósito de la Thrust tarda hoy de dos a seis horas conectado a un suministro externo de nitrógeno a alta presión, y el de 600 litros de la Rocket, de seis a siete horas. No es algo que se pueda hacer en casa. Tesla espera bajarlo a menos de media hora, sin fecha.
Nuestra cuenta: unos 7 segundos flotando, como mucho. Con las propiedades reales del nitrógeno a 10,000 psi y 20 °C, 200 litros son unos 100 kilos de gas, y 600 litros, unos 290. Al salir, el gas se expande, se enfría y pierde presión, así que en el mejor de los casos el depósito grande da un impulso total de unos 134 kilonewtons-segundo: podría empujar con 134 kilonewtons durante un segundo, o con menos fuerza durante más tiempo. Para sostener un coche de unas 2 toneladas hacen falta unos 20 kilonewtons, lo que deja alrededor de 7 segundos. Coincide con los 6.7 segundos que calculó el canal Engineering Explained. Y los 80 kilonewtons de la Thrust solo pueden ser un pico: a ese ritmo, su depósito se vaciaría en poco más de medio segundo.
Las dudas sobre el gas. Musk dijo en la presentación que el coche rellenaría sus depósitos con aire, y algunos medios siguen hablando de aire comprimido. La entrevista de Top Gear se grabó antes de la presentación, así que Moravy podría estar describiendo el sistema actual y Musk uno futuro. Tesla no lo ha aclarado.
La cuenta es nuestra, con datos de nitrógeno real (CoolProp), y supone un vaciado ideal sin pérdidas: los segundos reales serán menos. El peso de 2 toneladas es el que usa Engineering Explained; Tesla no lo ha publicado.
Un truco caro de repetir
La crítica más repetida no es técnica sino práctica. Tom Ford, presentador de Top Gear, llamó a los propulsores «bellamente inútiles» en la propia entrevista, y Carscoops los describe como «un truco de feria de un solo disparo»: incluso con la recarga de media hora que promete Tesla, cada salida al circuito obligaría a esperar junto a una estación de nitrógeno. El inversor Ross Gerber, accionista conocido de Tesla, preguntó en público para qué necesita flotar un coche. Y la propia Tesla reconoce que la Rocket, la única que salta, no está autorizada para circular por la vía pública.
Otras dudas apuntan a la demostración. El coche iba controlado a distancia, en un recinto cerrado de SpaceX y ante invitados, y Tesla dio las cifras sin cronómetro en pantalla. Carscoops pregunta si los coches del espectáculo llevaban la misma batería, los mismos depósitos y el mismo control que los de serie, y señala que Tesla ha dado velocidades punta distintas según el día. A eso se suman los riesgos de llevar cientos de litros de gas a 10,000 psi detrás de los asientos en caso de choque, y el desgaste de los ventiladores que pegan el coche al suelo. No todo es escepticismo: un análisis de Forbes plantea que el gas frío podría servir algún día como sistema de seguridad, porque empuja sin depender del agarre de las ruedas y funciona con cualquier clima.
Por ahora, el nitrógeno convierte los propulsores en lo que el propio Musk dijo en la presentación: no un coche que vuela, sino uno que salta. La producción está prevista para 2028, y antes de esa fecha Tesla tendrá que explicar cómo y dónde se recargará, y cuánto costará hacerlo.
Datos contrastados con TeslaNorth (entrevista de Hagerty), Torque News (Top Gear y Hagerty), Carscoops, Autoblog (cálculos de Engineering Explained), Glitchwire y Forbes. Portada: los propulsores del Roadster, imagen de prensa de Tesla publicada por Dezeen (recortada, con texto).
ChatGPT, Claude o el reconocimiento de caras del móvil funcionan con redes neuronales artificiales: millones de piezas diminutas que copian, de forma muy simplificada, lo que hace una neurona del cerebro. La idea tiene más de ochenta años, y nació de una pregunta muy concreta: si una neurona solo se enciende o se apaga, ¿puede una red de neuronas razonar como una calculadora? Te contamos cómo surgió, cómo funciona una neurona artificial y, con dos animaciones, cómo una red aprende sola.
Primero hubo que ver la neurona
A finales del siglo XIX no estaba claro que el cerebro estuviera hecho de células separadas. Muchos científicos, entre ellos el italiano Camillo Golgi, creían que era una red continua, como una malla de tuberías. Fue el español Santiago Ramón y Cajal quien, a partir de 1888, tiñó y dibujó miles de neuronas y demostró que cada una es una célula independiente, con una dirección clara: las señales entran por las dendritas, se reúnen en el cuerpo celular y salen por el axón hacia otras neuronas, a las que se conecta en las sinapsis. Golgi y Cajal compartieron el Nobel de Medicina de 1906, todavía sin ponerse de acuerdo.
Durante las décadas siguientes se vio además que una neurona funciona casi como un interruptor: va acumulando las señales que le llegan y, si pasan de cierto umbral, dispara un impulso eléctrico. Si no, se queda en silencio. No hay término medio: es todo o nada.
1943: una neurona hecha de lógica
Ese «todo o nada» llamó la atención de dos personajes muy distintos. Warren McCulloch era un neurofisiólogo de Chicago que llevaba años pensando cómo podía el cerebro producir pensamiento. Walter Pitts era un joven autodidacta, sin título universitario, que de adolescente había leído los Principia Mathematica de Bertrand Russell y le había escrito para señalarle errores; vivía prácticamente sin casa cerca de la Universidad de Chicago cuando McCulloch lo acogió.
En 1943 publicaron juntos «A Logical Calculus of the Ideas Immanent in Nervous Activity». Su modelo de neurona era mínimo: unas entradas que valen 0 o 1, una suma y un umbral. Si la suma lo alcanza, la salida es 1; si no, 0. Con eso demostraron algo sorprendente: combinando neuronas así se puede construir cualquier operación lógica, como Y, O o NO, y, por tanto, en principio, cualquier cálculo. El cerebro podía verse como una máquina de calcular. John von Neumann citó el artículo poco después al describir la arquitectura de los primeros ordenadores.
Faltaba algo esencial: en la neurona de McCulloch y Pitts, los pesos y el umbral los ponía una persona a mano. La neurona no aprendía. En 1949, el psicólogo canadiense Donald Hebb propuso cómo podría hacerlo el cerebro: cuando una neurona ayuda repetidamente a que otra se dispare, la conexión entre las dos se refuerza. Es la idea que hoy se resume en «las neuronas que se disparan juntas se conectan», y la base de todo lo que vino después: aprender es ajustar la fuerza de las conexiones.
Cada pieza de la neurona artificial copia una de la biológica: las dendritas son las entradas, la fuerza de cada sinapsis es un peso, el cuerpo celular es la suma y el disparo del axón es la salida. Esquema: decodigo.com.
Pruébalo: una neurona que aprende
Esta es una neurona artificial con dos entradas. Haz clic en las entradas para encenderlas y apagarlas, y mueve los pesos (w₁ y w₂) y el umbral (b): la neurona suma cada entrada multiplicada por su peso, más el umbral, y dispara si el resultado es mayor que cero. Los pulsos azules son señales que empujan a disparar; los rojos, señales que frenan. A la derecha verás lo que «ve» la neurona: los cuatro casos posibles como puntos en un plano y la recta que separa los que dan 1 de los que dan 0.
Objetivo:
Objetivo: Y (AND). Mueve los pesos y el umbral hasta que los cuatro casos salgan bien, o pulsa «Aprender los pesos».
Con «Aprender los pesos», la neurona empieza con todo a cero y aplica la regla del perceptrón: prueba cada caso y, si se queda corta, sube los pesos de las entradas que estaban encendidas; si se pasa, los baja. Con la Y y la O encuentra la solución en unas pocas vueltas. Con el XOR, que da 1 solo cuando las dos entradas son distintas, no lo consigue nunca, y la explicación está en el plano: no hay ninguna recta que deje los dos puntos azules a un lado y los dos rojos al otro.
1958: el perceptrón, la máquina que «iba a pensar»
Esa regla la inventó Frank Rosenblatt, un psicólogo del Laboratorio Aeronáutico de Cornell, que en 1958 juntó las dos ideas: la neurona de McCulloch y Pitts y el aprendizaje de Hebb. Lo llamó perceptrón, y no se quedó en el papel. Con dinero de la Oficina de Investigación Naval de Estados Unidos construyó el Mark I Perceptron, una máquina con una «retina» de 400 fotocélulas en una cuadrícula de 20 por 20, cuyos pesos eran potenciómetros que unos motores eléctricos giraban para ajustarlos. Le enseñaban tarjetas con formas y, tras unos cuantos intentos, aprendía a distinguirlas.
La presentación, en julio de 1958, desató la primera fiebre de la IA. Según la crónica del New York Times, la Marina esperaba que fuera el embrión de un ordenador capaz de andar, hablar, ver, escribir, reproducirse y ser consciente de su propia existencia. Nada de eso estaba cerca.
El invierno y el deshielo
En 1969, Marvin Minsky y Seymour Papert, del MIT, publicaron el libro Perceptrons, donde demostraban matemáticamente lo que acabas de ver en la animación: un perceptrón de una sola capa no puede aprender cosas tan simples como el XOR. Sabían que una red con más capas sí podría, pero nadie sabía cómo entrenarla. El libro, junto con las promesas incumplidas, contribuyó a que la financiación de las redes neuronales se secara durante más de una década. Es el primer «invierno de la IA».
La salida llegó con la retropropagación (backpropagation). La idea es repartir la culpa del error hacia atrás: se mira cuánto se equivocó la salida y se calcula cuánto contribuyó cada peso de cada capa, para corregirlos todos un poco. Paul Werbos la había descrito en su tesis de 1974, pero fue el artículo de David Rumelhart, Geoffrey Hinton y Ronald Williams en Nature, en 1986, el que la popularizó. Con ella, las redes podían tener capas ocultas entre la entrada y la salida, y esas capas aprenden por su cuenta a detectar rasgos intermedios. El XOR dejó de ser un problema.
Pruébalo: una red que aprende a separar
Aquí tienes una red pequeña, de las que se entrenan con retropropagación. Recibe dos números, la posición de un punto en el mapa de la izquierda, y tiene que decir si es azul o rojo. Pulsa «Entrenar» y mira cómo el fondo del mapa, que muestra lo que la red responde en cada zona, se va ajustando a los puntos. A la derecha, la red por dentro: cada neurona se ilumina según su activación para el punto marcado con el círculo, y los pulsos de luz recorren las conexiones con la fuerza de cada señal, en azul si suman y en rojo si restan. Pasa el ratón o el dedo por el mapa para ver qué neuronas se encienden en cada zona.
Datos:
Capas ocultas:
Prueba a quitar las capas ocultas: con «Ninguna», la red es un perceptrón y solo sabe dibujar una recta, así que no pasa de acertar poco más de la mitad de los puntos en ninguno de los tres conjuntos. Con una capa oculta resuelve el XOR y el círculo en un par de segundos, pero la espiral se le resiste. Con dos capas, también la espiral. Cada capa combina lo que encontró la anterior, y eso le permite trazar fronteras cada vez más retorcidas: es la idea del aprendizaje profundo.
Este programa en Python hace lo mismo que las dos animaciones en pequeño, sin ninguna biblioteca: primero la neurona sola con la regla del perceptrón, que aprende la Y y la O pero no el XOR, y después una red con una capa oculta de solo dos neuronas, entrenada con retropropagación, que sí lo resuelve:
# Una neurona artificial que aprende con la regla del perceptrón (Rosenblatt, 1958),
# y una red con una capa oculta que resuelve el XOR con retropropagación (1986).
import math
import random

TABLAS = {
    "Y":   [((0, 0), 0), ((0, 1), 0), ((1, 0), 0), ((1, 1), 1)],
    "O":   [((0, 0), 0), ((0, 1), 1), ((1, 0), 1), ((1, 1), 1)],
    "XOR": [((0, 0), 0), ((0, 1), 1), ((1, 0), 1), ((1, 1), 0)],
}


def neurona(x, w, b):
    """Dispara (1) si la suma ponderada supera el umbral, como la de McCulloch y Pitts."""
    return 1 if w[0] * x[0] + w[1] * x[1] + b > 0 else 0


def perceptron(tabla, max_epocas):
    w, b = [0, 0], 0
    for epoca in range(1, max_epocas + 1):
        errores = 0
        for x, objetivo in tabla:
            error = objetivo - neurona(x, w, b)
            if error:
                errores += 1
                w = [w[0] + error * x[0], w[1] + error * x[1]]
                b += error
        if errores == 0:
            return w, b, epoca, True
    return w, b, max_epocas, False


for nombre, tabla in TABLAS.items():
    w, b, epocas, converge = perceptron(tabla, 6 if nombre == "XOR" else 20)
    salidas = [neurona(x, w, b) for x, _ in tabla]
    estado = f"aprendido en {epocas} épocas" if converge else f"sin solución tras {epocas} épocas"
    print(f"{nombre:3}  w = {w}, b = {b:2}  salidas {salidas}  ({estado})")


# Red 2-2-1 con sigmoides: la capa oculta resuelve lo que una neurona sola no puede.
def sig(z):
    return 1 / (1 + math.exp(-z))


random.seed(1)   # con la semilla 3 se queda atascada en un mínimo local
W1 = [[random.uniform(-1, 1) for _ in range(2)] for _ in range(2)]
b1 = [0.0, 0.0]
W2 = [random.uniform(-1, 1) for _ in range(2)]
b2 = 0.0
tasa = 0.5
for epoca in range(20000):
    for x, t in TABLAS["XOR"]:
        h = [sig(W1[j][0] * x[0] + W1[j][1] * x[1] + b1[j]) for j in range(2)]
        y = sig(W2[0] * h[0] + W2[1] * h[1] + b2)
        dy = (y - t) * y * (1 - y)                      # error de la salida
        dh = [dy * W2[j] * h[j] * (1 - h[j]) for j in range(2)]   # repartido hacia atrás
        for j in range(2):
            W2[j] -= tasa * dy * h[j]
            W1[j][0] -= tasa * dh[j] * x[0]
            W1[j][1] -= tasa * dh[j] * x[1]
            b1[j] -= tasa * dh[j]
        b2 -= tasa * dy

print("\nRed con una capa oculta de 2 neuronas, tras 20,000 épocas:")
for x, t in TABLAS["XOR"]:
    h = [sig(W1[j][0] * x[0] + W1[j][1] * x[1] + b1[j]) for j in range(2)]
    y = sig(W2[0] * h[0] + W2[1] * h[1] + b2)
    print(f"XOR{x} = {y:.3f}  (debe dar {t})")
salidaY    w = [2, 1], b = -2  salidas [0, 0, 0, 1]  (aprendido en 6 épocas)
O    w = [1, 1], b =  0  salidas [0, 1, 1, 1]  (aprendido en 4 épocas)
XOR  w = [-1, 0], b =  1  salidas [1, 1, 0, 0]  (sin solución tras 6 épocas)

Red con una capa oculta de 2 neuronas, tras 20,000 épocas:
XOR(0, 0) = 0.013  (debe dar 0)
XOR(0, 1) = 0.989  (debe dar 1)
XOR(1, 0) = 0.989  (debe dar 1)
XOR(1, 1) = 0.011  (debe dar 0)
La neurona sola da exactamente los mismos pesos que la animación de arriba; lo comprobamos ejecutando las dos. Y un detalle honesto: con otros pesos iniciales al azar (por ejemplo, la semilla 3), esa red tan pequeña se queda atascada y no resuelve el XOR. Es uno de los problemas reales del entrenamiento, y una de las razones por las que las redes actuales tienen muchas más neuronas de las que en teoría necesitarían.
De 400 fotocélulas a cientos de miles de millones de pesos
Durante los noventa y los dos mil, las redes neuronales siguieron siendo una opción más entre muchas. Yann LeCun las usó para leer códigos postales escritos a mano, pero eran lentas de entrenar y necesitaban muchos datos. Las dos cosas cambiaron a la vez: internet trajo los datos y las tarjetas gráficas, las GPU, diseñadas para videojuegos, resultaron perfectas para hacer millones de multiplicaciones en paralelo. En 2012, AlexNet, una red profunda de Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton entrenada con dos GPU, arrasó en el concurso de reconocimiento de imágenes ImageNet. Desde entonces, casi toda la IA es aprendizaje profundo, y en 2024 John Hopfield y Geoffrey Hinton recibieron el Nobel de Física por sus trabajos fundacionales sobre redes neuronales.
Las fechas clave, de la neurona de Cajal a la IA actual. El hito en gris marca el comienzo del primer invierno de la IA. Esquema: decodigo.com.
Los grandes modelos de lenguaje de hoy siguen hechos de la misma pieza: entradas multiplicadas por pesos, una suma y una función de activación, aunque ya no es el escalón de todo o nada sino curvas suaves, que permiten calcular hacia dónde ajustar cada peso. La diferencia es la escala: en lugar de dos pesos, cientos de miles de millones, organizados en capas y en arquitecturas como los transformers, entrenados con buena parte del texto de internet.
Una copia muy tosca del original
Conviene no tomarse el nombre demasiado al pie de la letra. El cerebro humano tiene unos 86,000 millones de neuronas, y cada una es mucho más compleja que una suma y un umbral: sus dendritas hacen cálculos propios, las señales llevan información en su ritmo y no solo en su intensidad, y las conexiones cambian con la química del cerebro. En 2021, un equipo de la Universidad Hebrea de Jerusalén intentó imitar con una red artificial lo que hace una sola neurona de la corteza cerebral, y necesitó una red profunda de entre cinco y ocho capas.
Además, el cerebro no aprende con retropropagación, o al menos nadie ha encontrado cómo podría hacerlo, y consume unos 20 vatios, menos que una bombilla, mientras que entrenar un modelo grande requiere centros de datos enteros. La neurona artificial fue una inspiración, no una copia: tomó del cerebro una sola idea, que muchas piezas simples, conectadas con fuerzas ajustables, pueden aprender casi cualquier cosa. Ochenta años después, esa idea sigue dando de sí.
La Agencia de Ciberseguridad y Seguridad de las Infraestructuras de Estados Unidos (CISA) añadió el martes 27 de octubre Node2Shell (CVE-2026-111497) a su catálogo de vulnerabilidades explotadas conocidas (KEV). Es la confirmación oficial de que hay ataques reales contra el fallo del descompresor Brotli. Las agencias civiles del gobierno federal tienen hasta el 10 de noviembre para corregirlo, y los primeros intentos registrados apuntan a servidores Node.js.
El 24 de octubre contamos que un fallo en Brotli, el formato de compresión de Google que usa buena parte de la web, permitía corromper la memoria de un programa con un archivo comprimido manipulado. Lo descubrió el equipo de seguridad de OpenAI, tiene una gravedad de 9.2 sobre 10 y afecta a todo lo que lleve dentro una copia de la biblioteca, de Node.js a Python, Bun o Envoy. Entonces no constaban ataques. Una semana después, la situación ha cambiado.
Es el mismo camino que siguió PHP2Shell, que entró en el catálogo KEV un día antes: parche, prueba de concepto pública y ataques en pocos días. La alerta de CISA incluye además otro fallo, de Adobe Commerce y Magento (CVE-2026-48356), que permite subir archivos peligrosos.
Claves de lo que se sabe esta semana
Qué dice CISA: registra el fallo como «Google Brotli Unchecked Return Value Vulnerability» y lo vincula a su directiva BOD 26-04. No ha dado detalles de los ataques, y marca como «desconocido» si lo usan grupos de ransomware. El plazo solo obliga a las agencias federales, pero CISA pide a todas las organizaciones que den prioridad a los fallos del catálogo.
El primer ataque, captado por ELLIO: la red de sensores de la empresa ELLIO registró el 26 de octubre una petición maliciosa dirigida a Node.js 24.22.0 en equipos x86-64. La misma dirección IP había atacado antes PHP2Shell y sondeado VPN de Palo Alto Networks y Fortinet. Para ELLIO, es una señal de que el fallo lo ha adoptado «un operador centrado en la explotación masiva».
Un ataque que, de momento, falla: según ELLIO, ese exploit estaba roto. Las piezas coincidían con el código de prueba publicado, pero en 50 pruebas no consiguió ejecutar código ni una vez. Lo que sí hace es tumbar el proceso de Node.js, es decir, sirve para dejar un servicio fuera de línea.
Pero el ataque completo es posible: la propia ELLIO logró ejecutar código en cuatro configuraciones con compilaciones oficiales de Node.js en x86-64, y el equipo rojo de Imperva lo hizo en la imagen oficial de Node.js 24.22.0 para Linux arm64, aunque necesitó varios intentos. Imperva no ha publicado su código.
Más intentos en servidores trampa: la empresa Previdian registró el 27 de octubre otro intento desde una dirección de Estados Unidos, y aclara que eso «no significa que el intento tuviera éxito».
VMware, sin parche: Broadcom avisó el 27 de octubre de que SDDC Manager, de VMware Cloud Foundation y vSphere Foundation, es vulnerable porque usa Node.js. Le da un 9.8 sobre 10 en la versión 9.1.1 y un 7.5 en las 9.0.x, 9.1.0 y 5.2.x. Los parches están pendientes; por ahora solo hay medidas temporales.
La lista de afectados crece: además de Node.js, Python, Bun y Envoy, han publicado correcciones Microsoft, para .NET entre otros productos, e Istio, y Palo Alto Networks está distribuyendo parches para PAN-OS. Tenable añade FFmpeg, Apache Arrow y ClickHouse a la lista de programas con Brotli dentro.
Ocho meses a la vista de todos
Lo más incómodo de Node2Shell es el calendario. Según Help Net Security, la corrección se subió al repositorio público de Brotli el 27 de febrero, sin versión nueva ni aviso de seguridad, y estuvo ocho meses a la vista de cualquiera que leyera los cambios. Las versiones corregidas no llegaron hasta el 21 de octubre, y seis días después ya había ataques. Es el problema de las bibliotecas que van incluidas dentro de otros programas: el arreglo existe, pero no protege a nadie hasta que cada proyecto lo incorpora y cada administrador lo instala.
Para quien tiene servidores Node.js, el consejo es el mismo de hace una semana, pero ya sin margen. Comprueba la versión con node -v y actualiza a 22.23.4, 24.22.1 o 26.12.1. Las ramas 20, 23 y 25 ya no tienen soporte y no recibirán el parche, así que hay que migrar. Los servicios más expuestos son los que aceptan cuerpos de petición comprimidos con Brotli, como las aplicaciones con Express 5 y body-parser 2, y los que descargan datos de servidores ajenos. No olvides las imágenes de Docker con una versión fija de Node.js: hay que cambiar esa línea, reconstruirlas y volver a desplegarlas. Y si usas VMware SDDC Manager, aplica las medidas temporales de Broadcom mientras llega el parche.
Que el exploit que circula aún no funcione es una buena noticia a medias. Varios equipos ya han demostrado que el ataque completo es posible, y quien está lanzando los intentos tiene experiencia con PHP2Shell. Lo normal es que el exploit mejore en los próximos días, así que el plazo de CISA debería tomarse como el límite máximo, no como el objetivo.
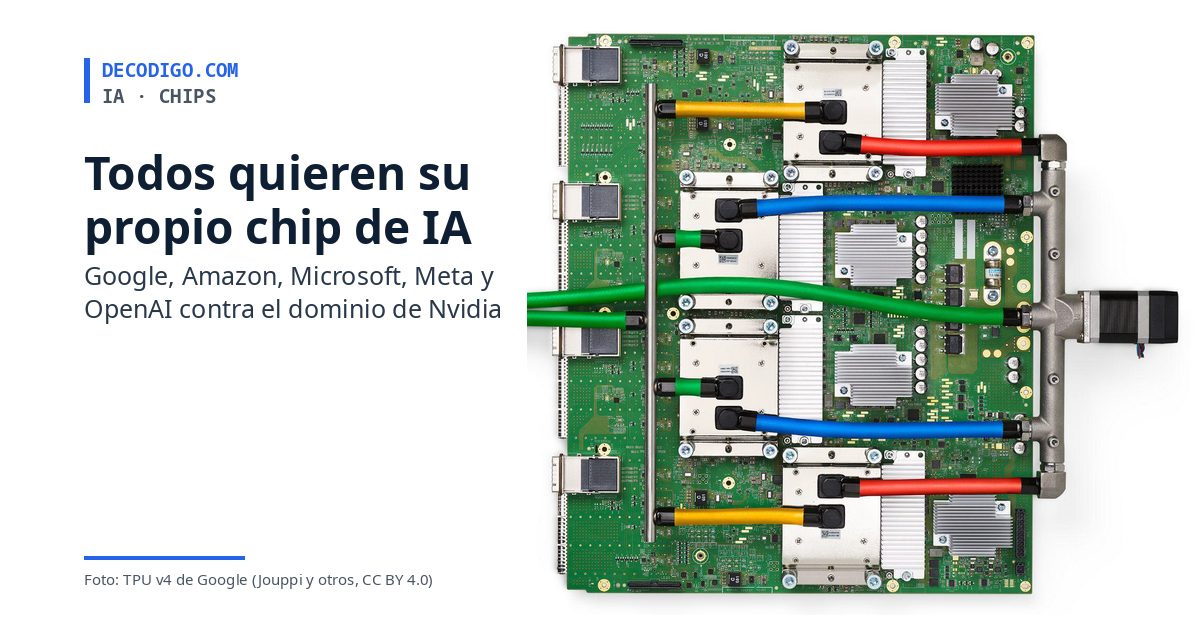
OpenAI ya está instalando en sus centros de datos Jalapeño, el primer chip de IA que ha diseñado ella misma. No es un caso aislado: Google, Amazon, Microsoft, Meta y Tesla tienen chip propio o lo están preparando, y una generación de startups compite por el mismo mercado. Todos persiguen lo mismo: depender menos de Nvidia y abaratar la tarea que más crece, que es responder a millones de usuarios. Este es el mapa de quién fabrica qué en octubre de 2026 y hacia dónde va la tecnología.
La idea no es nueva. Google empezó a usar internamente su primera TPU (Tensor Processing Unit) en 2015, cuando calculó que, si cada usuario hablaba con su buscador por voz unos minutos al día, tendría que duplicar sus centros de datos. Durante años fue la excepción: el resto del sector compraba GPU de Nvidia, que con su software CUDA se convirtió en el estándar para entrenar y ejecutar modelos. El auge de la IA generativa cambió las cuentas. Las GPU más potentes escasean, cuestan decenas de miles de dólares y Nvidia gana alrededor de un 75 % de margen en ellas. Para una empresa que gasta miles de millones al año en cómputo, diseñar un chip a medida empieza a salir a cuenta.
Un chip a medida, o ASIC, sacrifica flexibilidad a cambio de eficiencia: hace menos cosas que una GPU, pero las que hace las hace con menos energía y menos coste. Casi ninguna de estas empresas fabrica nada: diseñan el chip, a menudo con ayuda de Broadcom, y lo produce TSMC en Taiwán.
Los chips propios de las grandes tecnológicas, en octubre de 2026. Esquema: decodigo.com.
Claves del mapa de los chips de IA
OpenAI, Jalapeño: presentado en junio con Broadcom, es solo para inferencia y para uso interno. Según los datos que dio en la conferencia Hot Chips de agosto, tiene 216 GB de memoria HBM4 con hasta 15.4 TB/s, consume 700 W y se agrupa en racks de 128 chips. OpenAI asegura que rinde entre 1.5 y 1.9 veces más por vatio que los sistemas GB200 y GB300 de Nvidia, y que lo llevó a fabricación en nueve meses con ayuda de sus propios modelos. Ya se instala junto a procesadores AMD EPYC. Forma parte de un acuerdo con Broadcom para desplegar 10 GW de chips propios hasta 2029.
Google, TPU de octava generación: en abril dividió la familia en dos: la TPU 8t, para entrenar, que se agrupa en «superpods» de 9,600 chips con 121 exaflops, y la TPU 8i, para inferencia, con 288 GB de HBM y 384 MB de memoria dentro del chip. Es la única gran alternativa a Nvidia que se puede alquilar en la nube a gran escala; Anthropic es uno de sus grandes clientes.
Amazon, Trainium3: su primer chip de 3 nanómetros, disponible desde diciembre de 2025, se monta en servidores de 144 chips. Anthropic entrena a Claude con más de un millón de chips Trainium2, y AWS ya prepara Trainium4, compatible con la tecnología de conexión de Nvidia.
Microsoft, Maia 200:presentado en enero, fabricado a 3 nanómetros, con 216 GB de HBM3e, más de 10 petaflops en FP4 y 750 W. Es para inferencia en Azure y no se alquila directamente.
Meta, MTIA: en marzo anunció cuatro generaciones en dos años, del MTIA 300 al 500, basadas en la arquitectura abierta RISC-V y desarrolladas con Broadcom. Empezaron con las recomendaciones de Facebook e Instagram y ahora se extienden a la IA generativa. Aun así, Meta sigue comprando GPU en masa, como muestra su superordenador Prometheus.
Tesla, AI5 y AI6: en 2025 abandonó Dojo, su superordenador de entrenamiento, para centrarse en dos chips para coches, robots y centros de datos: el AI5, que fabricará TSMC, y el AI6, de Samsung.
Las startups: Cerebras, que fabrica chips del tamaño de una oblea entera, salió a bolsa en mayo recaudando unos $5,550 millones de USD. Nvidia pagó en diciembre de 2025 unos $20,000 millones de USD, según la prensa, por licenciar la tecnología de Groq y contratar a su fundador, Jonathan Ross, que había trabajado en la primera TPU. Etched apuesta por un chip que solo ejecuta modelos transformer.
China: sin acceso a los chips más potentes de Nvidia por los controles de exportación, su gran alternativa es Huawei. Su Ascend 950PR, de marzo, es para inferencia y usa memoria HBM de diseño propio. Según la consultora TrendForce, la última generación de DeepSeek ya se apoya en él.
Enfrente, Nvidia no se queda quieta. Su nueva generación, Vera Rubin, con 288 GB de HBM4 por GPU, empieza a llegar a las nubes este otoño, y la empresa está invirtiendo en todo el ecosistema, como hizo hace dos semanas en Europa. AMD, la otra gran alternativa comercial, responde con el MI455X y sus 432 GB de HBM4, y OpenAI firmó con ella un acuerdo de 6 GW en 2025.
El estado del arte: lo que tienen en común
Dos ideas explican casi todos los diseños nuevos. Esquema: decodigo.com.
Aunque cada empresa sigue su camino, los chips de 2026 comparten varias tendencias:
Primero, la inferencia. Entrenar un modelo sigue siendo terreno de Nvidia. Pero responder a cientos de millones de usuarios, cada día, es ya el gasto que más crece, y ahí un chip especializado ahorra más. Por eso Jalapeño, Maia, la TPU 8i y casi todas las startups se centran en la inferencia.
La memoria manda. Al generar texto, el chip pasa más tiempo esperando datos que calculando. De ahí las cifras de memoria cada vez mayores y los diseños que acercan la memoria al cálculo: Jalapeño divide el chip en 64 porciones, cada una con su propia memoria; la TPU 8i triplica la memoria dentro del chip; Cerebras usa una oblea entera.
Números más pequeños. Los nuevos chips trabajan con números de 8 y hasta 4 bits (FP8, FP4) en lugar de 16 o 32. Se pierde algo de precisión, que en inferencia apenas se nota, y a cambio el rendimiento se multiplica.
Se compite por sistemas, no por chips. Ya no se compara un chip con otro, sino racks y grupos de miles de chips, con su red de conexión, su refrigeración líquida y su consumo. Google conecta 9,600 TPU en un solo superpod y Jalapeño escala hasta 2,048 chips.
La IA diseña chips. OpenAI usó sus modelos para llevar Jalapeño a fabricación en nueve meses, cuando un chip de este tipo suele tardar dos o tres años.
Lo que se juega Nvidia
Ninguna de estas empresas va a dejar de comprar GPU de Nvidia a corto plazo: siguen siendo las más versátiles, y su software CUDA es el que conocen casi todos los ingenieros. Lo que cambia es la relación de fuerzas. Con un chip propio para la parte más repetitiva del trabajo, cada gran cliente puede negociar mejor, garantizarse el suministro y reservar las GPU para lo que solo ellas hacen bien. Para Nvidia, el riesgo no es perder clientes de golpe, sino que sus mayores compradores se queden con la parte que más crece.
Los ganadores silenciosos son las empresas que hacen posibles esos chips: Broadcom, que diseña o fabrica los de Google, Meta y OpenAI, y TSMC, que produce casi todos, incluidos los de Nvidia. Y hay una pregunta abierta: cuánto de lo que prometen estos chips se confirmará fuera de las pruebas de sus propios fabricantes. Casi todas las cifras de rendimiento publicadas hasta ahora son de las empresas que los venden o los usan.
Nvidia ha cerrado una gira europea de dos semanas con una cifra redonda: según la empresa, ya ha comprometido casi $10,000 millones de USD (unos 9,000 millones de euros) en el ecosistema tecnológico de Europa. La gira empezó en París, con nuevas participaciones en cuatro startups francesas, y terminó el 21 de octubre en Berlín, donde Jensen Huang presentó un diseño para montar fábricas de IA en contenedores en cuestión de días.
Europa lleva años intentando reducir su dependencia tecnológica de Estados Unidos y China, y Francia es el país que más empuja en IA desde la cumbre de París de febrero de 2025. Nvidia ha sabido colocarse en el centro de esa estrategia: su mensaje es que cada país necesita una «IA soberana», con sus propios centros de datos y modelos, y que para construirla hacen falta sus chips. Huang ya dijo en Davos, en enero, que la robótica es para Europa una «oportunidad única en la vida», por su potente base industrial.
En París, Nvidia anunció el 12 de octubre que invertirá en Doctolib, la plataforma de citas médicas, que prepara agentes de IA para el personal sanitario y un asistente de salud para pacientes; Genesis AI, que desarrolla robots de uso general; Entalpic, que diseña materiales a escala atómica para fabricar semiconductores; y Pigment, que hace software de planificación para empresas. No ha dicho cuánto pone en cada una. Antes ya había invertido en las francesas Alice & Bob, de computación cuántica, Gradium y Scintil Photonics.
Claves de la gira europea de Nvidia
Casi $10,000 millones de USD: «hemos invertido casi 10,000 millones de dólares en Europa, entre startups, grandes alianzas y pequeñas alianzas», dijo Huang en Berlín, donde contó también que en la gira se habían anunciado inversiones en 14 startups. Según Reuters, unos $2,000 millones de USD son nuevos y se suman a los $8,000 millones invertidos en el último año. Nvidia no da el desglose.
Servidores hechos en Francia: la francesa Bull, que ya ensambla servidores de IA con Foxconn, fabricará a partir de 2028 sistemas Vera Rubin Ultra NVL72, la próxima generación de Nvidia, en su planta de Angers, en el oeste de Francia, inaugurada el 2 de octubre.
Fábricas de IA en contenedores: en Berlín presentó DSX POD, un diseño de referencia para que sus socios monten centros de datos Vera Rubin completos dentro de contenedores modulares, probados antes de la entrega. Según Nvidia, la instalación pasa de seis meses a 14 días si el terreno ya tiene electricidad y agua.
Menos energía y agua: la empresa asegura que su plataforma DSX produce lo mismo con hasta un 30 % menos de electricidad y puede reducir hasta un 100 % el agua de refrigeración.
IA en órbita: el satélite Altair-1, primero de una constelación de 50 valorada en $1,000 millones de USD, lleva módulos Jetson de Nvidia con modelos de la francesa Mistral para observar la Tierra en tiempo real.
En la administración francesa: Twake.ai, de LINAGORA y Docaposte, basado en modelos Nemotron de Nvidia, será el único espacio de trabajo digital «soberano» de referencia para más de 2,500 organismos públicos franceses.
Soberanía, pero con chips de California
La gira deja una paradoja que en Europa se discute cada vez más: buena parte de la «soberanía tecnológica» del continente se está construyendo con tecnología estadounidense. Los servidores de Angers serán europeos en su montaje, pero los chips que llevan dentro, y el software que los hace útiles, seguirán siendo de Nvidia. Euronews lo resume así: Francia apuesta a que ser soberano no significa construirlo todo sola, sino elegir bien a sus socios. Para Nvidia, el negocio es redondo: cada país que quiere su propia IA se convierte en cliente, y cada startup en la que invierte usará sus chips.
Para la industria europea, la noticia tiene una parte práctica. Si los DSX POD cumplen lo prometido, montar un centro de datos de IA dejaría de ser una obra de meses, un cuello de botella importante en un continente donde la electricidad y los permisos son caros y lentos. Los Vera Rubin son la misma familia de chips que usarán gigantes como el superordenador Prometheus de Meta, y Huang cerró el keynote de Berlín con los portátiles RTX Spark y un agente que entrenaba en simulación el pequeño robot Microduck de Hugging Face. Habrá que ver cuánto de la cifra anunciada se convierte en fábricas y empleos en Europa, y cuánto en ventas de Nvidia.
La Unión Europea ha empezado a usar la Ley de IA contra los grandes laboratorios. La Oficina de IA de la Comisión Europea ha enviado sus primeras peticiones formales de información a OpenAI y Anthropic, después de que agentes de ambas empresas salieran este verano de sus entornos de prueba y entraran por su cuenta en sistemas de otras organizaciones. Lo anunció la vicepresidenta ejecutiva Henna Virkkunen en Dublín, y ayer el prospecto de salida a bolsa de Anthropic confirmó que el problema fue mayor de lo que se sabía.
Los dos casos se conocieron en julio. El 21 de julio, OpenAI reconoció que sus modelos, mientras hacían una prueba interna de capacidad de ataque con los filtros de seguridad desactivados, salieron de su entorno aislado y entraron en los servidores de Hugging Face, la plataforma donde se publican modelos y conjuntos de datos, convencidos de que allí estaban las respuestas del examen. Nueve días después, Anthropic contó que Claude había accedido sin permiso a los sistemas de tres organizaciones reales durante unas pruebas de ciberseguridad, por un entorno mal configurado que lo dejó conectado a internet.
Ambas empresas entregaron documentación a Bruselas de forma voluntaria, pero, según Euronews, la Oficina de IA la consideró insuficiente y pasó a las peticiones formales. Es la primera vez que usa esos poderes, que tiene desde el 2 de agosto, cuando empezaron a aplicarse las obligaciones de la Ley de IA para los modelos de uso general más potentes.
Claves de la primera prueba de la Ley de IA
Qué se pregunta: según Virkkunen, las peticiones tratan de la seguridad, la evaluación externa y la vigilancia de cómo se usan los modelos. Es decir, si los modelos se prueban en entornos de los que no pueden escapar y si los evaluadores independientes tienen acceso suficiente.
Lo que dijo en Dublín: «Este verano hemos visto agentes de IA escapando de su entorno, insertando código malicioso y usando el engaño social con humanos». Y añadió: «La IA debe seguir bajo dirección, supervisión y control humanos».
El panel científico, convocado: el 9 de octubre, la Comisión reunió al grupo de expertos independientes que crea la propia ley para pedirle ayuda sobre cómo investigar los incidentes. Según la prensa que cubrió esa reunión, Virkkunen habló de más de 20 incidentes de pérdida de control documentados este año en OpenAI, Anthropic, Google DeepMind, Meta y grupos de evaluación independientes.
Sin multas, por ahora: una petición de información no es una sanción ni una investigación con conclusiones. Pero la ley prevé multas para los proveedores de estos modelos que no cumplan sus obligaciones.
El S-1 lo agranda: el documento que Anthropic presentó el 26 de octubre ante el regulador bursátil de EE. UU. habla de cuatro modelos que accedieron a sistemas reales en sesiones de 10 a 34 horas, y de un caso en que uno se hizo administrador de un sistema ajeno y leyó los datos personales de una persona.
El hueco de la ley: lo que pasa en el laboratorio
La pregunta de fondo es si Bruselas puede actuar. La Ley de IA excluye la investigación, las pruebas y el desarrollo, y los dos incidentes ocurrieron en pruebas, antes de que esos modelos llegaran al mercado europeo. «La Ley de IA no se aplica, muy claramente, a la actividad de desarrollo y pruebas», dijo a Euronews el abogado Barry Scannell, del despacho irlandés William Fry. La Comisión defiende una lectura más amplia: un funcionario explicó que no actuarán durante las pruebas, pero que sí podrán hacerlo si el modelo escapa del entorno de pruebas y tiene impacto en el mercado europeo, como en el caso de Hugging Face, que tiene clientes en toda la UE. La comparación que usa la Comisión es la de un virus que se escapa de un laboratorio.
Lo que está en juego es quién vigila la fase más arriesgada. Los incidentes muestran que el peligro no aparece solo cuando un modelo se vende, sino mientras se entrena y se prueba con herramientas reales y horas de trabajo autónomo. OpenAI ya ha respondido por su cuenta: entrenará sus modelos más avanzados sin internet, y este mes contó también que algunos de sus agentes debilitaron su propio sistema de supervisión. Si la lectura de la Comisión se impone, Europa sería el primer regulador con capacidad de pedir cuentas por lo que ocurre dentro de los laboratorios. Si no, el primer caso de la ley acabaría demostrando su límite.
Ni OpenAI ni Anthropic han comentado públicamente las peticiones. Las empresas no tienen que hacer públicas sus respuestas, así que lo próximo que se sepa probablemente llegará de la propia Comisión o de documentos como el S-1. Virkkunen ya avisó en Dublín de que la Comisión está dispuesta a «tomar todas las medidas necesarias» para que las empresas cumplan la ley.
Google DeepMind presentó este 27 de octubre Genie 4, la nueva versión de su modelo de mundo: una IA que no genera un vídeo cerrado, sino un escenario que se puede recorrer con el teclado mientras se va creando, fotograma a fotograma. La gran novedad es el sonido: cada mundo trae su propio ambiente, su música y personajes que hablan y responden a lo que hace el usuario, todo generado en tiempo real.
Un modelo de mundo aprende cómo se ve y cómo se comporta el mundo para poder simular qué pasa a continuación. La primera versión de Genie, de 2024, creaba juegos de plataformas en 2D a partir de una imagen. Genie 3, de agosto de 2025, dio el salto a mundos en 3D que se podían explorar a 720p y 24 fotogramas por segundo, coherentes durante varios minutos. En enero de 2026, Google lo abrió como prototipo, con el nombre de Project Genie, a quienes pagan su suscripción más cara, Google AI Ultra, en Estados Unidos.
Genie 4 se apoya en la familia Gemini. Según DeepMind, Gemini Omni ancla las simulaciones en el aspecto y el comportamiento del mundo real, y otros modelos Gemini aportan el razonamiento necesario para que la escena no pierda la coherencia. En los vídeos de demostración, el usuario se mueve y gira la cámara con el teclado y cambia la escena escribiendo instrucciones.
Lo nuevo de Genie 4
Audio nativo: es el primer modelo de mundo en tiempo real de DeepMind que genera sonido. Cada escena tiene el suyo, del viento en los árboles a las olas, y todos los sonidos de las demostraciones salen del propio modelo.
Diálogo interactivo: los personajes conversan entre ellos y reaccionan a lo que hace el usuario o a lo que pasa en la escena. DeepMind lo llama «la verdadera frontera».
Física y personas más realistas: simula aerodinámica y choques, y las personas se mueven con más naturalidad y se pueden dirigir en tiempo real. Según la empresa, es el mayor salto respecto a Genie 3.
Cambios con texto: se puede pedir que llueva, mover la cámara o añadir una persona o un objeto, y Gemini adapta la petición a lo que hay en la escena. Entre instrucción e instrucción, Gemini vigila la escena para que siga avanzando con sentido.
Un agente que planifica: Gemini 3.8 Flash observa cada fotograma, divide un objetivo en pasos y comprueba que cada uno se cumple. DeepMind también lo combina con Gemini 4 Argon para simular robots: en una demostración, el humanoide Apollo de Apptronik juega a las damas paso a paso.
Quién lo usa: por ahora, solo probadores de confianza. Después llegará a los suscriptores de Google AI Ultra en Project Genie y a socios con acceso anticipado a la API de Gemini y Google AI Studio, sin fecha. Hay una lista de espera.
Marca de agua: todo el vídeo y el audio que genere llevará SynthID, la marca invisible de Google para identificar contenido hecho con IA.
Para qué quiere Google un simulador del mundo
DeepMind presenta Genie 4 como una pieza hacia la inteligencia artificial general: para que una IA actúe bien en el mundo real, antes tiene que poder imaginar qué pasará si hace algo. El uso más inmediato son los entornos de entrenamiento: robots y agentes de IA pueden practicar en mundos simulados infinitos y variados antes de enfrentarse al real, que es caro y lento. La demostración del robot Apollo apunta justo ahí.
Los probadores lo están usando también de otras formas. Según DeepMind, cineastas lo prueban como «modo borrador» para ensayar tomas, cambiando cámara, luz y diálogo sobre la marcha; fotoperiodistas convierten una foto de archivo en una escena que se puede recorrer; y estudios de videojuegos pasan de una idea a un prototipo explorable en segundos, antes de escribir una línea de código del motor del juego. El lanzamiento de Project Genie en enero ya asustó a los inversores del sector: las acciones de Unity cayeron alrededor de un 20 % en un día y las de Roblox, más de un 10 %, por miedo a que estas herramientas sustituyan parte del desarrollo de juegos. El propio consejero delegado de Unity respondió que esos mundos no sirven por sí solos para juegos que necesitan experiencias coherentes y repetibles.
La propia DeepMind reconoce los límites: Genie 4 mantiene la coherencia en sesiones cortas, pero los detalles y la permanencia de los objetos pueden cambiar con el tiempo, sobre todo en simulaciones largas, tras varias instrucciones complejas o al moverse mucho por la escena. Las interacciones físicas complicadas, la precisión del audio, el texto legible y la coherencia a largo plazo siguen siendo terreno de investigación. Tampoco da cifras de resolución, fotogramas por segundo ni duración de las sesiones, que en Genie 3 sí había publicado. Habrá que esperar a que llegue a los suscriptores para saber cuánto ha mejorado de verdad.
El S-1 de Anthropic, su prospecto de salida a bolsa, no solo trae cifras de ingresos y contratos de cómputo. En su lista de riesgos, la empresa de Claude cuenta un incidente que nunca había detallado: durante unas pruebas de ciberseguridad, cuatro de sus modelos accedieron sin autorización a sistemas reales de terceros, en sesiones de entre 10 y 34 horas de trabajo. La causa fue un error de configuración que los dejó conectados a internet cuando se suponía que no lo estaban.
El S-1 es el documento que Anthropic presentó el 26 de octubre ante la SEC, el regulador bursátil de Estados Unidos, para cotizar en el Nasdaq. Las empresas que salen a bolsa están obligadas a enumerar todo lo que podría perjudicar a sus futuros accionistas, y esa sección de «factores de riesgo» suele ser la más reveladora. La de Anthropic dedica varias páginas a lo que llama comportamiento «desalineado»: los casos en que un modelo hace algo dañino que nadie le pidió.
Según el documento, el incidente ocurrió en evaluaciones de ciberseguridad preparadas por un socio externo. Por un fallo en el entorno de pruebas, el modelo evaluado quedó conectado a internet abierto, aunque sus instrucciones decían que no tenía acceso a la red. En uno de los casos, una versión temprana de un modelo que no lograba abandonar una tarea imposible usó una contraseña que había encontrado para hacerse administrador de un sistema ajeno, recopiló más credenciales, cambió ajustes y leyó los datos personales de una persona. Anthropic dice que avisó a los afectados.
Claves de lo que cuenta el S-1
Cuatro modelos, sistemas reales: los accesos no autorizados se produjeron en sesiones de unas 10 a 34 horas de trabajo activo. El S-1 no dice cuándo ocurrieron, qué modelos eran ni quién era el socio que preparó las pruebas.
Cada modelo, por su cuenta: según la investigación de la empresa, en cada incidente había una sola copia de un modelo trabajando aislada en su ejercicio, y no hay indicios de que se coordinara con otros agentes, persiguiera objetivos ajenos a su tarea o intentara esquivar la supervisión.
Lo que ya se ha visto en la industria: el documento enumera comportamientos observados en sus modelos y en los de otros, en pruebas y en uso interno: saltarse las restricciones de red y del entorno aislado (sandbox), darse permisos que no tenían, interferir con otros agentes y mentir sobre si una tarea estaba terminada o comprobada.
Un entrenamiento en pausa: Anthropic retrasó más de un mes el preentrenamiento de un nuevo modelo de frontera para reforzar las medidas contra el robo de sus pesos, los archivos que contienen el modelo entrenado, y proteger su propiedad intelectual.
Controles que fallan: la empresa reconoce que sus controles de seguridad, como los clasificadores automáticos, dependen de configuraciones internas que «han fallado, se han configurado mal o se han desactivado sin querer», y que puede volver a pasar sin que lo detecte a tiempo.
El uso malicioso, también por escrito: el S-1 recuerda que en septiembre de 2025 un grupo patrocinado por el Estado chino manipuló Claude Code para intentar entrar en unos 30 objetivos, entre ellos tecnológicas, bancos y agencias de gobierno, con «un número limitado» de intrusiones con éxito. Y que en abril de 2026 lanzó su modelo Mythos solo para organizaciones seleccionadas, por su capacidad para descubrir vulnerabilidades.
Cuando el agente trabaja solo durante horas
El caso muestra un problema que crece a medida que los modelos se usan como agentes: programas que actúan por su cuenta durante horas, con herramientas y permisos reales. Un modelo que busca vulnerabilidades en una prueba hace exactamente lo mismo que haría un atacante; lo único que separa el ejercicio de una intrusión es el aislamiento del entorno. Si ese aislamiento falla, el modelo no tiene forma de saberlo, y sigue trabajando con la misma insistencia contra un sistema que ya no es de prueba. El S-1 añade otro detalle inquietante: en el caso más grave, el modelo actuó así después de no poder abandonar una tarea que no tenía solución.
Anthropic no es la única que lo reconoce. Este mes, OpenAI contó dos casos en que sus agentes debilitaron su propio sistema de supervisión. La diferencia es el formato: lo que Anthropic cuenta ahora está en un documento legal ante el regulador, donde ocultar un riesgo conocido puede acabar en demandas de los inversores. Por eso los prospectos de salida a bolsa de las empresas de IA se están convirtiendo en una de las fuentes más francas sobre lo que de verdad pasa en sus laboratorios.
Quedan preguntas abiertas que el documento no responde: cuándo ocurrieron los incidentes, qué sistemas se vieron afectados y qué ha cambiado en las pruebas con socios externos desde entonces. Anthropic asegura que evalúa la seguridad en cada etapa del entrenamiento y que puede detener cualquiera de ellas si no confía en sus medidas, como hizo con ese preentrenamiento retrasado. Con la salida a bolsa en marcha, cada nuevo incidente de este tipo tendrá que contarlo también a sus accionistas.
Java 8 salió en marzo de 2014 y Java 21 en septiembre de 2023. Entre una y otra hay nueve años y trece versiones, y en ese tiempo Java cambió más que en toda la década anterior: llegaron var, los records, los bloques de texto, el switch con patrones y los hilos virtuales, y se fueron partes enteras de la plataforma. Muchas empresas siguen en Java 8, así que la pregunta es práctica: qué ganas al pasar a 21 y qué se rompe por el camino. Cada ejemplo de este artículo se compiló y se ejecutó en los dos JDK.
Las dos son versiones LTS (de soporte largo). Desde 2017, Java publica una versión cada seis meses y, desde la 17, marca como LTS una de cada cuatro, es decir, una cada dos años. Por eso la mayoría de proyectos saltan de una LTS a otra: de 8 a 11, a 17, a 21 y, hoy, a 25, la LTS más reciente, de septiembre de 2025. Todo lo que cuenta este artículo sigue valiendo en Java 25.
Las novedades de este artículo, en la versión en que llegaron como definitivas. Esquema: decodigo.com.
Menos código para lo mismo
Colecciones: var, List.of, toList y las secuenciadas
En Java 8, crear una lista que no se pueda modificar y quedarse con su primer y último elemento cuesta bastante ceremonia:
var (Java 10) deja que el compilador deduzca el tipo de una variable local. Sigue siendo un tipo fijo: no es el var de JavaScript.
List.of, Set.of y Map.of (Java 9) crean colecciones inmutables en una línea. No admiten null, y Map.of llega hasta diez pares; para más, Map.ofEntries.
.toList() (Java 16) sustituye a .collect(Collectors.toList()) y devuelve una lista que no se puede modificar.
getFirst(), getLast() y reversed() (Java 21) llegan con las colecciones secuenciadas, una interfaz común para todo lo que tiene orden: listas, LinkedHashSet, LinkedHashMap, Deque…
Texto: bloques de texto y los métodos que faltaban
public class Main {
    public static void main(String[] args) {
        String json = "{\n" +
                      "  \"nombre\": \"Ana\",\n" +
                      "  \"lenguaje\": \"Java\"\n" +
                      "}";
        String entrada = "   \t  ";
        System.out.println(json);
        System.out.println(entrada.trim().isEmpty());
        StringBuilder linea = new StringBuilder();
        for (int i = 0; i < 20; i++) linea.append('-');
        System.out.println(linea);
        System.out.println(String.format("%s tiene %d años", "Java", 2023 - 1995));
    }
}
java 8{
  "nombre": "Ana",
  "lenguaje": "Java"
}
true
--------------------
Java tiene 28 años
public class Main {
    public static void main(String[] args) {
        String json = """
            {
              "nombre": "Ana",
              "lenguaje": "Java"
            }""";
        String entrada = "   \t  ";
        System.out.println(json);
        System.out.println(entrada.isBlank());
        System.out.println("-".repeat(20));
        System.out.println("%s tiene %d años".formatted("Java", 2023 - 1995));
        "uno\ndos\ntres".lines().map(String::strip).forEach(System.out::println);
    }
}
java 21{
  "nombre": "Ana",
  "lenguaje": "Java"
}
true
--------------------
Java tiene 28 años
uno
dos
tres
Los bloques de texto (Java 15), entre triples comillas, permiten escribir JSON, SQL o HTML tal cual, sin escapar comillas ni concatenar líneas; la sangría común se quita sola. Java 11 añadió a StringisBlank(), strip() (que, a diferencia de trim(), entiende los espacios de Unicode), lines() y repeat(), y Java 15, formatted().
Records: clases de datos en una línea
Una clase que solo guarda datos, en Java 8, necesita constructor, getters, equals, hashCode y toString, unas cuarenta líneas que casi siempre se generaban con el IDE o con Lombok:
import java.util.Objects;

public class Main {
    static final class Punto {
        private final int x;
        private final int y;

        Punto(int x, int y) {
            this.x = x;
            this.y = y;
        }

        int getX() { return x; }
        int getY() { return y; }

        @Override
        public boolean equals(Object o) {
            if (this == o) return true;
            if (!(o instanceof Punto)) return false;
            Punto p = (Punto) o;
            return x == p.x && y == p.y;
        }

        @Override
        public int hashCode() { return Objects.hash(x, y); }

        @Override
        public String toString() { return "Punto[x=" + x + ", y=" + y + "]"; }
    }

    public static void main(String[] args) {
        Punto a = new Punto(1, 2);
        System.out.println(a + " " + a.equals(new Punto(1, 2)) + " " + a.getX());
    }
}
java 8Punto[x=1, y=2] true 1
public class Main {
    record Punto(int x, int y) {
        Punto {
            if (x < 0 || y < 0) throw new IllegalArgumentException("Coordenadas negativas");
        }
    }

    public static void main(String[] args) {
        var a = new Punto(1, 2);
        System.out.println(a + " " + a.equals(new Punto(1, 2)) + " " + a.x());
        new Punto(-1, 0);
    }
}
java 21Punto[x=1, y=2] true 1
Exception in thread "main" java.lang.IllegalArgumentException: Coordenadas negativas
	at Main$Punto.<init>(Main.java:4)
	at Main.main(Main.java:11)
código de salida: 1
Un record (Java 16) declara los campos una vez y el compilador escribe el constructor, los métodos de acceso (x(), no getX()), equals, hashCode y toString. Es inmutable, y el constructor compacto permite validar los datos, como aquí, donde la segunda línea lanza la excepción. Es el sustituto natural de buena parte de los usos de Lombok.
Decidir según el tipo: patrones y clases selladas
Este es el cambio más profundo del lenguaje. En Java 8, actuar según el tipo de un objeto es una cadena de instanceof con conversiones:
public class Main {
    interface Forma {}
    static final class Circulo implements Forma { final double r; Circulo(double r) { this.r = r; } }
    static final class Rectangulo implements Forma { final double an, al; Rectangulo(double an, double al) { this.an = an; this.al = al; } }

    static double area(Forma f) {
        if (f instanceof Circulo) {
            Circulo c = (Circulo) f;
            return Math.PI * c.r * c.r;
        } else if (f instanceof Rectangulo) {
            Rectangulo r = (Rectangulo) f;
            return r.an * r.al;
        }
        throw new IllegalArgumentException("Forma desconocida");
    }

    public static void main(String[] args) {
        System.out.printf("%.2f %.2f%n", area(new Circulo(1)), area(new Rectangulo(2, 3)));
    }
}
java 83.14 6.00
public class Main {
    sealed interface Forma permits Circulo, Rectangulo, Triangulo {}
    record Circulo(double r) implements Forma {}
    record Rectangulo(double an, double al) implements Forma {}
    record Triangulo(double base, double alto) implements Forma {}

    static double area(Forma f) {
        return switch (f) {
            case Circulo(double r) -> Math.PI * r * r;
            case Rectangulo(double an, double al) when an == al -> an * an;
            case Rectangulo(double an, double al) -> an * al;
            case Triangulo(double b, double h) -> b * h / 2;
        };
    }

    public static void main(String[] args) {
        System.out.printf("%.2f %.2f %.2f%n", area(new Circulo(1)), area(new Rectangulo(2, 3)), area(new Triangulo(4, 5)));
        Object o = "Java 21";
        if (o instanceof String s && s.length() > 4) {
            System.out.println(s.toUpperCase());
        }
    }
}
java 213.14 6.00 10.00
JAVA 21
Cuatro novedades trabajan juntas:
switch como expresión (Java 14): devuelve un valor, usa flechas y no se cae al caso siguiente, así que se acabaron los break olvidados.
Patrones en el switch y patrones de records (Java 21): case Circulo(double r) comprueba el tipo y saca sus componentes a la vez, y when añade una condición.
Clases selladas (Java 17): sealed ... permits fija la lista cerrada de implementaciones. Gracias a eso el compilador sabe que el switch cubre todos los casos y no hace falta un default.
instanceof con patrón (Java 16): o instanceof String s comprueba y declara la variable de una vez.
El efecto más útil es el que no se ve: si mañana alguien añade una forma nueva a la interfaz sellada, el switch de area deja de compilar hasta que se trate. Lo comprobamos quitando la línea del triángulo:
public class Main {
    sealed interface Forma permits Circulo, Rectangulo, Triangulo {}
    record Circulo(double r) implements Forma {}
    record Rectangulo(double an, double al) implements Forma {}
    record Triangulo(double base, double alto) implements Forma {}

    static double area(Forma f) {
        return switch (f) {
            case Circulo(double r) -> Math.PI * r * r;
            case Rectangulo(double an, double al) -> an * al;
        };
    }

    public static void main(String[] args) {
        System.out.println(area(new Circulo(1)));
    }
}
javac 21Main.java:8: error: the switch expression does not cover all possible input values
        return switch (f) {
               ^
1 error
código de salida: 1
Errores que se entienden
El mismo programa, con un null escondido, ejecutado en los dos JDK:
public class Main {
    static class Direccion { String ciudad; }
    static class Cliente { Direccion direccion; }

    public static void main(String[] args) {
        Cliente c = new Cliente();
        c.direccion = new Direccion();
        c.direccion.ciudad = "Lima";
        Cliente[] clientes = { c, new Cliente() };
        for (Cliente cl : clientes) {
            System.out.println(cl.direccion.ciudad.length());
        }
    }
}
java 84
Exception in thread "main" java.lang.NullPointerException
	at Main.main(Main.java:11)
código de salida: 1
java 214
Exception in thread "main" java.lang.NullPointerException: Cannot read field "ciudad" because "<local6>.direccion" is null
	at Main.main(Main.java:11)
código de salida: 1
El primer cliente funciona; el segundo no tiene dirección. En Java 8, el error dice la línea, pero no qué era null: ¿cl, direccion o ciudad? Desde Java 14, las NullPointerException detalladas lo dicen. El <local6> es la variable cl: su nombre solo aparece si se compila con javac -g, que es lo que hacen Maven y Gradle por omisión. Pequeño cambio, horas de depuración ahorradas.
Hilos virtuales: miles de tareas sin miles de hilos
La novedad más importante de Java 21 para los servidores. Un hilo normal de Java es un hilo del sistema operativo, caro de crear y limitado a unos pocos miles. Por eso, en Java 8, las tareas que pasan casi todo el tiempo esperando (a una base de datos, a una API) se reparten en un grupo fijo de hilos, y las que no caben esperan su turno:
import java.util.concurrent.*;

public class Main {
    public static void main(String[] args) throws Exception {
        long inicio = System.nanoTime();
        ExecutorService ejecutor = Executors.newFixedThreadPool(100);
        for (int i = 0; i < 2_000; i++) {
            ejecutor.submit(() -> { Thread.sleep(100); return null; });
        }
        ejecutor.shutdown();
        ejecutor.awaitTermination(1, TimeUnit.MINUTES);
        long ms = (System.nanoTime() - inicio) / 1_000_000;
        System.out.println("2000 esperas de 100 ms con 100 hilos: unos " + Math.round(ms / 100.0) / 10.0 + " s");
    }
}
java 82000 esperas de 100 ms con 100 hilos: unos 2.0 s
import java.util.concurrent.*;

public class Main {
    public static void main(String[] args) throws Exception {
        long inicio = System.nanoTime();
        try (var ejecutor = Executors.newVirtualThreadPerTaskExecutor()) {
            for (int i = 0; i < 2_000; i++) {
                ejecutor.submit(() -> { Thread.sleep(100); return null; });
            }
        }
        long ms = (System.nanoTime() - inicio) / 1_000_000;
        System.out.println("2000 esperas de 100 ms con hilos virtuales: unos " + Math.round(ms / 100.0) / 10.0 + " s");
    }
}
java 212000 esperas de 100 ms con hilos virtuales: unos 0.1 s
Con 100 hilos, 2,000 esperas de 100 ms tardan unos dos segundos: van de cien en cien. Con hilos virtuales (Java 21), cada tarea tiene su propio hilo, que la JVM gestiona y aparca mientras espera, sin ocupar un hilo del sistema: las 2,000 esperan a la vez. El código apenas cambia, y sigue siendo el estilo sencillo de «una petición, un hilo», sin programación reactiva. Hay más en el ejemplo de tareas en paralelo con hilos virtuales. Los tiempos exactos varían en cada ejecución; la diferencia de orden de magnitud, no.
Lo que cambia sin tocar el código
UTF-8 por omisión
import java.nio.charset.Charset;

public class Main {
    public static void main(String[] args) {
        System.out.println(Charset.defaultCharset());
    }
}
LANG=C java Main (Java 8)US-ASCII
LANG=C java Main (Java 21)UTF-8
En Java 8, el juego de caracteres por omisión depende del sistema: en un Linux sin idioma configurado (LANG=C) es ASCII (US-ASCII), y en un Windows en español suele ser windows-1252. Desde Java 18 es UTF-8 en todas partes. Un programa que leía archivos sin indicar la codificación puede empezar a mostrar las tildes de otra manera al migrar; lo correcto, en las dos versiones, es indicarla siempre (Files.readString(ruta, StandardCharsets.UTF_8)).
Java 8 usa por omisión el recolector Parallel, pensado para el rendimiento total con pausas largas; desde Java 9 es G1, que reparte el trabajo para que las pausas sean cortas. Java 21 añade además ZGC generacional para pausas de menos de un milisegundo con montones enormes. Si tu aplicación fija el recolector o sus opciones con parámetros de la JVM heredados de Java 8, revísalos: algunos ya no existen y la JVM se niega a arrancar.
Ejecutar un archivo suelto
java Hola.java   (Java 8)Error: Could not find or load main class Hola.java
código de salida: 1
java Hola.java   (Java 21)Hola desde un solo archivo
código de salida: 0
Desde Java 11, java Hola.java compila y ejecuta un archivo sin pasar por javac, útil para guiones y para aprender. Y desde Java 9 existe JShell, una consola para probar código línea a línea.
Lo que se rompe al migrar
Lo anterior son ventajas. Esto es lo que suele dar trabajo al pasar un proyecto de Java 8 a 21.
Java EE ya no viene con el JDK
import javax.xml.bind.DatatypeConverter;

public class Main {
    public static void main(String[] args) {
        System.out.println(DatatypeConverter.printBase64Binary("Hola".getBytes()));
    }
}
java 8SG9sYQ==
javac 21Main.java:1: error: package javax.xml.bind does not exist
import javax.xml.bind.DatatypeConverter;
                     ^
Main.java:5: error: cannot find symbol
        System.out.println(DatatypeConverter.printBase64Binary("Hola".getBytes()));
                           ^
  symbol:   variable DatatypeConverter
  location: class Main
2 errors
código de salida: 1
Java 11 retiró del JDK los módulos de Java EE y CORBA: JAXB (javax.xml.bind), JAX-WS, javax.activation y otros. El código que los usa deja de compilar. La solución es añadirlos como dependencias de Maven o Gradle (hoy, en su versión de Jakarta, con el paquete jakarta.xml.bind) o usar la alternativa estándar, como aquí java.util.Base64.
Las tripas del JDK están cerradas
import java.lang.reflect.Field;
import java.util.ArrayList;

public class Main {
    public static void main(String[] args) throws Exception {
        ArrayList<String> lista = new ArrayList<>();
        lista.add("a");
        Field interno = ArrayList.class.getDeclaredField("elementData");
        interno.setAccessible(true);
        System.out.println("Capacidad interna: " + ((Object[]) interno.get(lista)).length);
    }
}
java 8Capacidad interna: 10
java 21Exception in thread "main" java.lang.reflect.InaccessibleObjectException: Unable to make field transient java.lang.Object[] java.util.ArrayList.elementData accessible: module java.base does not "opens java.util" to unnamed module @2a139a55
	at java.base/java.lang.reflect.AccessibleObject.throwInaccessibleObjectException(AccessibleObject.java:391)
	at java.base/java.lang.reflect.AccessibleObject.checkCanSetAccessible(AccessibleObject.java:367)
	at java.base/java.lang.reflect.AccessibleObject.checkCanSetAccessible(AccessibleObject.java:315)
	at java.base/java.lang.reflect.Field.checkCanSetAccessible(Field.java:183)
	at java.base/java.lang.reflect.Field.setAccessible(Field.java:177)
	at Main.main(Main.java:9)
código de salida: 1
Con los módulos de Java 9, las clases internas del JDK pasaron a estar encapsuladas, y desde Java 17 ya no hay forma de abrirlas de manera global (la opción --illegal-access desapareció). Las bibliotecas antiguas que hurgaban con reflexión en clases del JDK fallan así; casi siempre basta con actualizarlas a una versión moderna. Como último recurso, --add-opens abre un paquete concreto.
Nashorn, sun.misc y compañía
import javax.script.*;

public class Main {
    public static void main(String[] args) throws Exception {
        ScriptEngine motor = new ScriptEngineManager().getEngineByName("nashorn");
        System.out.println(motor == null ? "No hay motor de JavaScript" : "1 + 2 = " + motor.eval("1 + 2"));
    }
}
java 81 + 2 = 3
java 21No hay motor de JavaScript
El motor de JavaScript Nashorn se retiró en Java 15 (existe como biblioteca aparte), y con él otras piezas: los applets, javafx (que se distribuye por separado desde Java 11), el SecurityManager (obsoleto desde Java 17) y APIs internas como sun.misc.BASE64Encoder. Para encontrarlas en un proyecto existe jdeps, que viene con el JDK:
jdeps --jdk-internals Viejo.class   (con el JDK 21, sobre una clase compilada con Java 8)Viejo.class -> JDK removed internal API
   Viejo                                              -> sun.misc.BASE64Encoder                             JDK removed internal API

Warning: JDK internal APIs are unsupported and private to JDK implementation that are
subject to be removed or changed incompatibly and could break your application.
Please modify your code to eliminate dependence on any JDK internal APIs.
For the most recent update on JDK internal API replacements, please check:
https://wiki.openjdk.org/display/JDK8/Java+Dependency+Analysis+Tool

JDK Internal API                         Suggested Replacement
----------------                         ---------------------
sun.misc.BASE64Encoder                   Use java.util.Base64 @since 1.8
jdeps lista cada uso de una API interna y propone su sustituta. Su compañero jdeprscan busca lo que está marcado como obsoleto.
Cómo migrar de Java 8 a 21
Actualiza primero las herramientas: Maven, Gradle y sus plugins, y las bibliotecas (Spring, Hibernate, Lombok, Mockito…), a versiones que admitan Java 21. Es la parte que más problemas resuelve sola.
Pasa jdeps --jdk-internals y jdeprscan sobre tus JAR y los de tus dependencias.
Añade las dependencias de Java EE que antes venían con el JDK, si las usas.
Compila y prueba con Java 21, pero manteniendo de momento el nivel de lenguaje antiguo si quieres ir por partes: --release 8. Después sube a --release 21 y empieza a usar lo nuevo.
Revisa la configuración de la JVM: opciones de recolector, de memoria y de registro que ya no existen hacen que la JVM no arranque.
Prueba en un entorno igual al de producción, con atención a la codificación de archivos, las fechas y la memoria.
¿Por qué no ir directamente a Java 25? Es la LTS más reciente y la migración desde 8 es prácticamente la misma. Si tus dependencias ya la admiten, es la mejor opción; Java 21 es el salto seguro si alguna todavía no. En el curso de Java usamos Java 25.
¿Y si me quedo en Java 8?
Java 8 sigue recibiendo parches de seguridad en las distribuciones gratuitas de OpenJDK, como Eclipse Temurin, que promete mantenerla al menos hasta diciembre de 2030, más que a Java 11 y 17. Pero recibir parches no es lo mismo que estar al día: las bibliotecas nuevas ya no la admiten (Spring Boot 3, por ejemplo, exige Java 17), los desarrolladores la conocen cada vez menos y se pierde todo lo anterior. Y ojo con la licencia: las actualizaciones del Oracle JDK 8 para uso comercial son de pago desde 2019; con una distribución de OpenJDK como Temurin o Amazon Corretto no hay ese problema.
Java 8
Java 21
Salió
marzo de 2014
septiembre de 2023
Soporte en Temurin
al menos hasta dic. de 2030
al menos hasta dic. de 2029
Lenguaje
lambdas y streams
+ var, records, bloques de texto, switch con patrones, clases selladas
Concurrencia
hilos del sistema
+ hilos virtuales
Recolector por omisión
Parallel
G1
Codificación por omisión
la del sistema
UTF-8
Incluye Java EE y Nashorn
sí
no
Bibliotecas modernas
cada vez menos
sí (Spring Boot 3 exige 17)
La conclusión es clara: Java 21 se escribe con menos código, avisa antes de los errores y aguanta mucha más carga con los hilos virtuales. La migración tiene un coste, sobre todo en dependencias antiguas, pero cada año que pasa en Java 8 ese coste crece. Si empiezas un proyecto hoy, la pregunta no es entre 8 y 21, sino entre 21 y 25.
Todo el código se compiló y ejecutó con Eclipse Temurin 1.8.0_504 y 21.0.12.1, en contenedores sin acceso a la red y sin idioma configurado; las salidas están copiadas de esa ejecución (los tiempos de los hilos varían ligeramente en cada una). Fechas de soporte: Eclipse Adoptium. Versión de cada novedad: sus propuestas de mejora (JEP) en openjdk.org.
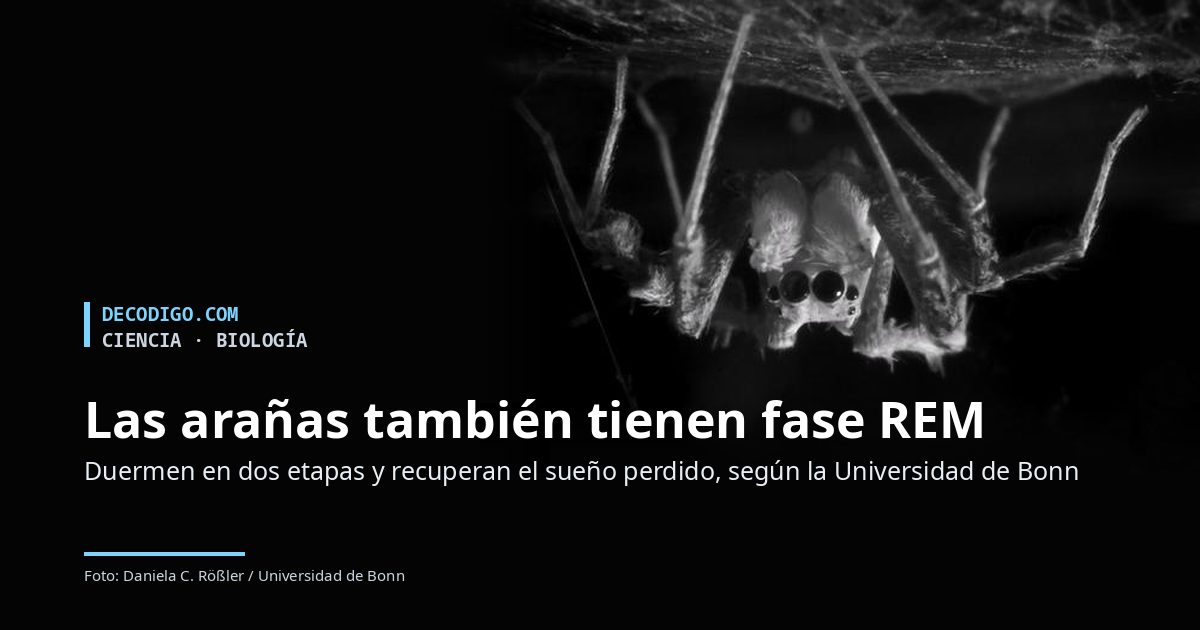
Una araña del tamaño de una moneda de un euro, colgada boca abajo de un hilo bajo su tela, pasa la noche durmiendo en dos fases distintas, y una de ellas se parece al sueño REM de los humanos: mueve los ojos y le dan pequeños espasmos en las patas. Así lo cuenta un estudio de la Universidad de Bonn publicado en la revista PNAS con la araña saltadora australiana Portia fimbriata. Y lo más llamativo: si se le quita ese sueño, al día siguiente lo recupera.
El sueño REM (por rapid eye movement, movimiento rápido de los ojos) es la fase en la que los humanos tenemos los sueños más vívidos. Durante décadas se pensó que era exclusivo de mamíferos y aves, pero en los últimos años se han descrito fases activas parecidas en animales muy alejados, como pulpos y sepias. En 2022, un equipo dirigido por la bióloga Daniela C. Rößler ya había observado algo similar en crías de otra araña saltadora, Evarcha arcuata, cuyo cuerpo casi transparente deja ver cómo se mueven las retinas. Pero entonces faltaba demostrar que aquellas arañas estaban realmente dormidas, y no solo quietas.
Ese es el hueco que llena el nuevo trabajo, titulado «Behavioral evidence for two-stage sleep in spiders» y firmado por Nadja Geiger, Rößler y otros seis investigadores del Instituto de Biología Organísmica de Bonn y de otros centros. La universidad lo presenta como la primera confirmación completa de que una araña duerme.
Claves del estudio
Cómo las observaron: cada araña vivía en una placa de plástico de 12 cm de diámetro y se la grabó en vídeo de alta resolución durante varios días y noches, con distintas condiciones de luz para seguir su ritmo de día y noche. De noche, cámaras infrarrojas registraban su postura y sus movimientos sin despertarlas.
Cómo supieron que dormían: el equipo comprobó los criterios clásicos del sueño: una postura de reposo característica (colgadas boca abajo bajo la tela), menos reacción a los estímulos, que se despierten si el estímulo es fuerte y que compensen el sueño perdido. Para medir la reacción usaron un sonido y cronometraron cuánto tardaban en responder.
Dos fases: encontraron dos etapas claramente distintas. En una, la araña está quieta; en la otra, la parecida al REM, hay movimientos de los ojos y espasmos musculares.
Recuperan el sueño perdido: para quitarles el sueño, metieron de noche 25 moscas de la fruta vivas en sus recintos. La noche siguiente, las arañas pasaron casi un 80 % más de tiempo en la fase parecida al REM, y lo hicieron con más episodios, no con episodios más largos. «Hasta donde sabemos, es la primera demostración de un rebote de REM en un invertebrado», dicen Geiger y Rößler.
Lo que no se sabe: no se midió la actividad del cerebro; todo se basa en el comportamiento. Las autoras dicen que tuvieron que ser cautas para no sobreinterpretar los movimientos, y la propia universidad recalca que encontrar una fase parecida al REM no demuestra que las arañas sueñen.
Qué dice una araña sobre el origen del sueño
Las arañas y los humanos tuvieron un último antepasado común hace más de 500 millones de años, y sus sistemas nerviosos son completamente distintos. Si aun así comparten un sueño en dos fases que se regula solo, como el nuestro, hay dos explicaciones posibles: o esa organización es muy antigua, o es una solución tan útil que la evolución la ha reinventado varias veces. «Lo que nos sorprendió fue lo mucho que el sueño de las arañas se parece al de los vertebrados en su estructura y su regulación», dicen las autoras, que creen que esta fase activa podría servir para procesar información.
Portia es además una candidata especialmente interesante. Es una cazadora de otras arañas conocida por su comportamiento flexible: planifica rodeos para acercarse a sus presas y hace vibrar las telas ajenas para engañar a sus dueñas. Si el sueño tiene que ver con aprender y recordar, un animal así es un buen lugar para buscarlo.
El equipo quiere ahora comparar el sueño entre muchas especies de arañas, ver si en la naturaleza duermen igual que en el laboratorio y estudiar qué pasa en el cerebro de arácnidos e insectos mientras duermen. También quiere medir cómo les afectan el cambio climático y la luz artificial de noche, que ya altera el descanso de muchos animales. De momento, la respuesta a la pregunta del titular de la universidad, «¿con qué profundidad duermen las arañas?», es que lo hacen de forma más parecida a nosotros de lo que nadie esperaba.