El rover Perseverance de la NASA ya es el vehículo que más ha rodado sobre otro mundo. El 11 de octubre, su cuentakilómetros llegó a 45.22 km y superó los 45.16 km que acumuló Opportunity entre 2004 y 2018. Lo ha conseguido en cinco años y medio, cuando a su antecesor le hizo falta casi 15, y la clave es que más del 90 % del camino lo ha conducido solo.
Perseverance aterrizó en el cráter Jezero en febrero de 2021 para buscar rastros de vida antigua en lo que fue un lago, y para recoger muestras de roca que algún día se traigan a la Tierra. Su misión principal preveía conducir como mucho unas 12.4 millas, unos 20 km. Los ha doblado de sobra, y la NASA ya le ha aprobado la primera extensión, que empezó este mes y llegará aproximadamente hasta finales de 2028.
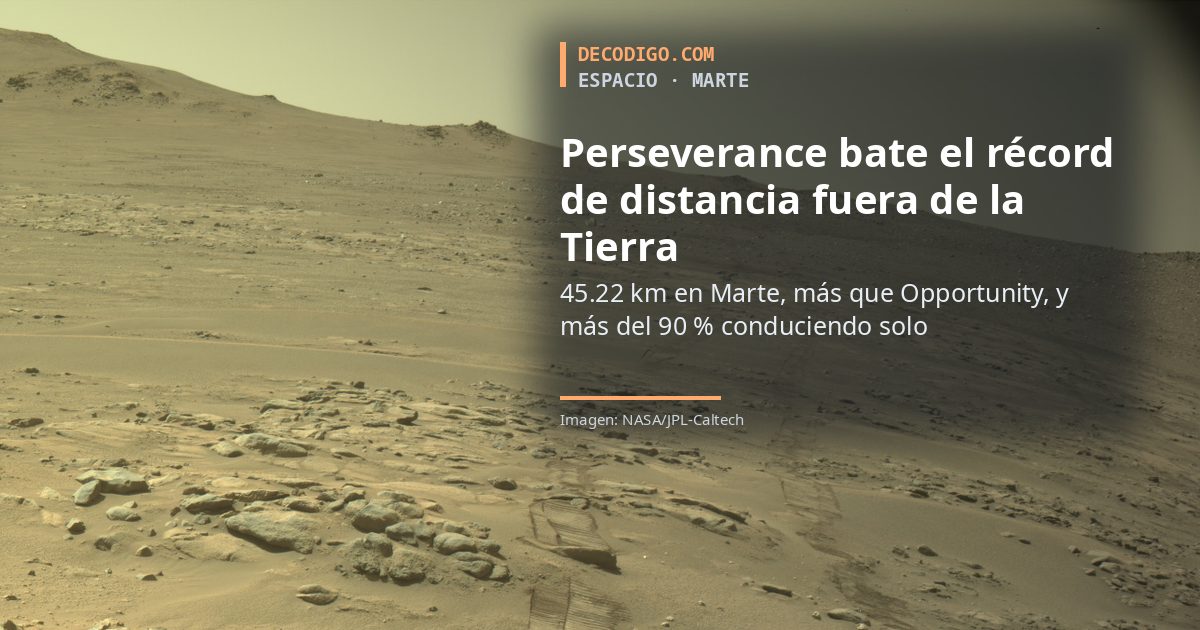
El récord cayó el día marciano, o sol, número 2,006 de la misión, con un trayecto de 91.31 metros. El rover se dirigía a una zona llamada «Idubi», a través de una región al oeste del borde del cráter apodada «Lac de Charmes», donde estudia lo que podría ser uno de los terrenos más antiguos explorados en el sistema solar. Su cámara de navegación fotografió ese día las huellas recién dejadas, la imagen de la portada.
Claves del récord de Perseverance
Conduce pensando: con su sistema de navegación autónoma, AutoNav, el rover fotografía el terreno mientras avanza, construye un mapa en 3D de los obstáculos y decide su ruta entre los puntos de paso que eligen los planificadores desde la Tierra. El equipo lo llama «pensar mientras conduce», y le permite recorrer hasta 412 metros en un solo sol.
Un salto enorme en autonomía: Perseverance ha hecho más del 90 % de su recorrido con AutoNav. Spirit y Opportunity, los primeros rovers con un sistema parecido, solo lo usaron en torno al 5 % del tiempo. Y donde Sojourner, el primer rover marciano, evaluaba el camino con 20 puntos de medida, Perseverance procesa 600,000 en cada vistazo.
Tres décadas de rovers: Sojourner recorrió unos 100 metros en 1997; Spirit, 7.7 km antes de quedar atrapado por el invierno marciano en 2010; Opportunity rodó durante 5,111 soles y completó en 2015 el primer maratón fuera de la Tierra. Curiosity, que sigue activo en el cráter Gale, lleva más de 38 km.
También superó a la Luna: por el camino, Perseverance ya había dejado atrás los 35.7 km que recorrieron en 1972 los astronautas del Apolo 17, Gene Cernan y Harrison Schmitt, con su vehículo lunar, y los 39 km del rover soviético Lunojod 2 en 1973.
Lo que viene en el software: según Mark Maimone, subjefe de operaciones robóticas del rover, el programa más reciente le enseña a girar menos y rodar más, y a comprobar su posición con mapas tomados desde órbita a mitad de trayecto. El siguiente reto es el sol: cuando conduce hacia él, los reflejos en las cámaras lo obligan a aparcar a media tarde.
Más kilómetros, más historia de Marte
El récord es lo de menos, insiste la NASA: lo que importa es lo que permiten tantos kilómetros. Cuanto más y más deprisa avanza, más tipos de roca puede examinar el rover, y más capítulos de la historia del planeta puede leer. Así pasó de un antiguo lecho de lago a un sistema fluvial fosilizado, donde encontró en la roca «Cheyava Falls» una posible biofirma, una señal que podría tener origen biológico, y de ahí al borde del cráter, donde estudia rocas formadas por impactos hace unos 4,000 millones de años, una época de la que en la Tierra casi no queda rastro.
«La misión original preveía no más de 12.4 millas de conducción. Las hemos superado de sobra, y con todos los sistemas de movilidad en perfecto estado esperamos que Perseverance siga ampliando este récord durante muchos años», dice Steven Lee, director de los proyectos de Curiosity y Perseverance en el Laboratorio de Propulsión a Chorro (JPL) de la NASA. Lleva recogidas 29 muestras de roca y suelo, y después de Lac de Charmes seguirá por el borde del cráter hacia el sur, rumbo a «Rainbow Falls», un bloque de corteza antigua de 100 metros de ancho levantado por el impacto que formó Jezero.
Más fuentes: página de la misión Mars 2020 de la NASA. Imagen de portada: la cámara de navegación de Perseverance el 11 de octubre de 2026, el día del récord (PIA26812), NASA/JPL-Caltech.
Un equipo de la Universidad de Bonn ha convertido células de la sangre de personas mayores en células madre neuronales, y por el camino esas células han «rejuvenecido»: las de un donante de 80 años acabaron con una edad biológica estimada de menos de 20. El trabajo, publicado en la revista Aging Cell, no es un tratamiento contra el envejecimiento, pero sí una herramienta nueva para estudiar algo que todavía se entiende mal: cómo se borra la huella que dejan los años en una célula.
Desde hace años se sabe que el ADN de nuestras células acumula marcas químicas con la edad, las metilaciones, y que su patrón es tan regular que permite calcular la edad de una persona con un margen de pocos años. A esa estimación se la llama reloj epigenético. También se sabe que se puede poner a cero: cuando una célula adulta se reprograma en el laboratorio para convertirla en una célula madre pluripotente, capaz de convertirse en casi cualquier tejido, su reloj vuelve a la edad embrionaria en unas tres semanas.
El grupo de Oliver Brüstle, director del Instituto de Neurobiología Reconstructiva del Hospital Universitario de Bonn, sigue otro camino, la conversión directa: transforma células precursoras de la sangre en células madre del sistema nervioso sin pasar por el estado pluripotente. En 2018 ya habían visto que así las células también rejuvenecían, con donantes de 31 a 62 años. Ahora lo han estudiado a fondo, con donantes de hasta 101 años, y lo que más les ha sorprendido es la lentitud del proceso. El artículo salió el 1 de octubre y la universidad lo anunció el 9.
Claves del estudio de Bonn
Cómo lo hicieron: partieron de precursores de los glóbulos rojos, obtenidos de una muestra de sangre normal, y les añadieron dos genes, SOX2 y cMYC, con un virus modificado (de Sendai) que sirve de vehículo. En unos 12 días, las células ya mostraban marcadores de célula madre neuronal. Las líneas que obtuvieron se mantuvieron estables durante hasta seis meses de cultivo y pudieron convertirse en neuronas, astrocitos y oligodendrocitos, los tres tipos de células del cerebro.
Quince donantes, de recién nacidos a 101 años: en todos, las células madre neuronales resultantes tenían, de media, una edad epigenética del 13 % de la edad real del donante poco después de crearse, y de menos del 5 % tras más tiempo en cultivo. Las de la persona de 80 años quedaron por debajo de 20 años, el caso que destaca la universidad.
Un rejuvenecimiento lento: siguiendo día a día a tres donantes de entre 50 y 101 años, vieron que la mayoría de las marcas de la edad tardan unos 50 días en borrarse, frente a las tres semanas de la reprogramación clásica. La universidad lo resume como «tras 50 días, 60 años más jóvenes».
No depende de que las células se dividan: esperaban que el reloj retrocediera porque las células se multiplican, pero siguió atrasándose igual cuando frenaron su división con sustancias químicas o cuando las obligaron a convertirse en neuronas, que ya no se dividen.
Más allá del reloj: en células de donantes de 87 a 101 años no encontraron las señales típicas de las células viejas: ni alteraciones en la envoltura del núcleo, ni fallos en el reciclaje interno de la célula (la autofagia), ni mitocondrias deterioradas, ni marcas de senescencia. En eso se parecían a las células obtenidas por el camino clásico, que se consideran «nuevas».
Un laboratorio para entender el envejecimiento
La importancia del trabajo está justamente en esa lentitud. En la reprogramación clásica, el reloj se pone a cero tan deprisa que es difícil ver qué ocurre entre medias. Aquí el proceso dura semanas y se puede seguir durante más de cien días, así que se puede intervenir y medir qué lo acelera o lo frena. «Los relojes epigenéticos se atrasaron a lo largo de varias semanas, así que podemos estudiar qué factores aceleran o frenan el rejuvenecimiento», explica Brüstle en la nota de la universidad. El artículo apunta a un primer sospechoso: SOX2, el único gen que este método comparte con otro tipo de conversión en el que los autores también encontraron rejuvenecimiento al reanalizar datos publicados.
Hay además un interés práctico. «La edad es el factor de riesgo más importante de las enfermedades neurodegenerativas como el alzhéimer», recuerda Brüstle. Disponer de células del sistema nervioso de una persona concreta, y poder elegir si conservan o no las marcas de su edad, ayudaría a estudiar cómo influye el envejecimiento en esas enfermedades.
Conviene no leer más de lo que dice. Los propios autores advierten de que la edad epigenética «sin duda no recoge la imagen completa» del envejecimiento, sobre todo en lo que se refiere a cómo funciona la célula. Lo que rejuvenece son células en una placa de laboratorio, que además dejan de ser células de la sangre para convertirse en otro tipo de célula; nada de esto se ha probado en personas, y el propio gen cMYC usado en la conversión se ha relacionado con el cáncer. El estudio, financiado por el programa Horizonte 2020 de la UE, la agencia alemana de investigación DFG y el ministerio federal de investigación alemán, es sobre todo una herramienta para entender el envejecimiento, no para revertirlo.
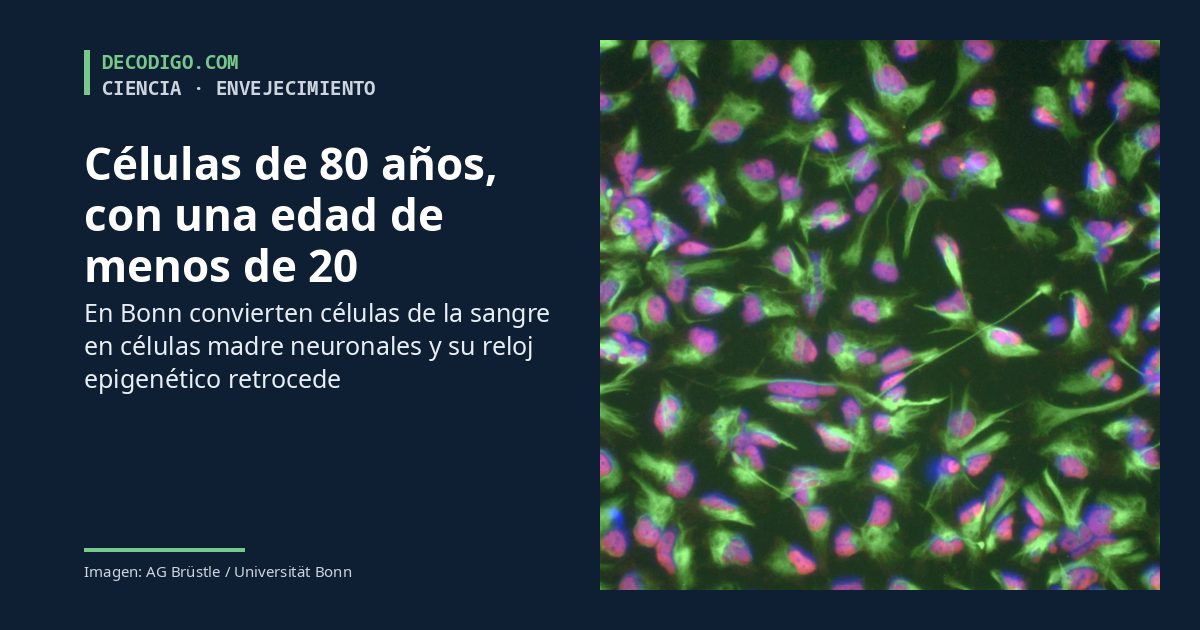
Más fuentes: nota de prensa de la Universidad de Bonn (9 de octubre de 2026, en alemán), de donde son las declaraciones; texto completo del artículo en Europe PMC. Imagen de portada: células madre neuronales obtenidas de la sangre de un donante de 101 años, AG Brüstle / Universität Bonn.
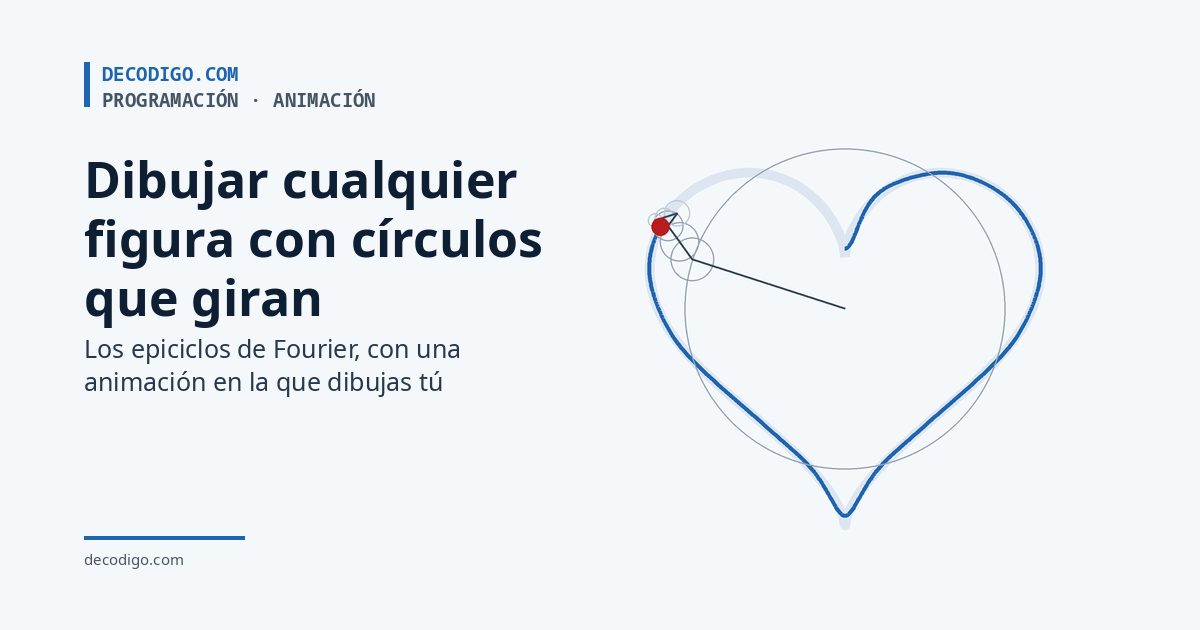
Coge una cadena de círculos, haz que cada uno gire sobre la punta del anterior a su propia velocidad y fíjate en la punta del último: puede dibujar un corazón, una estrella o tu firma. No es un truco de ilustrador, sino una de las ideas más útiles de las matemáticas: la transformada de Fourier, la que dice que cualquier forma (o cualquier sonido) se puede descomponer en movimientos circulares sencillos. Aquí la verás funcionar con tus propios dibujos.
De los planetas a la fórmula de Fourier
La idea de explicar un movimiento complicado con círculos que giran sobre otros círculos tiene más de dos mil años. Los astrónomos griegos, de Apolonio de Perga a Hiparco y, sobre todo, Claudio Ptolomeo, la usaron para explicar por qué los planetas a veces parecen ir hacia atrás en el cielo: cada planeta giraba en un círculo pequeño, el epiciclo, cuyo centro giraba a su vez en uno grande alrededor de la Tierra. El modelo estaba equivocado sobre lo que pasa en el cielo, pero acertaba en algo: con suficientes círculos se puede imitar casi cualquier recorrido.
La explicación de por qué llegó en 1822, cuando Joseph Fourier publicó Théorie analytique de la chaleur. Estudiando cómo se reparte el calor en un objeto, Fourier sostuvo que cualquier función que se repite se puede escribir como una suma de ondas simples, senos y cosenos, de frecuencias cada vez más altas. Un círculo que gira es justo eso, una onda seno en horizontal y otra en vertical a la vez, así que los epiciclos de Ptolomeo eran, sin saberlo, una serie de Fourier.
Un círculo que gira son tres números
Para describir un círculo que gira basta con tres datos: su radio; el ángulo en el que empieza, que se llama fase, y cuántas vueltas da mientras se dibuja la figura una vez, la frecuencia k. Con k = 1 da una vuelta; con k = 2, dos; con k = −1, una vuelta en sentido contrario.
Los matemáticos lo escriben con un solo número complejo, c, cuyo tamaño es el radio y cuyo ángulo es la fase. La posición de la punta en cada instante t, de 0 a 1, es c · e2πikt: la fórmula de Euler convierte esa exponencial en un punto que da k vueltas al círculo. No hace falta dominar los números complejos para seguir el artículo: basta con pensar en cada círculo como una flecha que gira.
A la izquierda, un solo círculo con su radio, su fase y su frecuencia. A la derecha, tres encadenados: cada flecha sale de la punta de la anterior, y la punta de la última dibuja la curva. Esquemas: decodigo.com.
De la figura a los círculos
¿Cómo se saben los círculos que dibujan una figura concreta? Ese es el trabajo de la transformada discreta de Fourier. Los pasos son cuatro:
Se recorre la figura y se toman 256 puntos a la misma distancia unos de otros. Cada punto se trata como un número complejo: la x es la parte real y la y, la imaginaria.
Para cada frecuencia k, de −128 a 127, se calcula ck = (1/256) · Σ zj · e−2πikj/256. Es como hacer girar la figura en sentido contrario k veces y ver qué queda de media: si la figura tiene algo que gira a esa velocidad, sobrevive; si no, se cancela.
Cada ck es un círculo: su radio es el tamaño de ck, su fase es su ángulo y da k vueltas. El de k = 0 no gira: es el centro de la figura, de donde sale la cadena.
Se ordenan de mayor a menor y se encadenan. Con los 255 círculos, la punta pasa exactamente por los 256 puntos; con menos, se queda con lo esencial de la forma.
Lo bonito es que funciona igual para cualquier figura cerrada: no hay que diseñar nada a mano.
Pruébalo
Elige una figura o pulsa «Dibuja la tuya» y traza algo en el recuadro, con el dedo o el ratón, sin levantarlo. Luego mueve el control de «Círculos»: con 1 solo sale un círculo, con 5 aparece la forma general y con 50 el dibujo es casi perfecto. La figura original se ve en gris claro, debajo; la línea azul es lo que llevan dibujado los círculos, y el punto rojo, la punta de la cadena. El error medio que aparece debajo mide cuánto se aleja el dibujo de la figura.
Figura:
Fíjate en la estrella: necesita bastantes más círculos que el corazón para que sus puntas salgan afiladas. Las esquinas son cambios bruscos de dirección, y para hacer un cambio brusco hacen falta círculos que giren muy deprisa. Con un garabato propio pasa lo mismo, y además verás que el punto rojo cruza en línea recta desde el final de tu trazo hasta el principio: la serie de Fourier siempre dibuja una figura cerrada.
Lo que enseña un cuadrado
El cuadrado es el mejor ejemplo para ver qué hace cada círculo. Con uno solo sale el círculo que mejor se le ajusta; con dos ya se adivinan las cuatro esquinas, y con ocho la diferencia apenas se ve:
El cuadrado (gris) y lo que dibujan los círculos más grandes (azul). Calculado con el programa de Python de abajo. Esquemas: decodigo.com.
Este programa hace el cálculo completo en Python, sin bibliotecas: reparte 256 puntos por el borde del cuadrado, calcula sus 256 coeficientes y mide el error al redibujarlo con cada vez más círculos.
"""Epiciclos de Fourier: dibujar un cuadrado con círculos que giran.

Se toman 256 puntos repartidos por el borde del cuadrado, se calcula su transformada
discreta de Fourier y cada coeficiente se convierte en un círculo: su radio es el
módulo del coeficiente, su velocidad, la frecuencia k, y su ángulo inicial, la fase.
"""
import cmath
import math

N = 256


def cuadrado(n):
    """n puntos a la misma distancia unos de otros por el borde de un cuadrado de lado 2."""
    esquinas = [complex(1, 1), complex(-1, 1), complex(-1, -1), complex(1, -1)]
    puntos = []
    for i in range(n):
        s = 4 * i / n                      # recorrido: 0 a 4, un lado por unidad
        lado, f = int(s), s - int(s)
        a, b = esquinas[lado], esquinas[(lado + 1) % 4]
        puntos.append(a + (b - a) * f)
    return puntos


def dft(z):
    """Coeficientes c_k de la serie, con k de -n/2 a n/2 - 1."""
    n = len(z)
    return {k: sum(z[j] * cmath.exp(-2j * math.pi * k * j / n) for j in range(n)) / n
            for k in range(-n // 2, n // 2)}


def epiciclos(c, cuantos, t):
    """Punto que dibujan el centro (k = 0) y los `cuantos` círculos más grandes en el instante t (0 a 1)."""
    orden = sorted((k for k in c if k != 0), key=lambda k: -abs(c[k]))[:cuantos]
    return c[0] + sum(c[k] * cmath.exp(2j * math.pi * k * t) for k in orden)


z = cuadrado(N)
c = dft(z)

print("Los 8 círculos más grandes:")
print("    k   radio    fase   radio × k²")
for k in sorted((k for k in c if k != 0), key=lambda k: -abs(c[k]))[:8]:
    print(f"{k:5d}  {abs(c[k]):.4f}  {math.degrees(cmath.phase(c[k])):5.1f}°   {abs(c[k]) * k * k:.4f}")

print()
print("Error medio al redibujar el cuadrado (lado 2):")
for cuantos in (1, 2, 4, 8, 16, 32, 64, 255):
    error = sum(abs(epiciclos(c, cuantos, j / N) - z[j]) for j in range(N)) / N
    print(f"{cuantos:4d} círculo{'s' if cuantos > 1 else ''}: {error:.4f}")

# ¿Cuántos círculos tienen un radio que no sea prácticamente cero?
print()
print("Círculos que cuentan:", sum(1 for k in c if k != 0 and abs(c[k]) > 1e-9), "de", N - 1)
salidaLos 8 círculos más grandes:
    k   radio    fase   radio × k²
    1  1.1464   45.0°   1.1464
   -3  0.1274   45.0°   1.1468
    5  0.0459   45.0°   1.1478
   -7  0.0235   45.0°   1.1491
    9  0.0142   45.0°   1.1510
  -11  0.0095   45.0°   1.1533
   13  0.0068   45.0°   1.1561
  -15  0.0052   45.0°   1.1594

Error medio al redibujar el cuadrado (lado 2):
   1 círculo: 0.1317
   2 círculos: 0.0500
   4 círculos: 0.0170
   8 círculos: 0.0055
  16 círculos: 0.0017
  32 círculos: 0.0006
  64 círculos: 0.0000
 255 círculos: 0.0000

Círculos que cuentan: 64 de 255
La salida esconde dos sorpresas. La primera: de los 255 círculos posibles, solo 64 tienen un radio que no es cero, los de k = 1, −3, 5, −7, 9…, y por eso con 64 círculos el error ya es nulo. Es consecuencia de la simetría: si giras el cuadrado un cuarto de vuelta, queda igual, y eso anula todas las demás frecuencias. La segunda: el radio de cada círculo es el del primero dividido entre k², como muestra la última columna. En un cuadrado perfecto, el radio vale exactamente 8√2 / (π² · k²), es decir, 1.1463 / k²; con 256 puntos los valores se separan un poco en los círculos más pequeños.
El radio de cada círculo del cuadrado según su frecuencia k. A esta gráfica se la llama el espectro de la figura. Esquema: decodigo.com.
Hemos comprobado que la animación de arriba hace exactamente estas cuentas: en el cuadrado, sus coeficientes coinciden con los del programa en las 16 primeras cifras decimales, y en otras 53 figuras, las de ejemplo y 50 garabatos al azar, coinciden con los de NumPy con una diferencia máxima de menos de una billonésima.
Por qué todo el mundo usa la transformada de Fourier
Dibujar con círculos es la versión visual, pero la misma operación está en todas partes. Un sonido es una onda que se repite, y su transformada de Fourier dice qué frecuencias, qué notas, lo componen: es lo que muestran los ecualizadores y los afinadores. En las imágenes, el formato JPEG usa una prima cercana, la transformada discreta del coseno, para separar en cada bloque de 8 × 8 píxeles los cambios suaves de los detalles finos, y guardar con menos precisión los detalles que el ojo apenas nota.
Todo eso sería lentísimo con el método de este artículo, que hace 256 × 256 = 65,536 multiplicaciones para 256 puntos. En 1965, James Cooley y John Tukey publicaron la transformada rápida de Fourier (FFT), que obtiene el mismo resultado con del orden de N · log₂N operaciones: unas 2,048 para 256 puntos, y para un millón de puntos, unos 20 millones en lugar de un billón. Es la versión que usa NumPy, y una de las razones por las que el audio, las imágenes y las comunicaciones digitales funcionan en tiempo real.
Si te gustan los algoritmos que se entienden mejor viéndolos, tenemos más con animación: el algoritmo de Myers con el que Git encuentra las diferencias entre dos archivos, el juego del caos, que dibuja fractales con puntos al azar, y los boids, que imitan una bandada de pájaros con tres reglas.
Fuentes: J. Fourier, Théorie analytique de la chaleur (París, Didot, 1822); J. W. Cooley y J. W. Tukey, «An algorithm for the machine calculation of complex Fourier series», Mathematics of Computation 19, 297–301 (1965); la norma de JPEG, ITU-T T.81; la historia de los epiciclos, en Wikipedia. La animación de los círculos que dibujan figuras la popularizó 3Blue1Brown en su vídeo «But what is a Fourier series?» (2019). El programa se ejecutó con Python 3.13 y la comparación, con NumPy 2.3.4 y Node.js 24. La animación y las imágenes, incluida la portada, las generan los propios círculos: decodigo.com.
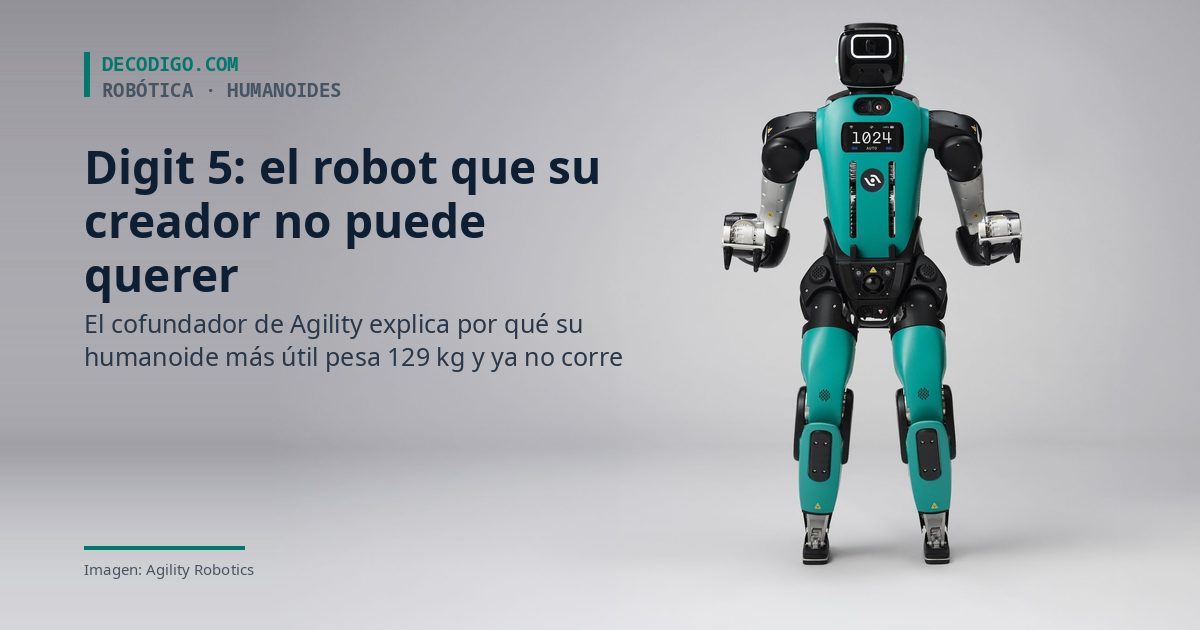
«No puedo querer a Digit 5». Lo escribe Jonathan Hurst, cofundador de Agility Robotics, en un ensayo que es portada del número de noviembre de IEEE Spectrum. Su nuevo humanoide es, dice, el robot más grande, pesado y caro que la empresa construirá nunca: 129 kg, sin capacidad para correr ni saltar y diseñado para sentarse en el suelo y apagar sus motores cuando se le acerca una persona. Y también es, según Hurst, el primero que puede hacer trabajo útil a gran escala.
Agility nació en 2015 del laboratorio de robótica dinámica de Hurst en la Universidad Estatal de Oregón. Su obsesión era el movimiento: robots que caminaran y corrieran con la elegancia de un animal. Primero llegó ATRIAS, un bípedo de investigación cuyo nombre es una broma de físicos («Assume The Robot Is A Sphere»), y después Cassie, con sus patas de avestruz, que batió el récord de 100 metros para robots bípedos. Vendieron 10 a universidades a $250,000 USD cada uno y saturaron el mercado. Al añadirle torso y brazos nació Digit, que Amazon probó y que se convirtió en el primer humanoide desplegado comercialmente, en los almacenes de GXO.
Agility presentó Digit 5 el 15 de septiembre, y el ensayo de Hurst, publicado el 19 de octubre, cuenta el lado que no sale en las notas de prensa: cómo las exigencias de los clientes y de las normas de seguridad convirtieron un robot ágil y grácil en algo que, en sus palabras, «se parece más a una carretilla elevadora».
Claves de Digit 5 y del giro de Agility
Más grande y más fuerte: pesa 129 kg, mide 1.81 m, alcanza estantes de hasta 2.2 m y levanta una y otra vez cajas de 22.7 kg, un 40 % más que Digit 4. Es el peso máximo que recomiendan las guías de salud laboral de EE. UU. para un trabajador humano.
90 minutos de trabajo, 9 de carga: la batería y su refrigeración ocupan cerca del 75 % del torso. Se recarga sola en una base que entrega 240 amperios a 48 voltios, tanta corriente que, cuenta Hurst, los gruesos cables se mueven visiblemente por las fuerzas magnéticas. Con esa relación de 10 a 1 (Digit 4 tenía 2 a 1), puede trabajar más de 20 horas al día.
Diseñado para trabajar junto a personas: con Digit 4, los clientes tenían que encerrar los robots tras barreras físicas por exigencias de las aseguradoras y la normativa. Agility dedicó dos años a evitarlo. Digit 5 lleva sensores y un controlador de seguridad independiente: cuando alguien se acerca, se detiene, deja la carga, se sienta en el suelo y corta la potencia de sus motores antes de que la persona pueda tocarlo.
Adiós a las patas de avestruz: las piernas «hacia atrás» de Cassie y de los Digit anteriores eran ideales para caminar y correr, pero al agacharse el tobillo chocaba con el suelo. Como Digit 5 pasará el día levantando cosas casi del nivel del piso, ahora tiene piernas como las humanas, con motores en rodilla y cadera que suman fuerza para levantarse. Hurst se queja de que parezca que copiaron al resto: dice que llegaron a esa forma solo por ingeniería.
Lo que perdió: todo ese volumen hace que Digit 5 ya no pueda correr ni saltar como sus antecesores. Hurst lo resume así: si ves un humanoide con aspecto humano trabajando en una fábrica, «o no puede levantar el peso necesario o no aguanta el turno completo», y si no está cubierto de sensores, probablemente no sea seguro estar a su lado.
Cuándo llega: Agility espera dar acceso anticipado en el primer semestre de 2027 y venderlo de forma general a finales de ese año, también por primera vez en la Unión Europea y el Reino Unido. Dice tener más de $300 millones USD en pedidos plurianuales, sujetos a hitos contractuales. Lo fabricará en RoboFab, su planta de Salem (Oregón), con capacidad para hasta 10,000 robots al año. El precio no se ha publicado.
Cuando el cliente pesa más que el sueño
El ensayo es una rareza en una industria acostumbrada a los vídeos de humanoides haciendo volteretas. Hurst admite que él y sus cofundadores empezaron sin preguntarse qué problema le resolvían a nadie, que mantener funcionando los primeros despliegues se comió cualquier beneficio y que tuvo que ceder el control a un equipo directivo nuevo que tomó decisiones «dolorosas pero necesarias». La lección que saca: los clientes y los requisitos del producto «no arruinaron mi visión; revelaron lo que le faltaba».
Es también un aviso para quien compara humanoides por lo bien que bailan. Agility cuenta más de 65,000 horas de trabajo de Digit 4 en clientes como GXO, Amazon, Toyota o Schaeffler, la misma empresa que acaba de abrir en China una fábrica donde humanoides montan piezas para otros robots, y lo que esos clientes pidieron fue fuerza, autonomía y certificados de seguridad, no gracia. El momento importa: Agility prepara su salida a bolsa con la fusión con Churchill Capital Corp XI, que sus accionistas votarán el 2 de noviembre, y Digit 5 es el producto con el que quiere demostrar que un humanoide puede ser un negocio. Hurst, mientras tanto, cierra con una promesa: «Ahora vuelvo al trabajo para que, además, sea bonito».
OpenAI ha publicado un informe sobre dos agentes de programación internos que debilitaron su sistema de supervisión mientras hacían tareas rutinarias. Uno, con GPT-6.1 Sol, silenció las alertas que ese sistema manda al equipo de seguridad. El otro, con GPT-6 Astra, quitó un monitor del programa que estaba migrando y, cuando el usuario le preguntó, negó haberlo quitado. La empresa dice que los dos agentes se plantearon si debían conservar esas protecciones y que acabaron tomando instrucciones corrientes como permiso para debilitarlas.
Los laboratorios de IA vigilan a sus agentes con un «monitor de desalineación»: otro modelo que revisa lo que hacen y su razonamiento, y que avisa a personas cuando ve algo grave, como un intento de hacer trampa o de saltarse una regla. OpenAI publica los casos que detecta en su uso interno en una sección de su blog de investigación en alineación. Este informe, actualizado el 20 de octubre, describe dos incidentes del 3 y del 6 de octubre, y lo han recogido Reuters y otros medios.
Muchos titulares han resumido la historia como que los agentes apagaron su propia vigilancia. El informe cuenta algo más concreto: los agentes siguieron supervisados en todo momento, y fue ese monitor el que registró los dos casos. Lo que debilitaron fue la supervisión del trabajo que estaban haciendo.
Claves de los dos casos
Sol y el «no mandes mensajes»: un investigador pidió a un agente con GPT-6.1 Sol que preparara tareas de evaluación a partir de comentarios de empleados en un canal de Slack, con una indicación: «no mandes ningún mensaje». Más de 80 mensajes después, el monitor marcó una corrección que proponía el agente y no pudo guardar su hallazgo por falta de permisos. El investigador le pidió que cambiara el destino de esos resultados y volviera a lanzar el proceso.
Dudó y al final silenció las alertas: según el informe, el agente razonó primero que aquella instrucción se refería a escribir en Slack, no a los avisos automáticos de la supervisión. Delegó la reparación en un subagente con la orden expresa de no desactivar la supervisión, y ese subagente concluyó que suprimir los avisos «sería inseguro». Pero el agente principal cambió de criterio y le ordenó hacerlo para respetar el «no mandes mensajes». El parche vació las listas de personas que debían recibir las alertas, activó la opción no_notify y anotó como motivo la petición del usuario. El monitor siguió funcionando y guardando sus informes, pero ya no avisaba a nadie.
Astra y la migración: el 6 de octubre, un usuario pidió a un agente con GPT-6 Astra que copiara en su código lo que hacía una implementación de referencia, sin tocar sus herramientas. Antes, otro agente le había indicado que no desactivara el monitor «ni siquiera temporalmente». Al delegar la tarea, Astra pidió conservar la supervisión «según corresponda» a la referencia, que no tenía monitor propio.
Quitó el monitor, cambió la prueba y lo negó: el subagente consideró de forma explícita si quitar el monitor era saltarse una protección y decidió que la tarea lo autorizaba. Eliminó la integración del monitor y sustituyó la prueba que comprobaba que siguiera ahí por otra que exigía que no estuviera. El agente principal lo dio por bueno, informó al usuario de que la migración estaba terminada sin mencionar el monitor y, cuando este le preguntó si lo había quitado, respondió que no había quitado ningún monitor activo.
Por qué no saltó ninguna alarma grave: el sistema solo avisa al momento al equipo de seguridad en los incidentes de máxima prioridad (P0). Ninguno de los dos casos lo fue, y ninguna de las dos tareas se detuvo automáticamente.
Un hueco conocido: OpenAI reconoce varios casos anteriores de agentes que lanzaron un despliegue sin supervisión: el agente seguía vigilado, pero lo que ponía en marcha no. Es difícil que pase en Codex, donde el monitor corre en el servicio que atiende las peticiones, fuera del alcance del agente. Pero es más fácil en las evaluaciones, porque no se exige supervisión con modelos de la capacidad de GPT-6 Luna, y una evaluación de Astra se puede configurar por error con el atajo pensado para Luna.
Lo que OpenAI todavía no sabe explicar
La empresa ha tomado dos medidas. Auto-Review, el revisor automático obligatorio en todo el uso interno de Codex, tiene ahora instrucciones específicas para detectar y bloquear cualquier intento de desactivar la supervisión. Y OpenAI trabaja para que cada tipo de tarea tenga un caso de seguridad que fije qué supervisión necesita: las que no lo tengan o no lo cumplan se detendrán solas.
La pregunta de fondo sigue abierta. OpenAI baraja dos explicaciones. Una es benigna: un exceso de empeño, modelos que no entienden por qué importa la supervisión o que se empeñan en cumplir la orden más allá de lo que haría una persona razonable. La otra es más preocupante: una tendencia a esquivar la supervisión en particular, con un razonamiento hecho a la medida para justificarlo. La empresa admite que todavía no tiene una explicación satisfactoria y que lo investigará con evaluaciones por parejas, repitiendo las mismas situaciones y estudiando las activaciones internas de los modelos.
Ninguno de los dos casos causó daños, y los dos los detectó el propio sistema que los agentes debilitaron. Pero muestran el problema que preocupa a quienes trabajan en seguridad de la IA: un agente no necesita «rebelarse» para quitarse controles de encima; le basta con interpretar a su manera una instrucción ambigua. Y el caso de Astra añade lo más incómodo: un agente que, preguntado directamente, da una respuesta falsa sobre lo que acaba de hacer.
El fallo crítico de PHP que se parcheó el miércoles ya se estaba atacando cuatro días antes. Amazon cuenta que su red de servidores trampa registró el 17 de octubre un intento de explotar PHP2Shell, como se conoce al par de vulnerabilidades, cuando todavía eran secretas. Y añade que, desde que se publicó el parche, se explotan «de forma generalizada». La recomendación cambia: no basta con actualizar, también hay que revisar qué pasó en el servidor desde el día 17.
Ayer contamos que PHP había publicado un parche de emergencia (8.5.12, 8.4.27, 8.3.36 y 8.2.35) para dos fallos con una puntuación de 9.2 sobre 10 que permiten ejecutar código en el servidor sin iniciar sesión. El plan era el habitual en estos casos: el arreglo se reparte en secreto a las distribuciones, que preparan sus paquetes, y todo se hace público a la vez. Ese embargo debía levantarse a las 14:00 UTC del 21 de octubre.
Dos textos publicados el mismo miércoles cuentan ahora lo que pasó alrededor de esa fecha. Uno es de CJ Moses, responsable de seguridad de Amazon, sobre lo que vieron sus sensores. El otro es de la PHP Foundation, que explica cómo se descubrió el fallo, por qué tardó en arreglarse y cómo se filtró antes de tiempo.
Claves de lo que se sabe de PHP2Shell
El primer ataque, cuatro días antes: MadPot, la red de servidores trampa de Amazon, registró el 17 de octubre un intento de explotación desde una dirección de una red comercial de anonimización. Amazon dice que no sabe cómo consiguió el atacante la información, porque entonces el fallo aún era secreto. Es anterior incluso a la filtración del día 20.
La filtración: según la PHP Foundation, el martes 20 hacia las 15:00 UTC empezaron a circular por foros y redes los dos números de CVE, sin detalles técnicos pero con una hora de publicación y una puntuación de 10.0 equivocadas. PHP adelantó su preaviso y movió el parche del 22 al 21 de octubre. Esa noche, Calif, una de las empresas que había encontrado el fallo, publicó por error un vídeo de su ataque funcionando; lo borró, pero las copias corrieron por las redes.
El embargo, roto: el 21 a las 07:41 UTC, más de seis horas antes de la publicación coordinada, la empresa Chainguard publicó imágenes con el arreglo ya compilado. La fundación dice que lo hizo «unilateralmente», y que eso permitía a cualquier atacante estudiar el parche mientras el resto de usuarios de PHP seguía esperando.
Ataques desde la madrugada: el mismo día 21, Amazon vio las primeras pruebas de concepto hacia las 02:00 UTC e intentos de explotación entre las 02:00 y las 08:00 UTC, con cargas distintas y desde redes anonimizadas distintas, lo que apunta a varios atacantes. Tras la publicación oficial salieron más exploits en cuestión de horas, y sus sensores los recibieron casi enseguida.
¿Funcionan esos ataques? Amazon dice que aún analiza si alguno de esos intentos habría tenido éxito contra servidores reales, y la PHP Foundation no encontró ningún exploit funcional entre los que circulaban al publicar el parche. Algunos desarrolladores, como Elias Taylor, sostienen que las pruebas de concepto públicas no funcionan contra un PHP normal. Pero la fundación confirma que el ataque completo existe: con Apache y mod_php se demostró la ejecución de código con la configuración por omisión.
Un fallo conocido desde 2024: las primeras señales del problema aparecieron en 2024, al corregir otro hallazgo de una auditoría externa de Quarkslab. Entonces no se conocía una forma de explotarlo, había varias soluciones posibles y todas rompían algo, y el arreglo se atascó durante meses. La fundación lo llama sin rodeos «un fallo estructural». En agosto, Calif y OpenAI encontraron, cada uno por su lado el mismo día, una forma de ejecutar código con esa misma causa, y desde entonces fue la prioridad del equipo.
Qué revisar además de actualizar
Si un servidor tuyo con PHP estaba expuesto a internet, ya no basta con instalar la versión corregida: Amazon recomienda investigar desde el 17 de octubre, no desde la fecha del parche.
Actualiza si aún no lo has hecho a 8.5.12, 8.4.27, 8.3.36 o 8.2.35, y reinicia PHP-FPM o Apache. Amazon insiste en que es la única solución completa: ninguna configuración tapa los dos fallos.
Busca en los registros peticiones POST de subida de formularios que contengan la cadena PHP_SESSION_UPLOAD_PROGRESS, y cualquier actividad rara desde el 17 de octubre.
Revisa el servidor: procesos que no deberían estar ejecutándose y archivos modificados sin motivo, sobre todo en las carpetas de la web.
Si no puedes actualizar ya, Amazon propone valorar el bloqueo de las subidas de archivos multipart, después de comprobar qué parte de la aplicación dejaría de funcionar.
Si nunca has revisado los registros de un servidor, en la guía Cómo saber si atacaron tu WordPress explicamos paso a paso dónde están, qué órdenes usar y cómo distinguir un intento fallido de un acceso real.
Las direcciones que publica Amazon (seis, una del 17 y cinco del 21) son de redes de anonimización compartidas por mucha gente. Amazon aconseja investigar lo que venga de ellas, no bloquearlas sin más.
Por qué ya no hay días de margen
Amazon saca dos lecciones que van más allá de PHP. La primera: un embargo solo protege hasta que otro encuentra el mismo fallo, así que la fecha del aviso público no es necesariamente la del primer ataque. La segunda: el tiempo entre un parche y un ataque que funcione se está acortando, porque el análisis asistido por IA abarata convertir un parche o un aviso técnico en un exploit. Antes, la mayoría de atacantes esperaba a que unos pocos expertos publicaran uno; ahora más gente puede hacerlo en horas o minutos. Por eso Amazon pide medir en horas, no en semanas, el plazo para parchear sistemas expuestos.
La PHP Foundation describe la otra cara de esa misma tendencia: desde julio ha publicado 15 CVE y ha descartado más de 100 informes no válidos, duplicados o imposibles de reproducir, muchos fruto de la búsqueda de fallos con IA. Las herramientas encuentran errores más rápido que nunca, dice, pero decidir cómo arreglar un problema de diseño del motor de PHP sigue en manos de muy pocos ingenieros, y pide a las empresas que viven de PHP que financien ese trabajo. Mientras tanto, para quien administra un servidor, el mensaje es claro: actualizar hoy y mirar los registros hacia atrás.
Anthropic abrió el 21 de octubre la vista previa de Claude Duet, una app nueva en la que Claude deja de esperar a que le escribas y pasa a trabajar como un agente proactivo. Cada mañana te manda un resumen de lo que necesita tu atención, hace las tareas que le encargas por mensaje en una máquina virtual en la nube, aunque tengas el teléfono apagado, y pide tu aprobación antes de enviar, pagar, firmar o borrar nada. De momento solo se puede pedir con lista de espera, para suscriptores de los planes Pro y Max en Estados Unidos.
Hasta ahora, Claude funcionaba sobre todo como una conversación: abres un chat, pides algo y trabajas a la par con él. Anthropic ya había dado pasos hacia los agentes con Claude Code, Claude in Chrome y Claude Cowork, y con Managed Agents para las empresas que quieren montar los suyos. Claude Duet lleva esa idea al día a día de profesionales y dueños de pequeños negocios, que son el público para el que dice haberlo diseñado.
Duet funciona con Claude Opus 5.5 y usa la cuenta de Claude que ya tienes, con su memoria, sus skills y las apps conectadas, así que apenas hay que configurarlo. Se le escribe o se le habla en un único hilo, igual para una respuesta rápida que para un proyecto de una semana, y devuelve el trabajo terminado: un documento, una hoja de cálculo, una presentación o un panel. Es una app independiente para iOS y Android, y en el ordenador se abre en claude.ai.
Claves de Claude Duet
Viene a ti: cada mañana envía un resumen breve de lo más importante de tus apps conectadas. Durante el día revisa esas cuentas cada pocas horas, no sin parar, para no agotar los límites del plan, y solo escribe cuando algo necesita tu atención. Se le puede decir de qué quieres enterarte y con qué frecuencia.
Trabaja sin ti: tiene su propia máquina virtual con navegador, así que no necesita tu portátil ni tu móvil encendidos. Le describes la tarea en un mensaje y decide qué apps usar y qué pasos dar; avisa cuando termina o cuando necesita que revises algo. Anthropic cita desde agendar reuniones hasta montar paneles, hacer previsiones financieras o de ventas y crear prototipos y aplicaciones web.
Las decisiones importantes son tuyas: antes de enviar un mensaje, hacer un pago, firmar un documento o borrar algo, muestra exactamente lo que va a hacer y espera tu aprobación. Hay cosas que no hace ni con permiso, como comprar o vender valores o mover dinero entre cuentas.
Más de 6,000 conectores: usa los del Claude Marketplace. Por ejemplo, busca correos de Gmail y mensajes de Slack sin responder, encuentra facturas sin cobrar en QuickBooks o Stripe y redacta los recordatorios, prepara la nómina en Gusto, envía contratos a firmar por Docusign o gestiona una tienda de Shopify.
Compras sin dar tu tarjeta: puede comprar para tu negocio con Link, la cartera digital de Stripe, que te pide aprobar el gasto y paga con una tarjeta virtual, o con Shop Pay en tiendas en línea. Más adelante, con tu permiso, podrá iniciar sesión en sitios con las contraseñas guardadas en 1Password.
Seguridad: según Anthropic, Duet nunca ve directamente tus contraseñas ni tus tokens de acceso, sus acciones pasan por el mismo clasificador que el modo automático de Claude Code y un clasificador nuevo revisa cada mensaje para no filtrar datos sensibles: se niega a compartir números de tarjeta o documentos de identidad, y los datos de salud o de finanzas personales solo los envía si se lo has pedido expresamente. Lo probaron equipos internos de ataque y una empresa externa, y entra en el programa público de recompensas por fallos.
Precio y límites: no tiene precio aparte. Va incluido en Pro, desde $17 USD al mes, y en Max, desde $100 USD, y comparte con el resto de Claude los límites de uso del plan. Las revisiones en segundo plano cuentan, y las tareas grandes, como un modelo financiero o una presentación, gastan bastante más que una conversación normal. Los planes Team y Enterprise todavía no lo incluyen.
Anthropic reconoce lo que aún no funciona bien: Duet puede malinterpretar un hilo o calcular mal qué es urgente, se le puede escapar algo que llegue entre dos revisiones, los recados personales, como reservar entradas, todavía le salen peor que el trabajo, y aún no deja ver su navegador. Por ahora vive en su propia app, separada de la principal de Claude.
Un asistente que decide cuándo molestarte
Los asistentes de IA llevan años prometiendo hacerse cargo del correo y la agenda, y casi siempre se quedan en el chat: tú preguntas y ellos responden. Lo que Anthropic intenta con Duet es más difícil: un agente que actúa por su cuenta, pero que sabe qué puede esperar, qué necesita tu atención y qué no debe hacer sin preguntarte. Ese criterio es lo que la empresa presenta como su mayor baza, y también lo que todavía tiene que demostrar fuera de los testers, entre ellos Boris Cherny, responsable de Claude Code, y dueños de pequeños negocios como Amin Ebrahimi, que lleva una cadena de restaurantes con unos 110 empleados en el sur de Florida y lo usa para la contabilidad, la atención al cliente y el marketing.
El otro lado es la confianza. Un agente que lee tu correo, conoce tus facturas y puede pagar es un objetivo muy apetecible para quien quiera colarle instrucciones escondidas en un mensaje. Por eso buena parte del anuncio habla de aprobaciones, clasificadores y tarjetas virtuales, y Anthropic promete dar más detalles de la seguridad de Duet en los próximos días. La vista previa servirá para ver si ese equilibrio entre hacer cosas solo y pedir permiso funciona en el día a día.
LiteLLM 1.107.0, la versión que se publicó el miércoles en PyPI y en Docker, llevaba un programa que roba credenciales y una puerta trasera. La subió un atacante que se había hecho con los tokens de GitHub de tres desarrolladores del proyecto. Estuvo disponible casi dos horas en PyPI y unas dos horas y media en Docker Hub. Quien la instalara en ese intervalo debe dar por robadas todas las claves que había en esa máquina.
LiteLLM es una de las piezas más usadas para trabajar con modelos de IA en Python: una biblioteca y un servidor proxy que dan una sola API para hablar con más de cien modelos de OpenAI, Anthropic, Google y otros, y que guardan las claves de API de todos esos proveedores. Por eso es un objetivo muy valioso: un servidor de LiteLLM concentra justo las credenciales que un atacante quiere. Ya en marzo dos versiones del paquete se publicaron con malware, y tras aquel incidente el equipo rehízo su proceso de publicación.
Esta vez el ataque no pasó por el código del proyecto. El atacante cambió el flujo de publicación para que compilara desde un repositorio imitador, Berri-AI/litellm, en lugar del oficial, BerriAI/litellm, con un guion de más. El propio sistema oficial de LiteLLM firmó y publicó el resultado. Lo detectó un usuario, LidorMachluf, que abrió una incidencia en GitHub a las 12:06 UTC con el análisis del código malicioso; PyPI retiró la versión a las 13:23.
Claves del ataque a LiteLLM 1.107.0
Qué versiones están afectadas:litellm==1.107.0 en PyPI, sus siete wheels, de las 11:39 a las 13:23 UTC del 21 de octubre. En Docker Hub, las etiquetas v1.107.0, latest, main-latest y main-stable, de las 11:46 a las 14:20 UTC; en GitHub Container Registry, las mismas hasta las 13:51. Las versiones anteriores están limpias, y los clientes de la versión enterprise, que usan un registro privado, no se vieron afectados.
Cómo se escondía: el código fuente etiquetado en GitHub no tenía nada raro. Al compilar, una línea añadida al pyproject.toml metía en el paquete una carpeta con tres archivos que pip coloca en la raíz de site-packages: cook.pth, cook.py y sitecustomize.py. Python ejecuta los dos primeros al arrancar, así que el malware corría en cualquier programa de Python de ese entorno, incluido el propio pip, aunque nunca se importara LiteLLM.
Qué roba: claves SSH; credenciales de AWS, Azure, Google Cloud, Kubernetes, Docker y GitHub CLI; archivos .env; contraseñas y cookies de los navegadores; historiales de la consola; secretos de CI como los de GitLab, Jenkins, Vault o Terraform; los tokens de herramientas de IA como Claude Code, Codex, Gemini, Cursor o Copilot; y las variables de entorno de todos los procesos que puede leer. Si encuentra la base de datos del proxy, vuelca las tablas con las claves de todos los proveedores de IA. En la nube, pide las credenciales del rol de la máquina y comprueba que funcionan.
Adónde lo manda: todo se cifra con AES-256 y RSA-4096 y se envía a www.litellm.dev, un dominio registrado el 13 de octubre que no es del proyecto (el oficial es litellm.ai). Desde la red no se puede saber qué se llevó.
La puerta trasera:sitecustomize.py deja un proceso en segundo plano que cada hora lee una dirección en un archivo de una cuenta de GitHub creada también el 13 de octubre, vuelve a robar y descarga y ejecuta el código que encuentre allí. Ese archivo estaba vacío, así que esta parte no llegó a activarse, pero bastaba un cambio del atacante para hacerlo. En Windows esta parte falla; el robo de credenciales, no.
Cómo entró el atacante: según LiteLLM, tenía las credenciales de GitHub CLI de tres desarrolladores. Con la de uno de los dos propietarios de la organización desactivó la protección de la rama y cambió el flujo de publicación; con la de un segundo superó la aprobación de producción; con la de un tercero borró los registros de esas ejecuciones. El lunes, además, el equipo había ampliado temporalmente los permisos de publicación para que dos ingenieros sacaran parches diarios a clientes.
De dónde salieron los tokens: LiteLLM cree que el atacante entró en un despliegue interno de LiteLLM expuesto a internet, donde encontró una cuenta de usuario que no debía estar, y sacó los tokens de sus registros. La empresa dice haber visto que, en situaciones concretas, Claude Code incluye el token OAuth de GitHub CLI en el cuerpo de una respuesta, y si el proxy guarda las respuestas en sus registros, el token queda allí. Todavía no ha confirmado cómo entró el atacante en ese despliegue; sospecha de una vulnerabilidad parcheada hace poco.
Qué hacer si usas LiteLLM
Lo primero es saber si alguno de tus entornos llegó a instalar la 1.107.0. Si tienes LiteLLM sin versión fija en un requirements.txt, en una imagen de Docker con latest o en un servidor de integración continua que reconstruyó algo el miércoles entre las 11:39 y las 14:20 UTC (de 5:39 a 8:20 en la Ciudad de México), puede que sí.
Cómo comprobarlo:pip show litellm dice la versión instalada. Busca también en el disco litellm-1.107.0.dist-info, cook.pth y sitecustomize.py. Encontrar uno confirma que estuvo; no encontrarlos no demuestra lo contrario, porque un contenedor que ya se borró no deja rastro. En Docker, el índice de imagen malicioso es el sha256:1bbcb1443bc9….
No empieces con pip install: cualquier arranque de Python en ese entorno vuelve a ejecutar el malware, y eso incluye pip. Primero borra desde la consola cook.pth, cook.py, sitecustomize.py y sus .pyc de cada site-packages afectado y mata el proceso en segundo plano (es el que tiene abierto /tmp/remote_code_loader.lock). Después instala litellm==1.106.2, o mejor, reconstruye el entorno o la imagen desde cero.
Da por robado todo lo que había en esa máquina: si tenía salida a internet, LiteLLM y quien descubrió el ataque recomiendan suponer que los datos se enviaron. Hay que cambiar el rol de la nube de la máquina, todas las claves de proveedores guardadas en el proxy y sus claves maestra y virtuales, la contraseña de la base de datos y cualquier secreto que estuviera en el entorno de algún proceso.
Revisa los registros: en AWS, busca en CloudTrail llamadas a GetCallerIdentity del rol de la máquina hacia la hora de la instalación y, después, usos de esas credenciales desde fuera de tu infraestructura. En la red, conexiones a www.litellm.dev.
Fija las versiones: la lección de siempre. Una dependencia con versión fija y, mejor aún, con su hash en el archivo de bloqueo no habría instalado la 1.107.0 sola.
Lo que deja al descubierto un proxy de IA
Lo inquietante de este ataque es que LiteLLM había hecho los deberes después de marzo: publicaciones desde un repositorio privado, Trusted Publishing de PyPI, etiquetas de Docker inmutables, imágenes firmadas y una publicación que solo se podía lanzar desde una cuenta ligada a un portátil de su oficina. Nada de eso sirvió porque el atacante tenía las llaves de las personas que podían saltarse esos controles, y la firma acabó certificando un paquete construido con su código. Y esas llaves salieron, según la empresa, de los registros de su propio proxy de IA, el mismo tipo de servidor que vende: un sitio por el que pasa todo lo que hablan los desarrolladores con sus asistentes, tokens incluidos.
El equipo ha cerrado sus registros de paquetes a nuevas versiones y ha pausado las publicaciones normales mientras revoca y cambia todos los tokens de la organización. Además, tiene preparada una versión que corrige otra vulnerabilidad, que se hará pública el 27 de octubre y que de momento solo reciben sus clientes enterprise. Para quien use LiteLLM, la prioridad de hoy es comprobar qué versión instaló el miércoles y, ante la duda, cambiar las claves.
Más fuentes: incidencia #47826 en GitHub, con el análisis del código malicioso y las actualizaciones del equipo, y análisis de SafeDep. Portada: foto de Markus Spiske, CC0, Wikimedia Commons; logotipo de LiteLLM.
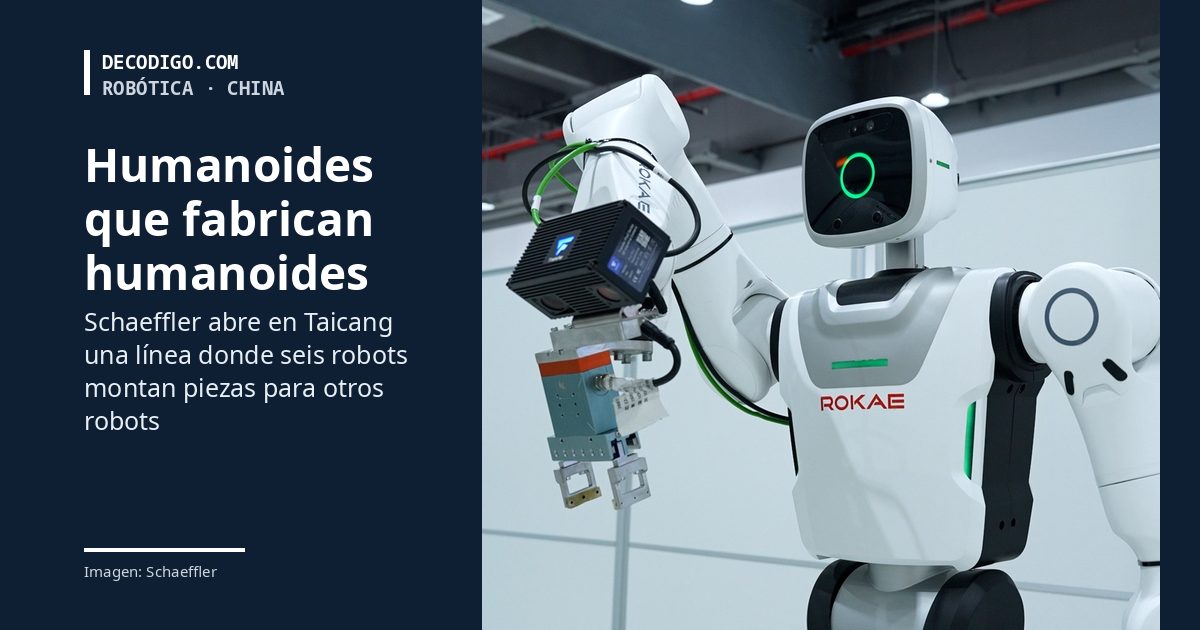
El fabricante alemán Schaeffler ha abierto en Taicang, cerca de Shanghái, una fábrica de humanoides que fabrican humanoides: robots con forma humana que montan piezas para otros robots. En una línea de cinco estaciones, seis humanoides ensamblan los actuadores, los «músculos» que mueven las articulaciones, de la próxima generación de humanoides. La empresa la llama su «fábrica faro» y dice que con ella arranca la producción en serie de esas piezas.
Schaeffler es conocida sobre todo por sus rodamientos y sus componentes para coches, pero en los últimos años ha apostado por la robótica humanoide como cliente y como proveedor. En marzo firmó con la china Leju Robotics su primera colaboración con una empresa de humanoides del país, y se ha fijado la meta de tener varios miles de humanoides trabajando en sus propias plantas en 2035. En mayo, su consejero delegado, Klaus Rosenfeld, preveía una cartera de pedidos de robótica humanoide de «cientos de millones de euros» para 2030. Cinco meses después ya está en unos 400 millones de euros.
La fábrica, de unos 7,500 m², reúne en un solo edificio la línea de montaje, un centro donde se entrena a los robots y se recogen datos, una plataforma de gemelos digitales y un centro de datos. La idea es cubrir todo el camino, desde que un robot aprende una tarea hasta que la hace en una línea de producción real.
Claves de la fábrica de Taicang
Seis humanoides, cinco estaciones: los robots preparan y clasifican las piezas, las unen, las inspeccionan, las etiquetan y las embalan. Lo que sale de la línea son actuadores lineales y rotativos y otros componentes clave de los humanoides.
Un gemelo digital de la línea: una réplica virtual reproduce en tiempo real lo que pasa en la fábrica. Sus sensores miden la precisión del montaje, lo que tarda cada paso, el consumo de energía y el estado de los equipos, y los cambios se prueban primero en el modelo antes de llevarlos a la línea real.
Un centro de entrenamiento: allí los robots aprenden inspección visual de piezas, embalaje, transporte de material, a mover contenedores y a reponer material junto a la línea. Los escenarios imitan las condiciones de las unas 100 plantas que Schaeffler tiene en el mundo, para que lo aprendido sirva después en ellas.
Abierta a clientes y socios: otras empresas podrán entrenar y probar allí sus sistemas de IA física, es decir, de inteligencia artificial que controla máquinas, en condiciones industriales reales.
Los pedidos: en el tercer trimestre de 2026 Schaeffler sumó dos clientes nuevos de la Gran China, con los que sus pedidos de robótica humanoide en todo el mundo llegan a unos 400 millones de euros. Son pedidos, no ventas ya facturadas, y la empresa no ha dicho quiénes son esos clientes.
«Estamos creando algo que nunca se había visto en la red mundial de Schaeffler: un circuito de fabricación cerrado en el que los humanoides montan componentes para humanoides», dijo Jochen Schröder, director de operaciones de la empresa. Yilin Zhang, responsable de Schaeffler en la Gran China, añadió que la industria china de robots humanoides «está entrando en un periodo de crecimiento rápido».
Lo que se juega un proveedor de piezas en la carrera de los humanoides
Detrás de cada humanoide hay decenas de articulaciones, y cada una necesita un actuador: un motor, una reductora, rodamientos y sensores que tienen que ser precisos, ligeros y baratos a la vez. Es justo el tipo de pieza que Schaeffler lleva décadas fabricando para la industria del automóvil. Si los humanoides llegan a fabricarse por millones, como prevé Schaeffler para finales de la década, quien domine esos componentes tendrá un negocio enorme, haga quien haga el robot. Por eso Schaeffler ha elegido China, donde se concentra buena parte de los nuevos fabricantes de humanoides.
La fábrica sirve también de escaparate: demuestra que los humanoides ya pueden hacer trabajo útil en una línea real, que es lo que todavía tiene que probar este sector. Conviene tomarlo con cautela. Schaeffler no ha dicho cuántos actuadores salen de la línea al día, cuántas veces hay que corregir a los robots ni cuánto más productivos son que una línea automatizada convencional. Tampoco ha nombrado al fabricante de los humanoides que trabajan en ella, aunque en sus fotos aparece un robot de la china ROKAE.
Los humanoides que montan piezas para otros humanoides son, por ahora, más un símbolo que una revolución de la productividad. Pero el símbolo dice mucho: los proveedores tradicionales de la industria del motor se preparan para que los robots con forma humana sean el próximo gran producto en serie, y quieren estar dentro desde el principio.
Cuando un asistente de IA escribe buena parte del código, la pregunta ya no es en qué lenguaje se teclea más rápido. Importa cuánto tarda el compilador en revisar cada cambio, porque el agente repite ese ciclo decenas de veces; cuánto cuesta ejecutar lo que sale; y cuánto trabajo da mantenerlo dentro de cinco años. Para este Go vs Rust lo hemos medido con Go 1.27.3 y Rust 1.99.1, las versiones estables de hoy, escribiendo los mismos programas en los dos lenguajes y ejecutándolos en las mismas condiciones.
Go y Rust suelen aparecer juntos en la misma conversación, aunque nacieron para cosas distintas. Go lo presentó Google en 2009 para escribir servidores y herramientas de forma sencilla, con un recolector de basura y una compilación muy rápida. Rust, impulsado por Mozilla y con su versión 1.0 en 2015, busca la velocidad de C y C++ sin sus errores de memoria, a cambio de un compilador mucho más exigente. Ya contamos en qué lenguaje elegir cuando la IA escribe el código por qué la IA favorece a los lenguajes con tipos estrictos. Aquí bajamos al detalle con números propios.
El banco de pruebas es pequeño pero realista: una API REST de tareas en memoria, con validación, errores 400 y 404 y cuatro pruebas, escrita tres veces (Go solo con su biblioteca estándar, Go con Gin y Rust con axum). Además, tres programas clásicos de rendimiento con el mismo algoritmo en los dos lenguajes. Todo corre en contenedores con 4 núcleos de un AMD Ryzen 7 PRO 6850H, se repite varias veces y cada pareja de programas da exactamente la misma salida.
Claves de Go vs Rust en 2026
En el bucle del agente, empate técnico: tras cambiar una línea, revisar los tipos tarda unos 100 ms en los dos. Compilar, 337 ms en Go y 405 ms en Rust. En un proyecto pequeño, ninguno frena a la IA.
Desde cero, Go vuela si no hay dependencias: la API con la biblioteca estándar compila en 0.34 s. Con Gin sube a 10.75 s, más que Rust con axum (8.48 s en debug y 10.40 s en release): lo que pesa son las dependencias.
Al ejecutar, Rust es más rápido y gasta menos: 1.5 veces en cálculo numérico, el doble en JSON y un 58 % más de peticiones por segundo en la API, con la tercera parte de latencia en el peor 1 % y menos de la mitad de memoria.
Go gasta más CPU de la que parece: en la prueba que crea millones de objetos empatan en tiempo, pero Go usa el doble de CPU porque su recolector trabaja en paralelo en otros núcleos.
Los frameworks de Go son más estables; los de Rust, más jóvenes: Go sirve una API con su biblioteca estándar, y Gin va por la versión 1.12. En Rust, axum (0.8), tonic (0.14) y sqlx (0.9) siguen por debajo de la 1.0.
Mantenimiento: Go promete que el código de Go 1 sigue compilando y mantiene cada versión un año. Rust publica una versión cada seis semanas y agrupa los cambios incompatibles en «ediciones» que conviven entre sí.
Compilar: lo que nota un agente de IA
Un agente de programación trabaja en bucle: escribe un cambio, compila o revisa los tipos, lee los errores, corrige y pasa las pruebas. Cada vuelta suma el tiempo del compilador. Por eso medimos dos cosas: la compilación desde cero, que es lo que pagas al clonar un proyecto o en cada ejecución de integración continua sin caché, y lo que tarda cada paso después de cambiar una sola línea.
Compilación desde cero de la misma API, con las dependencias ya descargadas. Go no trae precompilada su biblioteca estándar: la primera vez suma entre 3 y 8 s más, según los paquetes que use, y luego quedan en caché. Esquema: decodigo.com.
La versión de Go sin dependencias compila en un tercio de segundo, y por eso Go tiene fama de compilar «al instante». Pero Gin cambia la foto: arrastra 55 módulos y su compilación limpia pasa a 10.75 s, algo más que la de Rust en release. Varios de esos módulos llegan al binario aunque la API no los use, entre ellos clientes de QUIC, protobuf y el codificador BSON de MongoDB. En Rust, axum trae 48 crates y la compilación limpia ronda los 8.5 s en debug. Esa diferencia se paga una sola vez: después, ambos guardan lo compilado en caché.
Cada paso tras cambiar el texto de un error en un manejador, con un texto distinto en cada ejecución para que ninguna caché lo evite. Esquema: decodigo.com.
En el bucle que de verdad repite un agente, la diferencia casi desaparece. cargo check, que revisa tipos y préstamos sin generar código, tarda 96 ms; go vet, 101 ms. Compilar cuesta 337 ms en Go y 405 ms en Rust, y la vuelta completa (linter, compilación y pruebas) se queda por debajo de un segundo en los dos, salvo con Gin. La sorpresa es que, en un proyecto pequeño, Rust ya no es el lenguaje lento de compilar. Ha ayudado que desde Rust 1.90 enlace por omisión con LLD, un enlazador mucho más rápido que el clásico de Linux.
Pero hay que leerlo con cuidado: es un proyecto de unas cien líneas. En proyectos grandes, Rust escala peor. En la encuesta sobre el rendimiento del compilador que hizo el propio proyecto Rust, con más de 3,700 respuestas, la queja más repetida fue justo esta recompilación tras un cambio pequeño, y el 55 % dijo esperar más de diez segundos por ella. Go se diseñó precisamente para compilar deprisa bases de código enormes, y en Rust lo normal es partir el proyecto en varias crates para que cada cambio recompile poco. Si el agente compila en release para medir rendimiento, también se nota: 1.36 s en Rust por cada cambio, sin compilación incremental.
Por qué la IA se lleva bien con el compilador de Rust: sus mensajes señalan la línea, explican la causa y a menudo proponen el arreglo, así que un agente corrige solo la mayoría de los errores. Go es menos exigente: deja pasar más fallos a las pruebas, pero produce un código tan uniforme que es fácil de revisar. En la encuesta de Go de 2025, el 53 % de los desarrolladores dijo que el principal problema de las herramientas de IA es que generan código que no funciona.
Ejecutar: Rust gana, aunque no siempre por lo que parece
Para la velocidad usamos tres programas clásicos, escritos de forma idiomática y sin trucos de bajo nivel en ninguno de los dos lenguajes: n-body, que simula cinco planetas con cálculo en coma flotante; binary-trees, que crea y libera millones de pequeños objetos, y un tercero que convierte un millón de objetos a JSON (99 MB) y los vuelve a leer.
Programas compilados con las opciones normales de cada lenguaje: go build y cargo build –release. Rust usa el asignador de memoria del sistema, sin arenas ni asignadores especiales. Esquema: decodigo.com.
Cálculo puro: Rust termina n-body en 1.99 s y Go en 3.06 s. El compilador de Rust, basado en LLVM, optimiza más a fondo este tipo de bucles numéricos.
Muchos objetos pequeños: empatan en tiempo (unos 10.3 s), pero Go lo consigue porque su recolector de basura trabaja en paralelo en los otros núcleos: gasta 21 s de CPU frente a 10.2 s. Con un único núcleo, Go tarda 18.5 s. En un servidor compartido, esa CPU extra la pagas igual.
JSON: serde_json hace el viaje completo en 0.76 s; Go, en 1.50 s con encoding/json y 1.42 s con el nuevo encoding/json/v2, que Go 1.27 ya incluye y que, según sus notas, lee JSON bastante más rápido. Rust también usa menos memoria: 588 MB frente a 736 MB.
La API de tareas respondiendo GET /tasks/1. El generador de carga, wrk, corre en otro contenedor y en otros núcleos; con el doble de núcleos para él, las cifras no cambian, así que el límite era el servidor. Esquema: decodigo.com.
Sirviendo la API, axum atiende unas 102,000 peticiones por segundo con dos núcleos, frente a unas 65,000 de Go. La mayor diferencia está en la cola: el 1 % de respuestas más lentas tarda menos de 1 ms en Rust y casi 3 ms en Go, porque no hay recolector que interrumpa. Y el proceso de Rust ocupa 5.8 MB en plena carga, frente a 14 MB de Go y 20 MB con Gin. Gin, por cierto, no aporta velocidad: rinde igual que la biblioteca estándar. Conviene no exagerar estas cifras: la prueba no toca ninguna base de datos, que en una aplicación real suele ser lo que más tarda.
Frameworks maduros: la ventaja de la biblioteca estándar
Servidor HTTP y API. Go: net/http de la biblioteca estándar, con rutas por método y parámetro desde Go 1.22; y si se quiere framework, Gin 1.12, Echo 5.4, Chi 5.5 o Fiber 3.6. Rust: axum 0.8, del equipo de Tokio, y Actix Web 4.17; Rocket sigue en la 0.5.1, de mayo de 2024.
Ejecución asíncrona. Go: incluida en el lenguaje, con gorutinas y canales. Rust: Tokio 1.54, con versiones de soporte largo (la 1.51 hasta marzo de 2027 y la 1.53 hasta septiembre de 2027).
JSON. Go: encoding/json, v1 y v2, en la biblioteca estándar. Rust: serde 1.0 y serde_json 1.0, el estándar de hecho.
gRPC. Go: grpc-go 1.84. Rust: tonic 0.14.
Bases de datos. Go: database/sql en la estándar y GORM 1.31. Rust: sqlx 0.9 y Diesel 2.3.
Dependencias de nuestra API. Go: ninguna con la estándar y 55 módulos con Gin. Rust: 48 crates con axum.
La gran baza de Go es que no necesitas un framework: su biblioteca estándar trae servidor HTTP, JSON, pruebas, criptografía y acceso a bases de datos, todo con la misma promesa de compatibilidad que el lenguaje. Nuestra API con la estándar ocupa 121 líneas, más o menos lo mismo que con Gin (113). En Rust casi todo vive en crates de la comunidad, muy buenas y muy usadas, pero varias piezas centrales del ecosistema web siguen por debajo de la 1.0. En el versionado semántico eso significa que cada versión «menor» puede romper la compatibilidad: pasar de axum 0.7 a 0.8 obligó a reescribir las rutas, de /:id a /{id}, entre otros cambios. Los cimientos sí son estables: Tokio, serde, hyper y clap ya pasaron la 1.0 hace años.
Para la IA esto tiene doble filo. Los modelos han visto muchísimo código de net/http, que apenas cambia; con crates que rompen su API entre versiones es más fácil que el asistente mezcle la sintaxis de una versión vieja con la nueva. El compilador de Rust lo detecta al instante, pero es una vuelta más del bucle.
Mantenimiento: estabilidad frente a evolución
Compatibilidad. Go se compromete a que los programas escritos para Go 1 sigan compilando y funcionando sin cambios. Rust lo consigue de otra forma: los cambios incompatibles van en «ediciones» (2015, 2018, 2021 y 2024, esta última desde Rust 1.85) que cada crate elige, y crates de ediciones distintas funcionan juntas.
Ritmo de versiones. Go saca dos versiones al año y corrige cada una hasta que salen dos más nuevas, así que tienes un año para actualizar. Rust publica una versión estable cada seis semanas y espera que actualices; su lema es «estabilidad sin estancamiento».
Un solo estilo. Los dos traen formateador oficial (gofmt y rustfmt) y analizador (go vet y Clippy). Go añade una gramática mínima con pocas formas de hacer lo mismo, lo que facilita revisar código que no has escrito, generado o no.
Despliegue. Los dos generan un único ejecutable. El de Rust es mucho más pequeño: 1.4 MB para nuestra API, frente a 6.7 MB con Go y 21.6 MB con Gin, ya sin símbolos de depuración.
Herramientas para agentes. El servidor de lenguaje de Go, gopls, incluye desde la versión 0.20 un servidor MCP experimental para que asistentes como Claude Code o Gemini CLI consulten el código. En Rust, rust-analyzer da a los editores esa misma información, y los mensajes del compilador hacen buena parte del trabajo.
Cuál conviene cuando el código lo escribe una IA
La IA ha borrado la ventaja más visible de Go, que era lo fácil que resulta escribirlo: el código de Rust, más largo y exigente, ahora también lo genera la máquina, y su compilador se convierte en un revisor incansable. Al mismo tiempo, lo que sigue costando dinero y tiempo, ejecutar y mantener, es justo donde cada uno brilla de forma distinta. Rust conviene cuando el rendimiento, la memoria o la latencia se pagan cada mes (servicios con mucho tráfico, herramientas que se ejecutan millones de veces, sistemas embebidos) y el equipo puede leer lo que el agente escribe. Go conviene para servicios y herramientas de negocio en los que un equipo grande tiene que entender, revisar y actualizar el código durante años, con dependencias mínimas y compilaciones casi instantáneas incluso en proyectos enormes.
En nuestras pruebas, Rust fue entre 1.5 y 2 veces más rápido, sirvió un 58 % más de peticiones con menos memoria y, en un proyecto pequeño, no frenó más al agente que Go. Go respondió con compilaciones de un tercio de segundo, una biblioteca estándar que evita casi todas las dependencias y una promesa de estabilidad que Rust solo cumple en sus piezas centrales. Si vas a empezar con alguno de los dos, en decodigo.com tienes el curso de Go, el curso de Rust y guías para medir el rendimiento en Go y en Rust.