El algoritmo de Myers: así encuentra git diff las diferencias entre dos archivos, con animación

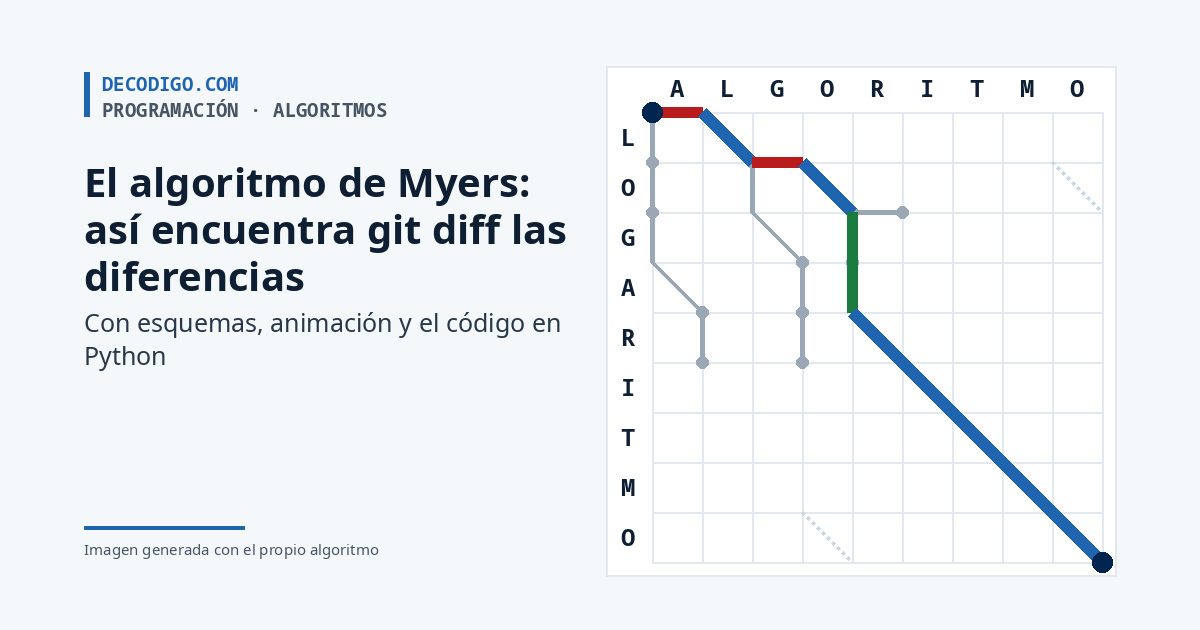
Cuadrícula de edición de ALGORITMO a LOGARITMO con el camino que encuentra el algoritmo de Myers

Cada vez que escribes git diff, Git compara dos versiones de un archivo y te enseña, en rojo y en verde, qué líneas se han quitado y cuáles se han añadido. Parece sencillo, pero detrás hay un problema que se resiste: entre los muchísimos caminos posibles para pasar de un texto a otro, hay que encontrar el más corto, y hacerlo rápido. La solución que usan Git y GNU diff, el algoritmo de Myers, la publicó Eugene Myers en 1986, y se entiende muy bien en un dibujo. Aquí la verás funcionar paso a paso, con tus propios textos.

Qué es un diff y por qué no es trivial

Un diff es una lista de instrucciones para convertir un texto A en otro texto B usando solo dos operaciones: borrar un elemento de A o insertar uno de B. Los elementos pueden ser letras, como en los ejemplos de este artículo, o líneas enteras, como hace Git. Lo que no se borra ni se inserta se conserva, y eso es lo que tienen en común los dos textos.

Pasar de A a B siempre se puede: basta con borrarlo todo y escribirlo todo de nuevo. Pero ese diff no sirve de nada, porque no dice qué ha cambiado de verdad. Lo que queremos es el diff con menos operaciones, el que conserva lo máximo posible. Lo que se conserva tiene nombre: es la subsecuencia común más larga (LCS, por sus siglas en inglés), la secuencia más larga de elementos que aparecen en los dos textos y en el mismo orden, aunque no estén seguidos. Encontrar el diff mínimo y encontrar la LCS son el mismo problema visto desde dos lados: si los textos miden N y M y la LCS mide L, el diff mínimo tiene N + M − 2L operaciones.

Lo que se conserva y lo que cambiaA = ABCABBA (antes) · B = CBABAC (después)A–B–C=B+A=B=B–A=C+Rojo: se borra de A. Verde: se inserta de B.Azul: lo común, la subsecuencia CABA.5 cambios: no hay forma de hacerlo con menos.
El ejemplo del artículo de Myers: de ABCABBA (7 letras) a CBABAC (6). La subsecuencia común más larga mide 4, CABA, así que el diff mínimo tiene 7 + 6 − 2 × 4 = 5 operaciones. Esquema: decodigo.com.

Lo difícil es que hay muchísimas formas de alinear dos textos. Con dos textos de mil líneas, las combinaciones posibles son astronómicas, y probarlas todas no es una opción. El método clásico, de programación dinámica, rellena una tabla de N × M casillas: para dos archivos de 10,000 líneas son 100 millones de casillas, aunque solo hayas cambiado una coma.

La cuadrícula de edición

La idea de Myers empieza por un dibujo. Escribe A en horizontal y B en vertical, y traza una cuadrícula. Cada punto de la cuadrícula es un estado a medio camino: «ya he recorrido tantas letras de A y tantas de B». Se empieza arriba a la izquierda, en (0, 0), y hay que llegar abajo a la derecha. Desde cada punto hay tres movimientos posibles:

  • A la derecha: borrar la siguiente letra de A. Cuesta 1.
  • Hacia abajo: insertar la siguiente letra de B. Cuesta 1.
  • En diagonal: solo se puede donde la letra de A y la de B son iguales, y no cuesta nada, porque esa letra se conserva.

Así, cada camino de una esquina a la otra es un diff, y su coste es el número de pasos que no son diagonales. El diff mínimo es el camino que aprovecha más diagonales. Myers llamó serpiente (snake) a cada tramo de diagonales seguidas, y D al número de pasos de pago.

La cuadrícula de ediciónArriba, A = GATO; a la izquierda, B = PATOGATOPATOiniciofinderecha: borrar una letra de Aabajo: insertar una letra de Bdiagonal: las letras coinciden, gratisLas diagonales k = x – yCada diagonal de la cuadrícula tiene su númeroGATOPATOk = -3k = -2k = -1k = 0k = 1k = 2k = 3Borrar (derecha) lleva a la diagonal k + 1.Insertar (abajo) lleva a la diagonal k – 1.Una coincidencia (diagonal) no cambia de k.
A la izquierda, el camino más barato de GATO a PATO: borra la G, inserta la P y baja en diagonal por A, T y O. Cuesta D = 2. A la derecha, las diagonales numeradas: el punto (x, y) está en la diagonal k = x − y. Esquemas: decodigo.com.

El truco de Myers: frentes y diagonales

Para orientarse en la cuadrícula, Myers numera sus diagonales: el punto (x, y) está en la diagonal k = x − y. La diagonal principal, la que sale de la esquina de inicio, es la k = 0; borrar te mueve a la diagonal de la derecha (k + 1), insertar te mueve a la de la izquierda (k − 1), y una coincidencia te deja en la misma.

Con eso, el algoritmo avanza por frentes. Primero mira hasta dónde se llega con D = 0 cambios: solo bajando en diagonal desde (0, 0) mientras las letras coincidan. Luego, con D = 1: un borrado o una inserción, seguidos de toda la diagonal gratis que haya. Luego con D = 2, y así sucesivamente. En cada frente solo guarda una cosa por diagonal: el punto más lejano al que se puede llegar en ella con D cambios. La clave, demostrada en el artículo, es que el punto más lejano con D cambios siempre sale de uno de los puntos más lejanos con D − 1, el de la diagonal de al lado, más un paso y la serpiente que venga detrás. No hace falta recordar nada más.

El primer frente que toca la esquina final da la respuesta, y como los frentes se prueban en orden, de menor a mayor, no puede haber un camino más corto. Para sacar el diff basta con guardar cada frente y recorrerlos hacia atrás desde la esquina.

Los frentes: D = 0, 1, 2…Hasta dónde llega cada diagonal con D cambiosABCABBACBABAC0112223343345445Cada círculo es el punto más lejano al que llegauna diagonal con D cambios. Con D = 5, uno llegaa la esquina: ese es el diff, el camino marcado.
Los frentes del ejemplo de Myers. Cada número es el punto más lejano al que llega una diagonal con ese número de cambios; con D = 5, el algoritmo llega a la esquina. Es la idea de la figura 3 del artículo original, y el camino marcado es el de su figura 1. Esquema: decodigo.com.

Pruébalo

Escribe dos textos, o elige un ejemplo, y pulsa «Reproducir». Cada paso de la animación es una diagonal de un frente: la arista roja es un borrado, la verde una inserción, y el tramo azul que sigue es la serpiente, las coincidencias que el algoritmo recorre gratis. La franja azul clara marca la diagonal que se está calculando, y las líneas discontinuas grises son todos los atajos que existen. Los frentes anteriores se quedan en gris. Cuando un frente llega a la esquina, se dibuja el camino elegido y, debajo, el diff. Con «Líneas», cada fila y cada columna son una línea entera, como en Git; los números de la cuadrícula son los números de línea.

Ejemplos:
Comparar por:

borrarinsertarcoincidenciaatajo posible

Prueba «Casi nada en común»: como GATO y PERRO no comparten ninguna letra salvo la O final, el algoritmo tiene que abrir casi todos los frentes, hasta D = 7. Con «El de Myers» basta con 19 pasos para encontrar el camino de D = 5.

Por qué es rápido

El frente D tiene D + 1 diagonales, y cada serpiente avanza sin volver atrás. En total, el algoritmo hace del orden de (N + M) × D operaciones, que Myers escribe O(ND) tomando N como la suma de las dos longitudes. Lo importante es la D: el trabajo no depende tanto del tamaño de los archivos como de cuánto han cambiado. Comparar dos versiones de un archivo de 10,000 líneas en las que has tocado tres líneas es casi instantáneo, porque el algoritmo llega a la esquina como mucho en el frente 6, sin haber mirado la mayor parte de la cuadrícula. Eso es justo lo que pasa casi siempre con el código: entre un commit y el siguiente, cambia poco.

Myers también demostró que, en promedio, el coste es de N + D², y propuso una variante que solo necesita memoria proporcional a N: busca a la vez desde las dos esquinas hasta que los dos recorridos se encuentran en una serpiente central, y repite el proceso a cada lado. Esa es la versión que usan GNU diff y Git.

Un detalle de la versión básica: cuando dos caminos llegan igual de lejos, la regla de elección del algoritmo hace que, en cada bloque de cambios, salgan primero los borrados y después las inserciones. Es como estamos acostumbrados a leer un diff: primero lo que había y luego lo que lo sustituye. Lo hemos comprobado en 2,006 pares de textos al azar: en ninguno aparece una inserción justo antes de un borrado.

El algoritmo en Python

Esta es la versión completa, con la vuelta atrás para sacar el diff. La función frentes es la figura 2 del artículo de Myers casi línea a línea; la única diferencia es que guarda una copia de cada frente para poder reconstruir el camino:

# Algoritmo de diferencias de Myers (1986), versión voraz hacia delante, con la vuelta atrás para sacar el
# script de edición. Referencia para comprobar el núcleo de articulos/myers.js (pruebas/myers/compara.js).
def frentes(a, b):
    """Recorre D = 0, 1, 2… y guarda, para cada D, el punto más lejano (x) alcanzado en cada diagonal k = x - y."""
    n, m = len(a), len(b)
    v = {1: 0}
    traza = []
    for d in range(n + m + 1):
        traza.append(dict(v))
        for k in range(-d, d + 1, 2):
            if k == -d or (k != d and v[k - 1] < v[k + 1]):
                x = v[k + 1]            # baja desde la diagonal k + 1: inserta
            else:
                x = v[k - 1] + 1        # avanza a la derecha desde k - 1: borra
            y = x - k
            while x < n and y < m and a[x] == b[y]:
                x, y = x + 1, y + 1     # serpiente: diagonal gratis mientras coinciden
            v[k] = x
            if x >= n and y >= m:
                return d, traza
    raise AssertionError("inalcanzable")


def diff(a, b):
    """Devuelve el script de edición: lista de ('=', a), ('-', a) y ('+', b), en orden."""
    d, traza = frentes(a, b)
    x, y = len(a), len(b)
    ops = []
    for d in range(d, -1, -1):
        v = traza[d]
        k = x - y
        if k == -d or (k != d and v[k - 1] < v[k + 1]):
            k_prev = k + 1
        else:
            k_prev = k - 1
        x_prev = v[k_prev]
        y_prev = x_prev - k_prev
        while x > x_prev and y > y_prev:
            x, y = x - 1, y - 1
            ops.append(("=", a[x]))
        if d > 0:
            if x == x_prev:
                y -= 1; ops.append(("+", b[y]))
            else:
                x -= 1; ops.append(("-", a[x]))
    ops.reverse()
    return ops


if __name__ == "__main__":
    a, b = "ABCABBA", "CBABAC"
    d, _ = frentes(a, b)
    ops = diff(a, b)
    print("D =", d)
    print(" ".join(s + c for s, c in ops))
    print("común:", "".join(c for s, c in ops if s == "="))
salidaD = 5
-A -B =C +B =A =B -B =A +C
común: CABA

Es el resultado de la figura 1 del artículo original: borrar A y B, conservar C, insertar B, conservar A y B, borrar B, conservar A e insertar C. Hemos comprobado que la animación de arriba usa exactamente el mismo cálculo: en 2,006 pares de textos al azar, las dos dan el mismo diff, letra a letra, y en todos ellos D es la mínima, la que da la LCS calculada con el método clásico.

Lo que hace Git: myers, minimal, patience e histogram

Git deja elegir el algoritmo con la opción --diff-algorithm. Hay cuatro: myers, el que usa por omisión; minimal, que gasta más tiempo para asegurarse de dar el diff más pequeño posible, porque la versión de Git recorta la búsqueda con algunos atajos en los casos difíciles; patience, que primero empareja las líneas que aparecen una sola vez en cada archivo y luego rellena lo que queda entre ellas, e histogram, una variante de patience que también aprovecha las líneas que se repiten poco.

¿Por qué hace falta más de uno? Porque el diff mínimo casi nunca es único: suele haber varios caminos con la misma D, y no todos se leen igual de bien. Un ejemplo clásico: en este programa en C hemos borrado la función fact, hemos añadido fib al principio y hemos quitado una línea de repite.

#include <stdio.h>

// Repite foo diez veces
int repite(int foo)
{
    int i;
    for (i = 0; i < 10; i++)
    {
        printf("Tu respuesta es: ");
        printf("%d\n", foo);
    }
}

int fact(int n)
{
    if (n > 1)
    {
        return fact(n - 1) * n;
    }
    return 1;
}

int main(int argc, char **argv)
{
    repite(fact(10));
}
#include <stdio.h>

int fib(int n)
{
    if (n > 2)
    {
        return fib(n - 1) + fib(n - 2);
    }
    return 1;
}

// Repite foo diez veces
int repite(int foo)
{
    int i;
    for (i = 0; i < 10; i++)
    {
        printf("%d\n", foo);
    }
}

int main(int argc, char **argv)
{
    repite(fib(10));
}

Esto es lo que da git diff --no-index --diff-algorithm=myers antes.c despues.c, con Git 2.39.5:

myers@@ -1,26 +1,25 @@
 #include <stdio.h>
 
-// Repite foo diez veces
-int repite(int foo)
+int fib(int n)
 {
-    int i;
-    for (i = 0; i < 10; i++)
+    if (n > 2)
     {
-        printf("Tu respuesta es: ");
-        printf("%d\n", foo);
+        return fib(n - 1) + fib(n - 2);
     }
+    return 1;
 }
 
-int fact(int n)
+// Repite foo diez veces
+int repite(int foo)
 {
-    if (n > 1)
+    int i;
+    for (i = 0; i < 10; i++)
     {
-        return fact(n - 1) * n;
+        printf("%d\n", foo);
     }
-    return 1;
 }
 
 int main(int argc, char **argv)
 {
-    repite(fact(10));
+    repite(fib(10));
 }

Y esto, con --diff-algorithm=patience:

patience@@ -1,26 +1,25 @@
 #include <stdio.h>
 
+int fib(int n)
+{
+    if (n > 2)
+    {
+        return fib(n - 1) + fib(n - 2);
+    }
+    return 1;
+}
+
 // Repite foo diez veces
 int repite(int foo)
 {
     int i;
     for (i = 0; i < 10; i++)
     {
-        printf("Tu respuesta es: ");
         printf("%d\n", foo);
     }
 }
 
-int fact(int n)
-{
-    if (n > 1)
-    {
-        return fact(n - 1) * n;
-    }
-    return 1;
-}
-
 int main(int argc, char **argv)
 {
-    repite(fact(10));
+    repite(fib(10));
 }

Los dos son igual de cortos: 10 líneas añadidas y 11 borradas. Pero el primero mezcla las llaves y las líneas en blanco de funciones distintas, y el segundo cuenta lo que de verdad ha pasado: una función nueva, una línea menos y una función borrada. Con este ejemplo, minimal da lo mismo que myers e histogram, lo mismo que patience. Curiosamente, la versión básica de Python de arriba, aplicada a estas líneas, da exactamente el diff de patience: recorre la cuadrícula en otro orden que la versión de Git, que busca desde las dos esquinas, y en el empate entre caminos igual de cortos elige otro. No es que sea mejor: con otros archivos puede pasar al revés. Si quieres que Git use otro algoritmo siempre, basta con git config --global diff.algorithm histogram.

Si te gustan los algoritmos que se entienden mejor viéndolos, tenemos más con animación: el juego de la vida, la hormiga de Langton y los boids. Y si Git te interesa por dentro, en esta explicación de Scion contamos por qué Anthropic ha dejado Git en su repositorio principal.

Fuentes: E. W. Myers, «An O(ND) Difference Algorithm and Its Variations», Algorithmica 1, 251–266 (1986) (figuras 1, 2 y 3, y secciones 3 y 4); la documentación de git diff (opción –diff-algorithm); el código de Git, xdiff/xdiffi.c, y el de GNU diff, diffseq.h de gnulib, que citan el artículo de Myers. El programa se ejecutó con Python 3.13 y el ejemplo de Git, con Git 2.39.5. La animación y las imágenes, incluida la portada, las genera el propio algoritmo: decodigo.com.
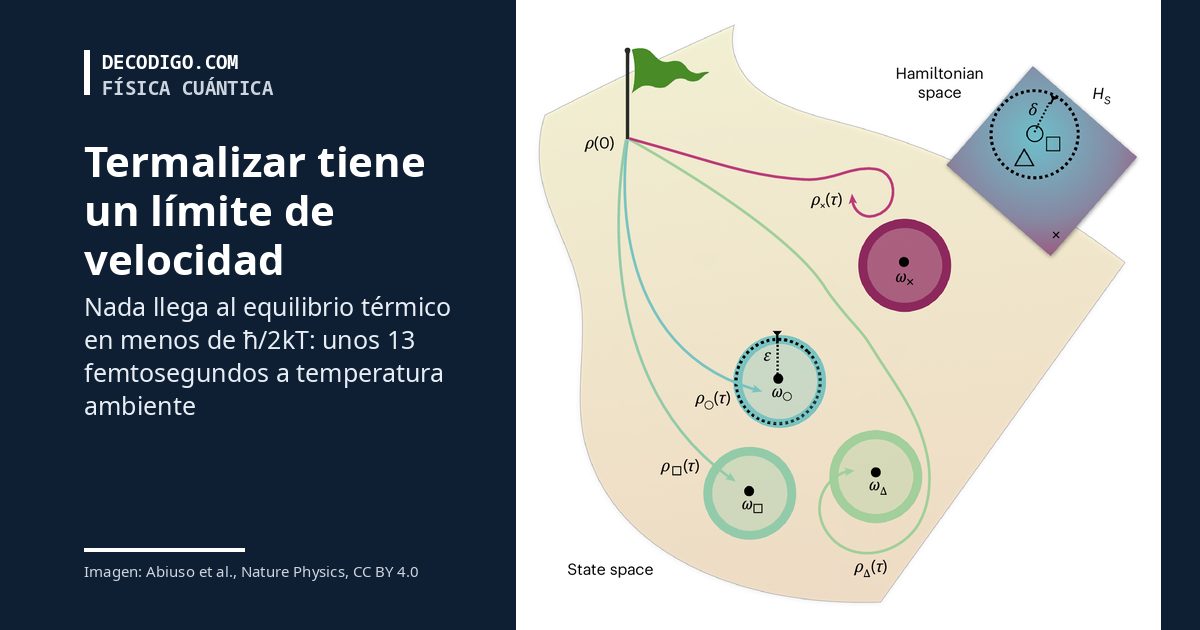
La mecánica cuántica pone un límite de velocidad a la termalización: nada llega al equilibrio térmico en menos de ħ/2kT

Esquema de una máquina de termalizar del artículo de Nature Physics junto al titular: termalizar tiene un límite de velocidad

Un café se enfría en minutos y un cubito de hielo tarda un rato en derretirse, pero ¿podría algo llegar al equilibrio térmico tan rápido como quisiéramos? Un equipo de Viena, Barcelona y Ginebra ha demostrado que no: la mecánica cuántica impone un límite de velocidad, un tiempo mínimo para termalizar, y depende solo de la temperatura y de dos constantes de la naturaleza. A temperatura ambiente son unos 13 femtosegundos.

Termalizar es lo que hace un sistema cuando, por contacto con su entorno, acaba en el estado de equilibrio que corresponde a una temperatura: el café que se pone a la del cuarto, los átomos de un gas que reparten su energía hasta tener la distribución que predice la física estadística. Desde hace dos décadas los físicos sospechaban que ese proceso tiene un límite universal, el llamado tiempo de Planck de la disipación, τPl = ħ/(kBT), donde ħ es la constante de Planck reducida, kB la de Boltzmann y T la temperatura. La idea nació para explicar cómo conducen la electricidad ciertos superconductores por encima de su temperatura crítica, y desde entonces aparecía una y otra vez, pero nadie la había demostrado en general.

El trabajo, firmado por Paolo Abiuso (IQOQI Viena, de la Academia Austríaca de Ciencias), Alberto Rolandi (TU Wien), John Calsamiglia y Martí Perarnau-Llobet (Universitat Autònoma de Barcelona) y Pavel Sekatski (Universidad de Ginebra), se publicó en Nature Physics el 24 de septiembre, en acceso abierto, y se ha difundido en las últimas semanas. Lo resume Perarnau-Llobet en Physics World: «un sistema físico no puede termalizar más deprisa que cierto límite fundamental».

Claves del límite cuántico a la termalización

  • La cifra: a cualquier temperatura finita, el tiempo de termalización τ cumple τ ≥ ħ/(2kBT), la mitad del tiempo de Planck de la disipación. Cuanto más caliente, menor es el mínimo: unos 13 femtosegundos a 300 K, unos 50 a la temperatura del nitrógeno líquido (77 K) y casi un picosegundo a la del helio líquido (4.2 K), según nuestros cálculos con la fórmula del artículo.
  • Cerca del cero absoluto cambia la regla: cuando la temperatura es tan baja que el sistema apenas puede salir de su estado de menor energía, lo que manda es el hueco Δ entre ese estado y el siguiente, y el límite pasa a ser τ ≥ ħ/Δ. Es la misma escala de tiempo que aparece en el teorema adiabático, que dice lo despacio que hay que cambiar un sistema cuántico para que no salte de estado.
  • Una «máquina de termalizar» cualquiera: para que el resultado valga para todo, los autores no modelan un material concreto. Imaginan una máquina que solo cumple dos condiciones: obedece la mecánica cuántica y deja el sistema cerca de su estado térmico. Puede ser todo lo grande y potente que se quiera.
  • La trampa que había que evitar: si se conoce de antemano el sistema, una máquina puede «preparar» su estado térmico casi al instante, por ejemplo intercambiándolo con una copia ya en equilibrio. Por eso la definición exige que la máquina termalice sin conocer con exactitud el sistema: tiene que funcionar para un conjunto de hamiltonianos (la función que describe su energía). «No sabemos cuál es el hamiltoniano del sistema cuántico, pero sí tenemos acceso al sistema», explica Abiuso.
  • La idea vino de la metrología: para dejar un sistema en el estado térmico que le toca, la máquina tiene que reaccionar a cómo es su energía, es decir, obtener información sobre ella. Y la mecánica cuántica limita la rapidez con que se puede ganar esa información: es el límite de Heisenberg, pariente de las relaciones de incertidumbre. La máquina no puede termalizar más rápido de lo que ese límite le deja «aprender».
  • A medio camino entre dos tareas: el trabajo sitúa la termalización entre preparar estados térmicos en un ordenador cuántico (el muestreo de estados de Gibbs) y averiguar el hamiltoniano de un sistema. En palabras de Calsamiglia, termalizar es «más difícil» que lo primero, pero «más fácil» que lo segundo.
  • Comprobado con un modelo: el equipo lo contrasta con la evolución exacta de un modelo de fermiones (un «nivel resonante» acoplado a un baño) y muestra que una máquina muy afinada puede llegar justo al límite para un par de hamiltonianos, así que la cota es alcanzable: no se puede apretar más sin añadir supuestos.
Gráfico del tiempo mínimo para termalizar frente a la temperatura: una recta que baja de unos 3.8 picosegundos a 1 K a unos 3.8 femtosegundos a 1000 K; a temperatura ambiente son unos 13 femtosegundos.El tiempo mínimo para termalizar, según la temperatura1 fs10 fs100 fs1 ps10 ps1 K10 K100 K1000 KTemperatura (escala logarítmica)Tiempo mínimoImposible: ninguna máquina termaliza tan rápidoPosible(los procesos reales suelen ir mucho más lentos)Ambiente, 300 K: 13 fsNitrógeno líquido, 77 K: 50 fsHelio líquido, 4.2 K: 0.9 psLínea: τ = ħ / (2 kB T). Cerca del cero absoluto el límite lo marca el hueco de energía, ħ / Δ.
El límite τ ≥ ħ/(2kBT) de 1 K a 1000 K. Por debajo de la línea no puede termalizar ningún proceso; los reales suelen quedar muy por encima. Cálculo y esquema: decodigo.com, con la fórmula de Abiuso et al.

Un suelo, no un pronóstico: lo que cambia para los cúbits

Conviene no leerlo al revés: el límite no dice que las cosas se enfríen en femtosegundos, sino que nada puede hacerlo más rápido. Una cerveza en la nevera sigue tardando sus buenos minutos, porque el calor tiene que atravesar el vidrio y el líquido. Lo que aporta el trabajo es un suelo firme que hasta ahora era solo una conjetura, deducido con supuestos mínimos y sin depender de cómo esté hecho el sistema.

Donde más puede pesar es en las tecnologías cuánticas. Los ordenadores cuánticos necesitan preparar estados térmicos para simular materiales o resolver problemas de optimización, y enfriar sus cúbits hasta el estado de menor energía antes de cada cálculo. El trabajo pone un mínimo a las dos cosas: para el enfriamiento, el límite ħ/Δ. Como ejemplo, en un cúbit superconductor de unos 5 GHz eso son unos 32 picosegundos, muy por debajo de lo que tardan hoy los métodos reales, así que hay margen para mejorar, pero ya se sabe dónde está el fondo. Es la misma clase de máquinas cuánticas que aparecen en el trabajo de Harvard y QuEra con circuitos diseñados por Claude.

Los autores dejan preguntas abiertas: qué papel tiene el entrelazamiento cuando el sistema está formado por muchas partes, qué ocurre en el límite de sistemas muy grandes y cuánto se pueden acercar las máquinas térmicas reales a la cota. Pero el resultado ya convierte una regla empírica que los físicos usaban desde los años 2000 en un teorema: el equilibrio térmico tiene un tiempo mínimo, y lo fija la propia mecánica cuántica.

Más fuentes: preprint en arXiv, Phys.org y Physics World. Portada: figura 1 del artículo (representación de una máquina de termalizar), de Paolo Abiuso, Alberto Rolandi, John Calsamiglia, Pavel Sekatski y Martí Perarnau-Llobet, licencia CC BY 4.0, colocada junto al texto sin otros cambios.

Fuente: Abiuso et al., «An information-theoretic proof of the Planckian bound for thermalization», Nature Physics (2026)

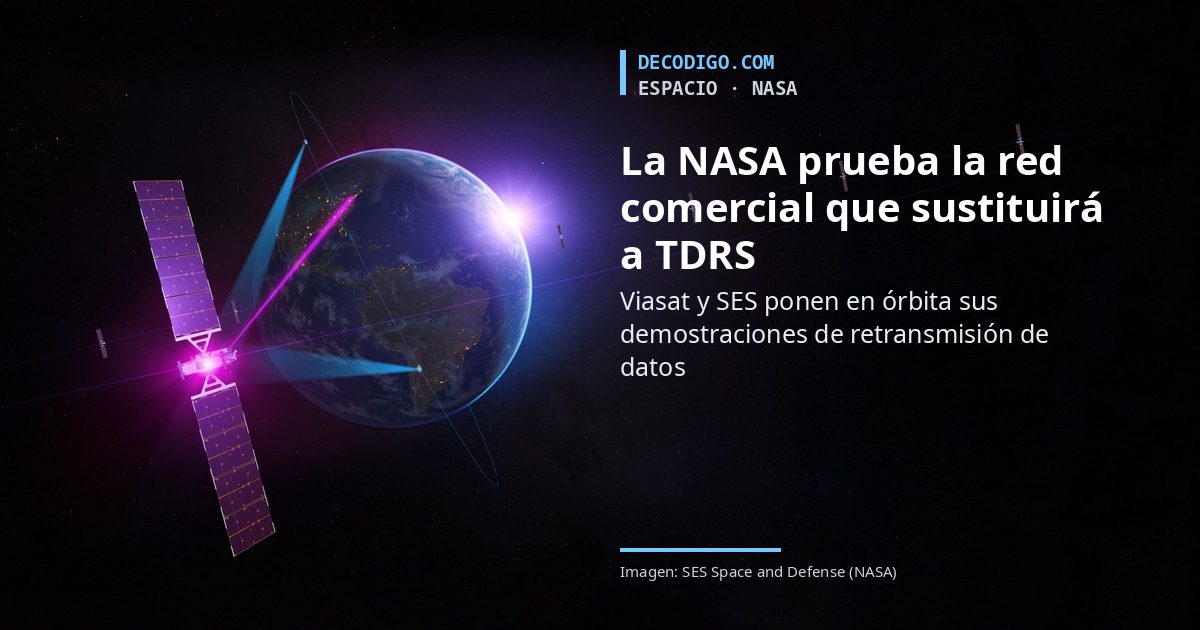
La NASA pone en órbita las pruebas de Viasat y SES para sustituir a TDRS, su red de satélites de comunicaciones

Concepto artístico de SES de un satélite que retransmite datos de naves en órbita baja, con la Tierra al fondo

La NASA ha dado un paso más para dejar de tener su propia red de satélites de comunicaciones. El martes 20 de octubre, un Falcon 9 de SpaceX despegó de Cabo Cañaveral con la misión compartida Bandwagon-5 y dejó en órbita baja dos demostraciones que la agencia financia: la de Viasat, con la nave Maxwell que le ha construido Rocket Lab, y la de SES Space and Defense. En las próximas semanas, las dos intentarán hacer el trabajo que hasta ahora hacen los satélites TDRS de la NASA: recoger los datos de una nave en órbita y hacerlos llegar a tierra.

TDRS (Tracking and Data Relay Satellite) es la red con la que la NASA habla con buena parte de sus misiones cercanas a la Tierra desde 1983, de la Estación Espacial Internacional al telescopio Hubble. Son satélites en órbita alta que hacen de repetidores: una nave que pasa a unos cientos de kilómetros de altura no ve siempre una antena en tierra, pero sí ve casi siempre a un TDRS. En octubre de 2024 la NASA anunció que la flota no aceptaría misiones nuevas: las que ya la usan seguirán con ella hasta mediados de la década de 2030, y las siguientes tendrán que contratar el servicio a empresas privadas.

Para que esas empresas existan, la NASA repartió en 2022 $278.5 millones de USD entre seis compañías dentro de su Communications Services Project (CSP): Inmarsat, Kuiper (de Amazon), SES, SpaceX, Telesat y Viasat. Son acuerdos en los que cada empresa pone al menos tanto dinero como la agencia; la NASA calculó una inversión total de más de $1,500 millones de USD. Lo que acaba de despegar son dos de esas pruebas.

Esquema: hasta ahora, una nave en órbita baja como la ISS o el Hubble envía sus datos a un satélite TDRS de la NASA en órbita alta, que los baja a antenas de la NASA; en las pruebas de Viasat y SES, la nave los envía a satélites comerciales geoestacionarios o de la constelación O3b mPOWER, que los bajan a las antenas de la empresaCómo llegan a tierra los datos de una nave en órbita bajaHasta ahora: la flota TDRS de la NASANave en órbita bajala ISS, el Hubble…Satélite TDRSde la NASA, en órbita altaAntenas de la NASAen tierraSiete TDRS en servicio; la flota empezó en 1983 y desde noviembre de 2024 no admite misiones nuevas.Lo que prueban Viasat y SESNave en órbita bajaMaxwell y la nave de SESSatélites comercialesen órbita alta y mediaAntenas de la empresay de ahí, a la misiónLa NASA dejaría de tener la red y compraría el servicio, como ya hace con la carga y los astronautas.

Claves de las dos demostraciones

  • Viasat y Maxwell: Viasat probará servicios de retransmisión de alta y baja velocidad con Maxwell, una nave de demostración construida por Rocket Lab. Según la NASA, Viasat usará un sistema autónomo que decide por dónde mandar los datos entre Maxwell, sus satélites geoestacionarios y su red mundial de estaciones de tierra. En 2022 recibió $53.3 millones de USD del CSP.
  • SES y dos órbitas a la vez: SES usará su constelación O3b mPOWER, en órbita media, para los datos de alta velocidad, y sus satélites geoestacionarios para los de baja velocidad, entre la nave de demostración y sus estaciones en tierra. Su contrato de 2022 fue de $28.96 millones de USD.
  • Dos tipos de enlace: la NASA necesita los dos. Los de alta velocidad bajan grandes volúmenes, como datos científicos o vídeo en 4K; los de baja velocidad sirven para seguir la nave y enviarle órdenes básicas.
  • Lo que se quiere demostrar: una conexión continua. Según Aerospace America, con TDRS hay cortes breves cuando una nave pasa de un satélite repetidor a otro; Skylar Cox, de Viasat, habla de una comunicación «siempre encendida» que empieza a ser una opción real.
  • Calendario: el proyecto, que dirige el Glenn Research Center de la NASA en Cleveland, seguirá probando estas capacidades con la industria hasta 2027. La agencia quiere tener servicios comerciales validados para su red de comunicaciones cercana a la Tierra en 2031.
  • Los otros cuatro: SpaceX ($69.95 millones de USD) y Kuiper ($67 millones de USD) proponían enlaces láser con sus constelaciones de órbita baja; Telesat ($30.65 millones de USD) e Inmarsat ($28.6 millones de USD), redes de radio en órbita geoestacionaria y baja.

Comprar el servicio en lugar de tener la red

La idea no es nueva para la NASA. Es la misma que aplicó a la carga y a los astronautas de la estación espacial: en vez de diseñar, construir y operar sus propios vehículos, paga a empresas para que lo hagan y se queda como cliente. Así lo explicó el responsable del proyecto, Eli Naffah, cuando se firmaron los acuerdos en 2022. Con las comunicaciones, la apuesta es que las redes que Viasat, SES y compañía ya explotan para otros clientes atiendan también a naves espaciales, y que a la agencia le salga más barato que mantener una flota propia.

El calendario aprieta. Los siete TDRS que siguen en servicio se irán retirando según el estado de cada uno, y la NASA no piensa sustituirlos. Las demostraciones del CSP debían terminar en 2025 y llegan con retraso, mientras las misiones nuevas ya no pueden apuntarse a TDRS. Si las pruebas de Viasat y SES salen bien, serán de las primeras naves de la NASA en enviar sus datos a casa por una red que no es de la NASA.

Más fuentes: NASA, acuerdos del Communications Services Project (2022), NASA, retirada de la flota TDRS (2024) y Aerospace America. Portada: concepto artístico de los servicios de retransmisión de SES para naves en órbita baja, imagen de SES Space and Defense publicada por la NASA.

Fuente: NASA, «Two NASA Commercial Satellite Communication Demonstrations Launch», 20 de octubre de 2026

Google «cultiva» estados mágicos en su chip cuántico Willow: 40 veces menos errores en una de las piezas más caras del ordenador cuántico

El chip cuántico Willow de Google sobre la palma de un guante blanco de laboratorio

Google Quantum AI ha demostrado en su procesador Willow que el «cultivo» de estados mágicos funciona en un chip real. Los estados mágicos son la pieza que necesita un ordenador cuántico para hacer cualquier cálculo, no solo los fáciles, y fabricarlos sin errores es de lo más caro del oficio. Con el cultivo, el error de esos estados baja unas 40 veces y la fidelidad llega a al menos el 99.99 %. El trabajo se publicó el 15 de octubre en la revista Science.

Un ordenador cuántico útil tiene que corregir sus propios errores, y para eso codifica cada cúbit «lógico» en muchos cúbits físicos. Con esa protección, las operaciones más sencillas, las llamadas de Clifford, salen relativamente baratas. Pero con ellas solas no se puede hacer nada que un ordenador normal no pueda simular. Para dar el salto hace falta otra operación, la puerta T, y la forma práctica de aplicarla con corrección de errores es consumir un estado mágico preparado aparte. Cada uno sirve una sola vez, y un algoritmo grande necesita millones.

El método clásico para fabricarlos, la destilación, se conoce desde 2004: se toman muchos estados con errores y se combinan para sacar unos pocos más limpios. Funciona, pero cuesta tanto que, según Google, algunas estimaciones reservan para ella hasta el 95 % de la capacidad de la máquina. En 2024, tres investigadores de Google, Craig Gidney, Noah Shutty y Cody Jones, propusieron una alternativa sobre el papel: el cultivo. Ahora lo han probado en el hardware.

Destilación frente a cultivo de estados mágicos. La destilación combina muchos estados con errores en una fábrica aparte para sacar unos pocos más limpios, y puede llevarse gran parte de la capacidad del ordenador. El cultivo inyecta un solo estado en un código pequeño, lo comprueba varias veces, descarta los intentos con errores y pasa el estado limpio a un código mayorDos formas de conseguir un estado mágico limpioDestilación (el método clásico)Muchos estadostodos con erroresFábricabloques de cúbits aparteSe combinany se mide el resultadoPocos estadosmás limpiosFunciona, pero es caro: según Google, podría llevarse hasta el 95 % de la capacidad de la máquina.Cultivo (probado ahora en Willow)Un estadoinyectado con ruidoComprobacionesen un código pequeño¿Algún error?se descarta y se repiteEstado limpiopasa a un código mayorOcupa poco más que una operación normal; a cambio, en Willow solo sobrevive un 8 % de los intentos.
Destilar frente a cultivar: la destilación combina muchos estados malos en una fábrica aparte; el cultivo comprueba uno solo, descarta los intentos con errores y pasa el estado limpio a un código mayor. Esquema: decodigo.com.

Claves del cultivo de estados mágicos en Willow

  • Un filtro, no una fábrica: el cultivo inyecta un estado ruidoso en una zona pequeña del chip, un código de color de distancia 3 con siete cúbits de datos, y le hace una serie de comprobaciones. Si alguna detecta un error, el intento se tira y se empieza de nuevo. Lo que pasa todos los filtros es un estado mucho más puro.
  • 40 veces menos error: comparado con inyectar el estado sin cultivarlo, el error baja unas 40 veces. El error lógico del circuito completo queda entre 1 y 2 por cada 10,000, por debajo del de cada una de las 216 puertas de dos cúbits y las 54 medidas que lo forman.
  • El precio, en intentos: para llegar a esa fidelidad solo se conserva el 8 % de los intentos; el resto se descarta. Es el peaje del método, y lo que tendrán que bajar los siguientes experimentos.
  • Una medida que se medía mal: durante las pruebas, la investigadora Emma Rosenfeld obtenía datos que parecían imposibles. Tras meses de comprobaciones, el culpable resultó ser el ruido del propio laboratorio, por la deriva de los equipos eléctricos y los cambios de temperatura, que invalidaba la técnica de medida habitual. El equipo inventó otra que usa el propio cultivo para medirse a sí mismo, y afinó la calibración del chip con aprendizaje por refuerzo.
  • Del código pequeño al grande: un estado mágico no sirve de mucho encerrado en un código de distancia 3. Por eso el equipo también lo «injertó» en un código de superficie de distancia 5, el tipo de código que Google usa para sus cúbits lógicos, en un experimento con 54 cúbits. Fue una primera prueba de que el estado sobrevive al cambio.
  • Willow, el mismo chip: es el procesador de 105 cúbits superconductores que Google presentó en 2024. Según el artículo, la fidelidad obtenida es parecida a la de las mejores demostraciones con iones atrapados, pero con la velocidad de los circuitos superconductores.

Un cuello de botella que se abre, pero no se rompe el cifrado

Lo importante no es la cifra récord, sino el coste. El artículo teórico de 2024 calculaba que el cultivo usa más o menos las mismas puertas que una operación CNOT de la misma fiabilidad, y se atrevía a decir que, en la práctica, quizá nunca haga falta volver a destilar. Si eso se confirma a mayor escala, la parte del ordenador cuántico dedicada a fabricar estados mágicos se reduce mucho, y con ella el tamaño de la máquina necesaria para problemas útiles. Además, el método mejora deprisa con el hardware: según el artículo, la infidelidad cae con el cubo del ruido de los cúbits, así que reducir ese ruido a la mitad la bajaría a unos 2 por cada 100,000.

Conviene no confundirlo con una amenaza inmediata para el cifrado. Willow tiene 105 cúbits, y la estimación más conocida para romper una clave RSA de 2048 bits, publicada por el propio Gidney en 2025, habla de menos de un millón de cúbits con ruido. El cultivo abarata una parte de esa cuenta, pero la distancia sigue siendo de varios órdenes de magnitud. Tampoco está todo resuelto en el propio experimento: cuando el estado ya injertado se dejó esperando en el código de superficie, sus errores fueron unas siete veces mayores de lo que predecían las simulaciones, probablemente por fugas de los cúbits a niveles de energía que no deberían ocupar. Google lo reconoce: falta demostrar el cultivo a mayor escala y quedan muchos retos técnicos.

La carrera por abaratar las operaciones cuánticas avanza por varios frentes a la vez. Hace unos días contamos cómo Claude diseñó, con Harvard y QuEra, circuitos cuánticos más eficientes que los mejores publicados.

Google ha convertido una idea de 2024 en un experimento: en un chip real, el cultivo da estados mágicos con un error de alrededor de uno por cada 10,000, 40 veces menos que sin él. Es un paso pequeño en tamaño y grande en coste, porque ataca el gasto que más pesaba en los planos de un ordenador cuántico corregido. El siguiente reto es repetirlo a más escala y con menos intentos descartados.

Más fuentes: artículo en Science, preprint del experimento en arXiv y propuesta teórica del cultivo (Gidney, Shutty y Jones, 2024). Imagen de portada: el chip Willow, imagen de Google Quantum AI.

Fuente: Google, «Bringing the magic: Google breaks open a bottleneck in quantum computing», 15 de octubre de 2026

REA 6.7: la herramienta de ingeniería inversa para agentes de IA suma Kuna y lleva Ghidra a Windows ARM y al 68000

Procesador Motorola 68000 de Thomson abierto, con el chip a la vista, junto al titular de REA 6.7

REA, la herramienta de código abierto que pone a los agentes de IA a hacer ingeniería inversa, ya va por REA 6.7. La versión 6.7.0, publicada el 18 de octubre, reúne los cambios de la 6.6.0: un descompilador nuevo, Kuna; Ghidra para programas de Windows en ARM y para volcados del veterano procesador 68000; y consultas sobre análisis ya hechos sin tener que repetirlos.

Contamos qué es REA en la noticia de su lanzamiento y qué programas se han abierto con ella en este repaso. En resumen, le da a un agente como Claude Code, Codex o Cursor las herramientas para abrir programas de los que no hay código fuente y explicar, con pruebas, cómo funcionan. El proyecto sigue creciendo a un ritmo poco común: el 21 de octubre tenía 354,849 estrellas en GitHub, unas 53,000 más que cuatro días antes.

Claves de REA 6.6 y 6.7

  • Kuna, un descompilador más. Es libre (licencia Apache-2.0) y se distribuye como un único ejecutable. REA no lo descarga ni lo instala: lo pones tú y le indicas su ruta con REA_KUNA_COMMAND. Analiza sin ejecutar nada y sirve, por ahora, para programas de Linux y de Mac (ELF y Mach-O de x86-64, AArch64 y ARM); Windows no está soportado.
  • Ghidra llega a Windows en ARM. REA ya puede abrir con Ghidra aplicaciones y bibliotecas de Windows compiladas para ARM (ARM64 y ARM de 32 bits), siempre trabajando desde un Windows x64.
  • Y al 68000. También admite volcados en bruto del Motorola 68000, el procesador de Amiga, Mega Drive y los primeros Mac, si se le indica dónde empieza el código. Solo está comprobado en macOS.
  • Consultas sin repetir el análisis. Sobre una app de JavaScript ya analizada se pueden pedir rutas exactas, propiedades o referencias a módulos, y de una app de Android, las tablas de textos de varios idiomas a la vez.
  • Menos trabajo perdido. Si un análisis se cancela o falla al limpiar, REA conserva lo que ya había comprobado y el motivo exacto del fallo.
  • La 6.6.0 no llegó a npm. Se etiquetó en GitHub, pero quien instala desde npm pasa de la 6.5.0 a la 6.7.0, que además corrige un fallo al editar la configuración de los agentes: si el archivo repetía la entrada de REA, el instalador cambiaba una distinta de la que lee el agente.

Más motores para no depender de uno

Kuna se suma a los motores que REA ya sabía usar, como Ghidra, Hopper, IDA o JADX para Android. Para quien analiza programas de Linux o de Mac, eso significa poder contrastar el resultado de Ghidra con el de otro descompilador libre sin salir del mismo flujo de trabajo: las peticiones son las mismas (funciones, pseudocódigo, llamadas, cadenas) y basta indicar el motor con --provider kuna. El soporte de Windows en ARM llega cuando cada vez más portátiles con Windows usan chips ARM, y el del 68000 interesa sobre todo a quien preserva o estudia juegos y programas antiguos. Las limitaciones están escritas en las propias notas: cada novedad dice en qué sistema se ha comprobado y qué queda sin verificar.

Para actualizar, si lo instalaste con npm basta rea update; con npx, la siguiente ejecución de npx -y rea-agents@latest ya descarga la 6.7.0, como comprobamos en un contenedor. Después conviene repetir rea setup y reiniciar el agente. Hemos puesto al día nuestra guía práctica de REA con todas sus pruebas repetidas en la 6.7.0, donde rea doctor ya pregunta por Kuna.

Notas de las versiones 6.6.0 y 6.7.0 y guía de Kuna del proyecto. Portada: un procesador 68000 de Thomson abierto, foto de yellowcloud, licencia CC BY 2.0, Wikimedia Commons.

Fuente: morluto/rea en GitHub, rea-agents 6.7.0, 18 de octubre de 2026

Reliable Robotics, la empresa que automatiza el Cessna Caravan, suma $115 millones de USD y ya vale más de $1,000 millones

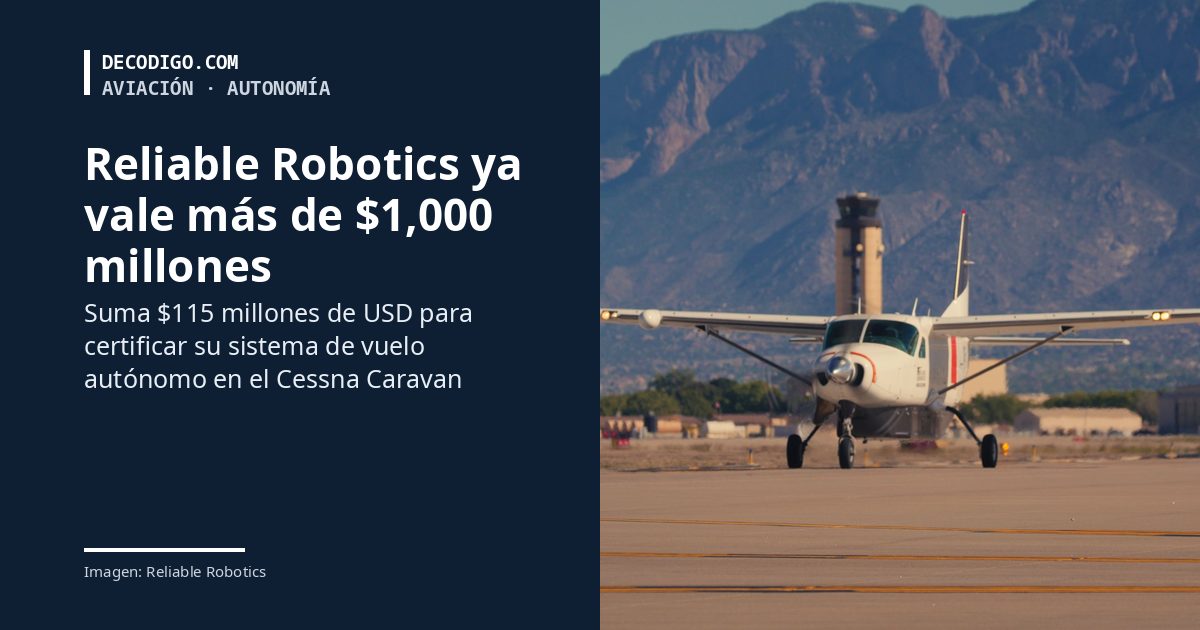
El Cessna 208B Grand Caravan automatizado de Reliable Robotics en la pista del aeropuerto de Albuquerque, con la torre de control y las montañas detrás

Reliable Robotics, la empresa californiana que convierte el avión de carga Cessna 208B Grand Caravan en una aeronave que despega, vuela y aterriza sola, ha sumado $115 millones de USD a su ronda Serie D y supera ya los $1,000 millones de USD de valoración. Un día después del anuncio, completó sus primeros vuelos automatizados en un gran aeropuerto comercial, el de Albuquerque, con el piloto al mando a más de 700 millas (unos 1,100 km) de distancia.

Reliable lleva casi una década en Mountain View desarrollando su tecnología. Su consejero delegado y cofundador, Robert Rose, dirigió el software de vuelo de SpaceX y antes trabajó en Tesla y Google; su director técnico, Juerg Frefel, pasó casi una década como ingeniero en SpaceX. Su apuesta no es diseñar un avión nuevo, sino un sistema que se instala en aviones ya certificados y que funciona con la infraestructura de hoy: los mismos aeropuertos, el mismo control aéreo, sin cambiar nada del espacio aéreo. En abril cerró una Serie D de $160 millones de USD liderada por Nimble Partners, el fondo de John Burbank, con la entrada de inversores como AE Ventures, socio estratégico de Boeing, RTX Ventures y Socium Ventures, de Cox Enterprises.

Ahora la amplía. Según la nota de prensa de la empresa, la demanda de los inversores la llevó a sumar $115 millones de USD más, de los que $25 millones de USD son un préstamo de Silicon Valley Bank; TechCrunch cifra el capital en $90 millones de USD. La Serie D llega así a $275 millones de USD, y lo recaudado desde su fundación pasa de $380 millones de USD. El dinero servirá para ampliar su flota de aviones y sus instalaciones de producción y para contratar ingenieros: la plantilla supera ya las 250 personas y abre oficinas en Seattle y San Diego.

Claves de la ronda de Reliable Robotics

  • Quién pone el dinero: repite como líder Nimble Partners. Entran Gideon Capital, RockCreek, Geek Ventures, Gold Hill Capital y Sparkwave Capital, y vuelve Island Green Partners. El préstamo es de Silicon Valley Bank.
  • Qué vende: el Reliable Autonomy System (RAS), que automatiza el avión «de puerta a puerta»: rodaje, despegue, ruta y aterrizaje. Su objetivo es evitar las causas más comunes de accidentes, como la pérdida de control y el vuelo controlado contra el terreno.
  • Dónde está con la FAA: la empresa dice tener el único plan de certificación aceptado por la FAA, con los medios de cumplimiento acordados y los documentos de cuestiones abiertas ya cerrados, para un piloto automático que no se desconecta en todo el vuelo. Rose calcula, según TechCrunch, que esa primera certificación, con piloto a bordo, llegará en 18 a 24 meses.
  • El piloto, en tierra: el siguiente paso es sacar al piloto de la cabina y llevarlo a una estación en tierra. Rose lo sitúa a «al menos tres años».
  • Un radar propio: como ningún proveedor tradicional quiso hacerlo, Reliable diseñó un radar anticolisión de estado sólido, sin piezas móviles, que espera certificar a finales de 2027. El equipo pasó «de cero a pruebas en vuelo en 24 meses», y ahora tendrá un centro dedicado en Seattle.
  • Clientes: en abril la empresa hablaba de compromisos por más de 200 sistemas de clientes comerciales y militares. Tiene contratos con varias ramas del ejército de Estados Unidos, entre ellos uno con la Fuerza Aérea para carga automatizada en el Indo-Pacífico.
  • Su propia aerolínea: Reliable Airlines, con base en Albuquerque, ya transporta carga seis días a la semana con seis Cessna Caravan.

Lo difícil no es volar solo, es certificarlo

Que un avión aterrice solo no es nuevo: los grandes aviones de pasajeros lo hacen con niebla desde hace décadas, siempre con dos pilotos vigilando. Lo que nadie ha conseguido todavía es que la FAA certifique un sistema que lleve el avión de puerta a puerta para uso comercial, primero sin depender del piloto y después sin piloto a bordo. Reliable ha elegido el camino lento: un avión muy común, un sistema pensado desde el principio para pasar la certificación y pasos graduales, primero con piloto a bordo y después con piloto en tierra.

Los vuelos de esta semana muestran por dónde va. Durante dos días, el Caravan de Reliable rodó, despegó y aterrizó por sí solo en el aeropuerto internacional de Albuquerque, el mayor de Nuevo México, que comparte pista con tráfico militar. El piloto que hablaba con la torre y daba las órdenes estaba en la sede de Mountain View; a bordo iba un piloto de seguridad. Los vuelos se hicieron dentro del programa piloto eIPP del Departamento de Transporte y la FAA, en el que el aeropuerto es uno de los ocho participantes del país. El plan es que Reliable Airlines haga después rutas diarias de carga a Durango (Colorado) y Santa Fe (Nuevo México), comunidades pequeñas que hoy tienen pocas conexiones.

«Cada vuelo de prueba aporta datos clave para construir un sistema que refuerce la infraestructura del país y conecte comunidades», dijo el administrador de la FAA, Bryan Bedford. Y Rose resume así el avance hacia la certificación: «Seguimos progresando y entregando pruebas a la FAA, y cada día nos acercamos un poco más».

Para quienes programan, el caso tiene otra lectura. Igual que en el software de vuelo de SpaceX, de donde viene su fundador, aquí el código es el producto, y la certificación aeronáutica exige demostrar, línea a línea, qué hace y cómo se comporta cuando algo falla. Entre las vacantes que anuncia Reliable para sus oficinas nuevas abundan los ingenieros de software de vuelo, de verificación y de simulación.

Con más de $1,000 millones de USD de valoración, Reliable entra en el club de las empresas emergentes «unicornio» de la aviación autónoma. Su reto ahora no es técnico, sino de calendario: convertir los planes aceptados en una certificación real antes de que se agote el dinero. Si cumple sus propios plazos, el primer Caravan automatizado certificado podría estar certificado hacia 2028, y el vuelo sin nadie en la cabina llegaría algo más tarde.

Más fuentes: TechCrunch, los vuelos en Albuquerque (Reliable), la ronda de abril (Reliable) y las oficinas de Seattle y San Diego (Reliable). Portada: el Cessna 208B Grand Caravan automatizado de Reliable en el aeropuerto de Albuquerque, imagen de Reliable Robotics publicada con su nota sobre los vuelos en Albuquerque.

Fuente: Reliable Robotics, «Reliable Robotics Secures $115M in New Capital», 20 de octubre de 2026

TypeScript 7.1 beta: el compilador en Go estrena API, compila más rápido y gasta hasta la mitad de memoria

Edificio 92 del campus de Microsoft en Redmond con el logotipo de TypeScript y el titular de la beta de TypeScript 7.1

Microsoft ha publicado la beta de TypeScript 7.1, la primera versión con novedades de peso desde que el compilador se reescribió en Go. Trae lo que más se echaba en falta en la 7.0: una API para crear herramientas sobre el compilador nuevo. Además, añade un sistema de complementos para que Vue, Svelte o Astro se revisen igual que un archivo .ts, reconoce ECMAScript 2026 y compila hasta 1.9 veces más rápido que la 7.0 en proyectos grandes. Se instala con npm install -D typescript@beta.

TypeScript 7.0, publicada en julio, cambió el compilador escrito en TypeScript por uno escrito en Go, unas diez veces más rápido según Microsoft. El precio fue dejar fuera la API de JavaScript que usaban linters, empaquetadores y extensiones de editor para preguntarle cosas al compilador: quien la necesitaba tenía que seguir con TypeScript 6. Por eso el editor en el navegador de nuestro curso de TypeScript usa todavía la 6.0.3.

Hemos instalado la beta en un contenedor con Node 24: npm ya la ofrece con la etiqueta beta (versión 7.1.0-beta), mientras que latest sigue siendo la 7.0.2. Los mensajes de error de esta noticia salen de ejecutar tsc --locale es con esa versión.

Claves de TypeScript 7.1

  • Vuelve la API, con otra forma: ya no es un único módulo, sino varios puntos de entrada: typescript/sync (un cliente síncrono con el programa y el revisor de tipos), typescript/async (lo mismo con promesas), typescript/fs (sistemas de archivos virtuales) y typescript/ast (el árbol de sintaxis, sus comprobaciones y su fábrica de nodos).
  • Hay que liberar los objetos: la API habla con el compilador en Go, así que el recolector de basura de JavaScript no basta. Cada objeto se cierra a mano o se declara con using, la palabra nueva de JavaScript que lo libera al salir del bloque.
  • Instantáneas: un snapshot guarda el estado de todos los proyectos en un momento dado; al cambiar un archivo se deriva uno nuevo sin reconstruirlo todo, y el anterior sigue disponible.
  • «Content mappers»: complementos que traducen un archivo .vue, .svelte o .astro a lo que TypeScript entiende y señalan qué trozo corresponde a qué línea del original. Es el modelo de Volar, que ahora el compilador adopta como propio. Ya hay prototipos para Astro, CSS Modules, Ember, MDX, Svelte y Vue.
  • Atributos de importación en los módulos ambientales: se puede declarar qué tipo devuelve un import … with { type: "text" } y TypeScript avisa si se olvida el atributo.
  • import source: soporte para esta propuesta de ECMAScript, que devuelve un módulo ya analizado pero sin ejecutar. Su uso práctico hoy es WebAssembly: el resultado se pasa tal cual a WebAssembly.instantiate.
  • ECMAScript 2026: --target es2026 y --lib es2026 pasan a ser estables, con Math.sumPrecise(), Error.isError(), getOrInsert() en Map, base64 y hexadecimal en Uint8Array o Array.fromAsync().
  • Más rápido y con menos memoria: más de cuarenta optimizaciones. En la documentación de MUI, la revisión pasa de 22.2 a 11.9 segundos y de 8,093 a 4,079 MiB.
  • Una regla de tipos más estricta: código que compilaba con la 7.0 puede dar un error nuevo, como se ve más abajo.

La API, probada

El ejemplo del anuncio crea un programa en un sistema de archivos que solo existe en memoria. Lo hemos reducido a lo mínimo: un archivo virtual que asigna un texto a una variable number, y la pregunta de cuántos errores tiene. Node 24 lo ejecuta directamente desde el .mts, sin compilar, porque borra los tipos al cargarlo:

import { API } from "typescript/sync";
import { createFileSystemWithLib } from "typescript/fs";
import { resolve } from "node:path";

const f = resolve("virtual.ts");
using api = new API();
using snap = api.createSnapshot({
  fileSystem: createFileSystemWithLib([[f, 'export const respuesta: number = "cuarenta y dos";']]),
  createPrograms: [{ rootFiles: [f], compilerOptions: { strict: true, noEmit: true } }],
});
using prog = snap.operation.createdPrograms[0];
console.log("errores:", prog.getSemanticDiagnostics().length);
node api.mts  (Node 24.22, typescript 7.1.0-beta)errores: 1

Por dentro, la API no ejecuta el compilador en JavaScript: arranca el binario nativo de Go que trae el paquete y se comunica con él por tuberías. Por eso es rápida y por eso hay que cerrar cada objeto. También explica que no sirva todavía en un navegador: el paquete no incluye una versión en WebAssembly.

Lo nuevo en el día a día

Los atributos de importación ya permitían cargar un texto, unos bytes o una hoja de estilos con with { type: … }, pero los tipos se declaraban por extensión (*.md, *.txt…), así que nada impedía olvidar el atributo. Ahora la declaración va por atributo:

// tipos.d.ts
declare module "*" with { type: "text" } {
    const content: string;
    export default content;
}

// main.ts
import leeme from "./LEEME.md" with { type: "text" };
import olvido from "./LEEME.md";
const mal: number = leeme;
npx tsc --noEmit --strict --module esnext --moduleResolution bundler --locale es tipos.d.ts main.tsmain.ts(2,20): error TS2307: No se encuentra el módulo "./LEEME.md" ni sus declaraciones de tipos correspondientes.
main.ts(3,7): error TS2322: El tipo 'string' no se puede asignar al tipo 'number'.

El primer error es el import sin atributo; el segundo demuestra que leeme ya llega como string. Microsoft aclara que estas declaraciones no vienen incluidas en TypeScript: cada proyecto las escribe según su entorno, y recomienda que las bibliotecas no las publiquen.

Con ECMAScript 2026 pasa algo parecido a cada año: lo que estaba en esnext se estabiliza. Un archivo que usa Math.sumPrecise, getOrInsert y Error.isError compila sin errores con --target es2026; con es2025, el compilador explica qué cambiar:

const total = Math.sumPrecise([0.1, 0.2, 0.3]);
const veces = new Map<string, number>();
veces.set("a", veces.getOrInsert("a", 0) + 1);
console.log(total, veces, Error.isError(new Error("x")));
npx tsc --noEmit --strict --target es2025 --locale es es2026.tses2026.ts(1,20): error TS2550: No existe la propiedad "sumPrecise" en el tipo "Math". ¿Necesita cambiar la biblioteca de destino? Pruebe a cambiar la opción del compilador "lib" a "es2026" o posterior.
es2026.ts(3,22): error TS2550: No existe la propiedad "getOrInsert" en el tipo "Map<string, number>". ¿Necesita cambiar la biblioteca de destino? Pruebe a cambiar la opción del compilador "lib" a "es2026" o posterior.
es2026.ts(4,33): error TS2550: No existe la propiedad "isError" en el tipo "ErrorConstructor". ¿Necesita cambiar la biblioteca de destino? Pruebe a cambiar la opción del compilador "lib" a "es2026" o posterior.

El cambio que puede romper algo afecta a los tipos condicionales que se distribuyen sobre una unión. Dentro de cada rama, el parámetro ya no se trata como el original, sino como un trozo de él, sin relación con otros tipos que dependían del original. Es el ejemplo del anuncio, que la 7.0 aceptaba:

type Show<A extends number, B extends A> = `${B} extends ${A}`;

type Issue<A extends number, B extends A> =
    A extends B ?
        never :
        Show<A, B>;
npx tsc --noEmit --strict --locale es distrib.tsdistrib.ts(6,17): error TS2344: El tipo 'B' no cumple la restricción 'A'.
  'B' solo se puede asignar al 'A' no distribuido, pero 'A' se ha distribuido aquí.

La 7.0 dejaba escribir Issue<0 | 1, 0> y producía el tipo "0 extends 1", que es falso. Microsoft lo explica con animales: un gato es un animal, pero no es cualquier animal.

Qué gana quien escribe herramientas (y qué falta)

Para quien solo usa tsc, la 7.1 es sobre todo velocidad y memoria: en las pruebas de Microsoft, con cuatro hilos de revisión, el ahorro de tiempo va del 13 % en Bluesky al 47 % en la documentación de MUI, y la memoria baja entre un 16 % y un 50 %. Para el ecosistema, lo importante es la API: sin ella, los linters, empaquetadores y extensiones que se apoyan en el compilador no podían usar el de Go. Ahora tienen una vía, aunque distinta de la de la versión 6, así que tendrán que adaptarse.

Los content mappers resuelven un problema viejo de Vue o Svelte: Volar daba buena ayuda en el editor, pero la revisión desde la línea de órdenes iba por otro camino. Con la 7.1, el mismo complemento sirve para los dos. Como son programas externos que el compilador ejecuta, hay que permitirlo: en la terminal, con tsc --runExternalCode; en VS Code, aceptando la confianza en el espacio de trabajo y los permisos del complemento.

En el editor de decodigo no cambia nada por ahora: necesita un compilador que funcione dentro del navegador, y la API de la 7.1 depende de un binario nativo. Lo que se aprende en el curso sirve igual con la 7.1: la regla nueva de tipos distribuidos es el único cambio de comportamiento que destaca el anuncio, y solo aparece en código muy avanzado.

Microsoft dedicará las próximas semanas a estabilidad y rendimiento. La versión candidata llegará en aproximadamente un mes y la definitiva poco después. Hasta entonces, la beta es para probarla en una rama aparte, no para producción.

Más fuentes: la versión 7.1 beta en GitHub y los cambios de atributos de importación, de tipos distribuidos y de content mappers. Portada: edificio 92 del campus de Microsoft en Redmond, foto de Coolcaesar, licencia CC BY-SA 4.0, Wikimedia Commons; logotipo de TypeScript, marca de Microsoft, Wikimedia Commons.

Fuente: Microsoft, «Announcing TypeScript 7.1 Beta», 20 de octubre de 2026

PHP saca un parche de emergencia para dos fallos críticos que permiten tomar el control del servidor sin iniciar sesión

El elePHPant, la mascota de PHP, junto al titular del parche de emergencia de PHP

PHP publicó este miércoles un parche de emergencia de PHP para todas sus ramas con soporte: 8.5.12, 8.4.27, 8.3.36 y 8.2.35. Corrigen dos fallos críticos, con una puntuación de 9.2 sobre 10, que permiten ejecutar código en el servidor sin autenticarse. El equipo de PHP pide actualizar de inmediato y avisa de que no hay ninguna medida que proteja del todo: «actualizar es la única opción segura».

El aviso llegó con un día de antelación. El martes, el equipo de seguridad de PHP anunció una versión de seguridad para el 21 de octubre a las 14:00 UTC, sin dar detalles, y se reservó el derecho de adelantarla si los fallos se hacían públicos o si aparecían ataques reales. Antes de que saliera, la empresa de seguridad watchTowr ya decía haber reproducido uno de ellos, y su director, Benjamin Harris, aseguró a la prensa que eran reales y que afectaban a versiones de PHP hasta la 5. El parche salió a su hora, junto con dos avisos técnicos en GitHub.

PHP es el lenguaje con el que funcionan WordPress, Drupal, Laravel, Moodle y buena parte de los servidores web del mundo. Por eso un fallo que se puede explotar con una simple petición HTTP, sin usuario ni contraseña, es de lo más grave que le puede pasar.

Claves del parche de emergencia de PHP

  • Dos fallos, CVE-2026-109618 y CVE-2026-109619: los dos tienen gravedad crítica (CVSS 4.0 de 9.2) y permiten ejecución remota de código sin autenticar. Afectan a todas las versiones anteriores a las publicadas hoy.
  • El primero, al quedarse sin memoria: cuando una petición agota la memoria, PHP la aborta de golpe. Si eso ocurre justo cuando los datos internos de la petición están a medio preparar, el cierre de la petición los trata después como válidos. Un atacante puede provocarlo con formularios de subida de archivos manipulados, por ejemplo con miles de cabeceras en una sola parte, sin pasar los límites aparentes de PHP.
  • El segundo, con memoria ya liberada: parte del estado interno de PHP sobrevive a una petición y sigue apuntando a memoria que ya se liberó. Si el mismo proceso atiende otra petición y la usa antes de reiniciarla, el atacante puede aprovecharlo. El ataque demostrado usa dos peticiones distintas que caen en el mismo proceso.
  • Quién está en riesgo: toda instalación de PHP que sirva páginas web: PHP-FPM, Apache con mod_php, php-cgi, FrankenPHP y LiteSpeed. El riesgo es mayor con mod_php, donde hay un ataque demostrado que se dispara antes de que se ejecute una sola línea de la aplicación. En FPM, el análisis del código indica que también es vulnerable, aunque no se ha demostrado un ataque completo.
  • Versiones antiguas: PHP 8.1 y anteriores ya no reciben actualizaciones del proyecto. Aun así, por la gravedad, el equipo de PHP ha dejado parches mínimos de código fuente para 7.4, 8.0 y 8.1, pensados para quien compila PHP por su cuenta. Las distribuciones y los proveedores de soporte extendido recibieron los parches por adelantado.
  • PHP 8.2 tiene fecha de caducidad: el anuncio de la 8.2.35 recuerda que esa rama deja de recibir parches de seguridad el 31 de diciembre de 2026.

Qué hacer si tienes un sitio en PHP

Lo primero es saber qué versión usa el servidor. En la línea de órdenes basta con php -v, pero ojo: el PHP de la consola puede no ser el mismo que sirve la web. Lo seguro es mirarlo desde el propio sitio (en WordPress, en Herramientas → Salud del sitio → Información → Servidor) o preguntar al proveedor de alojamiento.

  • Si tu servidor es tuyo: actualiza a 8.5.12, 8.4.27, 8.3.36 o 8.2.35 con los paquetes de tu distribución o desde php.net, y reinicia PHP-FPM o Apache para que los procesos carguen la versión nueva.
  • Si usas contenedores: reconstruye las imágenes cuando haya versión corregida. La imagen oficial php:8.5-cli de Docker Hub tardó unas tres horas en pasar a la 8.5.12 (lo hizo hacia las 16:55 UTC del 21 de octubre): comprueba que tu imagen base ya no es la 8.5.11.
  • Si tienes un alojamiento compartido: la actualización depende del proveedor. Conviene comprobar que la aplica y, si el panel deja elegir la versión de PHP, no quedarse en una rama sin soporte.
  • Si no puedes actualizar todavía: el aviso oficial propone medidas que reducen algunos caminos de ataque, pero insiste en que no hacen segura una instalación. Entre ellas: desactivar session.upload_progress.enabled en php.ini o en el pool de FPM y reiniciar todos los procesos; bajar post_max_size a 8 MB si no hay subidas de archivos; y limitar en el servidor web o el proxy el tamaño de las peticiones, sus campos y sus cabeceras. Ponerlas con ini_set() o en un .user.ini no sirve, porque el ataque ocurre antes, y ocultar los errores tampoco ayuda.

Los avisos técnicos se publicaron con todos los detalles a la vez que el parche, así que es cuestión de tiempo que aparezcan ataques automatizados. Para quien mantiene un sitio en WordPress o en cualquier otra aplicación PHP, la prioridad de hoy es comprobar la versión y actualizar.

Actualización del 22 de octubre: Amazon detectó un intento de explotar estos fallos el 17 de octubre, cuatro días antes del parche, y dice que ahora se explotan de forma generalizada. Lo contamos en El fallo crítico de PHP ya se atacaba cuatro días antes del parche, con qué revisar en el servidor además de actualizar.

Si quieres comprobar si alguien intentó colarse en tu servidor, en la guía Cómo saber si atacaron tu WordPress explicamos paso a paso cómo revisar los registros.

Más fuentes: avisos técnicos GHSA-w8hw-w9fx-j79w y GHSA-6wmf-4rv5-p3rp en GitHub, aviso previo de PHP y IT-Connect (declaraciones de watchTowr). Portada: un elePHPant, la mascota de PHP, foto de Atomic Taco, licencia CC BY-SA 2.0, Wikimedia Commons.

Fuente: PHP, «Security advisory: Critical remote code execution vulnerabilities, update now», 21 de octubre de 2026

ps3recomp convierte juegos de PS3 en programas nativos de PC: cuatro versiones en dos semanas y Killzone 3 ya en su primer nivel

Una consola PlayStation 3 Slim sobre fondo blanco, con el título de la noticia sobre ps3recomp

ps3recomp, un proyecto de código abierto, convierte juegos de PlayStation 3 en programas nativos para PC, sin emulador. Ha publicado cuatro versiones desde el 7 de octubre y ya tiene juegos que pasan de los menús: The Simpsons Arcade Game se juega incluso en línea, y los ports de la comunidad de inFamous y Killzone 3 llegan al primer nivel.

La PS3 es, desde hace años, la consola más difícil de llevar a otro sitio. Su procesador, el Cell, combina un núcleo PowerPC con seis coprocesadores vectoriales que trabajan cada uno con su propia memoria, y los juegos de la época se escribían exprimiendo esa arquitectura a mano. El emulador RPCS3 lleva más de una década imitándola y, según el propio README de ps3recomp, hace jugable alrededor del 70 % del catálogo. ps3recomp ataca el problema por el otro lado, igual que hicieron antes N64Recomp con Nintendo 64 o XenonRecomp y UnleashedRecomp con Xbox 360: en vez de imitar la consola, traduce el juego.

El proyecto lo empezó en marzo el desarrollador conocido como sp00nznet y tiene licencia MIT. En las dos últimas semanas se ha acelerado: la versión 0.13 salió el 7 de octubre, la 0.14 el 13, la 0.15 el 16 y la 0.16 el 19. Solo la 0.15 reunió 76 cambios de seis colaboradores, casi todos surgidos de los ports que la comunidad tiene en marcha.

Emulación frente a recompilación estática. El emulador RPCS3 traduce el código del procesador Cell en el PC del jugador e imita el hardware; ps3recomp lo traduce una sola vez a C y C++, lo compila con un compilador normal y lo enlaza con un runtime que sustituye al sistema de la PS3, pero cada juego es un port aparteDos formas de jugar a la PS3 en un PCEmulación (RPCS3)Tu juego de PS3el código del CellEmuladortraduce en tu PCCPU del PCejecuta lo traducidoPantallaRSX imitadoSirve para la mayor parte del catálogo sin tocar el juego, pero imitar el Cell y el RSX exige mucho al PC.Recompilación estática (ps3recomp)Tu juego de PS3el EBOOT de tu copiaTraductora C/C++, una sola vezCompiladorMSVC, GCC o ClangPrograma nativocon su runtimeLa traducción se hace antes de jugar, pero cada juego es un port aparte: hay que arreglarlo título a título.
Emular frente a recompilar: el emulador imita la consola; ps3recomp traduce el juego una vez y lo compila como un programa más. Esquema: decodigo.com.

Claves de ps3recomp

  • Traducir antes de jugar: sus herramientas leen el ejecutable del juego (el EBOOT), lo desensamblan y convierten el código del núcleo PowerPC (la PPU) y de los coprocesadores (las SPU) en C y C++. Ese código se compila con MSVC, GCC o Clang y se enlaza con un runtime que hace el papel del sistema de la PS3: su núcleo LV2, con más de 300 llamadas al sistema, y más de un centenar de bibliotecas.
  • El Cell, pieza a pieza: cada SPU tiene solo 256 KB de memoria propia y mueve los datos con transferencias explícitas, y muchos juegos reparten el trabajo entre ellas con el planificador SPURS de Sony. ps3recomp reproduce las dos cosas. En la versión 0.15, la coma flotante de las SPU pasó a dar exactamente los mismos resultados que el hardware, y en los chips ARM esos cálculos van entre 1.6 y 4 veces más rápido.
  • Gráficos en tres sistemas: las órdenes al chip gráfico de la consola, el RSX, se traducen a Direct3D 12 en Windows, Metal en Mac y Vulkan en Linux. La versión 0.16 añade texturas 3D y cachés para compilar menos sombreadores durante la partida.
  • Juegos que ya se juegan: The Simpsons Arcade Game es jugable y admite partidas en línea para dos jugadores a través de psnr, un servidor que sustituye a la red de PlayStation. Tornado Outbreak llega a su primer nivel con los gráficos correctos, aunque a unos 10–16 fps.
  • Los ports de la comunidad: inFamous funciona en Mac con chip de Apple a unos 13 fps; Killzone 3 llega a su primer nivel con luces, sombras y profundidad de campo; Twisted Metal muestra sus menús en Linux. También hay trabajo en inFAMOUS 2, Killzone 2, SoulCalibur II HD, LittleBigPlanet, Yakuza: Dead Souls y God of War II HD.
  • Solo Windows, por ahora: el runtime compila en Windows, Mac y Linux, y cada versión trae un paquete de desarrollo para los tres. Pero, en el código principal, solo en Windows hay ya un juego recompilado que funcione; los ports de Mac y Linux llevan parches que aún no se han integrado.
  • Tu copia, no la suya: el proyecto no incluye código, firmware ni claves de Sony, y no reparte juegos. Para cada port hay que descifrar el ejecutable de una copia propia y aportar sus datos, y los ports del propio autor no publican ejecutables listos para jugar.

Un port por juego, y todavía lejos del navegador

La recompilación estática tiene dos ventajas claras. El juego ya no se traduce mientras se juega, así que, según el proyecto, pide menos máquina. Y el resultado es código C y C++ que se puede modificar, depurar y llevar a otros sistemas. A cambio, cada juego es un port aparte: hay que localizar sus funciones, cubrir las bibliotecas del sistema que usa y arreglar lo que falle, título a título. Por eso la lista avanza de juego en juego, mientras que RPCS3 sirve para la mayor parte del catálogo sin tocar cada juego.

Lo que de momento no hay es una versión para el navegador. Los proyectos que llevan juegos de PSP y PS2 a una pestaña, como psp-web-recomp y ps2-web-recomp, siguen esta misma idea y compilan el resultado a WebAssembly. ps3recomp no lo menciona, y con juegos que en un PC rondan todavía los 10–16 fps, el salto a una pestaña queda lejos. Por eso, de la PS3, en el navegador solo hay hoy juegos como Skate 3, rehechos por otros caminos, que recogimos en nuestra lista de juegos clásicos que ya se juegan en el navegador.

El ritmo de las últimas semanas encaja con la ola que contamos en la IA desborda la descompilación de juegos: mucha gente trabajando a la vez sobre consolas antiguas. La diferencia es que ps3recomp no reparte nada de Sony ni de los juegos, y para jugar cada port hay que tener el disco o la descarga original.

ps3recomp ha pasado en dos semanas de una herramienta experimental a una base sobre la que varios grupos están portando juegos grandes de la PS3. Todavía hay mucho por hacer: velocidades bajas, solo Windows en el código principal y ningún ejecutable para el público. Pero ya se ha demostrado que el Cell, la consola que más ha costado emular, también se puede traducir.

Más fuentes: notas de las versiones 0.13 a 0.16, port de The Simpsons Arcade Game, port de Tornado Outbreak y RPCS3. Portada: PlayStation 3 Slim, foto de Evan-Amos, dominio público, Wikimedia Commons.

Fuente: ps3recomp en GitHub

Neo1, el humanoide hidráulico chino de 4 metros que, según su fabricante, levanta 500 kg con los dos brazos

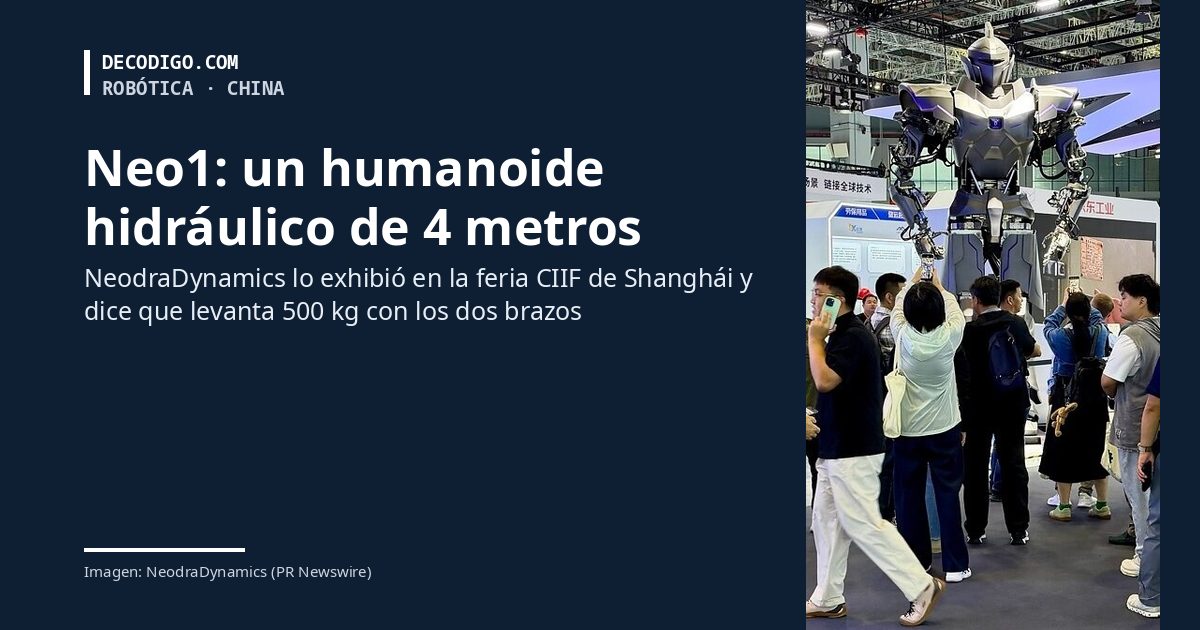
El robot Neo1 de NeodraDynamics en la feria CIIF 2026 de Shanghái, rodeado de visitantes, junto al título de la noticia

Una empresa de Pekín con apenas dos años de vida, NeodraDynamics, ha llevado a la feria industrial más grande de China un humanoide hidráulico de unos 4 metros de alto. Se llama Neo1 y, en lugar de los motores eléctricos que usan casi todos los robots de forma humana actuales, sus articulaciones las mueven sobre todo cilindros de aceite a presión. Según la empresa, puede cargar 500 kg entre los dos brazos. Todas esas cifras salen de sus notas de prensa: nadie las ha comprobado todavía de forma independiente.

NeodraDynamics se fundó en 2024 y la dirige Yang Tao; según la compañía, sus fundadores son ingenieros formados en la Universidad Tsinghua. El Neo1 debutó en la World Robot Conference de Pekín, como anunció la empresa en una nota del 14 de septiembre, y este mes volvió a exhibirse en la 26.ª Feria Internacional de la Industria de China (CIIF), que se celebró del 12 al 16 de octubre en el National Exhibition and Convention Center de Shanghái. Allí compartió espacio con JD Industrial, la división de suministros industriales del grupo de comercio electrónico JD.com.

La nota de prensa de la feria, del 14 de octubre, describe al Neo1 como un robot pesado híbrido, hidráulico y eléctrico. De sus 41 articulaciones con movimiento propio, 39 las mueven actuadores lineales hidráulicos digitales diseñados por la propia empresa; las otras dos, las que giran los antebrazos, son eléctricas. JD Industrial pondrá su red de proveedores y sus clientes para probar el robot en situaciones reales y buscar los primeros usos comerciales.

Claves del Neo1, según NeodraDynamics

  • Tamaño: la empresa habla de un robot «de clase 4 metros». El titular de la nota de octubre le atribuye 1.2 toneladas de peso, una cifra que no se repite en el texto ni aparece en la nota de septiembre.
  • Carga: 500 kg sujetos entre los dos brazos, trabajando a la vez.
  • Movimiento: 41 grados de libertad activos. 39 articulaciones son hidráulicas y 2 eléctricas. La nota de septiembre añade una mano de cinco dedos y brazos de siete grados de libertad, parecidos a los humanos.
  • La pieza clave: un cilindro hidráulico «digital» en miniatura. La nota de septiembre dice que pesa 1.1 kg y mueve 1,000 kg con una repetibilidad de una micra; la de octubre habla de 1 kg por actuador y de un empuje continuo «de toneladas».
  • Precisión: aquí las dos notas no coinciden. En septiembre la repetibilidad en la punta de los dedos era de ±0.05 mm; en octubre, de ±0.005 mm, diez veces mejor, sin explicar el cambio.
  • Para qué: montaje de piezas pesadas, carga en puertos, mantenimiento en centrales nucleares, reparaciones en el fondo del mar, minería, demolición y rescate. La empresa asegura que sus módulos hidráulicos aguantan radiación, presión submarina, temperaturas extremas, polvo y vibraciones.
  • Lo que no dice: ninguna de las dos notas explica cómo se desplaza, de dónde saca la energía, cuánto tiempo trabaja seguido, qué sensores lleva, cuánto cuesta ni cuándo se venderá. Los análisis publicados lo describen como una máquina fija: no hay ninguna demostración de que camine.

La apuesta a contracorriente: volver a la hidráulica

La hidráulica tiene una ventaja clara: mueve mucha fuerza con actuadores pequeños. Es lo que levanta el brazo de una excavadora. Pero también tiene fama de ruidosa, sucia por las fugas de aceite y difícil de controlar con precisión. Por eso Boston Dynamics jubiló en abril de 2024 su Atlas hidráulico, el robot de las acrobacias, y lo sustituyó por un Atlas eléctrico, al que acaba de ponerle una mano nueva. El resto del sector siguió el mismo camino: el Astribot T1, el FF Nova de Faraday Future o el Unitree G1 son robots eléctricos, ligeros y pensados para convivir con personas.

NeodraDynamics apuesta por lo contrario: un robot grande para trabajos donde ni una persona ni un humanoide ligero pueden entrar o cargar lo suficiente. «Las máquinas no deberían verse limitadas por los límites físicos del ser humano», dijo Yang Tao en septiembre; en octubre añadió que los robots «no deberían limitarse a copiar la forma humana». Si su cilindro digital cumple lo que promete, combinaría la fuerza de la hidráulica con la precisión que hasta ahora solo daban los motores eléctricos.

Ese «si» pesa mucho. Las cifras vienen de notas de prensa pagadas, cambian de una nota a otra y no hay pruebas de terceros. Tampoco se sabe nada de lo que más importa en una obra o en una mina: cuánto aguanta trabajando, si es seguro cerca de personas y cuánto costará mantenerlo.

El Neo1 es, por ahora, una demostración llamativa. La alianza con JD Industrial le da una vía para probarse en fábricas y almacenes reales, y será ahí, y no en una feria, donde se vea si la hidráulica digital tiene futuro en los robots de forma humana. Hasta entonces, conviene leer sus 500 kg como una promesa del fabricante.

Más fuentes: nota de prensa de NeodraDynamics del 14 de septiembre, Interesting Engineering y Mike Kalil. Imagen: NeodraDynamics, el Neo1 en la CIIF 2026, distribuida por PR Newswire.

Fuente: nota de prensa de NeodraDynamics (PR Newswire), 14 de octubre de 2026