Sale Linux 7.3: E/S más rápida, preparación para AMD Zen 6 y soporte para el nuevo mando de Steam

Un Tux de IBM, la mascota de Linux, con el titular de Linux 7.3

Linus Torvalds publicó Linux 7.3 el domingo 18 de octubre, en la fecha prevista. La nueva versión estable del kernel llega con entrada y salida más rápidas, mejoras de rendimiento en Btrfs, más preparación para los procesadores AMD Zen 6 y soporte inicial para el mando de Steam de 2026, entre miles de cambios más.

Linux 7.3 abrió su ventana de cambios a mediados de agosto y la cerró con su primera versión candidata el 30 de ese mes. Según LWN, en esas dos semanas entraron 15,267 cambios, la segunda cifra más alta de la historia del kernel en ese punto, solo por detrás de Linux 6.7, que incluyó casi 3,000 commits del historial de bcachefs. Firmaron el trabajo 2,450 desarrolladores, 520 de ellos por primera vez. Después vinieron siete versiones candidatas que el propio Torvalds describió varias veces como grandes, en buena parte por el aluvión de correcciones encontradas con ayuda de herramientas de IA.

El anuncio es breve: «nada muy especial parece haber pasado esta última semana, así que, como se esperaba, la 7.3 final ya está aquí». Torvalds avisa de que está de vacaciones con su familia, que pasará parte del día «en un barco y bajo el agua» y que la ventana de Linux 7.4 quizá necesite una semana extra para ponerse al día. Pero no la usará para colar trabajo tardío: lo que se fusione tiene que estar listo antes de que se abra la ventana, «así que no intentéis ninguna travesura».

Claves de Linux 7.3

  • E/S más rápida: Phoronix destaca ganancias en pruebas sintéticas de entrada y salida que se notan también en bases de datos y otras cargas con mucho disco, en varios sistemas. Btrfs suma sus propias mejoras de rendimiento.
  • Btrfs hace limpieza: desaparece la versión 1 de la caché de espacio libre, en desuso desde Linux 6.11, y la vieja opción de montaje usebackuproot, que hay que sustituir por rescue=usebackuproot.
  • Nuevo planificador de grupos: cambia cómo se reparte el peso de la CPU entre grupos de control (cgroups) en máquinas con muchos núcleos, donde el cálculo anterior podía dar factores de escala diminutos. El nuevo modo por omisión se llama concur. Además, sched_ext completa sus subplanificadores, que permiten delegar en otro planificador una parte del árbol de grupos.
  • failfs para aislar procesos: un sistema de archivos nuevo en el que cualquier operación falla. Un proceso con la raíz o el directorio de trabajo dentro de él solo puede abrir archivos a partir de descriptores que ya tenía abiertos. Llega con la llamada fchroot().
  • Hardware: el kernel ya distingue el nuevo núcleo de bajo consumo de AMD Zen 6; empieza el soporte de los Apple M3 Pro, Max y Ultra, aunque todavía no está listo para el usuario; y llegan controladores iniciales para el mando de Steam de 2026 y para los mandos de la consola portátil MSI Claw, trabajo de Valve.
  • Gráficos antiguos: también gracias a Valve, las primeras generaciones de GPU AMD GCN mejoran la recuperación tras un reinicio de la GPU, y los equipos con poca memoria de vídeo la gestionan mejor.
  • Rust y archivos: Rust llega a PowerPC y gana nuevas abstracciones para el resto del kernel. ntfs3 admite flujos alternativos de datos de NTFS, y el servidor SMB del kernel, ksmbd, ya sirve para copias de seguridad con Time Machine de Apple.
  • Lo que se va: los sistemas de archivos EFS, de las viejas estaciones de SGI, y FreeVxFS, de SCO UnixWare. Varias CPU Arm de 32 bits quedan en desuso: siguen soportadas en Linux 7.3, pero podrían desaparecer después.

¿Será la versión de soporte largo de 2026?

Es la pregunta que queda abierta. Cada año, Greg Kroah-Hartman elige una versión del kernel para mantenerla varios años. En kernel.org, la última con ese soporte largo (LTS) sigue siendo Linux 6.18, y Linux 7.3 todavía no figura como tal. LWN escribió en agosto que se esperaba que lo fuera. Phoronix, en cambio, apunta a que la elegida podría ser Linux 7.4 si sale antes de que acabe diciembre. La elección importa porque es el kernel que llevarán durante años muchas distribuciones, teléfonos y equipos embebidos. Ubuntu 26.10, por ejemplo, ya trae Linux 7.3.

Linux 7.3 también cierra su ciclo en plena discusión sobre la IA en el kernel. LWN contó la etiqueta Assisted-by en 1,264 commits de la ventana de cambios, algo más del 8 %, y advirtió que es «sin duda» una cifra muy por debajo de la real. Esa etiqueta es justo la que los mantenedores acaban de acordar retirar, con el respaldo de Torvalds.

Mientras tanto, ya está abierta la ventana de Linux 7.4, que debería dar su primera versión candidata a principios de noviembre y la versión final en diciembre. Linux 7.3 se puede descargar desde kernel.org. Para la mayoría, lo práctico será esperar a que llegue en las actualizaciones de su distribución.

Más fuentes: LWN, inicio de la ventana de cambios, LWN, resto de la ventana de cambios y Phoronix. Portada: el Tux de IBM, foto de Renato.pierri, licencia CC BY-SA 4.0, Wikimedia Commons.

Fuente: Linus Torvalds en la lista de correo del kernel Linux, 18 de octubre de 2026
Torvalds, sobre el código hecho con IA en Linux: «No vamos a poner reglas estúpidas»; el kernel retira la etiqueta Assisted-by

Linus Torvalds sonriendo en LinuxCon Europe, con el título de la noticia sobre el código hecho con IA en el kernel

Linus Torvalds ha zanjado el debate sobre el código hecho con IA en el kernel Linux con una respuesta de las suyas: «No vamos a poner reglas estúpidas que digan «no puedes usar herramientas para X»». Lo escribió en la lista de correo del kernel, en plena discusión sobre un parche que retira la etiqueta Assisted-by, la que hasta ahora debían añadir los desarrolladores que usaban asistentes de IA para preparar sus contribuciones.

La etiqueta se propuso en julio de 2025 y entró en la documentación oficial del kernel en enero de 2026, según The Register. Pedía que quien usara «cualquier tipo de herramienta avanzada de programación» lo reconociera con una línea como Assisted-by: LLM en el mensaje del commit, y avisaba de que no hacerlo podía «dificultar la aceptación» del trabajo. En septiembre contamos aquí los primeros parches del kernel firmados con esa etiqueta.

El 8 de octubre, en la reunión anual de mantenedores celebrada en Praga, la mayoría de los unos 30 invitados apoyó retirarla, según heise. Al día siguiente, Sasha Levin, mantenedor de las versiones estables, envió el parche: «La Maintainers Summit llegó a un consenso para retirar la etiqueta Assisted-by. Se elimina la documentación que la exige.» En su versión revisada aportó un dato: de los 18,533 commits de Linux 7.3 hasta su séptima versión candidata, solo alrededor del 10 % llevaba la etiqueta, así que su ausencia no dice nada de cómo se hizo un parche.

Claves del cambio

  • Qué desaparece: la obligación de declarar la IA en el commit. El parche borra la sección de la guía para asistentes de programación, el apartado de la guía para enviar parches, su traducción al italiano y el aviso que lanzaba checkpatch.pl.
  • Qué se queda: la responsabilidad. Un agente de IA sigue sin poder añadir la línea Signed-off-by, la firma con la que una persona certifica legalmente el origen del código (el DCO). Quien firma «asume toda la responsabilidad de la contribución».
  • Por qué se retira: casi nadie la ponía, no había forma de comprobarla y, para Jeff Layton, de Red Hat, la etiqueta «básicamente sirve de publicidad gratuita para las empresas de modelos propietarios».
  • Quién se opuso: Laurent Pinchart, mantenedor de controladores de cámara y vídeo, escribió que no le gusta quitarla «sin añadir otro mecanismo de declaración obligatoria»: la falta de etiqueta le servía para preguntar a los autores, y muchos de esos parches dudosos no volvían. Propuso pedirlo en la carta que acompaña a cada serie de parches, con poco apoyo.
  • La respuesta de Torvalds: le contestó con una «regla nueva solo para ti»: no usar compiladores, porque quien no sabe escribir en ensamblador no demuestra que entienda lo que hace la máquina, ni un editor de texto para el mensaje del commit, porque permite borrar los errores. «¿No ves lo TOTALMENTE ESTÚPIDAS que serían esas reglas?».
  • Lo que sí espera: «que la gente dé lo mejor de sí y entienda lo que hace. Pero esa comprensión tiene muy poco que ver con las herramientas que usa». Y añadió que, en su experiencia, la gente a la que respeta «no es la que rehúye las herramientas nuevas e interesantes».
  • Estado: el parche ya está en la rama de documentación que lleva Jonathan Corbet, pero todavía no ha llegado a la rama principal del kernel, según heise.

La IA deja de ser la excepción en el kernel

La discusión no va de si se usa IA en Linux, que ya se usa, sino de si conviene marcarla. Quienes la defienden quieren saber qué parches revisar con más cuidado; quienes la retiran creen que una etiqueta que la mayoría no pone solo da una falsa sensación de control. Torvalds se coloca en el segundo grupo y, además, predica con el ejemplo: según heise, por las mismas fechas firmó parches para acelerar las lecturas de la caché de páginas preparados con Claude Code bajo su dirección.

Lo que el kernel mantiene es la regla que de verdad importa: detrás de cada parche hay una persona que lo firma y responde por él. Para los revisores, el problema de los envíos de baja calidad no desaparece. Lorenzo Stoakes, otro mantenedor, lo resumió en el mismo hilo: la única estrategia a largo plazo contra la basura generada es «ignorarla sin contemplaciones».

Para el resto del software libre, la postura del proyecto más grande y visible pesa. Varios proyectos han prohibido las contribuciones hechas con IA o exigen declararlas; el kernel elige el camino contrario y juzga el código por lo que es, no por cómo se escribió.

Más fuentes: los mensajes de Sasha Levin y Laurent Pinchart en la lista del kernel, heise y The Register. Portada: Linus Torvalds en LinuxCon Europe 2014, foto de Krd, licencia CC BY-SA 4.0, Wikimedia Commons.

Fuente: Linus Torvalds en la lista de correo del kernel Linux, 13 de octubre de 2026

DeepSeek publica como código abierto DeepInfer, el motor de inferencia que sirve sus modelos

Vista de Hangzhou desde el lago del Oeste con el logotipo de DeepSeek y el título sobre su motor de inferencia

DeepSeek ha publicado como código abierto DeepInfer, el software con el que sirve sus modelos de IA en producción. Es lo que en el sector se llama un motor de inferencia: el programa que carga el modelo en las GPU, reparte el trabajo entre ellas y genera las respuestas lo más rápido y barato posible. Llega con licencia Apache 2.0, funciona en GPU de NVIDIA y en chips Ascend de Huawei, y de momento solo ejecuta DeepSeek-V4.1-Flash.

Publicar los pesos de un modelo, como hace DeepSeek desde hace tiempo, no basta para usarlo bien. Un modelo de miles de millones de parámetros hay que repartirlo entre decenas de chips, organizar las peticiones en lotes y exprimir cada operación, y de eso depende cuánto cuesta cada respuesta. Hasta ahora, quien quería servir los modelos de DeepSeek tenía que usar motores genéricos como vLLM o SGLang, que deben adaptarse a cada modelo nuevo y no llevan los ajustes internos de la empresa. Es lo mismo que hizo Meta con Muse Spark Open: dar el modelo y dejar el «cómo servirlo» a cada uno.

Con DeepInfer, DeepSeek comparte, según su anuncio, su «pila de producción» para ayudar a la comunidad a «reducir el coste de cómputo y el consumo de energía y hacer la IA más asequible». El código está en GitHub, en deepseek-ai/DeepInfer, y el mismo día de su publicación ya superaba las 12,000 estrellas. La empresa ha publicado a la vez deepseek-recipe, una biblioteca en Rust con licencia MIT que traduce las peticiones de las API más usadas al formato de sus modelos y vuelve a traducir las respuestas, para que un servidor propio se comporte igual que la API oficial.

Claves de DeepInfer

  • Licencia Apache 2.0: se puede usar, modificar y vender, también en productos comerciales.
  • Hardware: GPU NVIDIA de la arquitectura SM100 (la de los B200 de los centros de datos) y chips Huawei Ascend 950. Pide Linux, Python 3.12 y CUDA 13 o CANN 9.2, el equivalente de Huawei.
  • Un solo modelo por ahora: DeepSeek-V4.1-Flash. La empresa dice que el código de sus próximos modelos irá al mismo repositorio.
  • Reparto entre chips: divide el trabajo de tres formas a la vez: por datos, por contexto (los textos muy largos) y por expertos, ya que V4.1-Flash es un modelo de mezcla de expertos en el que cada palabra solo activa una parte de la red.
  • Decodificación especulativa: propone varios tokens de golpe y los verifica en una sola pasada, en lugar de generar uno por uno.
  • Resultados repetibles: en NVIDIA, la misma petición da la misma respuesta aunque vaya en un lote distinto, algo que la mayoría de motores no garantiza.
  • Salidas con formato: puede obligar al modelo a responder con un JSON válido según un esquema, una expresión regular o una gramática.
  • Lo que se ha guardado: la versión abierta no incluye la caché de contexto entre peticiones (KV cache), ni la separación entre leer el prompt y generar la respuesta en máquinas distintas, ni el reparto de carga entre réplicas. Son piezas clave para servir a escala, así que DeepInfer es un motor, no el sistema completo de DeepSeek.
  • Construido sobre vLLM: el propio README reconoce que nació «principalmente» sobre vLLM, con ideas de SGLang y de TensorRT-LLM de NVIDIA. Según The Next Web, el equipo de vLLM ya ha dicho que aprovechará ideas de DeepInfer para mejorar su soporte de V4.1-Flash.

Qué cambia para quien sirve modelos abiertos

El negocio de la IA ya no está solo en entrenar modelos, sino en servirlos baratos. Los proveedores que ofrecen modelos abiertos en la nube compiten por centavos por millón de tokens, y el motor de inferencia decide buena parte de ese margen. Al publicar el suyo, DeepSeek reduce la distancia entre su API y la de cualquiera que sirva sus modelos, y empuja los precios aún más abajo, lo que presiona también a los modelos cerrados.

El soporte de los chips de Huawei pesa igual. Las restricciones de EE. UU. a la venta de GPU avanzadas a China hacen que las empresas chinas necesiten alternativas, y un motor de producción que trata al Ascend 950 en igualdad con NVIDIA es una señal de que esa alternativa ya sirve para algo más que pruebas. Eso sí, las dos funciones de resultados repetibles solo funcionan, por ahora, en NVIDIA.

Falta comprobar las cifras. DeepSeek publica gráficas de rendimiento con 4 GPU SM100 para procesar los prompts y 64 para generar las respuestas, pero no hay pruebas independientes todavía, y la configuración está muy lejos del alcance de quien quiera probarlo en casa. Para la mayoría, lo útil llegará de forma indirecta: en los motores como vLLM que incorporen sus técnicas y en los proveedores que bajen precios gracias a ellas.

Más fuentes: el repositorio deepseek-recipe, The Next Web y The Decoder. Portada: Hangzhou, sede de DeepSeek, desde el lago del Oeste, foto de Y Chen, licencia CC BY-SA 4.0 (Wikimedia Commons), y logotipo de DeepSeek, marca registrada de DeepSeek, publicado con licencia MIT (Wikimedia Commons).

Fuente: DeepSeek, repositorio de DeepInfer en GitHub

Un fallo eléctrico en Londres tumba Google Cloud durante casi ocho horas y arrastra a Revolut y a bancos británicos

La City de Londres desde el Támesis con el título de la noticia sobre la caída de Google Cloud

Un fallo eléctrico en uno de sus centros de datos de Londres provocó este martes 20 de octubre una caída de Google Cloud que dejó a 38 de sus productos con fallos y errores durante casi ocho horas. El golpe se notó fuera del mundo técnico: Revolut se quedó sin servicio para millones de clientes en el Reino Unido e Irlanda, y bancos como Halifax, el servicio de tribunales británico y empresas de reparto también reportaron problemas.

Google Cloud organiza su infraestructura en regiones, que son ciudades o áreas geográficas, y cada región en varias zonas: centros de datos separados, con su propia alimentación eléctrica, refrigeración y red, pensados para que un problema en uno no arrastre a los demás. La región de Londres se llama europe-west2 y tiene tres zonas, a, b y c. Muchas empresas británicas la eligen porque la ley o sus clientes les piden guardar los datos en el país, y porque la cercanía reduce la latencia.

El incidente empezó a las 06:08 UTC (las 07:08 en Londres) en la zona europe-west2-b. Google tardó casi dos horas y media en publicar el primer aviso y cerca de cinco en explicar la causa: «Un evento eléctrico provocó una caída en la zona europe-west2-b». Hacia el mediodía de Londres el problema eléctrico estaba resuelto, pero volver a levantar servidores, discos y servicios llevó varias horas más. Google dio el incidente por cerrado a las 14:03 UTC, aunque admitió que un número muy pequeño de clientes seguía afectado.

Cronología del 20 de octubre (hora UTC; en Londres, una hora más)06:08Empieza la caída en europe-west2-b08:35Primer aviso público: «investigando»09:24Google sugiere mover cargas a otra zona11:12Causa: un fallo eléctrico, ya mitigado11:58Recuperación: primero lo que ya corría12:10La mayoría de las cargas se recuperan14:03Cierre: mitigado para casi todosUnas 6 horasde caída en la zona b7 h 52 minde incidenteFuente: página del incidente en el estado de Google Cloud (horas originales en PDT, UTC-7)
Cronología según la página del incidente de Google Cloud, con las horas pasadas de PDT a UTC.

Claves de la caída

  • Una sola zona, efecto en toda la región: la zona b dejó de dar servicio, y el resto de europe-west2 sufrió errores y cortes de red intermitentes.
  • 38 productos afectados, entre ellos los básicos: Compute Engine (máquinas virtuales), Kubernetes Engine, Cloud Run, Cloud SQL, Cloud Storage, BigQuery, Spanner, Pub/Sub, los discos persistentes y el balanceo de carga.
  • Recuperación por partes: Google priorizó volver a encender lo que ya estaba corriendo. Durante un buen rato no se pudieron crear máquinas ni servicios nuevos.
  • La única solución temporal que ofreció fue mover las cargas a otra zona o región, justo lo que es difícil de hacer en plena caída si no se ha preparado antes.
  • Revolut, cuya infraestructura está en Google Cloud, dejó a sus clientes sin acceso a la app, sin transferencias, sin pagos con tarjeta y sin retiros en cajeros. Solo en Irlanda tiene 3.4 millones de clientes. La empresa aseguró que «el dinero y los datos de todos nuestros clientes están a salvo».
  • Otros afectados: Halifax confirmó fallos en su app y su banca en línea, y el servicio de tribunales británico, en la plataforma de vídeo de las audiencias a distancia. Clientes de Lloyds y HSBC, y de empresas como DPD y Royal Mail, también reportaron problemas.
  • Sin explicación técnica todavía: Google no ha dicho qué falló en el suministro eléctrico ni por qué los sistemas de respaldo no lo evitaron. Ha prometido publicar un análisis.

Por qué una sola zona pudo tanto

Las zonas existen precisamente para esto: si un centro de datos se queda sin luz, las aplicaciones repartidas entre varias zonas siguen funcionando con las otras. Pero repartir cuesta dinero y complica la arquitectura, porque hay que duplicar servidores y mantener los datos replicados entre zonas. Muchos servicios, sobre todo los más antiguos o los que nacieron pequeños, siguen viviendo en una sola zona. Cuando esa zona cae, caen con ella.

Región europe-west2 (Londres): tres zonas independienteseurope-west2-aFuncionandoErrores y cortes de redintermitentes en la regióneurope-west2-bFallo eléctricoServicios caídosde 06:08 a ~12:10 UTCeurope-west2-cFuncionandoErrores y cortes de redintermitentes en la regiónAplicación en una sola zonaTodos sus servidores están en la zona bSi la zona cae, la aplicación cae enteraHay que esperar a que Google la recupereo mover las cargas a otra zona en plena caídaAplicación repartida en tres zonasabcUna copia en cada zona, con balanceoSi cae una zona, siguen las otras dosMás lenta, pero en pie. Cuesta másy exige replicar los datos entre zonas
Por qué una sola zona pudo tumbar servicios enteros: la diferencia entre desplegar en una zona o en las tres de la región.

Además, una región no es del todo independiente aunque sus zonas lo sean. Los servicios de red y de gestión que comparten las tres zonas también dieron errores, y cuando todos los clientes intentan a la vez mover sus cargas a las zonas que siguen en pie, esas zonas se saturan. Por eso, incluso una aplicación bien repartida pudo notar la caída, aunque mucho menos que una alojada solo en la zona b.

Y está la concentración. Que un fallo eléctrico en un solo edificio deje sin pagar con tarjeta a millones de personas muestra hasta qué punto los bancos y servicios públicos dependen de tres o cuatro proveedores de nube. Es el riesgo que los reguladores llevan tiempo intentando vigilar: en la Unión Europea, el reglamento DORA obliga a los bancos a tener planes para cuando falle un proveedor tecnológico crítico, y el Reino Unido tiene su propio régimen para supervisar a esos «terceros críticos».

Google cerró el incidente en algo menos de ocho horas, y el análisis que publique dirá si el problema fue el suministro, los generadores de respaldo o cómo se distribuyó la carga después. Mientras tanto, la lección para quien despliega en la nube es la de siempre, pero ahora con ejemplo reciente: una zona no es una garantía, y lo que no puede caerse tiene que estar en al menos dos.

Más fuentes: The Irish Times, ABC News y The Register. Portada: la City de Londres desde el Támesis, foto de Mike Peel (www.mikepeel.net), licencia CC BY-SA 4.0, Wikimedia Commons.

Fuente: Google Cloud Service Health, «Multiple services are experiencing issues in the europe-west2 region»

Los grandes diarios de Canadá demandan a Anthropic: piden hasta $20,000 CAD por cada artículo usado para entrenar a Claude

Osgoode Hall, sede histórica de los tribunales de Ontario en Toronto, con el titular de la demanda de los editores canadienses contra Anthropic

Los mayores editores de prensa de Canadá, The Globe and Mail, el Toronto Star, Postmedia y la agencia The Canadian Press, entre otros, han demandado a Anthropic ante el Tribunal Superior de Justicia de Ontario. Acusan a la empresa de copiar millones de sus artículos para entrenar a Claude sin permiso ni pago, de saltarse sus muros de pago y de enriquecerse a su costa. Piden una indemnización que puede llegar a $20,000 CAD por cada obra, y que deje de usar su contenido.

La demanda se presentó el 6 de octubre y la adelantó el sitio especializado Cartt.ca; The Canadian Press la difundió el 19. No es la primera vez que estos medios llevan a una empresa de IA a los tribunales: en noviembre de 2024, junto con CBC/Radio-Canada, demandaron a OpenAI por ChatGPT. OpenAI intentó que el caso se viera en Estados Unidos, pero en noviembre de 2025 la jueza Jessica Kimmel decidió que el tribunal de Ontario sí puede juzgarlo, porque la empresa hace negocios en la provincia y, al leer sus webs, aceptó sus condiciones de uso. Ese caso todavía no se ha resuelto.

Anthropic, por su parte, ya pagó por un pleito parecido. En 2025 aceptó un acuerdo de $1,500 millones de USD con un grupo de autores en Estados Unidos, el caso Bartz, después de que un juez federal de California considerara que descargar millones de libros pirateados no estaba amparado por la ley. La nueva demanda recuerda ese acuerdo, y también lo grande que es hoy la empresa.

Claves de la demanda contra Anthropic

  • Seis demandantes. El Toronto Star y Metroland Media, del grupo Torstar; Postmedia Network y PNI Maritimes; The Globe and Mail, y The Canadian Press. Demandan a Anthropic y a su filial canadiense.
  • Unos 13.5 millones de artículos. Según Broadcast Dialogue, que ha visto la demanda, los medios calculan cuántas obras les habría copiado Anthropic desde 2021: 4.2 millones de The Canadian Press, 3.5 millones de Postmedia, otros 3.5 millones de Torstar y 2.3 millones del Globe. Casi dos tercios son suyos y el resto, contenido que tienen licenciado.
  • Cuatro acusaciones. Infracción de derechos de autor; incumplimiento de las condiciones de uso de sus webs, que prohíben copiarlas con robots como ClaudeBot, el rastreador de Anthropic; elusión de medidas técnicas de protección, como los muros de pago y los sistemas de acceso, y enriquecimiento injusto: «Anthropic se ha enriquecido sustancial e injustamente en perjuicio de las empresas de medios», dice la demanda.
  • Una copia que no se detiene. Según los editores, Anthropic no solo usó sus artículos para entrenar sus modelos: los sigue extrayendo cuando Claude responde a las preguntas de los usuarios, y no ha cambiado de conducta pese a las críticas y a otras demandas.
  • Lo que piden. Una indemnización por daños, la devolución de los beneficios obtenidos o, como alternativa, los daños que fija la ley canadiense, de hasta $20,000 CAD por obra en usos comerciales. Además, daños punitivos por una conducta que consideran deliberada y una orden que impida a Anthropic acceder a sus contenidos, presentes y futuros, sin permiso por escrito.
  • Sin licencias. La demanda subraya que, «a diferencia de casi todas las grandes empresas de inteligencia artificial, incluida OpenAI», Anthropic no ha firmado ningún acuerdo público de licencia con grandes editores. También cita sus cifras: unos $125,000 millones de USD recaudados hasta mayo, una valoración de más de $965,000 millones de USD y más de un millón de usuarios nuevos al día.
  • Anthropic no ha respondido. No contestó a The Canadian Press, y como empresa extranjera tiene 60 días desde que se le notifica para presentar su defensa. Las acusaciones no se han probado ante un tribunal.

Por qué importa

Canadá no tiene todavía una regla clara sobre si entrenar una IA con textos protegidos es legal. La estrategia nacional de IA no abordó el tema, y los propios editores piden al gobierno federal que se pronuncie. Mientras tanto, la respuesta la van a dar los jueces, y el caso de OpenAI ya ha sentado un precedente importante: una empresa de IA sin oficinas en Ontario puede ser juzgada allí si usa contenido de medios de la provincia.

Para Anthropic, el frente se amplía. Ya pagó $1,500 millones de USD a los autores de libros en Estados Unidos, y esta demanda llega de una industria, la prensa, con la que, según los editores, no ha cerrado acuerdos de licencia, a diferencia de OpenAI. Si el tribunal da la razón a los editores, la cuenta por obra prevista en la ley canadiense, multiplicada por millones de artículos, sería difícil de ignorar.

El pleito tardará años en resolverse, como el de OpenAI, que lleva casi dos sin juicio. Pero apunta en la misma dirección que el resto del sector: cada vez es más difícil entrenar modelos con el trabajo de otros sin pagar por él, y la presión para negociar licencias con la prensa llega ya a todas las grandes empresas de IA.

Más fuentes: los detalles de la demanda, en Broadcast Dialogue; el fallo sobre la competencia en el caso de OpenAI, en Lerners. Otra demanda reciente contra la IA: ocho estados de EE. UU. contra OpenAI. Portada: Osgoode Hall, en Toronto, sede histórica de los tribunales de Ontario; foto de Rainer Halama, licencia CC BY-SA 4.0, Wikimedia Commons.

Fuente: The Canadian Press, «News publishers launch copyright suit against AI company Anthropic in Ontario»

Usan Claude Code para volver «tontas» sus smart TV: sin anuncios, sin rastreo y con un inicio limpio

Televisor apagado con el título de la noticia sobre volver «tontas» las smart TV escrito sobre la pantalla

La moda del momento entre programadores aficionados es pedirle a un agente de IA que arregle la tele. Con Claude Code y otras herramientas parecidas, cada vez más usuarios están quitando de su smart TV los anuncios, las apps que venían de serie y el rastreo de lo que ven, y cambiando la pantalla de inicio por otra limpia. Lo cuenta TechCrunch, y en GitHub ya hay dos proyectos, cleanyourtv y dumbtv, que lo han convertido en una receta con miles de seguidores en tres días.

Las teles inteligentes se venden cada vez más baratas porque el negocio ya no está solo en el aparato: está en lo que muestran y en lo que saben de quien las usa. Muchas enseñan filas de contenido patrocinado antes de llegar a Netflix, y casi todas llevan ACR, el reconocimiento automático de contenido, que identifica lo que se está viendo a partir de capturas de pantalla o fragmentos de audio y sirve para vender publicidad dirigida. Desactivarlo a mano suele exigir recorrer menús escondidos, y lo que viene instalado de fábrica rara vez se puede borrar.

El cambio es que ahora basta con explicárselo a un agente. El 17 de octubre, Gathin T. contó en X que había «arreglado» con IA la tele de sus padres, que mostraba un anuncio patrocinado antes de poder abrir Netflix: le dio a Claude Code el modelo, el agente encontró la tele en la red wifi, desactivó 25 paquetes de Xiaomi y escribió un lanzador nuevo. «Ahora parece una Apple TV», resumió. Las respuestas a su mensaje se llenaron de gente que lo repetía con su propio modelo.

Claves de las smart TV «tontas»

  • Todo pasa por ADB. Las teles con Android TV o Google TV tienen la misma puerta de depuración que los móviles Android. Al activar las opciones de desarrollador, un ordenador de la misma red puede dar órdenes a la tele, y eso es lo que aprovecha el agente: buscar los paquetes de publicidad y telemetría, desactivarlos e instalar otra pantalla de inicio.
  • cleanyourtv, el más popular. El repositorio de Gathin T. nació el 17 de octubre con el nombre tv-vibehack y ya suma más de 9,300 estrellas y 1,000 bifurcaciones. Incluye listas probadas para 93 modelos de 31 marcas, entre ellas TCL, Sony, Xiaomi, Philips y Hisense, y un lanzador de 370 KB inspirado en el de Apple TV. Su método no desinstala nada: desactiva los paquetes y guarda una copia para poder deshacerlo todo con un script.
  • dumbtv, el más radical. Lo publicó Muzzammil Yasin Sabuwala el 18 de octubre, y según TechCrunch lo hizo con DeepSeek V4.1 Flash, Claude Opus 5.5 y Claude Sonnet 5.5. En un Fire TV desactiva unas 65 apps y servicios, entre ellos el ACR, el identificador publicitario, las filas patrocinadas y Alexa; instala un filtro DNS en la propia tele y un lanzador de 45 KB que ni siquiera tiene permiso para conectarse a internet.
  • Resultados visibles. Mihir Gupta, uno de los usuarios citados por TechCrunch, desactivó 25 apps y cambió un lanzador de 192 MB por uno de 83 MB, y otros aseguran que la interfaz va más rápida. Para quien no quiera usar IA, existen lanzadores alternativos como Projectivy, FLauncher o ATV Launcher.
  • No todas las teles se dejan. Funciona en Android TV y Google TV, y a medias en Fire TV, donde Amazon no deja cambiar la pantalla de inicio en todos los modelos. Samsung, con Tizen, LG, con webOS, Roku o Vizio usan otros sistemas sin esa puerta, y dumbtv recomienda en esos casos bloquear la publicidad desde el router.
  • Y algún susto. Según TechCrunch, una persona dejó inservible su Android TV con Claude, y otra se quedó a medias con un Fire TV. El propio Claude no siempre colabora con una orden tan escueta como «hackea mi tele»: hay que explicarle qué se quiere conseguir.
Antes de probarlo. Desactivar el paquete equivocado puede dejar la tele con la pantalla en negro o en un bucle de reinicios; cleanyourtv avisa, por ejemplo, de que en Google TV el asistente de configuración puede quedarse atascado si se quita el inicio original. Usa solo los repositorios oficiales, haz primero la copia de la lista de paquetes que preparan sus scripts, aplica los cambios por tandas y no abras nunca el puerto de ADB a internet desde el router. dumbtv, además, desinstala algunas apps de streaming que luego hay que volver a bajar de la tienda. Y recuerda que un restablecimiento de fábrica deshace casi todo, pero no recupera las apps desinstaladas.

Por qué importa

Durante años, quitar la publicidad de una tele ha sido cosa de foros especializados y de listas de paquetes que solo valían para un modelo concreto. Lo que cambia con los agentes de IA es que cada usuario puede adaptar la receta a su aparato: el agente inspecciona la tele, propone qué desactivar y pregunta antes de tocar lo que la persona usa. Y lo que aprende uno vuelve al repositorio en forma de lista nueva, que es como cleanyourtv ha llegado a 93 modelos en tres días.

También es un aviso para los fabricantes. Las filas patrocinadas, el rastreo y las apps que no se pueden borrar son parte del precio bajo de muchas teles, y si quitarlas se vuelve tan fácil como pedirlo por escrito, ese modelo de negocio pierde fuerza. Por ahora, eso sí, los propios autores dejan claro que todo está en desarrollo.

Para el resto, la historia es un buen ejemplo de lo que ya pueden hacer los agentes de programación fuera del código: manejar un aparato real por la red, con sus riesgos. Quien se anime debería tratarlo como cualquier otra herramienta de terceros: leer qué va a hacer, guardar la copia y aceptar que una tele de segunda mano es mejor campo de pruebas que la del salón. Sobre cómo trabaja Claude Code con herramientas y habilidades, contamos el caso de Anatomy, la skill que explica ideas con máquinas.

Más fuentes: los repositorios cleanyourtv y dumbtv en GitHub. Portada: una tele FFalcon apagada, foto de Leoyiphs, licencia CC BY-SA 4.0, Wikimedia Commons.

Fuente: TechCrunch, «People are using AI to make their smart TVs dumb again»

Así es Prometheus, el superclúster de IA de Meta en Ohio: cientos de miles de GPU y camino del millón

Edificio del centro de datos de Meta en Luleå, Suecia, con el título: Prometheus, el superclúster de IA de Meta

Meta ha abierto las puertas, por escrito, de Prometheus, el superclúster de IA de escala gigavatio que tiene en New Albany, Ohio, y en el que entrena sus modelos Muse. Según su blog de ingeniería, ya reúne cientos de miles de GPU de NVIDIA repartidas en varios edificios que trabajan como una sola máquina, y el objetivo es llegar a un millón. El artículo, firmado por cuatro de sus ingenieros, cuenta también lo difícil que ha sido que algo así no se detenga cada pocos minutos.

Mark Zuckerberg anunció Prometheus en julio de 2025 como el primero de sus grandes clústeres: un gigavatio de capacidad que debía entrar en servicio en 2026 y que, para ir más rápido, se levantaba en parte en estructuras de despliegue rápido parecidas a carpas. Junto a él presentó Hyperion, en Luisiana, que podría crecer hasta 5 gigavatios. Desde entonces, Meta ha usado Prometheus para entrenar la familia Muse, incluido Muse Wonder, su modelo más capaz.

Lo llamativo es de dónde viene. Hace dos años, el sitio de New Albany era un centro de datos convencional, de los que sirven las páginas de Facebook e Instagram. Meta lo ha convertido en una fábrica de entrenamiento y da por terminada la primera fase.

Claves de Prometheus

  • Varios edificios, una sola máquina. Cada edificio tiene su propia red, con hasta 20,736 GPU conectadas entre sí, y una red de agregación une los edificios aunque estén a entre 2 y más de 100 km de distancia. Hacen falta decenas de miles de switches y millones de transceptores, y cada GPU tiene una conexión de 800 gigabits por segundo hacia el resto.
  • Tres generaciones de armarios. Prometheus empezó con los armarios Catalina, con 72 GPU GB200 de NVIDIA repartidas en dos racks, y ha sumado Clemente, con 72 GB300 en un solo rack. La próxima generación, San Miguel, usará las Vera Rubin de NVIDIA y consumirá más de 170 kW por armario, lo que consumen de media más de cien hogares estadounidenses.
  • Repuestos dentro de cada armario. Con 72 GPU unidas, un solo fallo deja fuera de juego nueve veces más hardware que con los antiguos servidores de 8. Por eso cada armario trabaja con 64 GPU y guarda 8 de reserva, y Meta tiene además un 2 % de armarios extra. Un entrenamiento que usa 32,768 GPU ocupa en realidad 37,656.
  • De mil cortes al día a casi ninguno. A mediados de 2025 llegaron a sufrir casi 1,000 interrupciones al día por cada 8,000 GPU, por fallos en las conexiones entre GPU, en la memoria o en la red. Tras un año de trabajo las han reducido un 99 %, y hoy pasan más de 54,000 horas de GPU de media entre una interrupción y la siguiente. El objetivo es bajar a 2 al día, unas 100,000 horas.
  • Entrenar sin perder tiempo. Con Muse Wonder, más del 85 % del tiempo de las GPU se dedicó a avanzar en el entrenamiento, y más del 90 % en la fase de aprendizaje por refuerzo. Cuando una parte falla, un sistema la aísla mientras el resto sigue trabajando, en lugar de volver a empezar desde la última copia guardada.
  • Un problema para la red eléctrica. Cuando miles de GPU empiezan o dejan de calcular a la vez, el consumo del clúster puede variar un 30 o 40 % y mover decenas de megavatios en segundos. Meta lo suaviza con baterías en cada armario y en toda la instalación, y con un sistema, Dynamo Dimmer, que baja poco a poco la potencia de las GPU para no tener que detener el entrenamiento.
  • Refrigeración mixta. Parte de las GPU se enfrían con líquido directamente sobre los chips, en el edificio diseñado para IA, y otra parte con aire ayudado por líquido, en las estructuras de despliegue rápido. Los centros más nuevos usan circuitos cerrados de agua.
ArmarioGPU de NVIDIAMemoria por GPUConsumo
Catalina72 GB200, en dos racks192 GB~120 kW por pareja de racks
Clemente72 GB300, en un rack288 GB~135 kW por rack
San Miguel (próximo)72 Vera Rubin, en un rack288 GB de HBM4más de 170 kW por rack

Por qué importa

La carrera de la IA se libra cada vez más en hormigón, cables y megavatios. Los laboratorios ya no compiten solo por tener los mejores modelos, sino por poder entrenarlos en máquinas de cientos de miles de chips sin que se paren. El artículo de Meta muestra la parte menos vistosa de esa carrera: que a esta escala lo normal es que algo falle constantemente, y que gran parte del trabajo consiste en que esos fallos no tiren por la borda días de cálculo.

También explica por qué el dinero sigue fluyendo hacia el hardware. Cada generación de NVIDIA consume más por armario y exige más refrigeración y más red, y el consumo de un clúster así obliga a negociar directamente con las compañías eléctricas: para Hyperion, Meta pagará la conexión completa a la red de Entergy en Luisiana. Es el mismo mercado en el que empresas como Tenstorrent, que acaba de recaudar $1,500 millones de USD, intentan colar alternativas a NVIDIA.

Prometheus todavía no está completo, y Meta no ha dicho cuánta potencia usa hoy ni cuántas GPU exactas tiene. Pero el plan está claro: llegar al millón de GPU en Ohio y aplicar lo aprendido en Hyperion, que será aún mayor. La próxima generación de modelos Muse saldrá de ahí.

Más fuentes: el anuncio de Prometheus y de Hyperion, en TechCrunch (julio de 2025). Portada: el centro de datos de Meta en Luleå (Suecia), foto de Christopher Down, licencia CC BY 4.0, Wikimedia Commons.

Fuente: Meta Engineering, «Inside Prometheus: Meta’s Journey to a Gigawatt-Scale Supercluster»

Halo, Vice City, Black Ops, Skate 3 y más: los juegos clásicos que ya se juegan en el navegador

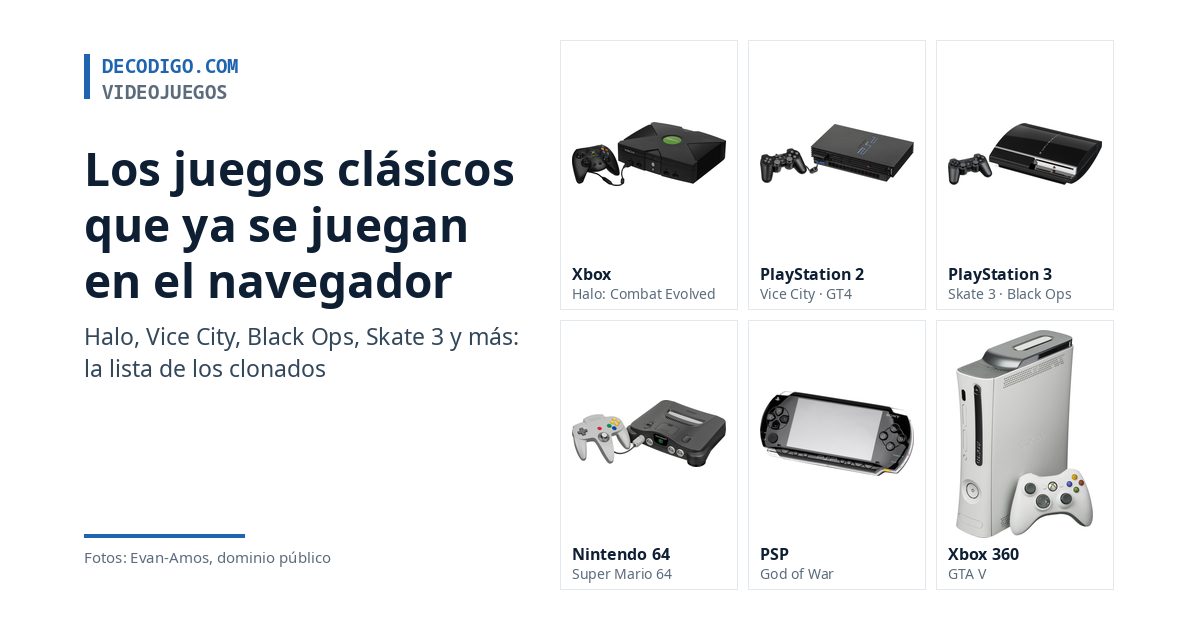
Collage de seis consolas: Xbox, PlayStation 2, PlayStation 3, Nintendo 64, PSP y Xbox 360, con los juegos clásicos de cada una que ya se juegan en el navegador

En las últimas semanas han aparecido versiones para el navegador de algunos de los juegos clásicos más queridos de los años 2000: Halo: Combat Evolved, GTA: Vice City, Call of Duty: Black Ops, Skate 3, God of War o Super Mario 64. Se abren en una pestaña, sin instalar nada, y según Kotaku algunas funcionan casi a la perfección. Esta es la lista de lo que se ha clonado hasta ahora, de qué consola viene cada juego y en qué estado está.

Kotaku contó el 9 de octubre que en dos semanas habían surgido «cientos» de emuladores y juegos descompilados, y lo atribuyó en buena parte a Claude Opus 5.5, el modelo de Anthropic. Su periodista, Lewis Parker, probó varios y destacó que casi todos son de la época de PlayStation 2 y PlayStation 3. Cómo se hacen, por qué la comunidad de la descompilación está dividida y qué han hecho las editoras lo contamos en la IA desborda la descompilación de juegos; aquí nos centramos en los juegos.

Hemos revisado cada proyecto en su web, en su repositorio o en el registro público de retiradas de GitHub. Un aviso antes de empezar: la lista cambia a diario, varios de estos juegos ya existían en el navegador antes de esta ola y no enlazamos ninguna versión, porque muchas reparten los archivos de juegos que siguen a la venta.

Los juegos clonados, uno a uno

  • Halo: Combat Evolved (Xbox, 2001). Es el más sonado. Mitchell Hynes lo anunció el 29 de septiembre con partidas en línea, a partir de una descompilación que otros llevaban meses haciendo. No incluye nada del juego: pide la imagen de tu propio disco de Xbox. Kotaku probó cuatro versiones distintas de Halo. La de Hynes sigue en línea, aunque ahora se llama «Combat Lab» y ya no menciona Halo en ningún sitio; no ha explicado por qué.
  • GTA: Vice City (PlayStation 2, 2002). Corre en el navegador sobre reVC, el proyecto de aficionados que reconstruyó su código hace años, y pide los archivos de tu copia. Sigue en línea. El mismo sitio aloja también Command & Conquer: Generals Zero Hour, cuyo código publicó la propia EA.
  • Call of Duty: Black Ops (2010). Luckey Faraday llevó al navegador partes de Black Ops y Black Ops II, incluido el mapa de zombis Kino der Toten. Según XDA, usaba mapas, modelos y animaciones de los juegos originales. Activision le envió una retirada por derechos de autor el 10 de octubre, y él mismo anunció que todo quedaba fuera de línea, aunque circulan copias. Otro port, de Modern Warfare 2, también cayó por una reclamación.
  • Skate 3 (PlayStation 3 y Xbox 360, 2010). Se presenta como un juego hecho por aficionados, «no hecho por EA», que carga los datos de tu propia copia convertida. Sigue en línea.
  • The Simpsons: Hit & Run (2003). Es de los veteranos: se publicó hace unos seis meses a partir del código del juego que se filtró en 2021. No pide nada al jugador, porque sirve los archivos desde su propio servidor, y sigue en línea.
  • God of War (PSP y PlayStation 2). Un mismo autor ha llevado al navegador los dos God of War de PSP, Chains of Olympus y Ghost of Sparta, y en un proyecto hermano, creado el 8 de octubre y con más de 1,100 estrellas en GitHub, God of War II y Gran Turismo 4 de PS2. Todos piden tu copia.
  • Super Mario 64 (Nintendo 64, 1996). Oliver Sauter publicó una versión con partidas de hasta 12 jugadores y videochat, hecha con ayuda de IA según XDA. Desde el 10 de octubre pide la ROM propia, y los vídeos en los que la mostraba en X fueron desactivados por una reclamación del titular de los derechos. La web sigue funcionando.
  • GTA V (Xbox 360 y PS3, 2013). El caso más llamativo duró horas: una web lo ponía a jugar directamente en Chrome, con todos los archivos del juego incluidos, y dejó de funcionar el 6 de octubre. No se sabe si la cerró una reclamación de Take-Two, y ya circulan copias en otros dominios.
  • Celeste (2018). Su estudio, Maddy Makes Games, pidió a GitHub el 14 de octubre retirar los archivos de una versión para el navegador que incluía los gráficos y sonidos del juego. Es una de las pocas retiradas que constan en el registro público.
  • Y otros clásicos de PC. También funcionan hoy en el navegador GTA III, Command & Conquer: Red Alert 2, LEGO Island y Counter-Strike 1.6, entre otros. Las listas de aficionados que siguen el fenómeno ya reúnen entre 30 y 80 proyectos.
JuegoConsola original¿Pide tu copia?Estado el 19 de octubre
Halo: Combat EvolvedXboxSí, la imagen del discoEn línea, renombrado «Combat Lab»
GTA: Vice CityPlayStation 2SíEn línea
Call of Duty: Black OpsPC, PS3, Xbox 360NoRetirado por Activision
Call of Duty: Modern Warfare 2PC, PS3, Xbox 360NoRetirado por una reclamación
Skate 3PS3, Xbox 360SíEn línea
The Simpsons: Hit & RunPS2, GameCube, Xbox, PCNoEn línea
God of War (PSP) y God of War IIPSP, PlayStation 2SíEn línea
Gran Turismo 4PlayStation 2SíEn línea
Super Mario 64Nintendo 64Sí, desde el 10 de octubreEn línea; vídeos retirados
GTA VPS3, Xbox 360NoCaído desde el 6 de octubre; hay copias
CelestePC y consolasNoArchivos retirados por su estudio

La ola tiene también juegos que se suelen meter en la misma lista pero no van en el navegador. Banjo-Tooie, de Nintendo 64, tiene un port hecho con IA, pero es un programa para Windows, y le valió la crítica de DarioSamo, autor de la versión para PC de Banjo-Kazooie, que lo calificó de falta de respeto al trabajo de otros. Su Banjo-Kazooie para PC es una recompilación estática, la técnica que explicamos en nuestra guía. Lo mismo pasa con Super Smash Bros. Ultimate, Mario Kart 8 Deluxe, Super Mario Odyssey o Metroid Prime, que según Kotaku ya tienen versiones para PC. Y Fallout: New York, que su autor cerró tras una carta de ZeniMax, no era un clon sino un juego nuevo hecho con Claude.

Por qué importa

La lista dice mucho de quién está detrás: no son juegos raros ni olvidados, sino los superventas de una generación, los que se jugaban en el salón con amigos hace veinte años. Que se puedan abrir en una pestaña, en un ordenador cualquiera, convierte en algo inmediato lo que antes exigía emuladores, configuraciones y paciencia.

También marca la frontera que están vigilando las editoras. Las versiones que piden tu propia copia, como Halo, Vice City o Skate 3, siguen en línea; las que reparten el juego entero, como Black Ops o GTA V, han caído o se esconden en dominios nuevos. Llama la atención, eso sí, que en el registro público de GitHub no conste ninguna retirada de Activision, Take-Two, Microsoft ni Sony: sus reclamaciones, si las hay, van por otras vías.

Y es muy probable que la lista crezca. Kotaku ya da cuenta de proyectos con juegos de Nintendo, y cada semana aparecen títulos nuevos en las listas de aficionados. Para los jugadores es una forma nueva de volver a sus clásicos; para las editoras, la señal de que hay demanda de esos juegos que muchas veces ya no venden.

Más fuentes: heise; la retirada de Call of Duty, en XDA; el aviso de Celeste, en el registro de retiradas de GitHub; los juegos de Nintendo, en Kotaku. Portada: fotos de las consolas de Evan-Amos, dominio público, Wikimedia Commons.

Fuente: Kotaku, «We Might Be Cooked, As These Vibe-Coded Web Browser Ports Of Halo, The Simpsons: Hit And Run, And GTA: Vice City Seem To Work Perfectly»

Tenstorrent, la empresa de chips RISC-V de Jim Keller, recauda $1,500 millones de USD y ya vale $6,200 millones

Jim Keller, director ejecutivo de Tenstorrent, sonriente con un jersey azul marino

Tenstorrent, la empresa de chips de inteligencia artificial que dirige Jim Keller, ha cerrado una ronda de financiación de $1,500 millones de USD que la valora en $6,200 millones de USD, más del doble que hace menos de dos años. Usará el dinero para fabricar en volumen sus servidores Galaxy, ofrecer modelos de IA abiertos en su propia infraestructura y seguir vendiendo a otras empresas los diseños de sus núcleos RISC-V.

Jim Keller es una de las figuras más conocidas del diseño de procesadores: participó en los chips A4 y A5 de Apple, en la arquitectura Zen de AMD y en el chip de conducción autónoma de Tesla. Desde 2023 es el director ejecutivo de Tenstorrent, una empresa fundada en Toronto en 2016 y hoy con sede en Santa Clara, que se ha propuesto competir con NVIDIA de una forma distinta: con hardware basado en RISC-V, una arquitectura de procesador abierta que cualquiera puede usar sin pagar licencias, y con todo su software publicado como código abierto.

Su ronda anterior, de diciembre de 2024, fue de más de $693 millones de USD, la lideraron Samsung Securities y AFW Partners, y en ella entraron Bezos Expeditions, el fondo de Jeff Bezos, y LG Electronics. La valoró en unos $2,600 millones de USD. A mediados de este año, según Bloomberg, Intel y Qualcomm llegaron a sondear su compra; Keller negó que hubiera negociaciones con Qualcomm, y ahora la empresa ha optado por seguir sola.

Claves de la ronda de Tenstorrent

  • $1,500 millones de USD en una serie E, con una valoración posterior de $6,200 millones de USD. La lideran Trace Capital, un fondo creado este año, e Innovation X.
  • Inversores de peso. Participan, entre otros, Fidelity, ARK Invest, Morgan Stanley, T. Rowe Price, Sandisk, XTX Markets y Tether Investments, el brazo inversor de la empresa de la criptomoneda Tether.
  • Servidores Galaxy a gran escala. Cada Galaxy Blackhole reúne 32 chips Blackhole con 1 TB de memoria GDDR6 en un armario de 6U refrigerado por aire, y alcanza 23 petaFLOPS en el formato de baja precisión que se usa para ejecutar modelos de IA. Su precio de lista es de $160,000 USD.
  • Su propia nube de modelos abiertos. Tenstorrent quiere servir en sus máquinas modelos de pesos abiertos, tanto de lenguaje como de generación de vídeo. Uno de los inversores, Protagonist, asegura que sus resultados en vídeo superan las referencias del sector antes de lo previsto.
  • Diseños que venden a otros. Además de chips, licencia su CPU RISC-V TT-Ascalon y sus núcleos de IA Tensix a empresas que fabrican su propio silicio. Samsung y LG son dos de sus clientes.
  • «Una arquitectura, a cualquier tamaño». Así lo resume Keller: «Construimos una sola arquitectura y la vendemos en todos los tamaños». Y añade que el futuro de la computación es «abierto, escalable y propiedad de quienes construyen sobre él».

Por qué importa

NVIDIA domina el hardware para inteligencia artificial gracias a sus chips y, sobre todo, a CUDA, el software sobre el que se ha construido casi todo el sector. Tenstorrent propone lo contrario: una arquitectura abierta, software abierto y la posibilidad de que otras empresas compren sus diseños para hacer sus propios chips. Con esta ronda, la apuesta pasa de ser una curiosidad técnica a tener dinero para fabricar en serio, y con fondos como Fidelity, Morgan Stanley o T. Rowe Price detrás.

Para RISC-V es también un respaldo importante. La arquitectura abierta ya está en microcontroladores y en algunos procesadores de uso general, y que una empresa del tamaño de Tenstorrent la lleve a los centros de datos de IA, y la licencie a Samsung y LG, la acerca a competir de verdad con x86 y Arm. Llega, además, en un momento en el que los grandes compradores de chips buscan cualquier alternativa a depender de un único proveedor.

Queda por ver lo más difícil: fabricar a gran escala y convencer a los desarrolladores de que cambien de software. NVIDIA vende millones de chips y Tenstorrent está empezando a fabricar en volumen. Pero con $1,500 millones de USD y uno de los ingenieros de procesadores más respetados al frente, la alternativa abierta a NVIDIA tiene, por primera vez, los recursos para intentarlo de verdad.

Más fuentes: ficha del servidor Galaxy Blackhole, de Tenstorrent; la ronda de 2024, en BetaKit. Sobre otros procesadores para IA: los portátiles con NVIDIA RTX Spark. Portada: foto de LG Electronics, licencia CC BY 2.0, Wikimedia Commons.

Fuente: Tenstorrent, «Tenstorrent Announces a $1.5B Series E at a $6.2B valuation»

Un atacante usó agentes de IA para entrar en más de 100 webs: unos $50 USD por intrusión, según NorForge

Tarjeta bancaria con chip apoyada sobre el teclado de un portátil

Un solo atacante, con unas instrucciones de pocas líneas y unos $5,000 USD en uso de modelos de IA, puso a trabajar a decenas de agentes de IA contra más de 1,200 tiendas en línea y consiguió entrar en más de 100 webs. Lo cuenta la empresa de seguridad noruega NorForge, que lo descubrió por un descuido del propio atacante: había dejado en internet, sin contraseña, los paneles de control de Cairn, la plataforma de código abierto con la que dirigía a sus agentes.

Que los delincuentes usan IA para atacar no es nuevo. En septiembre, Gambit Security describió una campaña en la que agentes de IA robaron al menos 600,000 registros de tarjetas de 25 empresas, y este mismo mes ya contamos cómo unos presuntos espías chinos explotaron un fallo de BeyondTrust. Lo distinto esta vez es que se puede ver el trabajo por dentro: qué pidió el atacante, cuánto tardaron los agentes y qué les salió bien.

Cairn se define como un motor de resolución de problemas: el operador le da un origen, por ejemplo una web, y un objetivo, como conseguir ejecutar código en ella. Varios agentes avanzan por turnos, y cada uno apunta en una pizarra compartida lo que ha averiguado y lo que piensa intentar, para que los demás lo aprovechen. Está pensada para pruebas de intrusión autorizadas, y su autor, que firma como «le1xia0», le dijo a Reuters que no fue diseñada para ataques. Pero nada impide usarla contra cualquiera.

Claves de la campaña de Cairn

  • Más de 20 paneles expuestos. El investigador Snorre Fagerland, de NorForge, empezó a buscarlos a raíz del informe de Gambit, con buscadores de equipos conectados a internet como Shodan y Censys. La mayoría de estos paneles piden contraseña; algunos no. Los agrupó en tres operaciones por el idioma, los objetivos y las instrucciones.
  • El grupo principal escribe en chino y busca quedarse dentro. Tiene 14 paneles y más de 1,100 proyectos de ataque contra tiendas en línea de EE. UU., Japón, Australia y Canadá. Sus agentes intentaban ejecutar código en cada web y dejar instalado un web shell, un pequeño programa que da acceso remoto, para volver cuando quisieran a la tienda y a su sistema de pagos. NorForge comprobó que uno de ellos seguía activo en la web de un gran proveedor de piezas.
  • El segundo grupo va a por el dinero. Escribe en inglés, tiene 10 paneles y apunta a pasarelas de pago, tiendas de dudosa reputación, farmacias en línea y comercios africanos, con el objetivo de robar tarjetas y criptomonedas. Un tercer panel, con 59 proyectos, parece exploratorio, y NorForge lo marca como malicioso con poca confianza.
  • Unas 23 horas por intrusión, y un éxito de 1 de cada 10. Los ataques con éxito del grupo principal tardaron de media un poco menos de 23 horas desde que se lanzaron hasta que se cumplió el objetivo. NorForge calcula que la tasa de éxito ronda el 10 %, aunque muchos de los intentos fallidos dejaron información útil para un segundo intento.
  • Unos $50 USD por cada web. Fagerland estima unos $5 USD por tarea, contando las que se abandonan pronto, y unos $5,000 USD en toda la campaña: alrededor de $50 USD por intrusión con éxito. Avisa de que no tiene datos reales de consumo y de que la cifra puede estar bastante desviada.
  • Modelos baratos. Las tareas del grupo principal las ejecutaba un trabajador llamado «claudecode_deepseek-v4.1-flash», lo que apunta a Claude Code, de Anthropic, funcionando con el modelo económico DeepSeek V4.1 Flash. El segundo grupo usaba DeepSeek a través de OpenRouter.
  • Víctimas conocidas. NorForge no da nombres, pero Reuters revisó la actividad de los paneles e identificó a Deere, que dice haber tomado medidas y no ve indicios de acceso a datos sensibles; SharkNinja, que habla de un sitio de soporte de productos separado y ya contenido, y Cummins, que investiga un posible ataque a la web de uno de sus proveedores. Reuters no pudo saber cuántos datos se llevaron, si se llevaron alguno.
  • Los atacantes también dejaron sus secretos al aire. En los paneles había cientos de contraseñas, claves de API y otros secretos; la herramienta Trufflehog confirmó que el 11 % seguían siendo válidos. NorForge retiene las direcciones de los paneles hasta que se cierren.

Por qué importa

Hasta ahora se daba por hecho que un agente de IA que ataca webs necesita a alguien detrás que lo vigile y lo corrija. Fagerland reconoce que él también lo pensaba, y califica de «asombroso» lo que ha visto: las instrucciones eran muy breves y los agentes hicieron el resto solos, día y noche, contra cientos de objetivos a la vez. Con $50 USD por web, atacar deja de ser caro, y lo que antes exigía un equipo de expertos queda al alcance de una sola persona con poca experiencia.

El informe deja otro aviso para el sector: entre los paneles abiertos había también pruebas de intrusión legítimas, de empresas de seguridad que trabajaban para clientes reales, con sus datos a la vista. NorForge lo califica de «muy problemático». Para quien tiene una tienda en línea, la conclusión es la de siempre, pero con más urgencia: mantener al día el gestor de la tienda y sus complementos, vigilar los archivos nuevos que aparecen en el servidor y no dar por hecho que un sitio pequeño no le interesa a nadie, porque a un agente le da igual.

La campaña muestra a la vez lo mejor y lo peor de estas herramientas. Las mismas plataformas que permiten a una empresa de seguridad revisar cien webs en una noche permiten a un delincuente atacarlas, y en este caso fue el descuido de los atacantes el que permitió descubrirlo. Es probable que el próximo grupo no deje la puerta abierta.

Actualización (17 de noviembre de 2026): el informe de Google Threat Intelligence Group del 16 de noviembre confirma que CAIRN se usó en ataques contra el sector aeroespacial de Estados Unidos, y describe una herramienta que va un paso más allá: exploit_agent, un agente de IA que convierte parches de seguridad en ataques sin ayuda humana.

Más fuentes: TNW, con los datos de la investigación de Reuters y las respuestas de las empresas. Portada: foto de Shixart1985, licencia CC BY 2.0, Wikimedia Commons.

Fuente: NorForge, «Inside Cairn: Open Windows into massive AI-Driven Cyber Operations»