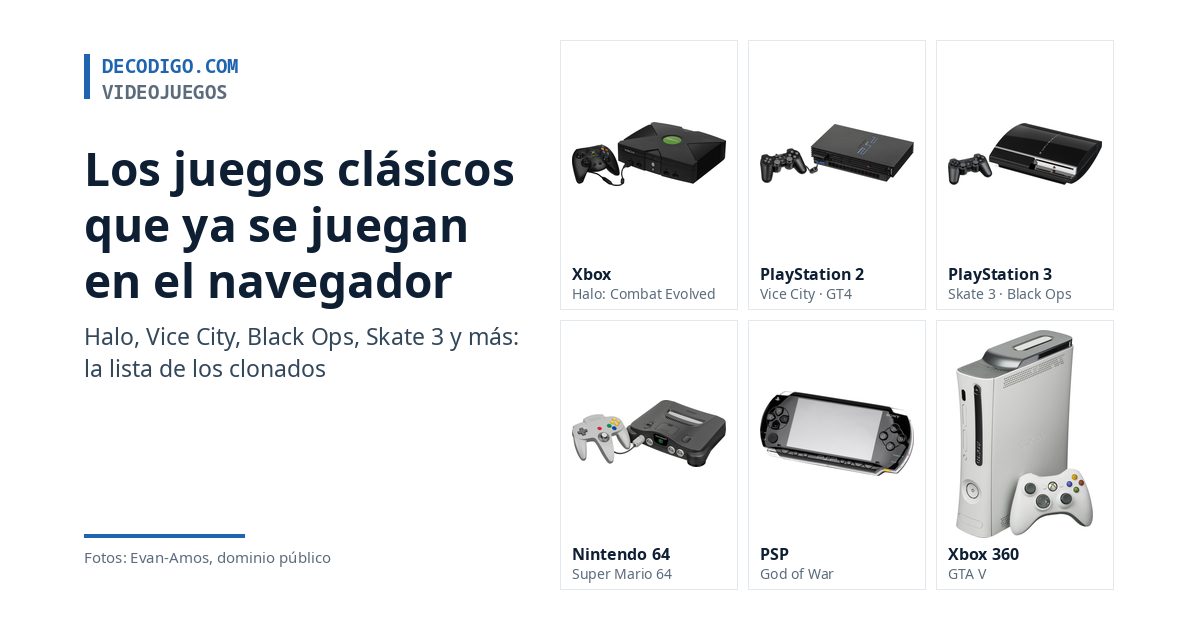
Halo, Vice City, Black Ops, Skate 3 y más: los juegos clásicos que ya se juegan en el navegador

Collage de seis consolas: Xbox, PlayStation 2, PlayStation 3, Nintendo 64, PSP y Xbox 360, con los juegos clásicos de cada una que ya se juegan en el navegador

En las últimas semanas han aparecido versiones para el navegador de algunos de los juegos clásicos más queridos de los años 2000: Halo: Combat Evolved, GTA: Vice City, Call of Duty: Black Ops, Skate 3, God of War o Super Mario 64. Se abren en una pestaña, sin instalar nada, y según Kotaku algunas funcionan casi a la perfección. Esta es la lista de lo que se ha clonado hasta ahora, de qué consola viene cada juego y en qué estado está.

Kotaku contó el 9 de octubre que en dos semanas habían surgido «cientos» de emuladores y juegos descompilados, y lo atribuyó en buena parte a Claude Opus 5.5, el modelo de Anthropic. Su periodista, Lewis Parker, probó varios y destacó que casi todos son de la época de PlayStation 2 y PlayStation 3. Cómo se hacen, por qué la comunidad de la descompilación está dividida y qué han hecho las editoras lo contamos en la IA desborda la descompilación de juegos; aquí nos centramos en los juegos.

Hemos revisado cada proyecto en su web, en su repositorio o en el registro público de retiradas de GitHub. Un aviso antes de empezar: la lista cambia a diario, varios de estos juegos ya existían en el navegador antes de esta ola y no enlazamos ninguna versión, porque muchas reparten los archivos de juegos que siguen a la venta.

Los juegos clonados, uno a uno

  • Halo: Combat Evolved (Xbox, 2001). Es el más sonado. Mitchell Hynes lo anunció el 29 de septiembre con partidas en línea, a partir de una descompilación que otros llevaban meses haciendo. No incluye nada del juego: pide la imagen de tu propio disco de Xbox. Kotaku probó cuatro versiones distintas de Halo. La de Hynes sigue en línea, aunque ahora se llama «Combat Lab» y ya no menciona Halo en ningún sitio; no ha explicado por qué.
  • GTA: Vice City (PlayStation 2, 2002). Corre en el navegador sobre reVC, el proyecto de aficionados que reconstruyó su código hace años, y pide los archivos de tu copia. Sigue en línea. El mismo sitio aloja también Command & Conquer: Generals Zero Hour, cuyo código publicó la propia EA.
  • Call of Duty: Black Ops (2010). Luckey Faraday llevó al navegador partes de Black Ops y Black Ops II, incluido el mapa de zombis Kino der Toten. Según XDA, usaba mapas, modelos y animaciones de los juegos originales. Activision le envió una retirada por derechos de autor el 10 de octubre, y él mismo anunció que todo quedaba fuera de línea, aunque circulan copias. Otro port, de Modern Warfare 2, también cayó por una reclamación.
  • Skate 3 (PlayStation 3 y Xbox 360, 2010). Se presenta como un juego hecho por aficionados, «no hecho por EA», que carga los datos de tu propia copia convertida. Sigue en línea.
  • The Simpsons: Hit & Run (2003). Es de los veteranos: se publicó hace unos seis meses a partir del código del juego que se filtró en 2021. No pide nada al jugador, porque sirve los archivos desde su propio servidor, y sigue en línea.
  • God of War (PSP y PlayStation 2). Un mismo autor ha llevado al navegador los dos God of War de PSP, Chains of Olympus y Ghost of Sparta, y en un proyecto hermano, creado el 8 de octubre y con más de 1,100 estrellas en GitHub, God of War II y Gran Turismo 4 de PS2. Todos piden tu copia.
  • Super Mario 64 (Nintendo 64, 1996). Oliver Sauter publicó una versión con partidas de hasta 12 jugadores y videochat, hecha con ayuda de IA según XDA. Desde el 10 de octubre pide la ROM propia, y los vídeos en los que la mostraba en X fueron desactivados por una reclamación del titular de los derechos. La web sigue funcionando.
  • GTA V (Xbox 360 y PS3, 2013). El caso más llamativo duró horas: una web lo ponía a jugar directamente en Chrome, con todos los archivos del juego incluidos, y dejó de funcionar el 6 de octubre. No se sabe si la cerró una reclamación de Take-Two, y ya circulan copias en otros dominios.
  • Celeste (2018). Su estudio, Maddy Makes Games, pidió a GitHub el 14 de octubre retirar los archivos de una versión para el navegador que incluía los gráficos y sonidos del juego. Es una de las pocas retiradas que constan en el registro público.
  • Y otros clásicos de PC. También funcionan hoy en el navegador GTA III, Command & Conquer: Red Alert 2, LEGO Island y Counter-Strike 1.6, entre otros. Las listas de aficionados que siguen el fenómeno ya reúnen entre 30 y 80 proyectos.
JuegoConsola original¿Pide tu copia?Estado el 19 de octubre
Halo: Combat EvolvedXboxSí, la imagen del discoEn línea, renombrado «Combat Lab»
GTA: Vice CityPlayStation 2SíEn línea
Call of Duty: Black OpsPC, PS3, Xbox 360NoRetirado por Activision
Call of Duty: Modern Warfare 2PC, PS3, Xbox 360NoRetirado por una reclamación
Skate 3PS3, Xbox 360SíEn línea
The Simpsons: Hit & RunPS2, GameCube, Xbox, PCNoEn línea
God of War (PSP) y God of War IIPSP, PlayStation 2SíEn línea
Gran Turismo 4PlayStation 2SíEn línea
Super Mario 64Nintendo 64Sí, desde el 10 de octubreEn línea; vídeos retirados
GTA VPS3, Xbox 360NoCaído desde el 6 de octubre; hay copias
CelestePC y consolasNoArchivos retirados por su estudio

La ola tiene también juegos que se suelen meter en la misma lista pero no van en el navegador. Banjo-Tooie, de Nintendo 64, tiene un port hecho con IA, pero es un programa para Windows, y le valió la crítica de DarioSamo, autor de la versión para PC de Banjo-Kazooie, que lo calificó de falta de respeto al trabajo de otros. Lo mismo pasa con Super Smash Bros. Ultimate, Mario Kart 8 Deluxe, Super Mario Odyssey o Metroid Prime, que según Kotaku ya tienen versiones para PC. Y Fallout: New York, que su autor cerró tras una carta de ZeniMax, no era un clon sino un juego nuevo hecho con Claude.

Por qué importa

La lista dice mucho de quién está detrás: no son juegos raros ni olvidados, sino los superventas de una generación, los que se jugaban en el salón con amigos hace veinte años. Que se puedan abrir en una pestaña, en un ordenador cualquiera, convierte en algo inmediato lo que antes exigía emuladores, configuraciones y paciencia.

También marca la frontera que están vigilando las editoras. Las versiones que piden tu propia copia, como Halo, Vice City o Skate 3, siguen en línea; las que reparten el juego entero, como Black Ops o GTA V, han caído o se esconden en dominios nuevos. Llama la atención, eso sí, que en el registro público de GitHub no conste ninguna retirada de Activision, Take-Two, Microsoft ni Sony: sus reclamaciones, si las hay, van por otras vías.

Y es muy probable que la lista crezca. Kotaku ya da cuenta de proyectos con juegos de Nintendo, y cada semana aparecen títulos nuevos en las listas de aficionados. Para los jugadores es una forma nueva de volver a sus clásicos; para las editoras, la señal de que hay demanda de esos juegos que muchas veces ya no venden.

Más fuentes: heise; la retirada de Call of Duty, en XDA; el aviso de Celeste, en el registro de retiradas de GitHub; los juegos de Nintendo, en Kotaku. Portada: fotos de las consolas de Evan-Amos, dominio público, Wikimedia Commons.
Fuente: Kotaku, «We Might Be Cooked, As These Vibe-Coded Web Browser Ports Of Halo, The Simpsons: Hit And Run, And GTA: Vice City Seem To Work Perfectly»

Tenstorrent, la empresa de chips RISC-V de Jim Keller, recauda $1,500 millones de USD y ya vale $6,200 millones

Jim Keller, director ejecutivo de Tenstorrent, sonriente con un jersey azul marino

Tenstorrent, la empresa de chips de inteligencia artificial que dirige Jim Keller, ha cerrado una ronda de financiación de $1,500 millones de USD que la valora en $6,200 millones de USD, más del doble que hace menos de dos años. Usará el dinero para fabricar en volumen sus servidores Galaxy, ofrecer modelos de IA abiertos en su propia infraestructura y seguir vendiendo a otras empresas los diseños de sus núcleos RISC-V.

Jim Keller es una de las figuras más conocidas del diseño de procesadores: participó en los chips A4 y A5 de Apple, en la arquitectura Zen de AMD y en el chip de conducción autónoma de Tesla. Desde 2023 es el director ejecutivo de Tenstorrent, una empresa fundada en Toronto en 2016 y hoy con sede en Santa Clara, que se ha propuesto competir con NVIDIA de una forma distinta: con hardware basado en RISC-V, una arquitectura de procesador abierta que cualquiera puede usar sin pagar licencias, y con todo su software publicado como código abierto.

Su ronda anterior, de diciembre de 2024, fue de más de $693 millones de USD, la lideraron Samsung Securities y AFW Partners, y en ella entraron Bezos Expeditions, el fondo de Jeff Bezos, y LG Electronics. La valoró en unos $2,600 millones de USD. A mediados de este año, según Bloomberg, Intel y Qualcomm llegaron a sondear su compra; Keller negó que hubiera negociaciones con Qualcomm, y ahora la empresa ha optado por seguir sola.

Claves de la ronda de Tenstorrent

  • $1,500 millones de USD en una serie E, con una valoración posterior de $6,200 millones de USD. La lideran Trace Capital, un fondo creado este año, e Innovation X.
  • Inversores de peso. Participan, entre otros, Fidelity, ARK Invest, Morgan Stanley, T. Rowe Price, Sandisk, XTX Markets y Tether Investments, el brazo inversor de la empresa de la criptomoneda Tether.
  • Servidores Galaxy a gran escala. Cada Galaxy Blackhole reúne 32 chips Blackhole con 1 TB de memoria GDDR6 en un armario de 6U refrigerado por aire, y alcanza 23 petaFLOPS en el formato de baja precisión que se usa para ejecutar modelos de IA. Su precio de lista es de $160,000 USD.
  • Su propia nube de modelos abiertos. Tenstorrent quiere servir en sus máquinas modelos de pesos abiertos, tanto de lenguaje como de generación de vídeo. Uno de los inversores, Protagonist, asegura que sus resultados en vídeo superan las referencias del sector antes de lo previsto.
  • Diseños que venden a otros. Además de chips, licencia su CPU RISC-V TT-Ascalon y sus núcleos de IA Tensix a empresas que fabrican su propio silicio. Samsung y LG son dos de sus clientes.
  • «Una arquitectura, a cualquier tamaño». Así lo resume Keller: «Construimos una sola arquitectura y la vendemos en todos los tamaños». Y añade que el futuro de la computación es «abierto, escalable y propiedad de quienes construyen sobre él».

Por qué importa

NVIDIA domina el hardware para inteligencia artificial gracias a sus chips y, sobre todo, a CUDA, el software sobre el que se ha construido casi todo el sector. Tenstorrent propone lo contrario: una arquitectura abierta, software abierto y la posibilidad de que otras empresas compren sus diseños para hacer sus propios chips. Con esta ronda, la apuesta pasa de ser una curiosidad técnica a tener dinero para fabricar en serio, y con fondos como Fidelity, Morgan Stanley o T. Rowe Price detrás.

Para RISC-V es también un respaldo importante. La arquitectura abierta ya está en microcontroladores y en algunos procesadores de uso general, y que una empresa del tamaño de Tenstorrent la lleve a los centros de datos de IA, y la licencie a Samsung y LG, la acerca a competir de verdad con x86 y Arm. Llega, además, en un momento en el que los grandes compradores de chips buscan cualquier alternativa a depender de un único proveedor.

Queda por ver lo más difícil: fabricar a gran escala y convencer a los desarrolladores de que cambien de software. NVIDIA vende millones de chips y Tenstorrent está empezando a fabricar en volumen. Pero con $1,500 millones de USD y uno de los ingenieros de procesadores más respetados al frente, la alternativa abierta a NVIDIA tiene, por primera vez, los recursos para intentarlo de verdad.

Más fuentes: ficha del servidor Galaxy Blackhole, de Tenstorrent; la ronda de 2024, en BetaKit. Sobre otros procesadores para IA: los portátiles con NVIDIA RTX Spark. Portada: foto de LG Electronics, licencia CC BY 2.0, Wikimedia Commons.

Fuente: Tenstorrent, «Tenstorrent Announces a $1.5B Series E at a $6.2B valuation»

Un atacante usó agentes de IA para entrar en más de 100 webs: unos $50 USD por intrusión, según NorForge

Tarjeta bancaria con chip apoyada sobre el teclado de un portátil

Un solo atacante, con unas instrucciones de pocas líneas y unos $5,000 USD en uso de modelos de IA, puso a trabajar a decenas de agentes de IA contra más de 1,200 tiendas en línea y consiguió entrar en más de 100 webs. Lo cuenta la empresa de seguridad noruega NorForge, que lo descubrió por un descuido del propio atacante: había dejado en internet, sin contraseña, los paneles de control de Cairn, la plataforma de código abierto con la que dirigía a sus agentes.

Que los delincuentes usan IA para atacar no es nuevo. En septiembre, Gambit Security describió una campaña en la que agentes de IA robaron al menos 600,000 registros de tarjetas de 25 empresas, y este mismo mes ya contamos cómo unos presuntos espías chinos explotaron un fallo de BeyondTrust. Lo distinto esta vez es que se puede ver el trabajo por dentro: qué pidió el atacante, cuánto tardaron los agentes y qué les salió bien.

Cairn se define como un motor de resolución de problemas: el operador le da un origen, por ejemplo una web, y un objetivo, como conseguir ejecutar código en ella. Varios agentes avanzan por turnos, y cada uno apunta en una pizarra compartida lo que ha averiguado y lo que piensa intentar, para que los demás lo aprovechen. Está pensada para pruebas de intrusión autorizadas, y su autor, que firma como «le1xia0», le dijo a Reuters que no fue diseñada para ataques. Pero nada impide usarla contra cualquiera.

Claves de la campaña de Cairn

  • Más de 20 paneles expuestos. El investigador Snorre Fagerland, de NorForge, empezó a buscarlos a raíz del informe de Gambit, con buscadores de equipos conectados a internet como Shodan y Censys. La mayoría de estos paneles piden contraseña; algunos no. Los agrupó en tres operaciones por el idioma, los objetivos y las instrucciones.
  • El grupo principal escribe en chino y busca quedarse dentro. Tiene 14 paneles y más de 1,100 proyectos de ataque contra tiendas en línea de EE. UU., Japón, Australia y Canadá. Sus agentes intentaban ejecutar código en cada web y dejar instalado un web shell, un pequeño programa que da acceso remoto, para volver cuando quisieran a la tienda y a su sistema de pagos. NorForge comprobó que uno de ellos seguía activo en la web de un gran proveedor de piezas.
  • El segundo grupo va a por el dinero. Escribe en inglés, tiene 10 paneles y apunta a pasarelas de pago, tiendas de dudosa reputación, farmacias en línea y comercios africanos, con el objetivo de robar tarjetas y criptomonedas. Un tercer panel, con 59 proyectos, parece exploratorio, y NorForge lo marca como malicioso con poca confianza.
  • Unas 23 horas por intrusión, y un éxito de 1 de cada 10. Los ataques con éxito del grupo principal tardaron de media un poco menos de 23 horas desde que se lanzaron hasta que se cumplió el objetivo. NorForge calcula que la tasa de éxito ronda el 10 %, aunque muchos de los intentos fallidos dejaron información útil para un segundo intento.
  • Unos $50 USD por cada web. Fagerland estima unos $5 USD por tarea, contando las que se abandonan pronto, y unos $5,000 USD en toda la campaña: alrededor de $50 USD por intrusión con éxito. Avisa de que no tiene datos reales de consumo y de que la cifra puede estar bastante desviada.
  • Modelos baratos. Las tareas del grupo principal las ejecutaba un trabajador llamado «claudecode_deepseek-v4.1-flash», lo que apunta a Claude Code, de Anthropic, funcionando con el modelo económico DeepSeek V4.1 Flash. El segundo grupo usaba DeepSeek a través de OpenRouter.
  • Víctimas conocidas. NorForge no da nombres, pero Reuters revisó la actividad de los paneles e identificó a Deere, que dice haber tomado medidas y no ve indicios de acceso a datos sensibles; SharkNinja, que habla de un sitio de soporte de productos separado y ya contenido, y Cummins, que investiga un posible ataque a la web de uno de sus proveedores. Reuters no pudo saber cuántos datos se llevaron, si se llevaron alguno.
  • Los atacantes también dejaron sus secretos al aire. En los paneles había cientos de contraseñas, claves de API y otros secretos; la herramienta Trufflehog confirmó que el 11 % seguían siendo válidos. NorForge retiene las direcciones de los paneles hasta que se cierren.

Por qué importa

Hasta ahora se daba por hecho que un agente de IA que ataca webs necesita a alguien detrás que lo vigile y lo corrija. Fagerland reconoce que él también lo pensaba, y califica de «asombroso» lo que ha visto: las instrucciones eran muy breves y los agentes hicieron el resto solos, día y noche, contra cientos de objetivos a la vez. Con $50 USD por web, atacar deja de ser caro, y lo que antes exigía un equipo de expertos queda al alcance de una sola persona con poca experiencia.

El informe deja otro aviso para el sector: entre los paneles abiertos había también pruebas de intrusión legítimas, de empresas de seguridad que trabajaban para clientes reales, con sus datos a la vista. NorForge lo califica de «muy problemático». Para quien tiene una tienda en línea, la conclusión es la de siempre, pero con más urgencia: mantener al día el gestor de la tienda y sus complementos, vigilar los archivos nuevos que aparecen en el servidor y no dar por hecho que un sitio pequeño no le interesa a nadie, porque a un agente le da igual.

La campaña muestra a la vez lo mejor y lo peor de estas herramientas. Las mismas plataformas que permiten a una empresa de seguridad revisar cien webs en una noche permiten a un delincuente atacarlas, y en este caso fue el descuido de los atacantes el que permitió descubrirlo. Es probable que el próximo grupo no deje la puerta abierta.

Más fuentes: TNW, con los datos de la investigación de Reuters y las respuestas de las empresas. Portada: foto de Shixart1985, licencia CC BY 2.0, Wikimedia Commons.

Fuente: NorForge, «Inside Cairn: Open Windows into massive AI-Driven Cyber Operations»

Anatomy, la skill de Claude Code que explica ideas convirtiéndolas en máquinas

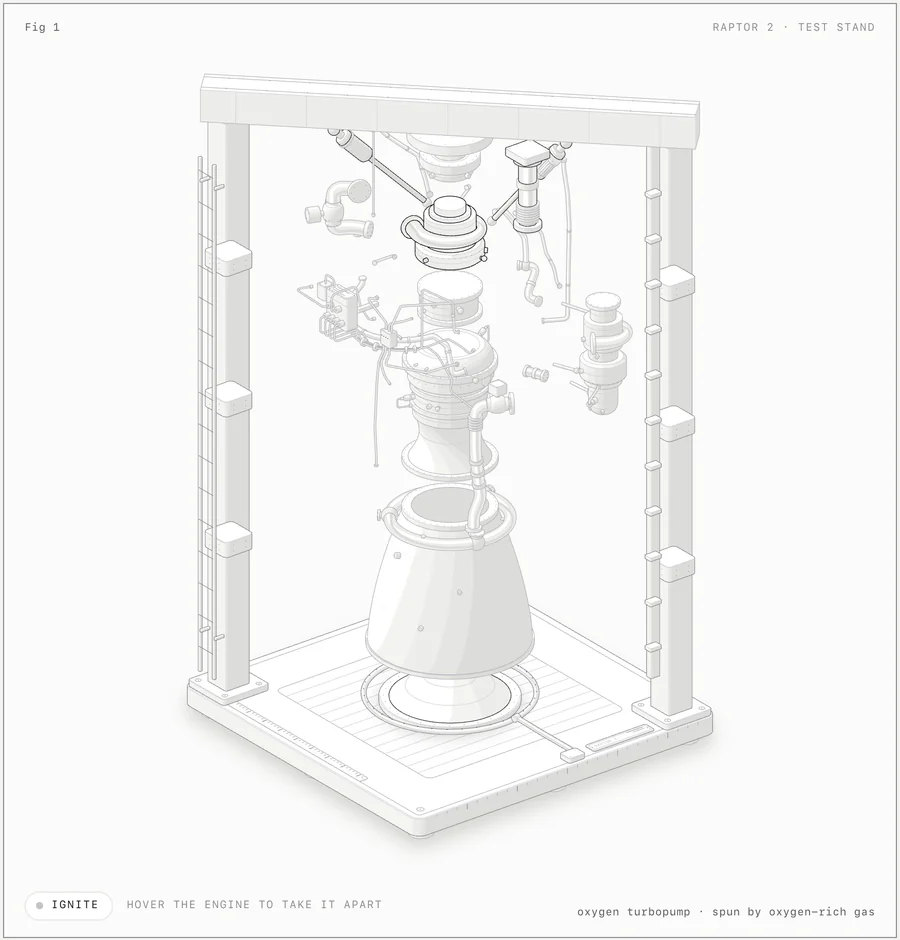
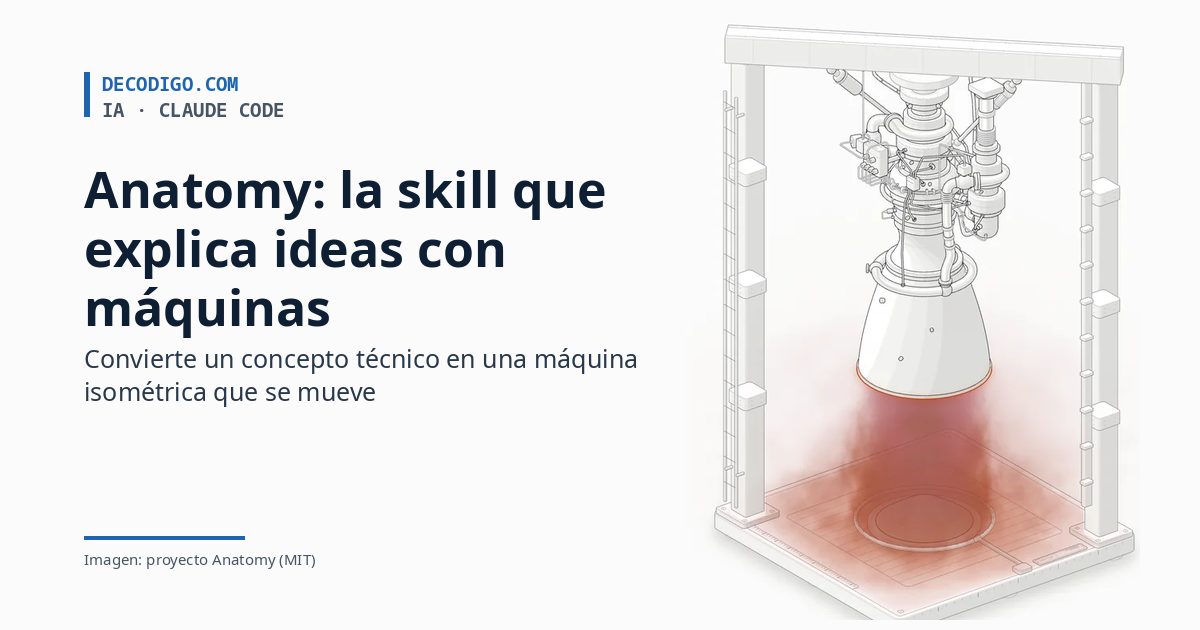
Figura isométrica del motor Raptor 2 encendido en su banco de pruebas, junto al titular sobre la skill Anatomy

Anatomy es una skill de código abierto para Claude Code que explica una idea técnica construyéndola como una máquina: le pides que explique cómo funciona un limitador de peticiones o una caché, y en lugar de un diagrama de cajas y flechas inventa un objeto real cuyo mecanismo es el concepto, lo dibuja en perspectiva isométrica con decenas de piezas y lo hace moverse con el ratón. La publicó el 10 de octubre un desarrollador independiente, Ryan (@wheresryan22), y en nueve días ha pasado de las 16,700 estrellas en GitHub.

Una skill es la forma que tiene Anthropic de enseñar a Claude un oficio concreto. La presentó en octubre de 2025 y en diciembre la convirtió en un estándar abierto, Agent Skills: una carpeta con un archivo SKILL.md de instrucciones, más los scripts y documentos que necesite. Claude solo carga al empezar el nombre y la descripción de cada skill instalada, y lee el resto cuando la tarea lo pide. Anatomy no es de Anthropic, pero sigue ese formato, así que funciona en Claude Code y también en otros agentes que lo han adoptado: Codex de OpenAI, OpenCode, Antigravity de Google y MiniMax Code.

Su lema está en la primera línea de su SKILL.md: «el objeto es la explicación». Una clave de caché que evita repetir trabajo se convierte en una cerradura de pines que solo gira cuando todos coinciden; un contexto de GPU compartido por muchos lienzos, en un trazador cuyo único cabezal visita 16 pocillos. Después, la skill guía a Claude para construir ese objeto pieza a pieza, ponerlo en una tarjeta con título y una lectura en vivo, animarlo y, sobre todo, revisarlo como lo haría un crítico exigente.

Figura isométrica de Anatomy: el motor Raptor 2 desmontado en 11 conjuntos dentro de su banco de pruebas
El ejemplo más ambicioso del proyecto: un motor Raptor 2 en su banco de pruebas que, al pasar el ratón, se desmonta en 11 conjuntos. Una auditoría comprueba que ninguna tubería atraviesa nada, ni en reposo, ni desmontado, ni en ningún fotograma intermedio. Imagen: proyecto Anatomy, licencia MIT.

Claves de Anatomy

  • Se instala con una orden. npx skills add wheresryan22/anatomy -g -a claude-code la copia en ~/.claude/skills/anatomy, y después basta con escribir, por ejemplo, /anatomy explain how a token bucket rate limiter works, interactive. Claude también la usa sin nombrarla cuando se le pide una ilustración isométrica o una figura explicativa. Necesita Node.js 20.10 o posterior, y Chrome o Chromium para las comprobaciones; no instala ninguna dependencia, porque su biblioteca de dibujo solo usa módulos de Node.
  • Un método de diez pasos. Primero dimensiona el encargo (una «Figure» de 40 a 80 piezas, un «Hero» de 80 a 150 que lleva de 2 a 4 horas, o un «Epic» de 6 horas o más, que no empieza sin permiso), reúne los datos reales del fenómeno, inventa el objeto, escribe una lista de piezas, planifica el mundo, construye la geometría, ordena qué se pinta delante y detrás, enmarca la figura, la anima y la verifica.
  • Tres tipos de figura. SVG puro, que es la base; SVG con efectos WebGL para lo que las líneas no pueden dibujar, como fuego, agua, cáusticas o luz de lámpara; y un modo 3D, todavía en beta, en el que algunas piezas giran de verdad.
  • Lo que entrega es código, no una imagen. Un script de Node que escribe una página HTML independiente, un archivo SVG o componentes de React. Desde las últimas versiones también imprime la figura como un PDF A4 (póster, plano técnico o folleto) y la publica en una galería comunitaria si se le pide.
  • Se revisa a sí misma. La skill obliga a Claude a hacer capturas en un navegador sin ventanas, a ampliar cada unión al 400 %, a pasar una auditoría geométrica que demuestra que nada atraviesa nada y a comprobar que cada línea termina en algo. Y le dice que mire cada imagen que genera.
El conceptoLa máquina que lo explica
Un contexto de GPU que sirve a muchos lienzosUn trazador con un solo cabezal que visita 16 pocillos
Una clave de caché que evita repetir trabajoUna cerradura de pines que solo gira si todos coinciden
Siete texturas con distintos bytes por píxelUna cómoda de siete cajones, cada uno tan hondo como sus bytes
Un desenfoque separable (49 × 49 frente a 49 + 49)Un sello de clavos junto a dos peines sobre raíles
La luz que depende de hacia dónde mira una caraUn pequeño estudio de fotos con focos alrededor de un plato giratorio

La tabla sale del propio SKILL.md, que también advierte de los dos errores más comunes: quedarse corto en abstracción (placas apiladas y cajas con etiquetas que no recuerdan a nada) y quedarse corto en detalle (una pieza grande con cuatro líneas). La solución que propone para ambos es la misma: una máquina reconocible, hecha de muchas piezas pequeñas y con sentido.

Los ejemplos, abiertos uno a uno

El repositorio trae nueve figuras de ejemplo, y siete incluyen ya la página construida, así que se pueden abrir en el navegador sin instalar nada (las otras dos son componentes de React para copiar en un proyecto). Abrimos esas siete en Chromium, con WebGL, en sus dos temas, y ninguna dio un solo error. Estas son algunas de las capturas.

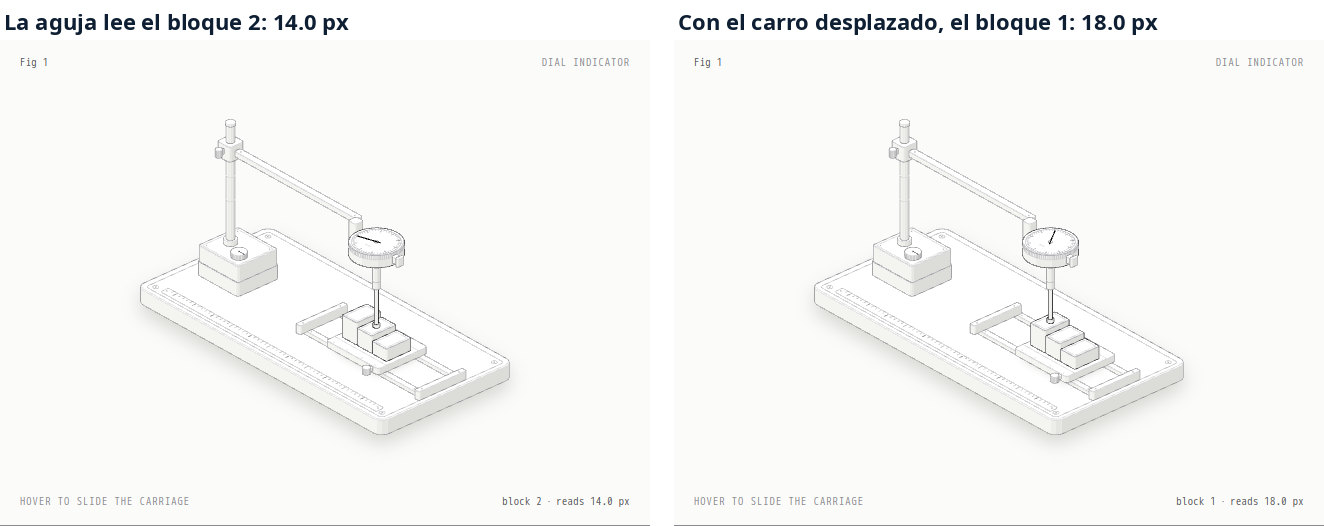
Dos estados del ejemplo dial-indicator de Anatomy: un comparador de reloj que mide dos bloques patrón distintos
El ejemplo más pequeño, unas 300 líneas: un comparador de reloj sobre un carro con bloques patrón. La aguja y la lectura de la esquina salen del mismo modelo que mueve las piezas: al desplazar el carro, el palpador pasa a otro bloque y la medida cambia. Imagen: proyecto Anatomy, licencia MIT.
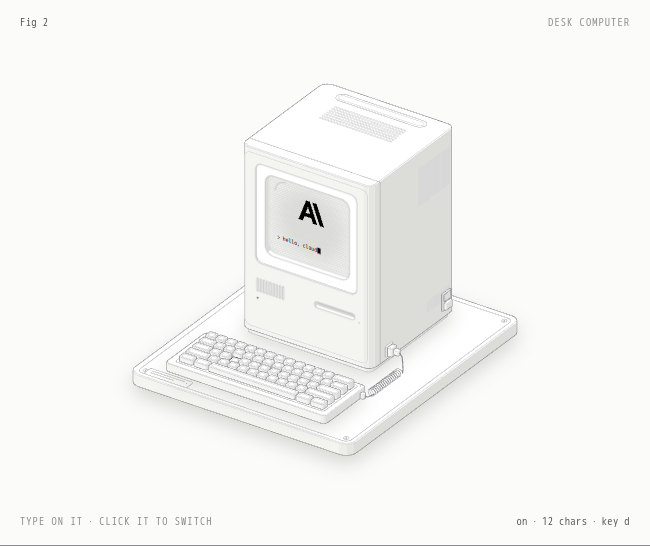
Ejemplo desk-computer de Anatomy: un ordenador de sobremesa de estilo 1984 con teclado, encendido
Un ordenador de sobremesa al estilo de 1984, con unas 85 piezas y un teclado en el que se puede escribir: el texto aparece en la pantalla, dibujada en el plano del frontal de la caja. Al apagarlo, la imagen se encoge a una línea y un punto, como en un tubo de rayos catódicos. Imagen: proyecto Anatomy, licencia MIT.
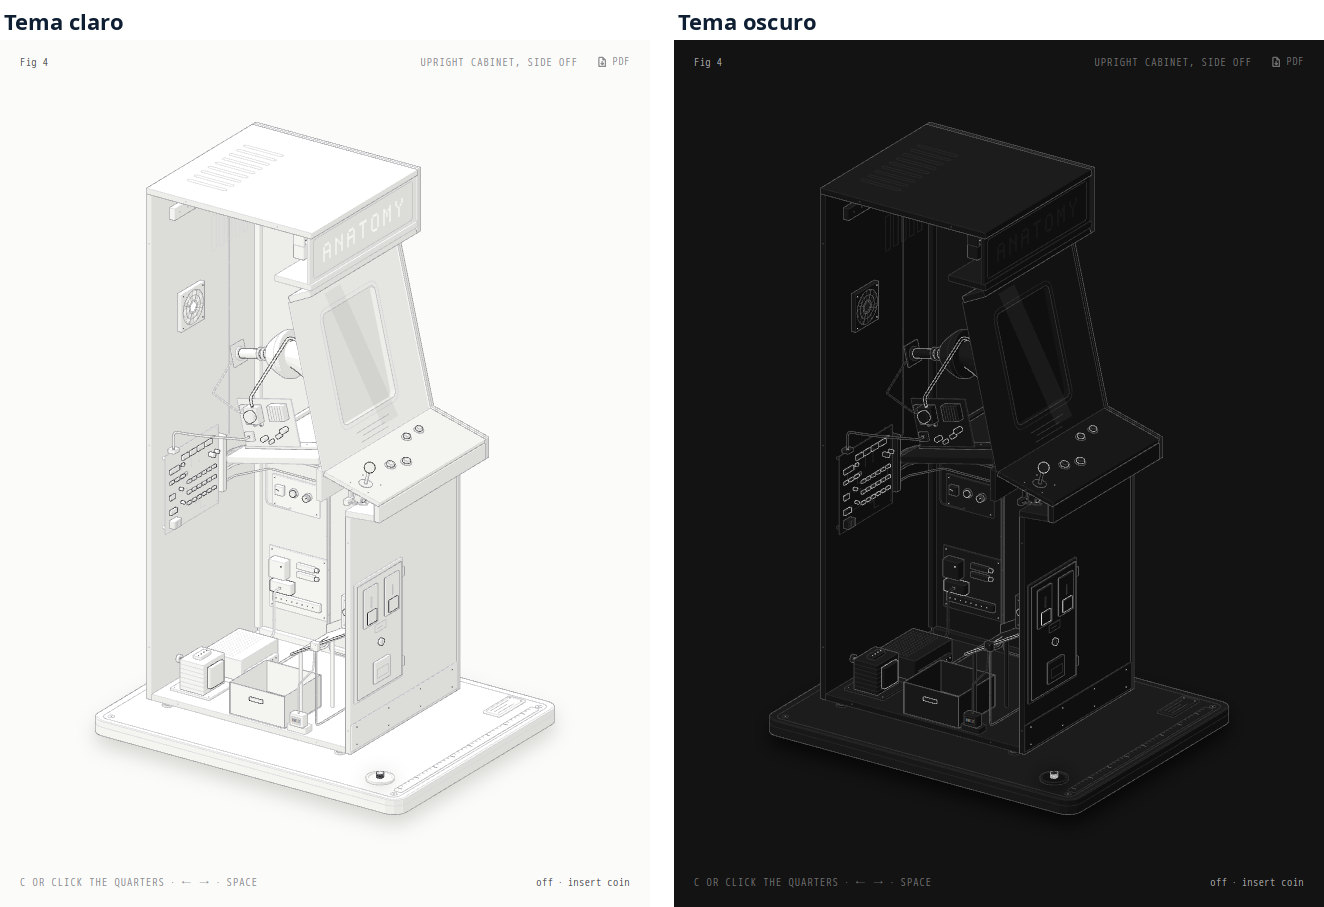
El ejemplo arcade-cabinet de Anatomy en tema claro y oscuro: una máquina recreativa con el panel lateral quitado
Una máquina recreativa con el panel lateral quitado, de unas 240 piezas y 15 cables, en sus dos temas. Al echar una moneda, rueda por el canal a la velocidad que alcanza un disco en una pendiente de 30°, activa el interruptor, el pulso recorre el cable hasta la placa y la pantalla se enciende. Imagen: proyecto Anatomy, licencia MIT.

Para comprobar que el proyecto hace lo que promete, reconstruimos tres de los ejemplos en un contenedor con Node.js 24: las páginas que salen son idénticas, byte a byte, a las publicadas en el repositorio, algo que su integración continua exige en cada cambio. Y la auditoría de la recreativa terminó con «audit passed» en 4.3 segundos, después de revisar 243 sólidos, 15 tubos y 1,290 pares de piezas que se solapan en pantalla para confirmar que cada una se pinta en el orden correcto.

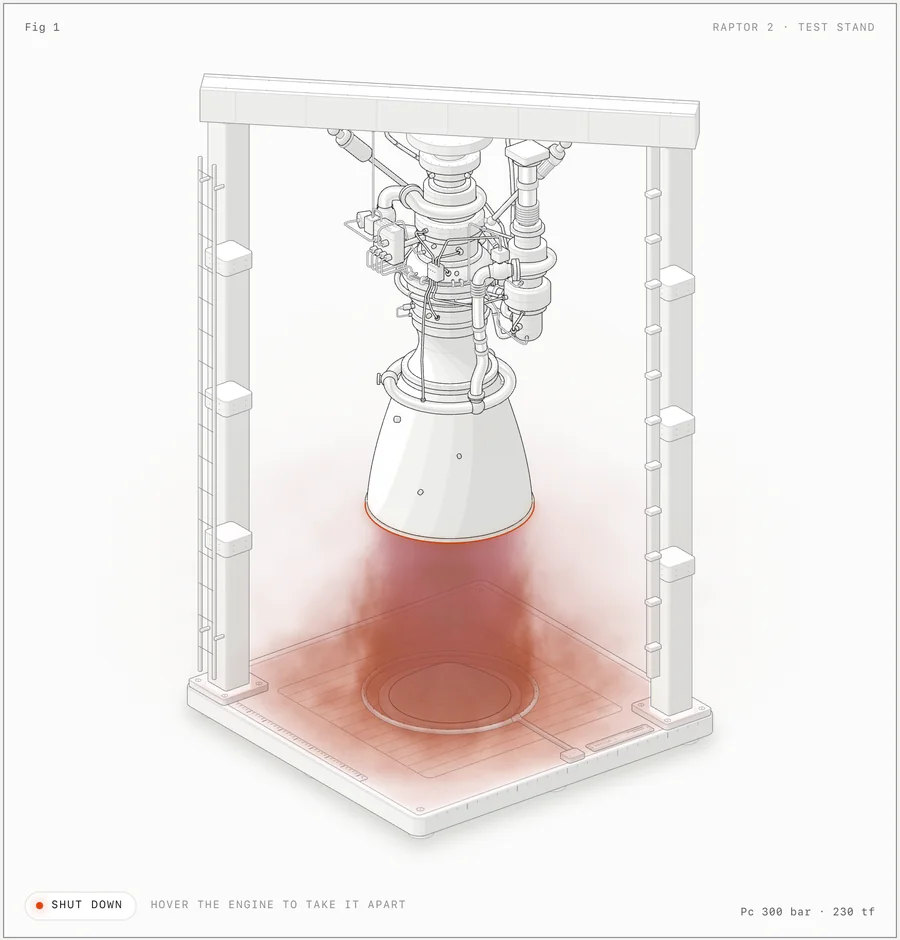
Figura isométrica de Anatomy: el motor Raptor 2 encendido en su banco de pruebas, con el chorro dibujado por un shader WebGL
El Raptor encendido. El motor y el banco son SVG; el chorro, el choque y el vapor son un shader WebGL que se dibuja entre una capa SVG trasera y otra delantera, con la misma cámara isométrica, así que parece formar parte del dibujo. Imagen: proyecto Anatomy, licencia MIT.
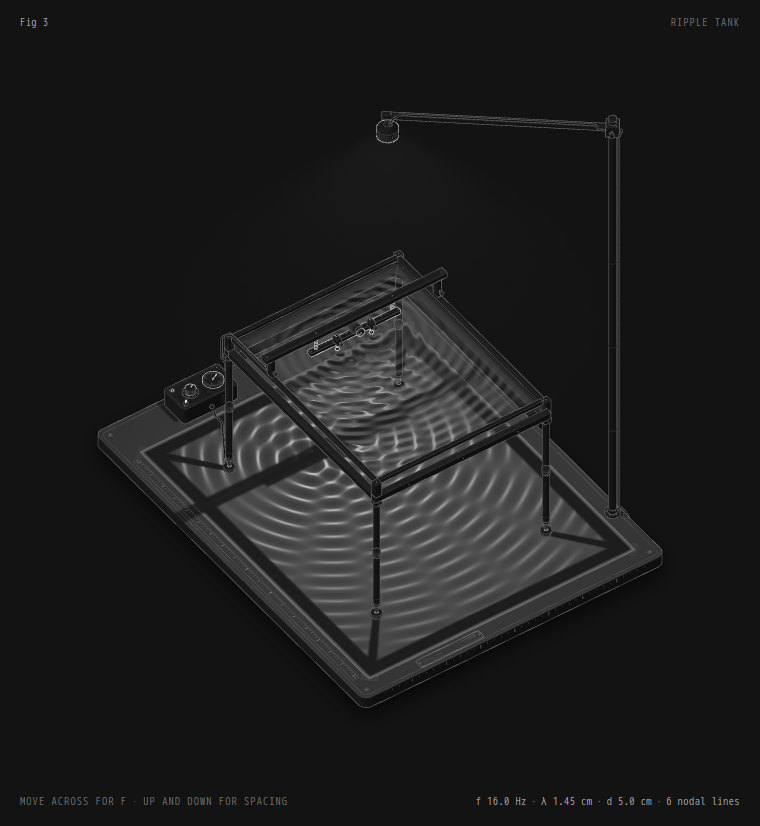
Ejemplo ripple-tank de Anatomy: una cubeta de ondas con dos fuentes que interfieren, dibujadas con WebGL
Una cubeta de ondas de laboratorio escolar. Dos capas WebGL, la luz de la lámpara con sus cáusticas sobre el papel y los reflejos del agua, están ajustadas a los planos isométricos y las mueve un modelo físico de dispersión y óptica. Imagen: proyecto Anatomy, licencia MIT.
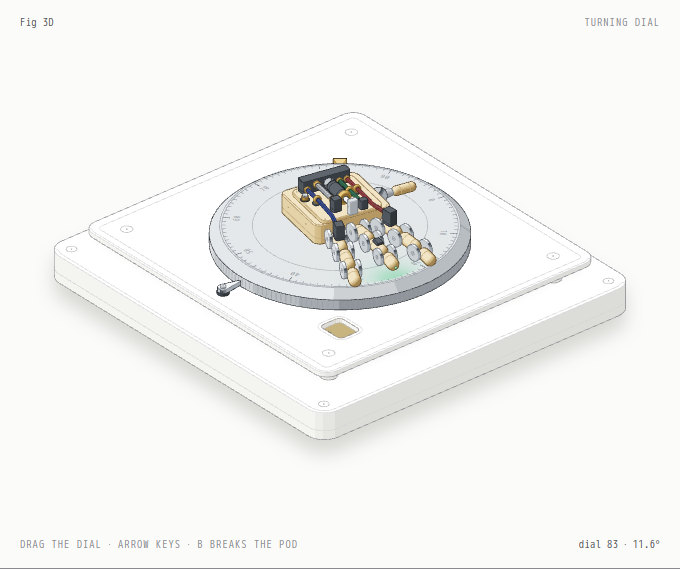
Ejemplo turning-dial de Anatomy en modo 3D: un dial de combinación con una pequeña mano robótica encima
El modo 3D, en beta: un dial de combinación que gira de verdad, con una pequeña mano robótica encima. Unas 90 piezas se vuelven a proyectar y a sombrear en cada fotograma mientras se arrastra el dial. Imagen: proyecto Anatomy, licencia MIT.
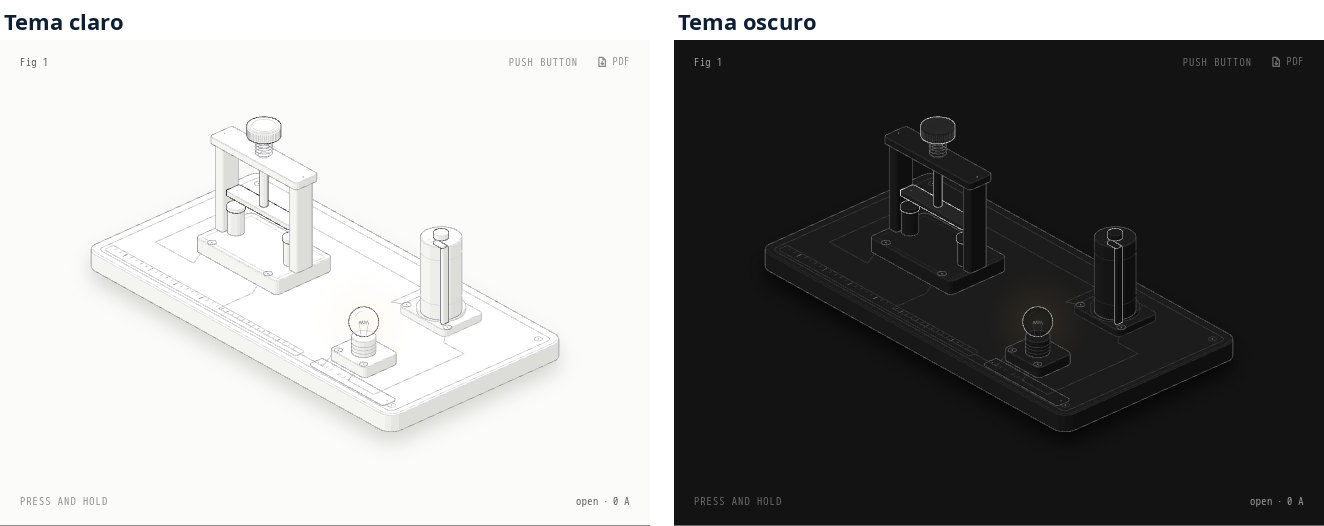
El ejemplo push-button de Anatomy en tema claro y oscuro: un pulsador sobre una placa con una bombilla
Un pulsador con una bombilla, en tema claro y oscuro. La skill diseña primero el tema claro, incluidos los efectos de luz, que en papel tienen que funcionar como tinta y no como brillo. Imagen: proyecto Anatomy, licencia MIT.

Por qué importa

Anatomy es un buen ejemplo de para qué sirven las skills: no añade ninguna capacidad nueva al modelo, sino un oficio. Claude ya sabía escribir SVG; lo que trae la skill son 185 líneas de criterio (qué hace que una figura parezca un objeto real y no un esquema), una biblioteca de dibujo con cámara isométrica, sombreado y tuberías, diez guías de consulta y, sobre todo, herramientas que comprueban el resultado. Esa última parte es la que más enseña: la skill no se fía de que el modelo dibuje bien, le obliga a demostrarlo con auditorías y capturas, del mismo modo que un buen programador no se fía de su código sin pruebas.

También tiene sus límites, y el propio proyecto los enumera: no hace gráficas ni mapas, no dibuja personas, y una idea sin un mecanismo que construir sale floja. Es lenta a propósito: una figura grande lleva horas, el motor tarda unos minutos en construirse y una auditoría 3D completa de 30 piezas, de 15 a 20 minutos, con el gasto de tokens que eso supone en un agente. Y conviene recordar que una skill no es solo texto: Anatomy ejecuta scripts de Node y arranca Chrome en tu equipo, así que, como con cualquier herramienta de terceros, hay que instalarla desde su repositorio oficial y revisar qué hace. Con la licencia MIT y el código a la vista, al menos eso es fácil.

Para quien escribe documentación, artículos o páginas de producto, Anatomy apunta a un tipo de ilustración que hasta ahora exigía semanas de un diseñador especializado. Para el resto, es una muestra de hacia dónde van los agentes de programación: menos instrucciones sueltas y más paquetes de conocimiento, con sus propias pruebas, que cualquiera puede instalar, leer y mejorar. Si quieres entender cómo se organizan los comandos y las skills de Claude Code, lo contamos en cómo encajan los comandos de Claude Code.

Las capturas de los ejemplos son nuestras, hechas en Chromium sobre las páginas que publica el repositorio; la del motor desmontado y la del motor encendido son las del propio README. Más fuentes: el SKILL.md y el registro de cambios del proyecto, su web, y el anuncio de Anthropic sobre Agent Skills.

Fuente: wheresryan22/anatomy en GitHub

Ghidra 12.2 pedirá Java 25: lo que trae la próxima versión del descompilador de la NSA

Sede de la NSA en Fort Meade con el logotipo de Ghidra y el título sobre Ghidra 12.2

La NSA ya ha publicado en el repositorio de Ghidra, su herramienta de ingeniería inversa de código abierto, las notas de la próxima versión, la 12.2. El cambio que más usuarios van a notar es que exigirá Java 25, pero trae bastante más: depuración «sin tiempo» en fase de pruebas, mejoras de velocidad y memoria, conexiones cifradas obligatorias con sus servidores y 182 cambios en total. Todavía no se puede descargar: la versión estable sigue siendo la 12.1.4, del 21 de septiembre.

Ghidra es un desensamblador y descompilador: abre un programa compilado, sin su código fuente, y reconstruye una versión en C bastante legible de lo que hace. La NSA lo liberó en 2019 con licencia Apache 2.0, y desde entonces se ha convertido en la alternativa gratuita a herramientas comerciales como IDA Pro. Su repositorio en GitHub tiene ya más de 91,000 estrellas, y ha ganado un protagonismo nuevo con los agentes de IA: es el motor que usan por debajo herramientas como REA y servidores MCP como GhidraMCP, con más de 11,000 estrellas, y una pieza habitual de la ola de descompilaciones de videojuegos con IA.

Las novedades se conocen porque el equipo de Ghidra trabaja en abierto: el «What’s New in Ghidra 12.2» y el historial de cambios, fechado en «octubre de 2026», ya están en la rama principal del repositorio, y el historial se actualizó por última vez el 14 de octubre. Es lo habitual antes de cada versión, pero hasta que se publique la etiqueta oficial puede haber retoques.

Claves de Ghidra 12.2

  • Java 25, obligatorio. Ghidra 12.1 funciona con Java 21; la 12.2 necesitará como mínimo el JDK 25. A cambio, quien escriba scripts y extensiones podrá usar las novedades del lenguaje de los últimos años, como la API para llamar a código nativo (Foreign Function & Memory), los Stream Gatherers o los comentarios de documentación en Markdown.
  • Depuración «sin tiempo», en beta. Una herramienta basada en Intel PIN graba la ejecución de un programa, y Ghidra la carga para recorrerla hacia delante y hacia atrás. Trae tres vistas nuevas: una línea temporal con cada vez que salta un punto de ruptura, un árbol con las llamadas a funciones tal como ocurrieron y un visor con el valor de cada variable. Por ahora hay que activarlas en la categoría Experimental.
  • Más rápido y con menos memoria. El acceso a la base de datos de cada programa pasa de un único bloqueo exclusivo a bloqueos separados de lectura y escritura, lo que, según el equipo, «en teoría» mejora el trabajo con varios hilos. Y Ghidra arranca Java con Compact Object Headers, una opción de Java 25 que reduce el tamaño de cada objeto en memoria.
  • Servidores más seguros. El Ghidra Server, que permite trabajar en equipo sobre el mismo proyecto, y el servidor de BSim exigen ahora autenticación TLS en todas las conexiones, y si se instalan sin certificado propio solo escuchan en el propio equipo. Quien use Ghidra en equipo tendrá que revisar su configuración.
  • Mejor análisis. Reconoce programas compilados con Go 1.26, añade el procesador Hexagon de Qualcomm y el CIP-51, corrige decenas de instrucciones de x86, ARM, RISC-V o PowerPC, y anota en una nueva propiedad en qué lenguajes estaba escrito el programa (Swift, Objective-C, Rust…). Incorpora los tipos enteros de C99, como int8_t o uint64_t, y una ventana para fusionar dos estructuras de datos que resultan ser la misma.
  • Más accesible. Mejora el soporte de lectores de pantalla en el listado de código y el visor de bytes, y ajusta el foco del teclado en varios diálogos.
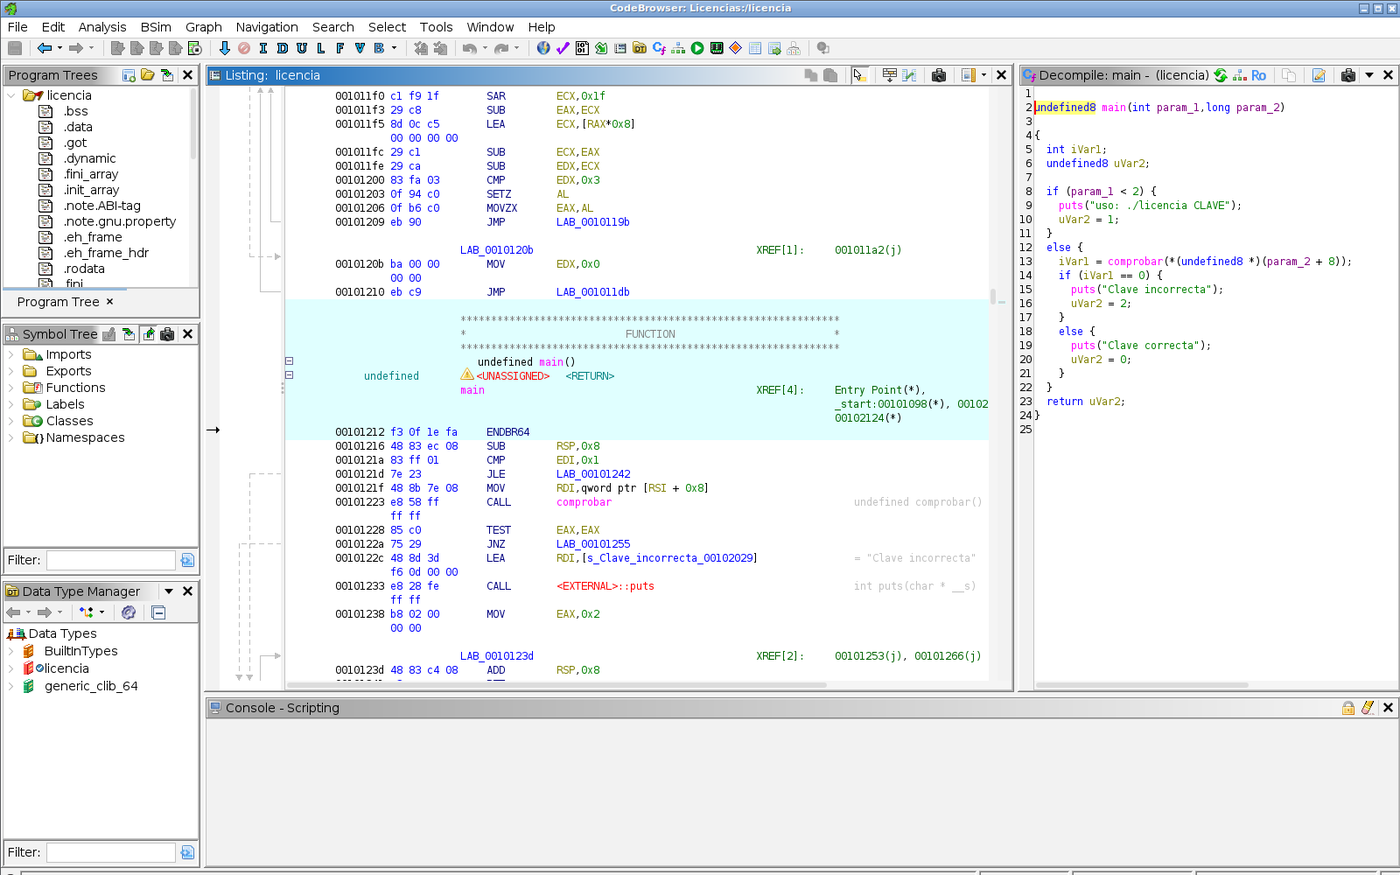
El CodeBrowser de Ghidra con el árbol del programa a la izquierda, el desensamblado en el centro y el código C reconstruido de main a la derecha
El CodeBrowser de Ghidra 12.1.4, la versión actual: en el centro, el ensamblador del programa; a la derecha, el C que reconstruye el descompilador. Captura: decodigo.com, de nuestra guía práctica de Ghidra.

Por qué importa

Para la mayoría, el cambio práctico es Java: quien actualice tendrá que instalar el JDK 25 (en Debian 13 y Ubuntu 26.04 es el paquete openjdk-25-jdk), y las extensiones de terceros pueden necesitar una versión nueva, porque además se eliminan funciones de la API que estaban obsoletas desde Ghidra 10. Hay dos detalles más que conviene saber antes de dar el salto. Los programas que se guarden con la 12.2 pueden no abrirse en versiones anteriores, así que en un equipo conviene actualizar a la vez. Y Ghidra deja de abrir directamente varios formatos de archivo comprimido e imagen de disco, entre ellos RAR, ISO, DEB y RPM, al prescindir de una biblioteca nativa; ZIP, 7z, bzip2 y xz siguen funcionando.

También importa para las herramientas de IA que se apoyan en Ghidra. REA, por ejemplo, pide hoy expresamente una instalación de la serie 12.1, como comprobamos en nuestra guía, así que quien la use con un agente hará bien en esperar a que la herramienta confirme su compatibilidad con la 12.2. El ritmo de cambios, con muchas contribuciones de fuera de la NSA en cada versión, refleja que Ghidra ha pasado de ser una curiosidad liberada por una agencia de espionaje a una infraestructura básica de la seguridad y, ahora, de los agentes que desarman programas.

Si nunca lo has usado, no hace falta esperar a la 12.2: en nuestra guía práctica de Ghidra explicamos cómo instalar la versión actual con Java 21, abrir un programa, leer lo que reconstruye el descompilador y conectarlo con REA, con capturas reales. Cuando salga la nueva versión bastará con instalar Java 25 y descomprimirla en otra carpeta.

Más fuentes: el historial de cambios de Ghidra 12.2 y la página de versiones, en GitHub. Portada: sede de la NSA en Fort Meade, foto de la NSA, dominio público (Wikimedia Commons), y logotipo de Ghidra, de Ryan Kurtz, licencia Apache 2.0, Wikimedia Commons.

Fuente: NSA, «What’s New in Ghidra 12.2»

La IA desborda la descompilación de juegos: ports al navegador, retiradas y el cierre de decomp.dev

Una Nintendo GameCube con su mando sobre fondo blanco, junto al titular sobre la descompilación de juegos con IA

La descompilación de videojuegos, el trabajo de reconstruir a mano el código fuente de un juego a partir del programa ya compilado, ha pasado en unas semanas de ser una afición de años a algo que un modelo de IA hace en días. El resultado es una avalancha: cientos de versiones no oficiales de Halo, GTA o Call of Duty que funcionan en el navegador, editoras que las retiran, Xbox creando un laboratorio para aprovecharlo y, a mediados de octubre, el cierre del índice de decomp.dev, el sitio que medía el avance de la comunidad, porque según su creador la IA ha roto el espíritu de esa comunidad.

Descompilar un juego no es lo mismo que piratearlo. Los equipos de la escena hacen una descompilación «coincidente»: escriben código en C que, compilado con el mismo compilador de la época, produce exactamente el mismo código máquina que el juego original, byte a byte. Cuando lo consiguen con todas las funciones, tienen un código fuente equivalente al original, y a partir de él se pueden hacer versiones para PC, mejoras o correcciones. Así nacieron los ports nativos de Super Mario 64 o de Zelda: Ocarina of Time (Ship of Harkinian), y así se completaron Super Smash Bros. Melee y Animal Crossing. Cada uno costó años de trabajo de decenas de voluntarios, y los proyectos serios no distribuyen nada del juego: piden que cada jugador extraiga los gráficos y los sonidos de su propia copia.

Descompilación coincidente: se escribe código en C, se compila con el compilador original y se compara byte a byte con el juego; si coincide, la función está terminada. El port a PC o al navegador es un paso posterior y aparteDescompilar un juego, «byte a byte», y después portarloJuego originalcódigo máquinaCódigo en Cuna persona o la IACompiladorel de la época¿Igual byte a byte?se compara con el originalsi no coincide, se prueba otra formanoFunción terminadael porcentaje subesíDespués, si se quiere, el portCon el código ya se puede compilar para PC o, traducido aWebAssembly, para el navegador. Los gráficos y sonidos sondel juego: los proyectos serios piden extraerlos de tu copia.
Cómo funciona una descompilación «coincidente», y por qué el port es un paso aparte. Esquema: decodigo.com.
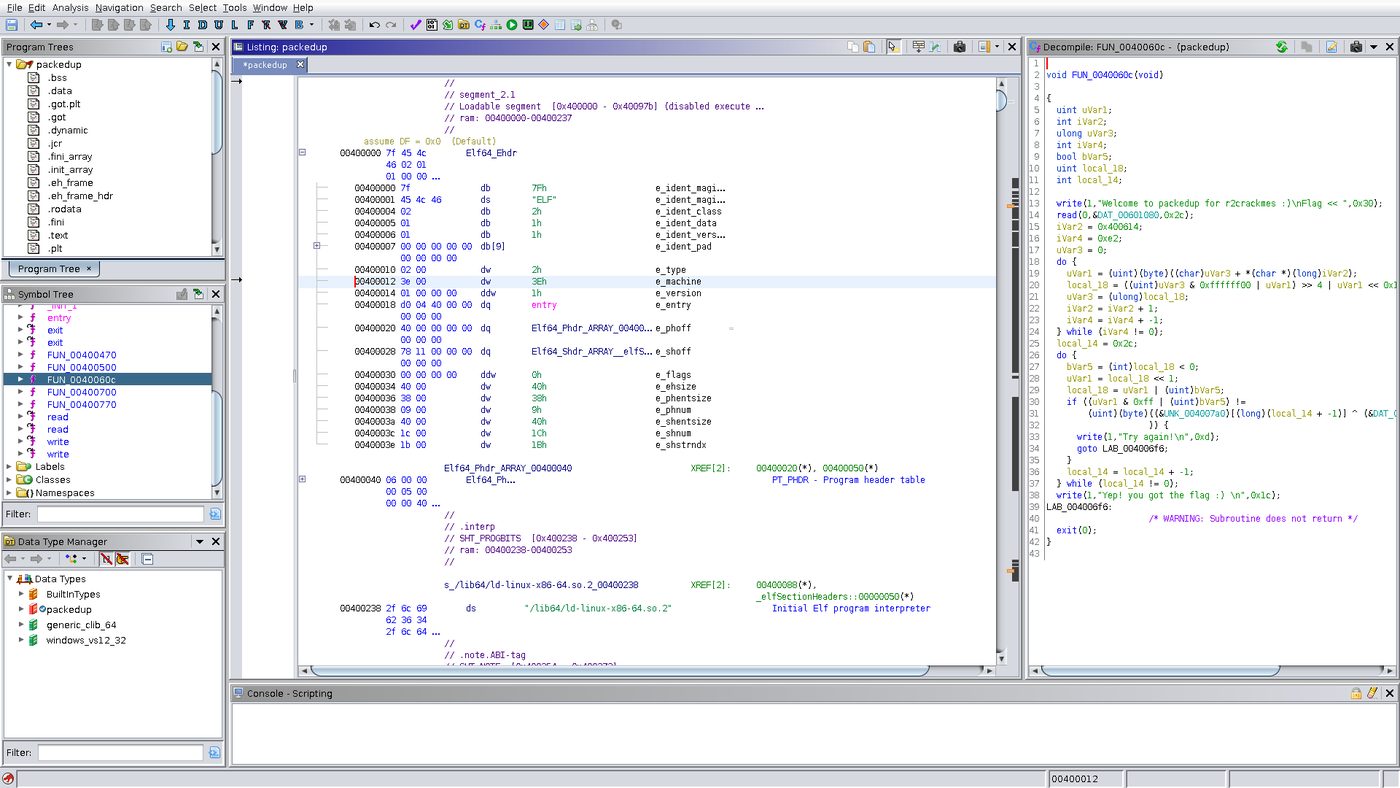
Ghidra con el código máquina de un programa a la izquierda y el código en C reconstruido por el descompilador a la derecha
Ghidra, el desensamblador de código abierto de la NSA: en el centro, el código máquina de un programa; a la derecha, el C que reconstruye su descompilador, con nombres como FUN_0040060c o uVar1. Convertir eso en código legible y que compile igual al original es el trabajo que ahora acelera la IA; cómo instalarlo y usarlo, en nuestra guía de Ghidra. Captura: Philipnelson99, CC BY-SA 4.0.

El cambio llegó con los últimos modelos. Kotaku lo atribuye a Claude Opus 5.5, que Anthropic lanzó el 22 de septiembre: en dos semanas aparecieron «cientos» de emuladores y juegos descompilados con IA. El propio creador de decomp.dev, que firma como encounter, cuenta que ya a principios de año Claude Opus 4.6 y GPT-5.4 parecían conocer las herramientas de la comunidad sin que nadie se las explicara, aunque sus resultados necesitaban mucha limpieza y salían caros. Los modelos más recientes, como GPT-6-Astra, son en sus palabras «permutadores excepcionalmente buenos»: escriben pequeños programas que prueban cientos de variantes del código hasta dar con la que compila igual al original, y aguantan trabajando horas sin perderse.

Claves de la polémica

  • Cientos de juegos en el navegador. Kotaku probó versiones para el navegador de Call of Duty: Black Ops, Halo: Combat Evolved, GTA: Vice City, Skate 3 y The Simpsons: Hit and Run, y concluyó que «parecen funcionar muy bien»; una de las de Halo tenía hasta servidores en línea. Según heise, no siempre está claro cuánta IA hay detrás: el Halo de Mitchell Hynes, de finales de septiembre, se apoya en descompilaciones de otros que llevaban años en marcha y pide al jugador la imagen de su disco de Xbox, mientras que otras versiones se abren directamente, con todo el contenido del juego incluido.
  • Retiradas, a goteo. El autor de «Fallout: New York», un Fallout para el navegador hecho con Claude Opus 5.5, cerró el proyecto tras recibir, según él, una carta de cese de Bethesda. Activision retiró el vídeo de la descompilación de Modern Warfare 2 que Maurice Heumann hizo con diecisiete agentes de IA a la vez, y bloqueó el sitio que alojaba el código. Un port de GTA V a WebAssembly dejó de funcionar a las pocas horas de difundirse, el 6 de octubre, aunque no se sabe si por una reclamación de Take-Two. Y en el registro público de GitHub constan, por ejemplo, la retirada de repositorios con el código fuente de Slay the Spire 2, pedida el 6 de octubre por Mega Crit, y la de los archivos de un port de Celeste para el navegador, pedida el 14 por sus creadores.
  • decomp.dev cierra su índice. Luke Street, encounter, mantiene decomp-toolkit, la herramienta de descompilación de juegos de GameCube y Wii, y creó decomp.dev en 2024 para seguir el porcentaje de cada proyecto. Su aviso dice que con IA y revisión humana el trabajo se acelera «de forma significativa», pero que «el aspecto comunitario de la descompilación se ha roto». Señala tres abusos: bifurcar proyectos ajenos para «terminarlos» con IA contra la voluntad de sus autores, correr a publicar ports a medio hacer a partir del trabajo de otros, y confundir descompilar con portar. La clasificación, escribe, se ha convertido en «un juego de números vacío». Desde ahora el sitio mantiene las páginas y el historial de los proyectos que ya tenía, pero desactiva el índice y no admite proyectos nuevos.
  • Choques dentro de la escena. DarioSamo, autor de Banjo: Recompiled, se desmarcó de un port de Banjo-Tooie hecho con IA sobre las herramientas de su equipo: son juegos antiguos que llevan décadas disponibles, escribió en Bluesky, así que «no hay prisa» por ser el primero.
  • Xbox, en cambio, quiere aprovecharlo. El 13 de octubre, la directora de Xbox, Asha Sharma, anunció Xbox Labs, un pequeño equipo dirigido por el director técnico, Scott Van Vliet, para convertir estas ideas en cosas que jugadores y desarrolladores puedan probar. En su comunicado reconoce que se han visto juegos descompilados y reconstruidos para funcionar en Apple Silicon o en el navegador, y que son «resultados inequívocamente buenos para los jugadores, incluso cuando (y a veces precisamente porque) desafían nuestros modelos de negocio». Al mismo tiempo promete seguir siendo un «custodio responsable» de su propiedad intelectual, y Activision, que es de Microsoft, sigue enviando retiradas.
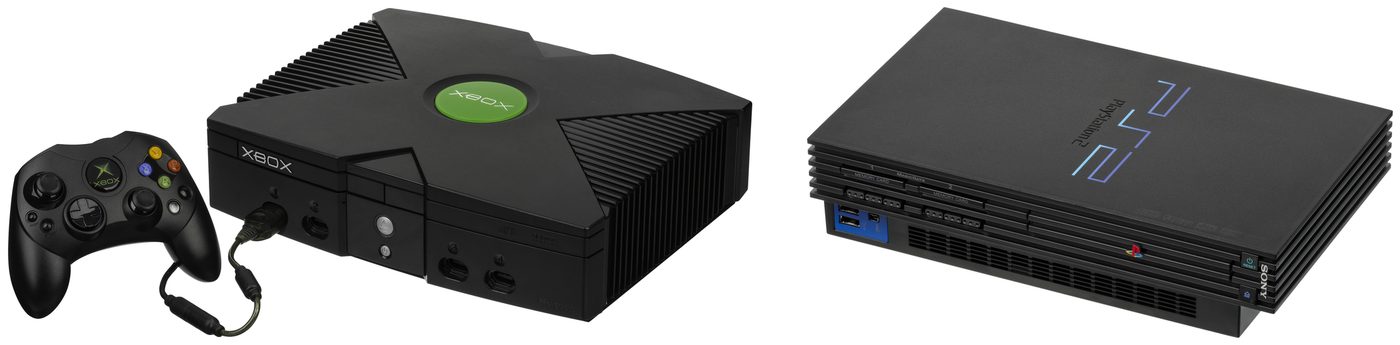
La Xbox original con su mando y una PlayStation 2
La Xbox original, la de Halo: Combat Evolved, y la PlayStation 2, la de GTA: Vice City y The Simpsons: Hit and Run. La mayoría de los ports al navegador son de juegos de esta generación y la siguiente: la PS3 tenía 512 MB de memoria, menos de lo que hoy usa una pestaña del navegador. Fotos: Evan-Amos, dominio público.

Por qué importa

Durante décadas, el código compilado ha sido la mejor protección de un juego: se podía piratear una copia, pero reconstruir su código fuente era un trabajo de años al alcance de muy pocos. Eric S. Raymond, uno de los pioneros del código abierto, escribió hace poco que había considerado los juegos uno de los últimos refugios del software cerrado, y que si la IA también los puede devolver a código fuente, ya nada está a salvo de la ingeniería inversa. Es el mismo fenómeno que contamos con REA, la herramienta que pone a los agentes a desarmar programas, aunque ninguno de estos proyectos dice haberla usado: los modelos ya lo hacen por su cuenta.

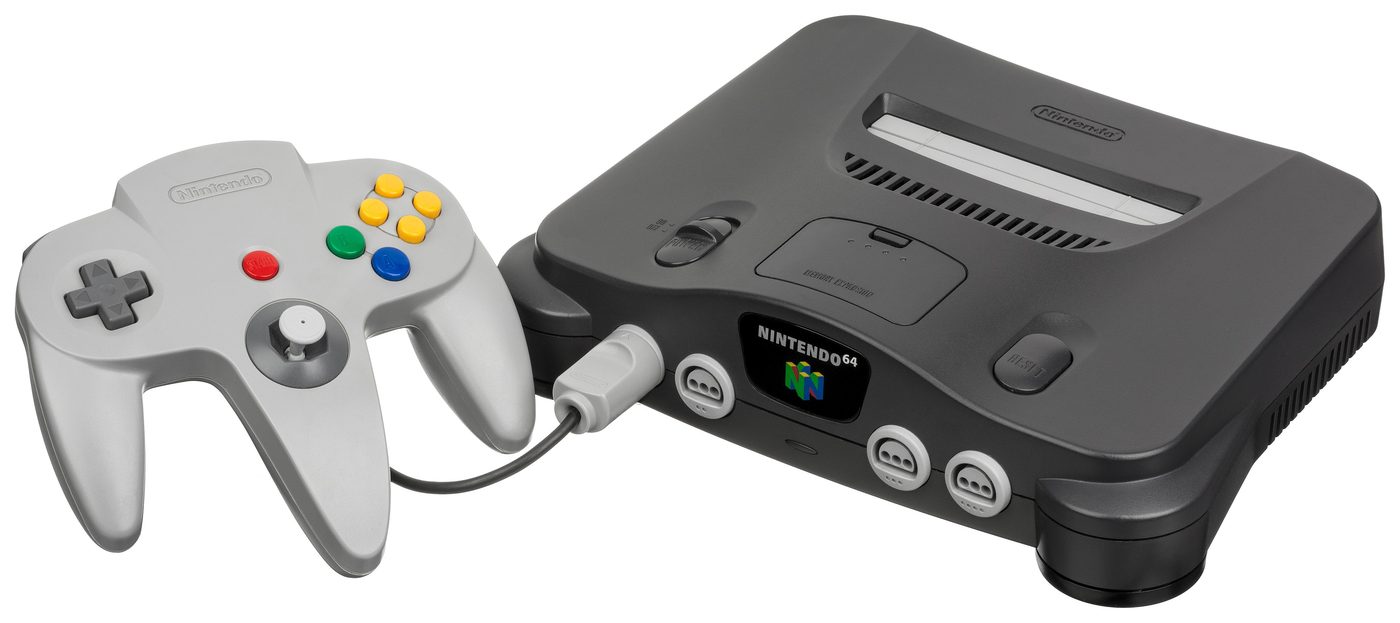
Consola Nintendo 64 con su mando
La Nintendo 64, donde empezó la descompilación moderna de juegos: Super Mario 64, Ocarina of Time y GoldenEye 007 se reconstruyeron a mano durante años. Foto: Evan-Amos, dominio público.

Las respuestas van en direcciones opuestas. Luke Dicken, que dirigió la investigación en IA de Take-Two hasta abril, le dijo a Kotaku que espera más protección de los juegos y que será «hostil para el consumidor»: DRM más invasivo, soluciones a nivel de plataforma y más juego en streaming, porque nadie puede descompilar lo que no tiene en su equipo. Emilio Coppola, director de Godot, cree que la responsabilidad debería estar en tiendas como Steam, donde ya se venden clones de juegos independientes hechos con IA, y cuenta que muchos estudios pequeños tienen ahora miedo de publicar versiones de acceso anticipado. La parte legal sigue sin resolverse: descompilar para estudiar un programa o hacerlo compatible tiene cierto amparo legal, pero distribuir el contenido de un juego no, y, que se sepa, ningún tribunal ha dicho todavía si un código reconstruido por una IA es una obra nueva o una copia con pasos intermedios.

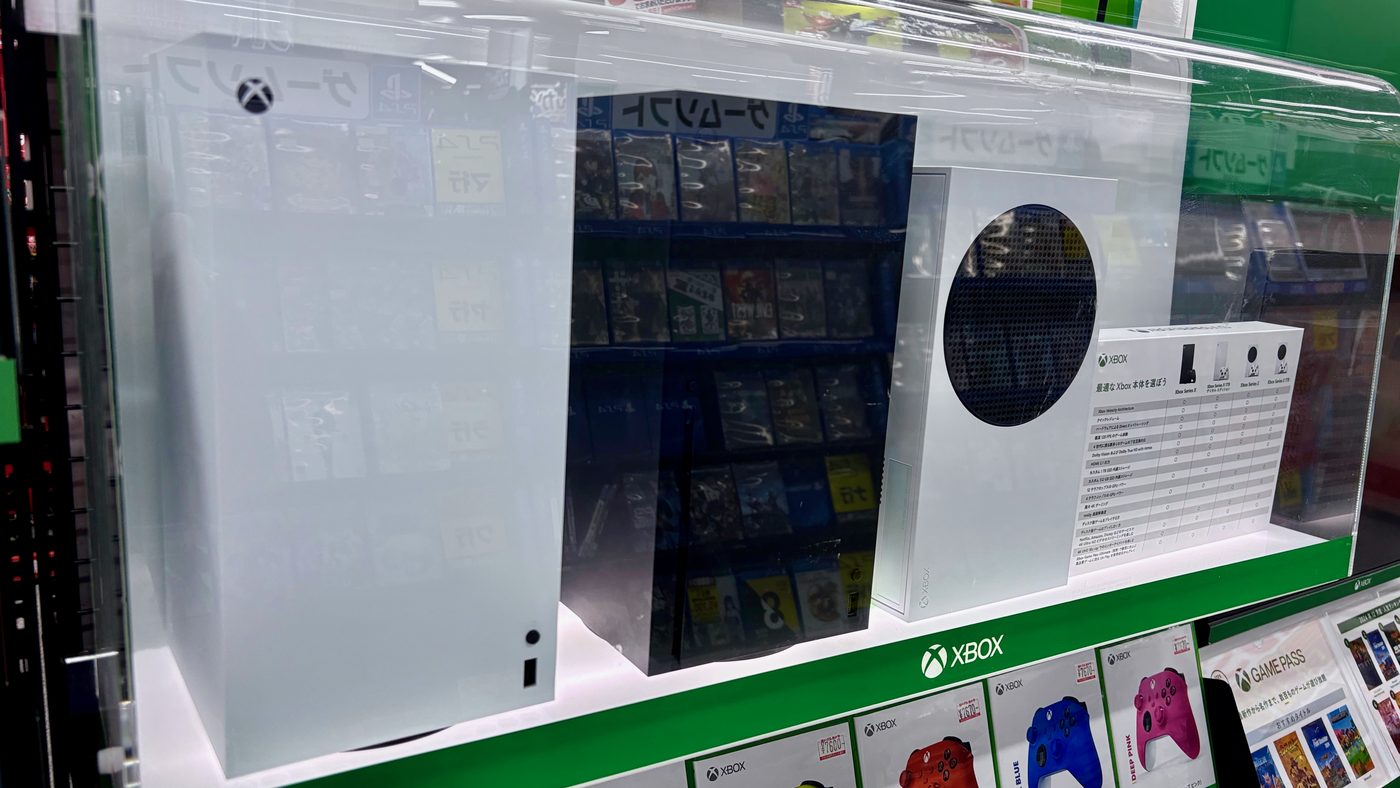
Xbox Series X y Xbox Series S en el escaparate de una tienda de Japón
Las Xbox Series X y S en una tienda de Japón. Microsoft responde a la ola con Xbox Labs mientras su filial Activision retira proyectos. Foto: Kyu3a, CC BY-SA 4.0.

Lo que se pierde es más difícil de medir. La descompilación siempre fue, sobre todo, una forma de entender cómo se hicieron los juegos que marcaron a una generación, y decomp.dev existía para celebrar cada décima de porcentaje conseguida a mano. Su creador no culpa a la IA en sí: dice que bien usada ayuda «muchísimo», pero que un aficionado solo no puede decidir cuál de cientos de proyectos merece estar en la lista. La técnica ya no tiene vuelta atrás; lo que está en juego ahora es quién la aprovecha, y quién paga por ella.

Portada: Nintendo GameCube, la consola de las herramientas de encounter y de Melee y Animal Crossing, dos juegos descompilados al 100 %; foto de Evan-Amos, dominio público, Wikimedia Commons. Más fuentes: Kotaku, los ports al navegador y las entrevistas; Xbox Wire, «Introducing Xbox Labs»; heise; TheGamer; Tom’s Hardware sobre GTA V; y los avisos de GitHub sobre Slay the Spire 2 y Celeste.
Fuente: decomp.dev, «Sunsetting decomp.dev»

Claude diseña circuitos cuánticos más eficientes que los mejores publicados, con Harvard y QuEra

Ordenador cuántico IBM Quantum System One dentro de su cubo de cristal, en una sala oscura

Anthropic ha puesto a Claude a diseñar circuitos cuánticos, los programas que ejecutará un ordenador cuántico, y el resultado ha superado a los especialistas: en los ocho problemas que le plantearon, encontró diseños que usan menos cúbits y menos operaciones que los mejores publicados, en algunos casos diez veces menos. El trabajo se hizo con los físicos de Harvard Susanne Yelin y Mikhail Lukin, este último también de la empresa de ordenadores cuánticos QuEra.

Los ordenadores cuánticos actuales todavía son demasiado pequeños y cometen demasiados errores para hacer algo útil, así que buena parte de la investigación consiste en preparar el terreno: diseñar los circuitos de los algoritmos y calcular cuántos cúbits y cuántas operaciones lógicas (puertas) necesitarán. Cada mejora en ese diseño acerca el día en que una máquina real pueda ejecutarlos. El ejemplo clásico es la simulación de FeMoco, una molécula clave para entender cómo las bacterias fijan el nitrógeno: en 2017 se estimaba que necesitaría unos 50 billones de puertas, y años de mejoras en los algoritmos lo han bajado a unos 340 millones, unas 150,000 veces menos.

El estudio lo dirigió Andi Gu, del programa de becas científicas de Anthropic, con el físico cuántico de la empresa Alek Kemeny, y está publicado en arXiv. Usaron Claude Mythos 5 en un bucle cerrado: Claude recibía la descripción de un circuito en lenguaje natural y proponía un diseño escrito en Python; un evaluador automático comprobaba que funcionara bien y le daba una nota, el número de cúbits multiplicado por el de puertas, y Claude usaba esa nota para intentarlo de nuevo, sin ninguna persona de por medio entre una ronda y la siguiente.

Claves del trabajo

  • Mejor en los ocho problemas. Los circuitos cubrían química, optimización, simulación de sistemas cuánticos, teoría de números y cálculo numérico. En todos, Claude encontró diseños con menos cúbits y menos puertas que los mejores publicados.
  • Suma de puntos en curvas elípticas. Tras 53 horas de trabajo, uno de sus diseños usa un 12 % más de cúbits que el más pequeño conocido, pero 17 veces menos puertas. Por el camino creó la primera versión reversible de un método de inversión modular (divsteps) que no necesita guardar el historial de decisiones, y demostró que su regla es correcta con el asistente de pruebas Lean.
  • Un decodificador 12 veces más ligero. Para DQI, un algoritmo cuántico de optimización prometedor, rediseñó su paso más caro, un decodificador de códigos Reed-Solomon, con unas 12 veces menos puertas que la construcción anterior de Google. Además, en lugar de reservar 665 cúbits para el peor caso, midió en 403 millones de decodificaciones simuladas cuántos hacían falta de verdad y lo dejó en 19. A cambio, el circuito falla aproximadamente una vez de cada 10,000.
  • Atajos en química. En la simulación de una molécula de hierro y azufre, Claude se dio cuenta de que ciertas simetrías permitían calcular algunos resultados una sola vez y reutilizarlos.
  • Con sus defectos. Los autores cuentan que Claude era demasiado prudente: dudaba de sus propias mejoras, revisaba los resultados una y otra vez y tendía a quedarse con los métodos conocidos. Para que explorara más, lo pusieron a probar varias ideas en paralelo y, a veces, le pidieron que ampliara la búsqueda.

Por qué importa

La suma de puntos en curvas elípticas no es un ejemplo cualquiera: es la pieza central del algoritmo de Shor aplicado a las curvas elípticas, es decir, del ataque con el que un ordenador cuántico suficientemente grande podría romper la criptografía de curvas elípticas que protege hoy HTTPS, las firmas digitales y las criptomonedas. Un circuito 17 veces más barato no rompe nada hoy, porque esas máquinas no existen, pero recorta los recursos que harán falta y refuerza la prisa por pasar a la criptografía poscuántica, algo que navegadores y servidores ya han empezado a hacer. Curiosamente, son las mismas curvas protagonistas de otra investigación de Anthropic de esta semana: el origen de las semillas de las curvas del NIST.

Hay que leer el resultado con cuidado. Las comparaciones son estimaciones sobre el papel, no ejecuciones en ordenadores reales, y el propio Anthropic recuerda que diseñar circuitos es solo una parte: la corrección de errores y el hardware siguen siendo los grandes problemas por resolver. Aun así, es una muestra de un cambio en cómo se investiga: un modelo de IA que trabaja durante días contra un evaluador automático y encuentra ideas nuevas en un campo muy especializado, en el que los avances se miden en años.

Portada: el IBM Quantum System One de Fraunhofer en Ehningen (Alemania), foto de IBM Research, Wikimedia Commons, CC BY 2.0. El ordenador de la foto no se usó en este trabajo.

Fuente: Anthropic, «Designing more efficient quantum circuits with Claude»

Claude descubre de dónde salieron las semillas de las curvas elípticas del NIST, un misterio de casi 30 años

Sede de la NSA en Fort Meade de noche, vista aérea con los edificios y aparcamientos iluminados

Un modelo de IA interno de Anthropic ha resuelto uno de los misterios más famosos de la criptografía: de dónde salieron las semillas con las que se crearon las curvas elípticas del NIST, como P-256, que protegen a diario conexiones HTTPS y firmas digitales. No eran frases secretas ni el resultado de un cálculo oculto: salieron de un generador de números aleatorios de C iniciado con la hora del ordenador, entre mayo de 1997 y abril de 1998.

Las curvas elípticas son la base de buena parte de la criptografía moderna: permiten firmas y claves mucho más cortas que RSA con la misma seguridad. En el año 2000, el NIST, el organismo de normas de Estados Unidos, publicó en su estándar FIPS 186-2 una serie de curvas recomendadas. Para demostrar que no estaban amañadas, cada una se obtenía pasando por una función hash un número de partida, la semilla, y el resultado fijaba uno de los coeficientes de la curva. La idea era que nadie puede elegir a voluntad lo que sale de un hash. El problema es que las semillas las proporcionó la NSA, la agencia de espionaje de Estados Unidos, sin explicar de dónde venían. Si alguien hubiera conocido una debilidad en ciertas curvas, podría haber probado millones de semillas hasta dar con una curva débil que pareciera aleatoria.

La sospecha creció en 2013, cuando los documentos de Edward Snowden apuntaron a que la NSA había metido una puerta trasera en otro estándar del NIST, el generador Dual_EC_DRBG. Durante años circuló la historia de que las semillas eran el hash de una frase graciosa elegida por Jerry Solinas, el matemático de la NSA que las preparó, pero Solinas murió en 2023 sin que nadie pudiera comprobarlo. Ese mismo año, el criptógrafo Filippo Valsorda organizó una recompensa de $12,288 USD, que se triplicaba si se donaba, para quien encontrara el origen de las semillas.

Claves del descubrimiento

  • Una corazonada. Un empleado de Anthropic preguntó al modelo si podía averiguar cómo se generaron las semillas. El modelo supuso que venían de algún generador de números pseudoaleatorios débil de los años 90, cuya salida se pudiera reconocer, y escribió un programa para buscar esa huella dentro de cada semilla.
  • La pista de los ceros. En varias semillas, ciertos bits que deberían ser aleatorios estaban siempre a cero. Es la firma de lrand48, una función clásica de C que guarda un estado interno de 48 bits y solo devuelve los 31 más altos.
  • Reconstruir el generador. Para las curvas binarias, el modelo probó por fuerza bruta los 17 bits ocultos del estado y comprobó que los siguientes números encajaban. Para las curvas primas, como P-256, que guardan menos bits de cada número, recuperó el estado con LLL, un algoritmo de reducción de retículos muy usado en criptoanálisis.
  • Una hora exacta. Dando marcha atrás al generador hasta su arranque, salía la marca de tiempo con la que se inició. La semilla de P-256, por ejemplo, es el candidato número 1,842 de una serie que empezó el 16 de agosto de 1997 a la 01:52:34 (hora universal). En las curvas binarias, el reloj parece haberse dividido entre dos: si no, las fechas caerían en 1984.
  • También los puntos base. El punto de partida de P-192 y de cinco curvas del estándar bancario ANSI X9.62 salió de otro generador, el de FreeLIP, una biblioteca de números grandes de Arjen Lenstra, con semillas tan simples como 20000.
  • Lo que falta. Queda sin explicar la semilla de la curva B-163, los puntos base de P-224, P-256, P-384, P-521 y de las curvas binarias, y por qué se descartaron algunos candidatos que también daban curvas válidas.
  • La recompensa. Anthropic se queda con los $36,864 USD de la recompensa de Valsorda y los dona al Internet Security Research Group, la organización que mantiene Let’s Encrypt.

Por qué importa

Para empezar, lo que no cambia: Anthropic insiste en que esto no es una rotura ni un ataque contra ECDSA ni contra las curvas, y que no hay que hacer nada. P-256 sigue siendo tan segura como ayer, y la mayoría de los investigadores ya confiaban en ella. Lo que sí cambia es la duda de fondo. Si las semillas salieron de algo tan corriente como la hora de un ordenador y un generador de la biblioteca de C, la idea de una NSA probando semillas en secreto hasta dar con una curva débil resulta mucho menos creíble. No queda descartada del todo, porque no se sabe cuántas veces se ejecutó el programa ni por qué se saltaron algunos candidatos, pero el misterio ha pasado a ser un detalle técnico.

También es una muestra de lo que ya pueden hacer los modelos de IA en investigación: el problema llevaba casi 30 años abierto y tres sin que nadie cobrara la recompensa, y el modelo lo resolvió combinando una intuición sobre el software de la época con técnicas de criptoanálisis de verdad. Si quieres saber dónde entran estas curvas en tu día a día, lo contamos en nuestra guía sobre cómo sabe tu navegador en qué certificados confiar y en HTTPS por dentro.

La recompensa, según el anuncio de Filippo Valsorda (octubre de 2023). Portada: la sede de la NSA en Fort Meade (Maryland), foto de Trevor Paglen para Creative Time Reports (2013), Wikimedia Commons, CC0.

Fuente: Anthropic, «Claude reveals ECDSA curve origins»

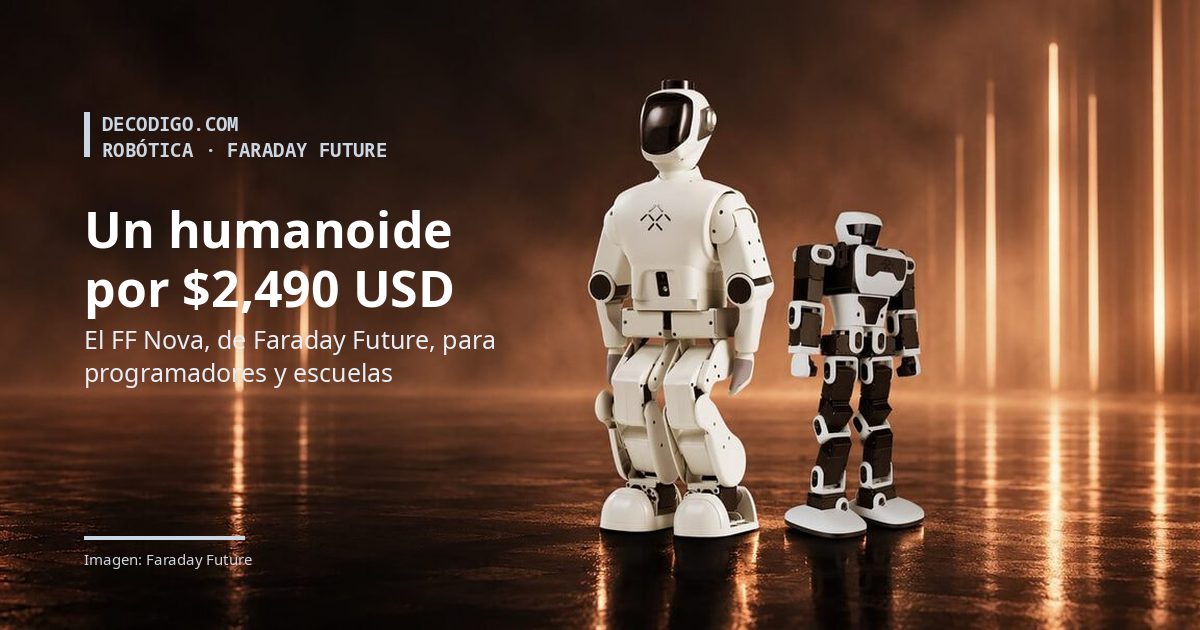
Faraday Future lanza el FF Nova, un robot humanoide de $2,490 USD para programadores y escuelas

El robot humanoide FF Nova, blanco, junto al pequeño Nova Mini sobre un suelo brillante

Faraday Future, la empresa californiana de coches eléctricos, presentó el FF Nova, un robot humanoide de medio metro de alto que cuesta $2,490 USD y está pensado para programadores, universidades y escuelas. Con él llega el FF Nova Mini, de $299 USD, para que niños desde los ocho años aprendan a programar. Las primeras 100 unidades del Nova se reparten solo por invitación.

Faraday Future se dio a conocer hace una década como rival de Tesla, con su coche eléctrico de lujo FF 91, pero arrastra años de problemas de dinero y ha vendido muy pocos coches. Su fundador, YT Jia, lleva tiempo buscando otros negocios, y ahora apuesta por los robots. El lanzamiento lo firma junto a FF EAI Robotics Ecosystem (FFR), una empresa que cotiza en bolsa y que hasta el 30 de septiembre se llamaba AIxCrypto Holdings. FFR va a comprar todo el negocio de robótica de Faraday Future pagando con acciones, en una operación que lo valora en unos $200 millones de USD. Al cerrarla, Faraday Future se quedará con cerca del 66 % de FFR.

«FF Nova es un paso importante en el esfuerzo de FFR para facilitar la adopción de robots humanoides de IA», dijo Jia. Las empresas lo presentan como el primer humanoide de este tipo que se vende en Estados Unidos por menos de $2,500 USD, aunque esa afirmación es suya y nadie la ha comprobado.

Claves del FF Nova y el Nova Mini

  • Pequeño y completo. El Nova mide unos 50 centímetros y pesa 2.8 kg. Tiene 20 grados de libertad (articulaciones que se mueven por separado), camina, gira, saluda y se levanta solo si se cae. Lleva LiDAR, una cámara gran angular, un sensor de profundidad y varios micrófonos en anillo.
  • Con ruedas si hace falta. Además de andar sobre dos piernas, se puede montar en una base con ruedas desmontable que lo lleva solo de un sitio a otro.
  • Pensado para programarlo. Tiene un kit de desarrollo (SDK) abierto, funciona con ROS 2, el sistema más usado en investigación robótica, y recibe actualizaciones por internet. Se conecta a un modelo de IA de voz que reconoce a quién está hablando. Por $390 USD más se vende un paquete de habilidades para desarrolladores.
  • Aprende en simulación. Faraday Future ofrece un programa para entrenar al robot con aprendizaje por refuerzo sobre Isaac, la plataforma de simulación de NVIDIA: se practica una habilidad miles de veces en un mundo virtual y después se pasa al robot real. También habrá una tienda donde los desarrolladores podrán compartir o vender las habilidades que creen.
  • Por fases. En la primera, 100 unidades para programadores e instituciones educativas invitados, de las que 20 se pueden entregar ya. Las solicitudes se hacen en developer.ff.com durante siete días. Después se abrirá a todos los desarrolladores y escuelas, y por último al público, sin fechas anunciadas.
  • Nova Mini, para niños. Pesa menos de 1 kg, tiene el cuerpo de aluminio, camina, se levanta solo y da volteretas. Se programa con bloques visuales o enseñándole los movimientos con la mano. Cuesta $299 USD, y aparte se vende un curso de $499 USD con 16 clases en vivo en grupos pequeños durante dos meses, que incluye un vale de descuento para el robot.

Por qué importa

El precio de los humanoides se está desplomando. Hace unos días contamos que el Astribot T1 llegaba a Estados Unidos por $18,000 USD, y el Nova cuesta casi lo mismo que un buen portátil. No es un robot para trabajar en una fábrica ni en casa: es pequeño y su fuerza no da para tareas reales. Pero para una universidad, un club de robótica o un programador curioso, un humanoide que se programa con ROS 2 y se entrena en simulación es una forma barata de aprender lo que hoy hacen las grandes empresas del sector. En ese terreno compite con robots educativos veteranos como el NAO, que cuesta varias veces más.

Hay motivos para la cautela. La propia nota de prensa advierte de que Faraday Future tiene dudas serias sobre su capacidad para seguir funcionando y de que depende de fabricantes chinos, justo cuando Estados Unidos pone trabas a los robots fabricados en China: en julio, la FCC prohibió los nuevos modelos de humanoides hechos en el extranjero, salvo los de menos de 2 kg. Faraday Future no ha aclarado si eso afecta al Nova. Con 100 unidades por invitación y sin fechas para el resto, habrá que ver si el robot llega de verdad a las aulas.

Altura y peso del Nova según The Next Web, a partir de la página del producto. Portada: el FF Nova y el Nova Mini, imagen de Faraday Future publicada en su página de lanzamiento (recortada, con texto).

Fuente: Faraday Future y FFR, nota de prensa en Business Wire

Qué es Scion, el control de versiones de Anthropic, y en qué se diferencia de Git

Injerto en un manzano: Scion, el control de versiones de Anthropic

Scion es el sistema de control de versiones que creó Anthropic, la empresa de Claude, para sustituir a Git en su repositorio de código principal. Lo presentó el 13 de octubre en su blog de ingeniería, y desde entonces mucha gente lo busca como «Claude Scion» o «Scion de Anthropic». Aquí explicamos qué es, cómo funciona, en qué se diferencia de Git y por qué no lo vas a poder instalar.

Un sistema de control de versiones guarda la historia de un proyecto: cada cambio, quién lo hizo y cuándo, y permite que muchas personas trabajen a la vez sin pisarse. El más usado del mundo es Git, que Linus Torvalds creó en 2005 para el núcleo de Linux. Git es distribuido: cada programador tiene una copia completa del repositorio en su equipo, trabaja sin conexión y sincroniza cuando quiere. Ese diseño es perfecto para un proyecto de código abierto con colaboradores repartidos por el mundo, pero sufre cuando el repositorio es gigantesco y quienes lo usan no son personas.

Ese es el caso de Anthropic. Guarda casi todo su código en un único repositorio, un monorepo, cuyo historial ronda los 100 GB. Desde que Claude escribe buena parte del código, los cambios fusionados al día pasaron de unos 2,500 en mayo a más de 30,000 en septiembre, y sus sistemas automáticos descargan el código unos 25 millones de veces al día. Para aguantarlo llegaron a mantener cientos de copias espejo de Git, cada vez más difíciles de operar. En lugar de seguir parcheando, siete personas construyeron Scion en cinco meses, con Claude escribiendo la mayor parte del código. Lo contamos en detalle en la noticia del anuncio.

Claves: en qué se diferencia de Git

La idea central es dar la vuelta al modelo de Git: en lugar de que cada cliente tenga todo y haga el trabajo, el servidor lo guarda todo y hace casi todo el trabajo, y los clientes, siempre conectados, piden solo lo que necesitan.

GitScion
ModeloDistribuido: cada copia es un repositorio completo y se puede trabajar sin conexiónCentralizado: los clientes están siempre conectados al servidor
Commits, fusiones y rebasesSe hacen en tu equipo y después se envían con pushSe hacen en el servidor: no hay nada que enviar
Descarga del códigoUn clon baja el historial en paquetes (packfiles), entero o recortadoSe piden solo las carpetas y los archivos que hacen falta, cuando hacen falta; la descarga se puede reanudar
AlmacenamientoObjetos y paquetes que hay que compactar de vez en cuandoCada cambio es una entrada de un registro, guardado en la base de datos Spanner; sin mantenimiento
Historial y autoría línea a líneaLos calcula tu equipo con git log y git blameLos calcula el servidor y se consultan por una API, sin tener el repositorio
RamasMuchas, una por tareaCasi todo va directo al tronco (main), más las ramas de cada versión
Revisión de códigoFuera de Git: GitHub, GitLab…Antique, creado a la vez, que distingue un cambio en un comentario de uno en lógica delicada
Quién puede usarloCualquiera: software libreSolo Anthropic
  • Tres niveles de caché. En cada máquina corre un scion-daemon que guarda los objetos para todos los procesos de esa máquina; por encima hay una caché por región, en memoria, y arriba el servidor principal. Los tres hablan el mismo idioma, así que el cliente (scn) no sabe ni le importa a cuál pregunta. Cada nivel resuelve más del 99 % de las peticiones sin subir al siguiente.
  • Archivos que aparecen al usarlos. Una copia de trabajo puede ser «virtual»: los archivos se descargan en el momento en que alguien los abre. Para un agente que solo toca tres carpetas de un repositorio enorme, eso es la diferencia entre segundos y minutos.
  • Sin colas de fusión. En lugar de probar cada cambio antes de fusionarlo, se prueba después de la fusión y antes de desplegar, y cuando dos cambios chocan, normalmente es Claude quien arregla el conflicto.
  • Los resultados. Según Anthropic, la infraestructura usa unas 200 veces menos procesador y memoria que los espejos de Git que sustituyó, las descargas tardan segundos en lugar de minutos y sus sistemas de integración continua recuperaron un 25 % de capacidad de cálculo.
  • No es una idea del todo nueva. Anthropic cita como antecedentes a Piper, el sistema interno con el que Google guarda su monorepo, y a Sapling, el de Meta. Las empresas con repositorios gigantes llevan años alejándose del modelo distribuido de Git.

¿Se puede descargar o usar Scion?

No. Anthropic no lo ha publicado y dice que ofrecerlo de forma útil sería difícil, porque depende de piezas hechas a medida para su infraestructura. Además, avisa de que Scion «no es, de ninguna manera, un sustituto adecuado de Git para uso general»: está pensado para repositorios enormes con muchísimos programadores o agentes trabajando a la vez. Lo que sí quiere es llevar sus ideas a los servidores y a los protocolos de Git, y dice que le gustaría hacerlo con GitHub, GitLab y la comunidad del software libre.

Actualización del 21 de octubre: lo que sí ha aparecido son clones hechos por la comunidad, escritos en Rust a partir del artículo de Anthropic y sin relación con la empresa. El más seguido es CarterT27/scion (licencia Apache-2.0, creado el 14 de octubre), que se presenta como una implementación independiente «desde cero»; su propio README deja fuera el trabajo sin conexión, la compatibilidad con el protocolo de Git y la sincronización en los dos sentidos con Git. También están OpenScion (GPL-3.0) y bnsd55/openscion (Apache-2.0), que se declara en fase alfa: funciona en una sola máquina y no está listo para producción. Ninguno es Scion: son experimentos con sus ideas, y Anthropic sigue sin publicar el suyo.

Para casi todo el mundo, la herramienta sigue siendo Git. Si estás empezando con él, tienes nuestra guía de Git.

Un último aviso para quien llegue buscando el nombre: SCION, en mayúsculas, es también una arquitectura de red para internet desarrollada en la universidad ETH de Zúrich, que no tiene nada que ver. Y en inglés, scion es el vástago que se injerta en un árbol, como el de la foto de portada.

Por qué importa

Scion es una señal de un cambio de escala. Las herramientas de programación de las últimas dos décadas se diseñaron para personas: unos cuantos cambios al día por programador y alguien que revisa cada línea. Cuando el código lo escriben agentes de IA, el cuello de botella ya no está en escribir, sino en la infraestructura que guarda, prueba y revisa: Anthropic multiplicó por doce sus fusiones diarias en cuatro meses. Que una empresa de este tamaño haya tenido que reescribir algo tan básico como el control de versiones, y que lo haya hecho con su propia IA, adelanta problemas que otras empresas que adopten agentes se van a encontrar.

Para un programador normal no cambia nada hoy: Git seguirá funcionando igual en sus proyectos. Pero si las ideas de Scion acaban en GitHub o GitLab, como pretende Anthropic, es posible que algún día los clones descarguen solo lo que se usa y que parte del trabajo de Git se haga en el servidor sin que nos demos cuenta.

Imagen de portada: injerto en un manzano, foto de Guillaume22, Wikimedia Commons, CC BY-SA 3.0.

Fuente: Anthropic Engineering, «Redesigning source control at Anthropic»