Hoy cambia la llave maestra del DNS: qué pasa el 11 de octubre y cómo comprobar que tu resolutor está listo

Portada: Hoy cambia la llave maestra de internet. La raíz del DNS estrena clave de firma, con la cadena de confianza raíz, .com y el dominio, y la clave antigua 20326 tachada junto a la nueva 38696

Hoy, 11 de octubre de 2026, la raíz del DNS empieza a firmarse con una clave nueva. Es un cambio previsto desde que la clave nueva se publicó, en enero de 2025, y para casi todos invisible, pero tiene una cara incómoda: un resolutor que valide DNSSEC y no conozca la clave nueva dejará de resolver todos los nombres, no solo algunos. Aquí explicamos qué cambia, cómo se comprueba que tu resolutor está listo y qué ocurre en uno que no lo está, porque lo reprodujimos con dos copias de Unbound.

Cuando tu navegador pide decodigo.com, el resolutor de tu proveedor se lo pregunta al DNS. Con DNSSEC, además de la respuesta recibe firmas que demuestran que no la ha alterado nadie por el camino, y esas firmas forman una cadena: la raíz firma a .com, y .com firma a cada dominio que use DNSSEC. Todo cuelga de un punto de partida que el resolutor ya conoce de antemano, llamado ancla de confianza: la clave pública de la raíz.

Esa clave se llama KSK (Key Signing Key). La raíz está firmada desde julio de 2010, según el archivo de anclas de IANA, y en todo ese tiempo ha tenido dos KSK: la de 2010 y la de 2017. La que se ha usado hasta hoy es KSK-2017 (etiqueta 20326), y esta es solo la segunda vez que se cambia. A partir de hoy la sustituye KSK-2024 (etiqueta 38696), que lleva en la raíz desde el 11 de enero de 2025 esperando su turno.

11 ene 2025Se publica KSK-2024en la raíz, junto a laantigua10 feb 2025Los resolutores quese actualizan solosla aceptantras 30 días de espera(RFC 5011)11 oct 2026KSK-2024 pasa afirmarla clave antigua deja defirmar11 ene 2027Se revoca KSK-2017se publica con el bitREVOKE22 mar 2027Se retira KSK-2017desaparece de la raízHOYFechas de IANA (iana.org/dnssec/files)

El calendario completo de la rotación. Fuente: IANA.

Claves del cambio

Qué cambia exactamente

La raíz publica dos tipos de clave. La KSK firma solo un registro, el conjunto de claves (DNSKEY); la ZSK (Zone Signing Key), que se renueva con mucha más frecuencia, firma todo lo demás. Lo que cambia hoy es quién firma el conjunto de claves: hasta ayer, la KSK-2017; desde hoy, la KSK-2024. Las dos están ahora mismo en la raíz:

consulta del 11 de octubre de 2026, 14:20 UTC$ dig DNSKEY . @1.1.1.1 +multi +noall +answer | grep -E "KSK|ZSK"
				) ; ZSK; alg = RSASHA256 ; key id = 8763
				) ; ZSK; alg = RSASHA256 ; key id = 57780
				) ; KSK; alg = RSASHA256 ; key id = 20326
				) ; KSK; alg = RSASHA256 ; key id = 38696

La prueba de que el cambio ya está en marcha es quién firma ese conjunto. Preguntando directamente a un servidor raíz, la firma lleva ya la etiqueta de la clave nueva y es válida desde las 00:00 UTC de hoy. Preguntando a un resolutor público, todavía sale la antigua: es la copia que tiene en caché.

la misma consulta a un servidor raíz y a un resolutor, 14:20 UTC$ dig +dnssec DNSKEY . @a.root-servers.net +norecurse +noall +answer | awk '$4=="RRSIG"{print "firma de la clave", $11, "válida", $10, "→", $9}'
firma de la clave 38696 válida 20261011000000 → 20261101000000

$ dig +dnssec DNSKEY . @1.1.1.1 +noall +answer | awk '$4=="RRSIG"{print "firma de la clave", $11, "válida", $10, "→", $9}'
firma de la clave 20326 válida 20261001000000 → 20261022000000

Las fechas son formato AAAAMMDDhhmmss. La segunda respuesta es una firma anterior, válida del 1 al 22 de octubre, que el resolutor guarda hasta que caduque su caché. Los resolutores que se actualizan bien no tienen problema: ya aceptaban las dos claves.

Quién se ve afectado

  • Si administras un sitio web, normalmente nada: según Cloudflare, la mayoría de los operadores de sitios no necesitan cambiar nada, y la clave de tu dominio no es esta.
  • Si usas un resolutor público grande, lo normal es que ya esté preparado: Cloudflare lleva KSK-2024 integrada en su resolutor desde julio de 2024, y el archivo de anclas de IANA la da por válida desde el 18 de julio de 2024. Las pruebas de más abajo lo confirman para Cloudflare y Quad9; el de tu proveedor conviene comprobarlo.
  • Si administras un resolutor que valida DNSSEC (Unbound, BIND, Knot Resolver, PowerDNS Recursor, o el que lleva un cortafuegos, un balanceador o una pasarela), sí. Si no confía en la clave nueva, todos los nombres darán error, incluidos los de dominios que ni usan DNSSEC.

La clave nueva se distribuye por dos caminos. Los resolutores con el estándar RFC 5011 la aprenden solos: la ven en la raíz y, tras esperar 30 días sin que desaparezca, la aceptan; eso ocurrió en febrero de 2025. Y el software actualizado la trae ya de serie. Las dos vías fallan en los mismos sitios: una máquina que estuvo apagada o aislada durante esos 30 días, un archivo de claves de solo lectura, una copia de seguridad con la clave vieja, o un equipo olvidado cuyo software nadie actualiza.

Resolutor con la clave nueva: la cadena se validaResolutorconfía en la 38696Raíz (.)firmada con la 38696.com y tu dominiofirmados desde la raíz✓ coincide✓ válidoResolutor que solo confía en la clave antigua: se rompe en el primer eslabónResolutorconfía en la 20326Raíz (.)firmada con la 38696.com y tu dominiono se llega a comprobar✗ no coincideSERVFAIL para todos

Qué ocurre cuando el resolutor no conoce la clave nueva: la validación falla en el primer eslabón y no se llega a comprobar nada más.

Cómo se ve el fallo: lo reprodujimos

Para ver el fallo de verdad, no en un diagrama, levantamos dos copias de Unbound 1.26.1 en contenedores limpios, que hablan directamente con los servidores raíz. Una solo conoce la clave antigua, como un resolutor que no se actualizó; la otra solo la nueva. El único cambio entre las dos es la línea del ancla de confianza, con los datos del archivo root-anchors.xml de IANA:

server:
    interface: 127.0.0.1
    port: 5301
    root-hints: "/home/ana/root.hints"
    # solo la clave antigua, KSK-2017 (etiqueta 20326)
    trust-anchor: ". DS 20326 8 2 E06D44B80B8F1D39A95C0B0D7C65D08458E880409BBC683457104237C7F8EC8D"
    # en la otra copia:
    # trust-anchor: ". DS 38696 8 2 683D2D0ACB8C9B712A1948B27F741219298D0A450D612C483AF444A4C0FB2B16"
dig @127.0.0.1 -p 5301 y -p 5302 para tres dominios, 11 de octubre de 2026== resolutor vieja: solo KSK-2017 (20326)
  example.com.     status: SERVFAIL
  wikipedia.org.   status: SERVFAIL
  decodigo.com.    status: SERVFAIL

== resolutor nueva: solo KSK-2024 (38696)
  example.com.     status: NOERROR  ad   104.20.23.154
  wikipedia.org.   status: NOERROR       208.80.153.224
  decodigo.com.    status: NOERROR       3.151.169.32

La copia que solo conoce la clave antigua da SERVFAIL para los tres dominios, y entre ellos wikipedia.org y decodigo.com, que ni siquiera están firmados con DNSSEC. No hay un dominio roto: lo que se rompe es la cadena desde la raíz. Sin ella, el resolutor no puede comprobar ni siquiera que .com no haya firmado esos dominios, así que no se fía de la respuesta y devuelve un error. Su registro lo dice claramente:

registro de Unbound en la copia con la clave antiguainfo: failed to prime trust anchor -- DNSKEY rrset is not secure . DNSKEY IN

La copia con la clave nueva resuelve todo con normalidad. La marca ad (authenticated data) solo aparece en example.com, el único de los tres que usa DNSSEC: significa que el resolutor ha verificado la cadena completa.

Esta prueba es más brusca que lo que verá una red real. Aquí la copia consulta a los servidores raíz, que ya sirven la firma nueva, así que falla al instante. Un resolutor normal conserva en caché el conjunto de claves firmado con la clave antigua, así que el fallo aparece cuando caduca esa caché, como mucho dos días después, que es el tiempo de vida de ese registro (172,800 segundos). Por eso se habla de «las próximas 48 horas» como la ventana en la que se descubren los problemas.

Cómo comprobar tu resolutor

1. La prueba del centinela (RFC 8509). Es la forma estándar de preguntarle a un resolutor, sin acceso a su configuración, si confía en una clave concreta. Se hacen dos consultas a dominios especiales; Cloudflare mantiene unos en dnstest.dev:

dig @IP_DE_TU_RESOLUTOR root-key-sentinel-is-ta-38696.dnstest.dev A +noall +comments | grep status
dig @IP_DE_TU_RESOLUTOR root-key-sentinel-not-ta-38696.dnstest.dev A +noall +comments | grep status
ConsultaConfía en KSK-2024No confía en KSK-2024
is-ta-38696respuesta válida (NOERROR)SERVFAIL
not-ta-38696SERVFAILrespuesta válida (NOERROR)

Lo curioso es que un SERVFAIL en la segunda consulta es la señal buena. Si las dos consultas resuelven bien, el resultado es indeterminado: el resolutor probablemente no implementa la prueba, y hay que mirar su configuración. Esto es lo que respondieron tres resolutores públicos:

Resolutoris-ta-38696not-ta-38696Conclusión
1.1.1.1 (Cloudflare)NOERRORSERVFAILConfía en la clave nueva
9.9.9.9 (Quad9)NOERRORSERVFAILConfía en la clave nueva
8.8.8.8 (Google)NOERRORNOERRORIndeterminado: no implementa la prueba

Que Google salga como «indeterminado» no significa que tenga un problema, solo que esta prueba no sirve para él. Si tu resolutor es público y muy usado, lo más probable es que el operador ya lo haya preparado.

2. Las anclas de confianza de tu software. Si administras el resolutor, comprueba que la etiqueta 38696 está en sus archivos de claves y que el proceso en marcha la ha cargado. Según Akamai, los archivos habituales son bind.keys (BIND), root.key (Unbound y algunas configuraciones de PowerDNS Recursor) y root.keys (Knot Resolver). Y para el proceso en marcha, rndc managed-keys status en BIND. Un archivo correcto no garantiza que el demonio lo haya leído.

En Debian, el paquete dns-root-data trae las anclas en /usr/share/dns/root.ds. Con la versión 2025080400 que instala Debian 13, el archivo ya incluye las dos:

dns-root-data 2025080400~deb13u1$ cat /usr/share/dns/root.ds
. IN DS 20326 8 2 E06D44B80B8F1D39A95C0B0D7C65D08458E880409BBC683457104237C7F8EC8D
. IN DS 38696 8 2 683D2D0ACB8C9B712A1948B27F741219298D0A450D612C483AF444A4C0FB2B16

Si falta la clave nueva, lo habitual es actualizar el software. Para Unbound existe unbound-anchor, que descarga el archivo de anclas de IANA y verifica su firma con el certificado de ICANN. Lo probamos con un usuario normal y un archivo que no existía:

Unbound 1.26.1, paquete unbound-anchor de Debian$ unbound-anchor -a root.key -v
/home/ana/root.key does not exist
success: the anchor is ok

$ grep -v '^;' root.key | cut -c1-80
.	86400	IN	DNSKEY	257 3 8 AwEAAaz/tAm8yTn4Mfeh5eyI96WSVexTBAvkMgJzkKTOiW1vkIbzxe
.	86400	IN	DNSKEY	257 3 8 AwEAAa96jeuknZlaeSrvyAJj6ZHv28hhOKkx3rLGXVaC6rXTsDc449

El archivo resultante contiene las dos claves raíz. Si no puedes actualizar, la guía de Akamai recomienda obtener el ancla directamente de IANA y, sobre todo, actualizar las imágenes base y las copias de seguridad, para que un equipo restaurado no vuelva con el ancla antigua.

Si solo fallan algunos dominios, el culpable no es la clave raíz. Cuando el problema es de la raíz, falla todo lo que se resuelve a través de ese resolutor. Si unos nombres funcionan y otros no, mira las firmas caducadas, un registro DS que ya no coincide con la clave del dominio o una migración mal hecha entre proveedores de DNS.

Por qué importa

DNSSEC solo protege si todas las piezas se actualizan a tiempo, y el cambio de clave raíz es la prueba más dura para esa promesa. Cambia muy pocas veces y obliga a tocar cosas que nadie mira durante años: las anclas guardadas en un dispositivo de red, una imagen de máquina virtual, el contenedor de un resolutor interno. La lección de la rotación anterior, según Cloudflare, es que los resolutores pueden perder la confianza que habían aprendido cuando se actualiza el software o se mueve la instalación a otra máquina. Por eso el software reciente incluye la clave nueva de serie.

El coste de un fallo es asimétrico. Si todo está bien, nadie nota nada. Si un resolutor corporativo no está preparado, deja sin internet a toda la oficina, y desde fuera parece una caída general: los sitios funcionan, pero no se llega a ellos. Lo más práctico es comprobarlo hoy, con dos consultas de dig contra el resolutor de la red.

El proceso no termina hoy. Según IANA, la clave antigua se publicará con el bit de revocación el 11 de enero de 2027, que es la señal para que los resolutores la descarten, y se retirará de la raíz el 22 de marzo de 2027. El cambio de hoy afecta a pocos, pero conviene dejar la comprobación hecha mientras el tema está fresco.

Lo medido se ejecutó el 11 de octubre de 2026, entre las 14:16 y las 14:20 UTC, con dig 9.20 y Unbound 1.26.1 en contenedores Debian 13 limpios; las salidas están copiadas de esa ejecución. Las anclas de confianza se tomaron del archivo root-anchors.xml de IANA. Más guías: Cloudflare, «The keys to the Internet change on October 11, 2026» y Akamai, «The October 2026 Root KSK Rollover».
Fuente: IANA, «DNSSEC Trust Anchors and Rollovers»

¿Cómo se calcula la magnitud de un sismo? Las fórmulas y el algoritmo detrás de la cifra

Portada: ¿Cómo se calcula la magnitud de un sismo?, en letras oscuras sobre la foto de un sismógrafo de tambor con su aguja trazando el registro, y la fórmula de la magnitud de momento

Unos minutos después de un temblor, el Servicio Sismológico Nacional ya publica una cifra: magnitud 5.8, 7.1… Detrás de ese número no hay una sola medida, sino un cálculo. Se parte de lo que registran los sismógrafos, se corrige por la distancia y se combina lo de muchas estaciones. Vemos qué fórmulas se usan, por qué hay varias escalas y cómo es el algoritmo, con un programa en Python que lo hace paso a paso.

La primera escala la publicó Charles Richter en 1935, en el Instituto Tecnológico de California. Quería ordenar por tamaño los sismos del sur de California, y para eso eligió algo que se pudiera medir igual siempre: la amplitud máxima que dejaba cada sismo en un sismógrafo concreto, el Wood-Anderson. Como esa amplitud varía de un sismo pequeño a uno grande en un factor de millones, usó su logaritmo. De ahí viene lo que todavía se dice hoy: un grado más de magnitud es una sacudida diez veces mayor.

La escala de Richter funcionaba bien para sismos cercanos y moderados, pero se quedaba corta con los grandes: a partir de cierto tamaño, la amplitud de las ondas deja de crecer aunque el sismo siga creciendo. Por eso hoy los sismos importantes se miden con la magnitud de momento (Mw), que no parte de la amplitud de las ondas sino de la física de la ruptura: qué superficie de falla se rompió y cuánto se deslizó. Las cifras que da son comparables con las de Richter, pero no se saturan.

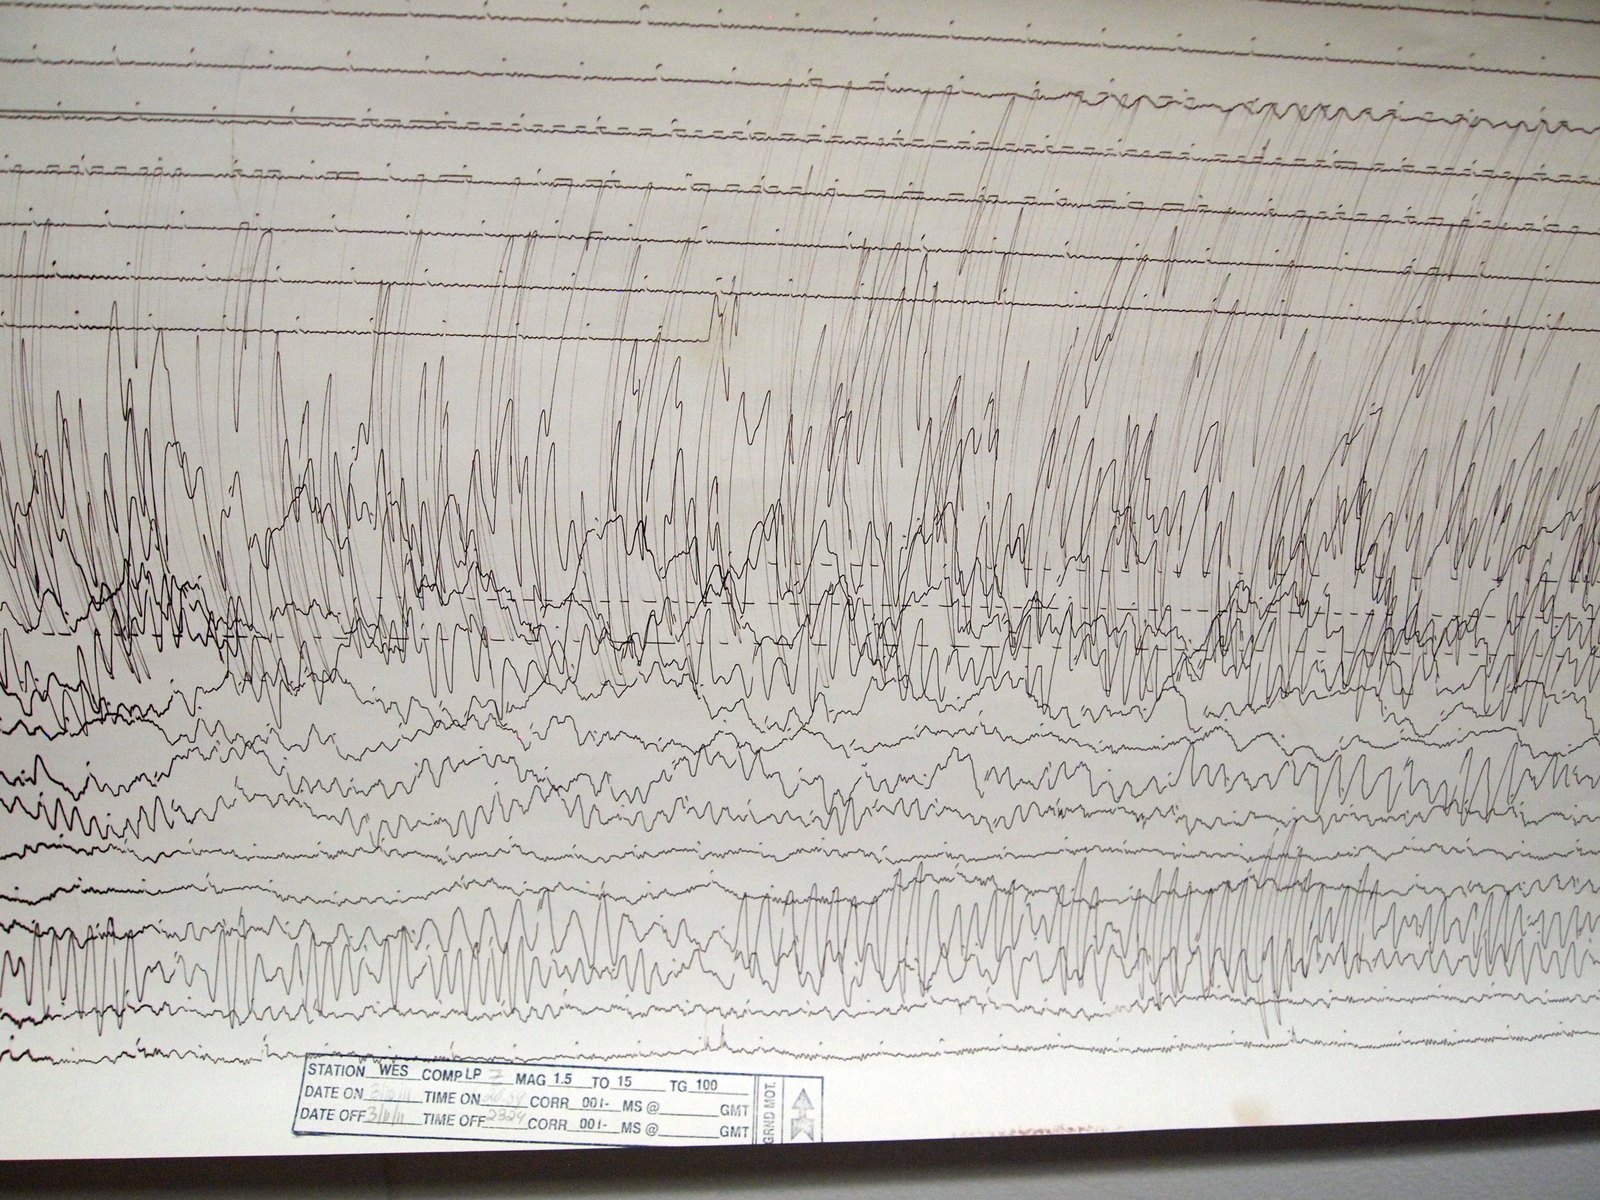
Sismograma en papel del terremoto de Tōhoku de 2011 registrado en el Observatorio Weston, con el trazo que se ensancha bruscamente al llegar las ondas
El terremoto de Tōhoku (Japón, 11 de marzo de 2011, Mw 9.1 según el USGS) registrado en papel en el Observatorio Weston, en Massachusetts, a más de 10,000 km. Foto: Z22, CC BY-SA 3.0, vía Wikimedia Commons.

Claves para calcular la magnitud

1. Lo que mide el sismógrafo

Un sismógrafo registra cómo se mueve el suelo a lo largo del tiempo. De un sismo llegan primero las ondas P, de compresión, que son las más rápidas, y después las ondas S, de cizalla, más lentas y casi siempre más fuertes. Del registro salen dos datos: la amplitud máxima, que dice cuánto se movió el suelo, y el tiempo entre P y S, que dice a qué distancia estaba el sismo.

Onda P · 10.02 sOnda S · 17.04 sS − P = 7.02 s → distanciaA = 1.94 mmtiempo (s)0510152025303540

Sismograma sintético generado con el programa de más abajo. Las líneas discontinuas marcan las llegadas P y S que detecta el algoritmo; la flecha, la amplitud máxima.

2. La distancia sale del retraso entre ondas

Las dos ondas salen del mismo punto a la vez, pero la S viaja más despacio. Cuanto más lejos esté el sismo, más tiempo le saca la P. Con las velocidades de las dos ondas se despeja la distancia:

d=Δt·VPVSVP−VS≈8.4·Δt

Δt: segundos entre la llegada de la onda P y la de la onda S. Con velocidades típicas de la corteza (VP = 6 km/s, VS = 3.5 km/s), cada segundo de retraso son unos 8.4 km.

Una sola estación sabe a qué distancia está el sismo, pero no en qué dirección: el sismo puede estar en cualquier punto de un círculo a su alrededor. Con tres estaciones, los tres círculos se cortan en un punto, el epicentro. En la práctica se usan decenas de estaciones y se resuelve con el método de Geiger (1910): se parte de una posición aproximada y se corrige por mínimos cuadrados hasta que los tiempos calculados coinciden con los observados, lo que da también la profundidad.

Estación AS−P 4.5 s · 38 kmEstación BS−P 9 s · 76 kmEstación CS−P 6 s · 50 kmEpicentroCírculos a escala: el radio de cada uno es la distancia calculada con S − P

Tres estaciones, tres distancias: los círculos solo coinciden en un punto. Esquema a escala.

3. La fórmula de Richter

Con la amplitud y la distancia ya se puede calcular la magnitud local (ML):

ML=log10A−log10A0(δ)

A: amplitud máxima, en milímetros, en un sismógrafo Wood-Anderson. A0(δ): la amplitud que tendría a esa distancia el sismo «de referencia». Richter fijó que un sismo de magnitud 3 deja un trazo de 1 mm a 100 km.

El primer término es la amplitud medida, en escala logarítmica; el segundo resta lo que se esperaría a esa distancia. Richter tenía A0 en una tabla. Hoy se usan fórmulas calibradas para cada región; esta es la más conocida:

ML=log10A+1.110log10r100+0.00189(r−100)+3.0

r: distancia hipocentral en km. El segundo término corrige que las ondas se reparten en un volumen cada vez mayor; el tercero, que la roca absorbe parte de la energía. Es la calibración de Hutton y Boore (1987) para el sur de California.

Comprobación rápida: con r = 100 km y A = 1 mm, los dos términos de distancia valen cero y ML = 3.0, la definición de Richter. Los sismógrafos modernos no son Wood-Anderson, así que su registro se transforma antes, por cálculo, en el que habría dado uno de ellos.

4. Muchas estaciones, una sola cifra

Cada estación calcula su propia magnitud, y nunca salen iguales: el terreno bajo cada una amplifica o atenúa las ondas, y la ruptura no radia lo mismo en todas las direcciones. Por eso la cifra oficial es una combinación, normalmente la mediana de todas las estaciones, que no se deja arrastrar por una lectura disparatada.

5. El algoritmo, en Python

Este programa reproduce los pasos con un sismograma sintético. La detección usa el método STA/LTA, el habitual en las redes sísmicas: compara la energía media de una ventana corta (STA, medio segundo) con la de una larga (LTA, diez segundos). Mientras solo hay ruido, el cociente ronda 1; cuando llega una onda, se dispara.

import numpy as np

FS = 100                      # muestras por segundo
rng = np.random.default_rng(7)

def ondicula(t, t0, frec, amp, decaimiento):
    """Un tren de ondas que empieza en t0 y se apaga poco a poco."""
    dt = t - t0
    return np.where(dt >= 0, amp * np.exp(-dt / decaimiento) * np.sin(2 * np.pi * frec * dt), 0.0)

def sintetico(t_p, t_s, amp_s, duracion=60):
    t = np.arange(0, duracion, 1 / FS)
    ruido = rng.normal(0, 0.004, t.size)
    p = ondicula(t, t_p, 6.0, amp_s * 0.18, 2.5)
    s = ondicula(t, t_s, 2.5, amp_s, 4.0)
    return t, ruido + p + s

def sta_lta(x, corta=0.5, larga=10.0):
    """Cociente entre la energía media de la ventana corta y la de la larga."""
    e = x ** 2
    nc, nl = int(corta * FS), int(larga * FS)
    acum = np.concatenate([[0.0], np.cumsum(e)])
    sta = (acum[nc:] - acum[:-nc]) / nc
    lta = (acum[nl:] - acum[:-nl]) / nl
    n = min(sta.size - (nl - nc), lta.size)
    return np.concatenate([np.zeros(nl), sta[nl - nc:nl - nc + n] / (lta[:n] + 1e-12)])

def detectar(t, x, umbral=4.0):
    """Llegada P: primer cruce del umbral. Llegada S: el siguiente cruce,
    después de que el cociente haya vuelto a bajar."""
    r = sta_lta(x)
    i_p = int(np.argmax(r > umbral))
    bajo = i_p + int(np.argmax(r[i_p:] < 1.5))
    i_s = bajo + int(np.argmax(r[bajo:] > 2.0))
    return t[i_p], t[i_s]

Con las llegadas detectadas, se calcula la distancia, la magnitud de cada estación y la de la red:

import math
import numpy as np
from sismograma import sintetico, detectar

VP, VS = 6.0, 3.5             # velocidades típicas en la corteza, km/s

def distancia(ts_menos_tp):
    """Las dos ondas salen juntas; la S llega tarde. d = Δt · Vp·Vs / (Vp − Vs)."""
    return ts_menos_tp * VP * VS / (VP - VS)

def magnitud_local(amplitud_mm, r_km):
    """Hutton y Boore (1987), sur de California. Amplitud en mm de un
    sismógrafo Wood-Anderson; r = distancia hipocentral en km."""
    return math.log10(amplitud_mm) + 1.110 * math.log10(r_km / 100) + 0.00189 * (r_km - 100) + 3.0

# --- una estación, paso a paso
t, x = sintetico(t_p=10.0, t_s=17.0, amp_s=2.0)
tp, ts = detectar(t, x)
d = distancia(ts - tp)
a = np.abs(x).max()
print(f"llegada P: {tp:.2f} s   llegada S: {ts:.2f} s   S-P: {ts - tp:.2f} s")
print(f"distancia: {d:.1f} km   amplitud máxima: {a:.2f} mm")
print(f"ML = {magnitud_local(a, d):.2f}")
print()

# --- la red: cada estación da su magnitud y se toma la mediana
estaciones = [("ACAP", 4.5, 7.80), ("CUER", 9.0, 2.85), ("PUEB", 14.0, 1.60),
              ("OAXA", 21.0, 0.55), ("TLAX", 30.0, 0.39)]
mags = []
for nombre, sp, amp in estaciones:
    t, x = sintetico(t_p=10.0, t_s=10.0 + sp, amp_s=amp)
    tp, ts = detectar(t, x)
    d = distancia(ts - tp)
    m = magnitud_local(np.abs(x).max(), d)
    mags.append(m)
    print(f"{nombre}  S-P {ts - tp:5.2f} s  d {d:6.1f} km  A {np.abs(x).max():5.2f} mm  ML {m:.2f}")
print(f"ML de la red (mediana): {np.median(mags):.2f}   (media: {np.mean(mags):.2f})")
python magnitud.pyllegada P: 10.02 s   llegada S: 17.04 s   S-P: 7.02 s
distancia: 59.0 km   amplitud máxima: 1.94 mm
ML = 2.96

ACAP  S-P  4.52 s  d   38.0 km  A  7.48 mm  ML 3.29
CUER  S-P  9.02 s  d   75.8 km  A  2.77 mm  ML 3.26
PUEB  S-P 14.00 s  d  117.6 km  A  1.56 mm  ML 3.31
OAXA  S-P 20.99 s  d  176.3 km  A  0.54 mm  ML 3.15
TLAX  S-P 29.98 s  d  251.8 km  A  0.38 mm  ML 3.31
ML de la red (mediana): 3.29   (media: 3.26)

Las cinco estaciones están a distancias muy distintas y registran amplitudes muy distintas, de 7.48 mm a 0.38 mm, pero una vez corregida la distancia todas coinciden en una magnitud cercana a 3.3. Esa es la idea de toda la fórmula. Los códigos de estación son inventados.

Es una versión simplificada para entender el método: el sismograma es sintético y la amplitud sale ya en milímetros Wood-Anderson. Un sistema real corrige primero la respuesta de cada sensor, usa detectores más robustos frente al ruido, localiza el sismo con muchas estaciones y aplica correcciones propias de cada estación.

6. Por qué hay varias escalas

La fórmula de Richter sirve para sismos cercanos. Para sismos lejanos se inventaron otras con la misma lógica, amplitud más corrección por distancia, pero con otras ondas: la de ondas superficiales (MS) y la de ondas de cuerpo (mb).

MS=log10(AT)+1.66log10Δ+3.30

Magnitud de ondas superficiales. A: amplitud de las ondas Rayleigh en micrómetros; T: su periodo, unos 20 s; Δ: distancia en grados, entre 20° y 160°. (La IASPEI usa la misma fórmula con A en nanómetros y +0.3 al final, que es equivalente).

Todas tienen el mismo problema: cada una mide ondas de un periodo concreto, y a partir de cierto tamaño el sismo sigue creciendo pero esas ondas ya no. Es la saturación. Según el USGS:

EscalaQué midePara qué tamañosSe satura hacia
ML (local, Richter)Amplitud máxima, hasta 600 kmDe 2 a 6.5; fiable sobre todo por debajo de 4—
mb (ondas de cuerpo)Primeras ondas P, de periodo 1 sDe 4 a 6.56.5
MS (ondas superficiales)Ondas Rayleigh de unos 20 sDe 5 a 8.58.3
Mw (momento)El tamaño físico de la rupturaCualquiera; la del USGS, desde 5No se satura

7. La magnitud de momento

En lugar de medir una onda, Mw estima el momento sísmico, M0, que depende del tamaño de la ruptura:

M0=μ·A·D

μ: rigidez de la roca, unos 3 × 10¹⁰ Pa en la corteza; A: área de la falla que se rompió; D: cuánto se deslizó, en promedio. Se mide en newton·metro.

Área de la falla A = L × WL (largo)W (ancho)D (deslizamiento)M₀ = μ · A · Dμ = rigidez de la roca (unos 3 × 10¹⁰ Pa en la corteza)

El momento sísmico crece con el área de la falla que se rompe y con lo que se desliza.

Y de ahí, la magnitud:

Mw=23(log10M0−9.1)

Magnitud de momento (Kanamori, 1977; Hanks y Kanamori, 1979), con M0 en N·m, como la define la IASPEI. Las constantes se eligieron para que coincida con las escalas antiguas allí donde estas funcionan bien.

Los sismólogos no miden el área ni el deslizamiento con una regla: obtienen M0 ajustando las ondas de periodo muy largo registradas en todo el mundo (la llamada inversión del tensor de momento; para sismos grandes, el USGS usa la fase W). Pero la fórmula se puede recorrer al revés para ver qué tamaño de falla corresponde a cada magnitud:

import math

def momento_sismico(rigidez_pa, largo_km, ancho_km, desliz_m):
    """M0 = μ · A · D, en newton·metro."""
    return rigidez_pa * (largo_km * 1e3) * (ancho_km * 1e3) * desliz_m

def magnitud_momento(m0):
    """Mw = 2/3 · (log10 M0 − 9.1), con M0 en N·m (estándar IASPEI)."""
    return 2 / 3 * (math.log10(m0) - 9.1)

MU = 3e10                     # rigidez típica de la corteza, Pa
for largo, ancho, desliz in [(1, 1, 0.02), (10, 5, 0.5), (50, 20, 2.0), (400, 150, 10.0)]:
    m0 = momento_sismico(MU, largo, ancho, desliz)
    print(f"falla {largo:>3} x {ancho:>3} km, desliz {desliz:>5} m  ->  M0 = {m0:.2e} N·m  ->  Mw {magnitud_momento(m0):.1f}")

print()
def energia_j(m):
    """Gutenberg y Richter: log10 E = 1.5 M + 4.8, con E en julios."""
    return 10 ** (1.5 * m + 4.8)

for m in [4, 5, 6, 7, 8]:
    print(f"M{m}: {energia_j(m):.1e} J   ({energia_j(m) / energia_j(4):,.0f} veces la de un M4)")
print(f"\nun grado más = {10 ** 1.5:.1f} veces la energía y 10 veces la amplitud")
python momento.pyfalla   1 x   1 km, desliz  0.02 m  ->  M0 = 6.00e+14 N·m  ->  Mw 3.8
falla  10 x   5 km, desliz   0.5 m  ->  M0 = 7.50e+17 N·m  ->  Mw 5.9
falla  50 x  20 km, desliz   2.0 m  ->  M0 = 6.00e+19 N·m  ->  Mw 7.1
falla 400 x 150 km, desliz  10.0 m  ->  M0 = 1.80e+22 N·m  ->  Mw 8.8

M4: 6.3e+10 J   (1 veces la de un M4)
M5: 2.0e+12 J   (32 veces la de un M4)
M6: 6.3e+13 J   (1,000 veces la de un M4)
M7: 2.0e+15 J   (31,623 veces la de un M4)
M8: 6.3e+16 J   (1,000,000 veces la de un M4)

un grado más = 31.6 veces la energía y 10 veces la amplitud

Una falla de 50 × 20 km que se desliza 2 m da Mw 7.1, la misma magnitud que el sismo del 19 de septiembre de 2017 en Puebla y Morelos. Para llegar a 8.8 hace falta una ruptura de cientos de kilómetros, que solo se da en las grandes zonas de subducción, como la costa del Pacífico mexicano.

La energía usa la relación de Gutenberg y Richter:

log10E=1.5M+4.8

Relación de Gutenberg y Richter entre la magnitud y la energía liberada en forma de ondas, E, en julios.

Cada grado multiplica la energía por 101.5, unas 31.6 veces, y dos grados, por 1,000. Por eso un sismo de magnitud 7 no es «un poco más» que uno de 6: libera unas 32 veces más energía.

Por qué importa

La magnitud es una medida del sismo en su origen, y no depende de dónde estés. Lo que se siente en cada lugar es la intensidad, que se mide con otra escala, la de Mercalli Modificada, y depende de la distancia, la profundidad y el terreno. Un sismo de magnitud 7 lejano y profundo puede sentirse menos que uno de 6 justo debajo de una ciudad. En el Valle de México, el suelo blando del antiguo lago amplifica las ondas, y por eso sismos con epicentro a cientos de kilómetros, como el de 1985 (M8.1), causaron tanto daño en la capital.

Entender la escala logarítmica también ayuda a leer las noticias. La ley de Gutenberg-Richter dice que, en una región, los sismos de cada grado son unas diez veces más frecuentes que los del grado siguiente:

log10N=a−bM

Ley de Gutenberg-Richter: N es el número de sismos de magnitud M o mayor en una región y un periodo. b suele valer cerca de 1.

Por cada sismo de magnitud 7 hay unos diez de magnitud 6 y unos cien de 5. Que haya muchos sismos pequeños no «descarga» la falla lo suficiente como para evitar los grandes: harían falta unos mil de magnitud 5 para liberar la energía de uno de 7.

Por eso la cifra que se publica minutos después del temblor puede corregirse en las horas siguientes: la primera estimación sale de las estaciones cercanas y de las escalas rápidas, y la magnitud de momento definitiva, de ajustar las ondas registradas en todo el mundo. Las dos cifras salen del mismo procedimiento que hemos visto: medir, corregir por la distancia y combinar las estaciones.

Fórmulas: Richter (1935); Hutton y Boore (1987), Bulletin of the Seismological Society of America; Kanamori (1977) y Hanks y Kanamori (1979); recomendaciones de la IASPEI sobre magnitudes (2013). El código se ejecutó con Python 3.14 y NumPy 2.5 en un contenedor limpio; las salidas están copiadas de esa ejecución. Foto de portada: sismógrafo histórico del Instituto de Geofísica de la Academia Checa de Ciencias, por Petr Brož, CC BY-SA 4.0, invertida y recortada.

Fuente: USGS, «Magnitude Types»

Docker Agent: los agentes de IA se definen en un YAML y se ejecutan como un contenedor

Portada: Docker Agent, agentes de IA en un YAML, con el logotipo de la ballena de Docker y un archivo agent.yaml de ejemplo sobre fondo azul claro

Docker Agent es la herramienta de código abierto de Docker para crear agentes de IA sin escribir el programa que los mueve: se describen en un archivo YAML (qué modelo usan, qué instrucciones siguen y qué herramientas pueden tocar) y se ejecutan con docker agent run. El 9 de octubre publicó su versión 1.150, y ya viene preinstalada en Docker Desktop. La instalamos para ver cómo funciona.

Hasta hace poco, montar un agente que lea archivos, ejecute órdenes o consulte una API significaba escribir código con alguna biblioteca de agentes y encargarse del bucle entre el modelo y las herramientas. Docker propone otra forma, la misma que aplicó a las aplicaciones con Compose: declarar lo que quieres en un archivo y dejar que la herramienta haga el resto.

El proyecto, con licencia Apache 2.0, publica versiones casi cada día; antes se llamaba cagent, y la propia herramienta todavía guarda su configuración en una carpeta con ese nombre. Desde Docker Desktop 4.63 viene incluido como complemento de la línea de órdenes, y también se instala con Homebrew o descargando el binario.

Claves de Docker Agent

Un agente es un archivo

Este es el ejemplo mínimo de la documentación oficial: un asistente de programación que puede trabajar con archivos, ejecutar órdenes y razonar paso a paso.

agents:
  root:
    model: anthropic/claude-sonnet-4-5
    description: A coding assistant
    instruction: |
      You are an expert developer. Help users write clean,
      efficient code. Explain your reasoning step by step.
    toolsets:
      - type: filesystem
      - type: shell
      - type: think

Cada agente tiene un modelo, una descripción, unas instrucciones y una lista de herramientas (toolsets). Se pueden definir varios agentes en el mismo archivo y hacer que el principal (root) delegue tareas en los demás. El modelo se elige con el formato proveedor/modelo: admite OpenAI, Anthropic, Google, AWS Bedrock, Mistral y otros, además de modelos locales con Docker Model Runner.

Treinta tipos de herramientas de serie

docker-agent toolsets
salida (recortada: son 30 en la v1.150.0)TYPE                SUMMARY
a2a                 Connect to remote agents via the Agent-to-Agent (A2A) protocol
api                 Create custom tools that call HTTP APIs
background_agents   Dispatch work to sub-agents concurrently and collect results
fetch               Read content from HTTP/HTTPS URLs
filesystem          Read, write, list, search, and navigate files and directories
git                 Read-only git repository inspection: status, log, branches, show, blame
mcp                 Extend agents with external tools via the Model Context Protocol
mcp_catalog         Discover and activate remote MCP servers from the Docker MCP Catalog
memory              Persistent key-value storage for cross-session recall
rag                 Search document knowledge bases with hybrid retrieval (RAG)
shell               Execute shell commands in the user's environment
think               Step-by-step reasoning scratchpad for planning
todo                Manage a task list for complex multi-step workflows
…

Además de leer y escribir archivos o ejecutar órdenes, hay herramientas para buscar en documentos (RAG), recordar datos entre sesiones, consultar un repositorio Git en modo solo lectura o generar herramientas a partir de una especificación OpenAPI. Y con mcp se puede conectar cualquier servidor del protocolo MCP, el estándar abierto para dar herramientas a los modelos, incluidos los del catálogo de Docker, que se ejecutan en contenedores.

Qué pasa si no tienes clave

Docker Agent no trae un modelo propio: usa el del proveedor que elijas, con tu clave. Ejecutamos el ejemplo anterior sin ninguna configurada:

docker-agent run --exec agent.yaml …  (código de salida 1)Error: The following environment variables must be set:
 - ANTHROPIC_API_KEY

Provide them using any of these sources:
 - Shell environment:      export ANTHROPIC_API_KEY=<value>
 - Env file:               docker agent run --env-from-file <file> ...
 - Docker Agent env file:  docker agent setup (stores the key in ~/.config/cagent/.env)

No API key? Run a local model instead: docker agent run --model dmr/ai/qwen3 ...

El mensaje dice exactamente qué falta y cómo darlo, y propone usar un modelo local con Docker Model Runner, que no necesita clave. La orden docker agent doctor repasa qué proveedores tienen credenciales configuradas, y docker agent setup lo configura de forma interactiva.

Probamos el binario oficial de la versión 1.150.0 (151 MB) en un contenedor Linux: su ayuda, la lista de herramientas, el diagnóstico de credenciales y el arranque del ejemplo. No lo ejecutamos con un modelo real, porque eso requiere la clave de un proveedor o descargar un modelo local de varios gigas.

Se comparten como imágenes

Los agentes se suben y se descargan de un registro de imágenes, igual que un contenedor, así que un equipo puede publicar los suyos y cualquiera los ejecuta por su nombre, sin copiar archivos:

docker agent run miempresa/revisor-de-codigo:1.0

También se pueden servir como API (docker agent serve), evaluar con casos de prueba (docker agent eval) o ejecutar en un entorno aislado (--sandbox), algo importante cuando el agente puede ejecutar órdenes en tu máquina.

Por qué importa

La idea de fondo es tratar a los agentes como Docker trató a las aplicaciones: un archivo que describe todo lo necesario, que se puede versionar con Git, revisar en una pull request y compartir por un registro. Eso los hace reproducibles, que es justo lo que suele faltar cuando cada agente es un programa distinto escrito a mano.

Que venga incluido en Docker Desktop lo pone al alcance de cualquiera que ya lo use, sin instalar nada más. Y apostar por MCP en lugar de un sistema de herramientas propio permite aprovechar los servidores que ya existen.

La precaución es la de cualquier agente: con herramientas como shell o filesystem, el modelo puede ejecutar órdenes y modificar archivos en tu equipo. Conviene empezar con permisos limitados o con el modo aislado, y revisar lo que hace antes de darle más libertad.

Documentación: Docker Agent. Versión probada: v1.150.0, publicada el 9 de octubre de 2026.

Fuente: Docker, repositorio oficial de Docker Agent en GitHub

GitHub abre a todos las pull requests apiladas: cambios grandes en piezas que se revisan por separado

Portada: Pull requests apiladas en GitHub, con el logotipo de GitHub y una pila de tres pull requests sobre la rama main

GitHub anunció el 6 de octubre la disponibilidad general de las pull requests apiladas (stacked pull requests). Permiten dividir un cambio grande en varias pull requests pequeñas y encadenadas, que se revisan por separado y se pueden fusionar juntas. Están disponibles en todos los planes de github.com.

Revisar una pull request de dos mil líneas es lento y poco fiable: quien revisa se cansa y los fallos se cuelan. La alternativa habitual era trocear el trabajo, pero GitHub no ayudaba: había que crear a mano cada rama sobre la anterior y, cuando se fusionaba la primera, rebasar y redirigir el resto una por una. Por eso existían herramientas externas para trabajar «en pila», populares en equipos grandes.

Ahora GitHub lo hace de forma nativa. Una pila es una serie de pull requests en el mismo repositorio, donde la primera apunta a main y cada una de las demás apunta a la rama de la anterior. GitHub muestra la pila completa, permite moverse entre sus piezas y se encarga de los rebases al fusionar.

Claves de las pull requests apiladas

  • Cada pieza se revisa sola. Cada pull request de la pila es un cambio pequeño y completo. Las reglas de protección de ramas, como las aprobaciones obligatorias de los responsables del código, y la integración continua se aplican a todas, no solo a la de abajo.
  • Las aprobaciones sobreviven a los rebases. Si al rebasar no cambia el código de una pull request, sus aprobaciones se conservan, y los commits firmados siguen firmados.
  • La pila se reorganiza sola. Al fusionar la de abajo, GitHub rebasa automáticamente las demás para que la siguiente pase a apuntar a main. Toda la pila entra en la cola de fusión como un solo elemento, y la fusión automática está llegando en las próximas semanas.
  • En todas partes. Funciona en la web, en la app móvil, por la API y con agentes. En la web, la pila aparece en la cabecera de cada pull request, y Shift+J y Shift+K llevan a la siguiente y a la anterior.
  • Un límite. Todas las ramas tienen que estar en el mismo repositorio: no se pueden apilar pull requests desde un fork.
  • Disponibilidad. Todos los planes de github.com. GitHub Enterprise Server lo recibirá en una próxima versión.

Cómo se usa desde la terminal

Desde la línea de órdenes se trabaja con la extensión gh stack de GitHub CLI, que necesita gh 2.90.0 o posterior y Git 2.20 o posterior. Este es el flujo para una pila de tres, tal como lo describe la guía rápida oficial:

gh extension install github/gh-stack

gh stack init                 # crea la pila y la primera rama
git add . && git commit -m "Nuevo modelo de datos"

gh stack add validacion-api   # segunda rama, encima de la primera
git add . && git commit -m "Validación en el API"

gh stack add formulario       # tercera rama
git add . && git commit -m "Interfaz del formulario"

gh stack push                 # sube todas las ramas
gh stack submit               # crea las tres pull requests y la pila en GitHub

Si en la revisión te piden cambios en una pieza intermedia, haces el commit en esa rama y gh stack sync se encarga del rebase en cascada de las de encima y de subirlas. gh stack merge fusiona una o varias pull requests de la pila de una vez.

Las órdenes salen de la guía rápida de GitHub; no las hemos podido ejecutar, porque necesitan una cuenta de GitHub y un repositorio real. Los nombres de las ramas y de los commits son de ejemplo.

Por qué importa

Las pull requests pequeñas se revisan mejor y antes, y eso se nota en el ritmo de un equipo. Según GitHub, los repositorios que usan pilas fusionan un 9 % más de código, y el 1 % más activo reduce un 5 % el tiempo hasta la fusión. Charlie Marsh, fundador de Astral (la empresa detrás de las herramientas de Python Ruff y uv), lo resumió así: «Me bastó una fusión con las stacked PR de GitHub para concluir que son increíbles».

También encaja con el momento: los agentes de IA generan cambios grandes con mucha facilidad, y partirlos en piezas revisables es una de las formas de mantenerlos bajo control. GitHub ya lo apunta al incluir a los agentes entre los que pueden crear y gestionar pilas.

Para quien ya trabajaba en pila con herramientas externas, el cambio es que ahora todo vive en GitHub, con sus reglas de protección y su cola de fusión. Para el resto, es una buena excusa para dejar de abrir pull requests gigantes.

Fuente: GitHub Changelog, «Stacked pull requests generally available», y la documentación de GitHub

Python 3.15 ya está aquí: importaciones perezosas, frozendict y UTF-8 por defecto

Portada: Python 3.15 ya está aquí, con el logotipo de Python sobre fondo claro y las novedades lazy import, frozendict, sentinel, UTF-8, JIT y Tachyon

La Python Software Foundation publicó el 9 de octubre Python 3.15.0, la nueva versión estable del lenguaje. Trae dos tipos integrados nuevos, una palabra clave para importar módulos solo cuando se usan y un cambio que acaba con muchos problemas de acentos: UTF-8 pasa a ser la codificación por defecto. Compilamos la versión final desde el código fuente oficial y probamos cada novedad.

Python publica una versión nueva cada octubre, con un ciclo de soporte de cinco años: dos de correcciones y tres más solo de seguridad. La 3.14 salió hace un año; la 3.15 es la primera versión estable que recoge el trabajo de estos doce meses, y es la que conviene empezar a probar con tus proyectos.

Las novedades se reparten entre el lenguaje (importaciones perezosas, frozendict, sentinel, desempaquetado en comprensiones), el comportamiento por defecto (UTF-8 en todas partes), las herramientas (un perfilador por muestreo en la biblioteca estándar) y el rendimiento, con un compilador JIT experimental mejorado.

Claves de Python 3.15

Importaciones perezosas con lazy import

import sys, time

inicio = time.perf_counter()
lazy import json
lazy import xml.dom.minidom
print("tras las importaciones:", "json" in sys.modules, "xml.dom.minidom" in sys.modules)
print(f"tiempo: {(time.perf_counter() - inicio) * 1000:.2f} ms")

print(json.dumps({"listo": True}))
print("después de usar json:", "json" in sys.modules, "xml.dom.minidom" in sys.modules)
python3.15 perezoso.pytras las importaciones: False False
tiempo: 0.01 ms
{"listo": true}
después de usar json: True False

Con lazy import, el módulo no se carga al llegar a esa línea sino la primera vez que se usa. Por eso, tras las dos importaciones, ninguno está en sys.modules; json se carga al llamar a json.dumps, y xml.dom.minidom, que no se llega a usar, no se carga nunca. En programas con muchas dependencias, sobre todo herramientas de línea de órdenes, esto acorta el arranque. También se puede activar para todo un programa con python -X lazy_imports=all o la variable PYTHON_LAZY_IMPORTS. Es una palabra clave nueva: Python 3.14 no la entiende.

el mismo código en Python 3.14.8  File "//v.py", line 1
    lazy import json
         ^^^^^^
SyntaxError: invalid syntax

frozendict: diccionarios inmutables

config = frozendict(host="localhost", puerto=5432)
print(config, config["puerto"])

try:
    config["puerto"] = 3306
except TypeError as e:
    print("TypeError:", e)

a = frozendict(x=1, y=2)
b = frozendict(y=2, x=1)
print(a == b, hash(a) == hash(b))

cache = {frozendict(lenguaje="python", version="3.15"): "lista"}
print(cache[frozendict(version="3.15", lenguaje="python")])
print(isinstance(config, dict))
salidafrozendict({'host': 'localhost', 'puerto': 5432}) 5432
TypeError: 'frozendict' object does not support item assignment
True True
lista
False

Es el equivalente de frozenset para los diccionarios: no se puede modificar y, si sus claves y valores lo son, se puede usar como clave de otro diccionario o meter en un conjunto. Conserva el orden de inserción, pero dos frozendict con el mismo contenido son iguales aunque estén en distinto orden. No hereda de dict (de ahí el False final), así que para aceptar ambos conviene comprobar collections.abc.Mapping.

sentinel: marcadores únicos sin trucos

FALTA = sentinel("FALTA")
print(FALTA, type(FALTA).__name__)

def buscar(datos, clave, por_defecto=FALTA):
    if clave in datos:
        return datos[clave]
    if por_defecto is FALTA:
        raise KeyError(clave)
    return por_defecto

datos = {"a": None}
print(buscar(datos, "a"))
print(buscar(datos, "b", 0))
try:
    buscar(datos, "b")
except KeyError as e:
    print("KeyError:", e)

import copy
print(copy.deepcopy(FALTA) is FALTA)
salidaFALTA sentinel
None
0
KeyError: 'b'
True

Sirve para distinguir «no me han pasado nada» de «me han pasado None», algo que hasta ahora se hacía con un object() anónimo. El nuevo tipo tiene un nombre legible, sobrevive a una copia sin dejar de ser el mismo objeto y se puede usar en las anotaciones de tipo (FALTA | None).

Desempaquetado dentro de las comprensiones

listas = [[1, 2], [3, 4], [5]]
print([*l for l in listas])

conjuntos = [{1, 2}, {2, 3}, {3, 4}]
print({*s for s in conjuntos})

ajustes = [{"tema": "claro"}, {"idioma": "es"}, {"tema": "oscuro"}]
print({**d for d in ajustes})
salida[1, 2, 3, 4, 5]
{1, 2, 3, 4}
{'tema': 'oscuro', 'idioma': 'es'}

El * y el ** ahora funcionan dentro de una comprensión. [*l for l in listas] aplana una lista de listas sin el doble for de antes, y {**d for d in ajustes} une diccionarios: si una clave se repite, gana el último.

UTF-8 por defecto

import sys, locale
with open("saludo.txt", "w") as f:
    f.write("Año, niño, café ☕")
with open("saludo.txt", "rb") as f:
    print(f.read())
print("modo UTF-8:", sys.flags.utf8_mode, "| locale:", locale.getpreferredencoding(False))
LANG=C python3.15 utf8.pyb'A\xc3\xb1o, ni\xc3\xb1o, caf\xc3\xa9 \xe2\x98\x95'
modo UTF-8: 1 | locale: utf-8

Aunque el sistema esté configurado con la codificación más básica (LANG=C), open() escribe en UTF-8 sin que se lo pidas. Hasta ahora usaba la del sistema, y por eso un programa que funcionaba en Linux fallaba con los acentos en Windows. Si algún programa antiguo depende del comportamiento anterior, se puede volver a él con PYTHONUTF8=0; así se ve lo que pasaba antes:

LANG=C PYTHONUTF8=0 python3.15 utf8.pyUnicodeEncodeError: 'ascii' codec can't encode character '\xf1' in position 1: ordinal not in range(128)

Errores que sugieren el método correcto

python3.15 -c …, cuatro errores típicos de quien viene de otro lenguajeAttributeError: 'list' object has no attribute 'push'. Did you mean '.append'?
AttributeError: 'str' object has no attribute 'toUpperCase'. Did you mean '.upper'?
AttributeError: 'dict' object has no attribute 'put'. Use d[k] = v.
AttributeError: 'tuple' object has no attribute 'append'. Did you mean to use a 'list' object?

Cuando alguien escribe un método de JavaScript o de Java, Python 3.15 sugiere el suyo: push → append, toUpperCase → upper. Las sugerencias aparecen en el mensaje que se imprime cuando el error no se captura; el texto de la excepción, si lo capturas con except, sigue siendo solo la primera parte. En Python 3.14 los mismos errores no sugieren nada.

Un perfilador nuevo: Tachyon

python3.15 -m profiling.sampling run lento.py
salida (recortada)Captured 262 samples in 0.26 seconds
Sample rate: 1000.00 samples/sec
       nsamples   sample%  tottime (ms)    cumul%  cumtime (ms)  filename:lineno(function)
        156/216      67.0       156.000      92.7       216.000  lento.py:7(ordenar)
          60/60      25.8        60.000      25.8        60.000  lento.py:7(ordenar.<locals>.<genexpr>)
          16/17       6.9        16.000       7.3        17.000  lento.py:2(fib)

El nuevo paquete profiling reúne los perfiladores de la biblioteca estándar. profiling.sampling, al que llaman Tachyon, mira cada poco qué está ejecutando el programa en lugar de medir cada llamada, así que casi no lo frena y puede incluso engancharse a un proceso que ya está en marcha (attach). Aquí señala que el 67 % del tiempo se va en la función ordenar. También genera gráficos de llama en HTML. cProfile sigue funcionando: ahora es un alias de profiling.tracing.

Lo demás

QuéEn resumen
Compilador JITSigue siendo experimental y no viene activado por defecto. Según el anuncio, rinde entre un 7 y un 8 % más (media geométrica) en x86-64 con Linux. No lo hemos medido.
TipadoTypedDict con claves extra tipadas (PEP 728), TypeForm (PEP 747) y bases disjuntas (PEP 800)
CompilaciónPunteros de marco activados por defecto (PEP 831), que facilitan perfilar desde fuera; en Windows, el intérprete con llamadas de cola; en macOS, la versión sin GIL se instala por defecto
RetiradoLos módulos sre_* (hay que usar re), el atributo __cached__ de los módulos y funciones obsoletas de ast, pathlib, typing y otros módulos

Por qué importa

La mayoría de estos cambios ahorran trabajo repetido. Las importaciones perezosas se hacían hasta ahora con importaciones escondidas dentro de las funciones; los diccionarios inmutables, con types.MappingProxyType o paquetes externos; los centinelas, con un object() sin nombre que aparecía en los mensajes de error como <object object at 0x7f…>. Ahora todo eso viene con el lenguaje y con una forma única de hacerlo.

El cambio a UTF-8 es el que más se notará sin hacer nada. Es la causa de una parte enorme de los errores con acentos y eñes en Windows, y para quien programa en español era un tropiezo habitual. Eso sí: un programa que dependía de la codificación del sistema puede comportarse de otra forma. Lo más prudente sigue siendo indicar siempre encoding="utf-8" al abrir archivos.

Python 3.15 se puede descargar ya desde python.org. Antes de pasar un proyecto a producción conviene esperar a que tus dependencias publiquen versiones para la 3.15, algo que suele llevar unas semanas, y probarlo primero en un entorno virtual. Para empezar con el lenguaje, nuestro curso de Python y los ejemplos de Python siguen sirviendo tal cual.

Probado compilando el código fuente oficial de Python 3.15.0 (Python-3.15.0.tar.xz) en un contenedor Debian; las salidas están copiadas de esa ejecución, y las de comparación, de Python 3.14.8. Detalle de cada cambio en What’s New in Python 3.15.

Fuente: Python Software Foundation, «Python 3.15.0»

El James Webb encuentra de dónde salió la ráfaga rápida de radio más lejana jamás medida

Portada: la ráfaga de radio más lejana jamás medida, con la galaxia anfitriona vista por el telescopio James Webb

Las ráfagas rápidas de radio son destellos de unos milisegundos que llegan desde otras galaxias, y casi veinte años después de descubrirlas nadie sabe con certeza qué las produce. El telescopio James Webb acaba de encontrar la galaxia de la más lejana medida hasta ahora, y lo que ha visto en ella inclina la balanza hacia una de las dos grandes explicaciones.

La primera ráfaga rápida de radio (FRB, por sus siglas en inglés) se identificó en 2007. Son pulsos de ondas de radio que duran milisegundos y que, en su gran mayoría, se ven una sola vez y nunca más. Eso las hace muy difíciles de estudiar: para saber qué las produce hay que localizar con mucha precisión el punto del cielo del que vienen y, después, encontrar y estudiar la galaxia que hay en ese lugar.

El 4 de marzo de 2024, el equipo MeerTRAP detectó con el radiotelescopio MeerKAT, en Sudáfrica, una ráfaga a la que se llamó FRB 20240304B. Los datos de radio indicaban que venía de muy lejos, quizá de más lejos que ninguna otra. Para confirmarlo hacía falta ver su galaxia, pero en ese punto exacto los mayores telescopios terrestres no veían nada. El equipo recurrió al Webb.

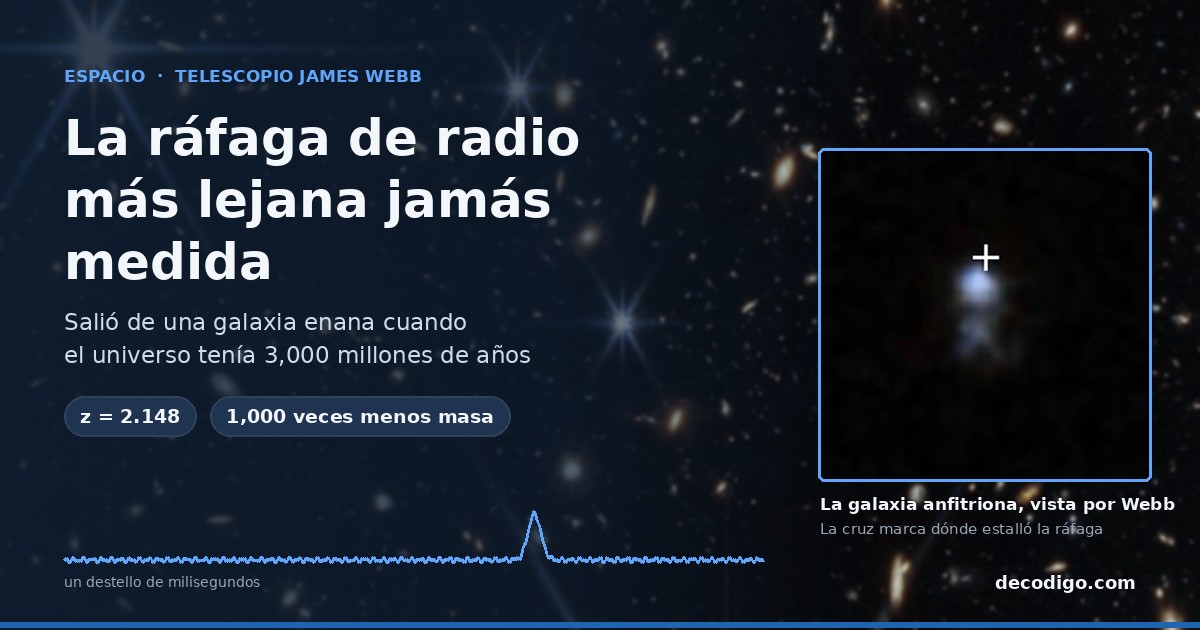
La cámara infrarroja NIRCam encontró una galaxia justo en ese lugar, y el espectrógrafo NIRSpec midió su corrimiento al rojo: 2.148. Eso significa que la ráfaga se produjo cuando el universo tenía unos 3,000 millones de años, y que su luz lleva viajando más de 10,000 millones de años. La sorpresa fue la galaxia: en vez de una galaxia grande, era una galaxia enana y muy joven. El estudio, dirigido por la astrofísica Manisha Caleb, de la Universidad de Sídney, se publicó el 8 de octubre en la revista Science.

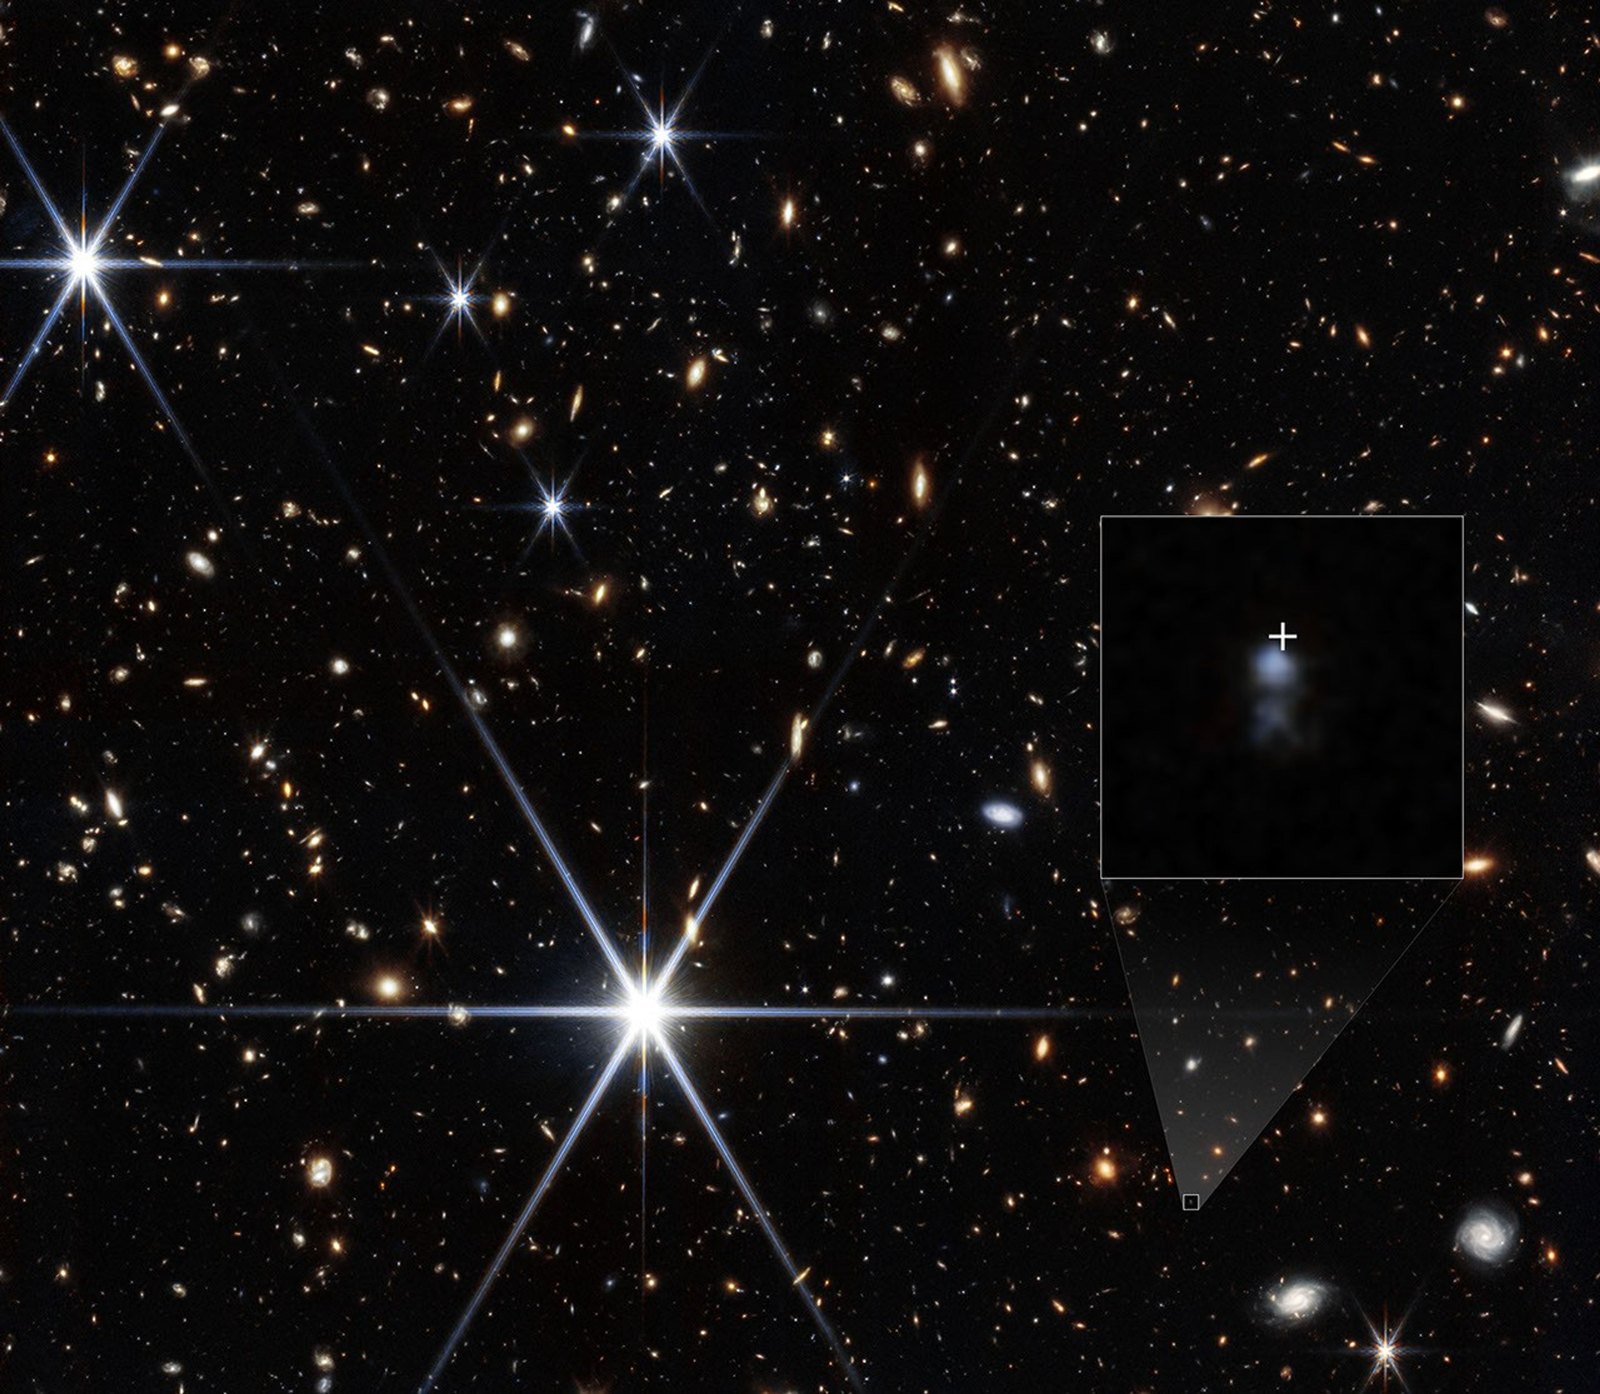
Campo de galaxias captado por NIRCam del telescopio James Webb, con un recuadro ampliado de la pequeña galaxia anfitriona de la ráfaga FRB 20240304B, marcada con una cruz
La galaxia de FRB 20240304B, en el recuadro ampliado. La cruz blanca marca el punto del que salió la ráfaga. Imagen: NASA, ESA, CSA, STScI, Themiya Nanayakkara (USYD); procesado: Joseph DePasquale (STScI).

«Si lo pones en perspectiva humana, cuando la luz salió de la fuente, el Sol no existía, el sistema solar no existía, no existía ningún ser humano.»Manisha Caleb, Universidad de Sídney, en declaraciones a la ABC australiana

Claves del hallazgo

  • Un récord de distancia. Con un corrimiento al rojo de 2.148, es la ráfaga más lejana confirmada. La gran mayoría de las detectadas hasta ahora ocurrieron miles de millones de años después.
  • Una galaxia inesperada. Casi todas las galaxias en las que se han localizado ráfagas son grandes y forman estrellas. Esta tiene unas 1,000 veces menos masa de lo que se esperaba. «Pensábamos que sería una galaxia grande y bien formada, y en su lugar era una pequeña galaxia enana», explica Caleb.
  • Muy joven. La galaxia existía en el llamado «mediodía cósmico», la época en la que el universo formaba estrellas a mayor ritmo. Por su ritmo de formación estelar, la mayoría de sus estrellas pudo nacer en solo 30 millones de años.
  • Una pista sobre el origen. Esa juventud encaja mal con que la ráfaga la produjera el choque de dos estrellas de neutrones, y bien con un magnetar. Lo explicamos más abajo.
  • Una linterna cósmica. La señal guarda la huella de lo que atravesó por el camino. En ella aparecen un cúmulo de galaxias desconocido hasta ahora, a unos 3,500 millones de años luz (corrimiento al rojo 0.3), y el cúmulo de Virgo, a 54 millones de años luz.
  • Un trabajo a dos bandas. MeerKAT detectó y localizó la ráfaga en radio; el Webb, en infrarrojo, encontró la galaxia y midió su distancia. Ningún telescopio podía hacerlo solo.

La pista sobre el origen es lo más interesante del estudio. Hay dos explicaciones principales para estas ráfagas, y la edad de la galaxia permite distinguirlas:

Choque de dos estrellas de neutronesUn magnetar
Qué esDos estrellas de neutrones que orbitan una alrededor de la otra hasta que chocanUna estrella de neutrones joven con un campo magnético enorme, que liberaría la ráfaga en una especie de terremoto estelar
Cuánto tardaMiles de millones de años desde que se forman hasta que chocanPoco después de la supernova que lo deja
Dónde se esperaríaGalaxias viejas, con estrellas evolucionadasGalaxias jóvenes que forman estrellas
¿Encaja con esta galaxia?No: no ha dado tiempoSí

«Nuestro trabajo sugiere que es muy improbable que esta ráfaga la produjera una fusión», resume Caleb.

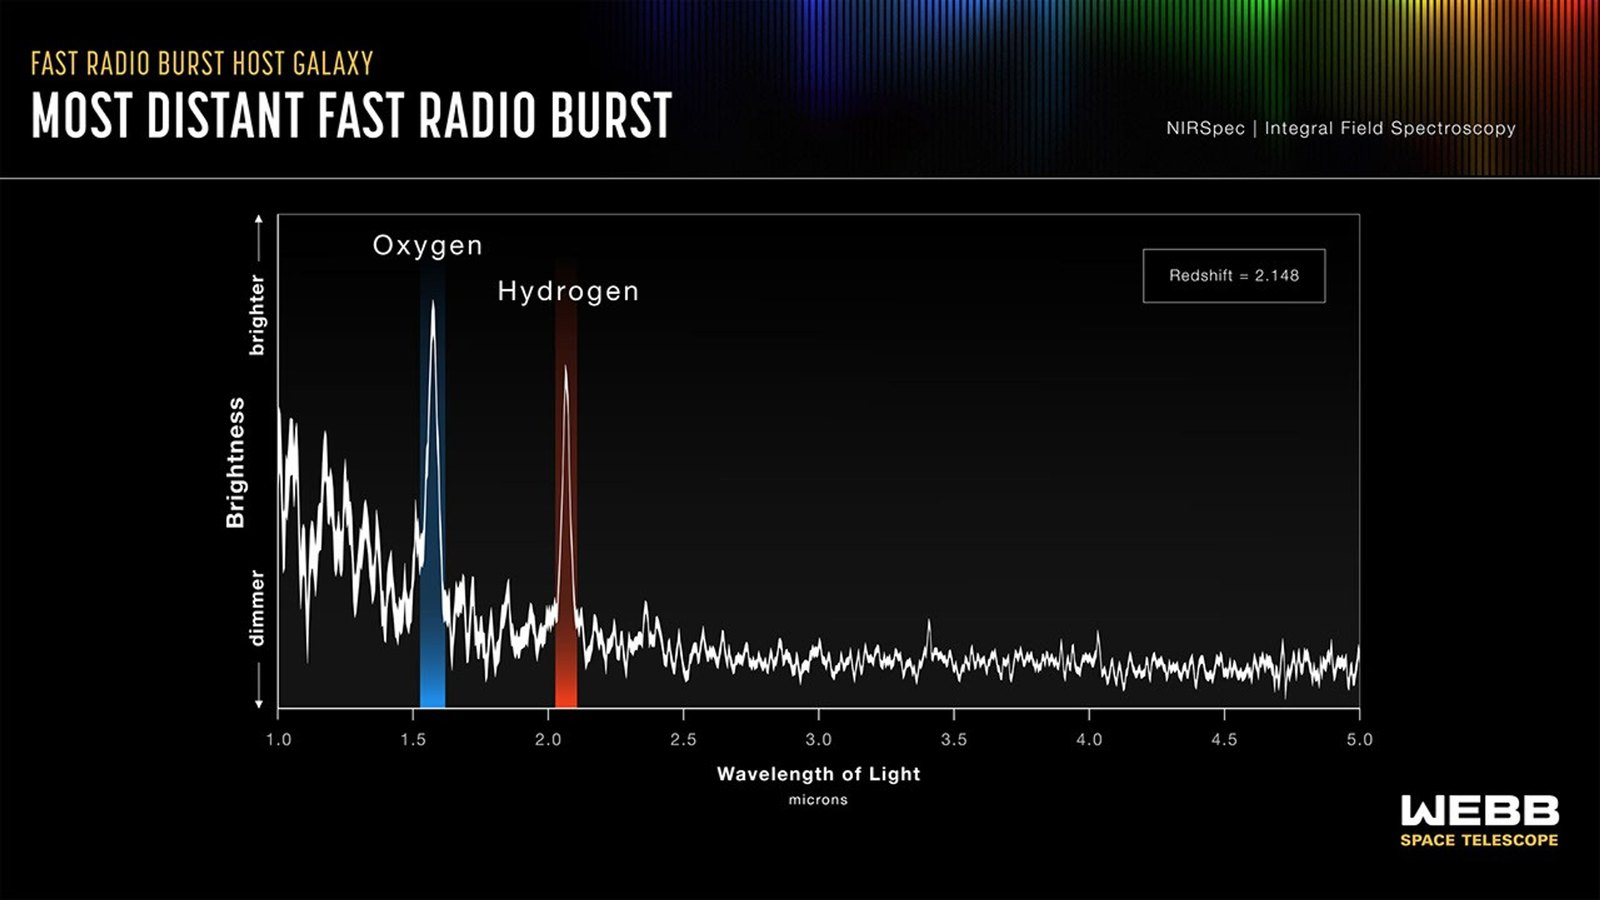
Espectro de NIRSpec de la galaxia anfitriona de la ráfaga más lejana, con las líneas del oxígeno y del hidrógeno y un corrimiento al rojo de 2.148
El espectro de la galaxia tomado con NIRSpec. El eje horizontal es la longitud de onda (en micras) y el vertical, el brillo. Los dos picos son el oxígeno (oxygen) y el hidrógeno (hydrogen). Ilustración: NASA, ESA, CSA, Joseph Olmsted (STScI); ciencia: Manisha Caleb (SIfA).
Cómo se mide la distancia en ese gráfico. El hidrógeno de una galaxia cercana brilla en una longitud de onda de 0.656 micras, que es luz roja. En esta galaxia, ese mismo pico aparece en torno a 2.07 micras, en el infrarrojo. La expansión del universo ha estirado su luz 3.148 veces, y ese factor es justamente 1 + 2.148: el corrimiento al rojo. Por eso hacía falta un telescopio infrarrojo como el Webb, y por eso los telescopios de tierra no la veían.

Por qué importa

Cada galaxia anfitriona que se estudia bien es una prueba más en un debate que lleva casi dos décadas abierto, y esta es especialmente valiosa: por su edad, es difícil de explicar con el choque de dos estrellas de neutrones. Un solo caso no cierra la discusión, pero apunta en una dirección concreta, la de los magnetares.

Además, las ráfagas lejanas sirven para algo más que entenderse a sí mismas. Como explica el coautor J. Xavier Prochaska, de la Universidad de California en Santa Cruz, una ráfaga «es casi como una linterna cósmica: ilumina todo lo que encuentra en su camino». Su señal permite rastrear la llamada red cósmica, la materia y las estructuras que no se ven de otra forma, y en este caso ya ha revelado un cúmulo de galaxias que nadie había detectado.

El equipo calcula que MeerKAT podría detectar y localizar cada año varias ráfagas con un corrimiento al rojo mayor que 1, es decir, de cuando el universo tenía menos de la mitad de su edad actual. Los nuevos radiotelescopios aumentarán ese ritmo, y el Webb será la herramienta para estudiar sus galaxias.

Lo que empezó como un destello de milisegundos captado en Sudáfrica termina como un récord, una galaxia que nadie esperaba y una pista sólida sobre uno de los misterios más persistentes de la astronomía reciente. Para la propia Caleb, lo más llamativo es el azar: la civilización se formó, construimos radiotelescopios «y resulta que miramos a la porción correcta del cielo en el momento justo».

Estudio: Manisha Caleb y otros, Science, 8 de octubre de 2026. Datos contrastados con la Universidad de California en Santa Cruz y la ABC. La portada combina dos imágenes del Webb del comunicado: el campo de galaxias de NIRCam, desenfocado, y la ampliación de la galaxia anfitriona (NASA, ESA, CSA, STScI, Themiya Nanayakkara; procesado de Joseph DePasquale).

Fuente: NASA, «Webb Measures Distance to Farthest Fast Radio Burst, Suggesting Origin»

Muere Margaret Hamilton a los 90 años: la ingeniera que puso nombre al oficio y llevó el software a la Luna

Margaret Hamilton sonriendo tumbada en la maqueta del módulo de mando del Apolo, junto al rótulo Margaret Hamilton 1936-2026

En 1965, cuando el Laboratorio de Instrumentación del MIT contrató a su primera programadora para el proyecto Apolo, el trabajo que iba a hacer no tenía nombre. No había carrera que lo enseñara, ni libros, ni una palabra para distinguirlo de la ingeniería eléctrica de la que colgaba. El software era lo que hacían unas personas en una sala mientras los ingenieros de verdad construían la nave.

Esa programadora se llamaba Margaret Hamilton, tenía 29 años y venía de un camino improvisado: matemáticas en Earlham College, un puesto temporal en el departamento de meteorología del MIT escribiendo programas de predicción con Edward Lorenz —el del efecto mariposa—, y cuatro años en el Lincoln Laboratory programando el prototipo del AN/FSQ-7, el ordenador del sistema de defensa aérea SAGE.

Margaret Hamilton murió el 30 de septiembre de 2026, a los 90 años. El MIT lo anunció el 7 de octubre. Entre aquel puesto temporal y hoy hay una carrera que explica por qué el oficio se llama como se llama.

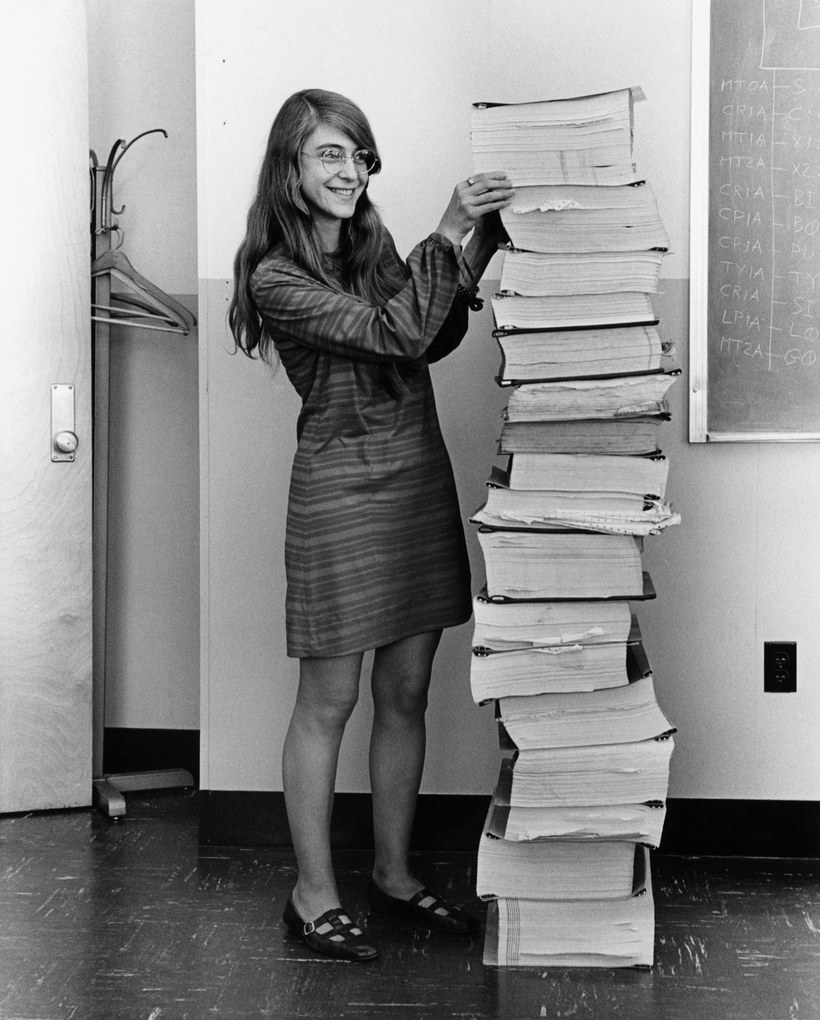
Margaret Hamilton en 1969 de pie junto a una pila de listados impresos del software del Apolo tan alta como ella
La foto que todo el mundo ha visto: Hamilton en 1969 junto a los listados del software que su equipo escribió para el módulo lunar y el de mando. Foto de Draper Laboratory, dominio público; restauración de Adam Cuerden.

Claves de una carrera

  • Paoli, Indiana, 1936. Empezó matemáticas en la Universidad de Michigan en 1955 y se licenció en Earlham College en 1958, con filosofía como asignatura secundaria. Se mudó a Boston en 1959.
  • Lincoln Laboratory, 1961. Programó para la Fuerza Aérea el prototipo del ordenador de SAGE, un sistema de defensa aérea que tenía que responder en tiempo real. Ahí aprendió lo que significa que un programa no pueda pararse.
  • 1965: la primera del Apolo. El Laboratorio de Instrumentación la contrata como primera programadora del proyecto, y es además la primera mujer que programa en él. En 1968 ya era directora adjunta al frente del equipo del módulo de mando y de servicio: más de 400 personas trabajando en el software del Apolo.
  • «No había una segunda oportunidad. Lo sabíamos. Nos tomábamos el trabajo en serio.» Es suya, y resume el método: en un programa que va a ejecutarse una sola vez, a 380.000 kilómetros, no hay versión 1.1.
  • El error de Lauren. Su hija de cuatro años, jugando en el simulador, lanzó el programa P01 —el de prelanzamiento— en pleno vuelo simulado y lo tiró abajo. Hamilton pidió añadir una comprobación que lo impidiera y le dijeron que los astronautas no se equivocan. En el Apolo 8, Jim Lovell lanzó el P01 en vuelo y borró los datos de navegación. Su equipo lo arregló desde tierra, y a partir de ahí la programación defensiva dejó de ser una manía suya.
  • El sistema de prioridades. Diseñó un ejecutivo asíncrono: las tareas no iban en fila, iban por importancia, y el ordenador podía reiniciarse y retomar el trabajo crítico sin perderlo. Es la pieza que hizo posible lo que pasó después.
  • La alarma 1202. Durante el descenso del Apolo 11, el ordenador se saturó y avisó. La causa real fue un documento de interfaz mal cerrado: el radar de encuentro, que se había dejado en espera, tenía su señal de 800 Hz sin sincronizar con la del ordenador y le robaba ciclos. El software soltó las tareas secundarias, se quedó con el guiado y el alunizaje siguió. Un ordenador que se cae en ese momento no deja un informe de fallo: deja un cráter.
  • La máquina con la que se hizo. El ordenador del Apolo trabajaba con palabras de 15 bits más uno de paridad, tenía 2.048 palabras de memoria borrable y 36.864 de memoria fija tejida a mano, iba a 2,048 MHz, pesaba 32 kg y consumía 55 vatios. Toda la memoria de trabajo cabe hoy en una línea de una hoja de cálculo.
  • Le puso nombre al oficio. Empezó a decir «ingeniería de software» para separarlo del hardware y reclamar para él el mismo rango. Según cuenta el MIT, «se consideraba bastante gracioso. Fue un chiste recurrente durante mucho tiempo».
  • Después del Apolo, empresa propia. Fundó Higher Order Software en 1976 y Hamilton Technologies en 1986, y desarrolló el Universal Systems Language, un lenguaje de modelado cuya idea central es la misma de siempre: que el error no se corrija, que no se pueda cometer.
  • Reconocimientos. NASA Exceptional Space Act Award en 2003, con $37,200 USD, la mayor cantidad que la agencia había dado nunca a una sola persona hasta entonces. Medalla Presidencial de la Libertad en 2016: «su arquitectura de software llevó a saltos de gigante para la humanidad», decía la mención. Premio del Computer History Museum en 2017, Intrepid en 2019 y el National Aviation Hall of Fame en 2022.
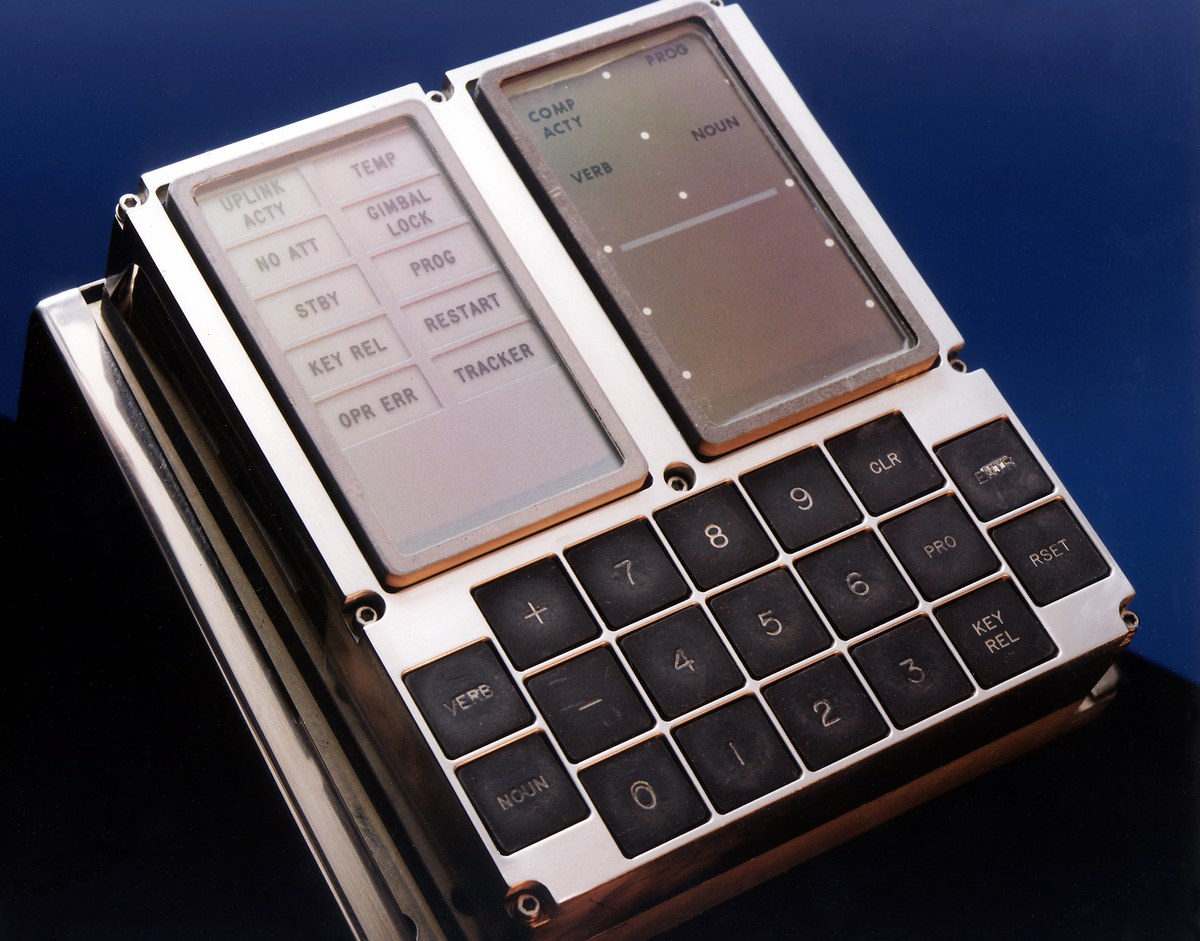
La unidad DSKY del ordenador de guiado del Apolo: teclado numérico, teclas VERB y NOUN y luces de aviso entre las que se ve PROG y RESTART
Así se hablaba con el ordenador del Apolo: dos dígitos de verbo, dos de nombre. Arriba a la izquierda están las luces de aviso, y entre ellas PROG, la que se encendió con la 1202, y RESTART. Foto: NASA / Dennis Taylor, dominio público.

Por qué importa

Es fácil quedarse con la anécdota del alunizaje, y la anécdota es buena. Pero lo que Hamilton dejó no es una hazaña, es una manera de trabajar que hoy damos por supuesta sin saber de dónde viene.

La primera idea es que el error se previene en el diseño, no se parchea después. Cuando pidió proteger el P01 y le contestaron que los astronautas no se equivocan, estaba discutiendo algo que seguimos discutiendo: si el trabajo del programador es cumplir la especificación o hacerse cargo de todo lo que puede salir mal, incluida la persona que está al otro lado. El Apolo 8 zanjó la discusión a su favor.

La segunda es la degradación elegante. Un sistema sobrecargado no tiene que caerse: puede soltar lastre y seguir con lo importante. Eso, que en 1969 era una decisión de diseño peleada, está hoy en el planificador de cualquier sistema operativo en tiempo real, en el backpressure de un servicio web y en el modo degradado de un coche. La alarma 1202 es el ejemplo canónico, y por eso se sigue contando.

Y la tercera es el nombre. Llamar «ingeniería» al software no fue vanidad: fue reclamar presupuesto, método, revisión y responsabilidad para una actividad a la que se trataba como un apaño. Ella lo dijo sin rodeos en 2018: «peleé por dar al software legitimidad, para que a él —y a quienes lo construyen— se le diera el respeto que merece».

Sesenta años después, cuando una empresa cuenta que su cohete vuela con Linux, C++ y un navegador, ese respeto ya no hay que pelearlo. Esa es la diferencia, y tiene nombre y apellidos.

Deja una hija, Lauren —la del error—, un yerno, dos nietos, cuatro bisnietos y tres hermanos.

Sobre las imágenes. Las tres son de dominio público. La de portada es un montaje sobre una foto de la NASA de Hamilton en la maqueta del módulo de mando del Apolo 12, del 24 de noviembre de 1969. La de los listados es de Draper Laboratory, publicada en 1969 sin aviso de copyright, con restauración de Adam Cuerden. La de la DSKY es de NASA / Dennis Taylor: es una unidad del Apolo, fotografiada en 1996 cuando el sistema se reutilizó en el F-8, el primer avión de mando digital.

En decodigo.com: la entrada que le dedicamos en 2016 · el software de vuelo de SpaceX.
Y las fuentes de esta noticia: el obituario del MIT · CNN · las características del ordenador de guiado y la causa de las alarmas 1201 y 1202 · el Smithsonian sobre el premio de la NASA de 2003.

Fuente: «Margaret Hamilton, computing pioneer who led software development for the Apollo program, dies at 90», MIT News, 7 de octubre de 2026.

Boston Dynamics ficha al que construyó Alexa: la robótica más famosa del mundo pone a un jefe de IA al mando

El robot cuadrúpedo Spot, amarillo y negro, caminando sobre un escenario con iluminación azul

Durante treinta años, Boston Dynamics fue la empresa que resolvía lo que nadie sabía resolver. Primero fueron robots que recuperaban el equilibrio de una patada, luego uno que daba volteretas hacia atrás, después un perro mecánico que sube escaleras y un humanoide que corre y salta sin cables. Cada vídeo suyo marcaba el límite de lo que una máquina podía hacer con su cuerpo, y lo marcaba por bastante margen.

El problema es que resolver el cuerpo resultó ser la mitad fácil. Un robot que da volteretas sigue necesitando que alguien le diga qué hacer, y esa parte —mirar una caja desconocida, entender que hay que moverla, decidir cómo agarrarla— llevaba décadas atascada. Lo que la ha desatascado en los últimos tres años no ha salido de la robótica, sino de los modelos de lenguaje y de visión.

Ese es el contexto del movimiento que la empresa anunció ayer.

Boston Dynamics tiene nuevo director desde hoy, y no viene de la robótica. Es Rohit Prasad, que pasó doce años en Amazon construyendo Alexa y, al final, creando la familia de modelos fundacionales Nova. Antes había estado casi catorce años en Raytheon BBN Technologies. El puesto llevaba vacío de pleno derecho desde febrero, cuando Robert Playter se marchó tras treinta años en la casa y seis al frente; la directora financiera, Amanda McMaster, ha cubierto el interinato desde entonces.

La nota de prensa no se esconde sobre el porqué. Jaehoon Chang, vicepresidente de Hyundai Motor Group —dueña de la empresa—, lo resume en una frase: la robótica de Boston Dynamics y «la capacidad demostrada de Rohit para convertir la IA en productos a escala global» son, dice, «una base sólida para construir y escalar la IA física».

Claves del relevo

  • Quién entra. Rohit Prasad, hasta ahora vicepresidente sénior y científico jefe de Alexa e inteligencia artificial general en Amazon. La nota lo presenta como quien «construyó y escaló Alexa» y «creó la familia de modelos fundacionales Amazon Nova».
  • Quién sale. Robert Playter, que anunció su marcha por memorándum interno el 10 de febrero. Treinta años en la empresa, seis como director. No se ha dado ningún motivo, ni entonces ni ahora.
  • Ocho meses de interinidad. Los ha cubierto Amanda McMaster, la directora financiera. Es mucho tiempo sin mando definitivo para una empresa que acaba de empezar a fabricar su producto más ambicioso.
  • Lo que dice el nuevo. «Juntando IA avanzada y robótica podemos construir sistemas inteligentes que creen valor real en entornos del mundo real.» Nótese dónde está el acento: en el producto y en el entorno industrial, no en la investigación.
  • Tres robots en catálogo. Spot, el cuadrúpedo de inspección industrial; Stretch, el que descarga cajas de los contenedores; y Atlas, el humanoide eléctrico, que es la apuesta.

Lo que estaba pasando antes de esto

El nombramiento se entiende mejor con dos fechas delante.

Enero de 2026. Boston Dynamics anuncia que empieza la producción comercial de la versión definitiva de Atlas. Toda la tirada del año está comprometida antes de fabricarse, y los nuevos clientes tendrán que esperar a principios de 2027. Los primeros destinos son el centro de aplicaciones robóticas que Hyundai ha montado en su planta de Georgia —un sitio para aprender a meter el Atlas en una línea de montaje de verdad— y Google DeepMind, con quien se están integrando los modelos Gemini Robotics en el robot. Hyundai, por su parte, habla de fabricar treinta mil robots al año.

Quien firmaba las declaraciones optimistas de ese anuncio era Robert Playter. Un mes después se iba.

Octubre de 2024. La empresa se alía con el Toyota Research Institute para llevar al Atlas los large behavior models, que son a los movimientos lo que un modelo de lenguaje es a las frases: en lugar de programar cada tarea, se entrena una red con demostraciones y acaba encadenando acciones largas por su cuenta. En agosto de 2025 enseñaron el resultado, y el detalle técnico que importa es que un único modelo controla el robot entero, tratando las manos y los pies casi igual. Nadie escribió el código de «agarra esa pieza y camina hasta la estantería».

Dicho de otro modo: la parte de Boston Dynamics que más ha avanzado últimamente no es la mecánica. Es el software que decide.

Por qué importa

Lo fácil es leer esto como una nota de personal. Lo que de verdad dice es dónde está ahora el cuello de botella.

Durante veinte años, el problema de los robots fue el cuerpo: que no se cayeran, que agarraran sin romper, que funcionaran una semana sin un técnico al lado. Boston Dynamics ganó esa carrera por goleada y aun así vendía pocas unidades, porque un robot que hace exactamente lo que le programaste solo sirve donde el entorno no cambia nunca. Esa es la razón de que llevemos décadas viendo demostraciones espectaculares y casi ningún robot en sitios normales.

Lo que ha cambiado es que ahora hay una forma plausible de que la máquina decida sola, y viene de la misma tecnología que escribe texto. Poner al frente al que industrializó Alexa —un producto que no destacaba por su inteligencia, sino por llegar a cien millones de dispositivos— es decir en voz alta que la prioridad ya no es la demostración, sino la unidad vendida.

Y hay una lectura menos cómoda. Boston Dynamics es una empresa admirada que ha ganado poco dinero en toda su historia, comprada primero por Google, luego por SoftBank y desde 2021 por Hyundai. El socio nuevo con el que integra su cerebro, Google DeepMind, es también el de su primer dueño. Un director fichado para «convertir la IA en productos a escala global», tras ocho meses de interinidad y justo cuando arranca la producción, suena a que a alguien se le ha acabado la paciencia con los vídeos virales.

Lo que esto no es

Tres precisiones, porque este tipo de noticia se cuenta mal con facilidad.

No hay ningún anuncio de producto. Lo de ayer es un nombramiento. Atlas sigue donde estaba en enero, Spot y Stretch también, y nada de lo que se ha dicho cambia una fecha.

No se sabe por qué se fue Playter. Ni la empresa ni él lo han explicado. Todo lo que se escriba sobre discrepancias o presiones es especulación, y por eso aquí no está.

Y que la IA decida no significa que el robot ya sirva. Los large behavior models funcionan en demostraciones cuidadas; que aguanten un turno completo en una fábrica, con ruido, polvo y piezas que llegan torcidas, está por ver. Es exactamente el mismo salto que separa a un asistente de voz que entiende el 95 % de las frases de uno que te resuelve el día.

Con esas reservas, el movimiento es coherente y vale la pena anotarlo. La empresa que durante treinta años demostró que un robot puede moverse como un animal acaba de contratar a alguien cuyo mérito es haber puesto software en cien millones de aparatos. Dice bastante sobre qué parte del problema queda por resolver.

Sobre la imagen de portada. Es un montaje sobre una foto de Spot en el Centre Stage del Web Summit 2025, tomada en Lisboa el 12 de noviembre de 2025 por Lukas Schulze / Web Summit vía Sportsfile y publicada bajo CC BY 4.0. Se ha recortado y oscurecido por la izquierda para que se lea el titular.

Más sobre robots humanoides en decodigo.com: Figure Helix 2.5, un humanoide probando tareas en casas que no conoce · LeRobot y el Unitree G1, programar un humanoide con herramientas abiertas.
Y las fuentes de esta noticia: The Robot Report sobre el nombramiento · TechCrunch sobre la marcha de Playter · The Register sobre el inicio de producción de Atlas · la alianza con el Toyota Research Institute.

Fuente: «Boston Dynamics Appoints Rohit Prasad as Chief Executive Officer», nota de prensa de Boston Dynamics del 6 de octubre de 2026, con efecto el día 7.

mold 3.0: el enlazador más rápido de Linux se reescribe en Rust y va a por el puesto de GNU ld

De todos los pasos que hay entre el código y un programa que funciona, el último es el que menos atención recibe y el que más suele hacer esperar. El compilador traduce cada archivo por separado, y después el enlazador tiene que coser todas esas piezas —más las bibliotecas— en un único ejecutable: resolver cada símbolo, colocar cada sección, ajustar cada dirección. Es un trabajo que no se puede repartir fácilmente y que hay que rehacer entero cada vez que cambias una línea.

En proyectos grandes eso se nota. Enlazar un navegador o una biblioteca de aprendizaje automático con el enlazador clásico de GNU puede llevar decenas de segundos, cada vez, al final de cada compilación. Ese es el hueco que vino a ocupar mold, que escribió Rui Ueyama partiendo de cero. No es un recién llegado al asunto: Ueyama es el autor original de lld, el enlazador de LLVM, y empezó mold precisamente porque se topó con límites de diseño que ya no podía arreglar optimizando aquel.

El resultado es, con diferencia, el enlazador más rápido que hay para Linux. Y aun así, la inmensa mayoría de las distribuciones siguen trayendo GNU ld como /usr/bin/ld. «Me parece una situación desafortunada para la comunidad de Linux», dijo Ueyama en septiembre, asumiendo parte de la responsabilidad.

El 5 de octubre de 2026 publicó la versión con la que pretende cambiarlo. Y lo primero que ha hecho ha sido tirar el código y volver a escribirlo.

mold 3.0 es la primera versión escrita en Rust. La 2.42.1, del 11 de septiembre, fue la última del código en C++. No es una bifurcación ni un experimento paralelo: es la rama principal, y se presenta como sustituto directo de la anterior. Mismas opciones de línea de órdenes, mismas arquitecturas, misma salida salvo las correcciones de errores, y —esto es lo que no era evidente— la misma velocidad: «el rendimiento al enlazar sigue a la par con 2.42.1», dicen las notas de la versión.

Lo interesante es que la reescritura no es el objetivo. Es el medio.

Claves de mold 3.0

  • Escrito entero en Rust. Requiere Rust 1.95 o posterior y un compilador de C. Se construye con Cargo en vez de CMake.
  • Una dependencia menos. Ya no necesita oneTBB, la biblioteca de paralelismo de Intel; el paralelismo lo resuelve ahora con las herramientas del propio Rust. Sigue enlazando estáticamente mimalloc 3.5.3 como reservador de memoria.
  • Sustituto directo de la 2.42.1. Acepta las mismas opciones y produce la misma salida. El equipo pasó la batería de pruebas en todas las arquitecturas soportadas y no encontró regresiones.
  • Sin coste en velocidad. El rendimiento se mantiene igual que en la última versión en C++, que es lo que había que demostrar: una reescritura que fuera más lenta no habría servido de nada.
  • El objetivo de la serie 3.x es cerrar lo que falta para ser compatible con GNU ld, y muy en concreto el soporte de linker scripts.
  • Licencia MIT, como la 2.x.

Las cifras

De la tabla de pruebas del propio proyecto, medida en 2026 sobre un Threadripper 7980X y en compilación de depuración, que es el caso que de verdad importa porque es el que repites cien veces al día:

Programamoldlld
Blender0,86 s4,72 s5,5×
Chromium1,65 s16,64 s10,1×
TensorFlow3,15 s50,73 s16,1×

Y conviene leer bien contra quién se compara: lld, el enlazador de LLVM, que ya es bastante más rápido que GNU ld. Los cincuenta segundos de TensorFlow son con el rival bueno.

Por qué importa

Lo primero es lo evidente: medio minuto de espera al final de cada compilación no es solo tiempo perdido, es tiempo en el que te vas a otra cosa y pierdes el hilo. Un ciclo de tres segundos y uno de cincuenta producen formas distintas de trabajar.

Pero lo segundo es más importante, y es el motivo real de esta versión. Casi nadie cambia su enlazador. Hay que saber que existe la alternativa, saber que se puede cambiar y saber cómo; la mayoría de la gente que compila software en Linux usa lo que venga puesto. Por eso Ueyama no quiere que mold sea una opción que instalas: quiere que sea /usr/bin/ld.

Y ahí está el obstáculo técnico que explica todo lo demás. Para ser el enlazador del sistema no basta con enlazar programas de usuario: hay que poder enlazar también el núcleo, los cargadores de arranque y el software empotrado, y todo eso depende de los linker scripts, unos archivos que describen al detalle cómo colocar cada sección en memoria. GNU ld los soporta por completo. mold, todavía no del todo. Cerrar esa distancia es, literalmente, el propósito declarado de la serie 3.x.

¿Y por qué reescribirlo en Rust justo ahora, antes de esa tarea? Ueyama lo atribuye a las garantías de seguridad del lenguaje y a otras comodidades que le resultan útiles como desarrollador principal. Dicho de otro modo: no es un cambio pensado para el usuario, sino para quien tiene por delante años de mantener y extender un programa muy concurrente y muy manipulador de memoria.

Rust ya está en los cimientos de Linux

mold no es un caso aislado. Es una pieza más de un movimiento que lleva un tiempo ocurriendo por debajo, y que este último año ha dejado de ser una promesa.

En el núcleo. El 12 de diciembre de 2025, Miguel Ojeda envió a la lista del kernel un parche con un título que lo resume: «rust: conclude the Rust experiment». No añadía ninguna funcionalidad; quitaba dieciocho líneas de documentación, las que avisaban de que el soporte de Rust era experimental y que ningún controlador en Rust servía para producción. «En la cumbre de mantenedores de 2025 el experimento acaba de darse por concluido», explicaba el mensaje. «El experimento ha terminado, es decir: Rust se queda.»

No es una declaración simbólica. Hay controladores en Rust funcionando y en la lista del propio proyecto Rust for Linux: el Binder de Android —que va en millones de teléfonos—, el controlador de GPU Nova para hardware de NVIDIA, Tyr para las GPU Mali de Arm, el controlador de dispositivo de bloques nulo, y controladores de red PHY.

En el espacio de usuario. Ubuntu 25.10 fue la primera versión que puso por omisión uutils, la reimplementación en Rust de las utilidades básicas —ls, cat, cp y compañía—, junto con sudo-rs en lugar del sudo de toda la vida. En la 26.04 LTS la transición se frenó a propósito: cp, mv y rm se quedaron en sus versiones GNU porque una auditoría externa encontró problemas de tipo TOCTOU en las implementaciones nuevas. Esos tres son los que faltan, y Ubuntu 26.10 —que sale el 15 de octubre— está previsto que complete el cambio.

Ese episodio merece subrayarse, porque es el contrapeso honesto de toda esta historia: escribir algo en Rust no lo hace correcto. Evita una familia concreta de errores, la de memoria; no evita que una comprobación se haga en el momento equivocado.

En las herramientas. mold tampoco es el único enlazador nuevo en Rust. wild, de David Lattimore, persigue un objetivo distinto: ser rápido en el desarrollo iterativo, y a la larga hacer enlazado incremental, rehacer solo la parte que cambió en vez del ejecutable entero. Eso último todavía no está implementado, según su propia documentación, y aun así ya es lo bastante rápido como para que las pruebas de mold lo incluyan entre los rivales a los que medirse. El proyecto lo respalda el Rust Innovation Lab de la Fundación Rust.

Lo que esto no es

Tres precisiones, porque este tipo de noticias se cuenta mal con facilidad.

mold 3.0 todavía no enlaza el kernel de Linux. Poder hacerlo es el objetivo de la serie 3.x, no algo que esta versión traiga ya resuelto. Lo que se ha publicado es la misma funcionalidad de antes, sobre una base nueva.

No hace tus programas más seguros. Un fallo de memoria en un enlazador produce un binario roto o un enlazador que se cae, no una vulnerabilidad en el programa que estás compilando. El beneficio de Rust aquí es para quien mantiene mold, no para quien lo usa.

Ninguna distribución ha anunciado el cambio. Que mold aspire a ser el enlazador por omisión no significa que vaya a serlo. Eso se decide distribución por distribución, y pasa por convencer a gente que tiene buenas razones para ser conservadora con una pieza de la que depende absolutamente todo lo demás.

Con esas tres salvedades, lo que queda sigue siendo notable. Un programa de sistema, de los de verdad, de los que están debajo de todo lo demás, ha cambiado de lenguaje sin perder un ápice de rendimiento y sin que sus usuarios tengan que tocar nada. Hace cinco años ese era el argumento que se usaba para decir que no se podía hacer.

Más referencias sobre Rust en Linux: «rust: conclude the Rust experiment», de Miguel Ojeda (LKML, 12 de diciembre de 2025) · Rust for Linux, con la lista de controladores en el núcleo · Phoronix sobre el fin del experimento · documentación de sudo-rs en Ubuntu · OMG! Ubuntu sobre el final de la transición a uutils · wild, el otro enlazador en Rust · Phoronix sobre el anuncio de la reescritura.

Fuente: notas de la versión mold 3.0.0 (5 de octubre de 2026) y el repositorio de mold, de donde salen las cifras de las pruebas.

El cohete vuela con Linux, C++ y un navegador web: lo que SpaceX ha contado de su software

Interior de una cápsula Crew Dragon con dos astronautas, junto al titular sobre el software de vuelo de SpaceX

El software que lleva a una persona al espacio tiene fama de ser una cosa aparte: lenguajes raros, procesadores endurecidos contra la radiación que cuestan una fortuna, sistemas operativos de tiempo real diseñados para aviones y décadas de certificación. Durante mucho tiempo fue exactamente así, y en buena parte de la industria lo sigue siendo.

SpaceX lo hace de otra manera, y lo ha contado. No hay código abierto ni documentación oficial, pero su equipo de software se ha sentado tres veces a responder preguntas en abierto —en 2013, en 2015 y sobre todo en junio de 2020, unos días después del primer vuelo tripulado de la Crew Dragon—, y de ahí sale casi todo lo que se sabe. Esto es lo que dijeron, y lo que conviene no dar por cierto.

Claves

  • Sistema operativo: Linux. No un sistema de tiempo real clásico, sino un Linux poco modificado con los parches PREEMPT_RT, con núcleo y cadena de herramientas propios.
  • Lenguajes: C++ para el software de vuelo, Python para las pruebas y HTML, CSS y JavaScript para las pantallas de la Crew Dragon.
  • Sí, un navegador: esas pantallas las dibuja Chromium, el mismo motor que hay debajo de Chrome. Solo dibuja; no pilota.
  • Nada de silicio especial: componentes comerciales corrientes en vez de procesadores endurecidos, y la radiación se compensa con el diseño del sistema.
  • Triple redundancia: cada decisión se calcula tres veces y se vota antes de emitirla.
  • Un equipo pequeño: unas 35 personas en 2013 y en torno a 50 hacia 2019 para todo el software de vuelo de todos los vehículos.

Cómo se toma una decisión a bordo

Esta es la parte interesante, y la que explica por qué se pueden usar procesadores de los que lleva cualquier portátil. En vez de comprar un chip carísimo que aguante la radiación, SpaceX asume que un chip corriente va a equivocarse de vez en cuando y monta el sistema para que una equivocación no llegue a ninguna parte.

El esquema de redundancia triple con el que el Falcon 9 toma cada decisiónCómo se toma una sola decisión a bordo del Falcon 9hilo de vuelo 1núcleo 1núcleo 2¿coinciden?si no, no emite nadahilo de vuelo 2núcleo 1núcleo 2¿coinciden?si no, no emite nadahilo de vuelo 3núcleo 1núcleo 2¿coinciden?si no, no emite nadael controlador compara los tressi uno discrepa, hace caso al que venía acertandola orden sale al motorProcesadores comerciales corrientes: la radiación se compensa con el diseño, no con silicio especial

El mecanismo se conoce como actor-juez. Hay tres «hilos de vuelo» independientes, cada uno con dos núcleos que ejecutan lo mismo. Un hilo solo emite una orden si sus dos núcleos coinciden; si discrepan, calla. Después, el controlador que recibe las órdenes compara los tres hilos: si los tres dicen lo mismo, adelante; si uno se sale, se hace caso al que venía acertando y se ignora al discrepante.

Los motores Merlin del Falcon 9 llevan su propia versión del mismo reparto: tres ordenadores que votan, cada uno con dos procesadores que se vigilan entre ellos.

Por qué esto importa más de lo que parece. Un procesador endurecido contra la radiación suele ir una década por detrás en potencia de cálculo, porque el proceso de fabricación que lo hace resistente es antiguo. Resolver la fiabilidad con arquitectura en vez de con silicio deja usar piezas actuales, baratas y potentes. Es la misma decisión de fondo que hace que un Falcon 9 cueste lo que cuesta.

Qué corre dónde

Las capas del software de un vehículo de SpaceXLas capas, de lo que ve el astronauta a lo que hay debajoPantallas de la Crew Dragoncon botones físicos de respaldoHTML · CSS · JavaScript, dibujado por ChromiumSoftware de vuelolo que de verdad pilota; Chromium no entra aquíC++Sistema operativonúcleo y cadena de herramientas propiosLinux con los parches PREEMPT_RTProcesadortriple redundancia en lugar de silicio especialcomponentes comerciales, no endurecidosNada de esto es código público: sale de lo que el propio equipo ha contado en abierto

La capa de arriba es la que dio que hablar. Cuando los astronautas de la Demo-2 pilotaron la cápsula con pantallas táctiles, resultó que lo que veían era HTML y JavaScript dibujados por el mismo núcleo que hay debajo del navegador Chrome. SpaceX usa Chromium únicamente como motor de dibujo, con una biblioteca reactiva propia encima, y lo mantiene aislado del resto: según el equipo, una pestaña colgada no se lleva por delante la cápsula. Y hay botones físicos de respaldo para lo esencial.

Debajo, lo que de verdad vuela la nave es C++ sobre Linux, y ahí Chromium no entra.

Starlink juega con otras reglas

Lo más revelador de la sesión de 2020 fue la comparación entre las dos mitades de la casa, porque enseña que no hay «una» manera de hacer software en SpaceX, sino dos muy distintas según lo que pase si algo falla.

Crew DragonStarlink
Qué pasa si falla unoEs una pérdida de misiónPerder un satélite no es una pérdida de misión
Ritmo de cambiosEl código se congela meses antes del vueloActualizaciones aproximadamente semanales
Forma de trabajarVerificación exhaustiva antes de volarIteración rápida, «como armarios de servidores en un centro de datos»

De esa diferencia sale un detalle que resume bien la escala: los satélites Starlink recién lanzados suelen llegar a órbita con el código ya atrasado respecto al resto de la constelación, porque entre que se cargó y que llegaron arriba el software ha seguido avanzando. En 2020 el equipo hablaba de más de treinta mil nodos Linux en órbita y más de seis mil microcontroladores.

Esa misma constelación es la que Starship empezó a desplegar en su primer vuelo orbital, y es también la razón de que la cifra no pare de crecer.

Lo que circula y no está claro

Buena parte de lo que se lee sobre este asunto son relatos de segunda mano de aquellas sesiones, y por el camino se han colado cosas que conviene marcar.

Se dice que…Qué pasa con eso
Los procesadores son x86Es lo que repiten la mayoría de fuentes, pero el relato de una charla en la GDC habla de tres procesadores ARM de doble núcleo en placas propias. No hay una declaración oficial que lo zanje
Usan VxWorksChoca de frente con lo que el propio equipo dijo en 2020 sobre Linux y PREEMPT_RT. Aparece en algún resumen y no en las fuentes directas
Certifican según la norma DO-178BNo he encontrado ninguna fuente primaria. Es una norma del mundo aeronáutico, no del lanzamiento espacial comercial
El simulador de atraque de su web lleva el código realEl equipo lo desmintió expresamente: no es el mismo código que vuela en la Crew Dragon
Y una cosa que no es menor: las pantallas de la sala de control de Hawthorne, las que salen en las retransmisiones, están hechas con LabVIEW. Es software de instrumentación industrial, no de vuelo, pero sirve de recordatorio de que «el software de SpaceX» son en realidad muchos programas distintos con requisitos muy diferentes.

Por qué importa

Importa porque desmonta una idea muy extendida: que el software crítico exige herramientas exóticas. Aquí hay un vehículo tripulado volando con el mismo núcleo que corre en cualquier servidor y con el mismo lenguaje que se usa para escribir videojuegos. La diferencia no está en las piezas, está en cómo se combinan: la fiabilidad la aporta la arquitectura —tres cálculos y una votación—, no la etiqueta del componente.

Importa también porque enseña que el nivel de rigor se elige según lo que cuesta un fallo, y no de manera uniforme. El mismo equipo congela el código de una cápsula durante meses y despliega en la constelación cada semana. Esa es una decisión de ingeniería deliberada, no una incoherencia, y es trasladable a cualquier proyecto en el que convivan partes que no pueden fallar con partes que pueden reintentarse.

Y conviene cerrar con la advertencia que atraviesa todo lo anterior: esto no es documentación, son declaraciones. Son respuestas en un foro, sin referencias, algunas ya con años encima y sin forma de contrastarlas. Lo mejor que se puede decir de ellas es que vienen del propio equipo; lo peor, que es lo único que hay.

Sobre la imagen de portada. Es una fotografía de archivo del interior de una Crew Dragon, con Robert Behnken y Douglas Hurley antes de la misión Demo-2, tomada en marzo de 2020. No tiene relación directa con el software del que habla el artículo, más allá de ser la nave cuyas pantallas se mencionan. Fotografía de SpaceX, bajo dominio público (CC0), vía Wikimedia Commons.

Fuentes: las sesiones de preguntas del equipo de software de SpaceX en Reddit (2013, 2015 y junio de 2020, recogida por Hackaday), InfoQ sobre el uso de JavaScript en la Dragon, la ficha del Falcon 9 v1.0 en Wikipedia para la aviónica y el hilo de Hacker News sobre el ordenador de vuelo.