
DeepSeek, el laboratorio chino de IA conocido por publicar sus modelos con pesos abiertos, ha lanzado DeepSeek-V4.1-Flash-1017. Es una revisión de V4.1-Flash, el modelo que presentó hace cinco semanas, y según la empresa mejora en casi todas sus pruebas, termina antes las tareas y escribe respuestas más cortas, con el mismo precio en la API. Los pesos, otra vez, se pueden descargar con licencia MIT.
V4.1-Flash salió el 10 de septiembre como el modelo más pequeño de una nueva familia de arquitectura. Es un modelo de mezcla de expertos (mixture of experts): tiene 552,000 millones de parámetros, pero cada token solo activa una parte, unos 8,000 millones al leer y 16,000 millones al escribir. Entiende imágenes de forma nativa y DeepSeek lo presentó con resultados por encima de su propio modelo grande, V4-Pro. Desde entonces es el que atiende el nombre deepseek-flash de su API, y hace unos días DeepSeek liberó también DeepInfer, el motor de inferencia con el que lo sirve.
La nueva versión, fechada el 17 de octubre (de ahí el «1017»), no cambia de arquitectura. DeepSeek la llama una «actualización menor» y la presenta como una mejora de Pareto: más rendimiento y menos coste a la vez. Ya funciona en la web, en la app y en la API, donde sustituye a la anterior sin que haya que cambiar nada: deepseek-flash pasa a servir la versión 1017 con las mismas tarifas.
Claves de V4.1-Flash-1017
- Más tareas de programación resueltas. En DeepSWE v1.1, una prueba de arreglar fallos en repositorios reales, pasa del 74.2 % al 77 %. En la misma tabla, Claude Opus 5 marca un 74 % y GPT-5.6 Sol un 73 %.
- Grandes saltos en tareas de agente. En Terminal-Bench 4.0, que mide el trabajo en una terminal, sube de 31.2 a 42.3; en ProgramBench, de 20.3 a 29.1, y en Apex Bench v1.1, de 64.6 a 72.1.
- Más rápido y más breve. Termina las tareas en menos tiempo y escribe menos tokens, lo que abarata cada tarea. DeepSeek no ha dado porcentajes de esa mejora.
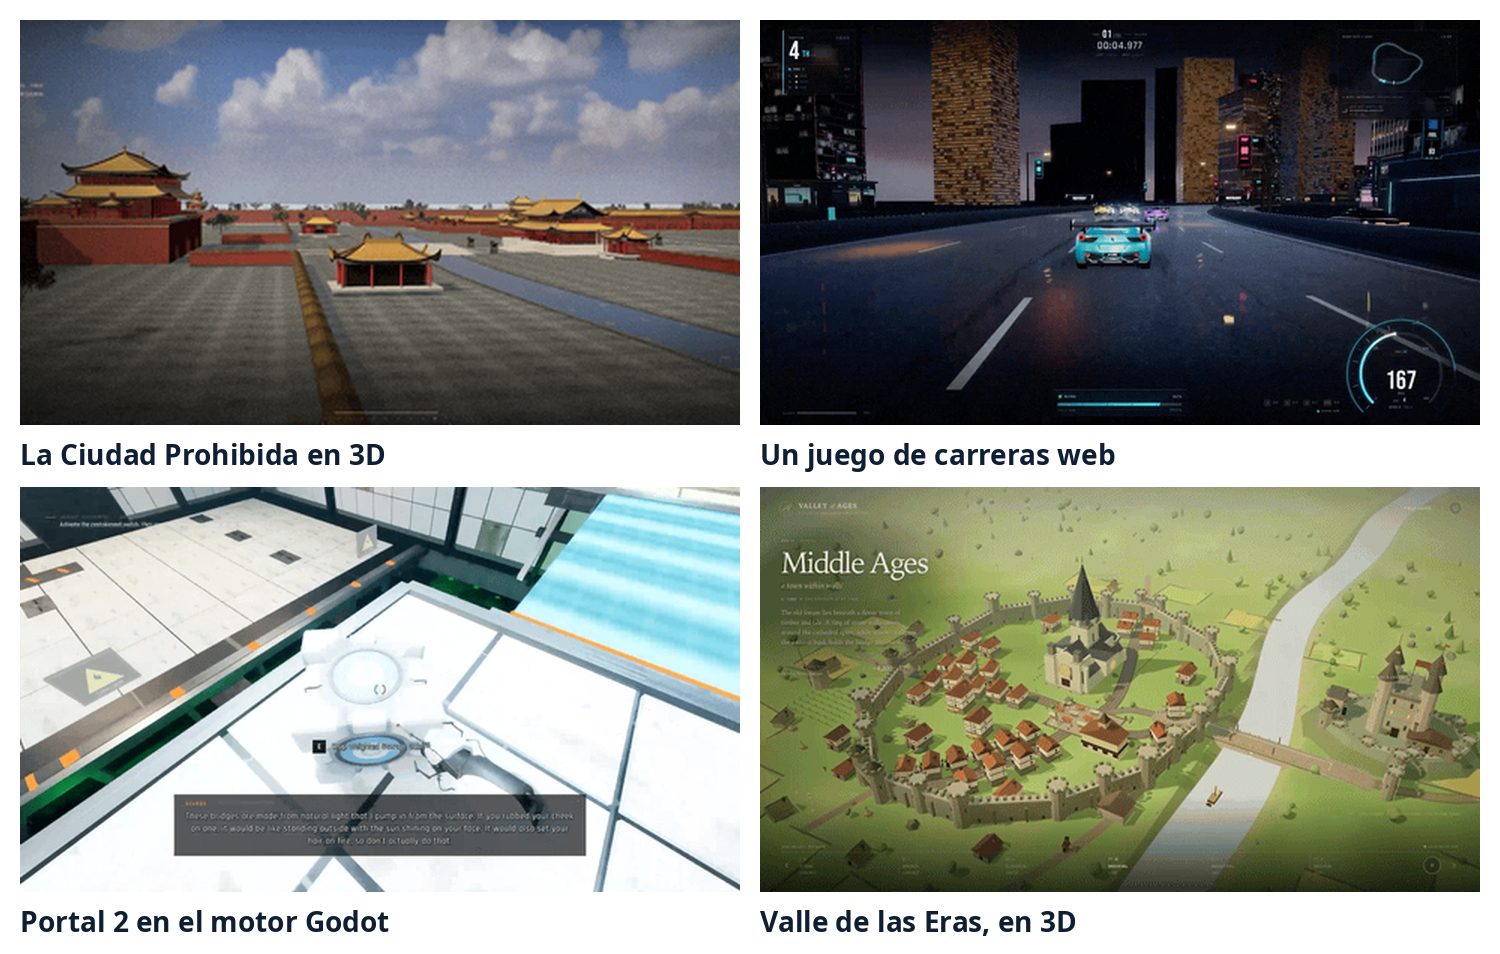
- Proyectos completos. Se entrenó con aprendizaje por refuerzo con autoevaluación (el modelo revisa su propio trabajo) para crear proyectos de principio a fin, desde juegos hasta modelos 3D.
- Pesos abiertos. Se descargan de Hugging Face y ModelScope con licencia MIT, con contexto de 1 millón de tokens. Se puede servir con vLLM, SGLang o Docker Model Runner.
- Pensado para agentes. Viene ajustado para DeepSeek Harness, su herramienta para crear agentes (en vista previa para desarrolladores, desde la versión 0.2.1-rc.1), y para dos productos de Tencent: el asistente de código CodeBuddy y el agente de oficina WorkBuddy.
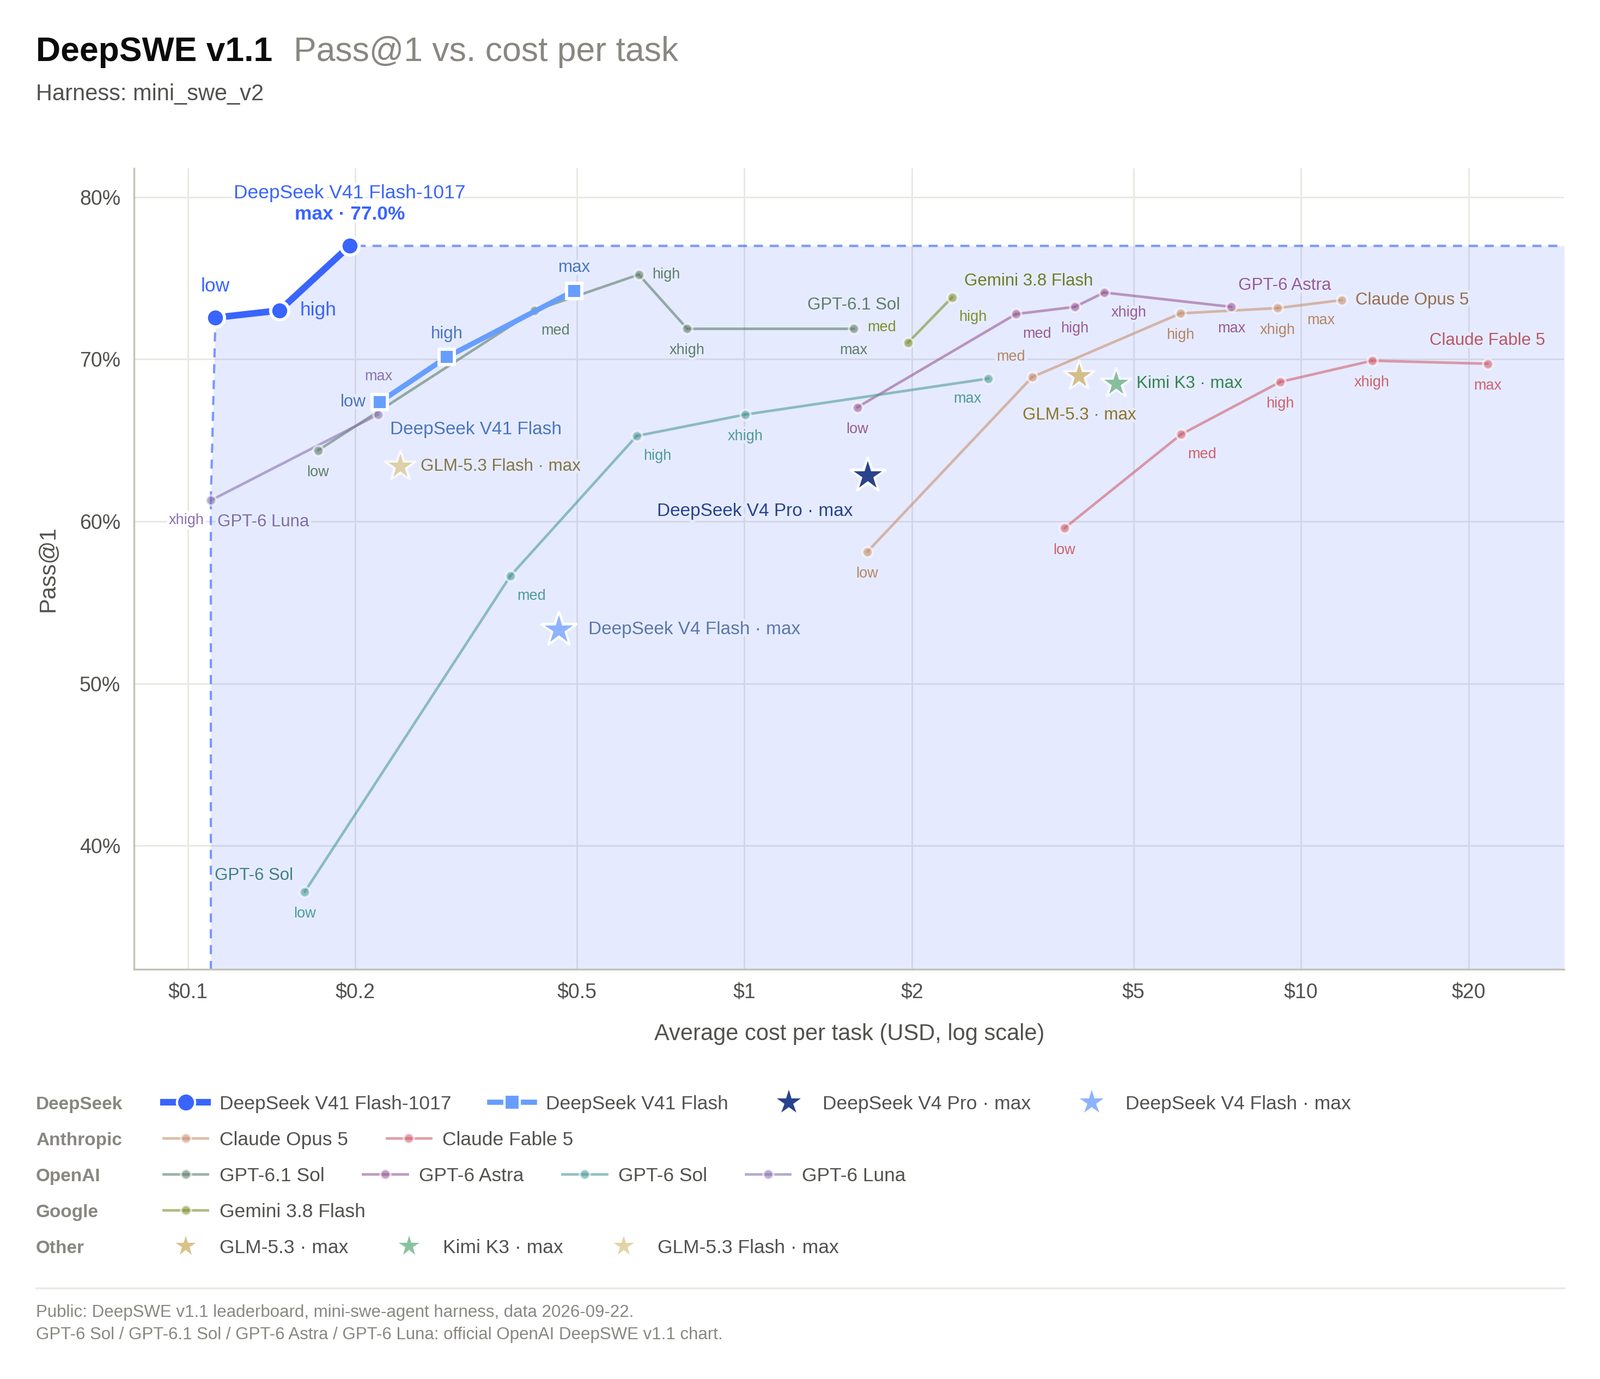
La gráfica resume el argumento de DeepSeek: no promete el mejor modelo del mundo, sino el que más resuelve por cada dólar. Las cifras, eso sí, son de sus propias pruebas. Y no gana en todo: de las 11 pruebas que publica, Claude Opus 5 queda por delante en 7. La mayor distancia está en Humanity’s Last Exam sin herramientas, una batería de preguntas de nivel experto, donde Opus 5 saca 56.3 y V4.1-Flash-1017, 42.6. Donde DeepSeek gana es en las pruebas de agente: DeepSWE, Automation-Bench (60.5 contra 50.3), Agents’ Last Exam y Apex Bench.
Con el modelo llega otra novedad: las API de búsqueda y lectura de páginas web (Search y Fetch) quedan abiertas a todo el mundo. Funcionan con el buscador propio de DeepSeek, que según la empresa atiende cientos de millones de consultas al día. Search devuelve hasta 50 resultados por consulta y Fetch convierte una página en texto. Cada una cuesta $0.75 USD por cada 1,000 llamadas, y solo se cobran las que devuelven resultados. Usadas desde DeepSeek Harness, Claude Code o Codex son gratis para los clientes de su API hasta el 31 de octubre a las 16:00 UTC; los detalles están en su guía.
Qué gana quien programa con agentes
Los agentes de programación gastan muchos tokens: leen archivos, prueban, se equivocan y vuelven a intentarlo. Por eso el coste por tarea pesa tanto como la nota en una prueba, y ahí está la apuesta de DeepSeek. Un modelo que resuelve lo mismo que los grandes por una fracción del precio, y que además termina antes y escribe menos, abarata justo el trabajo que más está creciendo. Que se pueda conectar a Claude Code o a Codex, y que su búsqueda web sea gratis desde esas herramientas durante unos días, apunta al mismo público.
Los pesos abiertos añaden otra ventaja: quien no quiera mandar su código a un servidor en China puede ejecutar el modelo en sus propias máquinas, o contratarlo a otro proveedor. Eso sí, no es un modelo para un ordenador de casa: con 552,000 millones de parámetros necesita varias GPU de centro de datos, aunque la comunidad ya ha publicado versiones comprimidas para llama.cpp, Ollama o LM Studio.
La otra cara es la capacidad. Según SiliconANGLE, la API de DeepSeek se cayó casi cinco horas el 15 de octubre, una de sus peores caídas del año; la empresa se disculpó, compensó a los clientes con crédito y prometió quitar puntos únicos de fallo. Responder más corto y más deprisa también le ayuda a atender a más gente con los mismos chips.
V4.1-Flash-1017 no es un salto de generación, sino un ajuste rápido, cinco semanas después del lanzamiento, que mejora la relación entre lo que resuelve y lo que cuesta. Falta que pruebas independientes confirmen sus cifras, y DeepSeek todavía tiene pendiente V4.1-Pro, la versión grande de la familia, que su API anunció en septiembre sin fecha.
Datos de la nota de DeepSeek del 17 de octubre, de la ficha del modelo en Hugging Face (tabla de pruebas, licencia y contexto), del anuncio de V4.1-Flash (arquitectura y parámetros) y de la guía de Search y Fetch. La caída del 15 de octubre, según SiliconANGLE. Las puntuaciones son de las pruebas de DeepSeek.
Fuente: DeepSeek, «DeepSeek-V4.1-Flash-1017: Wish-Driven Programming Made Real»