
Google presentó el 12 de noviembre Gemini 4 Hydrogen, el modelo rápido y económico de su nueva familia Gemini 4, hecho para agentes de IA y para el trabajo de todos los días. Desde ese mismo día responde en el Buscador de Google para todos los usuarios del mundo, está en la app de Gemini y los desarrolladores lo pueden usar en AI Studio, la API y Antigravity por $1.50 USD por millón de tokens de entrada y $7.50 USD por millón de salida. Según Google, termina las tareas 2.5 veces más rápido que Gemini 3.8 Flash, el modelo al que reemplaza, e inventa datos más de cinco veces menos.
Es el tercer modelo de la familia en un mes. El 13 de octubre llegó Gemini 4 Argon, abierto a desarrolladores y suscriptores de pago, y el 28 de octubre Gemini 4 Carbon, su modelo más potente, que primero se limitó a equipos de ciberseguridad. Los dos son modelos de frontera, para razonar a fondo sobre problemas difíciles, y cuestan más. Hydrogen ocupa el lugar que tenía la línea Flash: el modelo que se usa a diario y en grandes volúmenes, y el primero de la generación 4 que llega a todo el público.
Claves de Gemini 4 Hydrogen
- Para ejecutar, no para planear. Google lo describe como un modelo de ejecución rápida: escribir código, correr pruebas, revisar cambios, investigar y analizar datos. Puede trabajar solo o como el «brazo» de Carbon y Argon, que se quedan con las decisiones de arquitectura y los errores difíciles.
- Más listo que Argon en una medición. En el índice de Artificial Analysis, que promedia varias pruebas, saca 51 puntos con su ajuste predeterminado, uno más que Argon, y 54 con el máximo. En Terminal-Bench 4.1, que mide tareas en la terminal, resuelve 57 % contra 18.2 % de Gemini 3.8 Flash.
- Más rápido y con menos invenciones. Comparado con 3.8 Flash, termina las tareas 2.5 veces más rápido y reduce más de cinco veces las afirmaciones inventadas, las llamadas alucinaciones. En pruebas de clientes con grafos, SQL y datos empresariales fue de 2 a 2.8 veces más rápido y gastó de 12 % a 23 % menos tokens. Son cifras de Google, todavía sin pruebas independientes.
- Cuatro niveles de razonamiento. low, medium, high (el predeterminado) y uno nuevo, xhigh, para elegir cuánto «piensa» antes de responder y, con eso, cuánto tarda y cuánto cuesta.
- Un millón de tokens. Acepta un millón de tokens de entrada, con texto, imágenes, audio, video y PDF, y puede generar respuestas largas de hasta un millón de tokens. El precio es el mismo en toda esa ventana, sin tarifa más cara para documentos largos.
- Más cuidadoso como agente. Google asegura que, frente a 3.8 Flash, hace hasta 81 % menos cosas que no se le pidieron, es hasta dos veces menos propenso a saltarse permisos cuando una tarea está bloqueada y resiste 2.3 veces mejor la inyección indirecta de prompts, las instrucciones escondidas en páginas o archivos que intentan desviar a un agente.
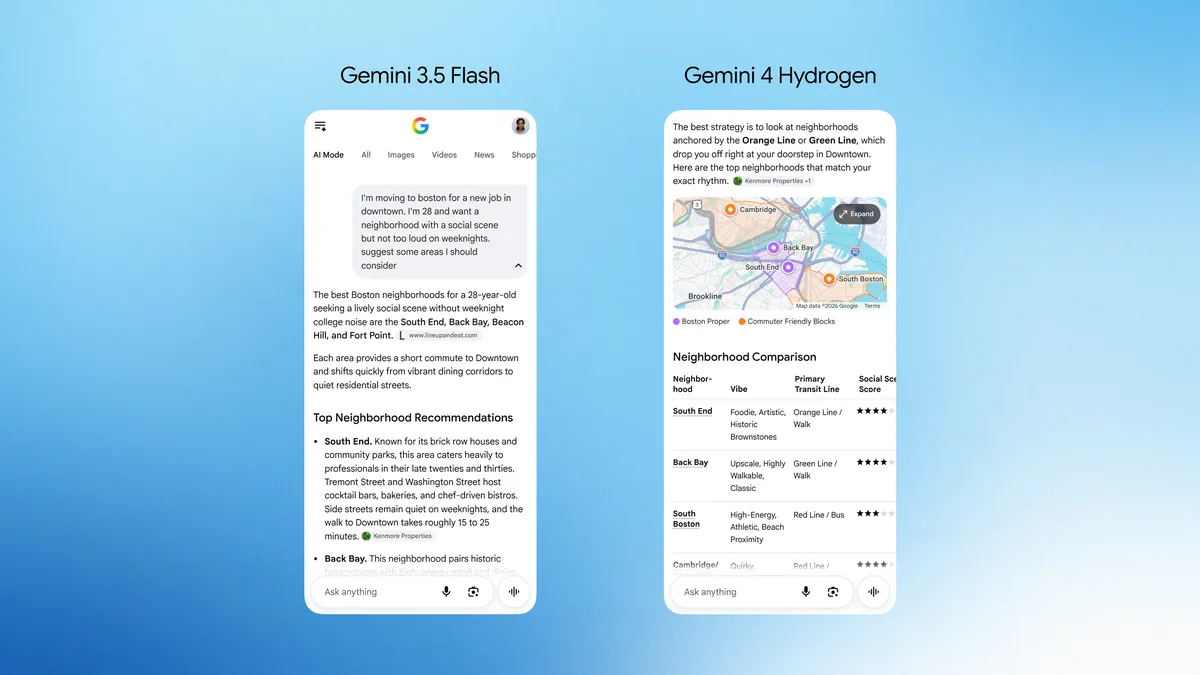
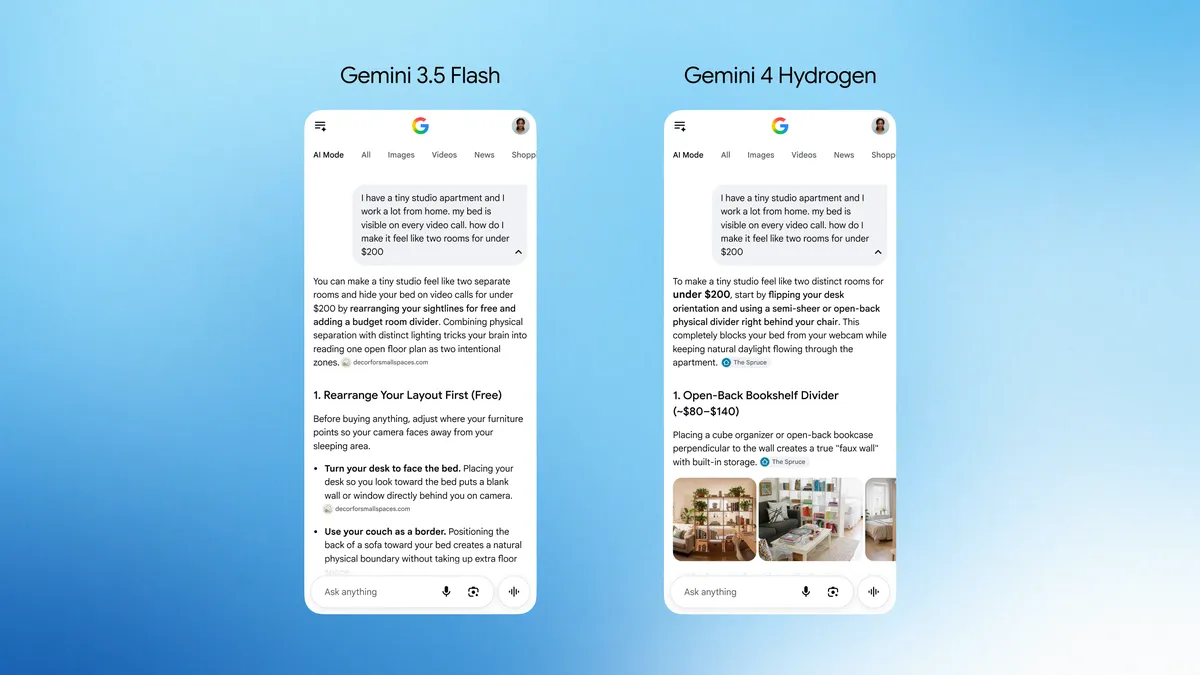
En el Buscador, Google lo llama «la mayor mejora de modelo en la historia de Search». Hydrogen entiende preguntas largas, de varias partes o con errores de dedo, y lanza más búsquedas en paralelo sobre cada subtema, una técnica que Google llama query fan-out, para mostrar enlaces a más sitios. Las respuestas traen más imágenes, tablas comparativas y herramientas armadas para cada pregunta, en todos los idiomas que admite el Modo IA, incluido el español.
Para programadores, el modelo se llama gemini-4-hydrogen en la API y tiene nivel gratuito en AI Studio. En el nivel de pago cuesta el doble que Gemini 3.8 Flash hoy, pero Google ya anunció que 3.8 Flash subirá al mismo precio el 1 de enero de 2027, y queda por debajo de Carbon y Argon, que duplican su tarifa el 1 de diciembre. Las peticiones por lotes cuestan la mitad: $0.75 USD de entrada y $3.75 USD de salida por millón de tokens. También está en Android Studio, en Gemini para empresas y en las Hojas de cálculo de Google, para suscriptores de Google AI Pro y Ultra.
En Antigravity, el entorno de programación con agentes de Google, Hydrogen llega a los suscriptores de pago de Google AI Pro y Ultra junto con Orchestrator, una opción del menú de modelos que reparte una misma tarea entre dos modelos: Carbon (o Argon) explora el proyecto y arma el plan, Hydrogen escribe los cambios y corre las pruebas, y si algo se atora le regresa el control al modelo grande. En las pruebas de Google con Terminal-Bench, logró casi la misma tasa de éxito que Carbon solo, con 24 % menos cuota y 19 % menos tiempo, en promedio. Orchestrator con Carbon es para Ultra; con Argon, también para Pro.
El Gemini 4 que va a usar todo el mundo
Carbon y Argon se llevan los récords, pero Hydrogen es el que más gente va a usar: cualquiera que haga una pregunta en el Modo IA del Buscador ya recibe respuestas de un modelo de la generación 4, sin pagar ni elegirlo. Que sea más rápido y más barato de servir es lo que hace posible ponerlo en algo tan masivo como Google Search, y que invente menos importa justo ahí, donde mucha gente toma la respuesta como un hecho.
Para los desarrolladores, la apuesta es la combinación de modelos. En lugar de pagar el modelo más caro para cada paso de un agente, Google propone que uno grande piense y uno rápido haga el trabajo repetitivo, la misma idea que ya siguen OpenAI y Anthropic con sus familias de modelos de varios tamaños. Si las cifras de Google se sostienen en pruebas independientes, Hydrogen puede abaratar mucho los agentes que corren miles de pasos al día; por ahora, son mediciones de la propia empresa.
Gemini 4 Hydrogen cierra la presentación de la familia Gemini 4 con el modelo pensado para el volumen. Ya se puede probar gratis en el Buscador, en la app de Gemini y en AI Studio, y quien construya agentes tiene hasta fin de año para comparar su precio con el de 3.8 Flash antes de que este suba.
Fuente: Introducing Gemini 4 Hydrogen, blog de Google; Google Search gets a major upgrade with Gemini 4 Hydrogen; Build with Gemini 4 Hydrogen; Gemini 4 Hydrogen and Orchestrator, blog de Google Antigravity; precios de la API de Gemini.