
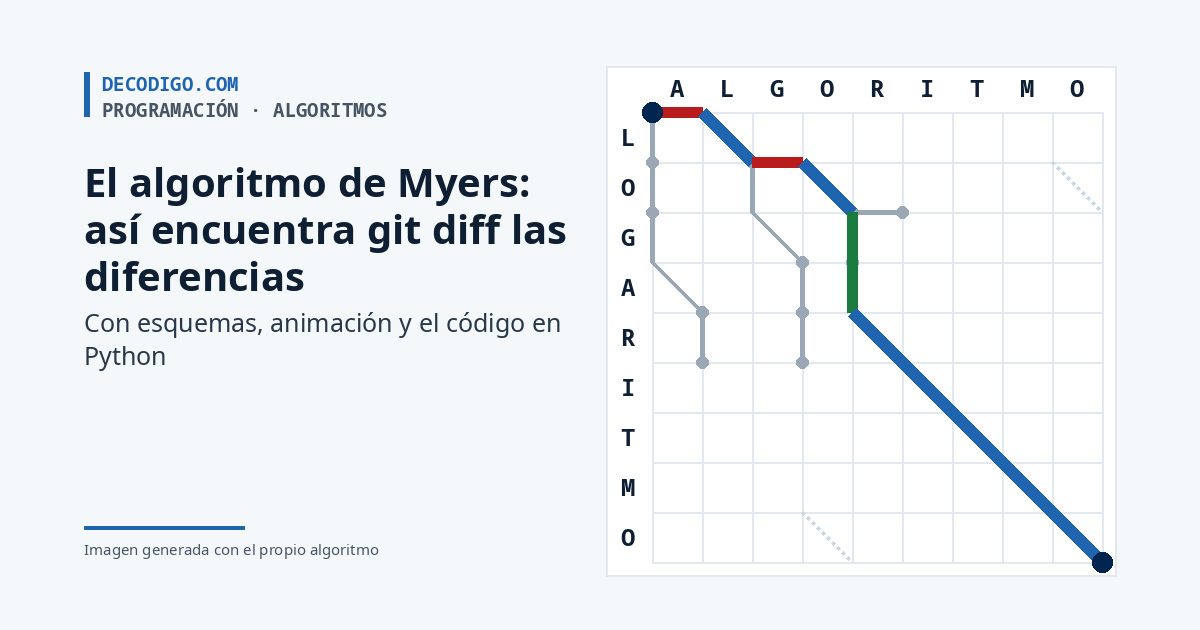
Cada vez que escribes git diff, Git compara dos versiones de un archivo y te enseña, en rojo y en verde, qué líneas se han quitado y cuáles se han añadido. Parece sencillo, pero detrás hay un problema que se resiste: entre los muchísimos caminos posibles para pasar de un texto a otro, hay que encontrar el más corto, y hacerlo rápido. La solución que usan Git y GNU diff, el algoritmo de Myers, la publicó Eugene Myers en 1986, y se entiende muy bien en un dibujo. Aquí la verás funcionar paso a paso, con tus propios textos.
Qué es un diff y por qué no es trivial
Un diff es una lista de instrucciones para convertir un texto A en otro texto B usando solo dos operaciones: borrar un elemento de A o insertar uno de B. Los elementos pueden ser letras, como en los ejemplos de este artículo, o líneas enteras, como hace Git. Lo que no se borra ni se inserta se conserva, y eso es lo que tienen en común los dos textos.
Pasar de A a B siempre se puede: basta con borrarlo todo y escribirlo todo de nuevo. Pero ese diff no sirve de nada, porque no dice qué ha cambiado de verdad. Lo que queremos es el diff con menos operaciones, el que conserva lo máximo posible. Lo que se conserva tiene nombre: es la subsecuencia común más larga (LCS, por sus siglas en inglés), la secuencia más larga de elementos que aparecen en los dos textos y en el mismo orden, aunque no estén seguidos. Encontrar el diff mínimo y encontrar la LCS son el mismo problema visto desde dos lados: si los textos miden N y M y la LCS mide L, el diff mínimo tiene N + M − 2L operaciones.
Lo difícil es que hay muchísimas formas de alinear dos textos. Con dos textos de mil líneas, las combinaciones posibles son astronómicas, y probarlas todas no es una opción. El método clásico, de programación dinámica, rellena una tabla de N × M casillas: para dos archivos de 10,000 líneas son 100 millones de casillas, aunque solo hayas cambiado una coma.
La cuadrícula de edición
La idea de Myers empieza por un dibujo. Escribe A en horizontal y B en vertical, y traza una cuadrícula. Cada punto de la cuadrícula es un estado a medio camino: «ya he recorrido tantas letras de A y tantas de B». Se empieza arriba a la izquierda, en (0, 0), y hay que llegar abajo a la derecha. Desde cada punto hay tres movimientos posibles:
- A la derecha: borrar la siguiente letra de A. Cuesta 1.
- Hacia abajo: insertar la siguiente letra de B. Cuesta 1.
- En diagonal: solo se puede donde la letra de A y la de B son iguales, y no cuesta nada, porque esa letra se conserva.
Así, cada camino de una esquina a la otra es un diff, y su coste es el número de pasos que no son diagonales. El diff mínimo es el camino que aprovecha más diagonales. Myers llamó serpiente (snake) a cada tramo de diagonales seguidas, y D al número de pasos de pago.
El truco de Myers: frentes y diagonales
Para orientarse en la cuadrícula, Myers numera sus diagonales: el punto (x, y) está en la diagonal k = x − y. La diagonal principal, la que sale de la esquina de inicio, es la k = 0; borrar te mueve a la diagonal de la derecha (k + 1), insertar te mueve a la de la izquierda (k − 1), y una coincidencia te deja en la misma.
Con eso, el algoritmo avanza por frentes. Primero mira hasta dónde se llega con D = 0 cambios: solo bajando en diagonal desde (0, 0) mientras las letras coincidan. Luego, con D = 1: un borrado o una inserción, seguidos de toda la diagonal gratis que haya. Luego con D = 2, y así sucesivamente. En cada frente solo guarda una cosa por diagonal: el punto más lejano al que se puede llegar en ella con D cambios. La clave, demostrada en el artículo, es que el punto más lejano con D cambios siempre sale de uno de los puntos más lejanos con D − 1, el de la diagonal de al lado, más un paso y la serpiente que venga detrás. No hace falta recordar nada más.
El primer frente que toca la esquina final da la respuesta, y como los frentes se prueban en orden, de menor a mayor, no puede haber un camino más corto. Para sacar el diff basta con guardar cada frente y recorrerlos hacia atrás desde la esquina.
Pruébalo
Escribe dos textos, o elige un ejemplo, y pulsa «Reproducir». Cada paso de la animación es una diagonal de un frente: la arista roja es un borrado, la verde una inserción, y el tramo azul que sigue es la serpiente, las coincidencias que el algoritmo recorre gratis. La franja azul clara marca la diagonal que se está calculando, y las líneas discontinuas grises son todos los atajos que existen. Los frentes anteriores se quedan en gris. Cuando un frente llega a la esquina, se dibuja el camino elegido y, debajo, el diff. Con «Líneas», cada fila y cada columna son una línea entera, como en Git; los números de la cuadrícula son los números de línea.
borrarinsertarcoincidenciaatajo posible
Prueba «Casi nada en común»: como GATO y PERRO no comparten ninguna letra salvo la O final, el algoritmo tiene que abrir casi todos los frentes, hasta D = 7. Con «El de Myers» basta con 19 pasos para encontrar el camino de D = 5.
Por qué es rápido
El frente D tiene D + 1 diagonales, y cada serpiente avanza sin volver atrás. En total, el algoritmo hace del orden de (N + M) × D operaciones, que Myers escribe O(ND) tomando N como la suma de las dos longitudes. Lo importante es la D: el trabajo no depende tanto del tamaño de los archivos como de cuánto han cambiado. Comparar dos versiones de un archivo de 10,000 líneas en las que has tocado tres líneas es casi instantáneo, porque el algoritmo llega a la esquina como mucho en el frente 6, sin haber mirado la mayor parte de la cuadrícula. Eso es justo lo que pasa casi siempre con el código: entre un commit y el siguiente, cambia poco.
Myers también demostró que, en promedio, el coste es de N + D², y propuso una variante que solo necesita memoria proporcional a N: busca a la vez desde las dos esquinas hasta que los dos recorridos se encuentran en una serpiente central, y repite el proceso a cada lado. Esa es la versión que usan GNU diff y Git.
Un detalle de la versión básica: cuando dos caminos llegan igual de lejos, la regla de elección del algoritmo hace que, en cada bloque de cambios, salgan primero los borrados y después las inserciones. Es como estamos acostumbrados a leer un diff: primero lo que había y luego lo que lo sustituye. Lo hemos comprobado en 2,006 pares de textos al azar: en ninguno aparece una inserción justo antes de un borrado.
El algoritmo en Python
Esta es la versión completa, con la vuelta atrás para sacar el diff. La función frentes es la figura 2 del artículo de Myers casi línea a línea; la única diferencia es que guarda una copia de cada frente para poder reconstruir el camino:
# Algoritmo de diferencias de Myers (1986), versión voraz hacia delante, con la vuelta atrás para sacar el
# script de edición. Referencia para comprobar el núcleo de articulos/myers.js (pruebas/myers/compara.js).
def frentes(a, b):
    """Recorre D = 0, 1, 2… y guarda, para cada D, el punto más lejano (x) alcanzado en cada diagonal k = x - y."""
    n, m = len(a), len(b)
    v = {1: 0}
    traza = []
    for d in range(n + m + 1):
        traza.append(dict(v))
        for k in range(-d, d + 1, 2):
            if k == -d or (k != d and v[k - 1] < v[k + 1]):
                x = v[k + 1]            # baja desde la diagonal k + 1: inserta
            else:
                x = v[k - 1] + 1        # avanza a la derecha desde k - 1: borra
            y = x - k
            while x < n and y < m and a[x] == b[y]:
                x, y = x + 1, y + 1     # serpiente: diagonal gratis mientras coinciden
            v[k] = x
            if x >= n and y >= m:
                return d, traza
    raise AssertionError("inalcanzable")


def diff(a, b):
    """Devuelve el script de edición: lista de ('=', a), ('-', a) y ('+', b), en orden."""
    d, traza = frentes(a, b)
    x, y = len(a), len(b)
    ops = []
    for d in range(d, -1, -1):
        v = traza[d]
        k = x - y
        if k == -d or (k != d and v[k - 1] < v[k + 1]):
            k_prev = k + 1
        else:
            k_prev = k - 1
        x_prev = v[k_prev]
        y_prev = x_prev - k_prev
        while x > x_prev and y > y_prev:
            x, y = x - 1, y - 1
            ops.append(("=", a[x]))
        if d > 0:
            if x == x_prev:
                y -= 1; ops.append(("+", b[y]))
            else:
                x -= 1; ops.append(("-", a[x]))
    ops.reverse()
    return ops


if __name__ == "__main__":
    a, b = "ABCABBA", "CBABAC"
    d, _ = frentes(a, b)
    ops = diff(a, b)
    print("D =", d)
    print(" ".join(s + c for s, c in ops))
print("común:", "".join(c for s, c in ops if s == "="))salidaD = 5 -A -B =C +B =A =B -B =A +C común: CABA
Es el resultado de la figura 1 del artículo original: borrar A y B, conservar C, insertar B, conservar A y B, borrar B, conservar A e insertar C. Hemos comprobado que la animación de arriba usa exactamente el mismo cálculo: en 2,006 pares de textos al azar, las dos dan el mismo diff, letra a letra, y en todos ellos D es la mínima, la que da la LCS calculada con el método clásico.
Lo que hace Git: myers, minimal, patience e histogram
Git deja elegir el algoritmo con la opción --diff-algorithm. Hay cuatro: myers, el que usa por omisión; minimal, que gasta más tiempo para asegurarse de dar el diff más pequeño posible, porque la versión de Git recorta la búsqueda con algunos atajos en los casos difíciles; patience, que primero empareja las líneas que aparecen una sola vez en cada archivo y luego rellena lo que queda entre ellas, e histogram, una variante de patience que también aprovecha las líneas que se repiten poco.
¿Por qué hace falta más de uno? Porque el diff mínimo casi nunca es único: suele haber varios caminos con la misma D, y no todos se leen igual de bien. Un ejemplo clásico: en este programa en C hemos borrado la función fact, hemos añadido fib al principio y hemos quitado una línea de repite.
#include <stdio.h>

// Repite foo diez veces
int repite(int foo)
{
    int i;
    for (i = 0; i < 10; i++)
    {
        printf("Tu respuesta es: ");
        printf("%d\n", foo);
    }
}

int fact(int n)
{
    if (n > 1)
    {
        return fact(n - 1) * n;
    }
    return 1;
}

int main(int argc, char **argv)
{
    repite(fact(10));
}
#include <stdio.h>
int fib(int n)
{
if (n > 2)
{
return fib(n - 1) + fib(n - 2);
}
return 1;
}
// Repite foo diez veces
int repite(int foo)
{
int i;
for (i = 0; i < 10; i++)
{
printf("%d\n", foo);
}
}
int main(int argc, char **argv)
{
repite(fib(10));
}Esto es lo que da git diff --no-index --diff-algorithm=myers antes.c despues.c, con Git 2.39.5:
myers@@ -1,26 +1,25 @@
 #include <stdio.h>

-// Repite foo diez veces
-int repite(int foo)
+int fib(int n)
 {
-    int i;
-    for (i = 0; i < 10; i++)
+    if (n > 2)
     {
-        printf("Tu respuesta es: ");
-        printf("%d\n", foo);
+        return fib(n - 1) + fib(n - 2);
     }
+    return 1;
 }

-int fact(int n)
+// Repite foo diez veces
+int repite(int foo)
 {
-    if (n > 1)
+    int i;
+    for (i = 0; i < 10; i++)
     {
-        return fact(n - 1) * n;
+        printf("%d\n", foo);
     }
-    return 1;
 }

 int main(int argc, char **argv)
 {
-    repite(fact(10));
+    repite(fib(10));
 }
Y esto, con --diff-algorithm=patience:
patience@@ -1,26 +1,25 @@
 #include <stdio.h>

+int fib(int n)
+{
+    if (n > 2)
+    {
+        return fib(n - 1) + fib(n - 2);
+    }
+    return 1;
+}
+
 // Repite foo diez veces
 int repite(int foo)
 {
     int i;
     for (i = 0; i < 10; i++)
     {
-        printf("Tu respuesta es: ");
         printf("%d\n", foo);
     }
 }

-int fact(int n)
-{
-    if (n > 1)
-    {
-        return fact(n - 1) * n;
-    }
-    return 1;
-}
-
 int main(int argc, char **argv)
 {
-    repite(fact(10));
+    repite(fib(10));
 }
Los dos son igual de cortos: 10 líneas añadidas y 11 borradas. Pero el primero mezcla las llaves y las líneas en blanco de funciones distintas, y el segundo cuenta lo que de verdad ha pasado: una función nueva, una línea menos y una función borrada. Con este ejemplo, minimal da lo mismo que myers e histogram, lo mismo que patience. Curiosamente, la versión básica de Python de arriba, aplicada a estas líneas, da exactamente el diff de patience: recorre la cuadrícula en otro orden que la versión de Git, que busca desde las dos esquinas, y en el empate entre caminos igual de cortos elige otro. No es que sea mejor: con otros archivos puede pasar al revés. Si quieres que Git use otro algoritmo siempre, basta con git config --global diff.algorithm histogram.
Si te gustan los algoritmos que se entienden mejor viéndolos, tenemos más con animación: el juego de la vida, la hormiga de Langton y los boids. Y si Git te interesa por dentro, en esta explicación de Scion contamos por qué Anthropic ha dejado Git en su repositorio principal.
Fuentes: E. W. Myers, «An O(ND) Difference Algorithm and Its Variations», Algorithmica 1, 251–266 (1986) (figuras 1, 2 y 3, y secciones 3 y 4); la documentación de git diff (opción –diff-algorithm); el código de Git, xdiff/xdiffi.c, y el de GNU diff, diffseq.h de gnulib, que citan el artículo de Myers. El programa se ejecutó con Python 3.13 y el ejemplo de Git, con Git 2.39.5. La animación y las imágenes, incluida la portada, las genera el propio algoritmo: decodigo.com.