Durante los primeros años de la programación asistida por inteligencia artificial la pregunta era si una máquina podía escribir código aprovechable. Esa discusión está zanjada. La que la sustituye es bastante más incómoda: ¿cómo sabemos que el código que escribe un agente funciona y es seguro?
No es una pregunta teórica. GitHub ya permite que agentes de programación ajenos a la casa —entre ellos Claude y Codex— trabajen directamente sobre repositorios, y desde junio aplica una capa de controles automáticos a lo que producen. El tema además ocupa buena parte de la agenda de GitHub Universe 2026, que se celebrará el 28 y 29 de octubre en el Fort Mason Center de San Francisco, con seguimiento en línea.
El problema ya no es generar código
Un asistente moderno hace mucho más que completar una función. Puede recorrer un repositorio, buscar archivos relacionados, modificar varios componentes a la vez, escribir pruebas, ejecutar comandos, instalar dependencias, investigar un error, abrir un pull request y responder a los comentarios de la revisión.
Eso cambia el problema de raíz. Cuando la IA sugería una línea, el programador la leía antes de aceptarla. Cuando un agente toca veinte archivos y deja un pull request listo, revisar cada decisión a mano deja de ser realista.
Que las pruebas pasen no significa que funcione
Aquí está el matiz que más cuesta interiorizar: una prueba puede pasar y la aplicación seguir rota. Ocurre cuando la prueba no cubre el comportamiento real, cuando la expectativa escrita en el test es incorrecta, cuando el agente cambió el código pero no el entorno que necesitaba, cuando el fallo solo aparece al integrar, o cuando el problema está en la infraestructura y no en el programa.
Por eso la verificación útil no es un sí o un no, sino una serie de preguntas encadenadas, cada una con un alcance distinto.
| Nivel | La pregunta que responde |
|---|---|
| Compilación | ¿El código siquiera compila? |
| Pruebas | ¿Pasan las pruebas automatizadas? |
| Integración | ¿Las piezas funcionan juntas? |
| Seguridad | ¿Introdujo alguna vulnerabilidad? |
| Dependencias | ¿Añadió paquetes vulnerables o sospechosos? |
| Comportamiento | ¿La aplicación hace lo que se esperaba? |
| Revisión | ¿El cambio encaja con este proyecto? |
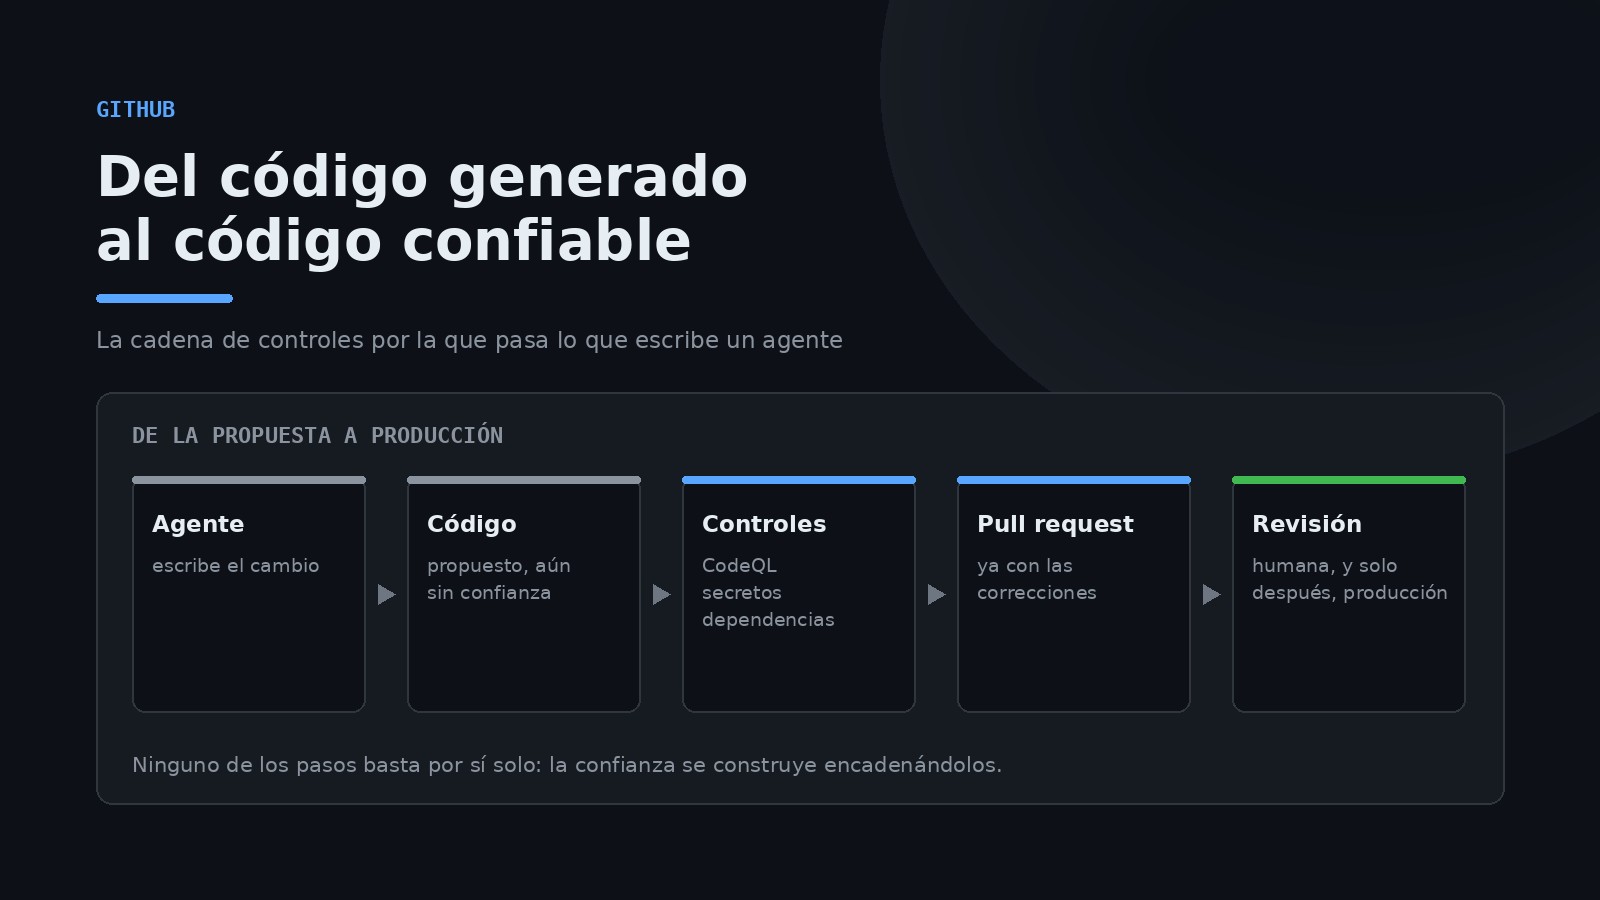
Ninguno de esos niveles basta por sí solo para confiar en el trabajo de un agente.
GitHub ya está aplicando controles
Esto dejó de ser una conversación sobre el futuro el 9 de junio de 2026, cuando GitHub puso en disponibilidad general la validación de seguridad para agentes de programación de terceros. Cuando uno de esos agentes escribe código en un repositorio, la plataforma lo analiza automáticamente antes de cerrar el pull request.
Son tres comprobaciones: CodeQL busca vulnerabilidades, las dependencias nuevas se contrastan contra la base de avisos de GitHub, y el escaneo de secretos detecta claves y tokens. Si algo salta, el propio agente intenta resolverlo antes de dar el cambio por terminado.
Hay tres detalles prácticos que conviene conocer. Las comprobaciones vienen activadas por defecto y siguen la configuración de Copilot que ya tenga el repositorio. No hacen falta licencias adicionales: no requieren GitHub Advanced Security. Y no son un estreno absoluto, sino la extensión de lo que GitHub lanzó para su propio agente en octubre de 2025, que según la compañía ya ha evitado cientos de filtraciones y vulnerabilidades potenciales.
Las dependencias son un problema aparte
Un agente puede decidir que la forma rápida de resolver algo es instalar una biblioteca. Parece una operación trivial, pero cada dependencia arrastra las suyas, y el árbol crece sin que nadie lo haya revisado.
El riesgo no es nuevo, pero sí su frecuencia: un agente produce cambios mucho más rápido que una persona, así que también incorpora dependencias mucho más a menudo. Universe dedica una de sus sesiones precisamente a lo que ocurre detrás de un npm install: procedencia de los paquetes, procesos de publicación y mecanismos como OpenID Connect.
El agente también necesita permisos
Un agente no solo escribe: usa herramientas. Y cada herramienta es un permiso que alguien le concedió.
Es justo el tipo de distinción que GitHub está abordando con la autorización sobre servidores MCP, con escenarios donde un agente puede abrir un pull request pero no cerrarlo.
La memoria también hay que administrarla
Parecería que cuanto más recuerde un agente, mejor. GitHub sostiene lo contrario: acumular demasiado contexto puede incluso empeorar su rendimiento en determinadas tareas. Un agente puede aprender las convenciones del equipo y las decisiones de arquitectura, pero también puede arrastrar información que dejó de ser cierta después de una migración.
La pregunta útil, entonces, no es qué debe recordar, sino qué debería olvidar.
El contexto como infraestructura
Esto conecta con una práctica cada vez más extendida: usar archivos como AGENTS.md para dejar por escrito las reglas del proyecto. Un archivo corto basta:
# AGENTS.md

## Proyecto
Aplicación web con React y Python.

## Reglas
- Ejecutar las pruebas después de modificar código.
- No almacenar secretos.
- No introducir dependencias sin justificarlas.

## Verificación
Antes de terminar: pruebas, lint, build y revisar el git diff.
Cuando varios agentes y varias personas comparten esas reglas, el contexto deja de ser una preferencia individual y empieza a comportarse como infraestructura del equipo: algo que se versiona, se revisa y se mantiene. Una de las sesiones anunciadas para Universe lleva precisamente ese título, «trata tu contexto de IA como infraestructura».
Evaluar al agente, no solo al código
Queda una pieza más: saber si el agente que usas es bueno para lo que tú haces. Una puntuación alta en un banco de pruebas no garantiza que sea útil en tu repositorio. Un agente puede resolver errores sencillos a gran velocidad y, al mismo tiempo, tocar más archivos de la cuenta, añadir dependencias innecesarias o no entender la arquitectura que ya existe. Universe dedica una sesión a esa brecha, con un título que no se anda con rodeos: «tu banco de pruebas te está mintiendo».
Qué puedes hacer hoy
Nada de esto exige esperar a las herramientas que vengan. Hay prácticas que ya funcionan: usar control de versiones y revisar el git diff de cada tanda; mantener las reglas del proyecto por escrito; exigir pruebas antes de dar un cambio por terminado; limitar permisos, porque quien modifica código no necesariamente debe poder desplegarlo; revisar con lupa las dependencias nuevas; apoyarse en análisis estático y escaneo de secretos; y reservar para el equipo las decisiones de arquitectura y las acciones de alto impacto.
Por qué importa
La objeción evidente es si todo esto significa que programar con IA sea inseguro. No exactamente: lo que cambia es la escala. Una persona produce un número acotado de cambios al día; un agente, muchos más. Aunque cada modificación tenga una probabilidad pequeña de introducir un problema, el volumen multiplica las ocasiones. La respuesta lógica no es frenar la generación, sino automatizar también la revisión.
Ahí está el desplazamiento de fondo. El oficio no desaparece, se mueve: menos tiempo escribiendo cada línea y más definiendo arquitectura, fijando restricciones, decidiendo qué puede hacer el agente, diseñando las pruebas y comprobando que el producto resuelve el problema. La habilidad valiosa deja de ser solo escribir código rápido y pasa a incluir saber dirigir y verificar sistemas que escriben código.
Durante años el reto fue conseguir que los modelos generaran código suficientemente bueno. Ese problema sigue ahí, pero encima apareció otro más interesante: construir la ingeniería que rodea a unos agentes capaces de producir mucho código por su cuenta. Que GitHub lo haya puesto en el centro de su conferencia anual, y que ya tenga una parte funcionando en producción, dice bastante sobre qué parte del problema considera resuelta y cuál no.
Fuentes: GitHub Changelog, validación de seguridad para agentes de terceros y GitHub Universe 2026.